Pourquoi l'IA lit votre écriture manuscrite sans faute
Mais rate encore une case cochée
Un développeur sur le forum OpenAI a passé trois semaines à construire un pipeline de traitement de demandes de prêt. L'IA a extrait tous les champs manuscrits — noms des emprunteurs, adresses des biens, montants des prêts — avec une précision quasi parfaite. Puis est venue la section des cases à cocher : « Type d'occupation : Résidence principale / Résidence secondaire / Bien d'investissement. » Le modèle n'a rien renvoyé. Trois boutons radio, clairement visibles, un seul coché. GPT-4 Vision les a regardés et n'a vu aucune sélection. Un fil documentant cette difficulté exacte a attiré des dizaines de développeurs confrontés au même mur : leur IA pouvait lire l'écriture d'un médecin, mais ne pouvait pas dire si une case contenait une coche.
Ce n'est pas un hasard. Une étude comparative de 2025 menée par Snowflake Research a testé huit modèles de langage visuel de pointe sur des tâches d'interprétation de cases à cocher. Le meilleur modèle a obtenu un score de 83,2 %, contre 97,5 % pour les humains — un écart suffisamment large pour que chaque modèle de pointe échoue au traitement direct sur les formulaires riches en cases à cocher. (Pour la répartition complète de la précision par type de marque — stylo, crayon ou marques ambiguës — consultez notre guide sur la précision des cases à cocher.) L'écart entre « lit bien l'écriture manuscrite » et « lit les cases à cocher de manière fiable » n'est pas mince — c'est la différence entre faire confiance à votre automatisation et vérifier chaque résultat à la main.
Ce paradoxe — le texte est facile, les coches sont difficiles — définit l'état actuel de l'IA de traitement de formulaires. Et comprendre pourquoi il existe est la clé pour choisir des outils qui fonctionnent réellement sur les formulaires que vous devez traiter, et pas seulement sur les démos qu'ils vous montrent.
Pourquoi votre OCR lit chaque mot — et ignore chaque case à cocher
Pour comprendre le problème des cases à cocher, vous devez comprendre ce qui se passe à l'intérieur d'un pipeline OCR traditionnel — et où l'information visuelle se perd.
La reconnaissance optique de caractères fonctionne en scannant une page, en détectant les zones de texte et en convertissant les motifs de pixels en codes de caractères. Un « W » dans un document scanné est un agencement spécifique de pixels sombres et clairs ; le moteur OCR fait correspondre ce motif à une forme de lettre connue. Cela fonctionne raisonnablement bien pour le texte imprimé et, avec les moteurs OCR modernes basés sur l'apprentissage profond, de mieux en mieux pour l'écriture manuscrite.
Mais voici la défaillance critique : l'OCR voit une case à cocher avec une coche — et n'a aucun caractère auquel la faire correspondre. Une coche n'est pas un « V » et ce n'est pas un « ✓ » dans aucun jeu de caractères que le moteur reconnaît. L'OCR soit l'ignore complètement, soit produit des données erronées : un symbole aléatoire, une chaîne vide, un caractère mal interprété.
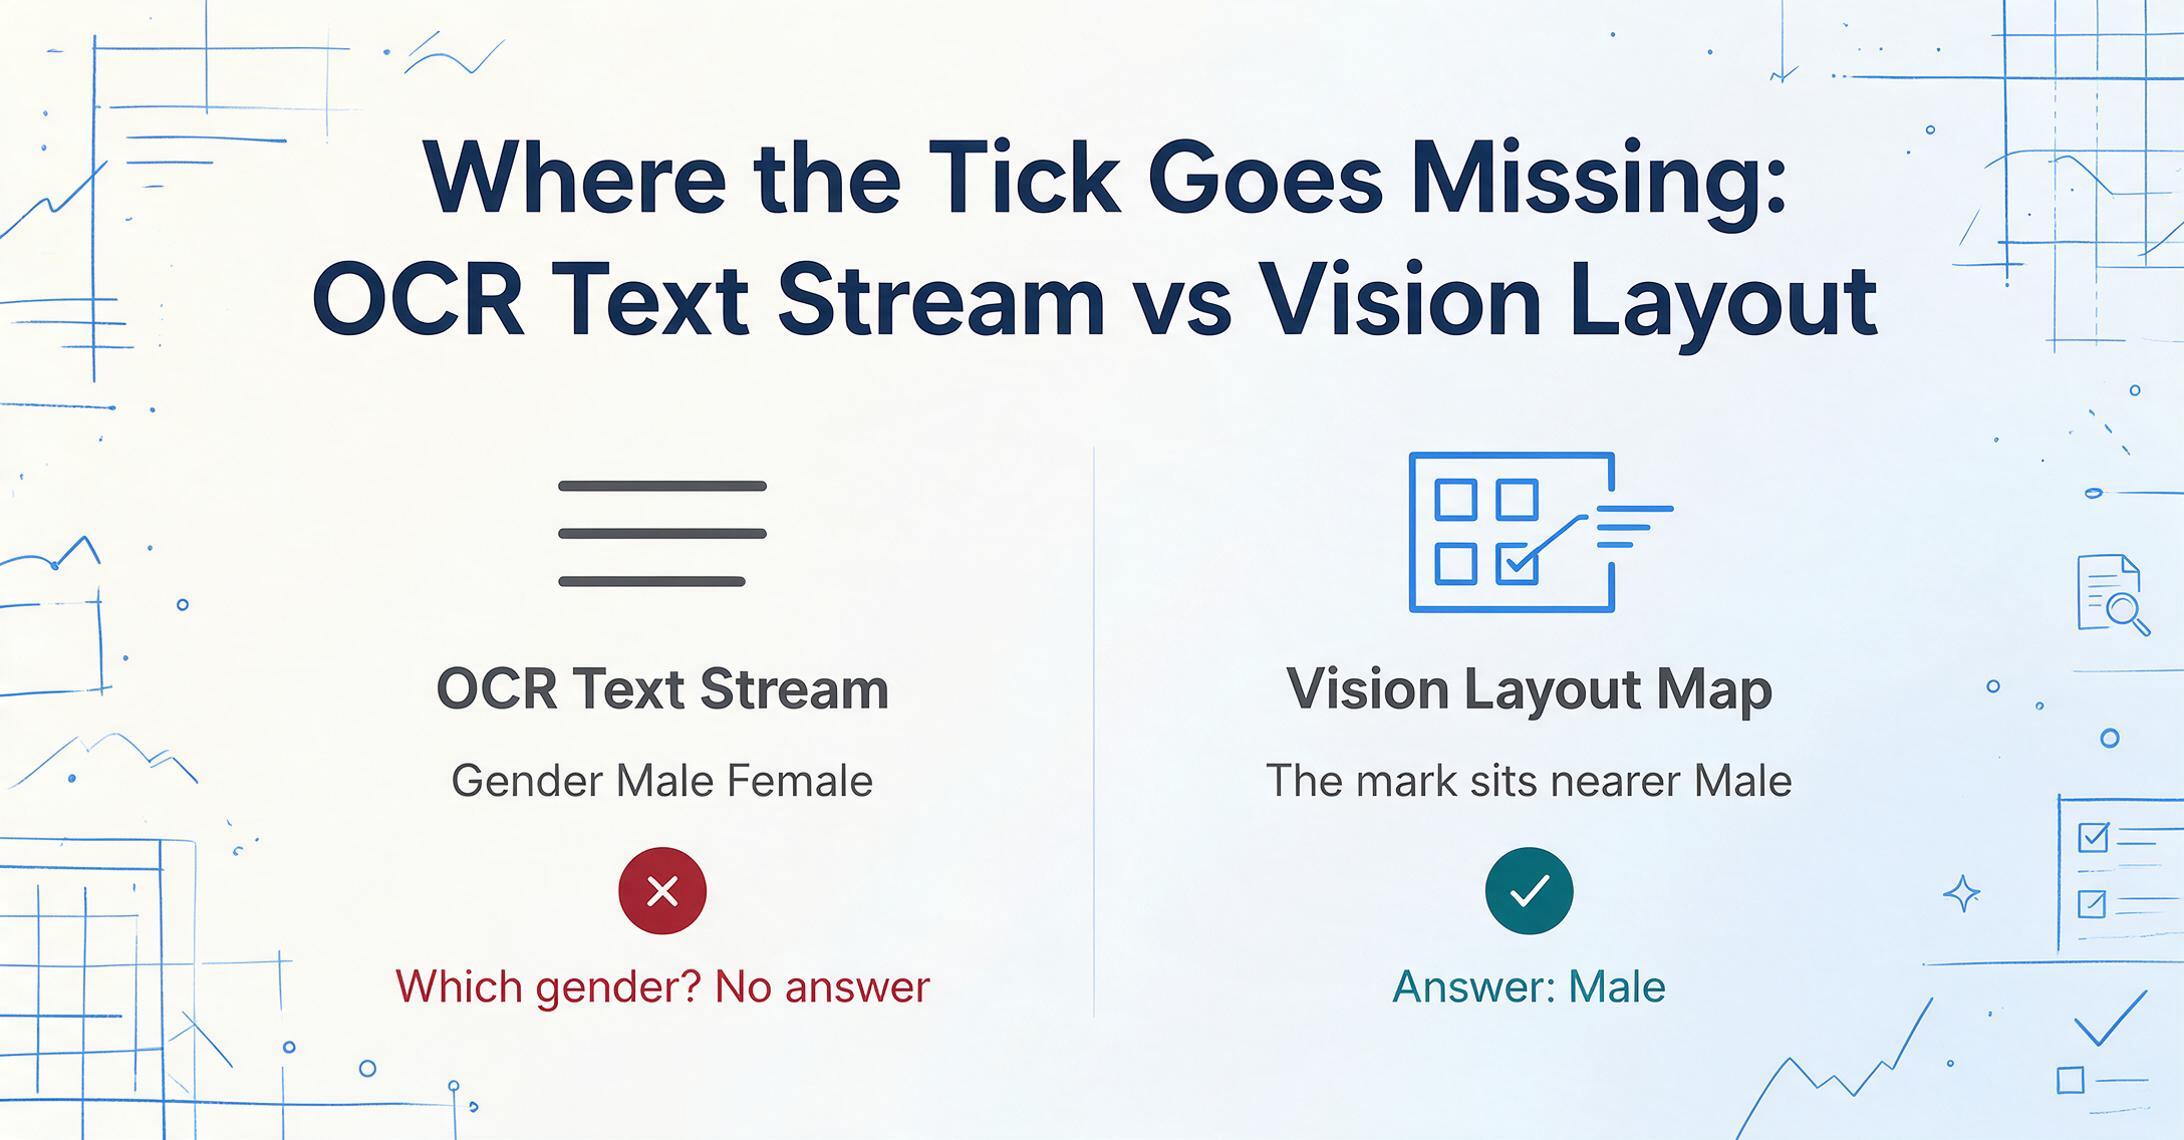
Même lorsque l'OCR capture la coche comme quelque chose, la relation spatiale entre la marque et son étiquette est perdue. Le pipeline produit un flux de texte plat : « Genre Homme Femme Âge 34 Groupe sanguin A+. » Quel genre a été sélectionné ? Le flux ne donne aucune indication. La mise en page visuelle — le fait qu'une marque soit plus proche de « Homme » que de « Femme » — a été écartée au moment où l'OCR a converti la page en texte. C'est pourquoi une approche basée sur l'OCR pour le traitement de formulaires échoue systématiquement sur les cases à cocher, les boutons radio et tout format de données où la position porte du sens.
Comment l’IA visuelle lit toute la page — pas seulement le texte qu’elle contient
Les modèles de langage visuel (VLM) — la catégorie d’IA qui alimente les outils modernes d’extraction de documents — changent fondamentalement l’approche. Au lieu de convertir l’image en texte puis de raisonner sur ce texte, un VLM traite directement l’image du document. Il voit la mise en page, les relations spatiales, les gestes visuels. Lorsque vous lui demandez « quelle case est cochée ? », il regarde la page comme le ferait une personne : il localise chaque case, examine si elle contient une marque, et associe cette marque au texte d’étiquette le plus proche.
Cette approche visuelle d’abord est ce qui rend possible le traitement des formulaires manuscrits. Un VLM n’a pas besoin que la coche soit un caractère — il doit simplement reconnaître « il y a de l’encre dans cette région rectangulaire » par rapport à « cette région est vide ». Le modèle apprend cette distinction à partir de données d’entraînement comprenant des millions d’images de documents avec des annotations indiquant quels champs sont remplis et lesquels ne le sont pas.
Mais — et c’est la partie que la plupart des pages produit omettent — les VLM ne sont pas aussi performants que vous pourriez le penser. Les modèles frontières qui lisent l’écriture cursive avec une précision supérieure à 90 % obtiennent régulièrement des scores de 60 à 83 % sur l’interprétation pure des cases à cocher, et même le meilleur modèle testé dans le benchmark CheckboxQA reste 14 points derrière la performance humaine.
La difficulté principale n’est pas que les VLM ne voient pas les cases à cocher. C’est que le signal visuel est extrêmement subtil par rapport à tout le reste de la page. Une case à cocher typique occupe environ 0,1 % des pixels d’une image de document. La différence entre « coché » et « non coché » peut être une fine ligne d’encre sur un carré de 12 pixels. Lorsque le modèle traite également des paragraphes de texte dense, des structures de tableaux, des logos et des étiquettes de formulaire, ce minuscule signal entre en compétition pour attirer l’attention — et parfois il perd.
Cinq façons dont l'IA se trompe sur les cases à cocher — même quand tout le reste est correct
Les chercheurs de CheckboxQA ont répertorié des schémas d'échec spécifiques qui se reproduisent sur chaque modèle testé. Comprendre ces schémas n'est pas théorique — cela vous indique à quoi faire attention lors de l'évaluation d'un outil de traitement de formulaires.
Échec n°1 : Inversion de la case et de l'étiquette
Sur de nombreux formulaires, la case à cocher se trouve à gauche de son texte d'étiquette. Sur d'autres, elle se trouve à droite. Le modèle attribue parfois une case de gauche à l'étiquette de droite, et une case de droite à l'étiquette suivante — inversant ainsi quelle option est marquée. C'est une erreur d'association spatiale, pas une erreur de détection : le modèle a vu la marque, mais l'a associée au mauvais texte.
Échec n°2 : Faire confiance au texte plutôt qu'à la vision
Lorsqu'un formulaire demande « Une tâche supplémentaire est-elle requise ? » avec des cases à cocher Oui/Non, certains modèles répondent en se basant sur le contexte textuel environnant plutôt qu'en vérifiant quelle case est réellement marquée. Ils se rabattent sur le raisonnement linguistique — « cette description de tâche semble complexe, donc probablement Oui » — au lieu d'effectuer l'inspection visuelle que la question exige. C'est particulièrement dangereux car la réponse semble plausible même lorsqu'elle est fausse.
Échec n°3 : Lister toutes les options
Dans les scénarios de sélection multiple — « Quelles catégories de véhicules sont indiquées comme applicables ? » — les modèles renvoient parfois toutes les options comme étant cochées, même lorsqu'un sous-ensemble seulement est marqué. Le modèle reconnaît l'ensemble des réponses possibles dans le texte, mais ne parvient pas à filtrer selon l'état visuel.
Échec n°4 : Perte des cases à cocher dans les tableaux
Lorsque les cases à cocher apparaissent dans des cellules de tableau — courant dans les listes de contrôle d'inspection et les formulaires de conformité — la structure tabulaire environnante peut distraire le modèle. Les lignes de grille, les valeurs des cellules adjacentes et les en-têtes de colonnes se disputent l'attention, et l'état de la case se perd dans le bruit visuel.
Échec n°5 : Renvoyer des symboles au lieu de réponses
Certains modèles répondent aux questions de cases à cocher avec des marques littérales — produisant « ✓ » ou « X » à la place d'une réponse textuelle comme « Coché » ou le texte de l'étiquette. Cela peut sembler mineur, mais lorsque vous intégrez les résultats d'extraction dans une base de données ou un tableur, un caractère ✓ là où vous attendiez « Résidence principale » casse le pipeline de données.
Ces échecs ne sont pas répartis uniformément. Les formulaires avec des cases à cocher propres et bien espacées et des mises en page simples obtiennent une meilleure précision que les formulaires denses à plusieurs colonnes avec de petites cases. Mais la conclusion constante de la recherche est que aucun modèle n'est assez fiable pour exécuter l'extraction de cases à cocher sans vérification — et les modèles les plus performants sur les tâches documentaires générales ne sont pas nécessairement les meilleurs pour les tâches spécifiques aux cases à cocher. La composition des données d'entraînement importe plus que la taille du modèle.
Le rebondissement de l'écriture manuscrite : pourquoi le texte griffonné est devenu le problème le plus facile
Si vous aviez demandé à un ingénieur en traitement de documents en 2018 quel était l'élément le plus difficile à extraire d'un formulaire, il aurait répondu l'écriture manuscrite — sans hésiter. Styles variables, liaisons cursives, espacements incohérents, casse mixte. La reconnaissance de l'écriture manuscrite était le défi principal.
En 2026, cette hiérarchie s'est inversée. Les VLM modernes sont remarquablement doués pour lire l'écriture manuscrite, car l'écriture manuscrite reste, au fond, un problème de texte. Même une cursive brouillonne suit les schémas statistiques du langage écrit — probabilités de séquences de lettres, limites de mots, attentes contextuelles. Un VLM peut utiliser sa compréhension du langage pour combler les lacunes : s'il lit « P_tient N_me » sur un formulaire médical sous « Nom du patient », il peut déduire les lettres manquantes du contexte.
Les cases à cocher n'ont pas ce filet de sécurité contextuel. L'état d'une case à cocher — cochée ou non — est purement visuel. Il n'y a aucun signal linguistique sur lequel s'appuyer lorsque la composante de vision est incertaine. Si le modèle ne peut pas voir clairement si de l'encre existe dans un petit rectangle, il doit deviner. Et dans les modèles de langage, une supposition tend à se rabattre sur le schéma le plus courant dans les données d'entraînement — souvent « non coché », statistiquement plus fréquent sur la plupart des formulaires — ce qui entraîne des faux négatifs systématiques.
Un utilisateur de Stack Overflow qui a revisité sa question vieille de dix ans sur la numérisation de cases à cocher a bien capturé la frustration : son IA lisait correctement les mots écrits, mais les cases à cocher n'étaient correctes qu'environ 80 % du temps — et personne ne pouvait expliquer les 20 % restants. Ce chiffre de 80 % semble acceptable jusqu'à ce que vous traitiez 200 formulaires. Quarante formulaires avec au moins une erreur. Quarante formulaires à revérifier manuellement.
Comment traiter des formulaires à cases à cocher dans Excel — sans perdre les coches
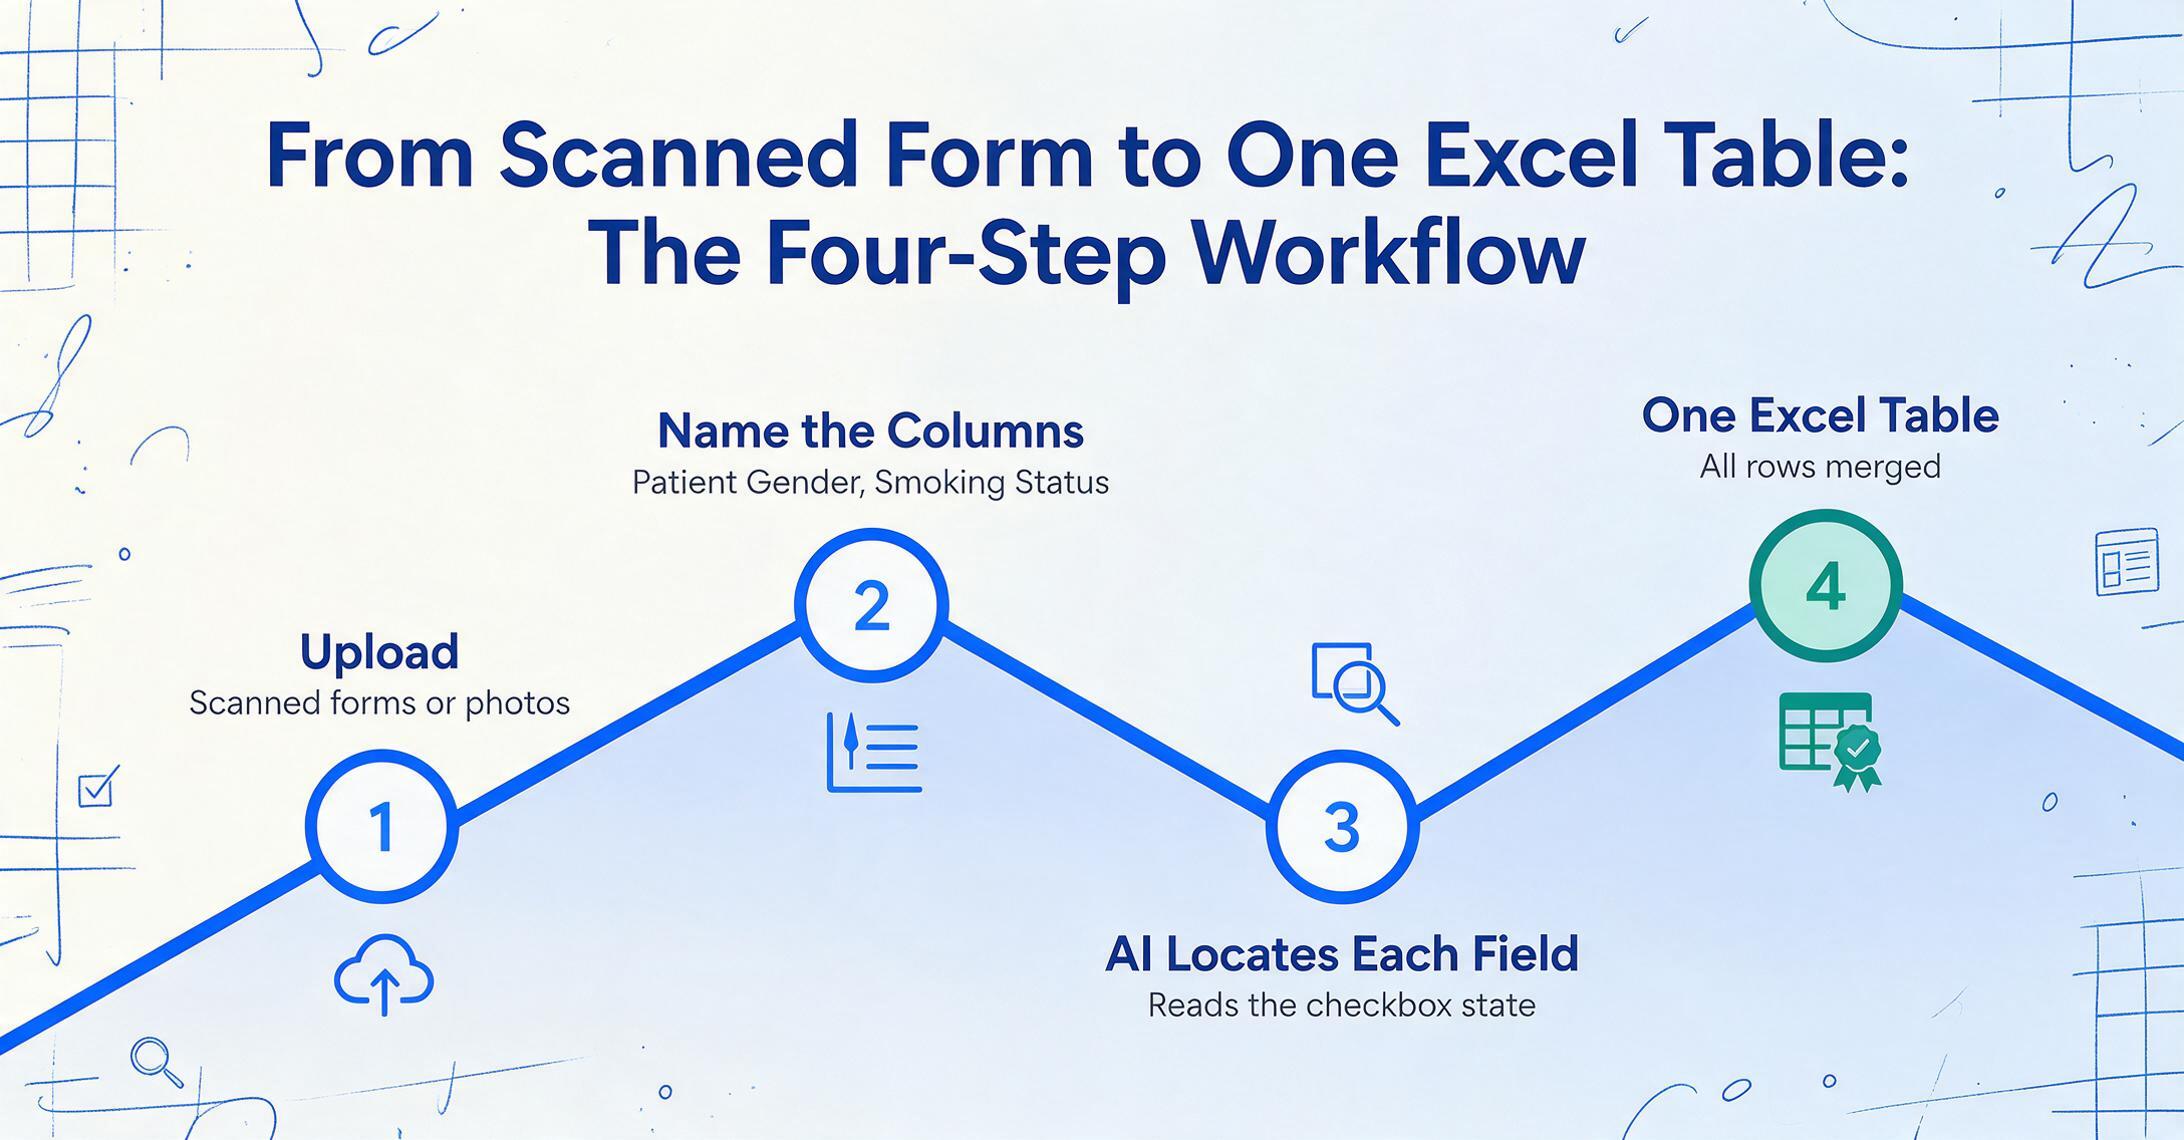
La recherche clarifie un point : vous ne pouvez pas jeter une image de formulaire brut à une IA générique et espérer une extraction parfaite des cases à cocher. Mais vous pouvez construire un flux de travail qui vous y mène. La différence réside dans la façon dont l'IA est instruite — et ce qui se passe autour.
L'approche moderne la plus efficace utilise l'extraction de colonnes personnalisée : au lieu de demander à l'IA de « tout lire sur ce formulaire », vous définissez exactement les champs que vous voulez. Vous tapez les noms de colonnes — « Sexe du patient », « Statut tabagique », « Allergies (cochées) » — et l'IA parcourt le document pour chaque champ, localise sa case à cocher ou sa valeur textuelle, et renvoie le résultat. C'est fondamentalement différent des outils basés sur des modèles où vous dessinez des cadres autour de chaque champ sur un formulaire maître. Vous définissez la sortie souhaitée ; l'IA détermine où se trouvent les données dans n'importe quelle mise en page.
L'approche « définissez votre sortie » est particulièrement importante pour les cases à cocher, car elle donne à l'IA une cible claire. Au lieu de poser une question ouverte comme « qu'est-ce qui est coché ? », vous demandez « pour le champ intitulé « Méthode de contact préférée », est-ce que Téléphone, E-mail ou Courrier est coché ? ». Le modèle n'a pas besoin de déterminer quels éléments de la page sont des champs de case à cocher — il recherche le texte du libellé que vous avez spécifié, puis examine la zone visuelle autour de celui-ci pour détecter une case cochée ou non cochée.
Pour un formulaire unique, cela fait gagner des minutes. Pour un lot de formulaires traités ensemble, le traitement par lots fusionne tous les résultats dans une seule feuille de calcul — chaque ligne correspond à un formulaire, chaque colonne à un champ. Une pile de 200 formulaires d'admission de patients devient un tableau de 200 lignes, prêt pour l'analyse, en à peu près le temps nécessaire pour traiter quelques formulaires individuellement.
Trois domaines où l'extraction de cases à cocher change la façon de travailler
L'écart entre la lecture de texte et la lecture de cases à cocher n'est pas théorique — il se manifeste dans des flux de travail spécifiques où les formulaires mélangent des saisies manuscrites et des champs à cocher. Ce sont les environnements où la différence entre un outil capable de gérer les cases à cocher et une OCR textuelle uniquement est la différence entre une automatisation complète et la nécessité de garder un humain dans la boucle.
Formulaires de réclamation d'assurance
Les formulaires de réclamation standardisés comme le CMS-1500 et l'UB-04 contiennent des dizaines de champs de cases à cocher et de boutons radio : codes de service, indicateurs de lieu de service, indicateurs d'acceptation de cession, pointeurs de diagnostic. Une enquête sectorielle de 2025 menée par Parseur a révélé que la saisie manuelle de données coûte aux entreprises américaines en moyenne 28 500 $ par employé et par an, les travailleurs consacrant plus de neuf heures par semaine au transfert répétitif de données de documents vers des systèmes. Pour les gestionnaires de réclamations d'assurance, une grande partie de ce temps est consacrée aux champs de cases à cocher — de petites saisies qui, collectivement, consomment des heures parce qu'elles apparaissent sur chaque formulaire.
Le marché de l'IA dans les réclamations d'assurance a atteint 514 millions de dollars en 2024 et devrait croître à un TCAC de 18,3 % pour atteindre 2,76 milliards de dollars d'ici 2034. Cette croissance est en partie due à la reconnaissance que l'automatisation des cases à cocher et des marques de sélection — et non pas seulement l'OCR des champs imprimés — est le goulot d'étranglement qui maintient les taux de traitement direct en dessous de ce que les assureurs souhaitent.
Formulaires d'admission médicale et d'antécédents des patients
Les formulaires d'admission des patients sont conçus pour être denses en cases à cocher. Listes de symptômes (« Cochez tout ce qui s'applique »), déclarations de médicaments, grilles oui/non sur les antécédents familiaux, accusés de consentement — un seul dossier de nouveau patient peut contenir plus de 50 champs de cases à cocher, accompagnés de saisies manuscrites pour les instructions posologiques, les notes d'allergie et les lignes de signature. Le problème est que les cases à cocher sont là où les modes de défaillance de la détection des cases frappent le plus durement : un patient qui entoure « Aucune des réponses ci-dessus » sur une liste d'allergies, ou une coche au crayon à peine visible sur un formulaire de consentement, produit un champ qu'une IA générique pourrait renvoyer comme non coché — faisant silencieusement basculer une réponse cliniquement pertinente dans la colonne « non ». L'écriture manuscrite dans les sections de texte libre est généralement bien extraite ; ce sont les sélections binaires qui nécessitent un flux de travail conçu autour de la vérification.
Listes de contrôle d'inspection et de conformité
Les inspections de sécurité sur les chantiers, les rapports d'état des propriétés, les listes de contrôle qualité, les journaux de maintenance des équipements — ce sont fondamentalement des documents à cases à cocher. Un inspecteur de terrain parcourt un site, coche des éléments sur un formulaire papier et griffonne des notes à côté des problèmes. Les données des cases à cocher (quels éléments ont réussi ? lesquels ont échoué ?) constituent la sortie principale. Les notes manuscrites sont le contexte. Mais le traitement manuel traite les deux de manière égale : quelqu'un doit examiner chaque case, chaque note, et les saisir dans une feuille de calcul.
Le volume augmente rapidement — un programme d'inspection hebdomadaire sur quelques sites génère des centaines de champs de cases à cocher par semaine, et chacun d'eux est une décision binaire dont dépend le rapport de conformité. Automatiser cela avec un outil d'extraction de formulaires capable de distinguer les cases cochées des cases non cochées tout en capturant les notes manuscrites transforme une tâche hebdomadaire de plusieurs heures en un traitement par lots de quelques minutes — mais cela ne fonctionne que si la gestion des cases à cocher de l'outil est vérifiée, car une lecture erronée de « dangereux » est pire que l'absence de données.
Questions fréquemment posées
L'IA peut-elle distinguer de manière fiable une coche (✓), une croix (X) et un cercle rempli ?
Les modèles de langage visuels (VLM) modernes peuvent distinguer ces types de marques avec une précision raisonnable — le plus grand défi n'est pas la classification du type de marque, mais la détection de la présence de la marque. Un trait de crayon léger, une marque partielle qui dépasse la limite de la case, ou une case légèrement ombrée plutôt qu'explicitement cochée créent tous des signaux visuels ambigus. Le modèle peut classer avec confiance une « ✓ » clairement visible comme « cochée » mais manquer un trait de crayon léger qu'un humain interpréterait comme une marque. Si vos formulaires ont des styles de marquage incohérents, attendez-vous à des cas limites nécessitant une révision humaine.
Quelle est la différence entre la détection de cases à cocher et l'interprétation de cases à cocher ?
La détection consiste à déterminer « y a-t-il une marque dans cette case ? » L'interprétation consiste à déterminer « que signifie cette marque dans le contexte de ce formulaire ? » Une case cochée à côté de « Refuser la couverture » signifie quelque chose de très différent d'une case cochée à côté de « Accepter les conditions ». La détection est une tâche visuelle ; l'interprétation nécessite de lire et de comprendre le texte de l'étiquette, les instructions du formulaire, et parfois la relation entre plusieurs cases à cocher (par exemple, les boutons radio mutuellement exclusifs par rapport aux cases à cocher à sélection multiple). Les bons outils de traitement de formulaires gèrent ces deux niveaux — et le niveau d'interprétation est là où la compréhension du langage devient essentielle.
L'extraction de cases à cocher fonctionne-t-elle sur les formulaires manuscrits, ou uniquement sur les formulaires imprimés ?
Elle fonctionne sur les deux, mais la précision diffère. Les formulaires imprimés avec des cases clairement délimitées et des coches sombres constituent le cas le plus simple. Les formulaires manuscrits introduisent deux variables supplémentaires : l'écriture manuscrite qui remplit les champs de texte (que les modèles de langage visuel (VLM) gèrent bien désormais) et les marques manuscrites à l'intérieur des cases à cocher — qui peuvent être griffonnées, barrées, entourées ou partiellement remplies. Un modèle de langage visuel (VLM) qui lit le document dans son ensemble peut mieux gérer les formulaires mixtes manuscrits et cases à cocher qu'un pipeline qui sépare la reconnaissance optique de caractères (OCR) et la détection des cases à cocher en étapes déconnectées, car le modèle de langage visuel (VLM) ne perd pas d'informations spatiales entre les étapes.
Combien de formulaires puis-je traiter à la fois ?
Le traitement par lots vous permet de téléverser plusieurs formulaires simultanément et de recevoir un tableau de sortie fusionné. La limite pratique dépend de l'architecture de l'outil — certains prennent en charge des dizaines, d'autres des centaines par lot. Sur ImageToTable.ai, l'extraction de colonnes personnalisée fonctionne sur des lots entiers : vous définissez vos colonnes une fois, téléversez tous vos formulaires, et les états des cases à cocher et les valeurs des champs de chaque formulaire remplissent les lignes correspondantes d'un seul tableur. Aucune configuration par formulaire, aucun modèle par fournisseur.
Quelle précision dois-je attendre pour l'extraction de cases à cocher ?
Sur l'interprétation pure des cases à cocher — isolée du reste du formulaire — les meilleurs modèles de langage visuel testés dans le benchmark CheckboxQA ont obtenu entre 60 % et 83 %, avec un niveau humain à 97,5 %. Mais sur des formulaires réels, la précision dépend davantage de la conception du formulaire et de la qualité des marques que du modèle : les grandes cases bien séparées sur des scans propres donnent des résultats nettement meilleurs que les petites cases sur des photos basse résolution. Pour la répartition type de marque par type de marque (cases numériques, coches au stylo, crayon, marques ambiguës), consultez notre guide de précision des cases à cocher. Le flux de travail le plus fiable est l'extraction automatisée avec vérification par contrôle par sondage — l'IA gère l'essentiel du travail, et vous vérifiez un échantillon pour repérer les cas limites, plutôt que de vérifier chaque formulaire individuellement.
Le vrai enseignement ne concerne pas les cases à cocher
Le problème des cases à cocher révèle une vérité plus profonde sur l'IA documentaire : la reconnaissance de texte n'est pas l'extraction de données. Un outil qui lit bien les mots peut encore manquer les informations non textuelles qui portent la moitié du sens de vos formulaires — les coches, les boutons radio, les signatures, les tampons, les champs barrés. Le critère qui compte n'est pas la précision de la reconnaissance optique de caractères (OCR). C'est de savoir si le tableau de sortie — ce que vous utilisez réellement — est correct sans que vous ayez à revérifier chaque cellule.
Cette distinction sépare les outils conçus pour la numérisation de documents de ceux conçus pour l'extraction de données. La case à cocher est le canari. Si un outil la gère de manière fiable — sur des mises en page variées, mélangée à de l'écriture manuscrite, à l'échelle du traitement par lots — il gère probablement aussi correctement le reste de vos données de formulaire. Si ce n'est pas le cas, vous faites encore de la saisie manuelle. Juste avec un logiciel plus esthétique.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.