Por qué la IA lee tu escritura a la perfección
pero aún no detecta una casilla marcada
Un desarrollador en el foro de OpenAI pasó tres semanas construyendo un flujo de procesamiento de solicitudes de préstamo. La IA extrajo todos los campos manuscritos — nombres de solicitantes, direcciones de propiedades, montos de préstamos — con una precisión casi perfecta. Luego llegó la sección de casillas: «Ocupación: Residencia principal / Segunda vivienda / Propiedad de inversión». El modelo no devolvió nada. Tres botones de opción, claramente visibles, uno marcado. GPT-4 Vision los miró y no vio ninguna selección. Un hilo que documenta esta misma dificultad atrajo a decenas de desarrolladores enfrentando el mismo muro: su IA podía leer la letra de un médico, pero no podía decir si una casilla tenía una marca.
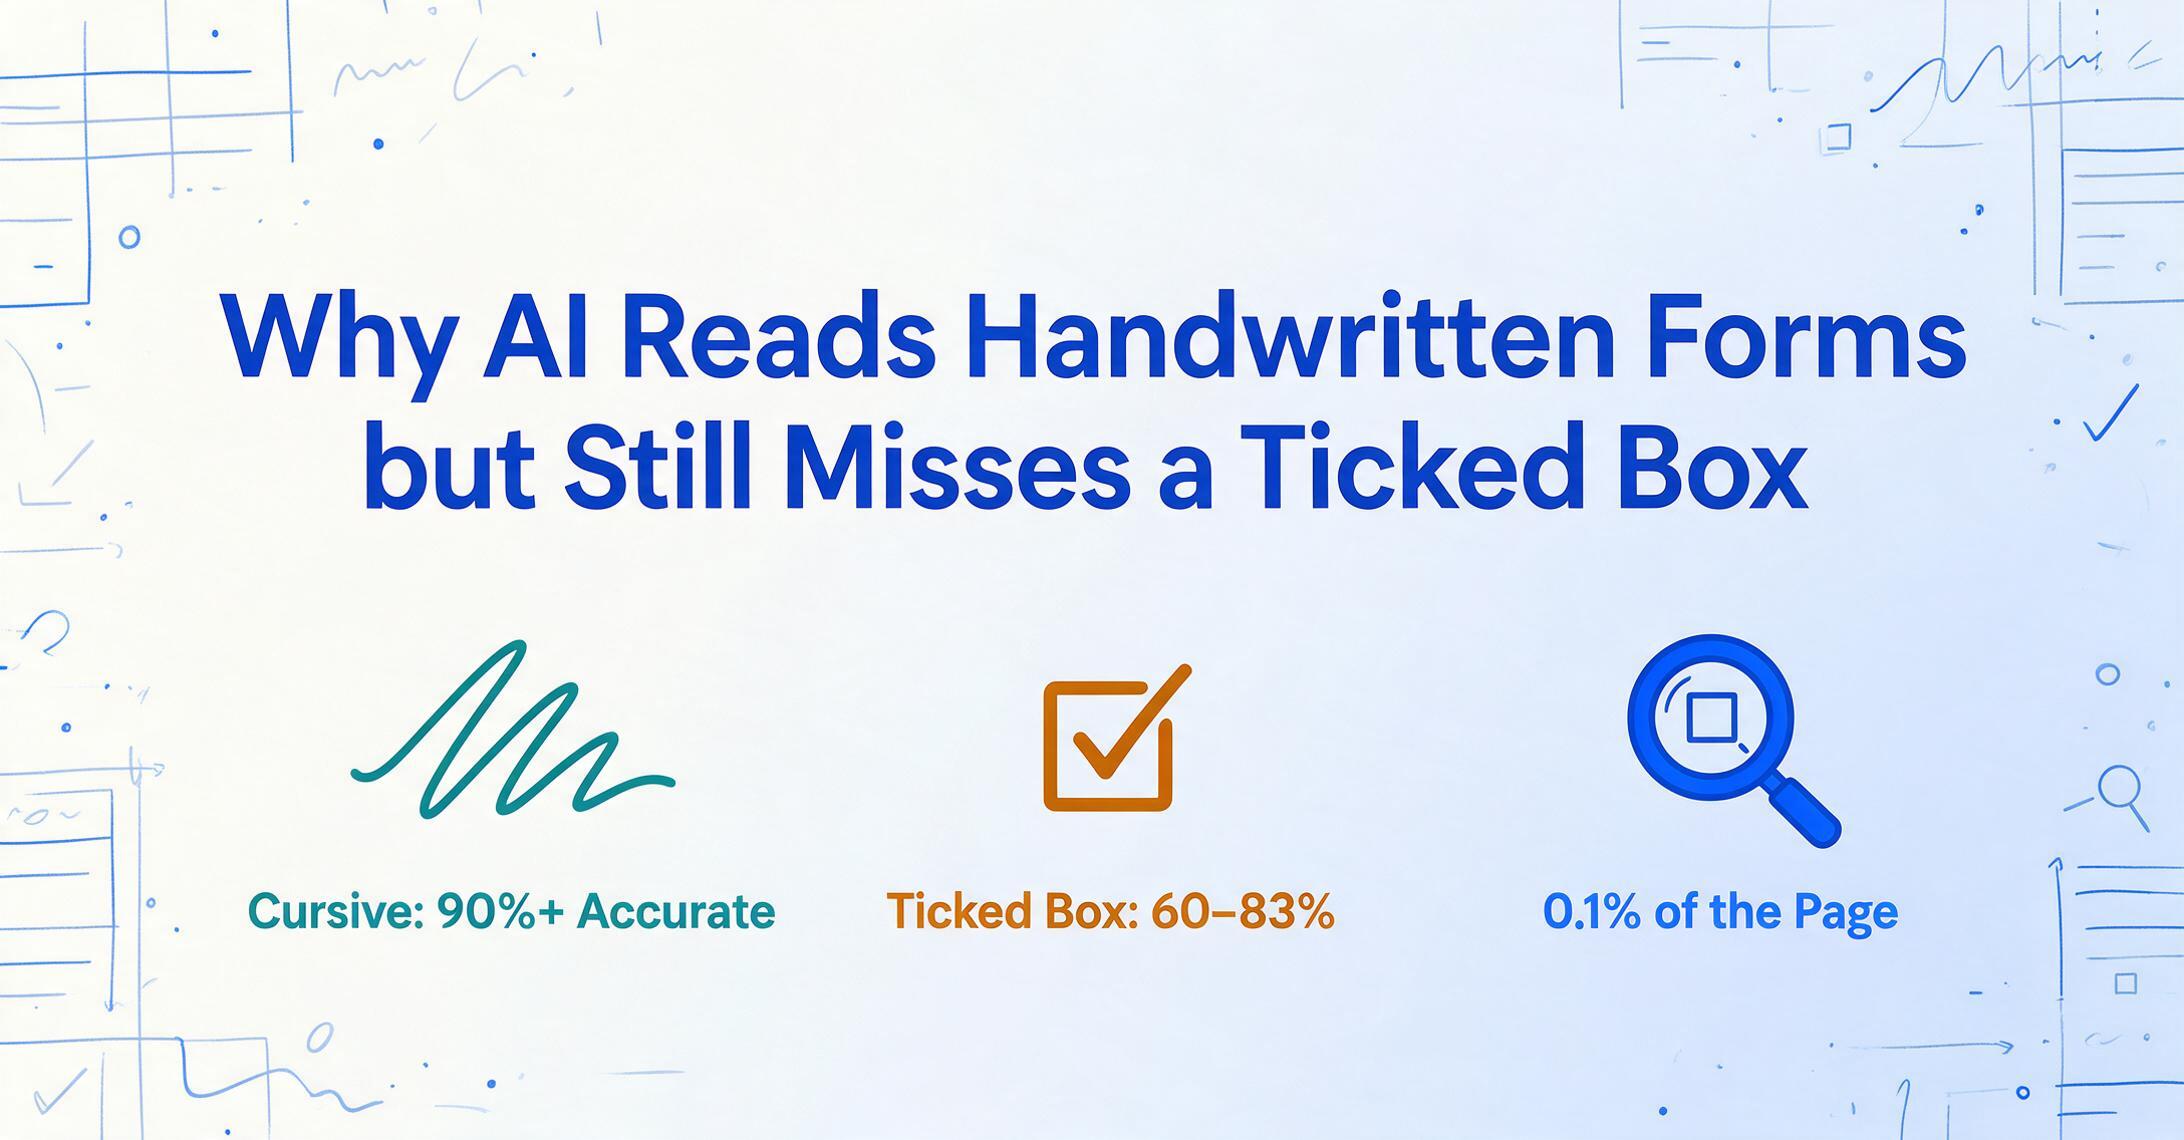
No es casualidad. Un estudio comparativo de 2025 de Snowflake Research probó ocho modelos de lenguaje visual líderes en tareas de interpretación de casillas de verificación. El mejor modelo obtuvo un 83,2%, frente al 97,5% de los humanos: una brecha lo suficientemente amplia como para que todos los modelos de vanguardia se queden cortos en el procesamiento directo de formularios con muchas casillas. (Para el desglose completo de precisión por tipo de marca — bolígrafo vs lápiz vs marcas ambiguas — consulta nuestra guía de precisión de casillas de verificación). La diferencia entre "leer bien la escritura manuscrita" y "leer casillas de verificación de forma fiable" no es pequeña: es la diferencia entre confiar en tu automatización y tener que revisar cada resultado a mano.
Esta paradoja — el texto es fácil, las marcas son difíciles — define el estado actual de la IA de procesamiento de formularios. Y entender por qué existe es la clave para elegir herramientas que funcionen de verdad con los formularios que necesitas procesar, no solo con las demos que te enseñan.
Por qué tu OCR lee cada palabra — e ignora cada casilla de verificación
Para entender el problema de las casillas, necesitas entender qué ocurre dentro de un pipeline de OCR tradicional — y dónde se pierde la información visual.
El reconocimiento óptico de caracteres funciona escaneando una página, detectando regiones de texto y convirtiendo patrones de píxeles en códigos de caracteres. Una "W" en un documento escaneado es una disposición específica de píxeles oscuros y claros; el motor de OCR compara ese patrón con una forma de letra conocida. Esto funciona razonablemente bien para texto impreso y, con los motores de OCR modernos basados en aprendizaje profundo, cada vez mejor para la escritura manuscrita.
Pero aquí está el fallo crítico: el OCR ve una casilla con una marca — y no tiene ningún carácter al que asignarla. Una marca no es una "V" ni es un "✓" en ningún juego de caracteres que el motor reconozca. El OCR o la omite por completo o genera basura: un símbolo aleatorio, una cadena vacía, un carácter malinterpretado.
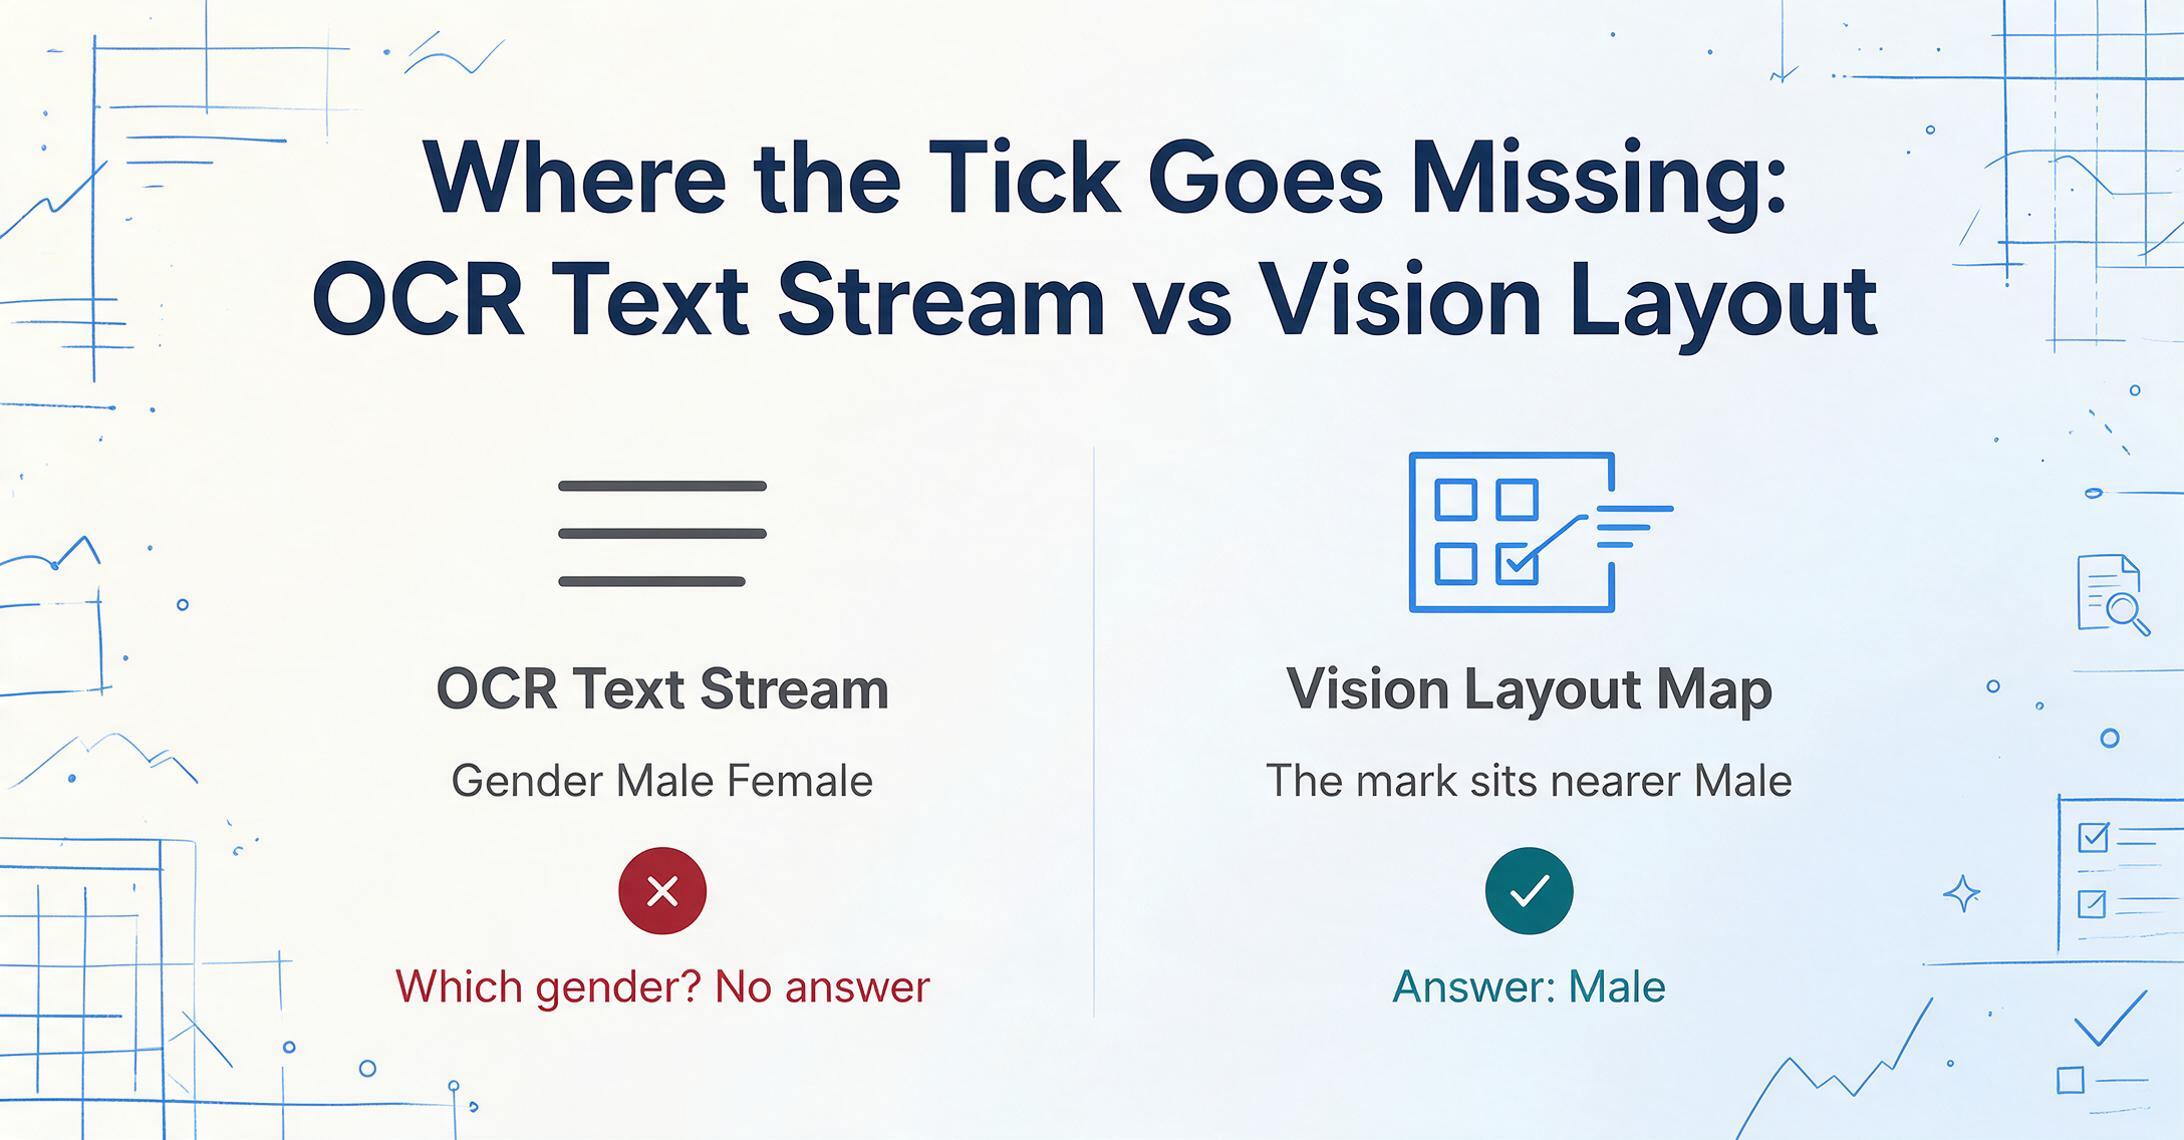
Incluso cuando el OCR captura la marca como algo, se pierde la relación espacial entre la marca y su etiqueta. El pipeline genera un flujo de texto plano: "Género Masculino Femenino Edad 34 Grupo Sanguíneo A+." ¿Qué género se seleccionó? El flujo no da ninguna indicación. El diseño visual — el hecho de que una marca esté más cerca de "Masculino" que de "Femenino" — se descartó en el momento en que el OCR convirtió la página en texto. Por eso un enfoque basado en OCR para el procesamiento de formularios falla sistemáticamente con las casillas de verificación, los botones de opción y cualquier formato de datos donde la posición tiene significado.
Cómo la IA de visión lee la página completa, no solo el texto que contiene
Los modelos de lenguaje visual (VLM), la clase de IA que impulsa las herramientas modernas de extracción de documentos, cambian el enfoque de forma fundamental. En lugar de convertir la imagen en texto y luego razonar sobre el texto, un VLM procesa la imagen del documento directamente. Ve el diseño, las relaciones espaciales, los gestos visuales. Cuando le preguntas «¿qué casilla está marcada?», mira la página como lo haría una persona: localizando cada casilla, examinando si contiene una marca y asociando esa marca con el texto de la etiqueta más cercana.
Este enfoque visual primero es lo que hace posible procesar formularios manuscritos en absoluto. Un VLM no necesita que la marca de verificación sea un carácter; solo necesita reconocer «hay tinta dentro de esta región rectangular» frente a «esta región está vacía». El modelo aprende esta distinción a partir de datos de entrenamiento que incluyen millones de imágenes de documentos con anotaciones sobre qué campos están completados y cuáles no.
Pero —y esta es la parte que la mayoría de las páginas de producto omiten— los VLM no son tan buenos en esto como cabría esperar. Los modelos de frontera que leen cursiva con una precisión superior al 90% suelen obtener puntuaciones en el rango del 60-83% en la interpretación pura de casillas, e incluso el mejor modelo probado en el benchmark CheckboxQA sigue estando 14 puntos por detrás del rendimiento humano.
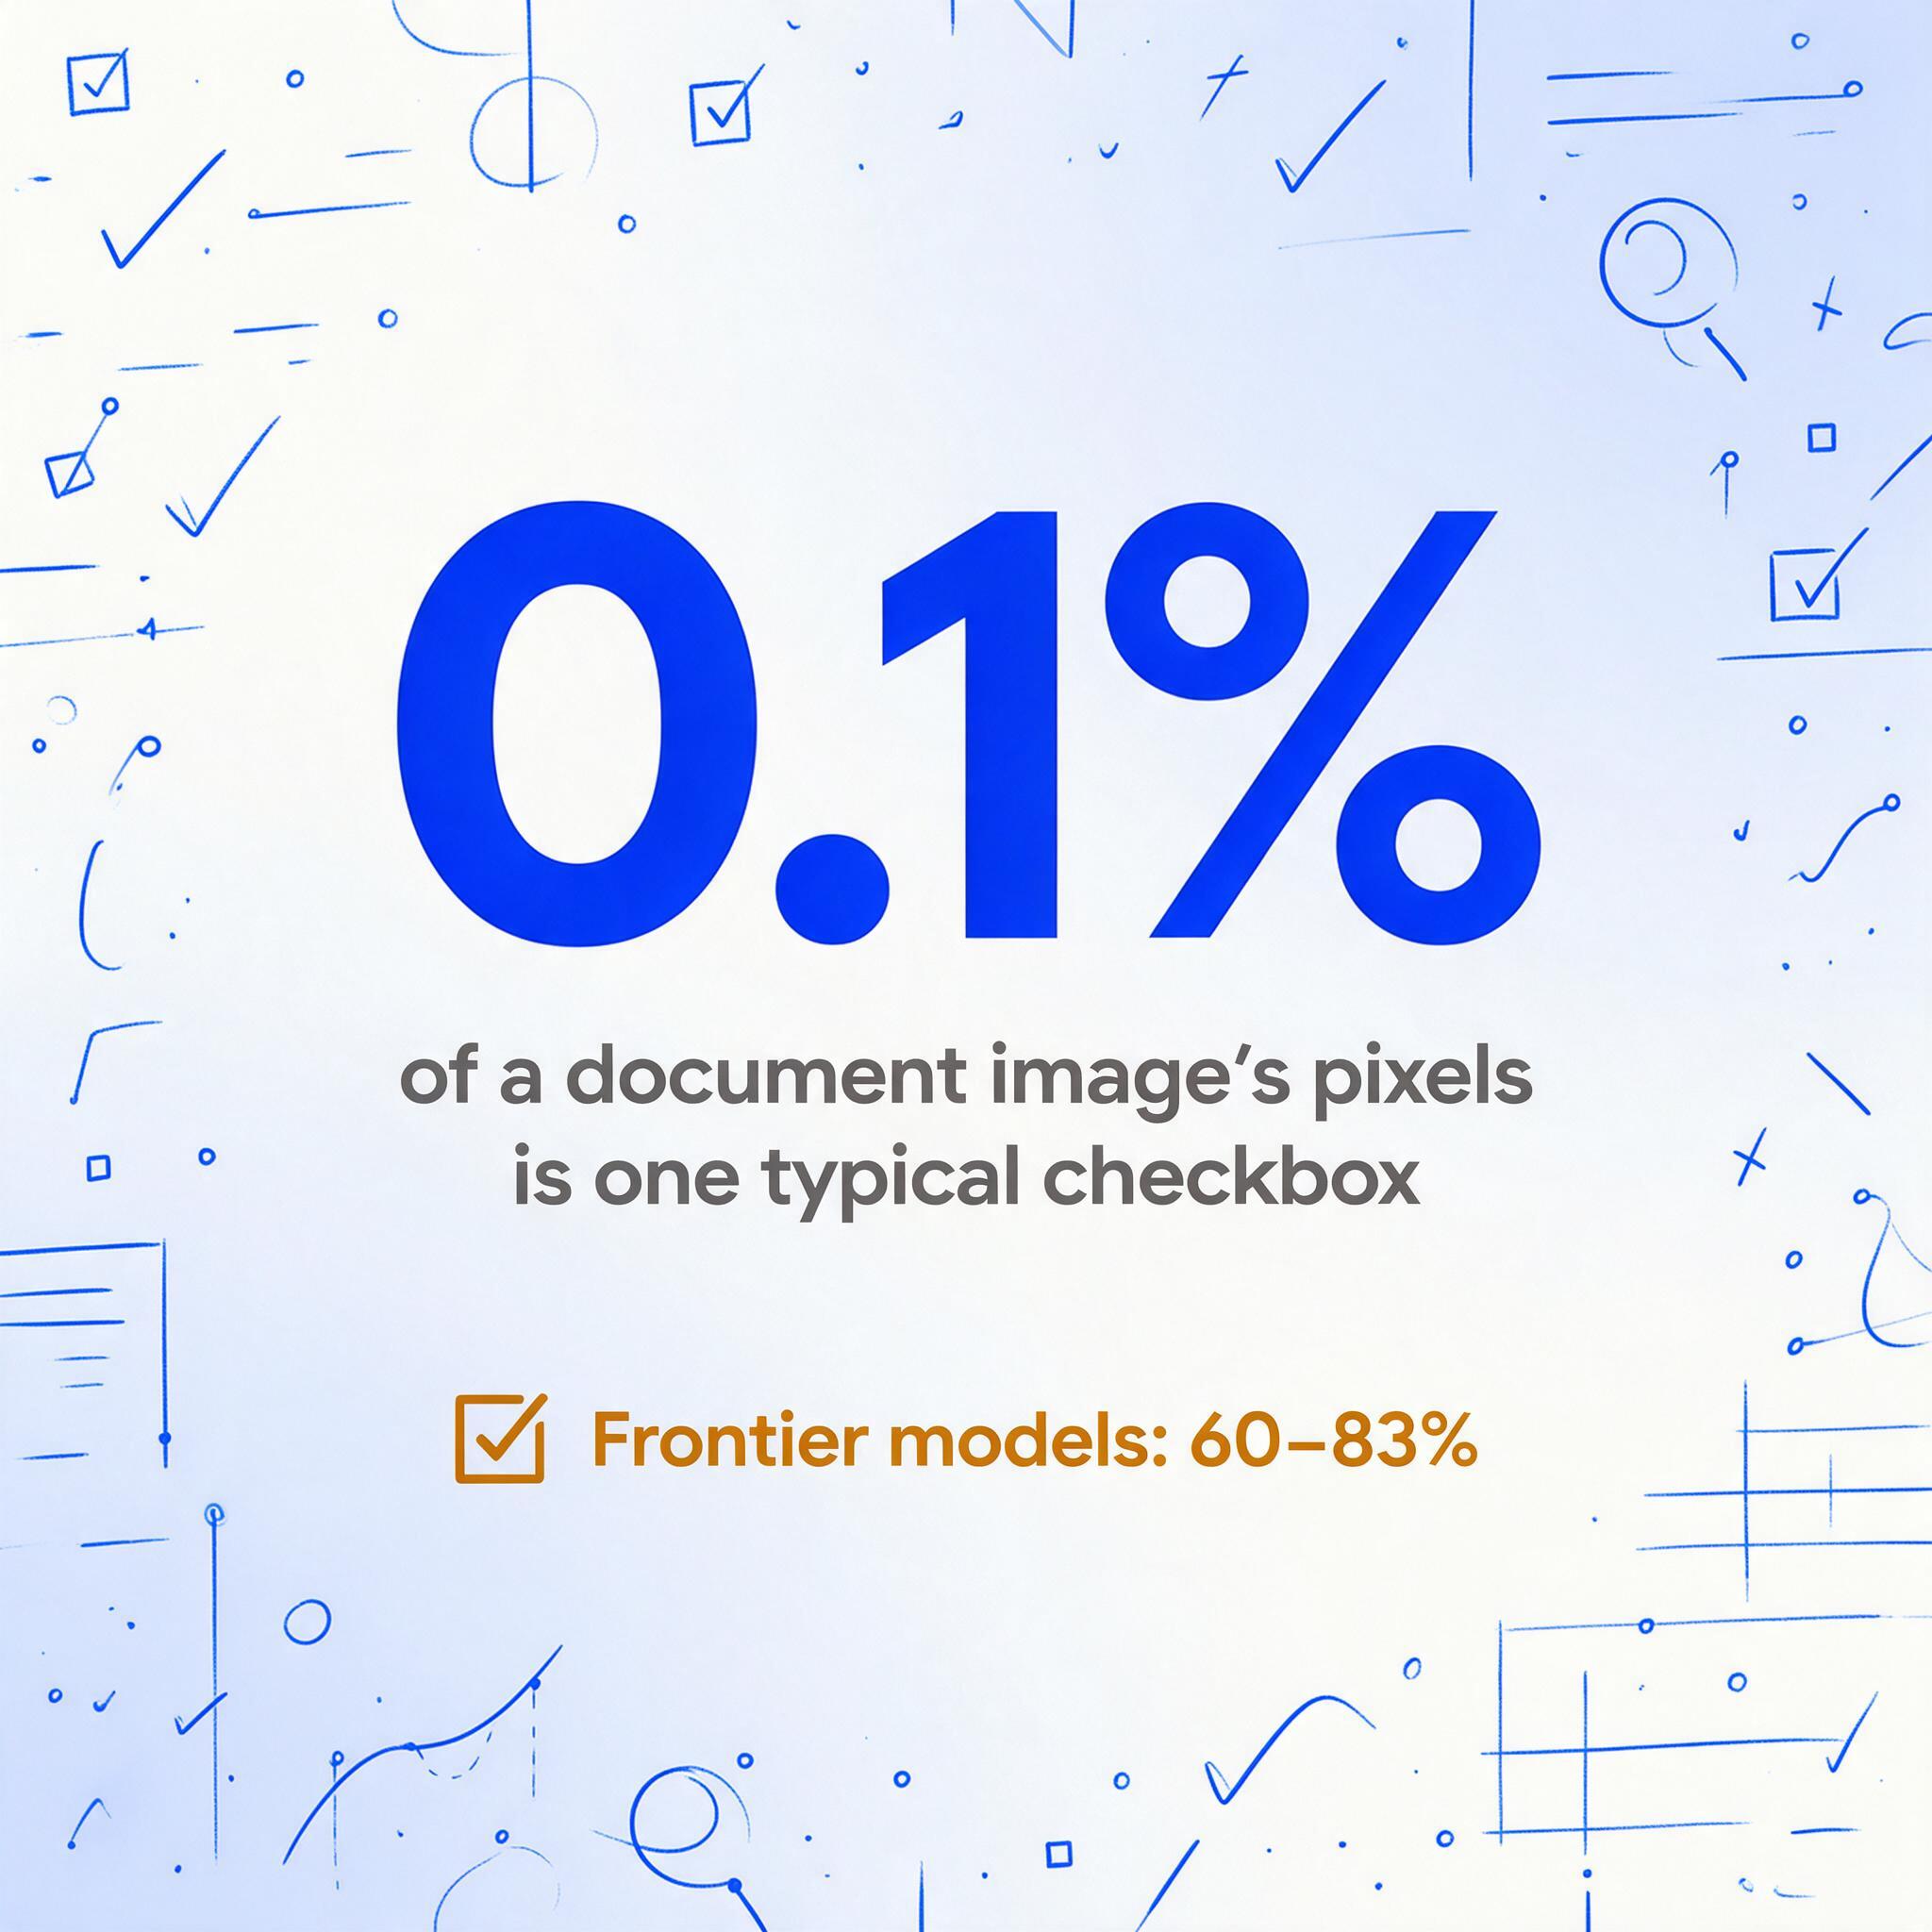
La dificultad principal no es que los VLM no puedan ver las casillas. Es que la señal visual es extremadamente sutil en comparación con todo lo demás en la página. Una casilla típica ocupa aproximadamente el 0.1% de los píxeles de la imagen de un documento. La diferencia entre «marcada» y «sin marcar» puede ser una línea fina de tinta en un cuadrado de 12 píxeles. Cuando el modelo también procesa párrafos de texto denso, estructuras de tablas, logotipos y etiquetas de formularios, esa pequeña señal compite por la atención —y a veces pierde.
Cinco formas en que la IA se equivoca con las casillas de verificación, incluso cuando todo lo demás está bien
Los investigadores de CheckboxQA catalogaron patrones de fallo específicos que se repiten en todos los modelos que probaron. Entenderlos no es algo académico: te dice qué vigilar cuando evalúas cualquier herramienta de procesamiento de formularios.
Fallo n.º 1: Intercambiar la casilla y la etiqueta
En muchos formularios, la casilla está a la izquierda de su texto de etiqueta. En otros, está a la derecha. El modelo a veces asigna una casilla del lado izquierdo a la etiqueta de su derecha, y una casilla del lado derecho a la siguiente etiqueta, intercambiando efectivamente qué opción está marcada. Es un error de asociación espacial, no de detección: el modelo vio la marca, pero la emparejó con el texto equivocado.
Fallo n.º 2: Confiar más en el texto que en la visión
Cuando un formulario pregunta «¿Se requiere una tarea adicional?» con casillas de Sí/No, algunos modelos responden basándose en el contexto del texto circundante en lugar de comprobar qué casilla está realmente marcada. Se decantan por el razonamiento lingüístico —«esta descripción de tarea suena compleja, así que probablemente Sí»— en lugar de realizar la inspección visual que la pregunta requiere. Esto es especialmente peligroso porque la respuesta parece plausible incluso cuando es incorrecta.
Fallo n.º 3: Listar todas las opciones
En escenarios de selección múltiple —«¿Qué categorías de vehículos se indican como aplicables?»— los modelos a veces devuelven todas las opciones como marcadas, incluso cuando solo un subconjunto está marcado. El modelo reconoce el conjunto de respuestas posibles a partir del texto, pero no filtra según el estado visual.
Fallo n.º 4: Perder casillas en tablas
Cuando las casillas aparecen dentro de celdas de tabla —algo común en listas de verificación de inspección y formularios de cumplimiento—, la estructura tabular circundante puede distraer al modelo. Las líneas de la cuadrícula, los valores de las celdas adyacentes y los encabezados de columna compiten por la atención, y el estado de la casilla se pierde en el ruido visual.
Fallo n.º 5: Devolver símbolos en lugar de respuestas
Algunos modelos responden a preguntas de casillas con marcas literales: generan «✓» o «X» en lugar de una respuesta textual como «Marcado» o el texto de la etiqueta. Puede parecer menor, pero cuando envías los resultados de extracción a una base de datos u hoja de cálculo, un carácter ✓ donde esperabas «Residencia principal» rompe el flujo de datos.
Estos fallos no se distribuyen de manera uniforme. Los formularios con casillas limpias y bien espaciadas y diseños simples obtienen mejor precisión que los formularios densos de varias columnas con casillas pequeñas. Pero el hallazgo constante en la investigación es que ningún modelo es lo bastante fiable como para ejecutar la extracción de casillas sin verificación — y los modelos que mejor rinden en tareas documentales generales no son necesariamente los mejores en tareas específicas de casillas. La composición de los datos de entrenamiento importa más que el tamaño del modelo.
El giro de la escritura a mano: por qué el texto garabateado se volvió el problema más fácil
Si le hubieras preguntado a un ingeniero de procesamiento de documentos en 2018 cuál era el elemento más difícil de extraer de un formulario, habría dicho la escritura a mano, sin dudarlo. Estilos variables, conexiones cursivas, espaciado inconsistente, mayúsculas y minúsculas mezcladas. El reconocimiento de escritura a mano era el desafío principal.
En 2026, esa jerarquía se ha invertido. Los modelos de lenguaje visual modernos son notablemente buenos leyendo escritura a mano porque la escritura a mano, en esencia, sigue siendo un problema de texto. Incluso la cursiva descuidada sigue los patrones estadísticos del lenguaje escrito: probabilidades de secuencia de letras, límites de palabras, expectativas contextuales. Un VLM puede usar su comprensión del lenguaje para llenar vacíos: si lee "P_tient N_me" en un formulario médico bajo "Patient Name", puede inferir las letras faltantes a partir del contexto.
Las casillas de verificación no tienen esa red de seguridad contextual. El estado de una casilla —marcada o desmarcada— es puramente visual. No hay señal lingüística a la que recurrir cuando el componente de visión es incierto. Si el modelo no puede ver claramente si hay tinta en un rectángulo pequeño, tiene que adivinar. Y en los modelos de lenguaje, una suposición tiende a decantarse por el patrón más común en los datos de entrenamiento —a menudo "desmarcada", que es estadísticamente más frecuente en la mayoría de los formularios—, lo que genera falsos negativos sistemáticos.
Un usuario de Stack Overflow que revisó su pregunta de hace una década sobre el escaneo de casillas capturó la frustración: su IA leía las palabras escritas con precisión, pero las casillas solo acertaban alrededor del 80% de las veces, y nadie podía explicar el otro 20%. Ese 80% suena aceptable hasta que procesas 200 formularios. Cuarenta formularios con al menos un error. Cuarenta formularios que tienes que revisar manualmente.
Cómo procesar formularios con casillas a Excel — sin perder las marcas
La investigación deja una cosa clara: no puedes lanzar una imagen de formulario en bruto a una IA genérica y esperar una extracción perfecta de casillas. Pero puedes construir un flujo de trabajo que te lleve allí. La diferencia está en cómo se instruye a la IA — y en lo que ocurre a su alrededor.
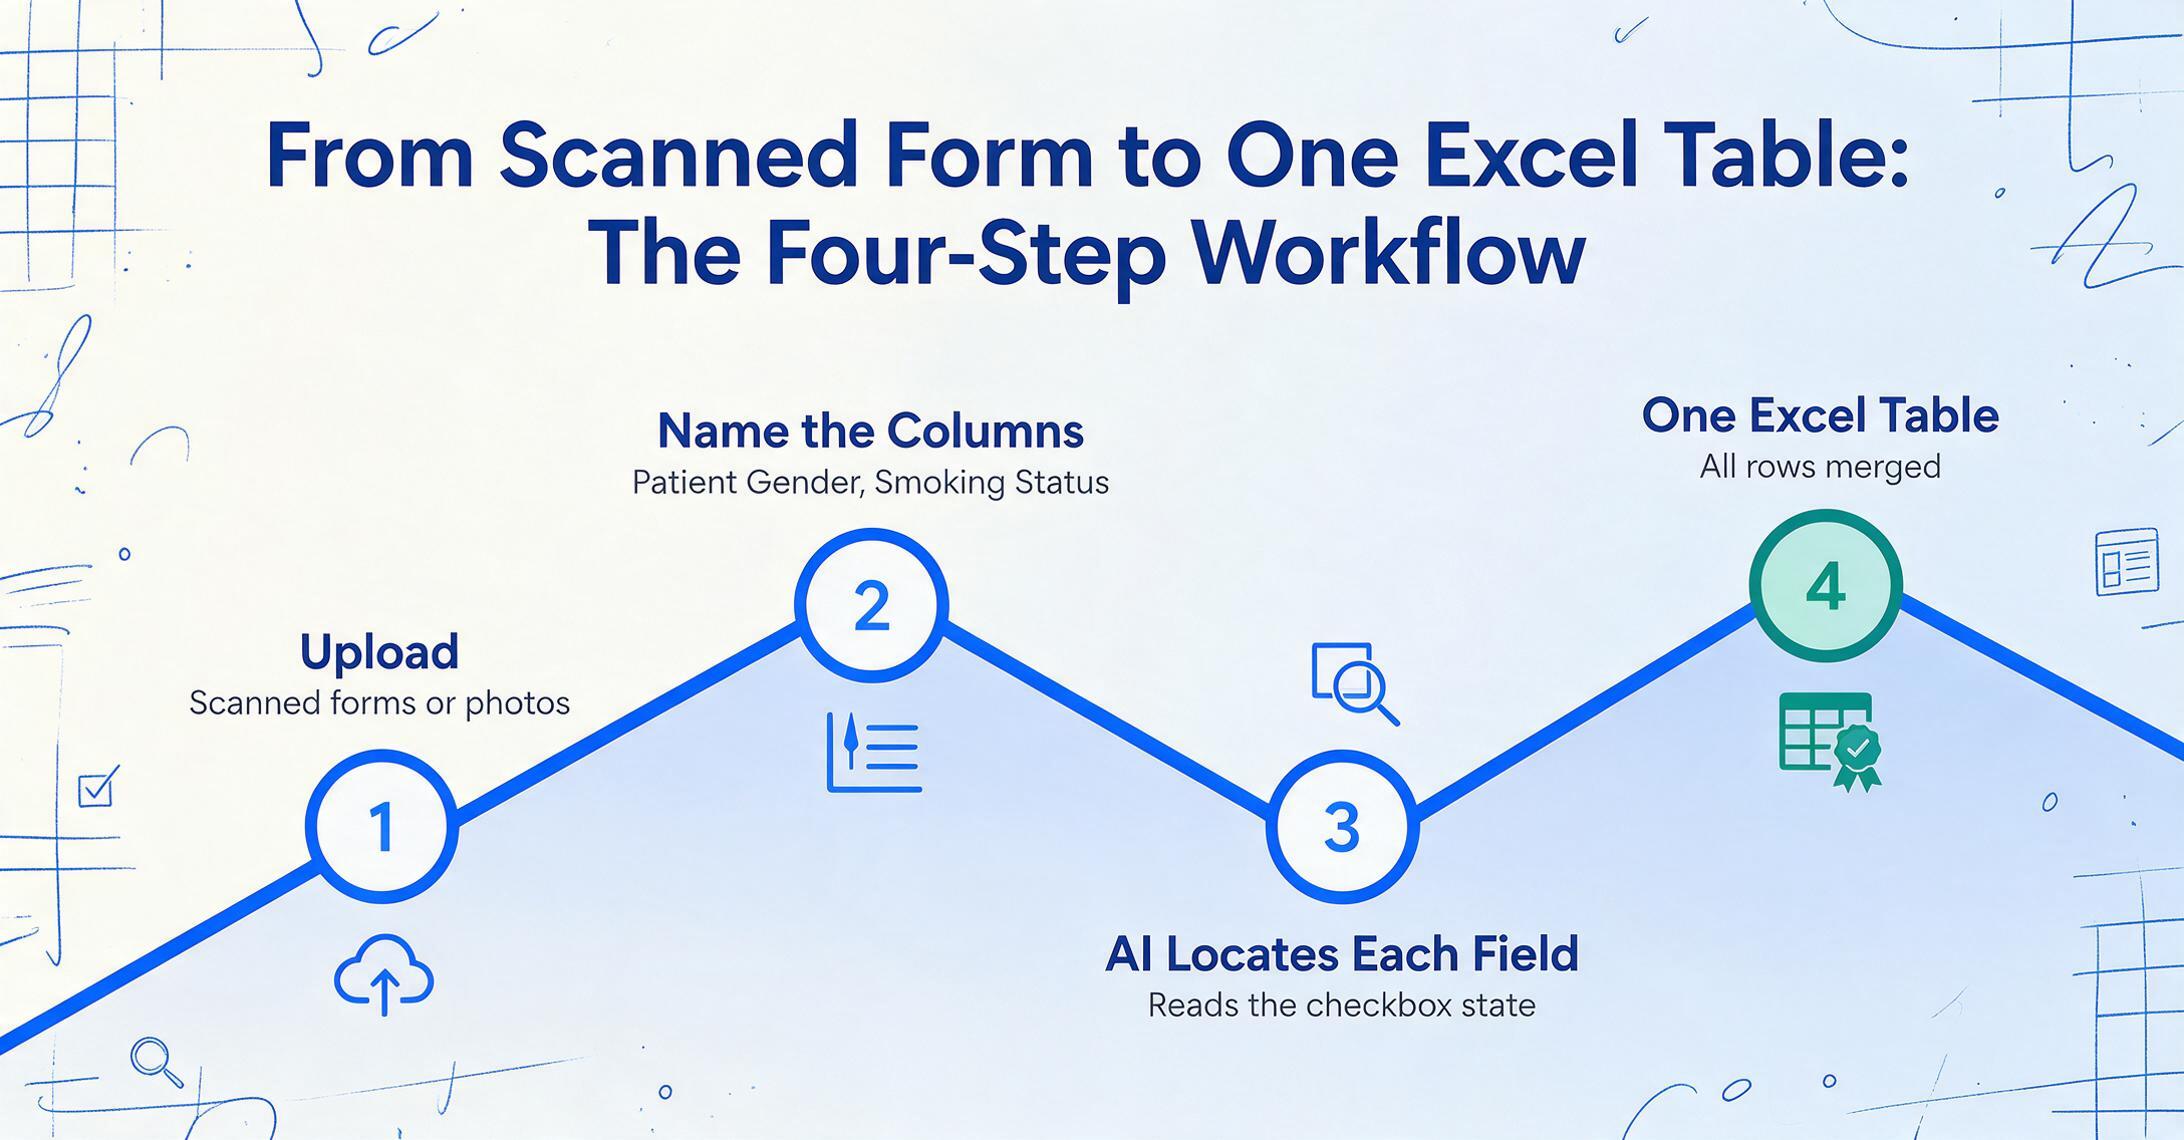
El enfoque moderno más eficaz utiliza la Extracción de Columnas Personalizadas: en lugar de pedirle a la IA que "lea todo en este formulario", defines exactamente qué campos quieres. Escribes los nombres de las columnas —"Patient Gender", "Smoking Status", "Allergies (Checked)"— y la IA busca cada campo en el documento, localiza su casilla o valor de texto, y devuelve el resultado. Esto es fundamentalmente diferente de las herramientas basadas en plantillas donde dibujas recuadros alrededor de cada campo en un formulario maestro. Tú defines la salida que quieres; la IA averigua dónde están los datos en cualquier diseño.
El enfoque de «definir tu salida» es clave para las casillas de verificación porque le da a la IA un objetivo claro. En lugar de preguntar de forma abierta «¿qué está marcado?», preguntas «para el campo etiquetado como "Método de contacto preferido", ¿está marcada la opción Teléfono, Correo electrónico o Correo postal?». El modelo no necesita averiguar qué elementos de la página son campos de casillas: busca el texto de la etiqueta que especificaste y luego examina la región visual alrededor para detectar una casilla marcada o sin marcar.
Para un solo formulario, esto ahorra minutos. Para un lote de formularios procesados juntos, el procesamiento por lotes combina todos los resultados en una sola hoja de cálculo: cada fila es un formulario, cada columna es un campo. Una pila de 200 formularios de admisión de pacientes se convierte en una tabla con 200 filas, lista para analizar, en aproximadamente el mismo tiempo que se tarda en procesar unos pocos formularios individualmente.
Tres Lugares Donde la Extracción de Casillas Cambia la Forma de Trabajar
La brecha entre leer texto y leer casillas no es teórica: se manifiesta en flujos de trabajo específicos donde los formularios combinan entradas manuscritas con campos marcables. Estos son los entornos donde la diferencia entre una herramienta capaz de leer casillas y un OCR solo de texto es la diferencia entre automatización completa y seguir necesitando a una persona en el proceso.
Formularios de Reclamaciones de Seguros
Los formularios de reclamaciones estandarizados como el CMS-1500 y el UB-04 contienen docenas de campos de casillas de verificación y botones de opción: códigos de servicio, indicadores de lugar de servicio, banderas de aceptación de asignación, punteros de diagnóstico. Una encuesta industrial de 2025 realizada por Parseur encontró que la entrada manual de datos cuesta a las empresas estadounidenses un promedio de $28,500 por empleado al año, y los trabajadores dedican más de nueve horas por semana a la transferencia repetitiva de datos de documentos a sistemas. Para los procesadores de reclamaciones de seguros, gran parte de ese tiempo se gasta en campos de casillas de verificación: entradas pequeñas que en conjunto consumen horas porque aparecen en cada formulario.
El mercado de IA en reclamaciones de seguros alcanzó los $514 millones en 2024 y se proyecta que crecerá a una tasa compuesta anual del 18.3% hasta los $2.76 mil millones para 2034. El crecimiento se debe en parte al reconocimiento de que la automatización de casillas de verificación y marcas de selección — no solo el OCR de campos impresos — es el cuello de botella que mantiene las tasas de procesamiento directo por debajo de lo que las aseguradoras quieren.
Formularios de Admisión Médica e Historial del Paciente
Los formularios de admisión de pacientes están densamente llenos de casillas de verificación por diseño. Listas de verificación de síntomas ("Marque todo lo que aplique"), declaraciones de medicamentos, cuadrículas de sí/no de historial familiar, confirmaciones de consentimiento — un solo paquete de paciente nuevo puede contener más de 50 campos de casillas de verificación junto con entradas manuscritas para instrucciones de dosificación, notas de alergias y líneas de firma. El problema es que las casillas de verificación son donde los modos de falla de detección de casillas golpean más fuerte: un paciente que circula "Ninguna de las anteriores" en una lista de alergias, o una marca tenue de lápiz en un formulario de consentimiento, produce un campo que una IA genérica podría devolver como no marcado — eliminando silenciosamente una respuesta clínicamente relevante a la columna de "no". La escritura a mano en las secciones de texto libre generalmente se extrae bien; son las selecciones binarias las que necesitan un flujo de trabajo diseñado en torno a la verificación.
Listas de Verificación de Inspección y Cumplimiento
Inspecciones de seguridad en obras, informes de condición de propiedades, listas de verificación de control de calidad, registros de mantenimiento de equipos — estos son fundamentalmente documentos de casillas. Un inspector de campo recorre un sitio, marca elementos en un formulario en papel y garabatea notas junto a cualquier problema. Los datos de las casillas (¿qué elementos pasaron? ¿cuáles fallaron?) son el resultado principal. Las notas manuscritas son contexto. Pero el procesamiento manual trata ambos por igual: alguien tiene que revisar cada casilla, cada nota, y escribirlas en una hoja de cálculo.
El volumen se acumula rápidamente — un programa de inspección semanal en varios sitios genera cientos de campos de casillas por semana, y cada uno es una decisión binaria de la que depende el informe de cumplimiento. Automatizar esto con una herramienta de extracción de formularios que pueda distinguir entre marcado y no marcado mientras también captura las notas manuscritas convierte una tarea semanal de varias horas en un trabajo por lotes de minutos — pero solo funciona si se verifica el manejo de casillas de la herramienta, porque una lectura errónea de "inseguro" es peor que no tener datos.
Preguntas Frecuentes
¿Puede la IA distinguir de manera confiable entre una marca de verificación (✓), una cruz (X) y un círculo relleno?
Los modelos de lenguaje visual (VLM) modernos pueden distinguir estos tipos de marcas con una precisión razonable — el mayor desafío no es la clasificación del tipo de marca, sino la detección de la presencia de la marca. Una marca de lápiz tenue, una marca parcial que se extiende más allá del límite de la casilla, o una casilla ligeramente sombreada en lugar de marcada explícitamente crean señales visuales ambiguas. El modelo puede clasificar con confianza una "✓" claramente visible como "marcada" pero pasar por alto una línea de lápiz ligera que un humano interpretaría como una marca. Si tus formularios tienen estilos de marcado inconsistentes, espera algunos casos límite que necesiten revisión humana.
¿Cuál es la diferencia entre detección de casillas e interpretación de casillas?
La detección es "¿hay una marca en esta casilla?" La interpretación es "¿qué significa esta marca en el contexto de este formulario?" Una casilla marcada junto a "Rechazar Cobertura" significa algo muy diferente de una casilla marcada junto a "Aceptar Términos." La detección es una tarea visual; la interpretación requiere leer y comprender el texto de la etiqueta, las instrucciones del formulario y, a veces, la relación entre múltiples casillas (por ejemplo, botones de opción mutuamente excluyentes vs. casillas de selección múltiple). Las buenas herramientas de procesamiento de formularios manejan ambas capas — y la capa de interpretación es donde la comprensión del lenguaje se vuelve esencial.
¿La extracción de casillas funciona en formularios manuscritos o solo en los impresos?
Funciona en ambos, pero la precisión varía. Los formularios impresos con casillas bien delimitadas y marcas oscuras son el caso más fácil. Los formularios manuscritos añaden dos variables: la escritura que llena los campos de texto (que los modelos de lenguaje visual manejan bien hoy en día) y las marcas manuscritas dentro de las casillas, que pueden ser garabatos, tachaduras, círculos o rellenos parciales. Un modelo de lenguaje visual que lee el documento de forma integral maneja mejor los formularios mixtos (manuscrito y casillas) que un sistema que separa el reconocimiento óptico de caracteres (OCR) y la detección de casillas en pasos desconectados, porque el modelo de lenguaje visual no pierde información espacial entre etapas.
¿Cuántos formularios puedo procesar a la vez?
El procesamiento por lotes te permite subir varios formularios a la vez y recibir una única tabla de resultados combinada. El límite práctico depende de la arquitectura de la herramienta: algunas admiten docenas, otras cientos por lote. En ImageToTable.ai, la Extracción de Columnas Personalizadas funciona en lotes completos: defines tus columnas una vez, subes todos tus formularios, y los estados de las casillas y los valores de los campos de cada formulario se rellenan en las filas correspondientes de una sola hoja de cálculo. Sin configuración por formulario, sin plantilla por proveedor.
¿Qué precisión puedo esperar en la extracción de casillas?
En la interpretación pura de casillas —aislada del resto del formulario—, los mejores modelos de lenguaje visual evaluados en el benchmark CheckboxQA obtuvieron entre 60% y 83%, con el nivel humano en 97.5%. Pero en formularios reales, la precisión depende más del diseño del formulario y de la calidad de la marca que del modelo: las casillas grandes y bien separadas en escaneos limpios rinden mucho mejor que las casillas diminutas en fotos de baja resolución. Para el desglose por tipo de marca (casillas digitales, marcas de bolígrafo, lápiz, marcas ambiguas), consulta nuestra guía de precisión de casillas. El flujo de trabajo más fiable es la extracción automática con verificación por muestreo: la IA hace la mayor parte del trabajo y tú verificas una muestra para detectar casos límite, en lugar de revisar cada formulario individualmente.
La conclusión real no trata sobre casillas de verificación
El problema de las casillas de verificación revela una verdad más profunda sobre la IA documental: el reconocimiento de texto no es extracción de datos. Una herramienta que lee palabras bien podría perder la información no textual que lleva la mitad del significado en tus formularios: las marcas de verificación, las selecciones de botones de opción, las firmas, los sellos, los campos tachados. El punto de referencia que importa no es la precisión de caracteres del reconocimiento óptico de caracteres (OCR). Es si la tabla de salida — lo que realmente usas — es correcta sin que tengas que volver a verificar cada celda.
Esa distinción es lo que separa las herramientas diseñadas para escanear documentos de las construidas para extraer datos. La casilla de verificación es el canario. Si una herramienta la maneja de forma confiable — en varios diseños de formularios, mezclada con escritura a mano, a escala de lotes — es probable que también maneje correctamente el resto de los datos de tu formulario. Si no lo hace, sigues haciendo entrada manual de datos. Solo que con un software de mejor apariencia.
Los archivos se procesan de forma segura y no se almacenan.