AIがあなたの手書きを完璧に読めるのに
チェックボックスを見落とす理由
OpenAIフォーラムである開発者が、融資申請処理パイプラインの構築に3週間を費やしました。AIは手書きフィールドのすべて—借り手の氏名、物件住所、融資額—をほぼ完璧な精度で抽出しました。そしてチェックボックス欄に差し掛かったときです。「居住形態:自宅/セカンドホーム/投資用物件」。モデルは何も返しませんでした。3つのラジオボタンがはっきり見え、1つは記入済みでした。GPT-4 Visionはそれらを見て、選択がなされていないと判断しました。このまさに同じ問題を記録したスレッドには、同じ壁に直面した何十人もの開発者が集まりました。彼らのAIは医者の手書き文字は読めるのに、ボックスにチェックマークが入っているかどうかは判別できなかったのです。
これは偶然ではありません。Snowflake Researchによる2025年のベンチマーク調査では、チェックボックス解釈タスクにおいて8つの最先端の視覚言語モデルをテストしました。最高スコアのモデルは83.2%で、人間の97.5%に対して—チェックボックスが多いフォームでは、すべてのフロンティアモデルがストレートスルー処理に届かないほどの大きな差です。(マークの種類別—ペン、鉛筆、あいまいなマーク—の完全な精度の内訳については、チェックボックス精度ガイドをご覧ください。)「手書きをうまく読む」と「チェックボックスを確実に読む」の間のギャップは小さくありません—それは自動化を信頼することと、すべての出力を手作業で再確認することの違いです。
このパラドックス—テキストは簡単、チェックは難しい—が、フォーム処理AIの現状を定義しています。そして、それがなぜ存在するのかを理解することが、彼らが見せてくれるデモだけでなく、実際に処理が必要なフォームで機能するツールを選ぶ鍵となります。
OCRがすべての単語を読み取り、すべてのチェックボックスを無視する理由
チェックボックスの問題を理解するには、従来のOCRパイプラインの内部で何が起こっているか—そして、視覚情報がどこで失われるかを理解する必要があります。
光学文字認識(OCR)は、ページをスキャンし、テキスト領域を検出し、ピクセルパターンを文字コードに変換することで機能します。スキャンされた文書の「W」は、明暗ピクセルの特定の配置であり、OCRエンジンはそのパターンを既知の文字形状にマッチングします。これは印刷テキストではかなりうまく機能し、現代の深層学習ベースのOCRエンジンでは、手書きでもますますうまく機能します。
しかし、ここに重大な欠陥があります:OCRはチェックマークが付いたチェックボックスを見ても、マッピングする文字がありません。チェックマークは「V」でもなく、エンジンが認識するどの文字セットの「✓」でもありません。OCRはそれを完全にスキップするか、ランダムな記号、空の文字列、誤解釈された文字など、無意味な出力を生成します。
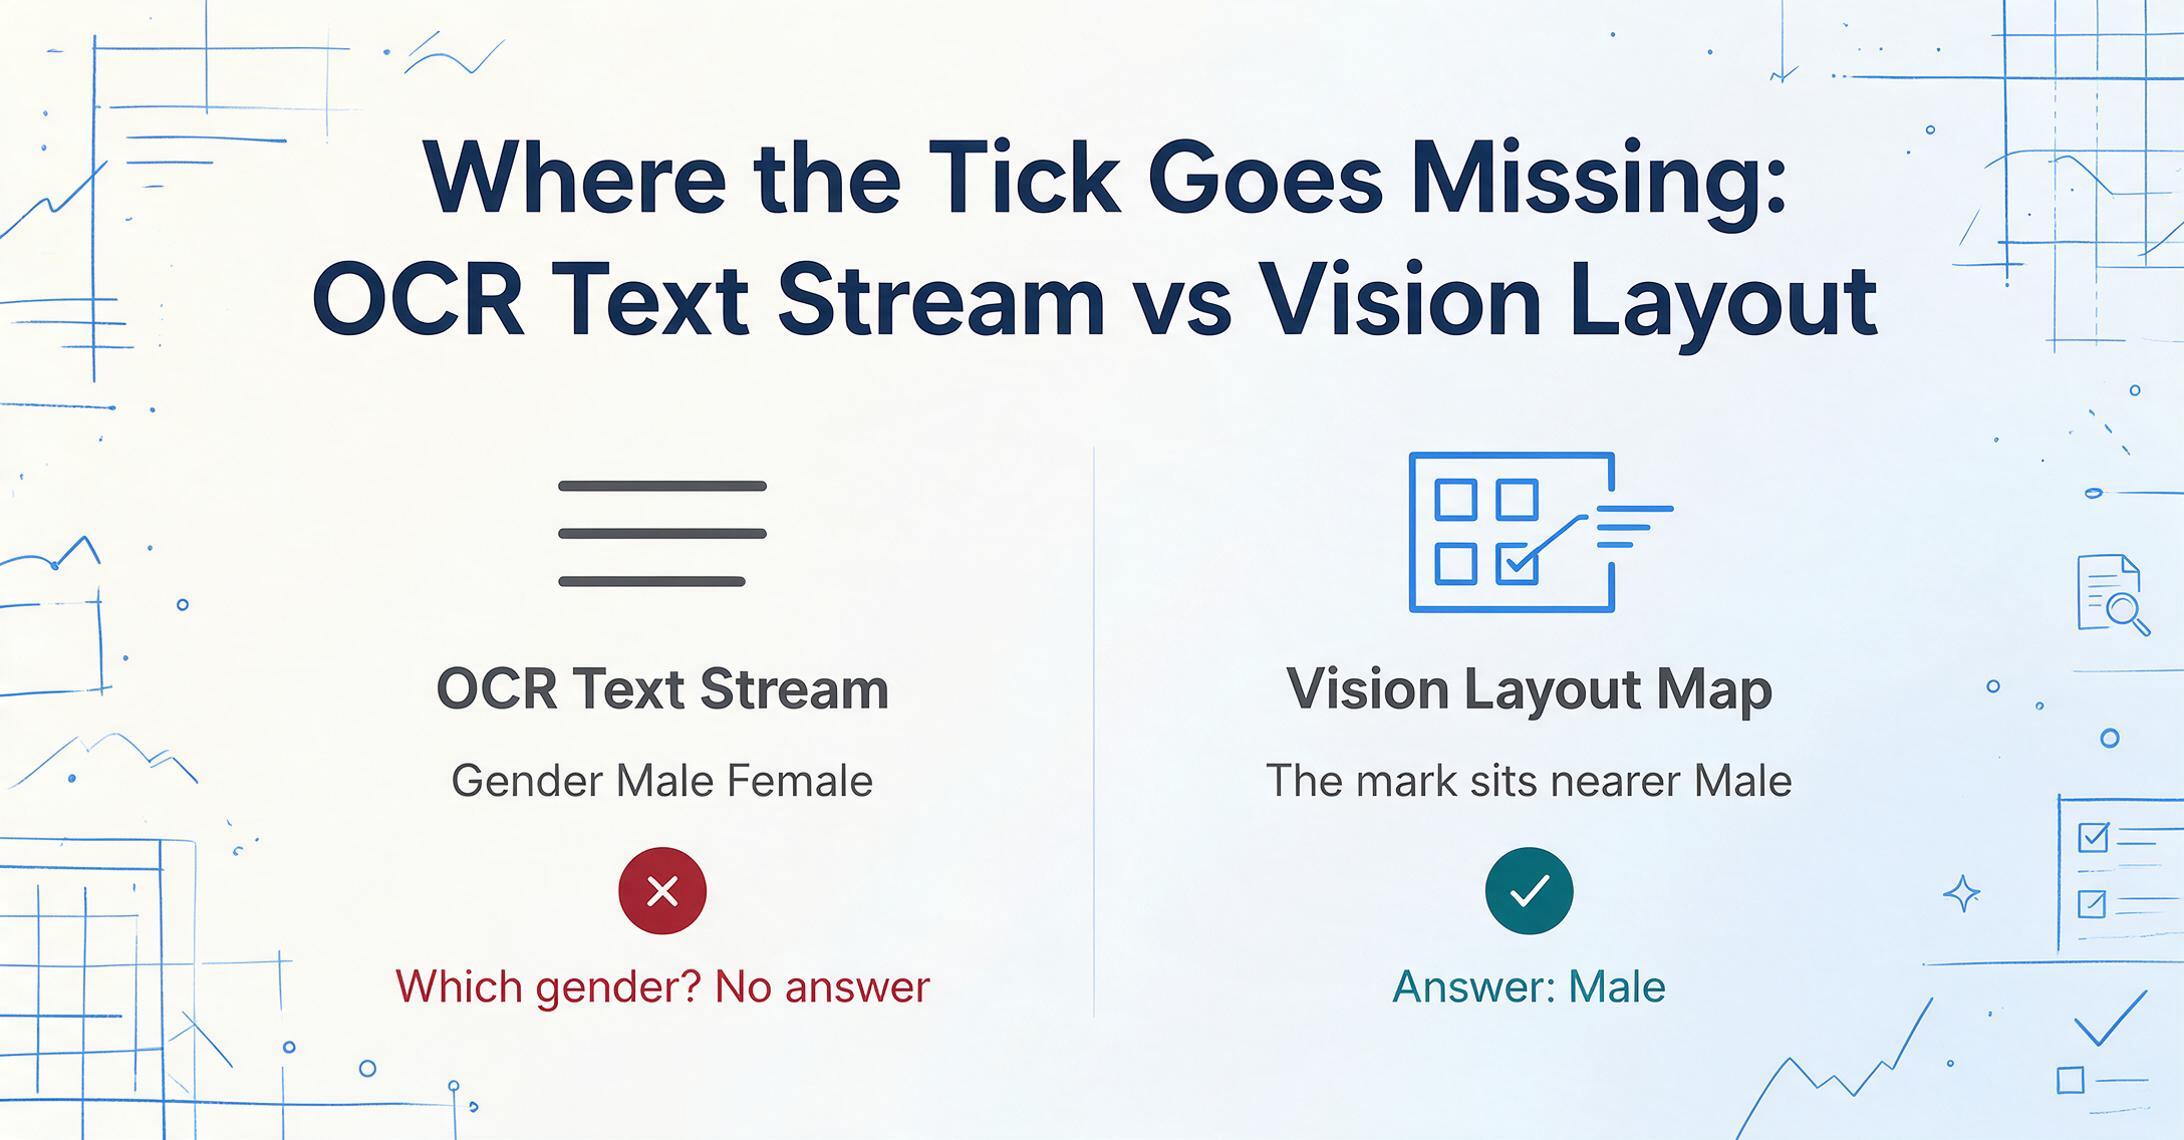
OCRがチェックマークを何かとして捉えたとしても、マークとそのラベルの間の空間的関係は失われます。パイプラインはフラットなテキストストリームを出力します:「性別 男性 女性 年齢 34 血液型 A+」。どの性別が選択されましたか?ストリームは何の手がかりも与えません。視覚的なレイアウト—マークが「女性」よりも「男性」に近いという事実—は、OCRがページをテキストに変換した瞬間に破棄されました。これが、OCRファーストのアプローチが、チェックボックス、ラジオボタン、そして位置が意味を持つあらゆるデータ形式で一貫して失敗する理由です。
Vision AIがページ全体をどう読むか — テキストだけではない
視覚言語モデル(VLM)— 現代の文書抽出ツールを支えるAIの一種 — は、そのアプローチを根本的に変えます。画像をテキストに変換してからそのテキストを推論する代わりに、VLMは文書画像を直接処理します。レイアウト、空間的な関係性、視覚的なジェスチャーを認識します。「どのチェックボックスにチェックが入っていますか?」と尋ねると、人間と同じようにページを見ます。各ボックスを特定し、マークが含まれているかを調べ、そのマークを最も近いラベルテキストに関連付けます。
この視覚ファーストのアプローチこそが、手書きフォームの処理を可能にするものです。VLMはチェックマークが文字である必要はありません。「この長方形の領域内にインクがある」か「この領域は空である」かを認識するだけでよいのです。モデルは、どのフィールドが記入済みでどのフィールドが未記入かという注釈が付いた何百万もの文書画像を含むトレーニングデータから、この区別を学習します。
しかし — ここがほとんどの製品ページが省略する部分ですが — VLMは期待されるほどこれに優れているわけではありません。筆記体を90%以上の精度で読むフロンティアモデルでも、純粋なチェックボックス解釈では60〜83%の範囲に留まることが多く、CheckboxQAベンチマークでテストされた最高のモデルでさえ、人間のパフォーマンスに14ポイント及びません。
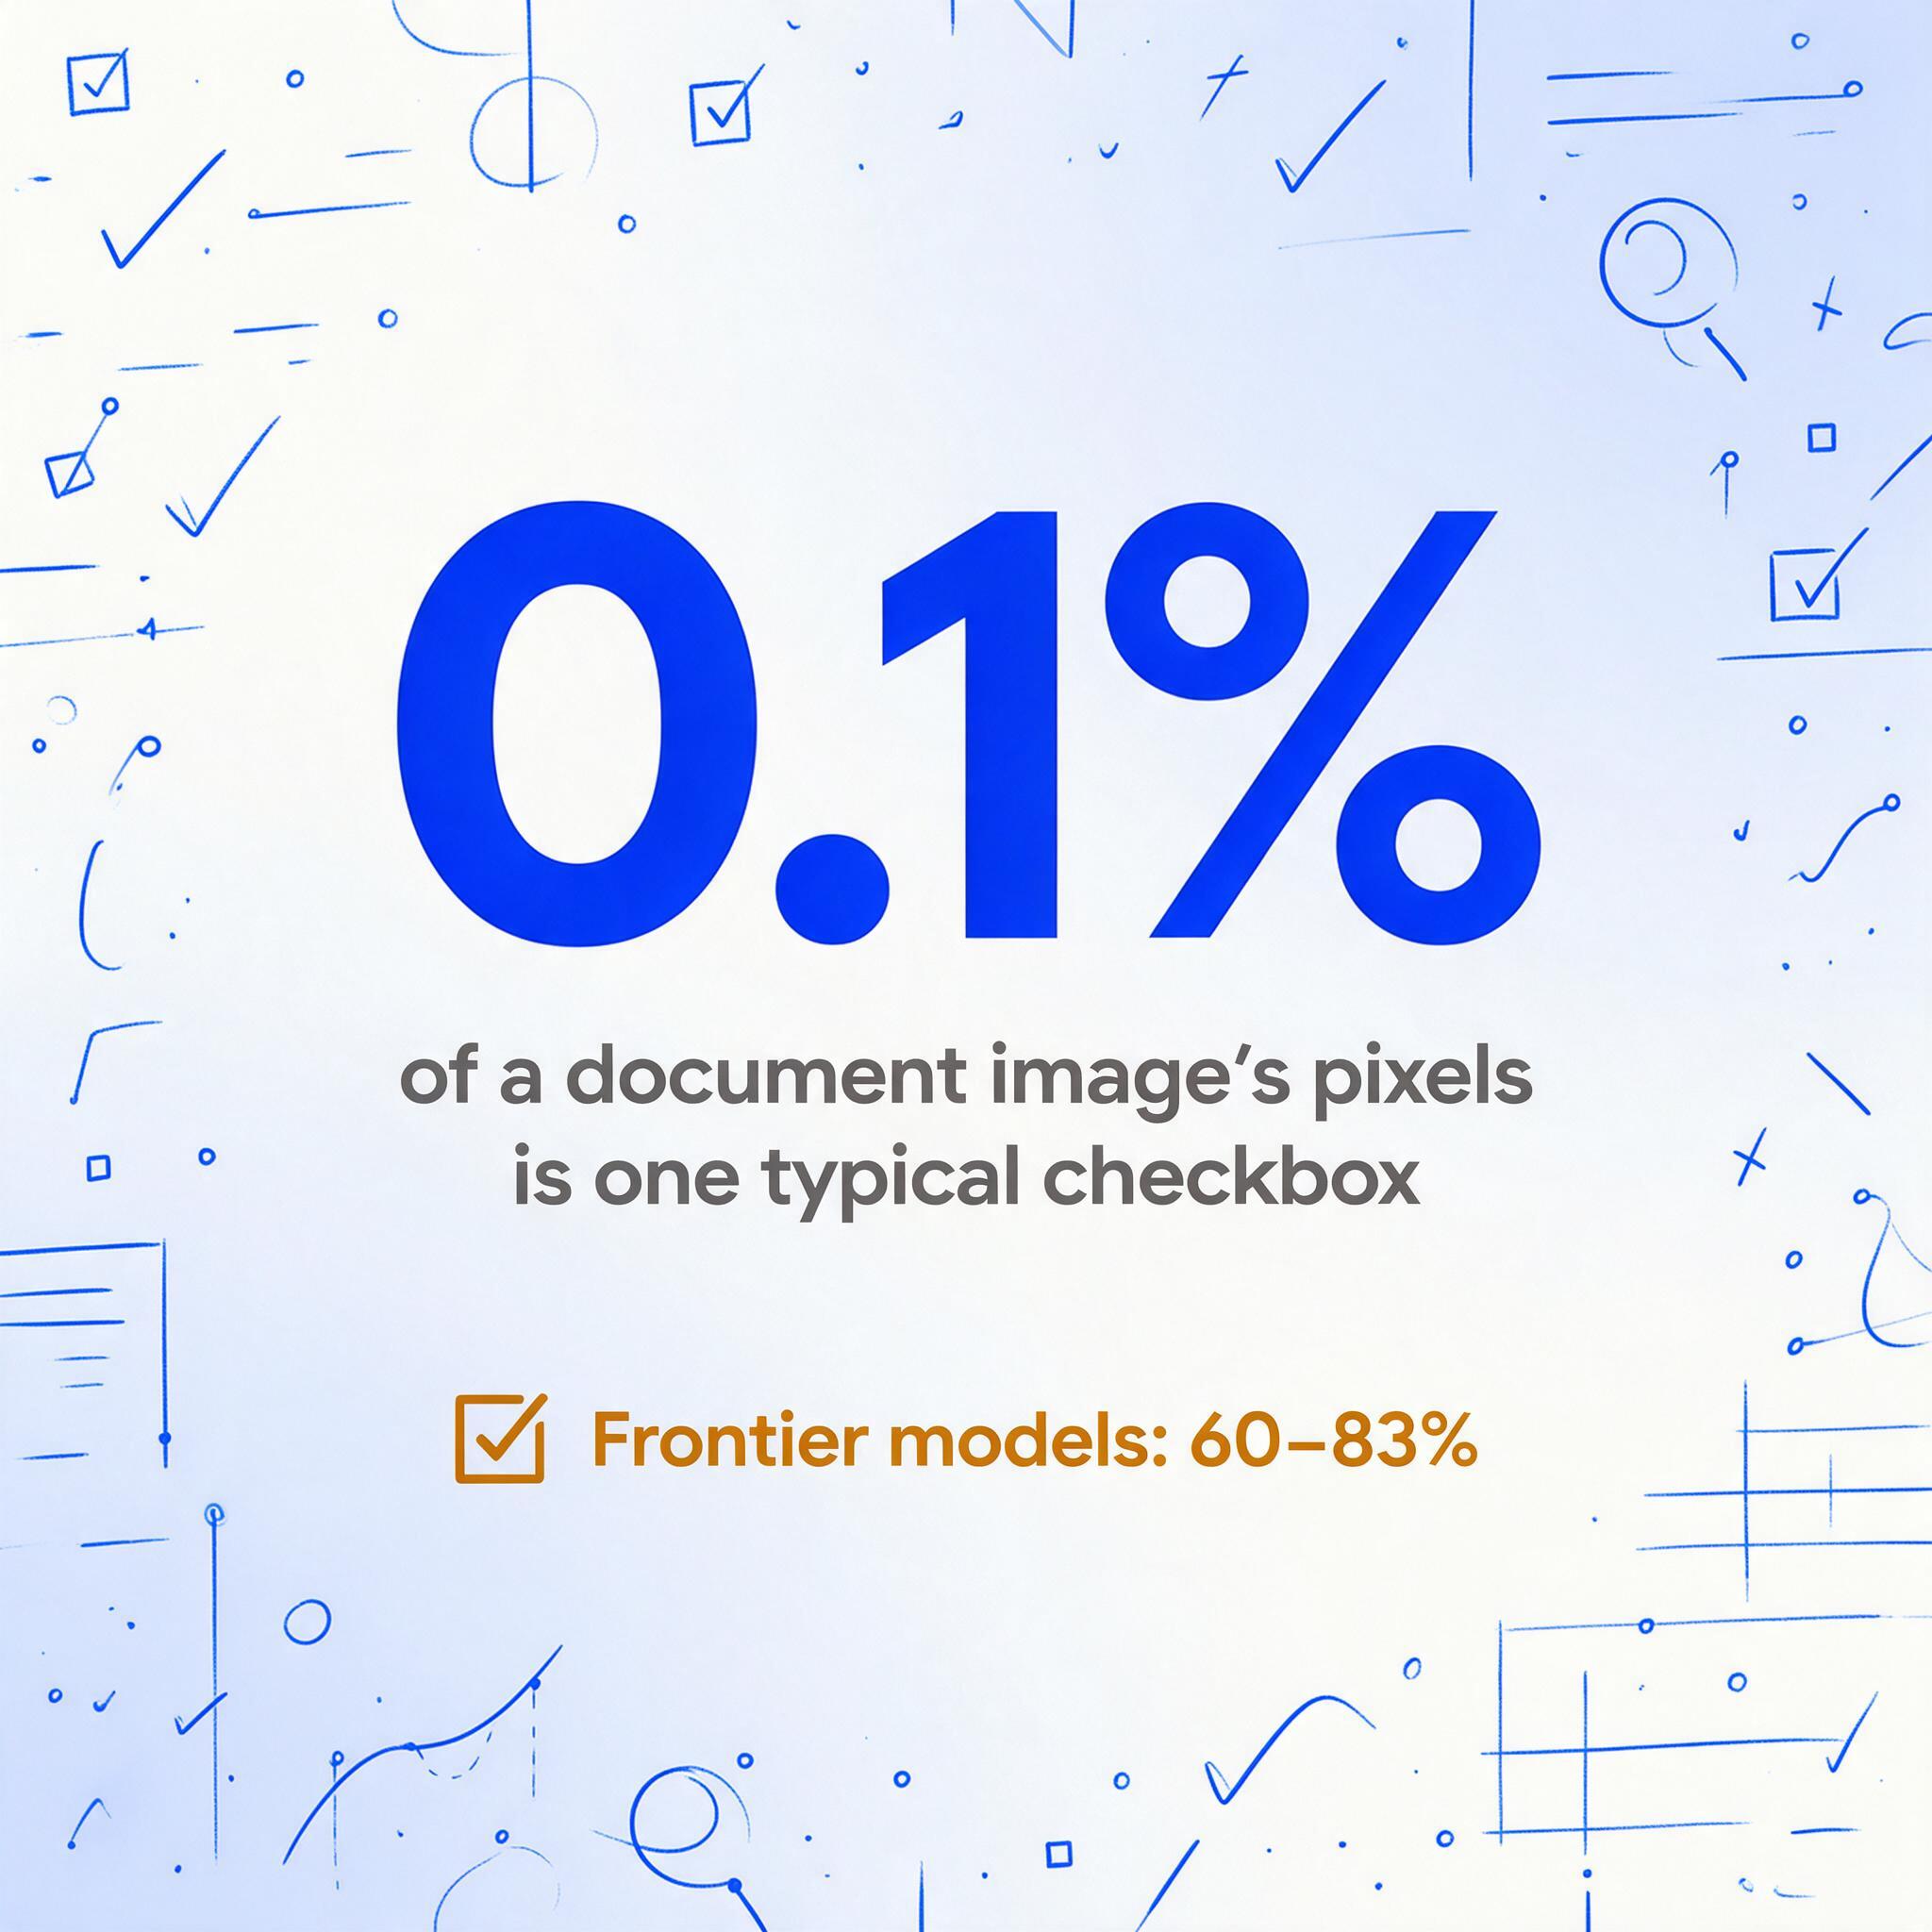
核心的な難しさは、VLMがチェックボックスを見られないことではありません。視覚的なシグナルが、ページ上の他のすべての要素と比較して極めて微妙であることです。典型的なチェックボックスは、文書画像のピクセルの約0.1%を占めるにすぎません。「チェック済み」と「未チェック」の違いは、12ピクセルの正方形を横切る細いインクの線かもしれません。モデルが密集したテキストの段落、テーブル構造、ロゴ、フォームラベルも同時に処理しているとき、その小さなシグナルは注目を競い合い — 時には負けてしまいます。
AIがチェックボックスを間違える5つのパターン — 他のすべてが正しくても
CheckboxQAの研究者たちは、テストしたすべてのモデルに共通して見られる特定の失敗パターンを分類しました。これを理解することは学術的な話ではありません。フォーム処理ツールを評価する際に何に注意すべきかを教えてくれるのです。
失敗パターン1:チェックボックスとラベルの取り違え
多くのフォームでは、チェックボックスはラベルテキストの左側にあります。他のフォームでは右側にあります。モデルは左側のチェックボックスを右側のラベルに、右側のチェックボックスをさらに隣のラベルに割り当ててしまうことがあり、実質的にどのオプションがマークされているかを取り違えます。これは空間的な関連付けのエラーであり、検出エラーではありません。モデルはマークを認識しているのに、それを間違ったテキストに結びつけているのです。
失敗パターン2:視覚よりもテキストを信頼する
フォームが「追加のタスクが必要ですか?」とYes/Noのチェックボックスで尋ねる場合、一部のモデルは実際にどのボックスがマークされているかを確認するのではなく、周囲のテキストの文脈に基づいて回答します。「このタスクの説明は複雑そうだから、おそらくYesだろう」という言語的な推論に頼ってしまうのです。これは、質問が求める視覚的な検査を行う代わりに起こります。答えが間違っていてももっともらしく見えるため、特に危険です。
失敗パターン3:すべてのオプションを列挙する
複数選択のシナリオ(「該当する車両カテゴリはどれですか?」など)では、モデルが一部だけがマークされている場合でも、すべてのオプションがチェックされていると返すことがあります。モデルはテキストから可能な回答のセットを認識しますが、視覚的な状態でフィルタリングすることに失敗します。
失敗パターン4:表の中のチェックボックスを見失う
検査チェックリストやコンプライアンスフォームでよく見られる、チェックボックスが表のセル内にある場合、周囲の表構造がモデルの注意をそらすことがあります。グリッド線、隣接するセルの値、列ヘッダーが注意を競い合い、チェックボックスの状態が視覚的なノイズの中で失われてしまいます。
失敗パターン5:回答ではなく記号を返す
一部のモデルはチェックボックスの質問に対して、「Checked」やラベルテキストのようなテキスト回答の代わりに「✓」や「X」などの文字通りのマークを出力します。これは些細なことに思えるかもしれませんが、抽出結果をデータベースやスプレッドシートに取り込む場合、「Primary Residence」を期待していた場所に✓の文字があると、データパイプラインが壊れてしまいます。
これらの失敗は均等に発生するわけではありません。チェックボックスがきれいに間隔を空けて配置されたシンプルなレイアウトのフォームは、小さなボックスが密集した複数列のフォームよりも精度が高くなります。しかし、研究全体を通して一貫しているのは、検証なしでチェックボックス抽出を実行できるほど信頼できるモデルはないということです。また、一般的なドキュメントタスクで最高のパフォーマンスを発揮するモデルが、チェックボックス固有のタスクで必ずしも最良とは限りません。モデルのサイズよりもトレーニングデータの構成が重要です。
手書きの逆転劇:なぜ走り書きのテキストが簡単な問題になったのか
2018年にフォーム処理エンジニアに「フォームから抽出するのが最も難しい要素は何か」と尋ねたら、ためらうことなく「手書き」と答えたでしょう。可変的なスタイル、筆記体のつながり、一貫しない間隔、大文字小文字の混在。手書き認識は最大の課題でした。
2026年、その優先順位は逆転しました。現代の視覚言語モデル(VLM)は手書きを読むのが驚くほど得意です。なぜなら手書きは、その核心において、依然としてテキストの問題だからです。乱雑な筆記体でさえ、書き言葉の統計的パターン(文字の出現確率、単語の境界、文脈上の期待値)に従っています。VLMは言語理解を活用してギャップを埋めることができます。「Patient Name」の下の医療フォームに「P_tient N_me」と読めた場合、文脈から欠落した文字を推測できるのです。
チェックボックスにはそのような文脈上の安全網がありません。チェックボックスの状態(チェックあり・なし)は純粋に視覚的です。視覚コンポーネントが不確かな場合に頼れる言語的な手がかりはありません。モデルが小さな四角形の中にインクがあるかどうかをはっきり見えない場合、推測するしかありません。そして言語モデルでは、推測はトレーニングデータ内の最も一般的なパターンに偏る傾向があります。多くのフォームでは統計的に「未チェック」が頻度が高いため、体系的な偽陰性につながります。
チェックボックススキャンに関する10年前の質問を再訪したStack Overflowユーザーは、そのフラストレーションを捉えています。彼らのAIは書かれた単語を正確に読み取りましたが、チェックボックスは約80%の精度しかなく、残りの20%を誰も説明できませんでした。その80%という数字は、200枚のフォームを処理するまでは許容できるように聞こえます。少なくとも1つのエラーがあるフォームが40枚。手動で再確認しなければならないフォームが40枚です。
チェックボックスフォームをExcelに処理する方法 — チェックを失わずに
この研究で明らかなことが1つあります。生のフォーム画像を汎用AIに渡して、完璧なチェックボックス抽出を期待することはできません。しかし、そこに到達するためのワークフローを構築することはできます。違いは、AIへの指示方法と、その周辺で何が行われるかにあります。
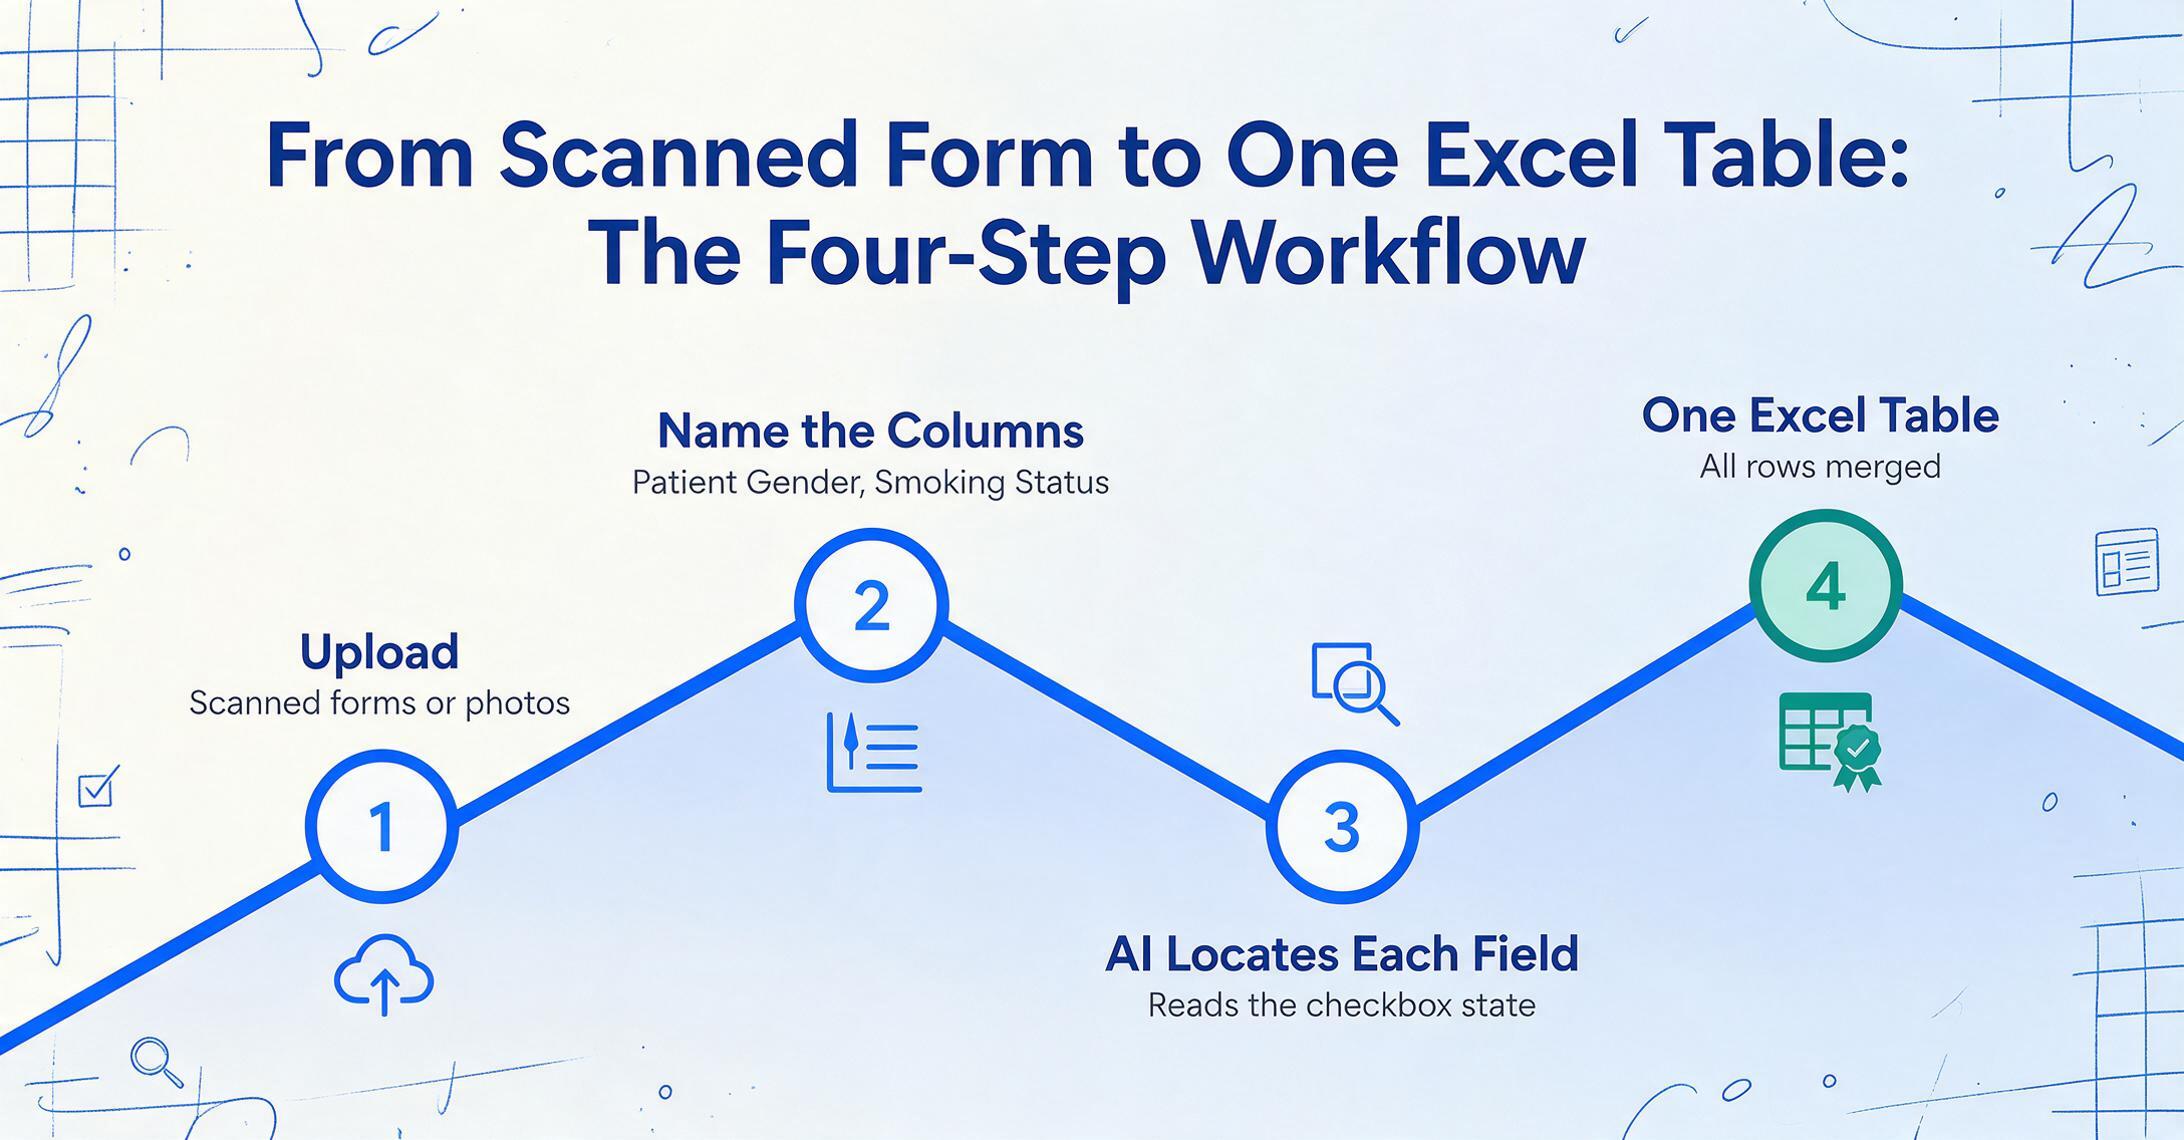
最も効果的な現代のアプローチはカスタム列抽出を使用します。「このフォームのすべてを読み取る」ようにAIに依頼する代わりに、必要なフィールドを正確に定義します。列名(「患者の性別」「喫煙状況」「アレルギー(チェック済み)」など)を入力すると、AIがドキュメント内の各フィールドを検索し、そのチェックボックスまたはテキスト値を特定して、結果を返します。これは、マスターフォーム上の各フィールドの周りにボックスを描画するテンプレートベースのツールとは根本的に異なります。必要な出力を定義すれば、AIが任意のレイアウトでデータの場所を特定します。
「出力を定義する」アプローチは、チェックボックスに関して特に重要です。AIに明確な目標を与えるからです。「何がチェックされていますか?」という曖昧な質問ではなく、「『希望連絡方法』というラベルのフィールドで、電話・メール・郵送のどれがチェックされていますか?」と尋ねます。モデルはページ上のどの要素がチェックボックスフィールドかを判断する必要はありません。指定したラベルテキストを探し、その周囲の視覚領域を調べて、チェック済みか未チェックかのボックスを確認します。
単一のフォームの場合、これで数分節約できます。まとめて処理するフォームのバッチの場合、バッチ処理によりすべての結果が1つのスプレッドシートに統合されます。各行が1つのフォーム、各列が1つのフィールドです。200枚の患者受付フォームの束が、200行の1つのテーブルになり、分析の準備が整います。処理時間は、数枚のフォームを個別に処理するのとほぼ同じです。
チェックボックス抽出が業務を変える3つの場面
テキストを読むこととチェックボックスを読むことの差は理論上の話ではありません。手書きの記入とチェック可能なフィールドが混在するフォームを扱う特定のワークフローで顕在化します。チェックボックス対応ツールとテキストのみのOCRの違いは、完全自動化と、まだ人の介入が必要な状態の違いです。
保険請求フォーム
CMS-1500やUB-04などの標準化された請求フォームには、サービスコード、場所コード、受領承諾フラグ、診断ポインタなど、数十のチェックボックスとラジオボタン項目があります。Parseurが実施した2025年の業界調査によると、手動データ入力は米国企業に従業員1人あたり年間平均$28,500のコストをもたらしており、労働者は文書からシステムへの反復的なデータ転送に週9時間以上を費やしています。保険請求処理担当者にとって、その時間の大部分はチェックボックス項目に費やされています。すべてのフォームに存在する小さな入力項目が、全体として何時間もの時間を消費しているのです。
保険請求におけるAI市場は2024年に$514 millionに達し、2034年までにCAGR 18.3%で$2.76 billionに成長すると予測されています。この成長の背景には、印刷フィールドのOCRだけでなく、チェックボックスや選択マークの自動化こそが、保険会社が望む水準にストレートスルー処理率を引き上げるためのボトルネックであるという認識があります。
医療受付・患者履歴フォーム
患者受付フォームは設計上、チェックボックスが密集しています。症状チェックリスト(「該当するものすべてにチェック」)、服薬申告、家族歴のはい・いいえグリッド、同意確認——新規患者パケット1つに、投薬指示、アレルギー注記、署名欄の手書き入力とともに50以上のチェックボックス項目が含まれることがあります。問題は、チェックボックス検出の失敗モードが最も顕著に現れるのがこのチェックボックス部分だということです。アレルギーリストの「上記のいずれにも該当しない」を丸で囲んだ患者、または同意書のかすれた鉛筆のチェックマークは、汎用AIが未チェックとして返す可能性があり、臨床的に関連する回答を「いいえ」の列に静かに落としてしまいます。自由記述セクションの手書き文字は通常問題なく抽出されます。検証を中心に設計されたワークフローが必要なのは、二者択一の選択なのです。
点検・コンプライアンスチェックリスト
建設現場の安全点検、物件状態レポート、品質管理チェックリスト、設備保守記録 — これらは基本的にチェックボックス形式の文書です。現場の点検員が現場を巡回し、紙のフォームに項目をチェックし、問題があれば隣にメモを書き込みます。チェックボックスのデータ(どの項目が合格か?どの項目が不合格か?)が主要な出力です。手書きのメモは文脈情報です。しかし、手動処理では両方を同等に扱います。誰かがすべてのボックスとメモを確認し、スプレッドシートに入力しなければなりません。
量は急速に増加します — 複数の現場での毎週の点検プログラムでは、毎週数百のチェックボックス項目が生成され、そのすべてがコンプライアンスレポートが依存する二値の判断です。これを、チェック済みと未チェックを区別し、手書きメモも取得できるフォーム抽出ツールで自動化すると、毎週数時間かかる作業が数分のバッチ処理になります。ただし、ツールのチェックボックス処理が検証されている場合に限ります。なぜなら、「不安全」の誤読はデータがないことよりも悪いからです。
よくある質問
AIはチェックマーク(✓)、バツ印(X)、塗りつぶし丸を確実に区別できますか?
最新のVLMはこれらのマークタイプをかなりの精度で区別できます。より大きな課題はマークタイプの分類ではなく、マークの有無の検出です。薄い鉛筆のチェック、ボックス境界を超える部分的なマーク、明示的にチェックされず薄く網掛けされたボックスなどは、すべて曖昧な視覚信号を生み出します。モデルは明確に見える「✓」を「チェック済み」と自信を持って分類できますが、人間がマークと解釈する薄い鉛筆のダッシュを見逃す可能性があります。フォームのマークスタイルが一貫していない場合は、人間のレビューが必要なエッジケースがいくつか発生することを想定してください。
チェックボックス検出とチェックボックス解釈の違いは何ですか?
検出は「このボックスにマークがあるか?」です。解釈は「このマークはこのフォームの文脈で何を意味するか?」です。「補償を辞退」の横のチェック済みボックスは、「規約に同意」の横のチェック済みボックスとは大きく異なる意味を持ちます。検出は視覚的なタスクです。解釈には、ラベルテキスト、フォームの指示、場合によっては複数のチェックボックス間の関係(例:相互排他的なラジオボタンと複数選択のチェックボックス)を読み取り理解することが必要です。優れたフォーム処理ツールは両方のレイヤーを処理します — そして解釈レイヤーこそ、言語理解が不可欠になる部分です。
チェックボックス抽出は手書きフォームでも機能しますか、それとも印刷されたフォームのみですか?
両方で機能しますが、精度は異なります。枠線が明確で濃いチェックマークのある印刷フォームが最も簡単なケースです。手書きフォームでは、テキスト欄を埋める手書き文字(現在の視覚言語モデル(VLM)はこれをうまく処理します)と、チェックボックス内の手書きマーク(走り書き、×印、丸印、部分的な記入など)という2つの追加変数が生じます。文書を全体として読み取るVLMは、OCRとチェックボックス検出を分離したパイプラインよりも、手書きとチェックボックスが混在するフォームをうまく処理できます。VLMは段階間で空間情報を失わないためです。
一度に何枚のフォームを処理できますか?
バッチ処理を使用すると、複数のフォームを同時にアップロードし、1つの結合された出力テーブルを受け取ることができます。実際の上限はツールのアーキテクチャによって異なります—バッチあたり数十枚をサポートするものもあれば、数百枚をサポートするものもあります。ImageToTable.aiでは、カスタム列抽出がバッチ全体で機能します:列を一度定義し、すべてのフォームをアップロードすると、各フォームのチェックボックス状態とフィールド値が単一のスプレッドシートの対応する行に入力されます。フォームごとの設定も、ベンダーごとのテンプレートも不要です。
チェックボックス抽出ではどの程度の精度が期待できますか?
純粋なチェックボックス解釈(フォームの他の部分から分離した場合)では、CheckboxQAベンチマークでテストされた最高の視覚言語モデルは60%から83%の範囲で、人間レベルは97.5%でした。しかし実際のフォームでは、精度はモデルよりもフォームの設計とマークの品質に依存します:クリーンなスキャン上の大きく明確に分離されたボックスは、低解像度の写真上の小さなボックスよりもはるかに優れたパフォーマンスを発揮します。マークタイプ別の内訳(デジタルボックス、ペンのチェック、鉛筆、曖昧なマーク)については、チェックボックス精度ガイドをご覧ください。最も信頼性の高いワークフローは、自動抽出とスポットチェック検証の組み合わせです—AIが作業の大部分を処理し、サンプルを検証してエッジケースを発見します。すべてのフォームを検証する必要はありません。
本当の結論はチェックボックスだけの話ではない
チェックボックスの問題は、ドキュメントAIのより深い真実を浮き彫りにします:文字認識はデータ抽出ではないということです。文字をうまく読めるツールでも、フォーム上の意味の半分を担う非テキスト情報——チェックマーク、ラジオボタンの選択、署名、印鑑、取り消し線が引かれた欄——を見逃すことがあります。重要なベンチマークはOCRの文字精度ではありません。重要なのは、実際に使う出力テーブルが、すべてのセルを再確認しなくても正しいかどうかです。
その違いこそが、文書スキャン用に作られたツールと、データ抽出用に作られたツールを分けるものです。チェックボックスはカナリアです。多様なフォームレイアウト、手書き文字との混在、バッチ規模の処理でも、ツールがチェックボックスを確実に処理できるなら、フォームデータの他の部分も正しく処理できている可能性が高いです。できないなら、結局手作業のデータ入力を行っていることになります。ただ、見た目が良いソフトウェアを使っているだけです。
ファイルは安全に処理され、保存されることはありません。