Como o Vision AI funciona vs
OCR tradicional? Duas formas de ler
Imagine duas pessoas tentando ler um menu em outro idioma. Uma traça cada caractere, traço por traço, montando um dicionário letra por letra. A outra olha a página inteira, reconhece o layout — entradas à esquerda, pratos principais no centro, preços em uma coluna — e encontra o que precisa entendendo a estrutura, não decifrando cada glifo. Essa é a diferença entre o OCR tradicional e o Vision AI.
Principais conclusões
- O OCR fornece texto e confiança, mas nunca entendeu um único campo que extraiu. Tudo o que você reconhece como "dados utilizáveis" foi criado por modelos, não pelo mecanismo de OCR.
- Esses modelos quebram silenciosamente quando um fornecedor muda o layout da fatura. Sem mensagem de erro, sem aviso — apenas dados errados em colunas que parecem certas, descobertos só na conciliação.
- O Vision AI lê documentos como você — reconhecendo o que os campos significam, não onde estão. Sem modelos baseados em coordenadas, não há nada para quebrar quando os layouts mudam.
Essa analogia do menu não é uma simplificação exagerada — ela captura o abismo arquitetônico entre as duas tecnologias. Uma construiu uma indústria em cima de onde os caracteres ficam na página. A outra lê documentos como você: entendendo o que as coisas significam. E essa diferença muda o que é possível.
Como o OCR Tradicional Lê um Documento
O Reconhecimento Óptico de Caracteres foi um avanço genuíno quando surgiu. Antes do OCR, transformar um documento digitalizado em texto legível por máquina significava alguém digitá-lo novamente, tecla por tecla.
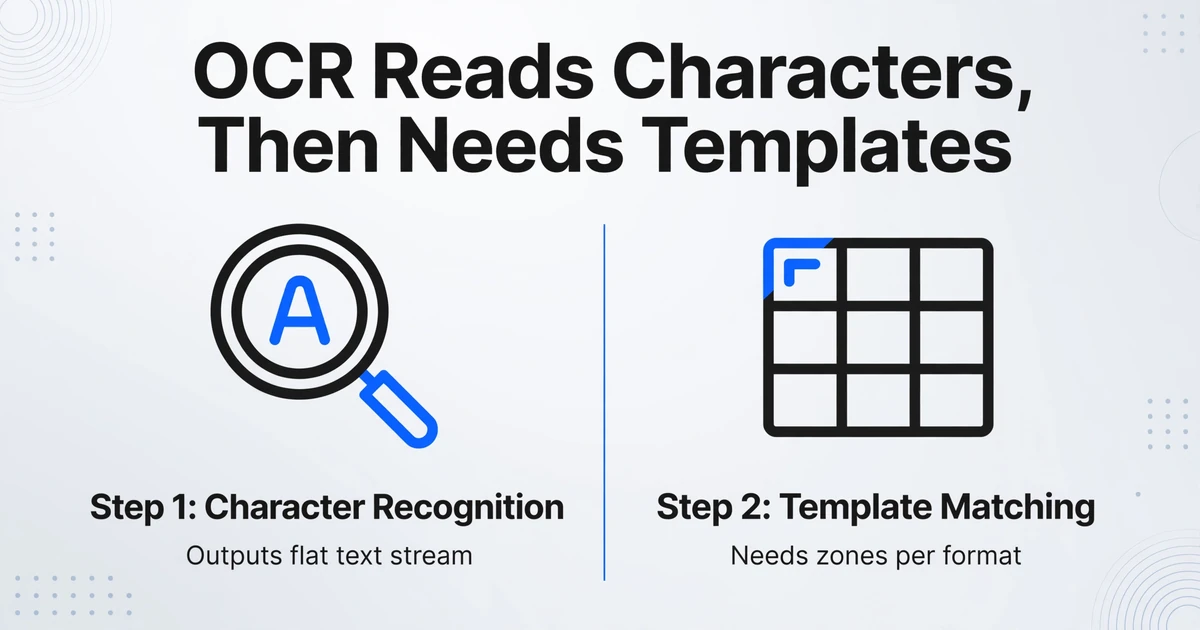
Em sua essência, o OCR funciona no nível do caractere. Ele escaneia uma página, isola regiões retangulares de pixels que se parecem com letras individuais e compara cada região com uma biblioteca de referência de formatos de caracteres conhecidos. Os primeiros motores de OCR usavam correspondência de modelo — uma comparação pixel a pixel com imagens armazenadas de cada letra em cada fonte que você esperava encontrar. Se os pixels escuros em uma região segmentada tivessem a maior correlação com o modelo armazenado para "A" em Arial, o sistema o classificava como "A".
Os motores de OCR modernos substituíram os modelos feitos à mão por redes neurais convolucionais (CNNs) que aprendem características visuais a partir de dados de treinamento. O reconhecedor ficou mais inteligente, mas a premissa fundamental permaneceu a mesma: cada caractere existe isoladamente, e ler significa identificar corretamente cada um em sequência. Uma página é apenas uma grade de glifos.
Essa arquitetura que prioriza o caractere cria uma cascata de dependências a jusante. Como o OCR produz apenas texto simples e não estruturado — "Fatura nº 1047 Data 15 de jan. de 2026 Total $2.340,00 Vencimento 14 de fev. de 2026" como uma única string indiferenciada — você precisa de outra coisa para dar sentido a isso. Essa outra coisa são os modelos.
A Camada de Modelo: OCR Zonal
Para extrair dados utilizáveis da saída do OCR, a maioria dos sistemas de produção adiciona uma camada de OCR zonal (também chamado de OCR com modelo). Veja como funciona: você pega uma fatura de exemplo do Fornecedor A, abre em uma ferramenta de configuração e desenha caixas delimitadoras ao redor de cada campo desejado — um retângulo ao redor do número da fatura, um ao redor da data, um ao redor do total. Você salva essas coordenadas de zona como um modelo. Toda fatura futura do Fornecedor A é processada com base nesse modelo: o motor de OCR lê apenas os pixels dentro de cada retângulo e atribui o texto reconhecido ao campo rotulado.
Isso funciona perfeitamente — até que algo mude. O Fornecedor A atualiza o layout da fatura. Um novo fornecedor envia sua primeira fatura com os campos em posições diferentes. Você recebe um documento digitalizado com uma leve rotação que desloca todas as coordenadas de zona. Cada desvio exige um novo modelo, e cada modelo é um ponto de manutenção que se acumula a cada novo formato de origem. Isso não é um defeito do OCR zonal; é a arquitetura. A abordagem inteira é baseada em posição: o sistema sabe o que os dados são porque sabe onde estão.
Como o Vision AI Lê um Documento
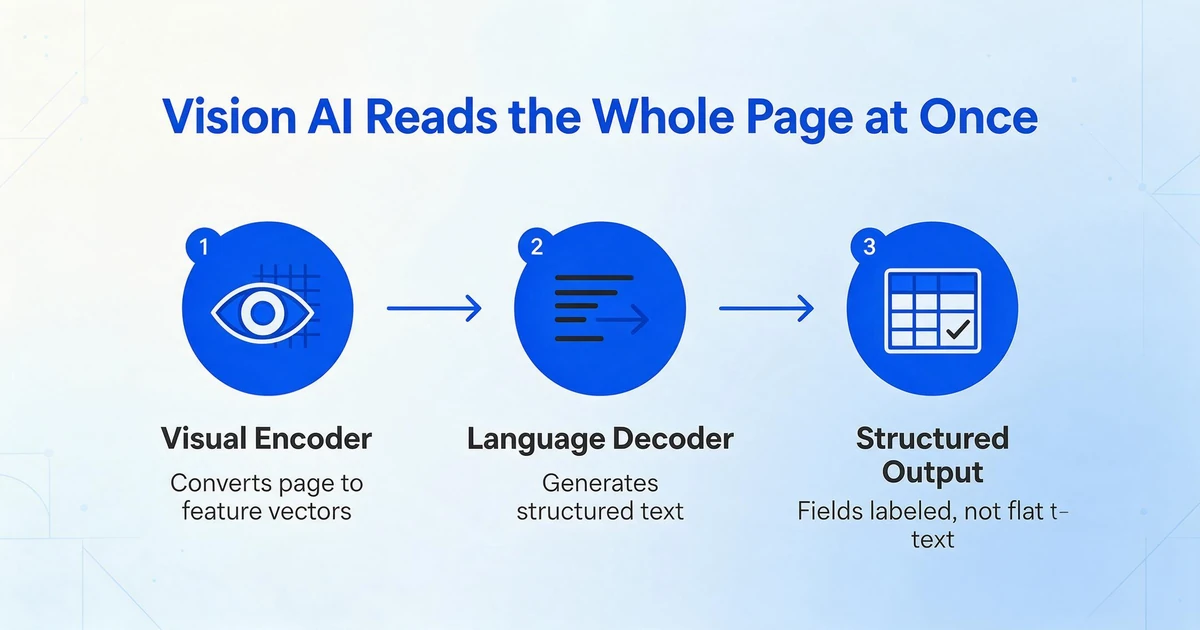
O Vision AI adota uma abordagem fundamentalmente diferente. Ele não segmenta caracteres, não compara padrões de pixels com uma biblioteca de fontes e não precisa de coordenadas para identificar um campo. Em vez disso, processa a página inteira como uma única imagem e gera saída estruturada a partir da compreensão visual.
Pense assim: se o OCR é como transcrever uma conversa gravada palavra por palavra sem saber quem está falando, o Vision AI é como assistir a um vídeo dessa conversa — ele vê quem está à mesa, percebe que a pessoa de terno está fazendo perguntas e a pessoa com a planilha está respondendo, e entende a dinâmica social que dá sentido a cada frase. O contexto visual não é um metadado adicionado depois; é a entrada.
Nos bastidores, um modelo de linguagem visual (VLM) usa um codificador visual — normalmente um Vision Transformer ou uma base CNN — para converter a imagem da página inteira em uma grade de vetores de características visuais. Esses vetores codificam não apenas "há texto aqui", mas também relações espaciais: "este texto é grande, em negrito e centralizado no topo", "este número está em uma coluna rotulada 'Total'", "esta seção é separada por uma linha horizontal da seção abaixo". Um decodificador de linguagem então atende a essas características visuais e gera saída de texto estruturado com base tanto no layout visual quanto no conteúdo semântico. O modelo não faz OCR primeiro e entende depois; ele faz ambos em uma única passagem direta.
É por isso que a extração sem modelo não é uma alegação de marketing — é uma consequência direta da arquitetura. Um VLM encontra o número da fatura não porque alguém lhe disse as coordenadas, mas porque sabe como é um número de fatura e pode localizá-lo em qualquer lugar da página. Ele entende que um número ao lado da palavra "Total" provavelmente é o valor total, quer essa palavra apareça no canto superior direito, no canto inferior esquerdo ou no meio da página dentro de uma tabela. A extração é baseada em semântica, não em posição.
Lado a Lado: OCR vs Vision AI
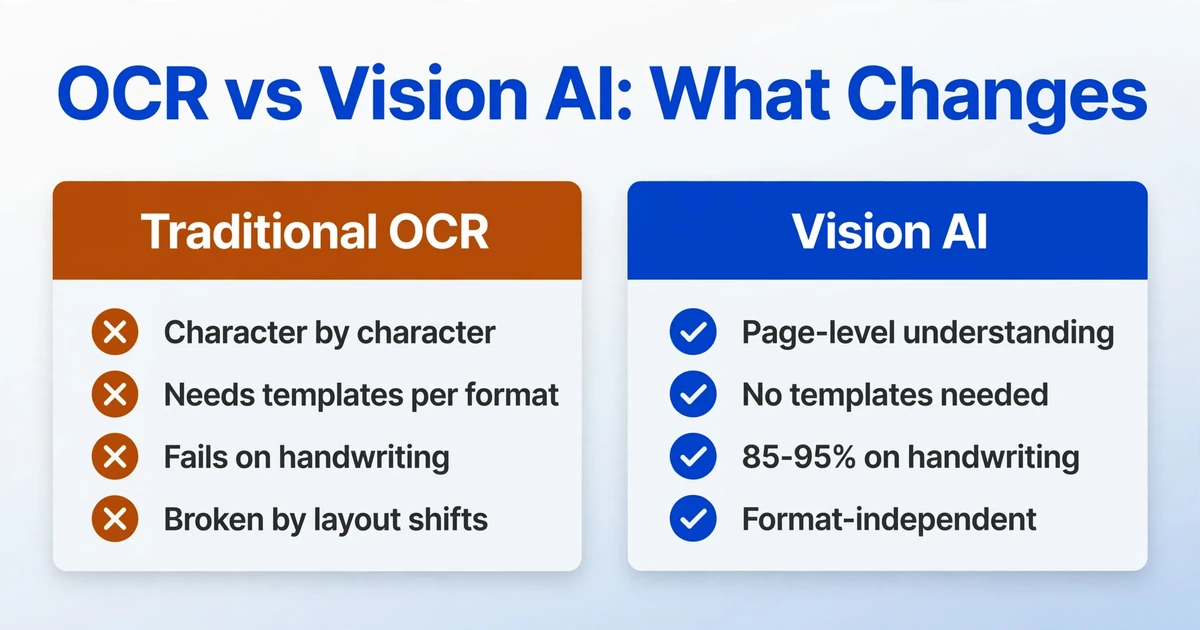
Veja como as duas abordagens se comparam nas dimensões que importam quando você processa documentos reais — não amostras limpas de laboratório, mas as faturas, recibos e formulários que chegam na sua caixa de entrada.
| Dimensão | OCR Tradicional + Modelos | Vision AI (VLM) |
|---|---|---|
| Como lê | Caractere por caractere, correspondência pixel a pixel com formas de glifos conhecidas | Compreensão visual em nível de página; processa a imagem inteira do documento como uma cena unificada |
| Dependência de modelos | Exige modelos de zona por formato de documento; cada novo layout = novo modelo | Sem modelos. Lê entendendo o que os campos significam, não onde estão |
| Escrita à mão | Falha em escrita cursiva e não padronizada. As formas dos caracteres não correspondem à biblioteca de referência | 85–95% de precisão em escrita à mão de qualidade razoável. Vê os traços em contexto |
| Mudanças de formato | Quebra até o modelo ser atualizado. Uma leve mudança de layout pode desalinhar todas as zonas | Independente de formato. Mudanças de layout não afetam a compreensão semântica |
| Custo de configuração | Criação manual de modelos por fonte de documento. Manutenção contínua conforme os formatos evoluem | Zero configuração. Digite os nomes das suas colunas e pronto — sem treinamento, sem documentos de amostra |
| Documentos em vários idiomas | Exige mecanismos de OCR específicos por idioma. Páginas com idiomas mistos causam conflitos de conjunto de caracteres | Compreensão multilíngue nativa. Lê cabeçalhos em chinês e itens de linha em inglês na mesma página |
| Saída do documento | Fluxo de texto não estruturado. O significado do campo existe apenas nos modelos, não na saída | Dados estruturados com rótulos de campo preservados. O número da fatura é rotulado como número da fatura |
Uma forma de resumir a diferença: o OCR gera "1047" e espera que uma regra posterior o conecte a "Número da Fatura". O Vision AI gera "Número da Fatura: 1047" porque entendeu o documento quando o leu.
Por que a diferença importa para seus documentos
A diferença arquitetural entre leitura de caracteres e compreensão de página produz três consequências práticas que se acumulam com a escala.
Primeiro, a diversidade de formatos deixa de ser um gargalo. Uma equipe financeira que recebe faturas de 50 fornecedores não precisa mais de 50 modelos. Uma única configuração de Vision AI — uma lista com os nomes das colunas que você deseja — funciona em todos os 50 formatos porque a IA busca conceitos semânticos, não coordenadas de pixels. Isso não é "geração automática de modelos". É um sistema que não usa modelos. Para equipes que processam pedidos de compra, notas de entrega ou qualquer tipo de documento em que a padronização de layout é impossível, essa é a linha divisória entre automação viável e manutenção manual perpétua.
Segundo, a escrita à mão se torna uma possibilidade técnica em vez de um modo de falha conhecido. O OCR tradicional falha com escrita à mão porque os traços cursivos não se segmentam de forma limpa em formas de caracteres discretos. Um "r" minúsculo conectado a um "i" não se parece em nada com os modelos de "r" e "i" armazenados na biblioteca de referência. O Vision AI não precisa segmentar caracteres — ele lê a forma da palavra e o contexto ao redor simultaneamente, como um humano lê uma anotação à mão. Isso torna recibos de entrega manuscritos, formulários de inspeção e relatórios de serviço de campo extraíveis pela primeira vez sem transcrição manual.
Terceiro, a manutenção não se acumula. Em um sistema baseado em modelos, adicionar um novo fornecedor significa criar um novo modelo. 50 fornecedores, 50 modelos para configurar e manter. Quando o Fornecedor 37 muda o layout da fatura — e vai mudar — alguém precisa perceber, atualizar o modelo e reprocessar tudo que falhou. O Vision AI absorve mudanças de layout silenciosamente porque nunca dependeu do layout antigo. O pipeline de extração não é apenas mais rápido no início; ele continua rápido porque não há nada se acumulando em segundo plano.
O que isso significa para a extração de documentos
Essa mudança da leitura baseada em posição para a baseada em semântica redefine o que o software de extração de documentos pode fazer. O paradigma do produto muda de uma ferramenta de configuração — em que um administrador passa tempo definindo caixas e regras — para uma ferramenta declarativa: você descreve a saída que deseja, e a IA entende a entrada o suficiente para produzi-la.
Na prática, isso é a Extração de Colunas Personalizadas: você digita os nomes dos campos que deseja — "Número da Fatura", "Nome do Fornecedor", "Total da Linha", "Data de Vencimento" — e a IA localiza cada valor em qualquer lugar da página entendendo o que ele significa. Você define a saída. A IA cuida da entrada. É a mesma abordagem que permite processar dados de faturas de diversos fornecedores sem nenhuma configuração por fornecedor, e o mesmo mecanismo que torna viável entender a extração de documentos com IA em ambientes com formatos mistos.
É também o que torna o processamento em lote prático em escala. Se cada documento de um lote de 200 exige o mesmo modelo para corresponder, o lote é tão eficiente quanto seu modelo mais fraco. Se zonas desalinhadas fazem 30 documentos falharem silenciosamente, você ainda precisa revisar tudo. Quando a extração é semântica em vez de posicional, o processamento em lote não é apenas mais rápido na ingestão — é mais confiável na saída, porque os modos de falha são mal-entendidos em nível de conceito (que a IA pode sinalizar) em vez de incompatibilidades em nível de coordenada (que o sistema não consegue detectar).
Nada disso significa que a Vision AI seja universalmente superior. Para documentos de alto volume e formato estável, como formulários governamentais em que cada campo fica na mesma posição em todas as cópias, o OCR baseado em modelo continua mais rápido e mais barato por página. Para tarefas que exigem extração de texto perfeita com zero interpretação — descoberta jurídica que precisa de transcrições literais, por exemplo — os pipelines de OCR puro ainda têm seu papel. A mudança não é sobre substituição; é sobre reconhecer que a maioria dos documentos do mundo real não se encaixa em nenhuma das duas categorias. Eles têm layouts variáveis, formatos mistos, campos com escrita à mão e seções em vários idiomas. Esses são os documentos em que ler pelo significado muda a equação.
Perguntas frequentes
O OCR está completamente obsoleto agora?
Não. Para documentos de alto volume e formato fixo, como formulários governamentais padronizados, o OCR baseado em modelo ainda é mais rápido e mais barato por página. O OCR também continua sendo a melhor escolha quando você precisa de transcrição literal do texto, sem nenhuma interpretação. A mudança é sobre qual ferramenta se encaixa em qual tarefa — e, para a maioria dos documentos empresariais do mundo real com layouts variáveis, o Vision AI é a melhor opção.
O Vision AI precisa de treinamento ou de documentos de exemplo para aprender meus formatos?
Não. Esse é um equívoco comum herdado das ferramentas baseadas em modelo. O Vision AI não precisa de documentos de exemplo, dados de treinamento nem ajuste fino do modelo. Você digita os nomes das colunas que deseja — "Invoice Number", "Total", "Due Date" — e a IA os localiza entendendo o que esses conceitos significam. Sem configuração, sem modelos, sem período de treinamento.
Quão preciso é o Vision AI em comparação com o OCR baseado em modelo no mesmo documento?
Em documentos limpos e de formato fixo, ambos alcançam 95–99% de precisão no nível de campo. A diferença aparece em formatos variáveis: quando os layouts mudam, os designs dos fornecedores mudam ou os documentos misturam texto impresso com escrita à mão. A precisão do OCR baseado em modelo cai drasticamente nessas condições, enquanto o Vision AI mantém praticamente a mesma precisão, porque nunca dependeu do layout desde o início.
O Vision AI consegue lidar com tabelas complexas em várias páginas?
Sim — e é aqui que a vantagem do entendimento no nível da página é mais forte. O OCR tradicional lê as tabelas linha por linha e perde as relações dos cabeçalhos das colunas quando as tabelas atravessam quebras de página. O Vision AI entende a estrutura tabular visualmente: reconhece os cabeçalhos, associa as células de dados às suas colunas corretas e mantém essa associação mesmo quando a tabela continua na página seguinte.
O Vision AI é mais caro que o OCR?
Por página, sim — uma invocação de VLM custa mais do que uma passagem simples de OCR. Mas por documento útil gerado, a comparação favorece o Vision AI, porque ele elimina os custos ocultos de criação de modelos, manutenção, reprocessamento por falhas de formato e verificação manual. Um custo por página mais alto que elimina 90% do pipeline manual ao redor costuma produzir um custo total de propriedade menor.
E documentos com vários idiomas na mesma página?
O OCR tradicional exige que você especifique o idioma de antemão — um mecanismo configurado para inglês vai deturpar caracteres japoneses, e vice-versa. O Vision AI lida com documentos em vários idiomas nativamente porque processa características visuais em vez de conjuntos de caracteres. Uma página com cabeçalhos em espanhol, itens em inglês e carimbos de endereço em chinês é lida corretamente em uma única passagem.
O Vision AI funciona com capturas de tela e fotos de celular, não apenas digitalizações?
Sim. Esta é outra área em que a diferença arquitetural importa. O OCR tradicional espera digitalizações limpas, endireitadas e em 300 DPI — fotos de celular com iluminação irregular e distorção de perspectiva degradam significativamente a precisão. O Vision AI lida melhor com imagens de qualidade inferior porque compensa o ruído visual usando contexto semântico: se o campo total estiver parcialmente desfocado, o layout ao redor e as pistas dos rótulos ainda orientam a extração correta.
Veja a Diferença nos Seus Documentos
Ler sobre diferenças arquiteturais é uma coisa. Ver um documento que você realmente manuseia ser processado — de uma foto de celular ou PDF para colunas estruturadas em segundos — é outra. Extrair dados de documentos do mundo real é para isso que o Vision AI foi criado. Experimente em uma amostra e veja o que muda quando sua ferramenta de extração entende documentos do jeito que você entende.