Vision AIは従来のOCRとどう違うのか?
2つの読み取り方法
外国語のメニューを読もうとしている2人の人を想像してみてください。1人は文字を一画ずつなぞり、辞書を一文字ずつ組み立てていきます。もう1人はページ全体をひと目見て、レイアウトを認識します—左に前菜、中央にメイン、価格は列になっている—そして、一文字ずつ解読するのではなく、構造を理解することで必要なものを見つけます。これが従来のOCRとVision AIの違いです。
重要なポイント
- OCRはテキストと信頼度を返しますが、抽出したフィールドを一度も理解したことがありません。「利用可能なデータ」として認識されるものはすべて、OCRエンジンではなくテンプレートによって作られています。
- ベンダーが請求書のレイアウトを変更すると、それらのテンプレートは静かに壊れます。エラーメッセージもフラグもありません—ただ、正しく見える列に間違ったデータが入り、照合の時になって初めて発見されます。
- Vision AIは、フィールドがどこにあるかではなく、何を意味するかを認識することで、あなたと同じように文書を読み取ります。座標ベースのテンプレートがないため、レイアウトが変わっても壊れるものはありません。
そのメニューのたとえは単純化しすぎではありません。2つのテクノロジーの間にある構造的な隔たりを的確に捉えています。一方は、文字がページのどこにあるかで業界を築きました。もう一方は、あなたがドキュメントを読むのと同じ方法、つまり意味を理解することで読み取ります。そして、その違いが実現可能なことを変えるのです。
従来のOCRがドキュメントを読む仕組み
光学文字認識(OCR)は登場した当時、まさに画期的な技術でした。OCRが登場する前は、スキャンしたドキュメントを機械可読なテキストに変換するには、誰かがキーストロークごとに打ち直す必要がありました。
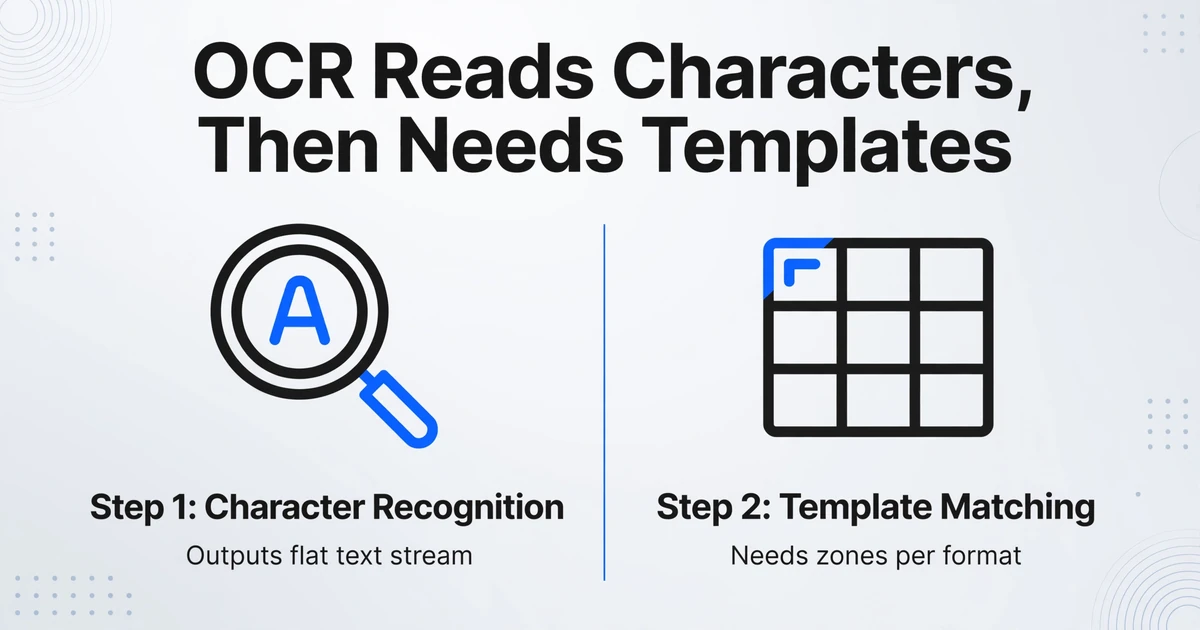
OCRはその核となる部分で、文字レベルで動作します。ページをスキャンし、個々の文字のように見える長方形のピクセル領域を分離し、各領域を既知の文字形状の参照ライブラリと照合します。初期のOCRエンジンはテンプレートマッチングを使用していました。これは、遭遇する可能性のあるすべてのフォントのすべての文字の保存済み画像とのピクセル単位の比較です。分割された領域内の暗いピクセルが、Arialの「A」の保存済みテンプレートと最も高い相関を示した場合、システムはそれを「A」と分類しました。
現代のOCRエンジンは、手作りのテンプレートを、トレーニングデータから視覚的特徴を学習する畳み込みニューラルネットワーク(CNN)に置き換えました。認識精度は向上しましたが、根本的な前提は変わりません。各文字は独立して存在し、読むとは各文字を順番に正しく識別することです。ページは単なるグリフのグリッドです。
この文字優先のアーキテクチャは、下流に連鎖的な依存関係を生み出します。OCRはフラットで構造化されていないテキストのみを出力するため(「請求書No. 1047 日付 2026年1月15日 合計 $2,340.00 支払期日 2026年2月14日」という1つの区別されていない文字列)、それを理解するには別のものが必要になります。その別のものこそがテンプレートです。
テンプレートレイヤー: ゾーンOCR
OCR出力から利用可能なデータを抽出するため、ほとんどの本番システムはゾーンOCR(テンプレートOCRとも呼ばれる)をレイヤーとして重ねます。仕組みはこうです: ベンダーAのサンプル請求書を取り、設定ツールで開き、抽出したい各フィールドの周りにバウンディングボックスを描きます — 請求書番号の周りに1つ、日付の周りに1つ、合計金額の周りに1つ。これらのゾーン座標をテンプレートとして保存します。ベンダーAからの将来のすべての請求書はそのテンプレートに対して処理されます: OCRエンジンは各矩形内のピクセルのみを読み取り、認識されたテキストをラベル付きフィールドに割り当てます。
これは完璧に機能します — 何かが変わるまでは。ベンダーAが請求書のレイアウトを更新する。新しいサプライヤーが異なる位置にフィールドを配置した最初の請求書を送ってくる。わずかに回転したスキャン文書を受け取り、すべてのゾーン座標がずれる。それぞれの逸脱が新しいテンプレートを要求し、各テンプレートは新しいソース形式ごとに増え続けるメンテナンスポイントになります。これはゾーンOCRのバグではなく、アーキテクチャそのものです。このアプローチ全体は位置ベースです: システムはデータがどこにあるかを知ることで、データが何かを把握します。
Vision AIがドキュメントを読む仕組み
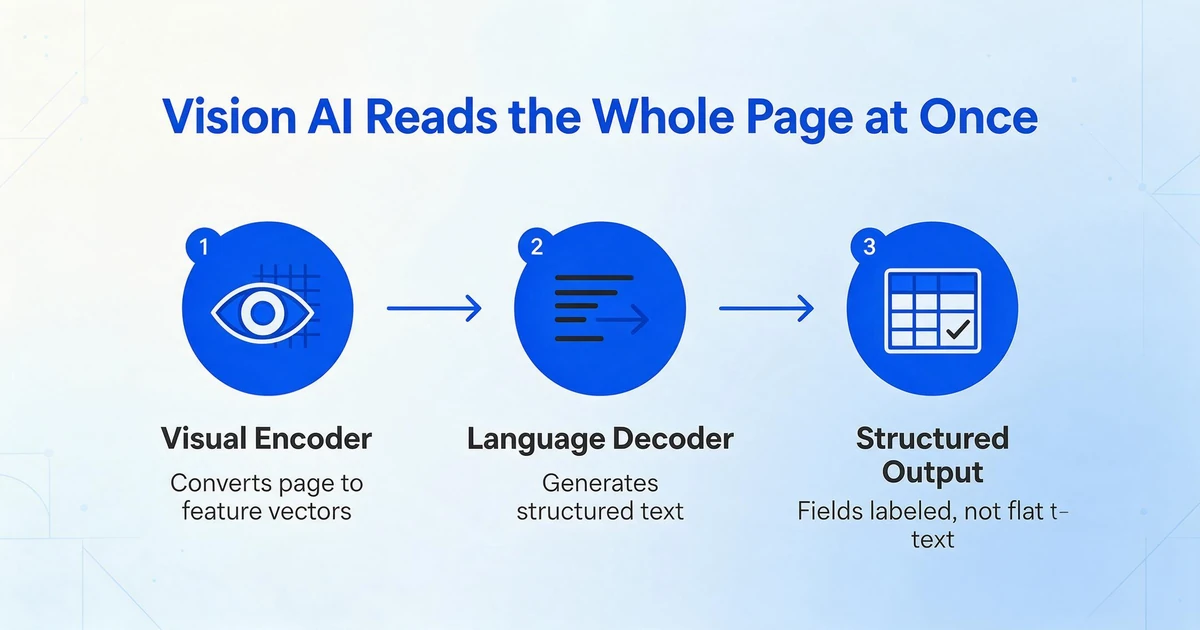
Vision AIは根本的に異なるアプローチを取ります。文字をセグメント化せず、フォントライブラリに対してピクセルパターンを照合せず、フィールドを識別するために座標を必要としません。代わりに、ページ全体を単一の画像として処理し、視覚的理解から構造化出力を生成します。
こう考えてみてください: OCRが誰が話しているかを知らずに録音された会話を単語ごとに書き起こすようなものなら、Vision AIはその会話のビデオを見るようなものです — 誰がテーブルにいるかを見て、スーツを着た人が質問し、スプレッドシートを持った人が答えていることを認識し、各文に意味を与える社会的ダイナミクスを理解します。視覚的コンテキストは後付けのメタデータではなく、入力そのものなのです。
内部では、視覚言語モデル(VLM)は視覚エンコーダー — 通常はVision TransformerまたはCNNバックボーン — を使用して、ページ画像全体を視覚的特徴ベクトルのグリッドに変換します。これらのベクトルは「ここにテキストがある」だけでなく、空間的関係もエンコードします: 「このテキストは大きく、太字で、上部中央にある」「この数字は『合計』とラベル付けされた列にある」「このセクションは下のセクションから水平線で区切られている」。言語デコーダーはこれらの視覚的特徴に注意を向け、視覚的レイアウトと意味的内容の両方に基づいて構造化テキスト出力を生成します。モデルは最初にOCRをしてから理解するのではなく、単一のフォワードパスで両方を行います。
これが、テンプレート不要の抽出がマーケティング上の主張ではなく、アーキテクチャの直接的な結果である理由です。VLMは、誰かが座標を教えたからではなく、請求書番号がどのようなものかを知っており、ページ上のどこにでもそれを見つけられるから、請求書番号を見つけます。「合計」という単語の隣にある数字が合計金額である可能性が高いことを理解します。その単語が右上隅、左下隅、またはページの途中のテーブル内に表示されるかどうかに関係なく。抽出は意味ベースであり、位置ベースではありません。
比較:OCR vs Vision AI
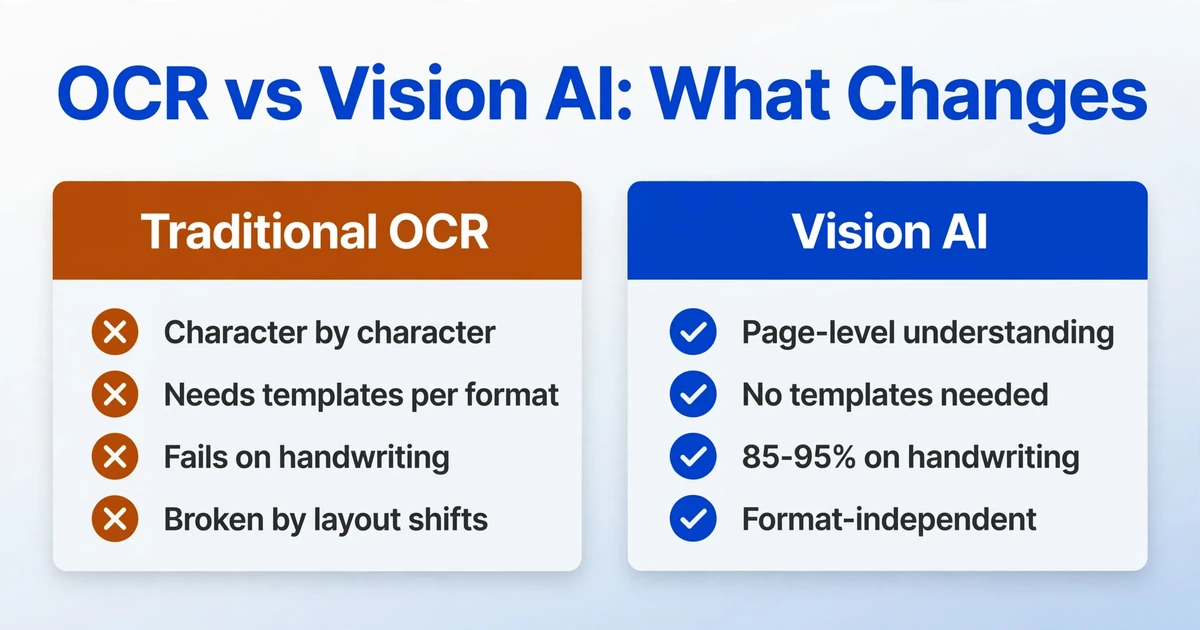
実際のドキュメントを処理する際に重要となる各側面で、2つのアプローチを比較してみましょう。クリーンな実験室サンプルではなく、受信トレイに届く請求書、領収書、フォームです。
| 側面 | 従来のOCR + テンプレート | Vision AI(VLM) |
|---|---|---|
| 読み取り方法 | 既知の文字形状に対する1文字ずつ、ピクセル単位のマッチング | ページ全体の視覚的理解。ドキュメント画像全体を1つのシーンとして処理 |
| テンプレートへの依存 | ドキュメント形式ごとにゾーンテンプレートが必要。新しいレイアウト=新しいテンプレート | テンプレート不要。フィールドの意味を理解して読み取るため、位置に依存しない |
| 手書き | 筆記体や標準的でない書き方は失敗。文字形状が参照ライブラリと一致しない | 品質が妥当な手書きで85〜95%の精度。文脈の中でストロークを認識 |
| 形式の変更 | テンプレートが更新されるまで機能しない。わずかなレイアウトのずれで全ゾーンがずれる | フォーマット非依存。レイアウトが変わっても意味理解に影響しない |
| セットアップコスト | ドキュメントソースごとに手動でテンプレート作成。形式の進化に伴う継続的なメンテナンスが必要 | セットアップ不要。列名を入力するだけで開始。トレーニングもサンプルドキュメントも不要 |
| 多言語ドキュメント | 言語別のOCRエンジンが必要。混在言語ページでは文字セットの競合が発生 | ネイティブな多言語理解。同じページで中国語のヘッダーと英語の明細行を読み取れる |
| ドキュメント出力 | 非構造化テキストストリーム。フィールドの意味はテンプレート内にのみ存在し、出力には含まれない | フィールドラベルが保持された構造化データ。請求書番号は請求書番号としてラベル付けされる |
その差を一言でまとめると:OCRは「1047」を出力し、下流のルールがそれを「請求書番号」に結びつけることを期待します。Vision AIは、読み取った時点でドキュメントを理解しているため、「請求書番号:1047」を出力します。
この違いがドキュメントにとって重要な理由
文字読み取りとページ理解のアーキテクチャ上の違いは、規模が大きくなるにつれて顕著になる3つの実用的な影響を生み出します。
第一に、フォーマットの多様性がボトルネックではなくなる。50社のサプライヤーから請求書を受け取る財務チームは、もはや50個のテンプレートを必要としません。1つのVision AI設定 — 必要な列名のリスト — で50種類すべてのフォーマットに対応できます。なぜならAIはピクセル座標ではなく意味的な概念を探しているからです。これは「自動テンプレート生成」ではありません。そもそもテンプレートを一切使わないシステムです。発注書、納品書、レイアウトの標準化が不可能なあらゆるドキュメントタイプを処理するチームにとって、これは実用的な自動化と永続的な手動メンテナンスの分岐点です。
第二に、手書きが既知の失敗モードではなく技術的な可能性になる。従来のOCRは手書きに失敗します。なぜなら筆記体のストロークは個別の文字形状にきれいに分割できないからです。小文字の「r」が「i」につながっている形は、参照ライブラリに保存されている「r」と「i」のテンプレートとはまったく似ていません。Vision AIは文字を分割する必要がありません — 人間が手書きのメモを読むのと同じように、単語の形状と周囲の文脈を同時に読み取ります。これにより、手書きの納品受領書、検査フォーム、現場サービスレポートが、手動転記なしで初めて抽出可能になります。
第三に、メンテナンスが累積しない。テンプレートベースのシステムでは、新しいサプライヤーを追加するたびに新しいテンプレートを作成する必要があります。サプライヤー50社なら、設定とメンテナンスが必要なテンプレートも50個です。サプライヤー37が請求書のレイアウトを変更したら — そして必ず変更します — 誰かが気づいて、テンプレートを更新し、失敗したものを再処理する必要があります。Vision AIはレイアウト変更を静かに吸収します。そもそも古いレイアウトに依存していなかったからです。抽出パイプラインは開始時点で速いだけでなく、バックグラウンドで蓄積するものがないため、速さを維持し続けます。
文書抽出への影響
位置ベースから意味ベースへのこの移行は、文書抽出ソフトウェアの可能性を再定義します。製品パラダイムは、管理者がボックスやルールを定義する設定ツールから、宣言型ツールへと変わります。つまり、望む出力を説明すれば、AIが入力を理解してそれを生成します。
実際には、これがカスタム列抽出です。「請求書番号」「仕入先名」「行合計」「支払期日」などのフィールド名を入力するだけで、AIが意味を理解してページ上の任意の場所にある各値を特定します。出力を定義するのはあなたです。入力を処理するのはAIです。これは、ベンダーごとの設定ゼロで複数のサプライヤーからの請求書データを処理できるようにするのと同じアプローチであり、AI文書抽出の理解を混合フォーマットの文書環境で実現可能にする仕組みでもあります。
また、これこそがバッチ処理を大規模に実用的にする理由です。200件のバッチ内のすべての文書が同じテンプレートに一致する必要がある場合、バッチの効率は最も弱いテンプレートに左右されます。位置ずれしたゾーンが原因で30件の文書が静かに失敗した場合、すべてを再確認する必要があります。抽出が位置的ではなく意味的に行われる場合、バッチ処理は取り込みが速いだけでなく、出力の信頼性も高まります。なぜなら、障害モードが概念レベルの誤解(AIがフラグを立てられる)であり、座標レベルの不一致(システムでは検出できない)ではないからです。
これはVision AIが常に優れているという意味ではありません。政府のフォームのように毎回同じ位置にフィールドがある高頻度・形式固定の文書では、テンプレートベースのOCRの方が1ページあたりのコストと速度で依然として優れています。逐語的な文字起こしが必要な法的文書の調査など、解釈ゼロで完璧なテキスト抽出が求められるタスクでは、純粋なOCRパイプラインの役割も残っています。この移行は置き換えではなく、ほとんどの実世界の文書がどちらのカテゴリーにも当てはまらないことを認識することです。それらの文書には、可変レイアウト、混合フォーマット、手書きフィールド、多言語セクションがあります。意味による読み取りが状況を変えるのは、まさにそうした文書なのです。
FAQ
OCRはもう完全に時代遅れですか?
いいえ。標準化された政府フォームのような大量・固定フォーマットの文書では、テンプレートベースのOCRの方が1ページあたりの処理が速く、コストも低いままです。また、解釈を一切加えずにテキストをそのまま文字起こしする必要がある場合も、OCRの方が適しています。変化しているのは、どのツールがどの作業に適しているかという点です。レイアウトが多様な実際のビジネス文書のほとんどでは、Vision AIの方が適しています。
Vision AIはフォーマットを学習するためにトレーニングやサンプル文書が必要ですか?
いいえ。これはテンプレートベースのツールから引き継がれたよくある誤解です。Vision AIはサンプル文書、トレーニングデータ、モデルのファインチューニングを必要としません。「請求書番号」「合計」「支払期日」など、必要な列名を入力するだけで、AIはそれらの概念の意味を理解して特定します。設定もテンプレートもトレーニング期間も不要です。
同じ文書で、Vision AIの精度はテンプレートOCRと比べてどうですか?
きれいな固定フォーマットの文書では、どちらも95〜99%のフィールドレベル精度を達成します。差が出るのは可変フォーマットの場合です。レイアウトが変わる、サプライヤーのデザインが変わる、文書に印刷テキストと手書きが混在するといった状況では、テンプレートOCRの精度は急激に低下します。一方、Vision AIはそもそもレイアウトに依存していないため、ほぼ同じ精度を維持します。
Vision AIは複数ページにわたる複雑なテーブルを処理できますか?
はい。そして、これこそがページ単位の理解という利点が最も発揮される場面です。従来のOCRはテーブルを行ごとに読み取り、テーブルがページの区切りをまたぐと列ヘッダーの関連性を見失います。Vision AIは表構造を視覚的に理解します。ヘッダーを認識し、データセルを正しい列に関連付け、テーブルが次のページに続いてもその関連性を維持します。
Vision AIはOCRよりコストが高いですか?
1ページあたりでは、はい。VLMの呼び出しは単純なOCR処理よりコストがかかります。しかし、利用可能な文書出力1件あたりで比較すると、Vision AIが有利です。テンプレート作成、メンテナンス、フォーマット失敗時の再処理、手動検証といった隠れたコストを排除できるからです。周辺の手動パイプラインの90%を排除する1ページあたりのコスト上昇は、多くの場合、総所有コストの低下につながります。
同じページに複数の言語が混在するドキュメントはどうなりますか?
従来のOCRでは、事前に言語を指定する必要があります。英語用に設定されたエンジンは日本語の文字をうまく処理できず、その逆も同様です。Vision AIは視覚的特徴を処理するため、複数言語のドキュメントをネイティブに扱えます。スペイン語のヘッダー、英語の明細行、中国語の住所スタンプが1ページに混在していても、1回の処理で正しく読み取れます。
Vision AIはスキャンだけでなく、スクリーンショットやスマホの写真でも機能しますか?
はい。これもアーキテクチャの違いが重要になる分野です。従来のOCRは、クリーンで傾き補正済みの300 DPIスキャンを想定しています。照明が不均一だったり遠近感が歪んだりするスマホ写真では、精度が大幅に低下します。Vision AIはセマンティックコンテキストを使って視覚的なノイズを補正するため、低品質の画像でもうまく処理できます。合計フィールドが部分的にぼやけていても、周囲のレイアウトやラベルの手がかりから正確な抽出を導き出せます。
あなたのドキュメントで違いを実感してください
アーキテクチャの違いについて読むのと、実際に扱うドキュメントが処理されるのを見るのとでは、まったく違います。スマホの写真やPDFから構造化された列が数秒で生成される様子を、ぜひご覧ください。実世界のドキュメントからデータを抽出することこそ、Vision AIが作られた目的です。サンプルで試して、抽出ツールがあなたと同じようにドキュメントを理解すると何が変わるかを実感してください。