ImageToTable.ai vs Docparser:
AI抽出 vs 絶えずメンテナンスが必要なルールテンプレート
財務チームが40社のベンダーから請求書を受け取るとします。Docparserでベンダーごとに1つのパーサーを構築するのに2週間を費やします。ゾーン矩形の描画、キーワードアンカーのテスト、正規表現フィルターの調整などです。1か月は順調に稼働します。しかし、ベンダー7が請求書テンプレートを更新すると、請求書番号を指していたゾーンが空のスペースを指すようになります。パーサーは静かに失敗します。誰かが3週間後の照合中に気づきます。これが、ルールベースの文書解析を大規模に運用する際のメンテナンスの現実です。
簡単比較
こんな場合はImageToTable.aiを選択
- レイアウトが異なる多数のベンダーや取引先からドキュメントを受け取る場合
- テンプレートライブラリの構築・保守を行うITサポート体制がない場合
- 数日ではなく数分でデータ抽出を開始したい場合
- 新しいドキュメント形式が定期的に追加され、それぞれにパーサーを設定できない場合
- 予算を考慮しており、より少ない費用でより多くのドキュメントを処理したい場合
- ベンダーごとの別々の出力ではなく、1つのテーブルに統合された結果が必要な場合
こんな場合はDocparserを選択
- 形式が安定した少数のベンダーからのドキュメントを処理する場合
- Zapier、Make、Power Automate、またはSalesforceとの高度な連携が必要な場合
- 解析ルールの構築・保守を行う技術リソースがチームにある場合
- 下流のAPIスキーマに合わせたカスタムWebhook出力が必要な場合
機能比較
| 項目 | Docparser | ImageToTable.ai |
|---|---|---|
| 必要な設定 | ベンダー・レイアウトごとにパーサーを1つ作成し、フィールドごとにゾーン、アンカー、ルールを定義して、初回抽出前にテストと反復が必要 | 必要な列名を入力し、ドキュメントをアップロードするだけで、パーサー設定なしで即座に抽出が実行されます |
| 抽出方法 | ゾーンOCR(位置ベース)+ キーワードアンカー + 正規表現パターン + DocparserAI(サンプルからのルール自動生成) | セマンティックなドキュメント理解を備えたビジョン大規模モデル — 固定位置ではなく意味でフィールドを特定します |
| ベンダーのフォーマット変更時 | ゾーンが崩れ、アンカーも壊れる可能性があり、パーサーを手動で更新する必要があり、過去のドキュメントの再解析が必要になる場合があります | 再設定は不要 — 同じ列名でAIがどのレイアウトからでも再抽出します |
| 複数ベンダーのバッチ処理 | ベンダーごとに独自のパーサーとエクスポートがあり、ベンダー間のマージにはZapierの自動化または手作業が必要 | あらゆるソースからファイルを一度にアップロードでき、すべての結果が1つのExcelテーブルに自動的にマージされます |
| 手書き・スタンプ対応 | 斜めにスキャンされたドキュメント、低解像度画像、手書きフィールド、スタンプ・シールの重なりで精度が低下します | 手書き、筆記体、スタンプ、署名、チェックボックス、印刷・手書き混在ドキュメントを認識します |
| 連携機能 | ここではDocparserの勝ち:Zapier(6,000以上のアプリ)、Make、Power Automate、Workato、Salesforce、QuickBooks、ウェブフック、メールトリガー、REST API | Excel/CSV/JSON直接エクスポート、Google Sheetsアドオン、自動処理付きメール受信ボックス、ウェブフック通知付き公開REST API — Zapier/MakeはAPI経由で接続可能ですが、Docparserのようなアプリストア向けの既製コネクタやネイティブのSalesforce/ERP連携はありません |
| 複数レイアウト対応 | パーサーあたり複数レイアウトはBusinessプラン($159/月〜)のみ、下位プランではレイアウトバリアントごとにパーサーが必要 | 同じワークフローでどのレイアウトも処理可能 — プランによる制限なし |
| 導入価格 | $39/月(100ドキュメント)、無料プランなし — 14日間トライアルのみ | $9/月(150クレジット)、$6/50画像からの従量課金、テスト用の無料アカウントあり |
| プロ向け設定オプション | Parsing Assistant:ドキュメントレイアウトあたり$149(Docparserがルールを代行作成、所要5営業日) | 有料の設定サービスは不要 — 最初のドキュメントからアップロードして抽出できます |
ベンダーごとに1つのパーサー — 隠れたセットアップコスト
Docparserの公式ドキュメントは明確に述べています: 「レイアウト(取引先/ベンダー)ごとに1つのドキュメントパーサーを作成する必要があります」 40社のベンダーから請求書を処理する企業の場合、40個のパーサーが必要になります — それぞれにサンプルドキュメントのアップロード、ゾーン設定、フィールドごとのルール設定、そして本番環境で信頼できるようになるまでのテストが必要です。
実際には、これがさらに複雑になります:同じベンダーでも、製品ラインや地域によってわずかに異なる形式の請求書を送ることがよくあります。1つのパーサーで形式のバリエーションを処理できるマルチレイアウト対応機能は、月額$159のBusinessプランでのみ利用可能です。それより低い価格帯では、各バリエーションが別々のパーサーになります。
Docparserはこれが実際に困難な問題であると認識しています。彼らは レイアウト1件あたり$149のParsing Assistantサービスを販売しています — これは、彼らのチームがルールを代わりに構築する有料オプションで、所要期間は5営業日です。これは、自社のセルフサービス設定プロセスに多くのユーザーにとって実際の障壁があることを最も直接的に認めたものです。位置ベースの抽出をより広く検討している場合は、 ExtractTable比較で、これらの制限の一部を共有するテーブルOCRアプローチを確認できます。
「プラットフォームはデータクレンジング用のパーサールールとフィルターを幅広く提供していますが、そのオプションの多さに圧倒されることがあります。特定の解析課題に取り組む際のベストプラクティスが必ずしも明確ではありません。」 — 検証済みレビュアー、 Capterra、2025年
「手作業が多すぎる上、AI機能に制限があり、コストもかかる可能性があります。」 — Colin R.、マネージングディレクター、 Capterra、2025年6月 ★★★
ベンダーがテンプレートを更新すると、ルールが機能しなくなる
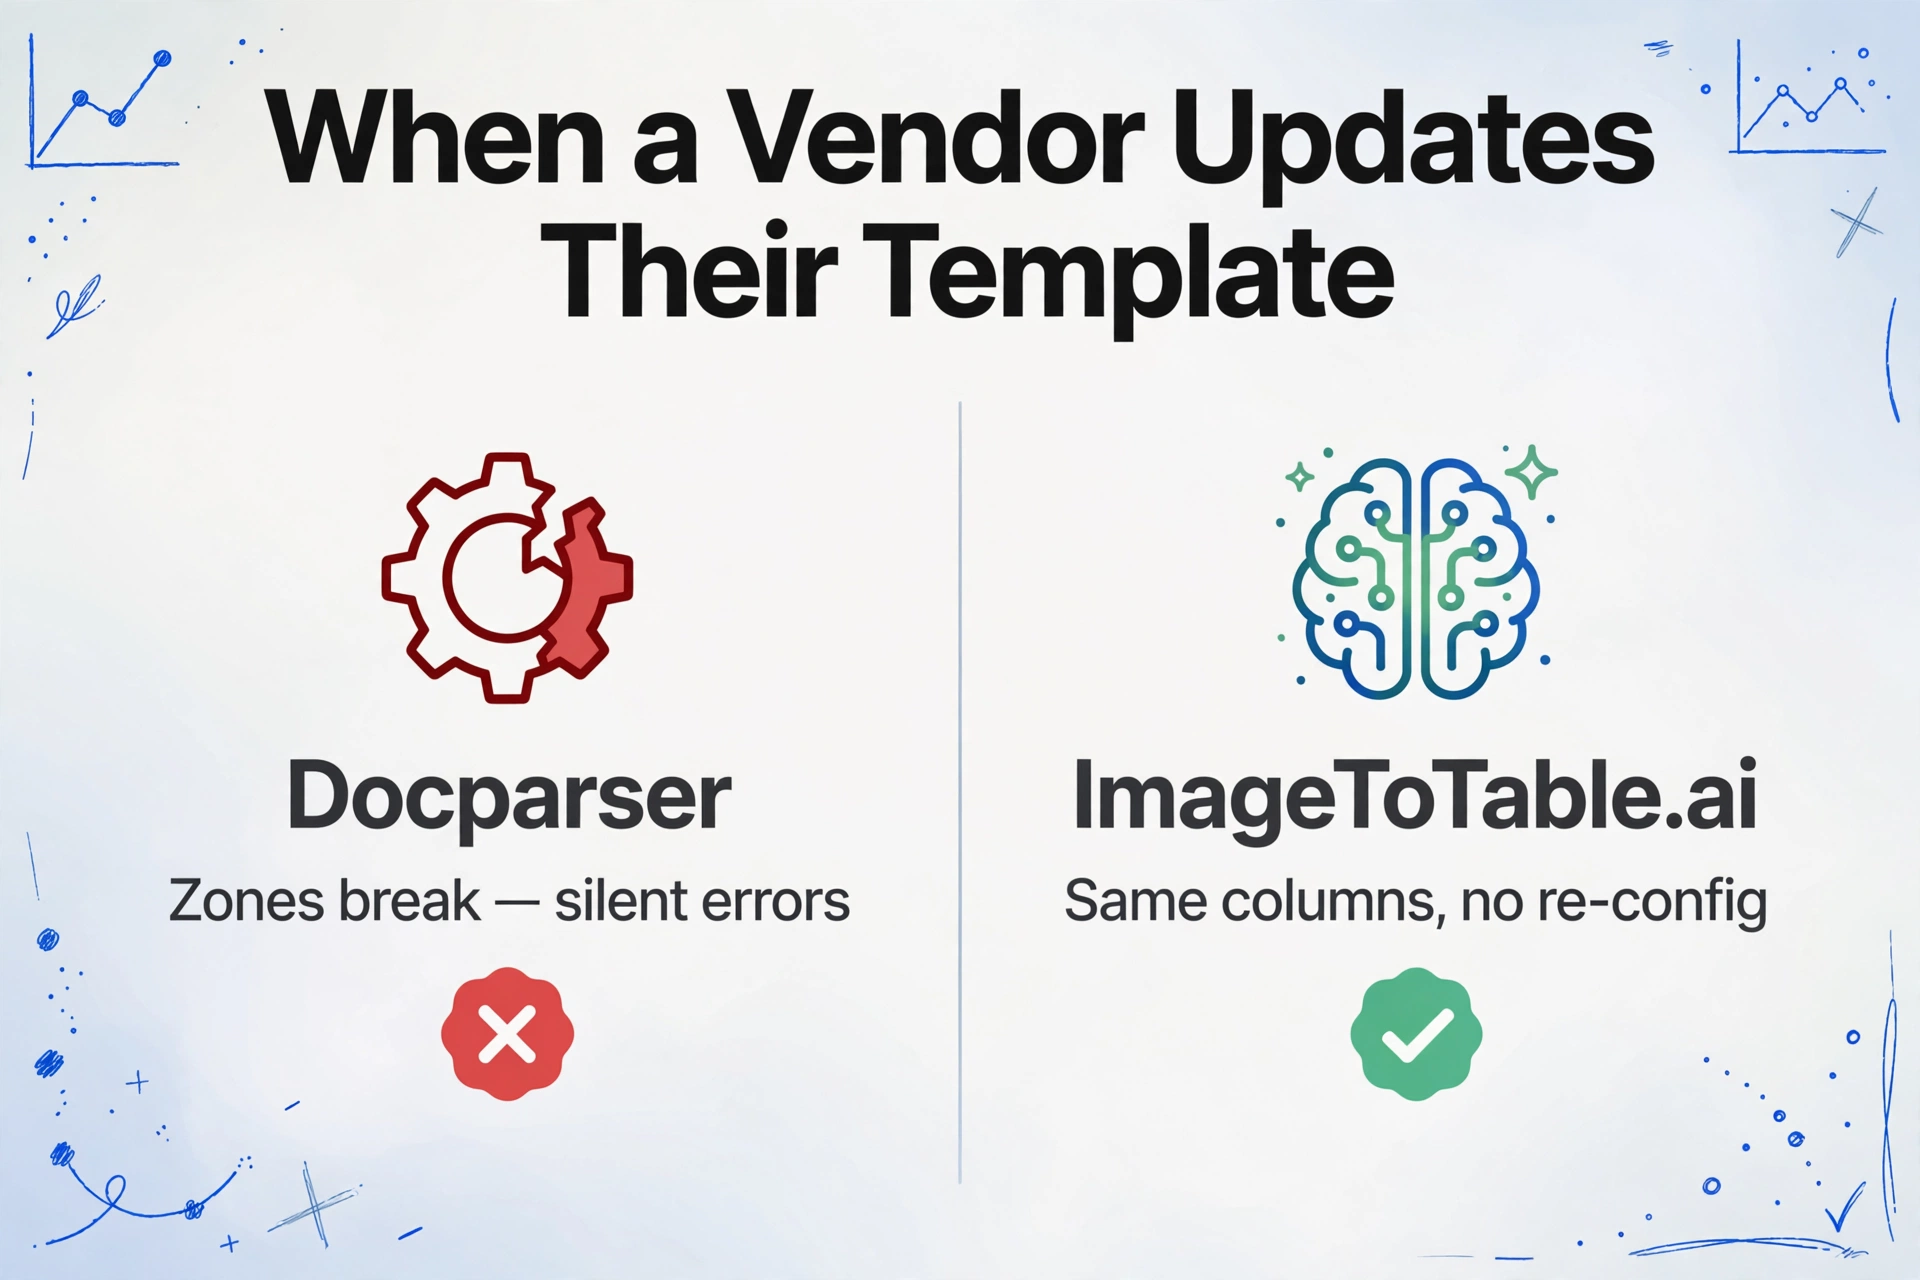
Docparserの公式ヘルプドキュメントには次のように記載されています: 「パーサールールやフィルターを変更するたびに、ドキュメントを再解析する必要があります。」 ベンダーが請求書を再設計し、請求番号を右上からヘッダーブロックに移動したり、2列レイアウトから1列レイアウトに変更したりすると、固定位置に依存していたゾーンは空の領域や誤ったデータを指すことになります。パーサーは大きなエラーを出さず、誰かが出力を確認するまで、静かに誤った値や空白を抽出し続けます。
修正には、障害の検出、どのルールが壊れたかの診断、ゾーンやアンカーの更新、そして古いルールで処理されたすべてのドキュメントの再解析が必要です。大量処理を行うチームにとって、これは大きな運用上の中断となります。
「PDFが変更されたり、斜めにスキャンされたりすると、データがずれてしまいます。注文入力時にそれを検出して修正するのは難しい場合があります。」 — Mitchell D.、社長、 Capterra、2025年9月
「ベンダーは請求書ごとに必ずしも一貫しているわけではないため、毎回テーブル形式を少し調整する必要があります。」 — 検証済みレビュアー、 Capterra
ImageToTable.aiのAIはセマンティックな意味でフィールドを見つけます。つまり、英数字の文字列が続く 「請求書番号:」 が、ページ上のどこにあっても請求書番号であることを理解します。ベンダーがレイアウトを変更した場合、同じ列名で新しい請求書をアップロードするだけです。再トレーニングも、ゾーン調整も、再解析も不要です。
Docparser の強み:統合の深さ
Docparser の真の競争優位性は、その統合エコシステムにあります。Zapier の 6,000 以上のアプリライブラリへの接続、Make、Microsoft Power Automate、Workato、Salesforce、QuickBooks へのネイティブ対応、カスタム JSON ペイロードを受け付ける完全なウェブフックシステムを備え、Docparser は単独で動作するのではなく、既存のエンタープライズワークフローに組み込まれるように設計されています。
抽出した請求書データを自動的に ERP に流し込み、Slack の承認をトリガーし、ブラウザから離れることなく Google シートにプッシュしたい AP チームにとって、Docparser の自動化レイヤーはこれをエンドツーエンドでカバーします。なお、ImageToTable.ai には、ファイルダウンロードの手順なしで抽出データをアクティブなシートに直接書き込む Google Sheets アドオン、Docparser のメールボックスと同じように転送された請求書を自動処理するメール受信トレイ、独自の統合を構築したいチーム向けのウェブフック通知付き公開 REST API があります。しかし、Docparser のより広範な自動化範囲(ネイティブの Zapier/Make/Power Automate コネクタと ERP 統合)は、Salesforce、QuickBooks、またはカスタムウェブフックスキーマへのノーコード自動化をすぐに実現したいチームにとって、はるかに先を行きます。Parseur もメールボックスごとの設定による同様のメールファーストのアプローチを採用しています。そのワークフローを検討中の場合は、Parseur の比較をご覧ください。
これらの機能は、大規模な自動化ワークフローに組み込まれているチームにとって、現実的で有意義なものです。主なニーズが、人手を介さずにドキュメントデータを下流システムに接続することであるなら、ここが Docparser が価格プレミアムに見合う価値を発揮する領域です。
料金比較
Docparserには無料の永久プランはなく、14日間のトライアルのみです。最安の有料プランは 100ドキュメントで月額$39からで、1ドキュメントあたり$0.39になります。 多くのマルチベンダーワークフローで必要となる複数レイアウト対応は、月額$159からのプランでのみ利用可能です。
| 月間ボリューム | Docparser | ImageToTable.ai |
|---|---|---|
| 月50ドキュメントまで | 月額$39のStarter(100ドキュメントプランが最低); それ以下のプランはなし | 従量課金: 50画像で$6; 無料アカウントでテスト可能 |
| 月約100ドキュメント | Starter: 月額$39(100ドキュメント、1件あたり$0.39) | Basic: 月額$9(150クレジット、1クレジットあたり$0.06)— 1ドキュメントあたり4倍お得 |
| 月約250ドキュメント | Professional: 月額$74(250ドキュメント) | Pro: 月額$19(400クレジット)— 150クレジット余裕あり |
| 月約1,000ドキュメント | Business: 月額$159(1,000ドキュメント; 複数レイアウト対応含む) | Max: 月額$59(1,500クレジット)— 500クレジット余分、価格は2.7倍お得 |
1ドキュメントあたりの価格差は、すべてのプランで顕著です。サブスクリプション費用に加えて、 セットアップ時間も考慮する必要があります — Docparserの新しいドキュメントレイアウトごとに、数時間の設定や レイアウトあたり$149のParsing Assistant費用がかかる場合があります。これらのコストは、新しい ベンダーやドキュメントタイプを追加するたびに前払いで発生します。
2026年4月時点の料金です。最新のプランは docparser.com/pricing および imagetotable.ai でご確認ください。
Docparserが適しているケース
Docparserは特定の状況に適した、よく設計されたツールであり、それが適切な選択となるケースについて率直に述べる価値があります。
安定した大量取引のあるベンダー関係と、深いワークフロー統合。 毎月数千件の請求書を、フォーマットがほとんど変わらない固定ベンダーから処理し、そのデータをSalesforce、QuickBooks、またはカスタムウェブフックに自動的に流し込む必要がある場合、Docparserのルールエンジンと統合レイヤーはまさにそのために作られています。初期設定のコストは時間の経過とともに回収できます。
ベンダーごとにルーティングされる複数のメールボックス。 請求書がメールで届き、ベンダーやドキュメントタイプごとに独立して設定されたアドレスを希望する場合、Docparserのパーサーごとのメールボックスモデルがそれを直接処理します。ImageToTable.aiのメール受信トレイも、Auto-Processがテンプレートにバインドされていれば、転送されたメールを自動処理します。違いは粒度です。アカウントごとに1つの受信トレイアドレスであり、ベンダーごとのメールボックスではないため、混合メールは複数の独立して設定されたものではなく、単一のバインドされたテンプレートを通じてルーティングされます。
エンタープライズワークフロー要件。 Microsoft環境向けのPower Automate統合、エンタープライズiPaaS向けのWorkato、内部APIスキーマに合わせたカスタムJSONウェブフック — これらは本格的なエンタープライズ統合機能です。大規模なIT管理された自動化スタックに組み込まれているチームは、Docparserのネイティブなノーコードコネクタの方が、ImageToTable.aiのREST APIやウェブフックよりも配線が簡単だと感じるでしょう。後者は開発者には適していますが、事前に構築されたコネクタをクリックするのではなく、誰かが統合を書く必要があります。
Docparserユーザーの声
「複雑なドキュメントへの絶え間ない調整は煩わしいものです。さまざまなドキュメントのルールを維持することは、時間の経過とともに難しくなります。」 — レビュアー、 G2
「明らかな方法ではできないため、目的のデータを取得するために不自然な方法を取らざるを得ないことがあります。」 — Robert T.氏、最高技術責任者(卸売業)、 Capterra、2025年8月
「月に2〜5件のドキュメントしか解析する必要がありません。しかし、このユースケースに合ったプランがありません。」 — 匿名、 Financesonline
肯定的なレビューは一貫して同じパターンを示しています。固定されたワークフロー用に設定に投資したユーザーは、実際の時間節約を報告しています。あるCapterraのレビュアーは、$39/月で毎月80スタッフ時間以上を節約できたと述べています。不満のレビューは、ルールベースモデルの限界に直面したユーザーからのものです。フォーマットの変動、最小料金ティアを下回る処理量、またはゾーン/アンカーアプローチがうまく処理できないドキュメントタイプなどが原因です。
よくある質問
Docparserで新しい文書タイプのセットアップにはどのくらい時間がかかりますか?
固定レイアウトの単一ベンダーからのシンプルでクリーンなPDFの場合、経験豊富な ユーザーであればDocparserパーサーを30〜60分で設定できます。複雑な文書、 マルチカラムレイアウト、またはテーブル抽出の場合、設定には通常数時間の 設定、テスト、反復が必要です。Docparser自身は、セルフサービスでの設定が 複雑すぎると感じるユーザー向けに、文書レイアウト1件につき$149で Parsing Assistantサービスを提供しています。ImageToTable.aiではパーサー設定が不要です — 抽出したい列名を入力するだけで、AIが最初のアップロードで抽出を処理します。
ベンダーが請求書の形式を変更した場合、Docparserではどうなりますか?
Docparserのゾーンベースのルールは、ページ上のデータの物理的な位置に依存しています。 ベンダーが請求書のレイアウトを変更すると、移動したフィールドを指していたルールは 誤ったデータを抽出したり、空白を抽出したりします — 多くの場合、目に見えるエラーなしに発生します。 ユーザーは障害を検出し、どのルールが壊れたかを特定し、ゾーン設定または キーワードアンカーを更新し、影響を受ける文書を再解析する必要があります。 Docparser自身のドキュメントには、ルールを変更した場合は既存の文書を再解析する必要があると 記載されています。ImageToTable.aiでは、ベンダーの形式変更に対してアクションは不要です — 文書のレイアウトに関係なく、同じ列名が機能します。
Docparserは無料ですか?価格はどのように比較されますか?
Docparserは14日間の無料トライアルを提供していますが、恒久的な無料プランはありません。 最安の有料プランは100文書で月額$39(1文書あたり$0.39)です。複数レイアウトのサポート — 複数の請求書形式を送信するベンダーに必要 — はBusinessプラン(月額$159)からのみ利用可能です。 ImageToTable.aiのBasicプランは150クレジットで月額$9(1クレジットあたり$0.06)で、 50画像から$6の従量制も利用できます。同等のボリューム帯では、ImageToTable.aiは 文書あたり約4分の1のコストで、ベンダーごとの設定投資も不要です。
Docparserは複数のベンダーからの結果を1つのExcelテーブルに統合できますか?
Docparserはパーサーごとに結果をエクスポートします — 各ベンダーパーサーには独自のエクスポートがあります。 複数のベンダーからのデータを統合テーブルにマージするには、Docparserを ZapierやMakeなどのダウンストリームツールに接続するか、エクスポートを手動で結合する必要があります。 ImageToTable.aiは、ソースやレイアウトに関係なく、アップロードされたすべての文書を バッチ処理の一部として自動的に単一のExcelテーブルに統合します。
Docparserは手書き文書や低品質のスキャンを処理できますか?
信頼性の高い抽出には、Docparserは最低300 DPIを推奨しています。実際の Capterraレビューでは、斜めにスキャンされた文書や手書きのあるフィールドで精度が低下することが報告されています。スタンプや印鑑はゾーン認識を妨げることがあります。ImageToTable.aiは、手書き、スタンプ、署名、チェックボックス、印刷・手書き混在コンテンツをコア機能として明示的に処理するビジョン大規模モデルに基づいています。
DocparserからImageToTable.aiに切り替えられますか?
はい。無料のImageToTable.aiアカウントに登録し、文書のサンプルをアップロードして、Docparserで現在抽出している列名を入力してください。AIがフィールドマッピングを処理するため、再設定は不要です。切り替え前に、同じ文書セットで両方のツールを並行して実行し、出力を比較できます。主な考慮点は、ワークフローがDocparserのネイティブなノーコードのZapier/Make/Power AutomateコネクタやERP連携に依存しているかどうかです。ImageToTable.aiはExcel/CSV/JSONファイルを直接エクスポートし、Google Sheetsアドオンを提供し、完了時にウェブフック通知を備えた公開REST APIを提供します。ZapierとMakeはそのAPIを通じて接続できますが、アプリストア用の既製コネクタやネイティブERP連携はまだありません。
あらゆるドキュメントから抽出 — パーサー設定不要
任意のベンダーの請求書をアップロードしてください。必要な列名を入力します。 ルールを1つも作成せず、ゾーンを描画せず、レイアウト変更時の再設定もなしに、数秒で構造化されたExcelテーブルを取得できます。
無料アカウントを利用できます。50ドキュメントあたり$6からの従量課金制。設定費用なし、パーサー設定も不要です。