CMS-1500医療請求書から
Excelへのデータ抽出方法
CMS-1500フォームには、専門的な請求を処理するために保険会社が必要とするすべての情報が含まれています。患者の基本情報、保険の適用範囲、ICD-10-CM診断コード、修飾子付きのCPT手順コード、サービス日、料金、および33の番号付きボックスにわたる提供者識別子などです。これらすべてが、人間が読むために設計された密集したグリッドに1ページに収められており、機械による抽出には適していません。この密度こそが、請求の審査においてフォームが効率的に機能する理由であり、そのデータをスプレッドシートや請求システムに手動で入力すると、多くのエラーが発生する理由でもあります。
重要なポイント
- CMS-1500請求が拒否されたとき、自分を責めてしまいがちですが、ボックス24Eの診断ポインターがボックス21の有効なICD-10コードを参照していない場合、それは入力時点で人間の目には見えないエラーです。
- その単一のクロスフィールド不一致は、30〜60日後に拒否として戻ってきて、調査に費やす時間は、手動データ入力が節約するはずだったすべての分を消し去ります。
- 各フィールドの意味を理解してフォームを読み取るセマンティックAI抽出を使用すると、すべての値を入力する代わりに、支払者ルールに対して構造化出力を監査でき、支払者が検出する前に依存関係エラーを捕捉できます。
CMS-1500用紙とは
CMS-1500(旧称HCFA-1500)は、医師、セラピスト、診療所など施設以外の医療提供者が、専門的なサービスの請求のためにメディケア、メディケイド、民間保険会社に提出する標準化された健康保険請求書です。この様式は、全米統一請求委員会(NUCC)が管理しており、同委員会はアメリカ医師会が議長を務め、メディケア・メディケイド・サービスセンターが重要なパートナーとなっている任意の標準化団体です。現行版(02/12様式)は2012年2月に承認され、2014年4月に紙媒体での必須様式となりました。NUCCは2025年7月にバージョン13.0の指示マニュアルを公開し、フィールドルールとコーディング要件の最新の更新を反映しています。
この様式の33の番号付きボックスは、3つの機能ゾーンに分かれています:
- ボックス1~13 — 患者および保険情報:患者名、生年月日、性別、住所、保険証券番号、被保険者名、被保険者との関係、給付調整の詳細。
- ボックス14~23 — 状態の詳細と承認:疾病または負傷の日付、入院日、患者の最終就労日、紹介情報、ICD-10-CM診断コード(最大12件)、事前承認番号、メディケイド再提出コード。
- ボックス24~33 — サービス明細と請求提供者データ:6行のサービス明細項目(サービスの日付、サービスの場所、CPT/HCPCSコード、修飾子、診断ポインタ、料金、単位数)、請求提供者名、NPI、納税者番号、提供者の署名。
これらのボックス間には、完全で提出可能な請求書に必要な約90の個別データポイントが存在します。これは誇張ではありません — 様式仕様マニュアルは60ページ以上にわたり、各フィールドのフォーマットルールを詳細に説明しています。
手動でのCMS-1500データ入力がボトルネックになる理由
紙のCMS-1500フォームを処理する請求スペシャリストは、フォームごとに同じサイクルを繰り返します。文書を見て、各フィールドの値を特定し、請求ソフトウェアやスプレッドシートの該当フィールドを見つけ、入力し、元の文書と照合し、次の入力に移ります。1件の請求につき約90のデータポイントがあり、Box 24A〜Jのサービス明細行が6行にわたって繰り返されるため、認知的負荷は急速に高まります。Box 24の1行には、サービス提供期間(24A)、サービス場所コード(24B)、緊急フラグ(24C)、最大4つの修飾子を伴うCPTまたはHCPCSコード(24D)、Box 21を参照する診断ポインタ(24E)、請求額(24F)、日数または単位数(24G)、施術提供者のNPI(24J)が含まれます。
CMS-1500が一般的な文書入力と異なるのは、フィールド依存関係の連鎖です。Box 24Eの診断ポインタは、Box 21に存在する有効なICD-10コードを参照する必要があります。Box 24DのCPTコードは、Box 24Bのサービス場所コードに適している必要があります。Box 24JのNPIは、Box 33の提供者登録記録と一致する必要があります。これらのフィールド間の関係は、入力している人には見えません。数週間後に請求が拒否され、「診断ポインタが有効な診断コードを参照していません」という拒否コードが表示されて初めて表面化します。
Redditのr/CodingandBillingコミュニティでは、こうした不満が定期的に取り上げられています。請求担当者が、特定の行に修飾子を付ける必要があるか、Box 33bのタクソノミーコードがNPPES記録と一致するか、Box 32aのサービス施設NPIが提供者と一致しない場合にクリアリングハウスが請求を拒否するかどうかを尋ねています。これらは知識不足ではなく、相互に依存する多数のフィールドを1ページに詰め込み、毎回手動で正確に転記することに依存するフォームの自然な結果です。
CMS-1500抽出がEOB、UB-04請求、その他の支払者文書とどのように連携するかについての詳細は、医療向けOCRガイドをご覧ください。請求書データ抽出の精度に特化してツールを比較する場合は、医療文書抽出ツールの総合比較で、実際のCMS-1500およびEOB文書を使用して7つのプラットフォームをテストしています。
CMS-1500抽出が他の医療文書より難しい3つの理由
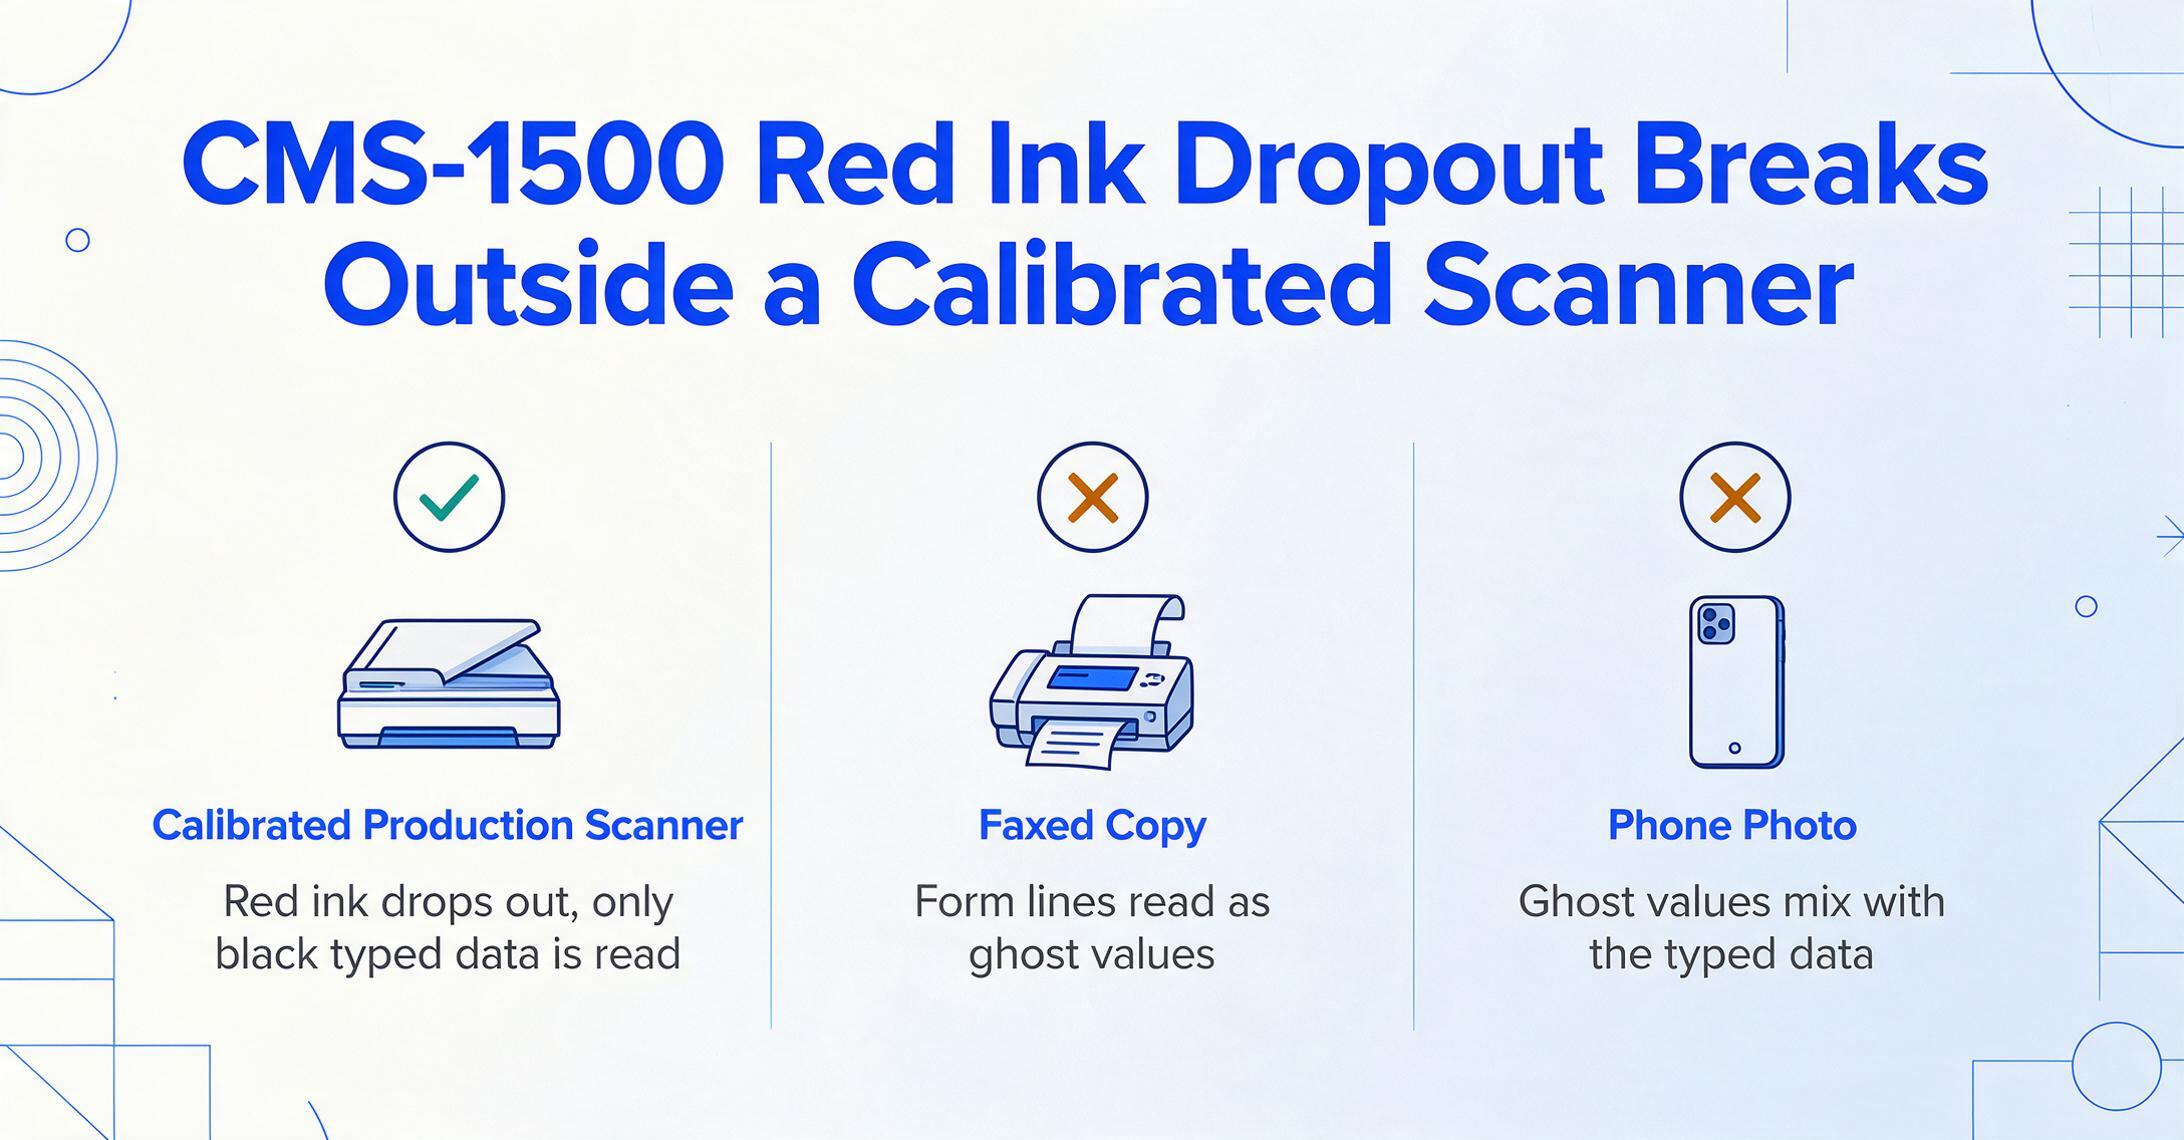
CMS-1500抽出には、一般的な文書OCRツールでは対応できない課題があります。これを理解することが、実用的なソリューションを選ぶ第一歩です。
1. 赤インクのドロップアウト。 CMS-1500フォームはFlint OCR Red(J6983)インクで印刷されています。これは高速OCRスキャン中にドロップアウトするよう設計された特殊な配合で、黒で入力されたデータのみが読み取られ、フォームの線、フィールドラベル、ボックス枠はスキャナに認識されません。これはMedicare Administrative Contractorの処理センターで較正済み業務用スキャナを使用した場合に機能します。しかし、CMS-1500がFAXコピー、複合機でのスキャンコピー、または紙の請求書のスマホ写真として届いた場合、赤インクはきれいにドロップアウトしません。その結果、一般的なOCRツールはフィールドラベルやフォーム線をテキストとして読み取り、実際のデータにゴースト値が混ざったノイズの多い出力になります。
2. 1ボックス1文字の制約がある高密度グリッドレイアウト。 Box 24のサービス明細テーブルは、約4×6インチの固定スペースに6行のデータを収め、各行に10列あります。多くのフィールド(特にBox 24JのNPI番号とBox 24Eの診断ポインタ)では、小さな印刷ボックス内で文字レベルの精度が求められます。ボックス境界を越えたり隣接列ににじんだ手書き入力は、従来のゾーンベースOCRではフィールド全体を誤読します。問題は文字が判読不能なことではなく、列境界に対する空間的な位置が曖昧なことです。
3. ゼロトレランスのフィールドレベル精度要件。 Box 24DのCPTコードには正しい修飾子を含める必要があり、そうでなければ請求は拒否されます。Box 21のICD-10-CMコードは最も詳細なレベルまで報告する必要があります。合併症のない2型糖尿病は「E11.9」であり、「E11」だけでは不十分です。Box 17(紹介医療提供者)の10桁のNPIは桁の入れ替えがあってはなりません。Medicare Claims Processing Manual(第26章)は各フィールドの形式を正確に指定しており、支払者は提出時にこれらのルールを適用します。抽出精度は「おおまかな正確さ」で測定されるのではなく、支払者の検証に合格するかどうかで決まります。
テンプレート不要のAI抽出がこれらの課題にどう対応するか
従来のテンプレートベースのOCRツールでは、空白のフォームにフィールド領域を描画する必要があります。「Box 21はピクセル座標(x, y)で始まり、(x₂, y₂)で終わる」といった具合です。さらに、フォームのバージョンごと、スキャナーの較正ごと、用紙の向きごとに個別のテンプレートを維持する必要があります。CMS-1500がわずかに傾いて届いたり、ファックスのヘッダーが上部に印字されていたり、レイアウトが異なるバリアントだったりすると、領域座標がずれて抽出品質が低下します。
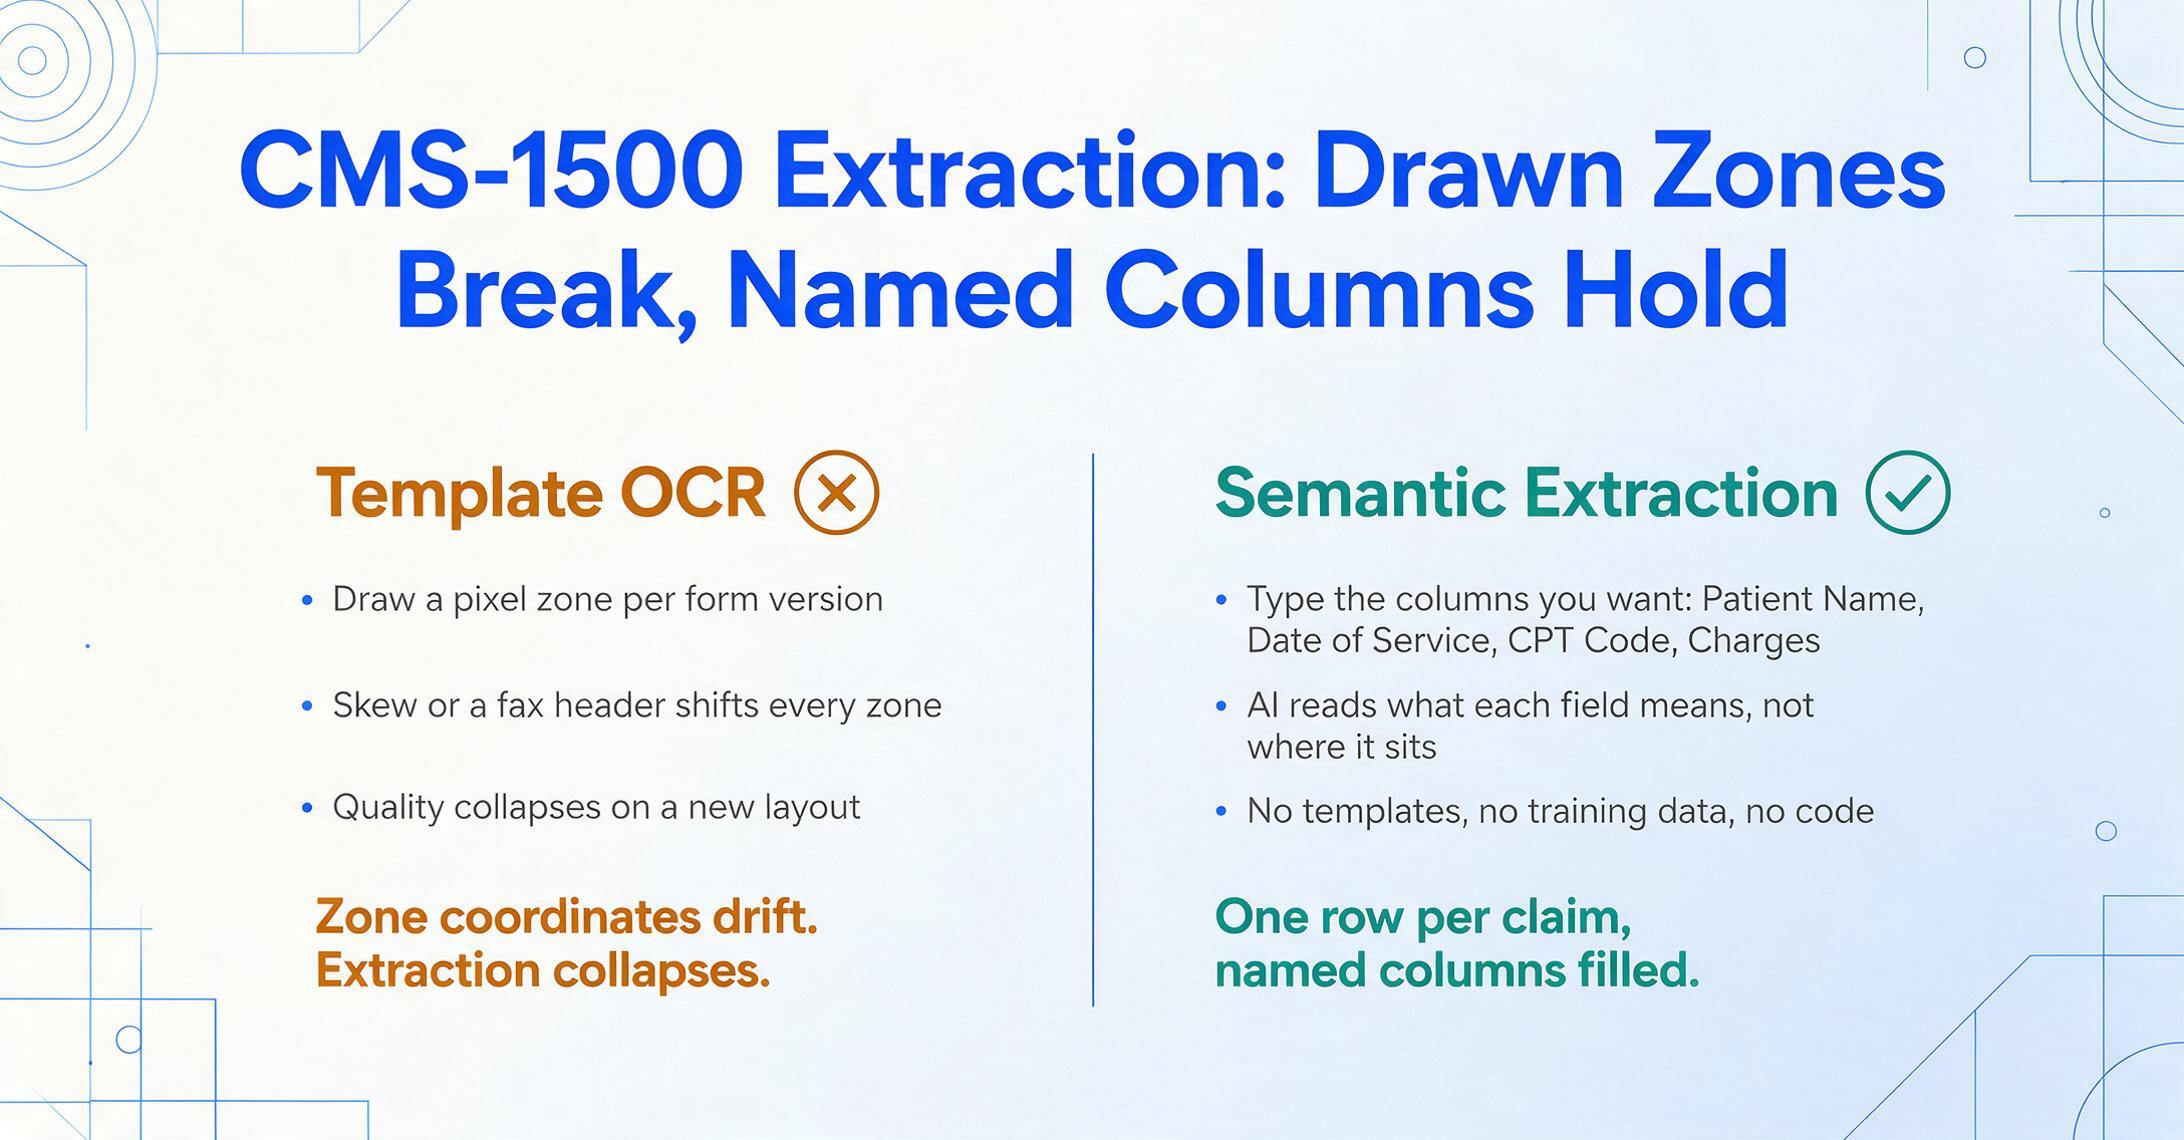
テンプレート不要のセマンティック抽出は、異なるアプローチを取ります。「このフィールドはページのどこにあるか」ではなく、「このフィールドは文書内で何を意味するか」を問います。出力は、必要な列に名前を付けて定義します。「患者名」「診療日」「CPTコード」「診断コード」「請求額」などです。AIはピクセル座標の一致ではなく、文書の構造とフィールドの意味を理解して各値を特定します。これはカスタム列抽出として知られています。必要なデータポイントの名前を入力すると、AIがフォームを読み取り、各データが文脈で何を意味するかを認識して各列を埋めます。
自動抽出に不慣れな請求チームにとって、このノーコードのアプローチは、トレーニングデータ、モデル設定、開発者の関与が不要です。アップロードして列に名前を付け、エクスポートするだけです。AIが文書理解を処理し、請求チームは請求の検証と提出を担当します。
このアプローチは、CMS-1500の特有の課題に直接対応します:
- 赤インクのドロップアウト:AIはデータが何を意味するか(事前に描画された領域のどこにあるかではなく)を読み取るため、専用スキャナーで赤インクが除去されていない場合でも、Box 24Dに入力された「99213」と、その上に印刷されたラベル「CPT/HCPCS」を区別できます。
- 高密度グリッドレイアウト:フォーム構造のセマンティックな理解により、AIはBox 24に6行10列のサービスデータがあることを認識します。ピクセル単位の完全な位置合わせに頼るのではなく、各セルにどのタイプの値(CPTコード、日付、請求額)が属するかを理解して読み取ります。
- フィールドレベルの精度:フィールドを特定する同じAIが形式も検証し、修飾子付きのCPTコードや適切な特異性レベルのICD-10コードを抽出します。出力は、提出前にスポットチェックできる構造化データであり、再入力が必要な生テキストではありません。
抽出は設計上バッチファーストであるため、複数のCMS-1500フォーム(数十枚または数百枚)を1つのバッチでアップロードし、すべてのフォームのデータが一貫した列にまとめられた1つの統合Excelテーブルを受け取ることができます。各フォームは個別に処理され、すべての結果は手動での統合なしに1つのスプレッドシートに結合されます。
CMS-1500データをExcelに抽出する方法:ステップバイステップ
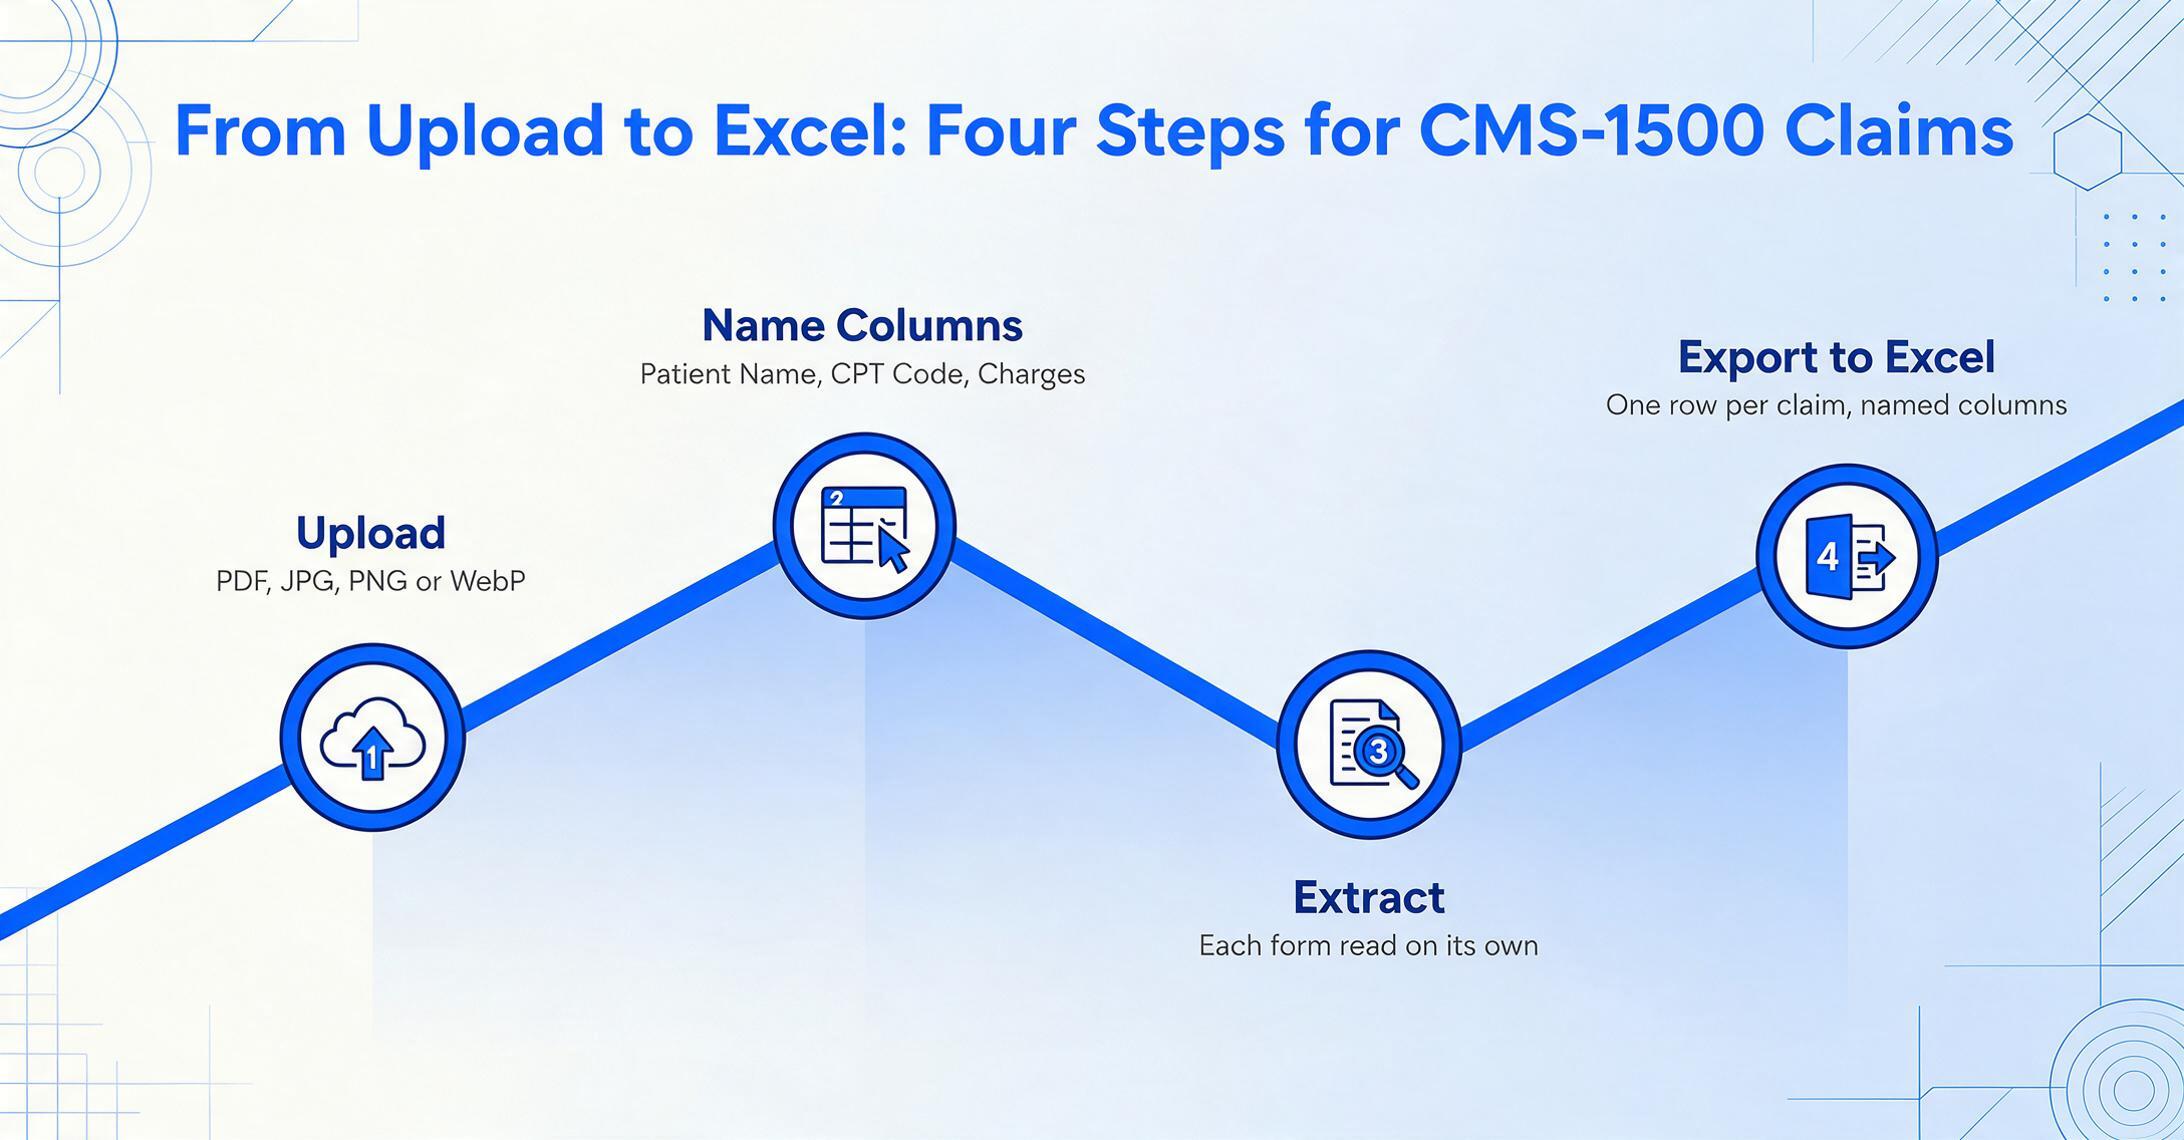
以下の手順では、テンプレート設定、トレーニング設定、コードは一切不要です。アカウントを作成せずに、サンプルのCMS-1500フォームでプロセスをテストできます。
ファイルは安全に処理され、保存されることはありません。
CMS-1500フォームから抽出する主要項目
抽出する項目は、請求チームが照合、監査、データ移行に何を必要とするかによって異なります。ほとんどのワークフローでは、以下の列でCMS-1500の必須データをカバーできます。
| 列名 | ボックス | 説明 |
|---|---|---|
| 患者名 | Box 2 | 患者の姓、名、ミドルネームの頭文字 |
| 生年月日 | Box 3 | 患者の生年月日(MMDDYYYY形式) |
| 保険種別 | Box 1 | メディケア、メディケイド、TRICARE、CHAMPVA、グループ保険、FECA、その他 |
| 保険証/ID番号 | Box 1a / Box 11 | 保険証に記載されている被保険者のID番号 |
| 診断コード | Box 21 | ICD-10-CMコード(最大12件)、最も詳細なレベルで報告 |
| サービス日 | Box 24A | 各サービス明細の開始日と終了日 |
| サービス場所 | Box 24B | サービス提供場所を示すPOSコード(11=診療所、22=外来病院など) |
| CPT/HCPCSコード | Box 24D | 最大4つの修飾子を含む手技コード |
| 診断ポインタ | Box 24E | このサービス明細をBox 21の診断コードにリンクする文字(A~L) |
| 請求額 | Box 24F | このサービス明細の請求金額 |
| 単位数 | Box 24G | このサービス明細の日数または単位数 |
| 実施提供者NPI | Box 24J | 実施提供者の10桁のNPI |
| 請求提供者NPI | Box 33A | 請求提供者の10桁のNPI |
| 合計請求額 | Box 28 | 全サービス明細の合計請求金額 |
これは網羅的なリストではありません。ワークフローによっては、紹介元提供者NPI(Box 17)、事前承認番号(Box 23)、患者番号(Box 26)なども必要になる場合があります。列名の付け方を自由に定義することで、プロセスに本当に必要な項目を正確に指定できます。
精度について:限界を正直に解説
Medicare Administrative Contractorsに提出される紙の請求書の大半を占める、タイプ打ちまたはコンピューター印字されたCMS-1500(診療報酬明細書)の場合、抽出エンジンは構造化された医療文書でトレーニングされたビジョンAIに期待される高い精度で、全33ボックスを確実に処理します。印字された文字認識は、製品仕様書に記載されている精度範囲に近い性能を、明瞭な印字データに対して発揮します。
精度が低下する可能性があるシナリオが2つあります。これらを率直に共有することで、請求チームがレビュー工程を計画しやすくなります。
手書きのフォーム。手書きで記入されたCMS-1500フォームにはばらつきが生じ、高度なAIでも100%解決できない場合があります。医師の筆記体による診断コード、急いで書かれた修飾子、数字が互いに接触しているNPIなどは、フィールドごとの精度を低下させる可能性があります。Vision AIは従来のOCRよりも手書き文字の処理に優れており、明瞭なブロック体の手書きであれば抽出は信頼できます。ただし、手書きフォームを大量に処理する請求チームは、抽出された値を原本と照合するスポットチェックの時間を予算に組み込む必要があります。これは、患者受付フォームから診療記録に至るまで、医療におけるあらゆる手書き文字認識シナリオに当てはまる現実です。
フォームの品質。低解像度のFAX(200 DPI以下)、コピーのコピー、斜めから撮影されて影が入った写真で届いたCMS-1500フォームは、クリーンなスキャンに比べて抽出精度が低下します。赤インクのドロップアウト問題もこれに拍車をかけます。キャリブレーション済みの赤色フィルタースキャナーの利点なしに、AIがタイプ打ちされたデータとフォームの罫線を分離する必要があるためです。前処理技術によって失われた品質の一部を回復できますが、目に見えて状態の悪いフォームは、優先的な手動レビューの対象としてフラグを立てるべきです。
実務上の指針
CMS-1500フォームを処理する請求チームに推奨されるワークフローは、まずすべてのフォームをAI抽出にかけ、その後、抽出結果のサンプルを原本と照合してスポットチェックするというものです。一般的な請求チームの場合、これは抽出されたフォームの10〜20%をレビューしてフィールド精度を確認することを意味します。すべてのフォームのすべての値を手入力する必要はありません。これはプロの医療請求業務で使用されているものと同じスポットチェック検証アプローチであり、完全な手動入力と比較して大幅な時間節約を実現しながら、監査可能な精度を維持します。
よくある質問
同じツールでCMS-1500とUB-04の両方の請求書を処理できますか?
はい、抽出はテンプレート照合ではなく意味理解に基づいているため、再設定なしで同じバッチ内で両方のフォームタイプを処理できます。CMS-1500(医師やクリニックが使用する専門請求書)はUB-04(病院が使用する施設請求書)とはレイアウトが異なりますが、同じ列名アプローチが両方に機能します。AIが読み取っているフォームタイプを識別し、それに応じてフィールド認識を調整します。
CMS-1500の抽出はHIPAAに準拠していますか?
CMS-1500フォームを処理するツールは、患者名、生年月日、保険ID、診療記録番号などの保護対象医療情報(PHI)を扱う必要があります。ImageToTable.aiは暗号化された送信でファイルを安全に処理し、アップロードされた文書をAIトレーニングに使用しません。正式なHIPAA準拠要件を持つ請求チーム向けに、HIPAA医療文書抽出ガイドでは、医療データ処理に関する具体的なコンプライアンス上の考慮事項を説明しています。署名済みのビジネスアソシエイト契約(BAA)を必要とする組織は、患者データを処理する前に適用範囲を確認する必要があります。
すでに電子提出している場合、CMS-1500データの抽出は役立ちますか?
請求の大部分が電子837P提出で処理される場合でも、紙のCMS-1500フォームはいくつかのワークフローで依然として発生します:再提出が必要な修正請求、添付書類を伴う異議申し立て、ASCA困難免除の対象となるプロバイダーからの請求、紙での提出が必要な給付調整のシナリオなどです。これらの紙フォームからデータを抽出してExcelで提出前に確認することで、電子ワークフローがすでに提供しているのと同じ構造化された検証を得られます。
Box 24に複数のサービス明細がある場合、抽出はどのように処理しますか?
AIはBox 24が最大6行のサービス明細データにわたって繰り返されることを認識します。各行は独立して抽出され、それぞれの診療日、CPTコード、請求額、診断ポインタが出力され、出力列にはこの行レベルの粒度が反映されます。フォームごとにサービス明細ごとに出力テーブルに1行が生成されるため、個々の明細項目を簡単に監査できます。
抽出は請求が拒否された理由を特定するのに役立ちますか?
間接的には、はい。拒否された請求の紙のCMS-1500からすべてのフィールド値を構造化されたスプレッドシートに抽出することで、チームは提出された値を保険者要件と一括比較できます。Box 24Eの診断ポインタがBox 21のコードを参照しているか確認し、NPI形式が正しいか検証し、CPT修飾子がサービス場所コードと一致しているかを確認できます。構造化された出力により、拒否調査は文書ごとの手動検索から、フィルタリング可能なデータ分析タスクに変わります。請求が支払われた後は、同じワークフローを拡張して、結果のEOBからのデータ抽出による照合が可能になり、請求ライフサイクルの両側で請求チームに構造化データを提供します。
請求プロバイダーNPI(Box 33)と実施プロバイダーNPI(Box 24J)の違いは何ですか?
請求プロバイダーNPIは、請求を提出し支払いを受け取る事業体(通常は診療所、クリニック、または専門法人)を識別します。実施プロバイダーNPIは、実際にサービスを実施した個々の臨床医を識別します。複数プロバイダーの診療所では、これらは異なるNPIであることがよくあります。CMS-1500フォームでは両方が必須であり、支払者は実施プロバイダーが請求プロバイダーのNPI記録に関連付けられていることを検証します。抽出出力はこの区別を保持し、請求チームが提出前に一致を確認できるようにする必要があります。
CMS-1500データがスプレッドシートでご利用いただけます
CMS-1500フォームの設計 — 33のボックス、約90のデータ項目、密集したグリッドレイアウト、相互依存するフィールド — は、手動処理が最も難しい医療文書の一つです。すべてのフィールドが重要であり、すべてのフィールドの依存関係が維持されなければなりません。そして、データ入力エラーによって失敗する請求は、償還サイクルに30日から60日を追加します。
テンプレートマッチングや静的ゾーン座標に依存する抽出ツールは、異なるスキャン品質、ファックスアーティファクト、手書き文字がフォームに現れるとすぐに機能しなくなります。セマンティック抽出 — 各フィールドの位置ではなく意味を理解してフォームを読み取る方法 — は、設定、テンプレート、トレーニングを必要とせずにCMS-1500の特有の課題を処理します。出力は構造化されたExcelファイルで、請求チームが監査し、支払者要件に対して検証し、診療管理ワークフローにインポートできます。
ご自身のCMS-1500フォームでプロセスをテストしてください。フォームあたり90のデータ項目を手動入力で5分かけるか、AI抽出で5秒で処理するか — どちらのワークフローが請求業務に適しているかをお決めください。