Comment extraire les données des
formulaires de réclamation médicale CMS-1500 vers Excel
Le formulaire CMS-1500 capture tout ce dont un assureur a besoin pour traiter une réclamation professionnelle — données démographiques du patient, couverture d'assurance, codes de diagnostic ICD-10-CM, codes de procédure CPT avec modificateurs, dates de service, frais et identifiants du prestataire répartis sur 33 cases numérotées. Tout tient sur une seule page dans une grille dense conçue pour la lisibilité humaine, pas pour l'extraction automatique. Cette densité explique pourquoi le formulaire fonctionne si efficacement pour l'adjudication des réclamations — et exactement pourquoi la saisie manuelle de ses données dans un tableur ou un système de facturation génère autant d'erreurs.
Points clés à retenir
- Vous vous blâmez lorsqu'une réclamation CMS-1500 est refusée, mais un pointeur de diagnostic dans la case 24E qui ne fait pas référence à un code ICD-10 valide dans la case 21 est une erreur invisible à l'œil humain au moment de la saisie.
- Cette seule incohérence entre champs reviendra sous forme de refus 30 à 60 jours plus tard, et le temps passé à enquêter efface chaque minute que la saisie manuelle était censée faire gagner.
- L'extraction sémantique par IA qui lit le formulaire en comprenant la signification de chaque champ vous permet d'auditer la sortie structurée par rapport aux règles du payeur au lieu de saisir chaque valeur — en détectant les erreurs de dépendance avant le payeur.
Qu'est-ce que le formulaire CMS-1500 ?
Le CMS-1500 — encore souvent appelé HCFA-1500 — est le formulaire standardisé de demande de remboursement de soins de santé utilisé par les médecins, thérapeutes, cliniques et autres prestataires de soins non hospitaliers pour facturer Medicare, Medicaid et les assureurs privés pour des services professionnels. Il est géré par le National Uniform Claim Committee (NUCC), un organisme de normalisation bénévole présidé par l'American Medical Association, avec les Centers for Medicare & Medicaid Services comme partenaire clé. La version actuelle — formulaire 02/12 — a été approuvée en février 2012 et est devenue le format papier obligatoire en avril 2014. Le NUCC a publié le manuel d'instructions version 13.0 en juillet 2025, reflétant les mises à jour les plus récentes des règles de champs et des exigences de codage.
Les 33 cases numérotées du formulaire se répartissent en trois zones fonctionnelles :
- Cases 1 à 13 — Informations sur le patient et l'assurance : nom du patient, date de naissance, sexe, adresse, numéro de police d'assurance, nom de l'assuré, lien avec l'assuré, détails de coordination des prestations.
- Cases 14 à 23 — Détails de l'affection et autorisation : dates de la maladie ou de la blessure, dates d'hospitalisation, date du dernier jour travaillé, informations d'orientation, codes de diagnostic CIM-10-CM (jusqu'à 12), numéro d'autorisation préalable, codes de resoumission Medicaid.
- Cases 24 à 33 — Lignes de service et données du prestataire facturant : six lignes d'articles de service (dates de service, lieu de service, code CPT/HCPCS, modificateurs, pointeur de diagnostic, frais, unités), nom du prestataire facturant, NPI, numéro d'identification fiscale, signature du prestataire.
Entre ces cases, environ 90 points de données individuels doivent être présents sur une demande complète et soumettable. Ce n'est pas une exagération — le manuel de spécification du formulaire fait plus de 60 pages détaillant les règles de format pour chaque champ.
Pourquoi la saisie manuelle des données CMS-1500 est un goulot d'étranglement
Un spécialiste de la facturation qui traite des formulaires CMS-1500 papier suit le même cycle, formulaire après formulaire : regarder le document, identifier chaque valeur de champ, trouver le champ correspondant dans le logiciel de facturation ou la feuille de calcul, le saisir, le vérifier par rapport à la source, puis passer à l'entrée suivante. Avec environ 90 points de données par réclamation, et les lignes de services dans le bloc 24A–J se répétant sur six lignes, la charge cognitive s'accumule rapidement. Une seule ligne du bloc 24 comprend les dates de début et de fin des services (24A), le code du lieu de service (24B), l'indicateur d'urgence (24C), le code CPT ou HCPCS avec jusqu'à quatre modificateurs (24D), un pointeur de diagnostic renvoyant au bloc 21 (24E), le montant facturé (24F), le nombre de jours ou d'unités (24G), et le NPI du prestataire traitant (24J).
Ce qui distingue le CMS-1500 de la saisie de documents génériques, c'est la chaîne de dépendances entre les champs. Le pointeur de diagnostic dans le bloc 24E doit faire référence à un code ICD-10-CM valide présent dans le bloc 21. Le code CPT dans le bloc 24D doit être approprié au code du lieu de service dans le bloc 24B. Le NPI dans le bloc 24J doit correspondre aux dossiers d'inscription du prestataire dans le bloc 33. Ces relations entre champs sont invisibles pour la personne qui saisit les données — elles ne se manifestent que lorsque la réclamation est refusée, des semaines plus tard, avec un code de rejet indiquant « Le pointeur de diagnostic ne fait pas référence à un code de diagnostic valide. »
La communauté r/CodingandBilling sur Reddit fait régulièrement remonter ces frustrations : des facturateurs demandant si un modificateur doit être ajouté à une ligne spécifique, si le code de taxonomie dans le bloc 33b correspond à l'enregistrement NPPES, ou si un centre d'échange rejettera une réclamation où le NPI de l'établissement de services dans le bloc 32a ne correspond pas au prestataire traitant. Ce ne sont pas des lacunes de connaissances — c'est la conséquence naturelle d'un formulaire qui regroupe des dizaines de champs interdépendants sur une seule page et qui repose sur la transcription manuelle pour les remplir correctement à chaque fois.
Pour une vue plus large sur la façon dont l'extraction CMS-1500 s'intègre aux EOB, aux réclamations UB-04 et aux autres documents de payeurs, consultez notre guide OCR pour la santé. Si vous comparez des outils spécifiquement sur la précision de l'extraction des formulaires de réclamation, notre tour d'horizon des outils d'extraction de données de réclamation teste sept plateformes sur de véritables documents CMS-1500 et EOB.
Trois raisons pour lesquelles l'extraction CMS-1500 est plus difficile que pour d'autres documents médicaux
L'extraction CMS-1500 présente des défis que la plupart des outils OCR génériques ne sont pas conçus pour gérer. Les comprendre est la première étape pour choisir une solution viable.
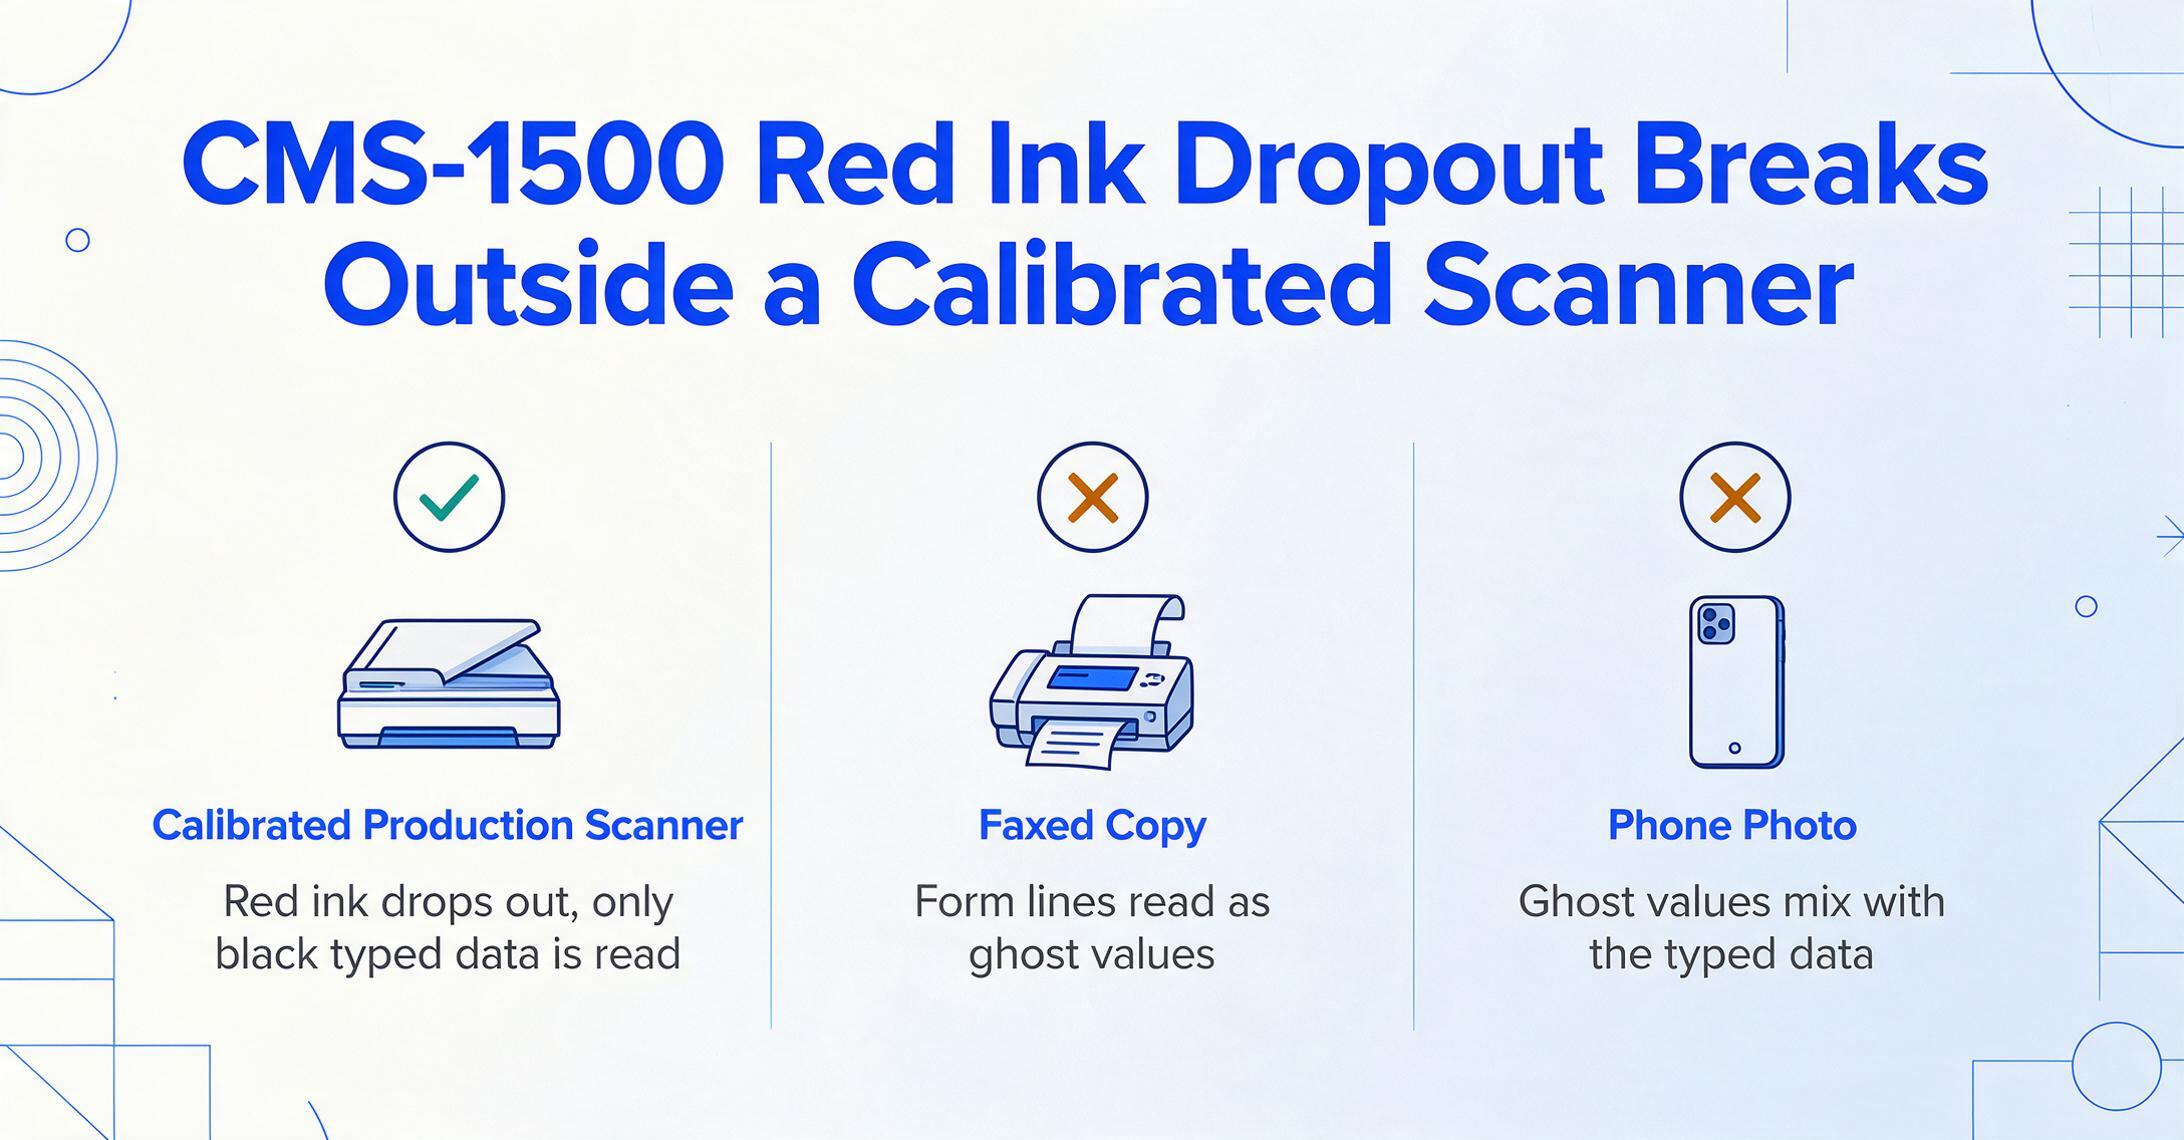
1. Disparition de l'encre rouge. Les formulaires CMS-1500 sont imprimés avec de l'encre Flint OCR Red (J6983) — une formulation spécifique conçue pour disparaître lors de la numérisation OCR à haute vitesse afin que seules les données saisies (tapées en noir) soient lues, tandis que les lignes du formulaire, les étiquettes de champs et les bordures de cases sont invisibles pour le scanner. Cela fonctionne dans les centres de traitement des entrepreneurs administratifs de Medicare avec des scanners de production calibrés. Mais lorsqu'un CMS-1500 arrive sous forme de copie faxée, de photocopie numérisée sur une imprimante multifonction, ou de photo de téléphone d'une réclamation papier, l'encre rouge ne disparaît pas proprement. Le résultat : les outils OCR génériques lisent les étiquettes de champs et les lignes du formulaire comme du texte, produisant un mélange bruyant de valeurs fantômes mélangées aux données réelles.
2. Disposition en grille dense avec contraintes de caractère par case. Le tableau des lignes de services de la case 24 comprime six lignes de données dans un espace fixe d'environ 4 sur 6 pouces, avec 10 colonnes par ligne. De nombreux champs — en particulier les numéros NPI dans la case 24J et les pointeurs de diagnostic dans la case 24E — exigent une précision au niveau du caractère à l'intérieur de petites cases imprimées. Les saisies manuscrites qui dépassent les limites des cases ou empiètent sur les colonnes adjacentes font que l'OCR zonale traditionnelle lit mal le champ entier. Le problème n'est pas que les caractères sont illisibles — c'est que leur position spatiale par rapport aux limites des colonnes est ambiguë.
3. Exigences de précision au niveau du champ avec tolérance zéro. Un code CPT dans la case 24D doit inclure le modificateur correct, sinon la réclamation est refusée. Un code ICD-10-CM dans la case 21 doit être déclaré au plus haut niveau de spécificité — « E11.9 » pour le diabète de type 2 sans complications, pas seulement « E11. » Un NPI à 10 chiffres dans la case 17 (prestataire référent) ne doit pas avoir de chiffres transposés. Le Medicare Claims Processing Manual (chapitre 26) précise exactement comment chaque champ doit être formaté, et les payeurs appliquent ces règles au moment de la soumission. La précision de l'extraction ne se mesure pas en « exactitude générale » — elle passe la validation du payeur ou elle échoue.
Comment l'extraction IA sans modèle gère ces défis
Les outils OCR traditionnels basés sur des modèles exigent de dessiner des zones de champ sur un formulaire vierge — « La case 21 commence aux coordonnées de pixel (x, y) et se termine à (x₂, y₂) » — et de maintenir des modèles séparés pour chaque version de formulaire, calibrage de scanner et orientation papier. Lorsqu'un CMS-1500 arrive avec une légère inclinaison, un en-tête de télécopie tamponné en haut, ou une variante de mise en page différente, les coordonnées de zone dérivent et la qualité d'extraction s'effondre.
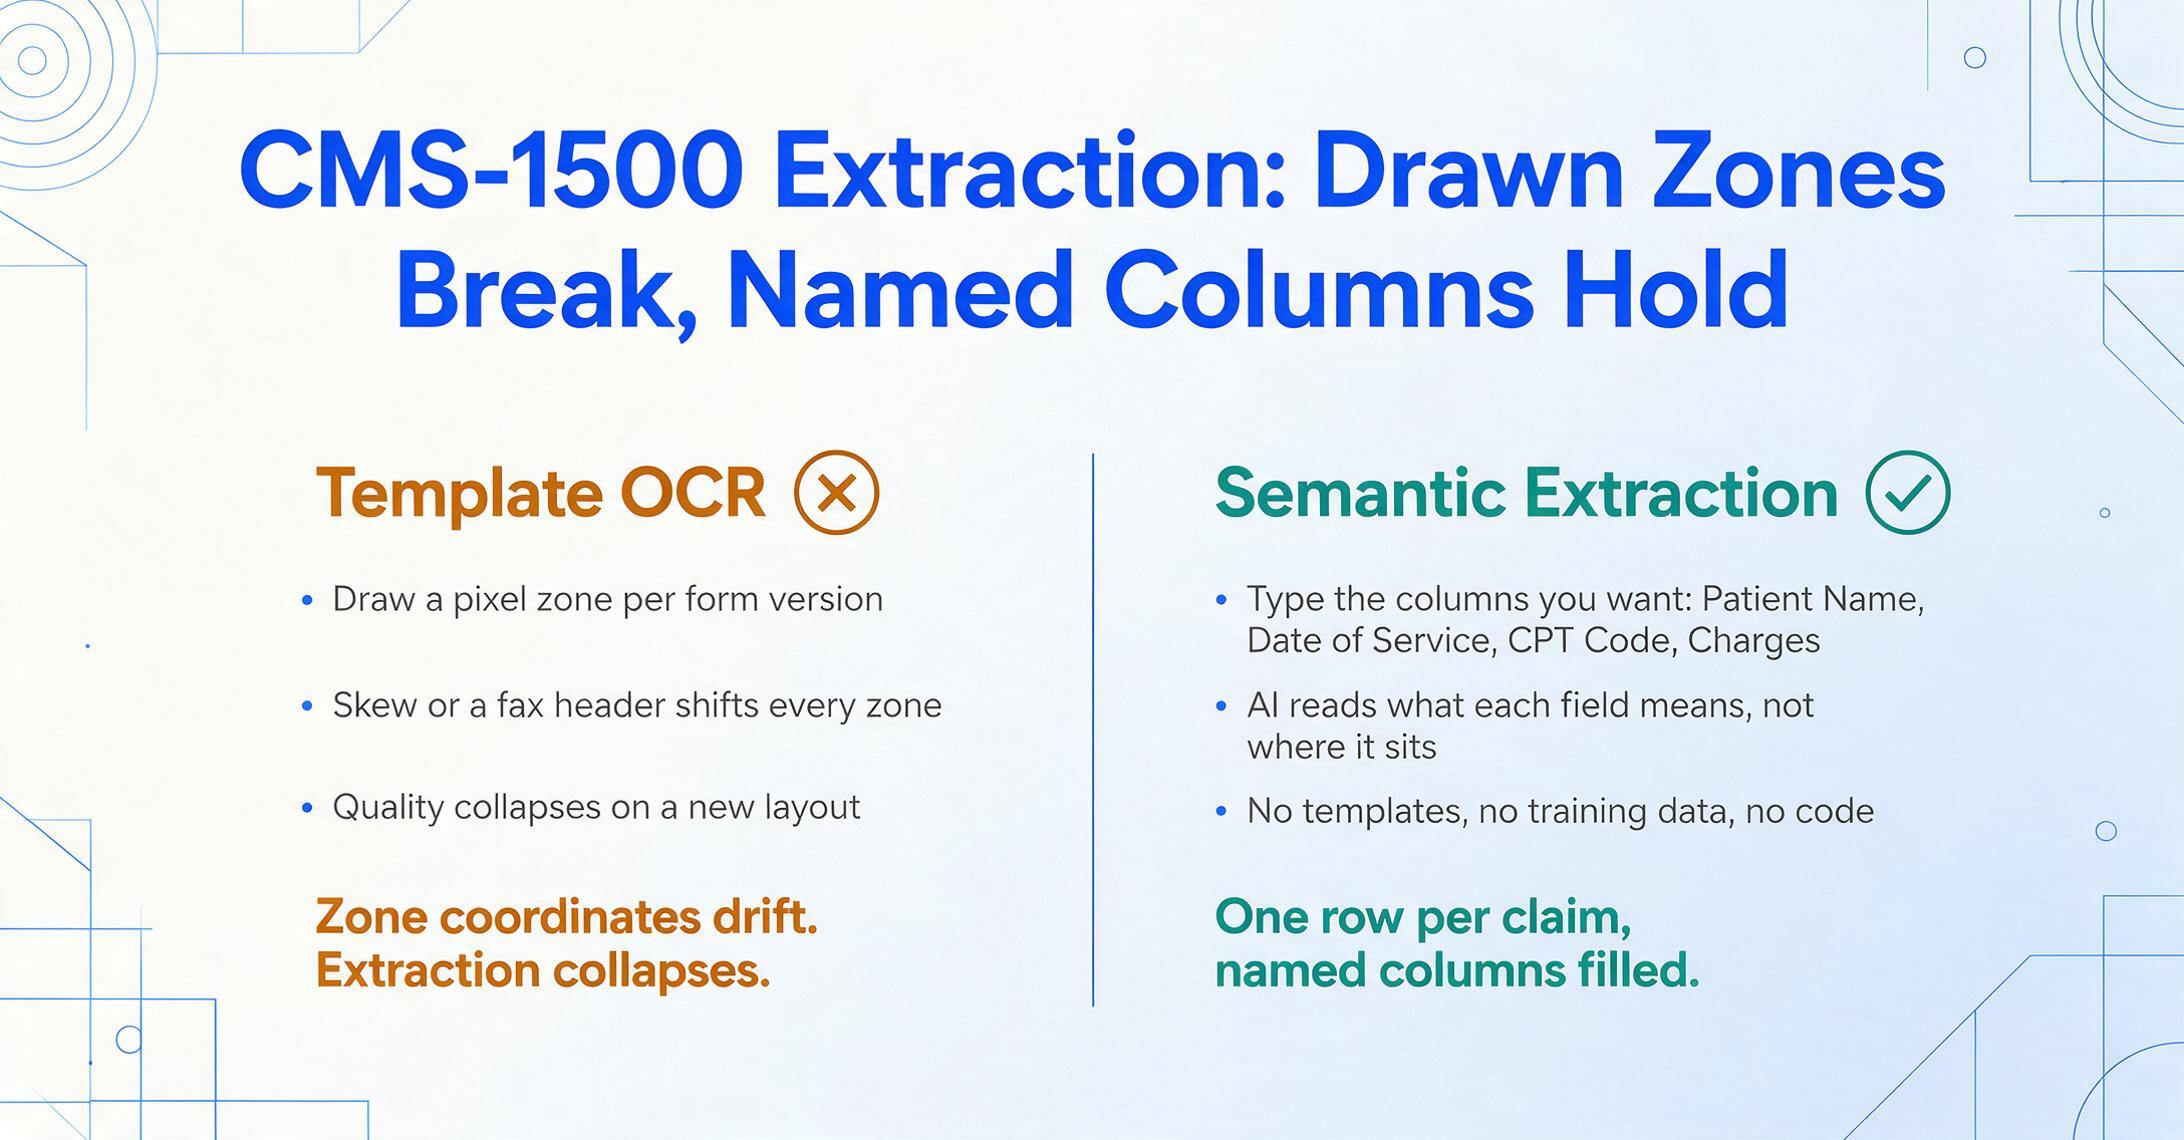
Une approche d'extraction sémantique sans modèle fonctionne différemment. Au lieu de demander « où se trouve ce champ sur la page ? », elle demande « que signifie ce champ dans le document ? » Vous définissez la sortie en nommant les colonnes souhaitées — « Nom du patient », « Date de service », « Code CPT », « Code de diagnostic », « Frais » — et l'IA localise chaque valeur en comprenant la structure du document et la sémantique des champs, et non en faisant correspondre des coordonnées de pixel. C'est ce qu'on appelle l'Extraction de colonnes personnalisées : vous saisissez les noms des points de données souhaités, et l'IA lit le formulaire et remplit chaque colonne en reconnaissant ce que chaque donnée signifie dans son contexte.
Pour les équipes de facturation novices en matière d'extraction automatisée, cette approche sans code signifie aucune donnée d'entraînement, aucune configuration de modèle et aucune implication de développeur — il suffit de téléverser, nommer les colonnes et exporter. L'IA gère la compréhension du document ; l'équipe de facturation gère la validation et la soumission de la réclamation.
Cette approche gère directement les défis spécifiques du CMS-1500 :
- Suppression de l'encre rouge : Parce que l'IA lit ce que les données signifient (et non où elles se trouvent sur une zone pré-dessinée), elle peut distinguer le « 99213 » saisi dans la case 24D de l'étiquette imprimée « CPT/HCPCS » au-dessus, même lorsque l'encre rouge n'a pas été filtrée par un scanner spécialisé.
- Disposition en grille dense : La compréhension sémantique de la structure du formulaire permet à l'IA de reconnaître que la case 24 comporte six lignes et dix colonnes de données de service. Elle lit chaque cellule en comprenant quel type de valeur y appartient — un code CPT, une date, un montant de frais — et non en s'appuyant sur un alignement parfait au pixel près.
- Précision au niveau du champ : La même IA qui localise le champ valide également son format, extrayant les codes CPT avec leurs modificateurs et les codes ICD-10 au niveau de spécificité correct. La sortie est des données structurées qui peuvent être vérifiées ponctuellement avant soumission, et non du texte brut nécessitant une ressaisie.
Parce que l'extraction est conçue pour le traitement par lots en priorité, vous pouvez téléverser plusieurs formulaires CMS-1500 — des dizaines ou des centaines — en un seul lot et recevoir un tableau Excel unifié avec les données de chaque formulaire dans des colonnes cohérentes. Chaque formulaire est traité indépendamment, tous les résultats sont fusionnés dans une seule feuille de calcul sans consolidation manuelle.
Comment extraire les données CMS-1500 vers Excel : étape par étape
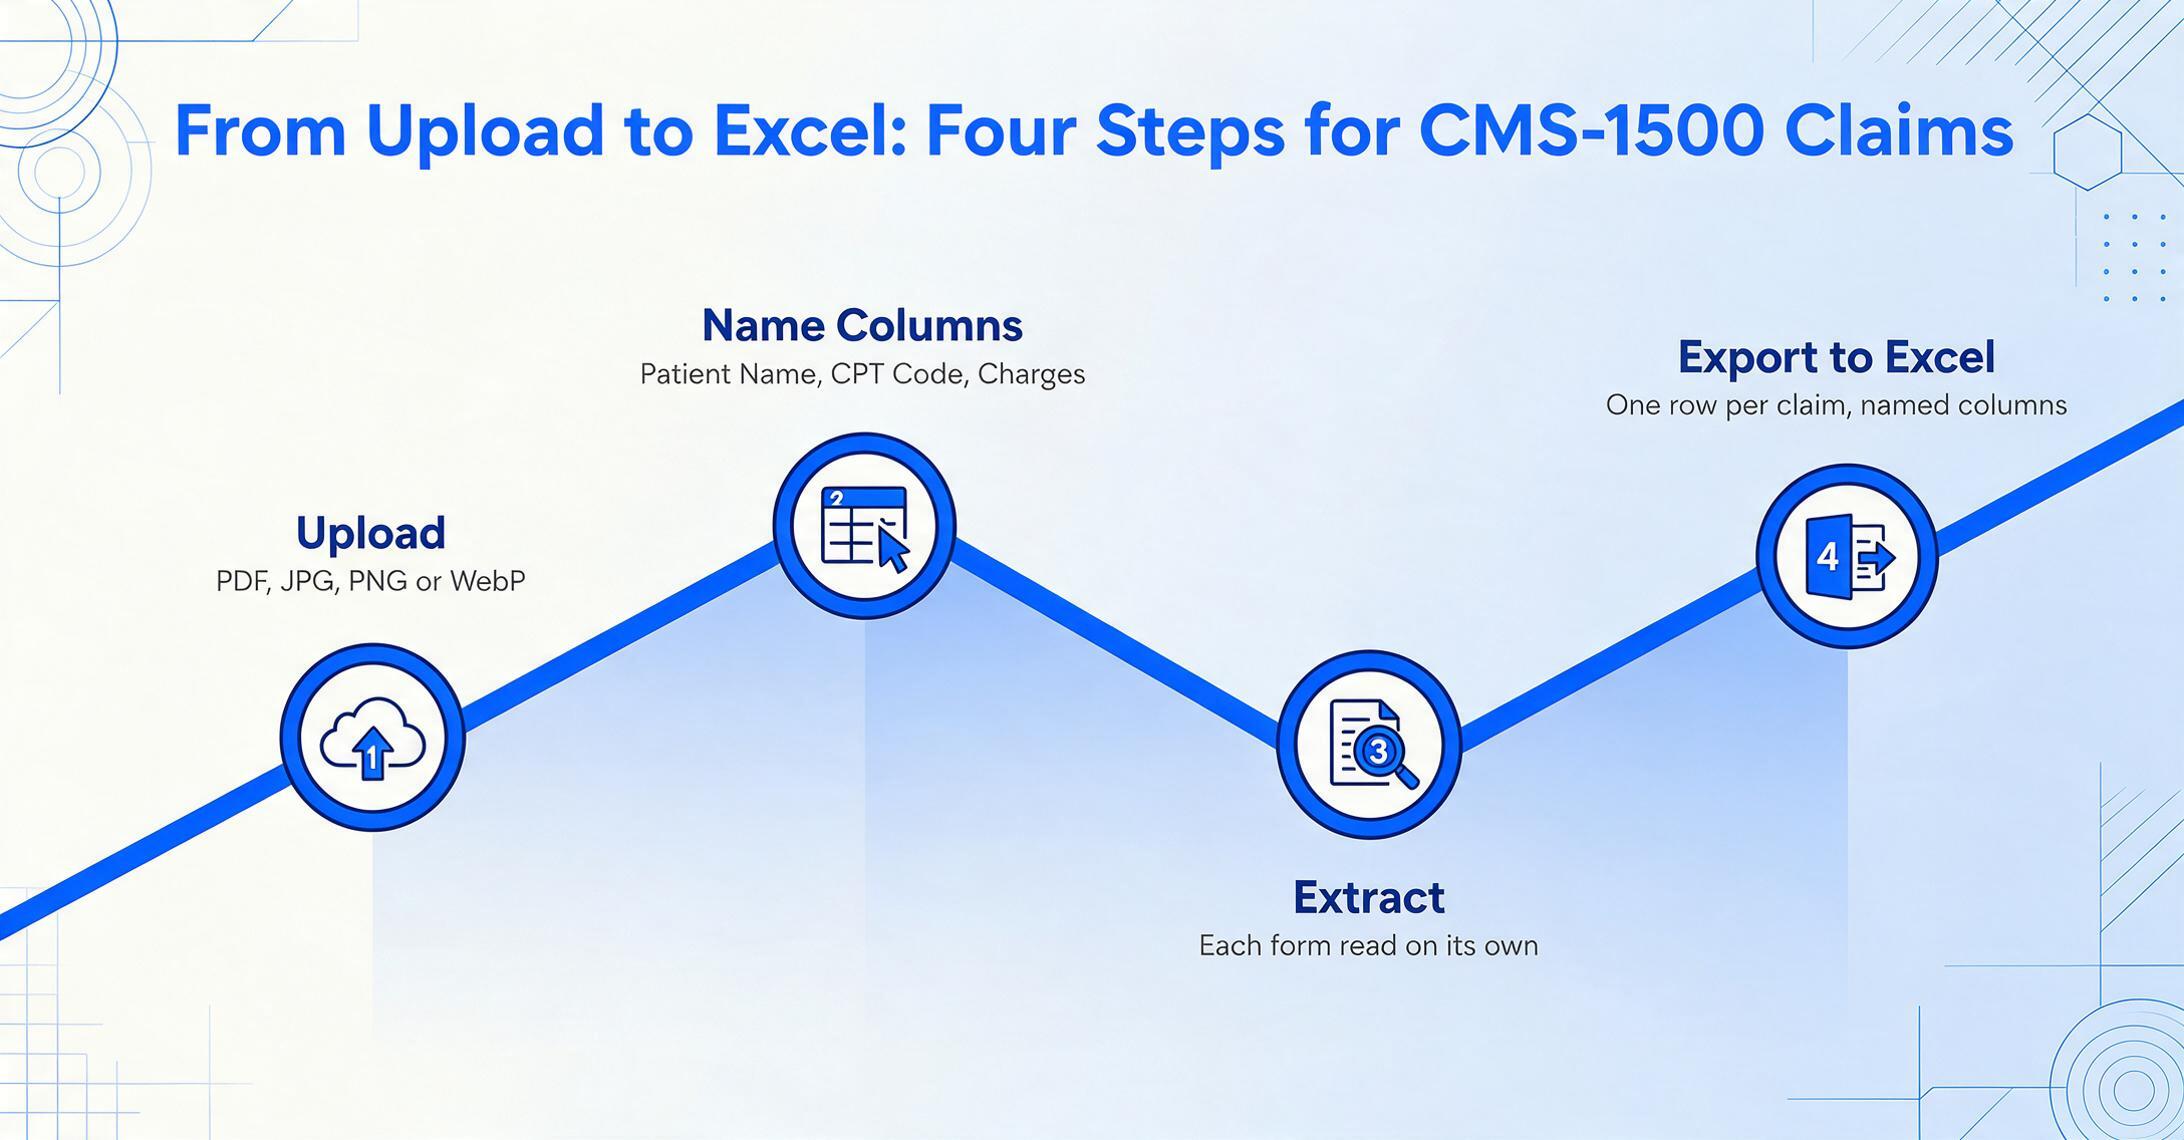
La procédure suivante ne nécessite aucune configuration de modèle, aucune configuration d'entraînement et aucun code. Vous pouvez tester le processus sur un formulaire CMS-1500 d'exemple sans créer de compte.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Champs clés à extraire des formulaires CMS-1500
Les champs que vous extrayez dépendent des besoins de votre équipe de facturation pour le rapprochement, l'audit ou la migration de données. Pour la plupart des flux de travail, les colonnes suivantes couvrent les points de données essentiels du CMS-1500 :
| Nom de la colonne | Case | Description |
|---|---|---|
| Nom du patient | Case 2 | Nom de famille, prénom, initiale du deuxième prénom du patient |
| Date de naissance | Case 3 | Date de naissance du patient (format MMDDAAAA) |
| Type d'assurance | Case 1 | Medicare, Medicaid, TRICARE, CHAMPVA, Assurance collective, FECA, Autre |
| Numéro de police/ID | Case 1a / Case 11 | Numéro d'ID de l'assuré tel qu'il figure sur la carte d'assurance |
| Codes de diagnostic | Case 21 | Codes CIM-10-CM (jusqu'à 12), rapportés avec la plus haute spécificité |
| Date de service | Case 24A | Dates de début et de fin pour chaque ligne de service |
| Lieu de service | Case 24B | Code POS indiquant où le service a été rendu (11 = cabinet, 22 = hôpital ambulatoire, etc.) |
| Code CPT/HCPCS | Case 24D | Code de procédure avec jusqu'à quatre modificateurs |
| Pointeur de diagnostic | Case 24E | Lettre (A–L) reliant cette ligne de service à un code de diagnostic dans la case 21 |
| Frais | Case 24F | Montant facturé pour cette ligne de service |
| Unités | Case 24G | Jours ou unités pour cette ligne de service |
| NPI du prestataire traitant | Case 24J | NPI à 10 chiffres du prestataire traitant |
| NPI du prestataire facturant | Case 33A | NPI à 10 chiffres du prestataire facturant |
| Frais totaux | Case 28 | Total des frais facturés pour toutes les lignes de service |
Cette liste n'est pas exhaustive — selon votre flux de travail, vous pouvez également souhaiter le NPI du prestataire référent (case 17), le numéro d'autorisation préalable (case 23) ou le numéro de compte du patient (case 26). L'approche de dénomination des colonnes vous permet de définir exactement ce qui est important pour votre processus.
Qu'en est-il de la précision ? Un regard honnête sur les limites
Pour les formulaires CMS-1500 dactylographiés ou imprimés par ordinateur — la majorité des réclamations papier soumises aux entrepreneurs administratifs de Medicare — le moteur d'extraction traite de manière fiable les 33 cases avec la haute précision que l'on attend d'une IA de vision entraînée sur des documents médicaux structurés. La reconnaissance du texte imprimé se rapproche de la plage de précision documentée dans les spécifications du produit pour des données imprimées claires.
Il existe deux scénarios où la précision peut être moindre, et être transparent à ce sujet aide les équipes de facturation à planifier leur processus de vérification :
Formulaires manuscrits. Les formulaires CMS-1500 remplis à la main introduisent une variabilité que même une IA avancée ne peut pas toujours résoudre à 100 %. Un code de diagnostic en écriture cursive d'un médecin, un modificateur écrit à la hâte ou un NPI dont les chiffres se touchent peuvent réduire la précision par champ. L'IA de vision gère mieux l'écriture manuscrite que l'OCR traditionnel, et pour une écriture claire en lettres majuscules, l'extraction est fiable — mais les équipes de facturation traitant un volume élevé de formulaires manuscrits doivent prévoir une vérification ponctuelle des valeurs extraites par rapport aux documents sources. C'est la même réalité qui s'applique à tout scénario de reconnaissance d'écriture manuscrite dans le secteur de la santé, des formulaires d'admission des patients aux notes cliniques.
Qualité du formulaire. Un CMS-1500 reçu sous forme de fax basse résolution (200 DPI ou moins), une photocopie d'une photocopie, ou une photo prise en angle avec des ombres aura une précision d'extraction inférieure à celle d'un scan propre. Le problème de la suppression de l'encre rouge aggrave la situation, car l'IA doit séparer les données dactylographiées des lignes du formulaire sans l'avantage d'un scanner calibré avec filtre rouge. Les techniques de prétraitement peuvent récupérer une partie de cette qualité perdue, mais les formulaires en mauvais état visible doivent être signalés pour une vérification manuelle prioritaire.
Conseils pratiques
Le flux de travail recommandé pour les équipes de facturation traitant les formulaires CMS-1500 est le suivant : exécutez d'abord tous les formulaires via l'extraction IA, puis vérifiez ponctuellement un échantillon des résultats par rapport aux documents sources. Pour l'équipe de facturation typique, cela signifie vérifier 10 à 20 % des formulaires extraits pour confirmer la précision des champs — pas saisir chaque valeur de chaque formulaire. C'est la même approche de vérification ponctuelle utilisée dans les opérations de facturation médicale professionnelles, et elle permet un gain de temps significatif par rapport à la saisie manuelle complète tout en maintenant une précision vérifiable.
Questions fréquemment posées
Le même outil peut-il traiter les formulaires CMS-1500 et UB-04 ?
Oui, car l'extraction repose sur une compréhension sémantique plutôt que sur la correspondance de modèles, il peut traiter les deux types de formulaires dans le même lot sans reconfiguration. Le CMS-1500 (réclamation professionnelle, utilisée par les médecins et les cliniques) a une mise en page différente de celle du UB-04 (réclamation institutionnelle, utilisée par les hôpitaux), mais la même approche par noms de colonnes fonctionne pour les deux — l'IA identifie le type de formulaire qu'elle lit et ajuste sa reconnaissance des champs en conséquence.
L'extraction CMS-1500 est-elle conforme à la HIPAA ?
Tout outil traitant des formulaires CMS-1500 doit gérer les informations de santé protégées (PHI) — noms des patients, dates de naissance, identifiants d'assurance, numéros de dossier médical. ImageToTable.ai traite les fichiers de manière sécurisée avec transmission chiffrée et n'utilise pas les documents téléchargés pour l'entraînement de l'IA. Pour les équipes de facturation ayant des exigences formelles de conformité HIPAA, le guide d'extraction de documents médicaux HIPAA couvre les considérations de conformité spécifiques au traitement des données de santé. Les organisations qui exigent un contrat d'associé commercial (BAA) signé doivent vérifier la couverture avant de traiter les données des patients.
L'extraction des données CMS-1500 aide-t-elle si nous soumettons déjà par voie électronique ?
Même lorsque la majorité de vos réclamations passent par la soumission électronique 837P, les formulaires papier CMS-1500 apparaissent encore dans plusieurs flux de travail : réclamations corrigées nécessitant une nouvelle soumission, appels avec documentation justificative, réclamations de prestataires admissibles à la dérogation pour difficultés ASCA, et scénarios de coordination des prestations où le papier est requis. Extraire les données de ces formulaires papier dans Excel pour examen avant soumission vous offre la même validation structurée que les flux de travail électroniques fournissent déjà.
Comment l'extraction gère-t-elle la case 24 avec plusieurs lignes de services ?
L'IA reconnaît que la case 24 se répète sur jusqu'à six lignes de données de services. Chaque ligne est extraite indépendamment — ses propres dates de service, code CPT, montants et pointeur de diagnostic — et les colonnes de sortie reflètent cette granularité au niveau de la ligne. Vous obtenez une ligne dans le tableau de sortie pour chaque ligne de service et chaque formulaire, ce qui facilite l'audit des postes individuels.
L'extraction peut-elle nous aider à identifier pourquoi une réclamation a été refusée ?
Indirectement, oui. En extrayant l'ensemble des valeurs de champs d'un formulaire CMS-1500 papier refusé dans un tableur structuré, votre équipe peut comparer les valeurs soumises aux exigences du payeur en masse : vérifier si le pointeur de diagnostic de la case 24E fait référence à un code de la case 21, confirmer que le format du NPI est correct et s'assurer que le modificateur CPT correspond au code du lieu de service. La sortie structurée transforme l'enquête sur les refus d'une recherche manuelle document par document en une tâche d'analyse de données filtrable. Une fois la réclamation payée, le même flux de travail peut être étendu à l'extraction de données de l'EOB résultant pour le rapprochement — offrant à votre équipe de facturation des données structurées des deux côtés du cycle de vie de la réclamation.
Quelle est la différence entre le NPI du fournisseur de facturation (case 33) et le NPI du fournisseur exécutant (case 24J) ?
Le NPI du fournisseur de facturation identifie l'entité qui soumet la réclamation et reçoit le paiement — généralement le cabinet, la clinique ou la société professionnelle. Le NPI du fournisseur exécutant identifie le clinicien individuel qui a réellement effectué le service. Dans les cabinets multi-fournisseurs, il s'agit souvent de NPI différents. Le formulaire CMS-1500 exige les deux, et les payeurs vérifient que le fournisseur exécutant est affilié au dossier NPI du fournisseur de facturation. Les sorties d'extraction doivent préserver cette distinction afin que les équipes de facturation puissent vérifier la correspondance avant la soumission.
Vos données CMS-1500 sont prêtes pour le tableur
La conception du formulaire CMS-1500 — 33 cases, environ 90 points de données, disposition en grille dense, champs interdépendants — en fait l'un des documents médicaux les plus difficiles à traiter manuellement. Chaque champ compte. Chaque dépendance entre champs doit être respectée. Et chaque demande rejetée à cause d'une erreur de saisie ajoute 30 à 60 jours au cycle de remboursement.
Les outils d'extraction basés sur la correspondance de modèles ou les coordonnées de zones statiques échouent dès que le formulaire arrive avec une qualité de numérisation différente, des artefacts de télécopie ou une écriture manuscrite. L'extraction sémantique — lire le formulaire en comprenant la signification de chaque champ, et non son emplacement — gère les défis spécifiques du CMS-1500 sans configuration, sans modèles et sans formation. Le résultat est un fichier Excel structuré que votre équipe de facturation peut auditer, valider par rapport aux exigences des payeurs et importer dans votre flux de travail de gestion de cabinet.
Testez le processus sur vos propres formulaires CMS-1500. Voyez si 90 points de données par formulaire nécessitent 5 minutes de saisie manuelle ou 5 secondes d'extraction par IA — et décidez quel flux de travail convient à votre opération de facturation.