So extrahieren Sie Daten aus
CMS-1500-Anspruchsformularen in Excel
Das CMS-1500-Formular erfasst alles, was ein Versicherer zur Bearbeitung eines professionellen Anspruchs benötigt – Patientendaten, Versicherungsabdeckung, ICD-10-CM-Diagnosecodes, CPT-Prozedurencodes mit Modifikatoren, Leistungsdaten, Gebühren und Anbieterkennungen in 33 nummerierten Feldern. All das passt auf eine einzige Seite in einem dichten Raster, das für menschliche Lesbarkeit ausgelegt ist, nicht für maschinelle Extraktion. Diese Dichte ist der Grund, warum das Formular so effizient für die Anspruchsprüfung funktioniert – und genau der Grund, warum die manuelle Eingabe seiner Daten in eine Tabellenkalkulation oder ein Abrechnungssystem so viele Fehler erzeugt.
Wichtigste Erkenntnisse
- Sie geben sich selbst die Schuld, wenn ein CMS-1500-Anspruch abgelehnt wird, aber ein Diagnoseverweis in Feld 24E, der keinen gültigen ICD-10-Code in Feld 21 referenziert, ist ein Fehler, der für menschliche Augen im Moment der Eingabe unsichtbar ist.
- Diese einzelne feldübergreifende Diskrepanz führt 30 bis 60 Tage später zu einer Ablehnung, und die Zeit, die für die Untersuchung aufgewendet wird, löscht jede Minute aus, die die manuelle Dateneingabe hätte sparen sollen.
- Semantische KI-Extraktion, die das Formular liest, indem sie versteht, was jedes Feld bedeutet, ermöglicht es Ihnen, strukturierte Ausgaben gegen Versichererregeln zu prüfen, anstatt jeden Wert einzutippen – und fängt Abhängigkeitsfehler ab, bevor der Versicherer es tut.
Was ist das CMS-1500-Formular?
Das CMS-1500 — noch immer häufig HCFA-1500 genannt — ist das standardisierte Krankenversicherungs-Abrechnungsformular, das von Ärzten, Therapeuten, Kliniken und anderen nicht-stationären Gesundheitsdienstleistern verwendet wird, um Medicare, Medicaid und private Versicherer für erbrachte Leistungen abzurechnen. Es wird vom National Uniform Claim Committee (NUCC) verwaltet, einem freiwilligen Normungsgremium unter Vorsitz der American Medical Association, mit den Centers for Medicare & Medicaid Services als wichtigem Partner. Die aktuelle Version — Formular 02/12 — wurde im Februar 2012 genehmigt und wurde im April 2014 zum verbindlichen Papierformat. Das NUCC veröffentlichte im Juli 2025 das Handbuch Version 13.0, das die aktuellsten Aktualisierungen der Feldregeln und Kodierungsanforderungen widerspiegelt.
Die 33 nummerierten Felder des Formulars gliedern sich in drei funktionale Bereiche:
- Feld 1–13 — Patienten- und Versicherungsinformationen: Patientenname, Geburtsdatum, Geschlecht, Adresse, Versicherungspolice-Nummer, Name des Versicherungsnehmers, Verhältnis zum Versicherungsnehmer, Angaben zur Leistungskoordination.
- Feld 14–23 — Angaben zum Zustand und Genehmigung: Daten der Erkrankung oder Verletzung, Krankenhausaufenthaltsdaten, Datum der letzten Arbeitsunfähigkeit, Überweisungsinformationen, ICD-10-CM-Diagnosecodes (bis zu 12), Vorabgenehmigungsnummer, Medicaid-Wiedereinreichungscodes.
- Feld 24–33 — Leistungszeilen und abrechnender Leistungserbringer: sechs Zeilen für Leistungspositionen (Leistungsdaten, Leistungsort, CPT/HCPCS-Code, Modifikatoren, Diagnoseverweis, Gebühren, Einheiten), Name des abrechnenden Leistungserbringers, NPI, Steuer-ID, Unterschrift des Leistungserbringers.
Zwischen diesen Feldern müssen auf einem vollständigen, einreichbaren Antrag etwa 90 einzelne Datenpunkte vorhanden sein. Dies ist keine Übertreibung — das Handbuch zur Formspezifikation umfasst über 60 Seiten mit detaillierten Formatregeln für jedes Feld.
Warum die manuelle CMS-1500-Dateneingabe ein Engpass ist
Ein Abrechnungsspezialist, der papierbasierte CMS-1500-Formulare verarbeitet, durchläuft Formular für Formular denselben Zyklus: Dokument ansehen, jeden Feldwert identifizieren, das passende Feld in der Abrechnungssoftware oder Tabelle finden, eingeben, mit der Quelle abgleichen und zum nächsten Eintrag übergehen. Bei etwa 90 Datenpunkten pro Anspruch, wobei sich die Leistungspositionszeilen in Box 24A–J über sechs Zeilen wiederholen, steigt die kognitive Belastung schnell an. Eine einzelne Zeile in Box 24 umfasst das Von- und Bis-Datum der Leistung (24A), den Ortscode der Leistungserbringung (24B), das Notfallkennzeichen (24C), den CPT- oder HCPCS-Code mit bis zu vier Modifikatoren (24D), einen Diagnoseverweis zurück auf Box 21 (24E), den abgerechneten Betrag (24F), die Anzahl der Tage oder Einheiten (24G) und die NPI des erbringenden Leistungserbringers (24J).
Was die CMS-1500 von der allgemeinen Dokumenteneingabe unterscheidet, ist die Kette von Feldabhängigkeiten. Der Diagnoseverweis in Box 24E muss auf einen gültigen ICD-10-Code verweisen, der in Box 21 vorhanden ist. Der CPT-Code in Box 24D muss zum Or der Leistungserbringung in Box 24B passen. Die NPI in Box 24J muss mit den Anbieterregistrierungsdaten in Box 33 übereinstimmen. Diese feldübergreifenden Beziehungen sind für die Person, die tippt, unsichtbar – sie treten erst zutage, wenn der Anspruch Wochen später mit einem Ablehnungscode zurückkommt, der besagt: „Der Diagnoseverweis verweist nicht auf einen gültigen Diagnosecode."
Die r/CodingandBilling-Community auf Reddit thematisiert diese Frustrationen regelmäßig: Abrechner fragen, ob ein Modifikator in eine bestimmte Zeile muss, ob der Taxonomiecode in Box 33b mit dem NPPES-Datensatz übereinstimmt oder ob eine Clearingstelle einen Anspruch ablehnt, bei dem die NPI der Leistungserbringungsstätte in Box 32a nicht mit dem erbringenden Leistungserbringer übereinstimmt. Das sind keine Wissenslücken – sie sind die natürliche Folge eines Formulars, das Dutzende voneinander abhängiger Felder auf einer einzigen Seite bündelt und sich darauf verlässt, dass die manuelle Übertragung jedes Mal korrekt ist.
Für einen breiteren Überblick darüber, wie die CMS-1500-Extraktion neben EOBs, UB-04-Anspruchsformularen und anderen Zahlungsdokumenten funktioniert, lesen Sie unseren OCR-Leitfaden für das Gesundheitswesen. Wenn Sie Tools speziell hinsichtlich der Genauigkeit bei der Extraktion von Anspruchsformularen vergleichen, testet unser Überblick über Extraktionstools für Gesundheitsdokumente sieben Plattformen anhand realer CMS-1500- und EOB-Dokumente.
Drei Gründe, warum die CMS-1500-Extraktion schwieriger ist als bei anderen medizinischen Dokumenten
Die CMS-1500-Extraktion stellt Herausforderungen dar, für die die meisten allgemeinen Dokument-OCR-Tools nicht ausgelegt sind. Diese zu verstehen ist der erste Schritt zur Wahl einer praktikablen Lösung.
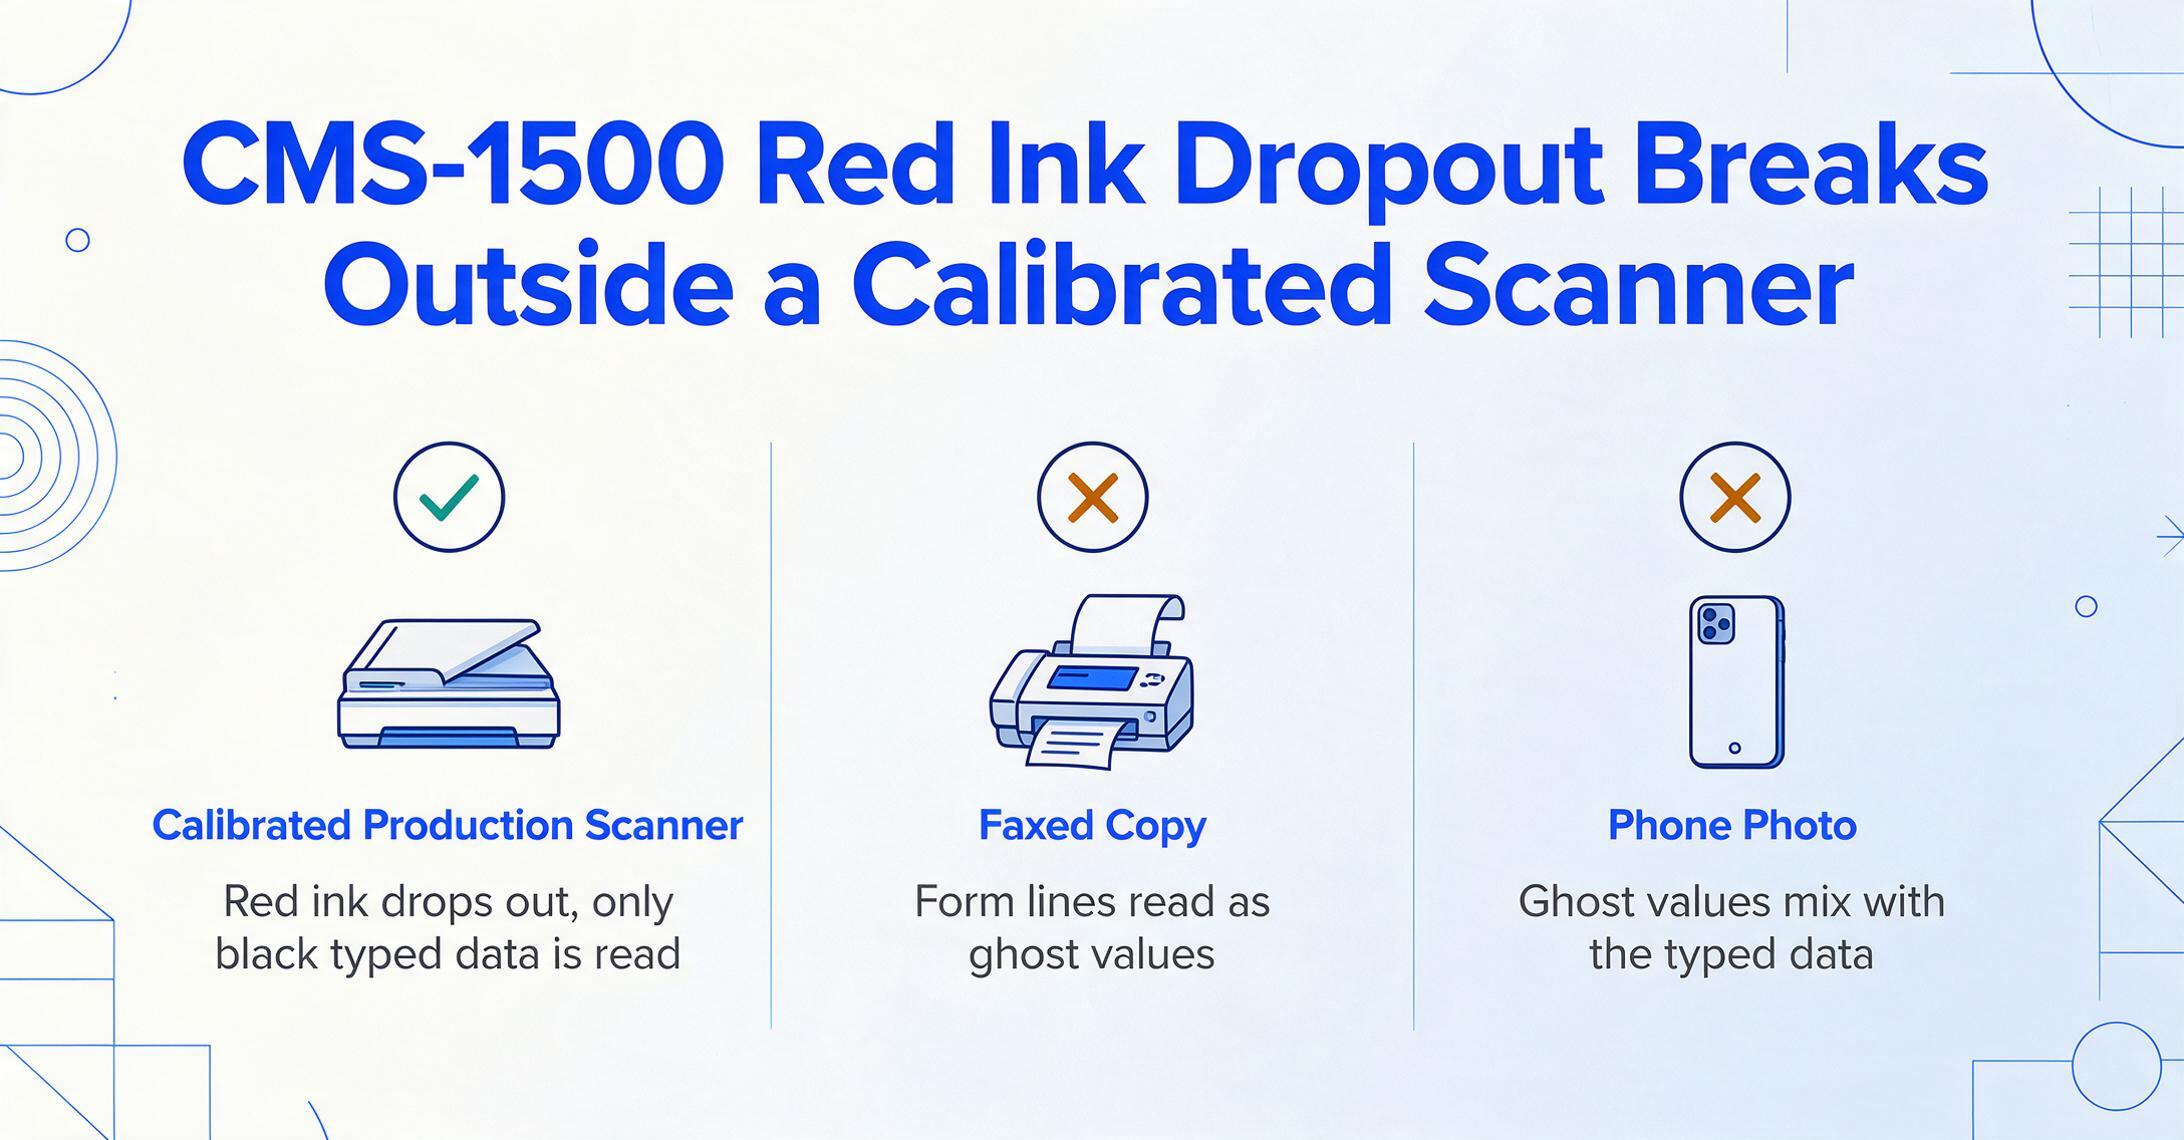
1. Rot-Ausblendung. CMS-1500-Formulare werden mit Flint OCR Red (J6983)-Tinte gedruckt – einer speziellen Formulierung, die beim Hochgeschwindigkeits-OCR-Scannen ausgeblendet wird, sodass nur die eingegebenen Daten (in Schwarz getippt) gelesen werden, während Formularlinien, Feldbeschriftungen und Kastenränder für den Scanner unsichtbar sind. Dies funktioniert in den Verarbeitungszentren der Medicare Administrative Contractor mit kalibrierten Produktionsscannern. Wenn ein CMS-1500 jedoch als Faxkopie, als gescannte Fotokopie auf einem Multifunktionsdrucker oder als Handyfoto eines Papieranspruchs eintrifft, wird die rote Tinte nicht sauber ausgeblendet. Das Ergebnis: Generische OCR-Tools lesen Feldbeschriftungen und Formularlinien als Text und erzeugen ein verrauschtes Durcheinander aus Geisterwerten, gemischt mit echten Daten.
2. Dichtes Rasterlayout mit Zeichen-pro-Kasten-Beschränkungen. Die Leistungspositionszeilentabelle in Kasten 24 packt sechs Datenzeilen in einen festen Raum von etwa 4 x 6 Zoll, mit 10 Spalten pro Zeile. Viele Felder – insbesondere NPI-Nummern in Kasten 24J und Diagnoseverweise in Kasten 24E – erfordern zeichengenaue Präzision in kleinen bedruckten Kästen. Handschriftliche Einträge, die Kastengrenzen überschreiten oder in benachbarte Spalten hineinragen, führen dazu, dass herkömmliche zonenbasierte OCR das Feld vollständig falsch liest. Das Problem ist nicht, dass die Zeichen unleserlich sind – sondern dass ihre räumliche Position relativ zu den Spaltengrenzen mehrdeutig ist.
3. Feldgenaue Präzisionsanforderungen ohne Toleranz. Ein CPT-Code in Kasten 24D muss den korrekten Modifikator enthalten, sonst wird der Anspruch abgelehnt. Ein ICD-10-CM-Code in Kasten 21 muss mit der höchsten Spezifitätsstufe angegeben werden – „E11.9" für Typ-2-Diabetes ohne Komplikationen, nicht nur „E11." Eine 10-stellige NPI in Kasten 17 (überweisender Leistungserbringer) darf keine vertauschten Ziffern aufweisen. Das Medicare Claims Processing Manual (Kapitel 26) legt genau fest, wie jedes Feld formatiert sein muss, und die Kostenträger setzen diese Regeln zum Zeitpunkt der Einreichung durch. Die Extraktionsgenauigkeit wird nicht in „allgemeiner Korrektheit" gemessen – sie besteht entweder die Validierung des Kostenträgers oder nicht.
Wie die KI-Extraktion ohne Vorlage diese Herausforderungen bewältigt
Traditionelle OCR-Tools mit Vorlagen erfordern, dass Sie Feldzonen auf einem leeren Formular zeichnen – „Box 21 beginnt bei Pixelkoordinate (x, y) und endet bei (x₂, y₂)“ – und separate Vorlagen für jede Formularversion, Scankalibrierung und Papierausrichtung pflegen. Wenn ein CMS-1500 mit einer leichten Schräglage, einem Faxkopf oben oder einer anderen Layoutvariante eintrifft, verschieben sich die Zonenkoordinaten und die Extraktionsqualität bricht ein.
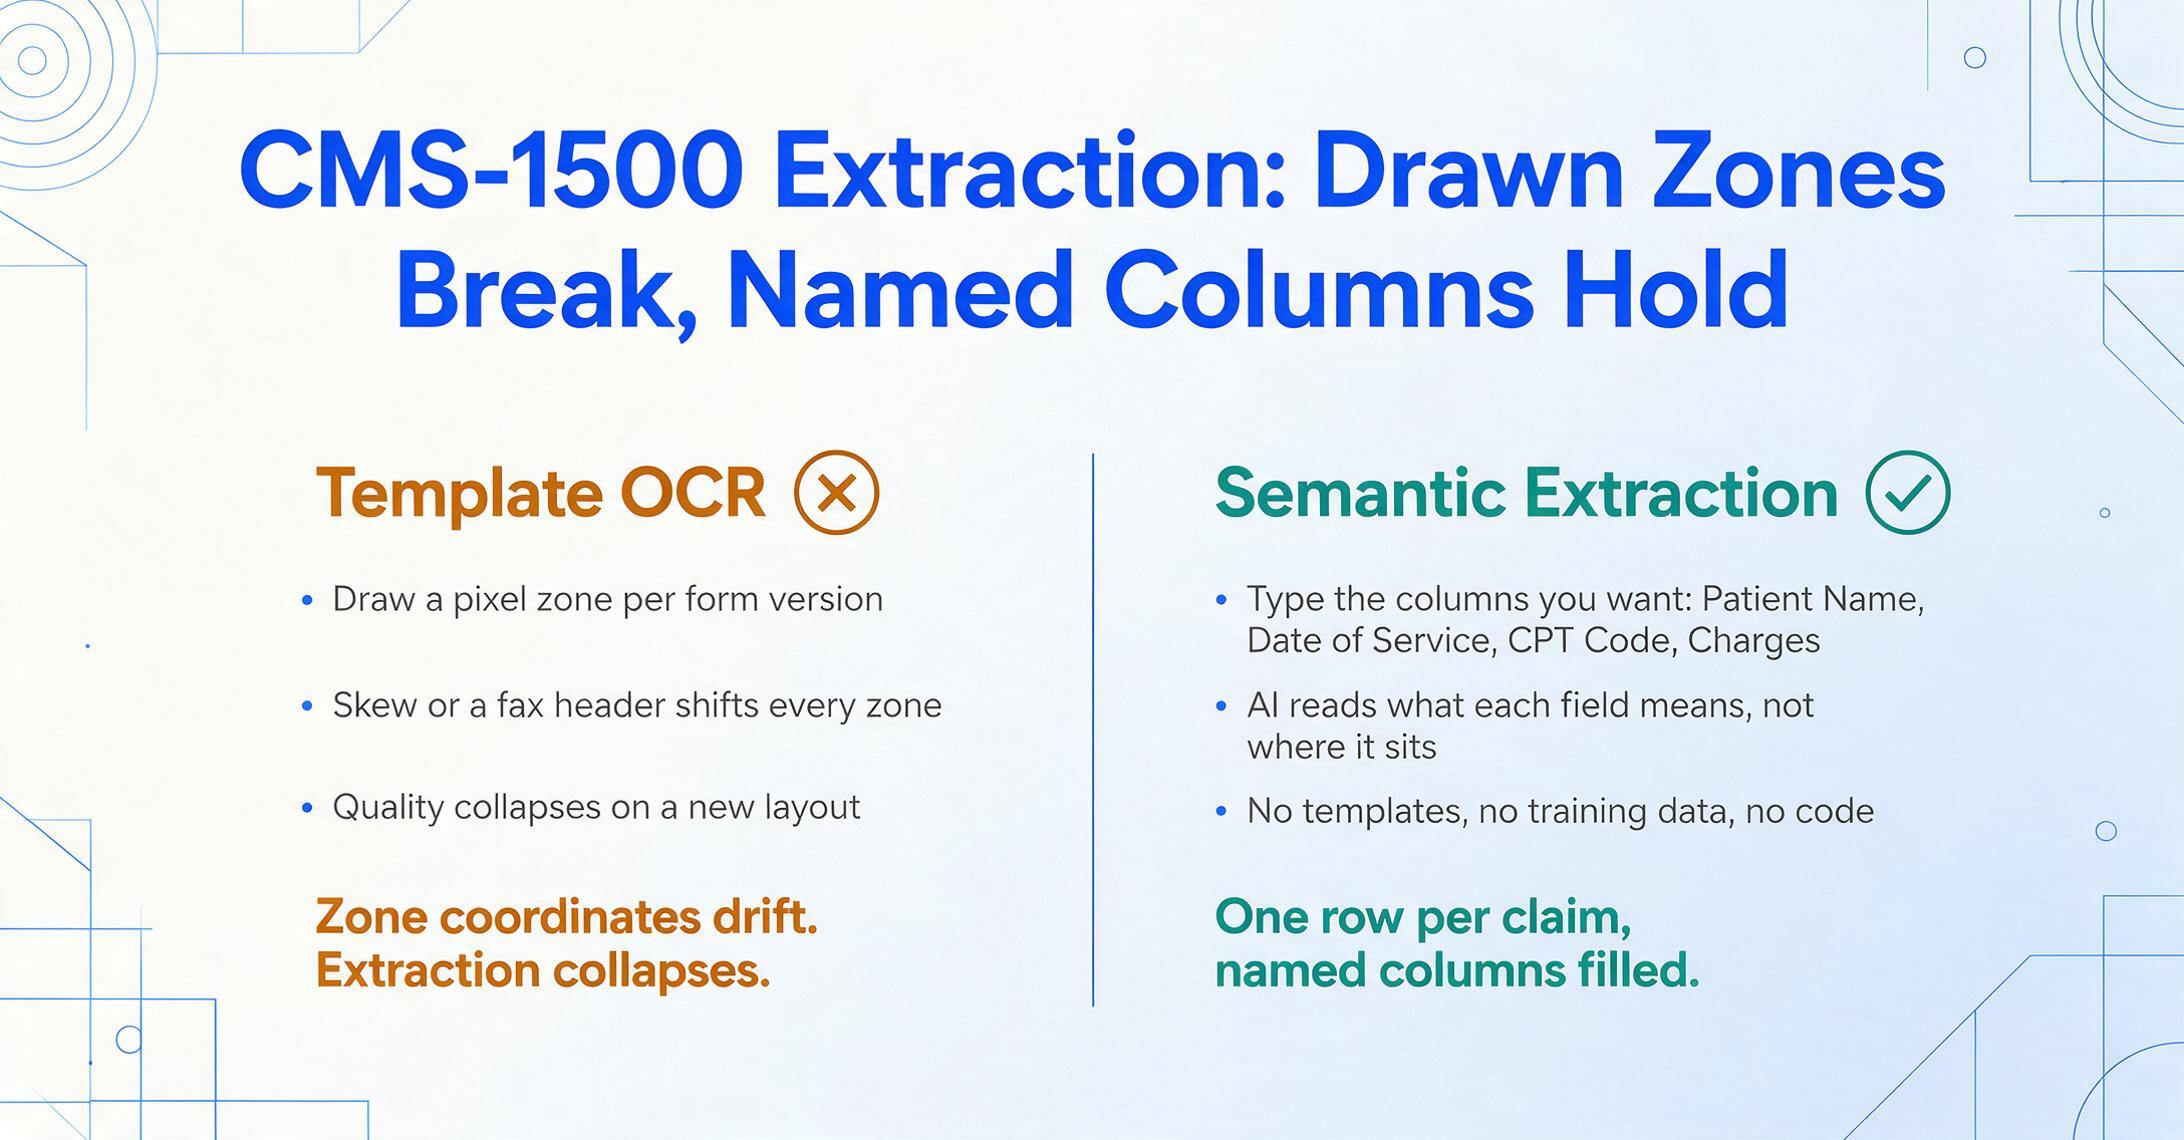
Ein Ansatz ohne Vorlage mit semantischer Extraktion funktioniert anders. Statt zu fragen „Wo befindet sich dieses Feld auf der Seite?“, fragt er „Was bedeutet dieses Feld im Dokument?“. Sie definieren die Ausgabe, indem Sie die gewünschten Spalten benennen – „Patientenname“, „Leistungsdatum“, „CPT-Code“, „Diagnosecode“, „Gebühren“ – und die KI lokalisiert jeden Wert, indem sie die Struktur des Dokuments und die Feldsemantik versteht, nicht durch den Abgleich von Pixelkoordinaten. Dies wird als Benutzerdefinierte Spaltenextraktion bezeichnet: Sie geben die Namen der gewünschten Datenpunkte ein, und die KI liest das Formular und füllt jede Spalte, indem sie erkennt, was jedes Datenelement im Kontext bedeutet.
Für Abrechnungsteams, die neu in der automatisierten Extraktion sind, bedeutet dieser No-Code-Ansatz keine Trainingsdaten, keine Modellkonfiguration und keine Entwicklerbeteiligung – einfach hochladen, Spalten benennen und exportieren. Die KI übernimmt das Dokumentverständnis; das Abrechnungsteam übernimmt die Anspruchsvalidierung und -einreichung.
Dieser Ansatz bewältigt die spezifischen Herausforderungen von CMS-1500 direkt:
- Ausblendung roter Tinte: Da die KI liest, was die Daten bedeuten (nicht, wo sie auf einer vorgezeichneten Zone liegen), kann sie das getippte „99213“ in Box 24D von der gedruckten Beschriftung „CPT/HCPCS“ darüber unterscheiden, selbst wenn rote Tinte nicht von einem Spezialscanner gefiltert wurde.
- Dichtes Rasterlayout: Das semantische Verständnis der Formularstruktur bedeutet, dass die KI erkennt, dass Box 24 sechs Zeilen und zehn Spalten mit Leistungsdaten enthält. Sie liest jede Zelle, indem sie versteht, welche Art von Wert dort hingehört – ein CPT-Code, ein Datum, ein Gebührenbetrag – und nicht durch pixelgenaue Ausrichtung.
- Präzision auf Feldebene: Dieselbe KI, die das Feld lokalisiert, validiert auch sein Format, extrahiert CPT-Codes mit ihren Modifikatoren und ICD-10-Codes auf der korrekten Spezifitätsebene. Die Ausgabe sind strukturierte Daten, die vor der Einreichung stichprobenartig geprüft werden können, nicht Rohtext, der neu eingegeben werden muss.
Da die Extraktion von Natur aus Batch-First ist, können Sie mehrere CMS-1500-Formulare – Dutzende oder Hunderte – in einem einzigen Batch hochladen und eine einheitliche Excel-Tabelle mit den Daten aller Formulare in konsistenten Spalten erhalten. Jedes Formular wird unabhängig verarbeitet, alle Ergebnisse werden ohne manuelle Zusammenführung in einer einzigen Tabelle zusammengeführt.
So extrahieren Sie CMS-1500-Daten in Excel: Schritt für Schritt
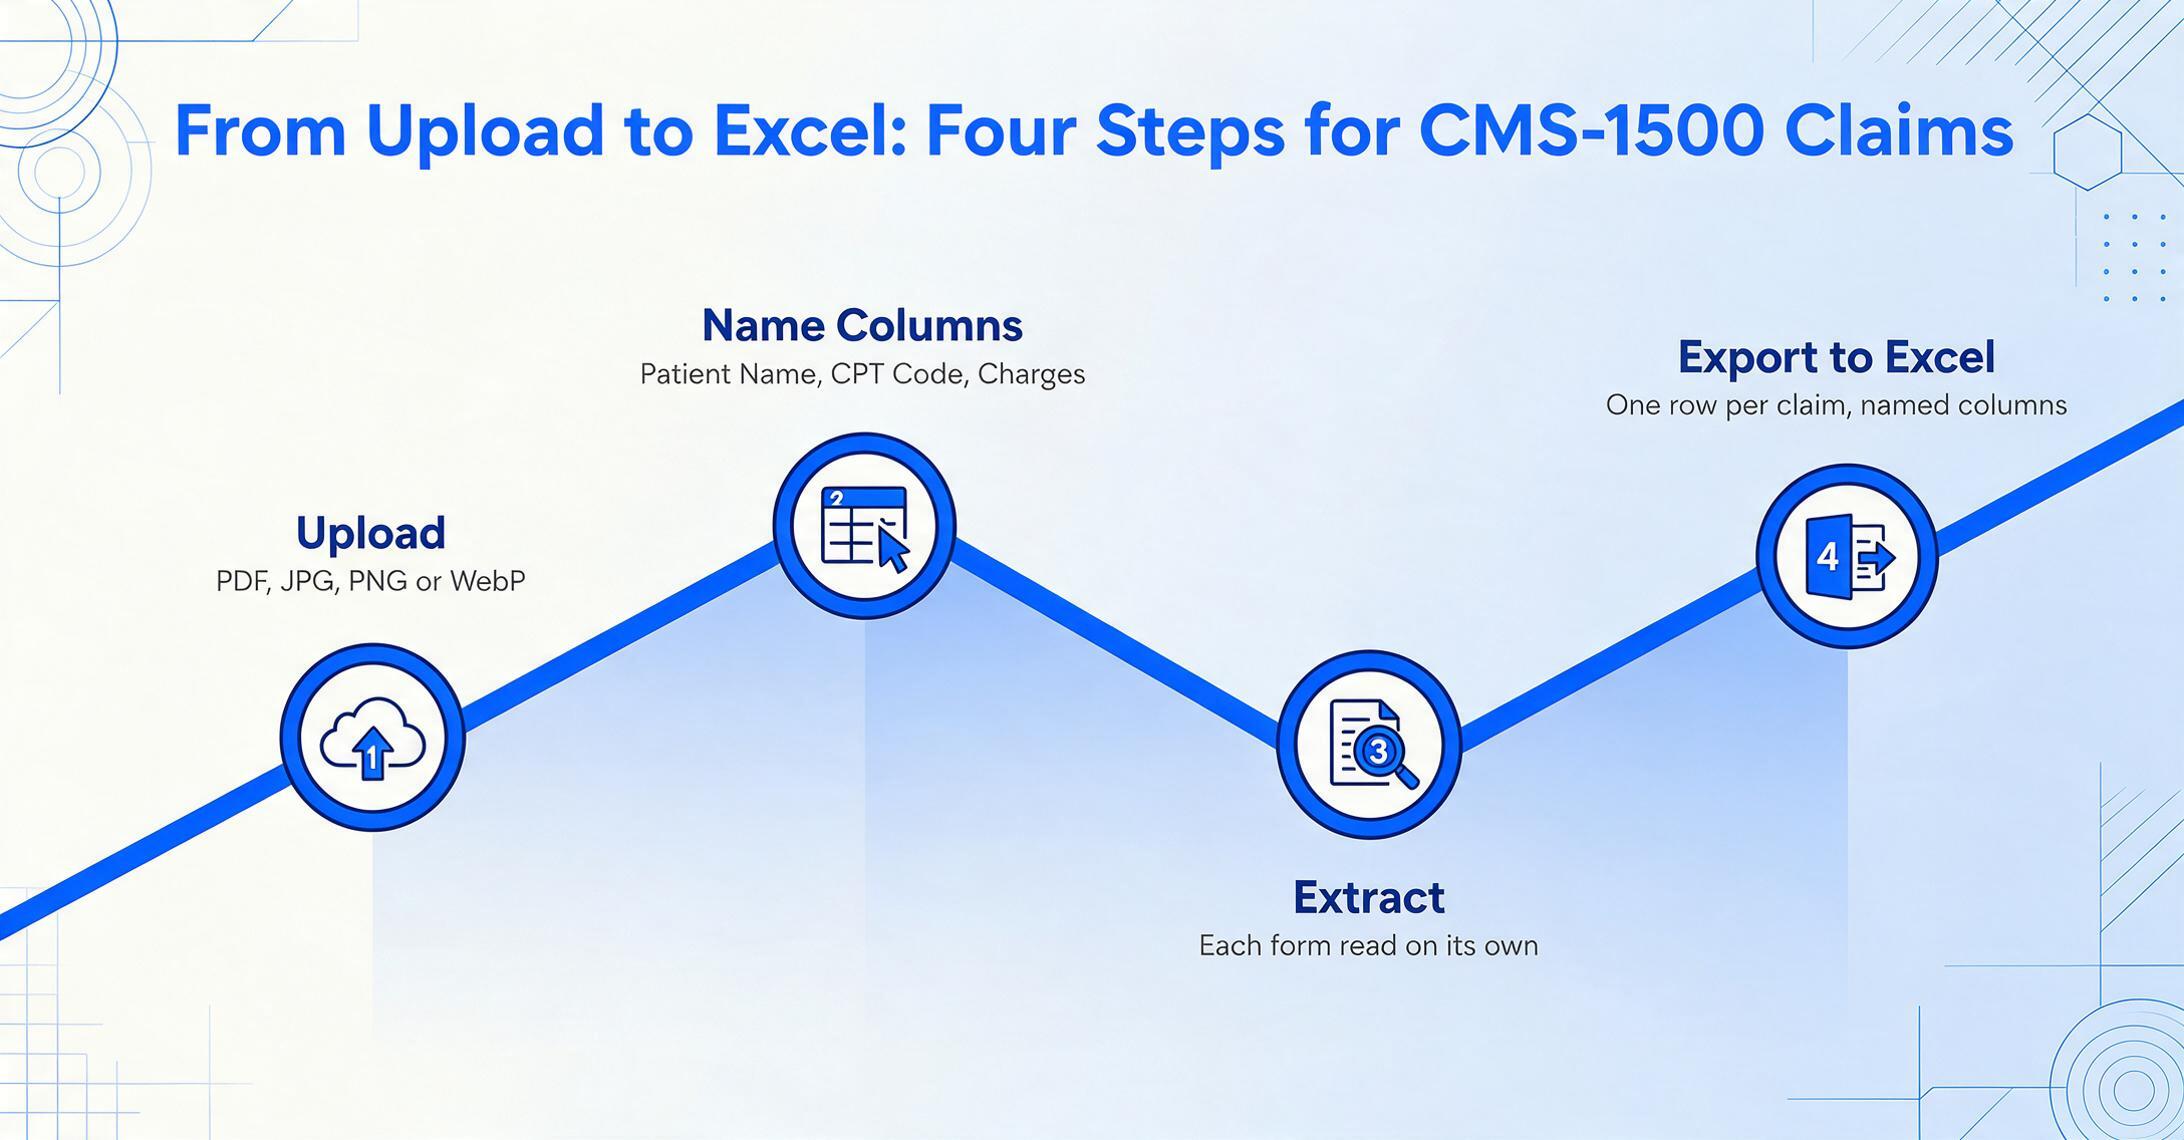
Die folgende Anleitung erfordert keine Vorlagenkonfiguration, kein Training-Setup und keinen Code. Sie können den Prozess mit einem Beispiel-CMS-1500-Formular testen, ohne ein Konto zu erstellen.
Dateien werden sicher verarbeitet und nicht gespeichert.
Wichtige Felder aus CMS-1500-Formularen
Die zu extrahierenden Felder hängen davon ab, was Ihr Abrechnungsteam für Abstimmung, Prüfung oder Datenmigration benötigt. Für die meisten Arbeitsabläufe decken die folgenden Spalten die wesentlichen CMS-1500-Datenpunkte ab:
| Spaltenname | Feld | Beschreibung |
|---|---|---|
| Patientenname | Feld 2 | Nachname, Vorname, zweiter Vorname des Patienten |
| Geburtsdatum | Feld 3 | Geburtsdatum des Patienten (Format MMTTJJJJ) |
| Versicherungsart | Feld 1 | Medicare, Medicaid, TRICARE, CHAMPVA, Gruppenversicherung, FECA, Sonstige |
| Versicherungsnummer | Feld 1a / Feld 11 | ID-Nummer des Versicherten, wie auf der Versicherungskarte angegeben |
| Diagnosecodes | Feld 21 | ICD-10-CM-Codes (bis zu 12), mit höchstmöglicher Spezifität |
| Leistungsdatum | Feld 24A | Von- und Bis-Daten für jede Leistungszeile |
| Ort der Leistungserbringung | Feld 24B | POS-Code für den Ort der Leistung (11 = Praxis, 22 = Krankenhaus ambulant, usw.) |
| CPT/HCPCS-Code | Feld 24D | Prozedurencode mit bis zu vier Modifikatoren |
| Diagnoseverweis | Feld 24E | Buchstabe (A–L) zur Verknüpfung dieser Leistungszeile mit einem Diagnosecode in Feld 21 |
| Gebühren | Feld 24F | Berechneter Betrag für diese Leistungszeile |
| Einheiten | Feld 24G | Tage oder Einheiten für diese Leistungszeile |
| NPI des Leistungserbringers | Feld 24J | 10-stellige NPI des Leistungserbringers |
| NPI des abrechnenden Leistungserbringers | Feld 33A | 10-stellige NPI des abrechnenden Leistungserbringers |
| Gesamtgebühren | Feld 28 | Summe der berechneten Gebühren über alle Leistungszeilen |
Dies ist keine vollständige Liste – je nach Arbeitsablauf können auch die NPI des überweisenden Leistungserbringers (Feld 17), die Vorabgenehmigungsnummer (Feld 23) oder die Patientenkontonummer (Feld 26) relevant sein. Die Spaltenbenennung ermöglicht es Ihnen, genau das zu definieren, was für Ihren Prozess wichtig ist.
Wie steht es um die Genauigkeit? Ein ehrlicher Blick auf die Grenzen
Bei getippten oder computergedruckten CMS-1500-Formularen – der Mehrheit der Papieransprüche, die an Medicare Administrative Contractors eingereicht werden – verarbeitet die Extraktionsengine zuverlässig alle 33 Felder mit der hohen Präzision, die Sie von einer Vision-KI erwarten, die auf strukturierte medizinische Dokumente trainiert wurde. Die Erkennung von gedrucktem Text erreicht den in den Produktspezifikationen für klare gedruckte Daten dokumentierten Genauigkeitsbereich.
Es gibt zwei Szenarien, in denen die Genauigkeit geringer sein kann – und Transparenz darüber hilft Abrechnungsteams, ihren Prüfprozess zu planen:
Handschriftliche Formulare. Von Hand ausgefüllte CMS-1500-Formulare bringen eine Variabilität mit sich, die selbst fortschrittliche KI nicht immer zu 100 % auflösen kann. Ein kursiv geschriebener Diagnosecode eines Arztes, ein hastig notierter Modifikator oder eine NPI, bei der einzelne Ziffern aneinanderliegen, können die feldgenaue Genauigkeit verringern. Vision-KI verarbeitet Handschrift besser als herkömmliche OCR, und bei klarer Blockschrift ist die Extraktion zuverlässig – aber Abrechnungsteams, die ein hohes Volumen handschriftlicher Formulare verarbeiten, sollten ein Stichprobenprüfung der extrahierten Werte gegen die Quelldokumente einplanen. Dies ist dieselbe Realität, die für jedes Szenario der Handschrifterkennung im Gesundheitswesen gilt, von Patientenaufnahmeformularen bis hin zu klinischen Notizen.
Formularqualität. Ein CMS-1500, das als Fax mit niedriger Auflösung (200 DPI oder weniger), als Kopie einer Kopie oder als schräg aufgenommenes Foto mit Schatten ankommt, weist eine geringere Extraktionsgenauigkeit auf als ein sauberer Scan. Das Problem des Rotstift-Ausblendens verschärft dies, da die KI getippte Daten von Formularlinien trennen muss, ohne den Vorteil eines kalibrierten Rotfilter-Scanners. Vorverarbeitungstechniken können einen Teil dieser verlorenen Qualität wiederherstellen, aber Formulare in sichtbar schlechtem Zustand sollten für eine vorrangige manuelle Prüfung gekennzeichnet werden.
Praktische Anleitung
Der empfohlene Arbeitsablauf für Abrechnungsteams, die CMS-1500-Formulare verarbeiten, ist: Führen Sie zuerst alle Formulare durch die KI-Extraktion und prüfen Sie dann eine Stichprobe der Ausgabe gegen die Quelldokumente. Für das typische Abrechnungsteam bedeutet dies, 10–20 % der extrahierten Formulare zu überprüfen, um die Feldgenauigkeit zu bestätigen – nicht jeden Wert aus jedem Formular abzutippen. Dies ist derselbe Stichprobenprüfungsansatz, der in professionellen medizinischen Abrechnungsbetrieben verwendet wird, und er spart im Vergleich zur vollständigen manuellen Eingabe erheblich Zeit, während eine prüfbare Genauigkeit erhalten bleibt.
Häufig gestellte Fragen
Kann dasselbe Tool CMS-1500- und UB-04-Formulare verarbeiten?
Ja, da die Extraktion auf semantischem Verständnis und nicht auf Vorlagenabgleich basiert, kann es beide Formulartypen im selben Batch ohne Neukonfiguration verarbeiten. Das CMS-1500 (professioneller Anspruch, verwendet von Ärzten und Kliniken) hat ein anderes Layout als das UB-04 (institutioneller Anspruch, verwendet von Krankenhäusern), aber derselbe Spaltennamen-Ansatz funktioniert für beide – die KI erkennt, welchen Formulartyp sie liest, und passt ihre Felderkennung entsprechend an.
Ist die CMS-1500-Extraktion HIPAA-konform?
Jedes Tool, das CMS-1500-Formulare verarbeitet, muss geschützte Gesundheitsinformationen (PHI) handhaben – Patientennamen, Geburtsdaten, Versicherungs-IDs, Krankenaktennummern. ImageToTable.ai verarbeitet Dateien sicher mit verschlüsselter Übertragung und verwendet hochgeladene Dokumente nicht für das KI-Training. Für Abrechnungsteams mit formalen HIPAA-Konformitätsanforderungen deckt der HIPAA-Leitfaden zur Extraktion medizinischer Dokumente die spezifischen Konformitätsaspekte für die Verarbeitung von Gesundheitsdaten ab. Organisationen, die eine unterzeichnete Business Associate Agreement (BAA) benötigen, sollten die Abdeckung vor der Verarbeitung von Patientendaten überprüfen.
Hilft die CMS-1500-Datenextraktion, wenn wir bereits elektronisch einreichen?
Auch wenn der Großteil Ihrer Ansprüche über die elektronische 837P-Einreichung läuft, tauchen Papierformulare CMS-1500 weiterhin in mehreren Arbeitsabläufen auf: korrigierte Ansprüche, die erneut eingereicht werden müssen, Einsprüche mit unterstützenden Unterlagen, Ansprüche von Anbietern, die für die ASCA-Härtefallausnahme qualifiziert sind, und Koordinationsszenarien, in denen Papier erforderlich ist. Die Extraktion von Daten aus diesen Papierformularen in Excel zur Überprüfung vor der Einreichung bietet Ihnen dieselbe strukturierte Validierung, die elektronische Arbeitsabläufe bereits bieten.
Wie funktioniert die Extraktion bei Feld 24 mit mehreren Leistungszeilen?
Die KI erkennt, dass sich Feld 24 über bis zu sechs Zeilen mit Leistungsdaten wiederholt. Jede Zeile wird unabhängig extrahiert – mit eigenem Leistungsdatum, CPT-Code, Gebühren und Diagnoseverweis – und die Ausgabespalten spiegeln diese Granularität auf Zeilenebene wider. Sie erhalten eine Zeile in der Ausgabetabelle pro Leistungszeile und Formular, was die Prüfung einzelner Positionen erleichtert.
Kann die Extraktion uns helfen, den Grund für eine abgelehnte Anspruch zu ermitteln?
Indirekt, ja. Durch die Extraktion aller Feldwerte eines abgelehnten papierbasierten CMS-1500 in eine strukturierte Tabelle kann Ihr Team die eingereichten Werte in großem Umfang mit den Anforderungen der Kostenträger vergleichen: Prüfen Sie, ob der Diagnoseverweis in Feld 24E auf einen Code in Feld 21 verweist, ob das NPI-Format korrekt ist und ob der CPT-Modifikator mit dem Ort der Leistungserbringung übereinstimmt. Die strukturierte Ausgabe verwandelt die Ablehnungsanalyse von einer manuellen, dokumentenweisen Suche in eine filterbare Datenanalyseaufgabe. Sobald der Anspruch bezahlt ist, kann derselbe Workflow auf die Extraktion von Daten aus der resultierenden EOB zur Abstimmung ausgeweitet werden – so erhält Ihr Abrechnungsteam strukturierte Daten auf beiden Seiten des Anspruchslebenszyklus.
Was ist der Unterschied zwischen der NPI des abrechnenden Leistungserbringers (Feld 33) und der NPI des behandelnden Leistungserbringers (Feld 24J)?
Die NPI des abrechnenden Leistungserbringers identifiziert die Einrichtung, die den Anspruch einreicht und die Zahlung erhält – in der Regel die Praxis, Klinik oder Berufsausübungsgemeinschaft. Die NPI des behandelnden Leistungserbringers identifiziert den einzelnen Kliniker, der die Leistung tatsächlich erbracht hat. In Praxen mit mehreren Leistungserbringern sind dies oft unterschiedliche NPIs. Das CMS-1500-Formular verlangt beide, und Kostenträger prüfen, ob der behandelnde Leistungserbringer mit dem NPI-Datensatz des abrechnenden Leistungserbringers verknüpft ist. Die Extraktionsausgabe sollte diese Unterscheidung beibehalten, damit Abrechnungsteams die Übereinstimmung vor der Einreichung überprüfen können.
Ihre CMS-1500-Daten sind bereit für die Tabelle
Das Design des CMS-1500-Formulars – 33 Felder, rund 90 Datenpunkte, dichtes Rasterlayout, voneinander abhängige Felder – macht es zu einem der anspruchsvollsten medizinischen Dokumente für die manuelle Verarbeitung. Jedes Feld ist wichtig. Jede Feldabhängigkeit muss stimmen. Und jeder Antrag, der aufgrund eines Dateneingabefehlers scheitert, verlängert den Erstattungszyklus um 30 bis 60 Tage.
Extraktionstools, die auf Vorlagenabgleich oder statischen Zonenkoordinaten basieren, versagen, sobald das Formular mit unterschiedlicher Scanqualität, Faxartefakten oder handschriftlichen Einträgen eingeht. Semantische Extraktion – das Lesen des Formulars durch Verstehen der Bedeutung jedes Feldes, nicht seiner Position – bewältigt die spezifischen Herausforderungen des CMS-1500 ohne Konfiguration, ohne Vorlagen und ohne Training. Das Ergebnis ist eine strukturierte Excel-Datei, die Ihr Abrechnungsteam prüfen, gegen die Anforderungen der Kostenträger validieren und in Ihren Praxisverwaltungsworkflow importieren kann.
Testen Sie den Prozess mit Ihren eigenen CMS-1500-Formularen. Sehen Sie selbst, ob 90 Datenpunkte pro Formular 5 Minuten manuelle Eingabe oder 5 Sekunden KI-Extraktion benötigen – und entscheiden Sie, welcher Workflow für Ihren Abrechnungsbetrieb sinnvoll ist.