Warum liest meine OCR keine Handschrift?
6 häufige Ursachen & Lösungen
Wenn Ihre OCR gedruckten Text problemlos liest, aber bei Handschrift versagt, sind Sie nicht allein – dies ist die häufigste Extraktionsfehlerart überhaupt, und sie hat mindestens vier verschiedene Ursachen, jeweils mit einer anderen Lösung. Die gute Nachricht: Die meisten lassen sich beheben, ohne neue Software zu kaufen. Entscheidend ist zu wissen, auf welcher Ebene das Problem liegt: Bildqualität, Handschriftstil, Dokumenttyp oder das Tool selbst. Beginnen Sie mit der günstigsten Lösung und arbeiten Sie sich nach unten vor.
Die wichtigsten Erkenntnisse
- Ihr OCR-Tool funktioniert bei gedrucktem Text einwandfrei – wenn es Handschrift also stillschweigend überspringt, nehmen Sie an, der Scan sei schlecht oder Sie hätten etwas falsch gemacht.
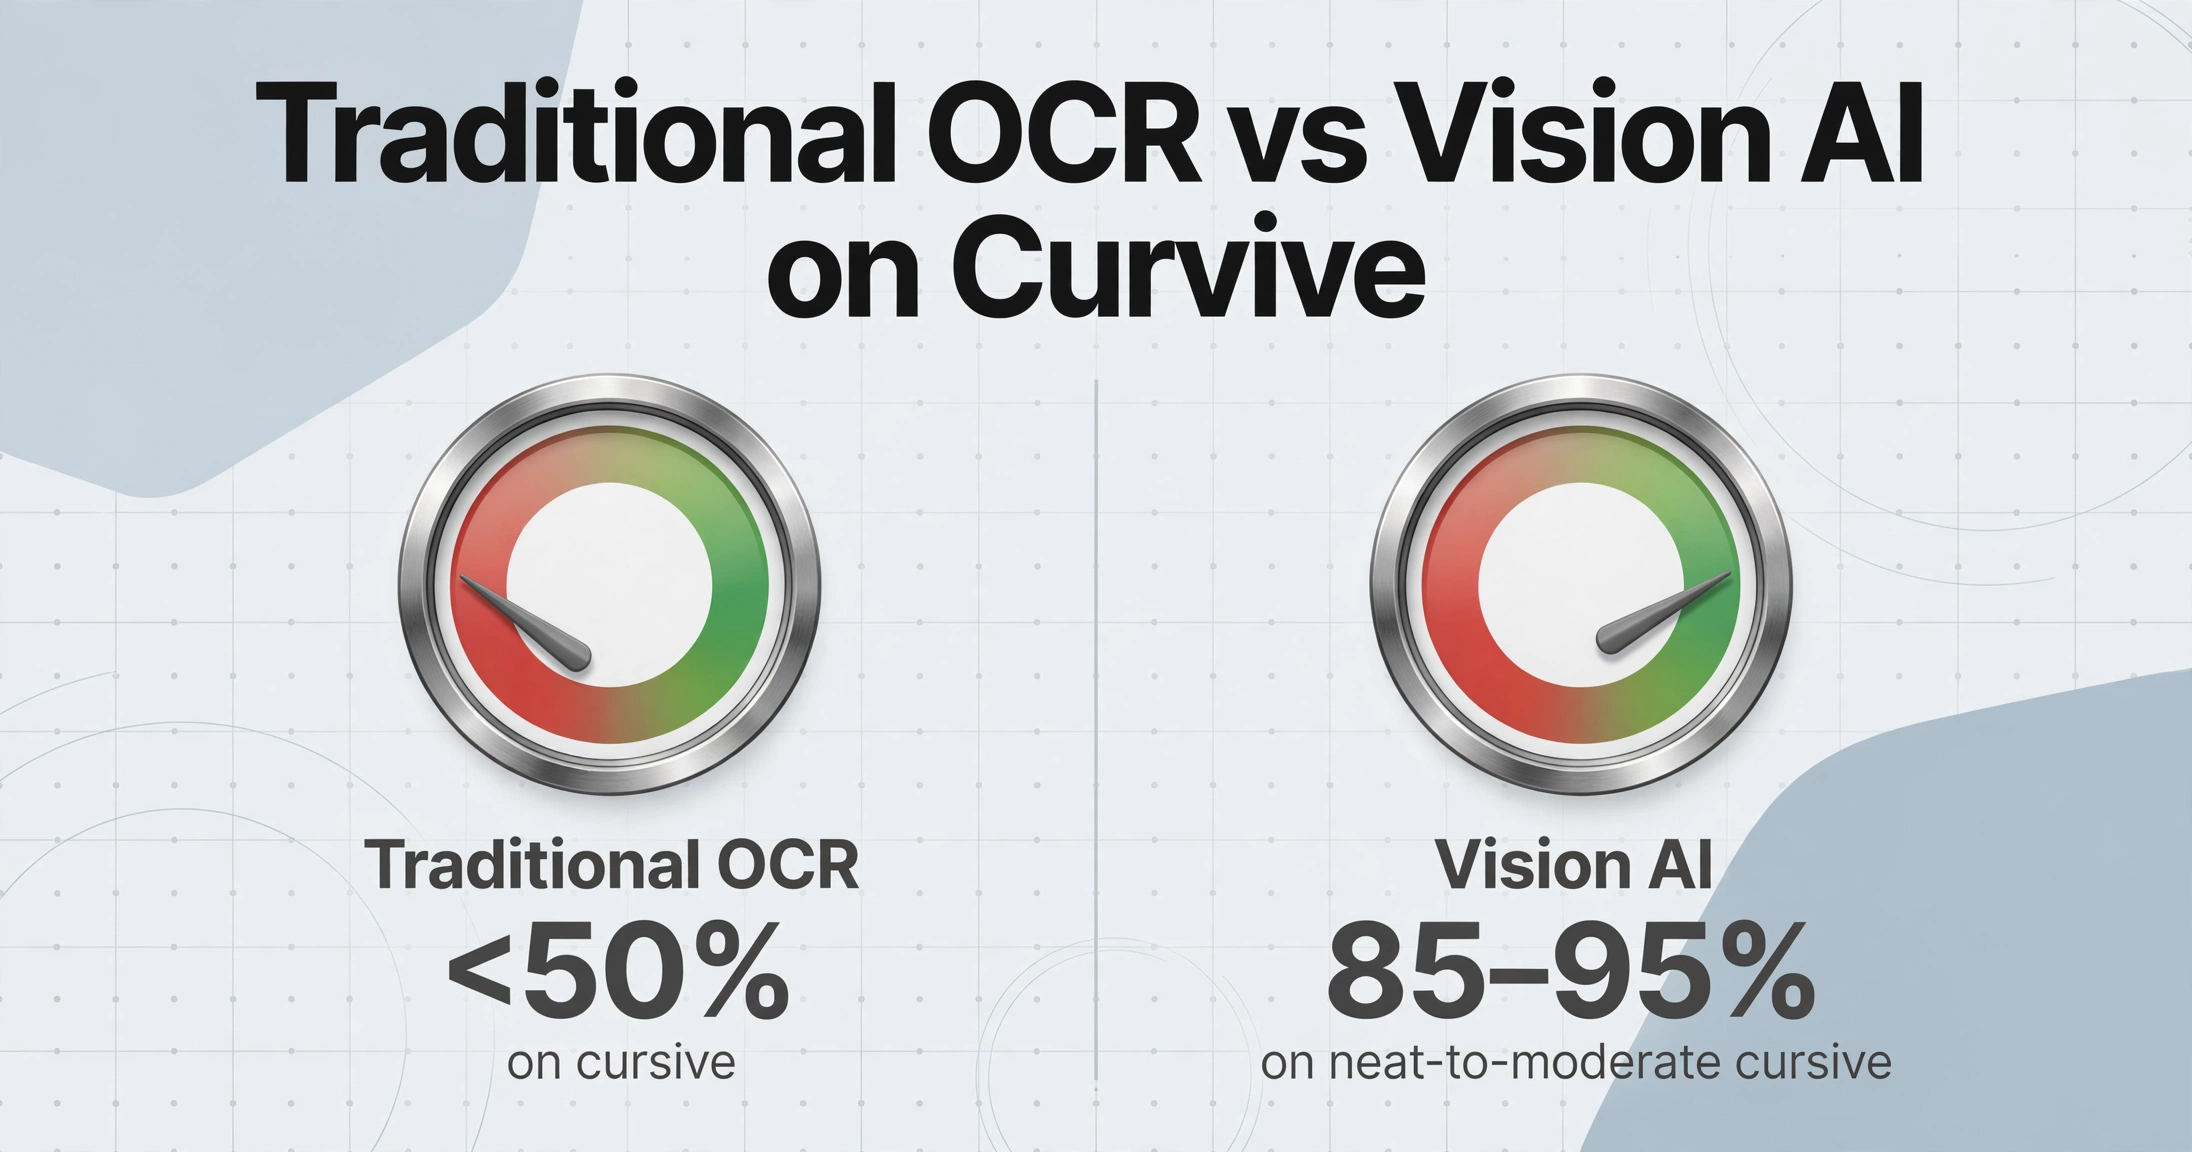
- Traditionelle OCR (Musterabgleich von Text aus Bildern) wurde entwickelt, um gedruckte Zeichen in feste Vorlagen zu segmentieren; Schreibschrift hat keine Zeichengrenzen zum Segmentieren, und die Genauigkeit fällt unter 50 %.
- Testen Sie ein Dokument mit einem Vision-KI-Tool, das ganze Wörter anhand des Kontexts liest statt Zeichen zu segmentieren – wenn die Handschriftgenauigkeit vom Raten auf 85–95 % springt, war das Tool die ganze Zeit der Engpass.
Ursache 1: Unscharfe oder niedrig aufgelöste Bilder
Das Erste, was zu prüfen ist, liegt fast nie an der Software. Herkömmliche OCR-Engines sind auf scharfe Kanten zwischen Zeichen angewiesen. Ist ein Bild unscharf – häufig bei Handyfotos bei schlechtem Licht oder aus nächster Nähe – verschwimmen die Zeichengrenzen. Ein unscharfes „e" sieht aus wie „c", ein weiches „m" wird zu „n", und handgeschriebene Zahlen verschmelzen miteinander.
Die Auflösung ist ebenso entscheidend. Die meisten OCR-Engines erwarten mindestens 300 DPI. Ein Handyfoto eines Dokuments liegt meist bei 72–150 DPI, wenn die Kamera zu weit entfernt ist oder das Licht eine langsamere Verschlusszeit erzwingt. Unter 200 DPI verpixeln handgeschriebene Striche und verlieren die feinen Kurven, die Buchstaben voneinander unterscheiden.
Lösung: Scannen oder fotografieren Sie das Dokument mit mindestens 300 DPI neu. Verwenden Sie nach Möglichkeit einen Flachbettscanner – er garantiert gleichmäßiges Licht und durchgehende Schärfe. Falls Sie ein Handy nutzen müssen, legen Sie das Dokument auf eine ebene Fläche bei gutem Licht (Tageslicht, nicht Deckenlicht), halten Sie die Kamera parallel zum Papier und tippen Sie vor dem Auslösen auf den Text, um scharfzustellen.
Ursache 2: Schiefe oder schlecht beleuchtete Aufnahme
Selbst ein klares Bild taugt nichts, wenn der Text nicht flach und gleichmäßig ausgeleuchtet ist. Fotografiert man ein Dokument schräg, verzerren sich die Zeichen – ein geneigtes „a" kippt in eine Form, die die OCR-Engine nicht erkennt. Schatten sind ebenso zerstörerisch. Ein Schatten, der über ein handgeschriebenes Wort fällt, verdunkelt den Strich so sehr, dass die Engine eine Lücke statt eines Buchstabens sieht.
Dies tritt besonders häufig bei handgeschriebenen Formularen auf, die unter einer einzelnen Schreibtischlampe fotografiert werden. Der Schatten der schreibenden Hand oder eine Wölbung des Dokuments erzeugen dunkle Streifen, die den Textfluss unterbrechen.
Lösung: Verwenden Sie Frontlicht – platzieren Sie die Lichtquelle auf derselben Seite wie die Kamera, nicht hinter oder neben dem Dokument. Viele mobile Scanner-Apps (Google Drive Scan, Adobe Scan, Microsoft Lens) bieten automatische Entzerrung und Schattenentfernung. Lassen Sie Ihr Bild vor der OCR-Verarbeitung durch eine dieser Apps laufen. Falls Ihr Tool bereits eine automatische Korrektur vornimmt, prüfen Sie, ob das Originalbild keine so tiefen Schatten aufweist, dass kein Algorithmus den darunterliegenden Text wiederherstellen kann.
Ursache 3: Schreibschrift und verbundene Handschrift
Hier zeigt sich die grundlegende Einschränkung der meisten OCR-Tools. Traditionelle OCR-Engines arbeiten mit Segmentierung – sie finden die Grenzen zwischen Zeichen, isolieren jedes einzelne und gleichen es mit bekannten Formen ab. Schreibschrift verbindet jedoch jedes Zeichen eines Wortes miteinander. Es gibt keine Grenzen zu finden. Eine Hand, die „Montag“ in einem durchgehenden Strich schreibt, erzeugt eine Form, die die OCR-Engine nicht in einzelne Zeichen zerlegen kann – also rät sie, und zwar schlecht.
Das ist kein Fehler in der Software, sondern eine architektonische Grenze. Traditionelle OCR (einschließlich Tesseract, der OCR-Engine von Adobe Acrobat und der meisten Cloud-Dokument-APIs im Basismodus) wurde für gedruckten Text entwickelt, der in sauberen, getrennten Zeichen vorliegt. Handschrift tut das nicht.
Lösung: Die Lösung hier ist keine bessere Vorverarbeitung, sondern eine andere Art von Werkzeug. Vision-KI-Modelle (manchmal auch VLM-basierte oder LLM-OCR genannt) segmentieren keine Zeichen. Sie lesen ganze Wörter im Kontext, so wie ein Mensch eine handschriftliche Notiz liest: durch die Betrachtung der Form des gesamten Wortes, des umgebenden Textes und des Zwecks des Dokuments. Moderne Vision-KI-Modelle erreichen eine Genauigkeit von 85–95 % bei sauberer bis mäßiger Schreibschrift, verglichen mit unter 50 % bei traditioneller OCR bei derselben Eingabe.
Falls Sie es noch nicht getan haben, lesen Sie wie Vision-KI Handschrift anders liest als traditionelle OCR – der architektonische Unterschied erklärt, warum die eine versagt und die andere funktioniert.
Ursache 4: Unregelmäßige Abstände, Größen und abweichende Grundlinien
Selbst gedruckte Handschrift kann OCR verwirren, wenn die Schrift kein konsistentes Raster aufweist. Anders als maschinell gedruckter Text bleibt Handschrift selten auf einer perfekten horizontalen Grundlinie. Buchstaben driften über und unter die Linie. Die Größen variieren – ein großes „S“ kann dreimal so hoch sein wie ein kleines „c“ derselben Hand. Die Abstände zwischen Wörtern sind unregelmäßig und manchmal gar nicht vorhanden.
Traditionelle OCR-Engines verlassen sich auf vorhersehbare Metriken: x-Höhe, Oberlängenhöhe, konsistente Grundlinie. Wenn diese Metriken innerhalb eines einzigen Satzes schwanken, erzeugt die Zeichensegmentierungs- und Erkennungslogik Fehler, die sich fortsetzen – ein falsch gelesener erster Buchstabe führt zu einer falschen Wortzuordnung, was die gesamte Zeile durcheinanderbringt.
Lösung: Es gibt keinen Bildverarbeitungstrick, der inkonsistente Handschrift „korrigiert“. Die Lösung ist dieselbe wie bei Ursache 3: ein Tool, das kontextuell und nicht nach Vorlage liest. Vision-KI-Tools kommen mit Grundlinienabweichungen und Größenschwankungen natürlich zurecht, da sie kein festes Zeichenraster annehmen. Sie behandeln unregelmäßige Handschrift als normale Eingabe, nicht als zu korrigierenden Fehler.
Ursache 5: Handschrift auf unstrukturierten Dokumenten
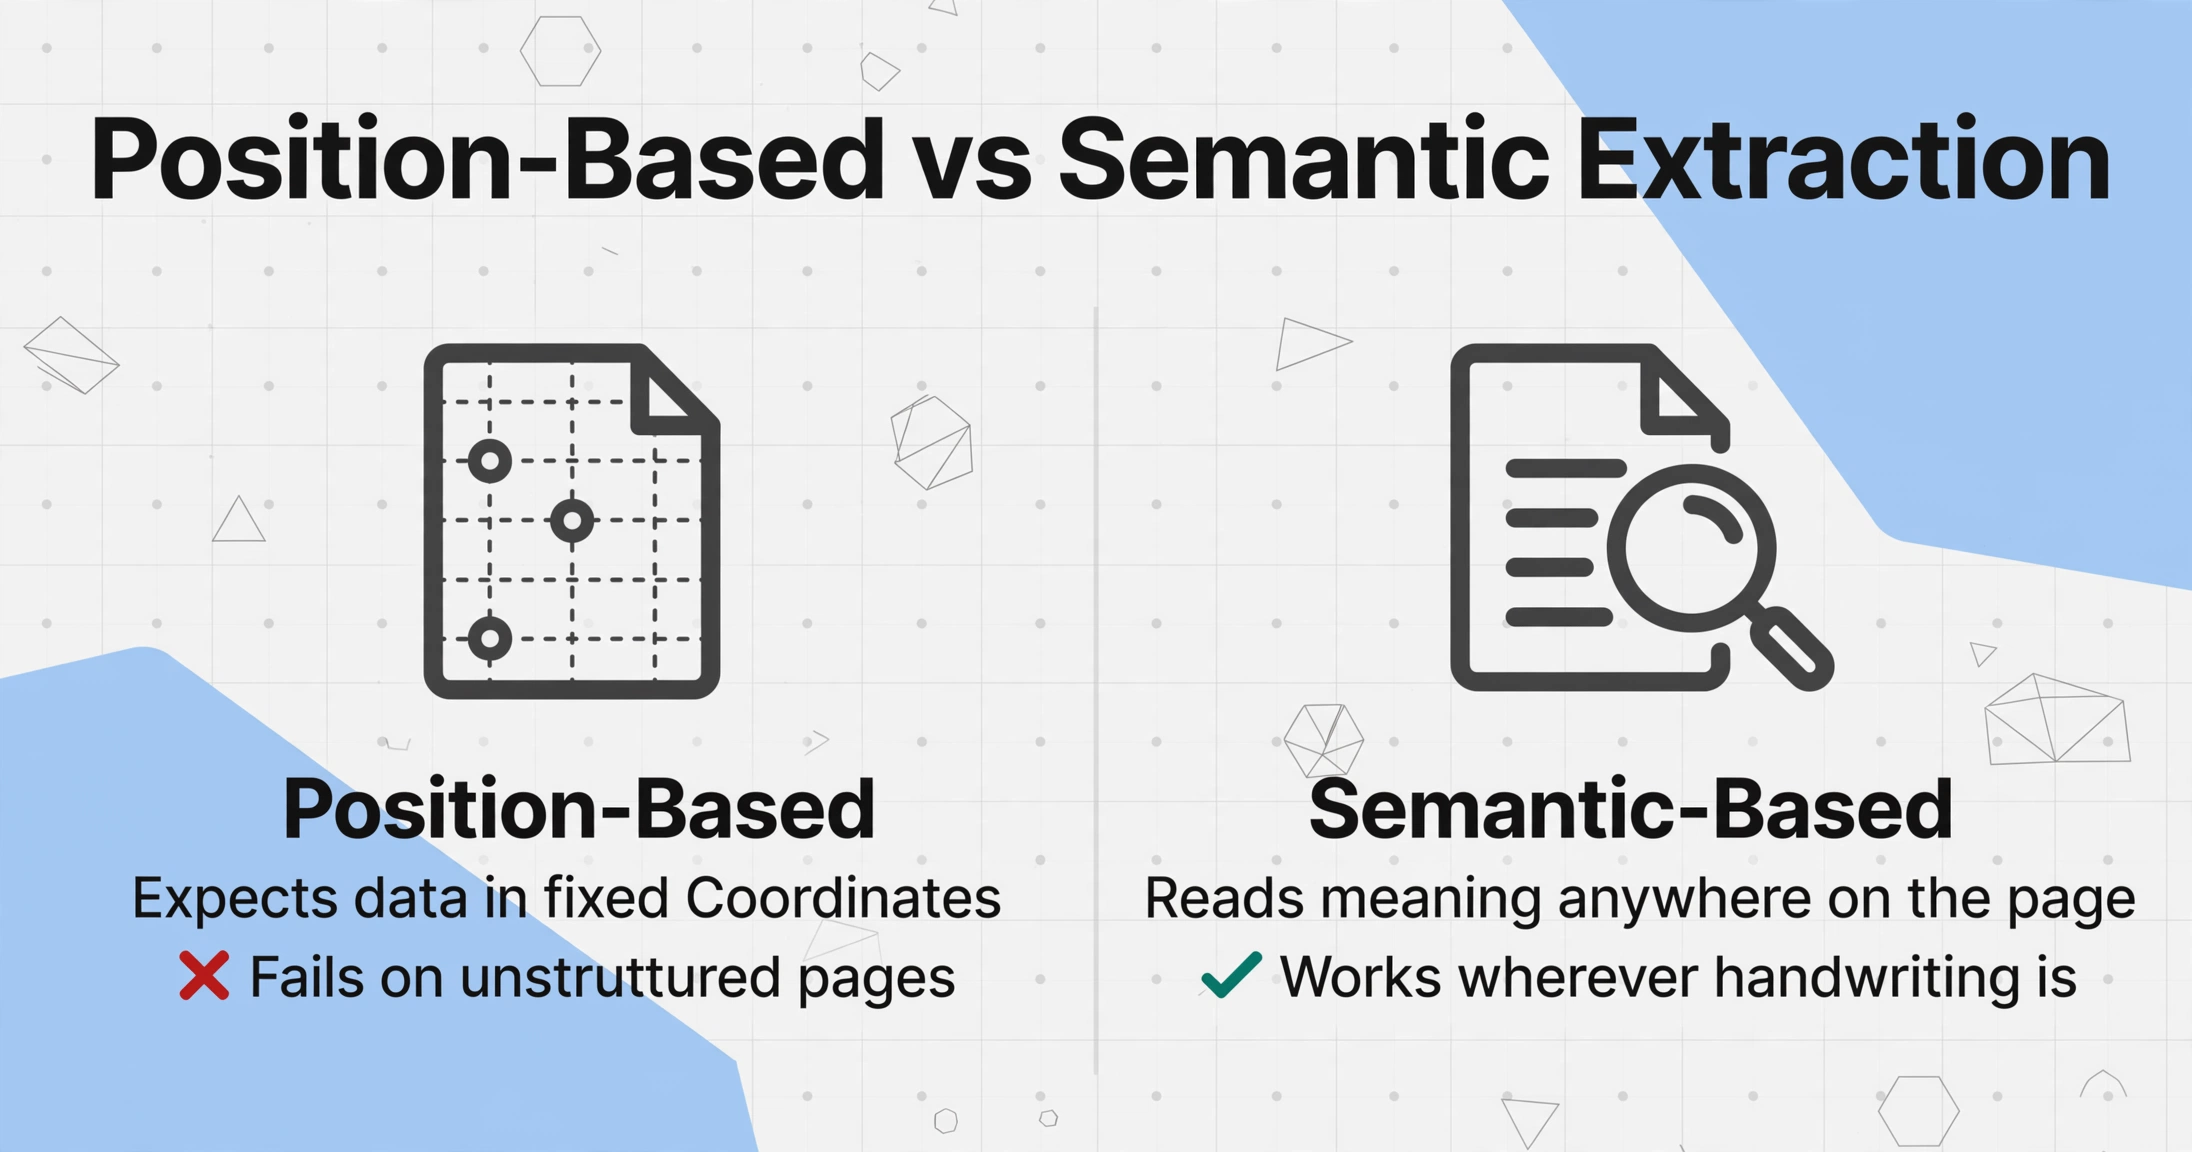
Wo die Handschrift auf der Seite steht, ist genauso wichtig wie die Art, wie sie geschrieben ist. Viele OCR-Tools – insbesondere die vorlagenbasierten – verlassen sich darauf, zu wissen, wo sie suchen müssen. Ein Tool, das darauf konfiguriert ist, „Kundenname“ aus Zeile 3, Spalte 2 eines gedruckten Rechnungsformulars zu extrahieren, scheitert vollständig, wenn dieser Name handschriftlich am Rand oder auf einem leeren Blatt Papier steht.
Zu den unstrukturierten Dokumenten gehören Feldnotizen, Inspektionsbögen, Lieferbelege mit Kommentaren im freien Raum sowie Besprechungsnotizen. Diese Dokumente haben keine vorhersehbaren Layoutbereiche, an denen sich die OCR verankern kann. Wenn Handschrift überall auf der Seite erscheinen kann, bricht die positionsbasierte Extraktion zusammen.
Lösung: Verwenden Sie ein Tool ohne Vorlage, das die gesamte Seite semantisch liest, statt Daten an festen Koordinaten zu erwarten. ImageToTable.ai verwendet beispielsweise die Benutzerdefinierte Spaltenextraktion: Sie geben die gewünschten Spaltennamen ein (wie „Lieferadresse“ oder „Prüfernotizen“), und die KI findet die passenden handschriftlichen Inhalte überall auf der Seite, indem sie versteht, was jedes Feld bedeutet – nicht, indem sie weiß, wo es steht. Das ist der Unterschied zwischen positionsbasierter Extraktion (anfällig bei unstrukturierten Dokumenten) und semantischer Extraktion (funktioniert überall dort, wo die Handschrift ist).
Ursache 6: Ihr Tool wurde für Druck, nicht für Handschrift entwickelt
Dies ist die tiefste Ebene und diejenige, die die meisten Benutzer übersehen, weil das Tool „OCR“ verspricht. Traditionelle OCR – die Technologie hinter Tesseract, den meisten PDF-Editoren und universellen Dokumentenscannern – wurde in den 1970er-Jahren für maschinell gedruckten Text entwickelt. Sie verwendet Musterabgleich mit festen Zeichenvorlagen. Ein gedrucktes „A“ sieht immer gleich aus, weil es eine Schriftart ist. Ein handgeschriebenes „A“ variiert je nach Schreiber, Stimmung, Stiftwinkel und dem vorhergehenden Buchstaben.
Branchen-Benchmarks beziffern die Genauigkeit traditioneller OCR bei kursiver Handschrift auf unter 50 % – das bedeutet, mehr als die Hälfte der Wörter ist falsch. Selbst bei sauberer Druckschrift liegt die Genauigkeit bei etwa 70–75 %. Vision-AI-Modelle erreichen dagegen 85–95 % bei Handschrift angemessener Qualität – gleiche Eingabe, sehr unterschiedliche Ergebnisse.
„Angemessene Qualität“ definiert: 300 DPI oder höher, gleichmäßige Beleuchtung von vorne, keine Verdeckung (Finger, Schatten, Falten), Dokument flach, Text ungefähr horizontal. Das ist die Grundvoraussetzung für ein gutes Ergebnis mit jedem Tool, einschließlich Vision AI.
Lösung: Wechseln Sie von einer traditionellen OCR-Engine zu einem Vision-AI-Extraktionstool, das große Sprachmodelle zum Lesen von Dokumenten verwendet. Der Unterschied ist nicht inkrementell – er ist kategorial. Traditionelle OCR versucht, Pixelmuster abzugleichen. Vision AI liest Kontext, versteht die Dokumentstruktur und bewältigt die natürliche Variabilität von Handschrift. Eine detaillierte Aufschlüsselung der Genauigkeitslücke finden Sie in unserem Vergleich von KI- vs. traditioneller Handschriftgenauigkeit.
Warum das wichtig ist
Wenn Ihr Tool traditionelle OCR verwendet, scheitern Sie nicht an der Handschriftextraktion – das Tool wurde nie dafür entwickelt. Die sechs oben genannten Ursachen stapeln sich übereinander: Beheben Sie zuerst die Bildqualität, dann den Handschriftstil, dann die Dokumentstruktur, dann die Tool-Architektur. Die meisten Fehler bei der Handschriftextraktion werden bereits durch Ebene 1 oder 2 allein gelöst.
Wann eskalieren – Was noch manuell erfasst werden muss
Ehrlichkeit ist wichtig. Selbst die besten KI-Tools für Bilderkennung stoßen bei Handschriften an ihre Grenzen. Planen Sie in diesen Fällen eine manuelle Bearbeitung ein:
- Extrem unleserliche oder verkrakelte Handschrift – die Art, die selbst ein Kollege kaum entziffern könnte. Kein Tool kann Text zuverlässig extrahieren, den ein Mensch nicht lesen kann.
- Gemischte Schriften – Handschrift, die innerhalb eines Satzes zwischen Schriftsystemen wechselt (z. B. Lateinisch und Arabisch oder Englisch und Kanji). Die meisten Bilderkennungsmodelle sind hauptsächlich auf einsprachige Dokumente trainiert.
- Kritische Zahlenfelder ohne Prüfkontext – handschriftliche Kontonummern, Steuer-IDs oder Teilenummern, bei denen ein einziger falscher Buchstabe echten Schaden anrichtet. Diese sollten immer von Menschen überprüft werden, selbst wenn die KI sie extrahiert.
- Stark verblasste oder beschädigte Originale – Tinte, die über Jahrzehnte verblasst ist, Papier mit Wasserschäden oder Text auf dunklem oder gemustertem Hintergrund. KI kann manchmal mehr rekonstruieren als herkömmliche OCR, aber es gibt eine Grenze, unter der kein Tool funktioniert.
Der praktische Workflow: Nutzen Sie KI-Extraktion, um 85–95 % der Daten automatisch zu erfassen, und leiten Sie die verbleibenden schwierigen Felder an einen menschlichen Prüfschritt weiter. Das ist schneller als die manuelle Erfassung jedes Feldes und zuverlässiger, als sich bei jedem Feld auf die KI zu verlassen.
FAQ
Warum funktioniert OCR bei gedrucktem Text, aber nicht bei Handschrift?
Herkömmliche OCR verwendet Mustervergleiche mit festen Zeichenvorlagen – derselbe Ansatz, der gedruckte Schriftarten perfekt liest, weil jedes „A" in derselben Schriftart identisch ist. Handschrift hat keine feste Vorlage; jeder Schreiber formt Buchstaben anders, und selbst dieselbe Person variiert ihre Schrift je nach Geschwindigkeit, Stift und Stimmung. Der Ansatz, der für Druckschrift funktioniert, ist auf Handschrift schlicht nicht anwendbar.
Welche Bildqualität benötige ich für die Handschrift-OCR?
Mindestens 300 DPI Auflösung, gleichmäßige Beleuchtung von vorne (keine Schatten, die über den Text fallen), Dokument flach und unverdeckt, Text ungefähr horizontal. Dies gilt sowohl für traditionelle OCR als auch für Vision-KI-Tools – kein Tool kann lesen, was es nicht sehen kann.
Kann KI wirklich unleserliche Handschrift lesen?
Ja, innerhalb gewisser Grenzen. Vision-KI-Modelle erreichen 85–95 % Genauigkeit bei moderater Handschrift und 65–75 % bei unleserlicher Schreibschrift. Der Schlüssel liegt darin, dass KI den Kontext liest – sie nutzt die umgebenden Wörter und die Dokumentstruktur, um unklare Zeichen zu unterscheiden. Eine traditionelle OCR-Engine hat keinen solchen Kontext; sie sieht nur Pixel. Wenn Sie sich für die genauen Zahlen pro Handschrifttyp interessieren, zeigt unser Genauigkeitsvergleich genau, was KI lesen kann und was nicht.
Lohnt sich ein Upgrade auf ein Vision-KI-Tool, oder sollte ich bei meinem aktuellen bleiben?
Wenn Handschrift ein regelmäßiger Teil Ihres Dokument-Workflows ist – handschriftliche Lieferscheine, Inspektionsformulare, Stundenzettel oder Feldberichte – dann ja. Der Unterschied zwischen traditioneller OCR (~50 % Genauigkeit bei Schreibschrift) und Vision-KI (~85–95 %) ist nicht marginal; es ist der Unterschied zwischen unbrauchbarer Ausgabe und einem funktionierenden Prozess. Wenn Handschrift selten vorkommt, versuchen Sie zuerst, die Bildqualität zu verbessern – das allein löst viele Fälle.
Die sechs oben genannten Ursachen stapeln sich übereinander. Die meisten Fehler bei der Handschriftextraktion werden durch die ersten beiden Ebenen gelöst – eine bessere Bildqualität allein macht einen Unterschied. Wenn das nicht reicht, ist die Antwort keine bessere OCR-Einstellung, sondern ein Tool, das für Handschrift entwickelt wurde, nicht für Druckschrift. Probieren Sie es mit Ihrem eigenen handschriftlichen Dokument aus und sehen Sie, in welcher Ebene Ihr Problem liegt.