¿Por qué mi OCR no lee la escritura a mano?
6 causas comunes y soluciones
Si su OCR lee texto impreso sin problemas pero falla con la escritura a mano, no está solo: este es el modo de fallo de extracción más común, y tiene al menos cuatro causas distintas, cada una con una solución diferente. La buena noticia es que la mayoría se pueden resolver sin comprar software nuevo. La clave está en saber en qué capa vive el problema: calidad de imagen, estilo de escritura, tipo de documento o la propia herramienta. Empiece por la solución más económica y vaya profundizando.
Conclusiones clave
- Su herramienta OCR funciona perfectamente con texto impreso, así que cuando omite silenciosamente la escritura a mano, usted asume que el escaneo está mal o que hizo algo incorrecto.
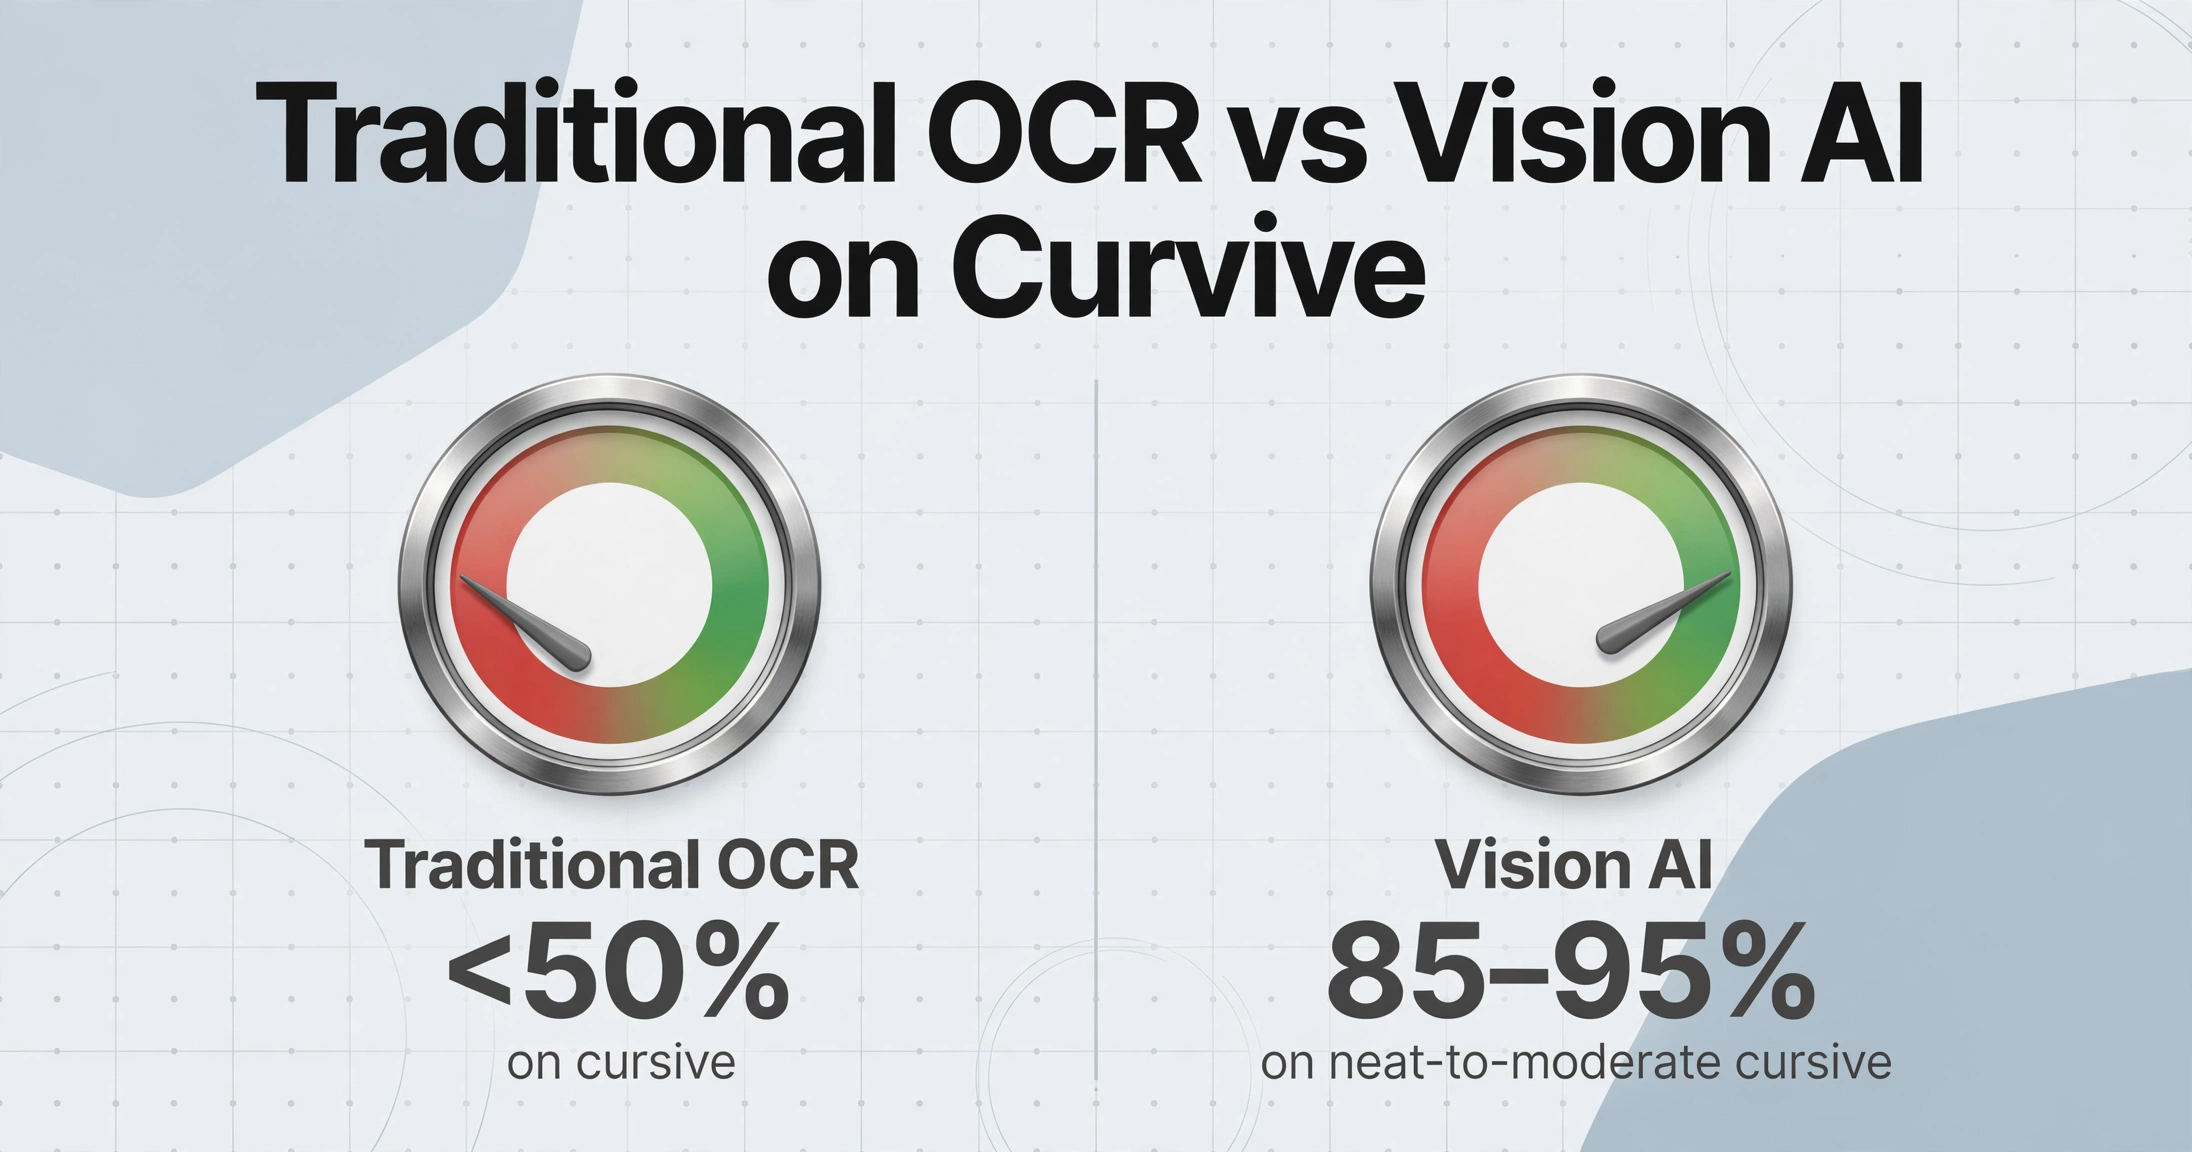
- El OCR tradicional (reconocimiento de patrones de texto en imágenes) fue diseñado para segmentar caracteres impresos en plantillas fijas; la escritura cursiva no tiene límites de caracteres que segmentar, y la precisión cae por debajo del 50%.
- Pruebe un documento en una herramienta de IA de visión que lea palabras completas por contexto en lugar de segmentar caracteres; si la precisión con escritura a mano pasa de adivinar al 85-95%, la herramienta era el cuello de botella desde el principio.
Causa 1: Imágenes borrosas o de baja resolución
Lo primero que hay que revisar casi nunca es el software. Los motores OCR tradicionales dependen de bordes nítidos entre caracteres. Cuando una imagen está borrosa —algo común en fotos de teléfono con poca luz o a corta distancia— los límites de los caracteres se disuelven. Una "e" borrosa parece una "c", una "m" suave se vuelve "n" y los números escritos a mano se funden entre sí.
La resolución también importa. La mayoría de los motores OCR requieren al menos 300 DPI. Una foto de un documento tomada con un teléfono suele rondar los 72–150 DPI si la cámara está demasiado lejos o la luz obliga a una obturación lenta. Por debajo de 200 DPI, los trazos manuscritos se pixelan y pierden las curvas sutiles que distinguen una letra de otra.
Solución: Vuelve a escanear o fotografiar el documento a un mínimo de 300 DPI. Usa un escáner de cama plana cuando sea posible: garantiza iluminación uniforme y enfoque constante. Si debes usar la cámara del teléfono, coloca el documento sobre una superficie plana con buena luz (luz natural, no de techo), sostén la cámara paralela al papel y toca la pantalla para enfocar el texto antes de disparar.
Causa 2: Captura inclinada o con mala iluminación
Incluso una imagen nítida falla si el texto no está plano y bien iluminado. Al fotografiar un documento en ángulo, los caracteres se distorsionan —una "a" inclinada se convierte en una forma que el motor OCR no reconoce. Las sombras son igualmente destructivas. Una sombra que cae sobre una palabra manuscrita oscurece el trazo hasta que el motor ve un espacio, no una letra.
Esto es especialmente común con formularios manuscritos fotografiados sobre un escritorio bajo una sola lámpara. La sombra de la mano del escritor o la propia curvatura del documento crean bandas oscuras que rompen el flujo del texto.
Solución: Usa iluminación frontal —coloca la fuente de luz en el mismo lado que la cámara, no detrás ni al costado del documento. Muchas aplicaciones de escaneo móvil (Google Drive scan, Adobe Scan, Microsoft Lens) incluyen enderezado automático y eliminación de sombras. Procesa tu imagen con una de ellas antes de pasarla a tu herramienta OCR. Si la herramienta que usas ya hace corrección automática, verifica que la imagen original no tenga sombras tan profundas que ningún algoritmo pueda recuperar el texto debajo.
Causa 3: Escritura Cursiva y Conectada
Aquí es donde la mayoría de las herramientas OCR revelan su limitación fundamental. Los motores OCR tradicionales funcionan mediante segmentación: encuentran los límites entre caracteres, aíslan cada uno y lo comparan con formas conocidas. La escritura cursiva, por diseño, conecta cada letra de una palabra. No hay límites que encontrar. Una mano que escribe "Monday" en un trazo continuo produce una forma que el motor OCR no puede dividir en caracteres individuales, por lo que adivina — y adivina mal.
Esto no es un error del software; es un límite arquitectónico. El OCR tradicional (incluidos Tesseract, el motor OCR de Adobe Acrobat y la mayoría de las API de documentos en la nube en su modo básico) fue creado para texto impreso que se presenta en glifos ordenados y separados. La escritura a mano no lo está.
Solución: La solución aquí no es un mejor preprocesamiento, sino un tipo de herramienta diferente. Los modelos de IA de visión (a veces llamados OCR basado en VLM o LLM) no segmentan caracteres. Leen palabras completas en contexto, de la misma manera que una persona lee una nota manuscrita: observando la forma de la palabra completa, el texto circundante y el propósito del documento. Los modelos modernos de IA de visión logran una precisión del 85–95% en cursiva clara o moderada, en comparación con el <50% del OCR tradicional con la misma entrada.
Si aún no lo ha hecho, lea cómo la IA de visión lee la escritura a mano de manera diferente al OCR tradicional — la diferencia arquitectónica explica por qué uno falla y el otro funciona.
Causa 4: Espaciado irregular, tamaño y desviación de la línea base
Incluso la escritura a mano impresa puede confundir al OCR si carece de una cuadrícula consistente. A diferencia del texto impreso por máquina, la escritura a mano rara vez se mantiene en una línea base horizontal perfecta. Las letras se desvían por encima y por debajo de la línea. Los tamaños varían: una "S" mayúscula puede tener tres veces la altura de una "c" minúscula escrita por la misma mano. El espaciado entre palabras es irregular y, a veces, inexistente.
Los motores de OCR tradicionales dependen de métricas predecibles: altura de la x, altura de los ascendentes y una línea base consistente. Cuando estas métricas fluctúan dentro de una sola oración, la lógica de segmentación y reconocimiento de caracteres produce errores que se acumulan: una primera letra mal leída conduce a una coincidencia de palabra incorrecta, lo que desvía toda la línea.
Solución: No existe un truco de procesamiento de imágenes que "corrija" la escritura a mano inconsistente. La solución es la misma que en la Causa 3: una herramienta que lea contextualmente, no mediante plantillas. Las herramientas de IA de visión manejan la desviación de la línea base y la variación de tamaño de forma natural porque no asumen una cuadrícula de caracteres fija. Tratan la escritura a mano irregular como una entrada normal, no como un error que corregir.
Causa 5: Escritura a mano en documentos no estructurados
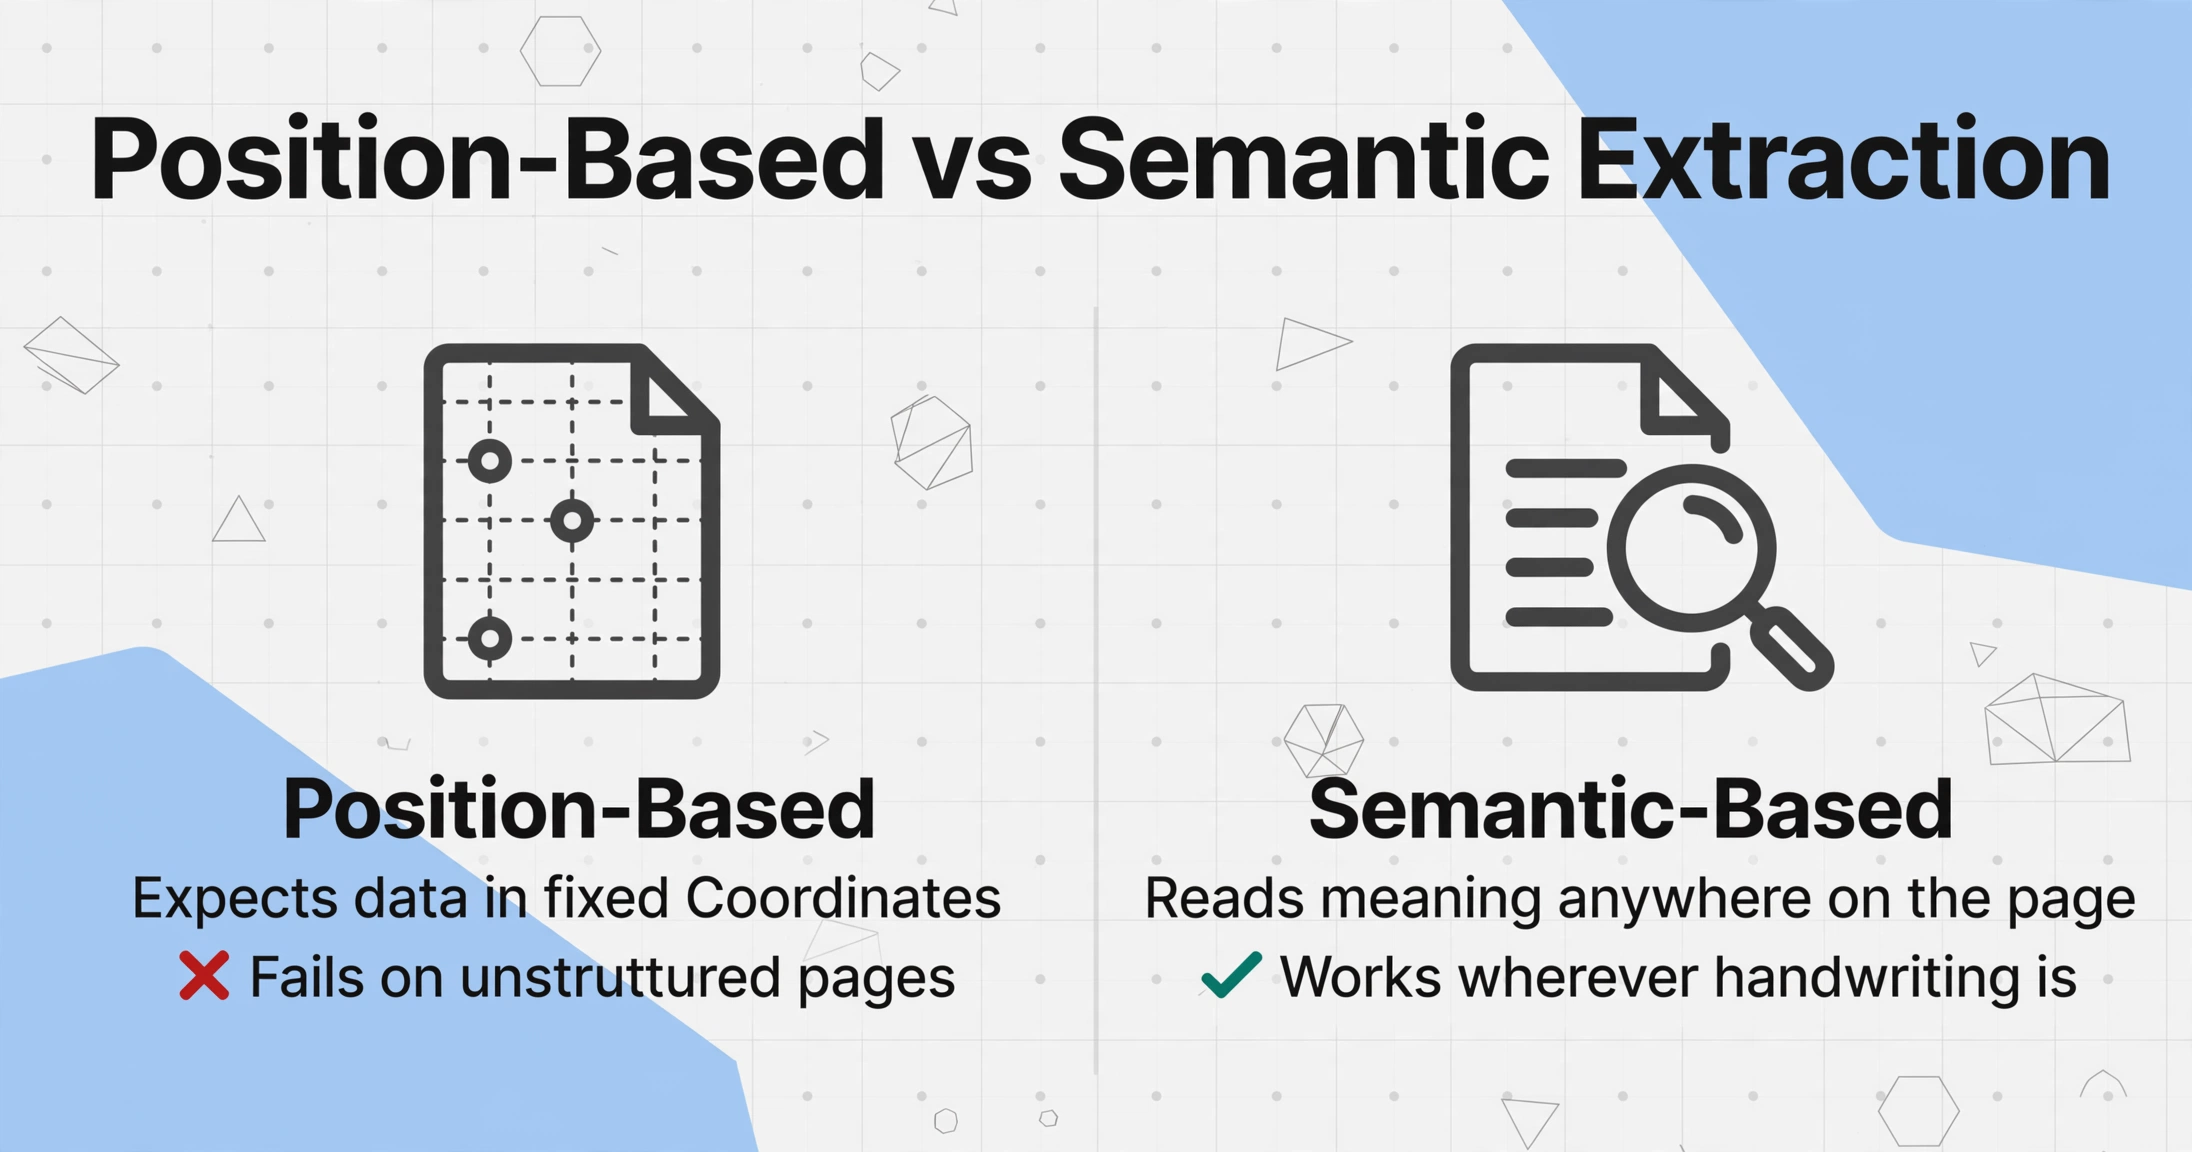
El lugar donde se encuentra la escritura a mano en la página importa tanto como cómo está escrita. Muchas herramientas de OCR — especialmente las basadas en plantillas — dependen de saber dónde mirar. Una herramienta configurada para extraer el "Nombre del cliente" de la fila 3, columna 2 de un formulario de factura impreso falla por completo cuando ese nombre está escrito a mano en el margen, o en una hoja de papel en blanco.
Los documentos no estructurados incluyen notas de campo, hojas de inspección, recibos de entrega con comentarios garabateados en el espacio abierto y notas de reuniones. Estos documentos no tienen zonas de diseño predecibles en las que el OCR pueda anclarse. Cuando la escritura a mano puede aparecer en cualquier parte de la página, la extracción basada en posición falla.
Solución: Utilice una herramienta de extracción sin plantilla que lea toda la página semánticamente en lugar de esperar datos en coordenadas fijas. ImageToTable.ai, por ejemplo, utiliza la Extracción de Columnas Personalizadas: usted escribe los nombres de las columnas que desea (como "Dirección de entrega" o "Notas del inspector"), y la IA localiza el contenido escrito a mano correspondiente en cualquier parte de la página al comprender qué significa cada campo, no al saber dónde se encuentra. Esta es la diferencia entre la extracción basada en posición (frágil en documentos no estructurados) y la extracción basada en semántica (funciona dondequiera que esté la escritura a mano).
Causa 6: Su herramienta fue diseñada para impresos, no para escritura a mano
Esta es la capa más profunda, y la que la mayoría de los usuarios pasa por alto porque la herramienta "dice" que hace OCR. El OCR tradicional — la tecnología detrás de Tesseract, la mayoría de los editores de PDF y los escáneres de documentos de uso general — se inventó en la década de 1970 para texto impreso por máquina. Utiliza coincidencia de patrones contra plantillas de caracteres fijos. Una "A" impresa siempre se ve igual porque es una fuente. Una "A" escrita a mano varía según el escritor, el estado de ánimo, el ángulo del bolígrafo y la letra que la precede.
Los puntos de referencia de la industria sitúan la precisión del OCR tradicional en escritura cursiva por debajo del 50% — lo que significa que más de la mitad de las palabras son incorrectas. Incluso en escritura a mano impresa y prolija, la precisión ronda el 70–75%. Los modelos de IA de visión, en cambio, alcanzan un 85–95% en escritura a mano de calidad razonable — la misma entrada, resultados muy diferentes.
"Calidad razonable" definida: 300 DPI o más, iluminación frontal uniforme, sin obstrucciones (dedos, sombras, pliegues), documento plano, texto aproximadamente horizontal. Ese es el punto de partida para un buen resultado con cualquier herramienta, incluida la IA de visión.
Solución: Cambie de un motor OCR tradicional a una herramienta de extracción con IA de visión que utilice grandes modelos de lenguaje para leer documentos. La diferencia no es incremental — es categórica. El OCR tradicional intenta coincidir patrones de píxeles. La IA de visión lee el contexto, comprende la estructura del documento y maneja la variabilidad natural de la escritura a mano. Para un desglose detallado de la brecha de precisión, consulte nuestra comparación de precisión entre IA y OCR tradicional en escritura a mano.
Por qué esto importa
Si su herramienta utiliza OCR tradicional, no está fallando en la extracción de escritura a mano — la herramienta nunca fue diseñada para eso. Las seis causas anteriores se acumulan una sobre otra: primero corrija la calidad de imagen, luego el estilo de escritura, luego la estructura del documento y luego la arquitectura de la herramienta. La mayoría de los fallos de extracción de escritura a mano se resuelven solo con la capa 1 o 2.
Cuándo escalar — qué sigue requiriendo ingreso manual
La honestidad importa. Incluso las mejores herramientas de visión artificial tienen límites con la escritura a mano. Debes planificar el manejo manual en estos casos:
- Escritura extremadamente desordenada o ilegible — del tipo que a un colega le costaría leer. Ninguna herramienta puede extraer texto que un humano no pueda descifrar.
- Escritura con idiomas mezclados — escritura que alterna entre alfabetos (ej., latino y árabe, o inglés y kanji) dentro de la misma oración. La mayoría de los modelos de visión se entrenan principalmente con documentos en un solo idioma.
- Campos numéricos críticos sin contexto de validación — números de cuenta bancaria, IDs fiscales o números de pieza escritos a mano donde un solo carácter incorrecto causa daños reales. Siempre deben ser verificados por humanos, incluso si la IA los extrae.
- Originales muy desvaídos o dañados — tinta que se ha desvanecido con décadas, papel dañado por agua o texto escrito sobre un fondo oscuro o estampado. La IA a veces puede recuperar más que el OCR tradicional, pero hay un límite por debajo del cual ninguna herramienta funciona.
El flujo de trabajo práctico: usa la extracción con IA para obtener automáticamente el 85–95% de los datos, luego deriva los campos difíciles restantes a un paso de revisión humana. Esto es más rápido que el ingreso manual de cada campo y más confiable que confiar en la IA para todos.
Preguntas frecuentes
¿Por qué el OCR funciona con texto impreso pero falla con escritura a mano?
El OCR tradicional usa coincidencia de patrones contra plantillas de caracteres fijas — el mismo enfoque que lee fuentes impresas perfectamente porque cada "A" en la misma fuente es idéntica. La escritura a mano no tiene una plantilla fija; cada escritor forma las letras de manera diferente, e incluso la misma persona varía su escritura según la velocidad, el bolígrafo y el estado de ánimo. El enfoque que funciona para texto impreso simplemente no aplica a la escritura a mano.
¿Qué calidad de imagen necesito para el OCR de escritura manuscrita?
Resolución mínima de 300 DPI, iluminación frontal uniforme (sin sombras que caigan sobre el texto), documento plano y sin obstrucciones, texto aproximadamente horizontal. Esto aplica tanto para el OCR tradicional como para las herramientas de IA de visión: ninguna herramienta puede leer lo que no puede ver.
¿Puede la IA realmente leer escritura desordenada?
Sí, dentro de ciertos límites. Los modelos de IA de visión alcanzan una precisión del 85–95% en escritura moderada y del 65–75% en cursiva desordenada. La clave es que la IA lee el contexto: utiliza las palabras circundantes y la estructura del documento para descifrar caracteres poco claros. Un motor de OCR tradicional no tiene ese contexto; solo ve píxeles. Si le interesan los números exactos por tipo de escritura, nuestra comparación de precisión cubre exactamente lo que la IA puede y no puede leer.
¿Vale la pena actualizar a una herramienta de IA de visión, o debo quedarme con lo que tengo?
Si la escritura manuscrita es parte regular de su flujo de trabajo con documentos —notas de entrega escritas a mano, formularios de inspección, hojas de horas o informes de campo— entonces sí. La brecha entre el OCR tradicional (~50% de precisión en cursiva) y la IA de visión (~85-95%) no es marginal; es la diferencia entre una salida inutilizable y un proceso funcional. Si la escritura manuscrita es poco frecuente, intente primero mejorar la calidad de la imagen: eso por sí solo resuelve muchos casos.
Las seis causas anteriores se acumulan entre sí. La mayoría de los fallos de extracción de escritura manuscrita se resuelven con las dos primeras capas: una mejor calidad de imagen por sí sola marca la diferencia. Cuando no es así, la respuesta no es una mejor configuración de OCR; es una herramienta diseñada para escritura manuscrita, no para texto impreso. Pruébela con su propio documento manuscrito y vea en qué capa se encuentra su problema.