Por que meu OCR não lê escrita à mão?
6 causas comuns e soluções
Se o seu OCR lê texto impresso sem problemas, mas falha com escrita à mão, você não está sozinho — esse é o modo de falha de extração mais comum, e tem pelo menos quatro causas distintas, cada uma com uma solução diferente. A boa notícia é que a maioria delas pode ser resolvida sem comprar software novo. O truque é saber em qual camada o problema está: qualidade da imagem, estilo da escrita, tipo de documento ou a própria ferramenta. Comece pela solução mais barata e vá aprofundando.
Principais conclusões
- Sua ferramenta de OCR funciona perfeitamente em texto impresso — então, quando ela ignora silenciosamente a escrita à mão, você assume que o scan está ruim ou que fez algo errado.
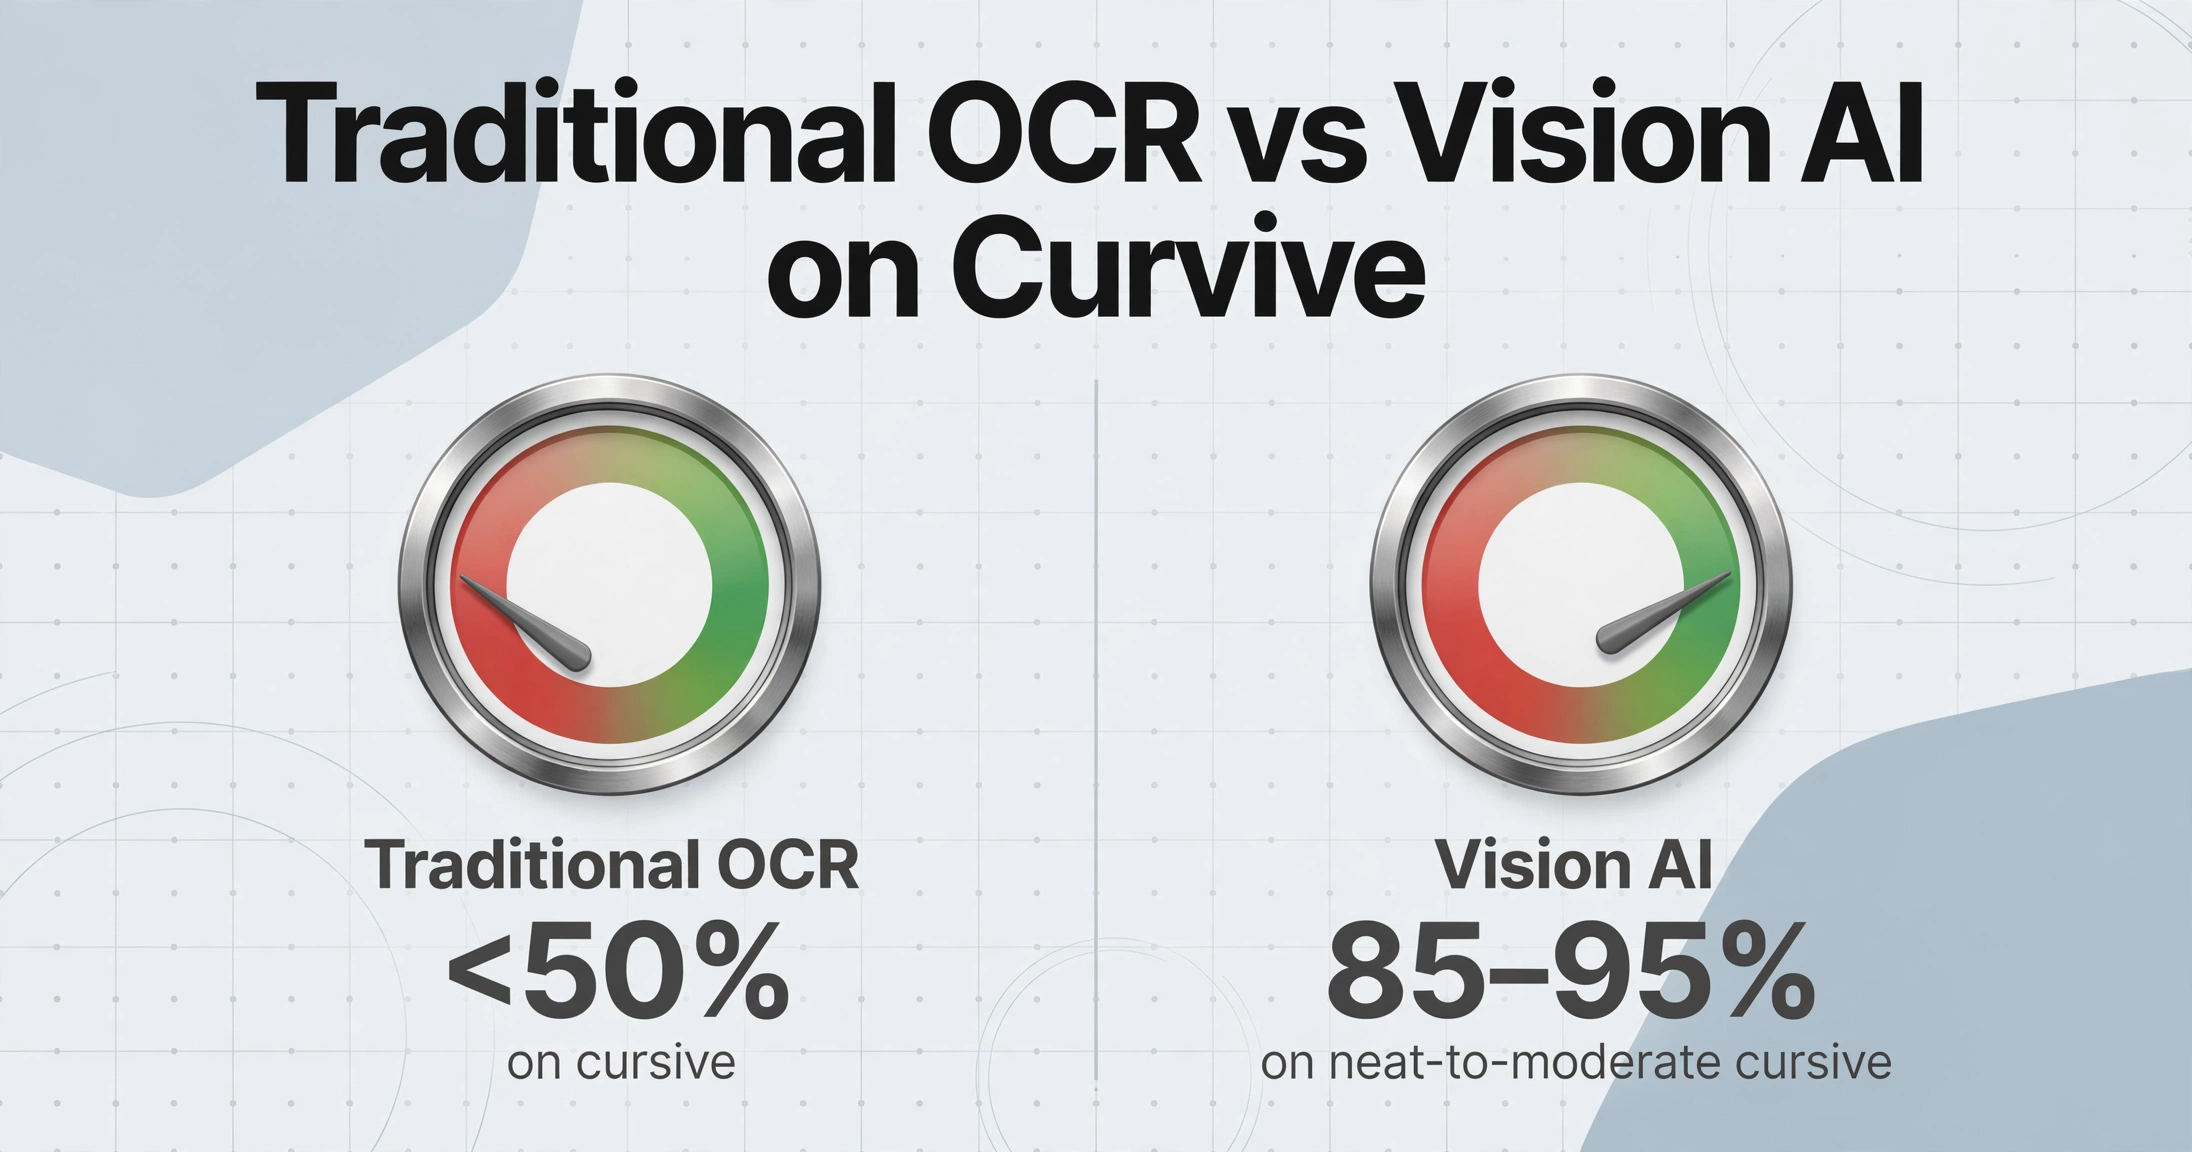
- O OCR tradicional (correspondência de padrões de texto em imagens) foi criado para segmentar caracteres impressos em modelos fixos; a escrita cursiva não tem limites de caracteres para segmentar, e a precisão cai abaixo de 50%.
- Teste um documento em uma ferramenta de IA de visão que lê palavras inteiras pelo contexto em vez de segmentar caracteres — se a precisão da escrita à mão saltar de adivinhação para 85-95%, a ferramenta era o gargalo o tempo todo.
Causa 1: Imagens Borradas ou de Baixa Resolução
A primeira coisa a verificar quase nunca é o software. Mecanismos de OCR tradicionais dependem de bordas nítidas entre caracteres. Quando uma imagem está borrada — comum em fotos de celular tiradas com pouca luz ou de perto — os limites dos caracteres se dissolvem. Um "e" borrado parece um "c", um "m" suave vira "n" e números manuscritos se confundem.
A resolução é igualmente importante. A maioria dos mecanismos de OCR espera pelo menos 300 DPI. Uma foto de documento tirada com celular geralmente fica entre 72 e 150 DPI quando a câmera está muito longe ou a iluminação força um obturador mais lento. Abaixo de 200 DPI, traços manuscritos pixelizam e perdem as curvas sutis que distinguem uma letra da outra.
Solução: Digitalize ou fotografe novamente o documento com no mínimo 300 DPI. Use um scanner de mesa sempre que possível — ele garante iluminação uniforme e foco consistente. Se precisar usar a câmera do celular, coloque o documento em uma superfície plana com boa luz (luz do dia, não luz de teto), mantenha a câmera paralela ao papel e toque para focar no texto antes de fotografar.
Causa 2: Captura Inclinada ou Mal Iluminada
Mesmo uma imagem nítida falha se o texto não estiver plano e uniformemente iluminado. Ao fotografar um documento em ângulo, os caracteres distorcem — um "a" inclinado assume uma forma que o mecanismo de OCR não reconhece. Sombras são igualmente destrutivas. Uma sombra sobre uma palavra manuscrita escurece o traço a ponto de o mecanismo enxergar uma lacuna, não uma letra.
Isso é especialmente comum com formulários manuscritos fotografados em uma mesa sob um único abajur. A sombra da mão do escritor ou a curvatura do próprio documento criam faixas escuras que interrompem o fluxo do texto.
Solução: Use iluminação frontal — posicione uma fonte de luz no mesmo lado da câmera, não atrás ou ao lado do documento. Muitos aplicativos de scanner para celular (Google Drive scan, Adobe Scan, Microsoft Lens) incluem correção automática de inclinação e remoção de sombras. Processe sua imagem em um deles antes de enviá-la à sua ferramenta de OCR. Se a ferramenta que você usa já faz correção automática, verifique se a imagem original não tem sombras tão profundas que nenhum algoritmo consiga recuperar o texto abaixo.
Causa 3: Escrita Cursiva e Conectada
É aqui que a maioria das ferramentas de OCR revela sua limitação fundamental. Os mecanismos de OCR tradicionais funcionam por segmentação — eles encontram as fronteiras entre caracteres, isolam cada um e os comparam com formas conhecidas. A escrita cursiva, por design, conecta cada letra em uma palavra. Não há fronteiras para encontrar. Uma mão que escreve "Monday" em um traço contínuo produz uma forma que o mecanismo de OCR não consegue dividir em caracteres individuais, então ele adivinha — e adivinha mal.
Isso não é um bug no software; é um limite arquitetural. O OCR tradicional (incluindo Tesseract, o mecanismo de OCR do Adobe Acrobat e a maioria das APIs de documentos em nuvem no modo básico) foi construído para texto impresso que fica em glifos organizados e separados. A escrita manual não.
Solução: A solução aqui não é um pré-processamento melhor — é um tipo diferente de ferramenta. Modelos de Visão IA (às vezes chamados de OCR baseado em VLM ou LLM) não segmentam caracteres. Eles leem palavras inteiras no contexto, da mesma forma que uma pessoa lê uma nota manuscrita: observando a forma da palavra inteira, o texto ao redor e o propósito do documento. Modelos modernos de Visão IA alcançam 85–95% de precisão em cursiva legível a moderada, em comparação com menos de 50% do OCR tradicional na mesma entrada.
Se você ainda não leu, veja como a Visão IA lê escrita manual de forma diferente do OCR tradicional — a diferença arquitetural explica por que um falha e o outro funciona.
Causa 4: Espaçamento Irregular, Tamanhos e Desvio da Linha Base
Até a escrita manuscrita impressa pode confundir o OCR se a escrita não segue uma grade consistente. Diferentemente do texto impresso por máquina, a escrita à mano raramente permanece em uma linha base horizontal perfeita. As letras se desviam acima e abaixo da linha. Os tamanos variam — um "S" maiúsculo pode ter três vezes a altura de um "c" minúsculo escrito pela mesma pessoa. O espaçamento entre palavras é irregular e, às vezes, inexistente.
Os motores de OCR tradicionais dependem de métricas previsíveis: altura do x, altura das ascendentes, linha base consistente. Quando essas métricas flutuam dentro de uma única frase, a lógica de segmentação e reconhecimento de caracteres produz erros que se propagam — uma primeira letra mal lida leva a uma correspondência de palavra errada, o que desestabiliza toda a linha.
Solução: Não há truque de processamento de imagem que "corrija" a escrita inconsistente. A solução é a mesma que para a Causa 3: uma ferramenta que lê contextualmente, não por modelo. As ferramentas de IA de Visão lidam naturalmente com o desvio da linha base e a variação de tamanho porque não assumem uma grade de caracteres fixa. Tratam a escrita irregular como entrada normal, não como um erro a corrigir.
Causa 5: Escrita à Mano em Documentos Não Estruturados
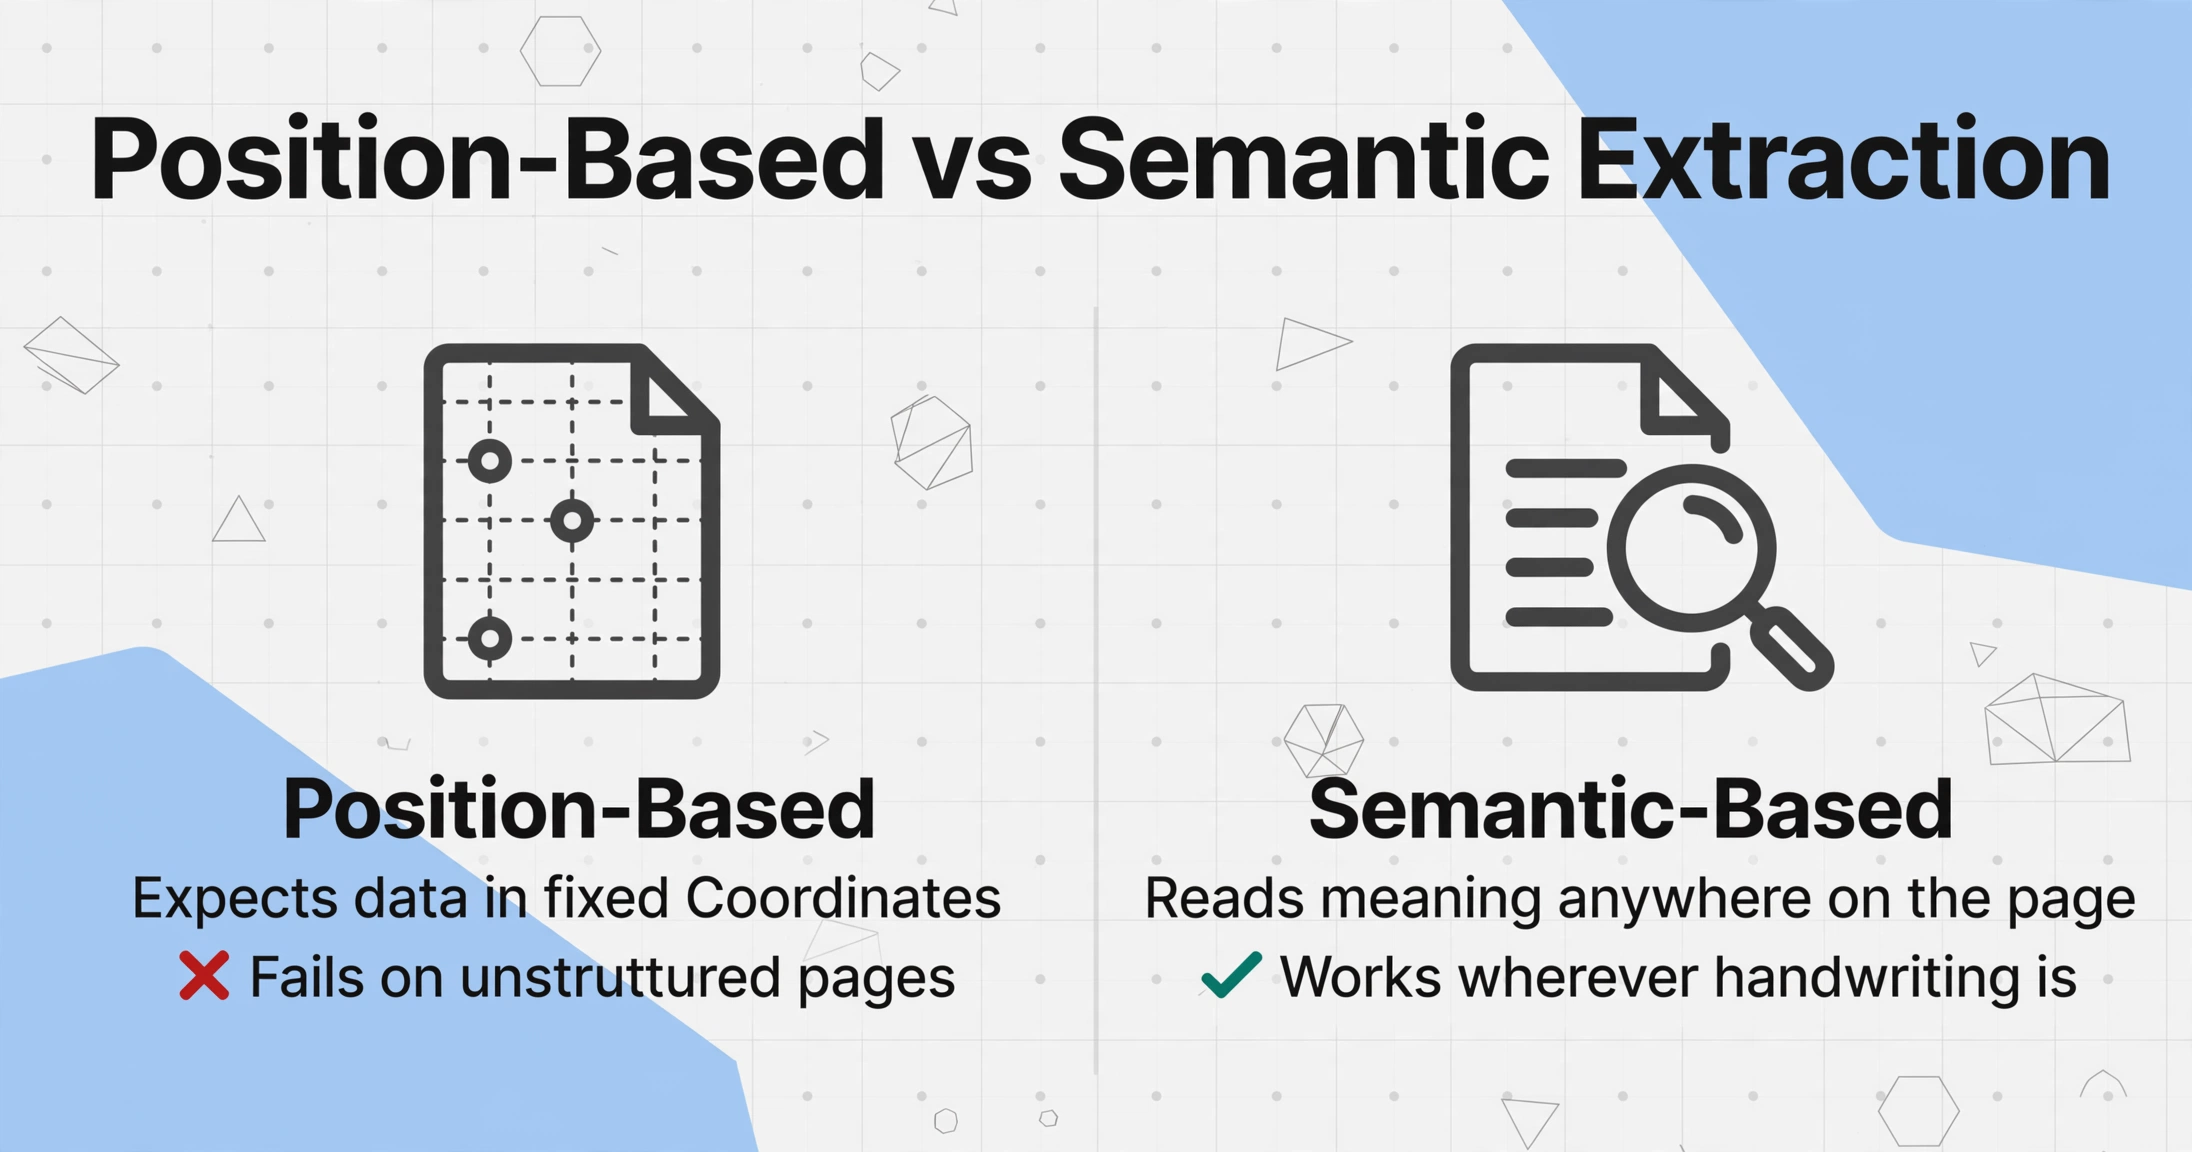
Onde a escrita à mano está na página importa tanto como a forma como está escrita. Muitas ferramentas de OCR — especialmente as baseadas em modelos — dependem de saber onde procurar. Uma ferramenta configurada para extraer "Nome do Cliente" da linha 3, columna 2 de um formulário de fatura impresso falha completamente quando esse nome é escrito à mano na margen, ou em uma folha de papel em branco.
Documentos não estruturados incluem notas de campo, fichas de inspeção, recibos de entrega com comentários escritos à mano em espaço aberto e notas de reuniões. Estes documentos não têm zonas de layout previsibles para que o OCR se ancore. Quando a escrita à mano pode aparecer em qualquer lugar da página, a extração baseada em posição se rompe.
Solução: Use uma ferramenta de extração sem modelo que lea toda a página semáticamente em lugar de esperar dados em coordenadas fixas. ImageToTable.ai, por exemplo, usa Extração de Colunas Personalizadas: você digita os nomes das colunas que deseja (como "Endereço de Entrega" ou "Notas do Inspector"), e a IA localiza o conteúdo manuscrito correspondente em qualquer lugar da página ao entender o que cada campo significa — não ao saber onde está. Esta é a diferença entre a extração baseada em posição (frágil em documentos não estruturados) e a extração sem modelo (funciona onde quer que esteja a escrita à mano).
Causa 6: Sua Ferramenta Fue Feita para Impressão, Não para Escritura Manual
Esta é a camada mais profunda, e a que a maioria dos usuários ignora porque a ferramenta "dice" que faz OCR. O OCR tradicional — a tecnologia por trás de Tesseract, a maioria dos editores de PDF e scanners de documentos de uso geral — foi inventado na década de 1970 para texto impresso por máquina. Ele usa correspondência de padrões contra modelos de caracteres fixos. Um "A" impresso sempre parece igual porque é uma fonte. Um "A" escrito à mano varia segundo o escritor, o humor, o ângulo da caneta e a letra que vem antes.
Os benchmarks do setor estiman a precisão do OCR tradicional em escritura cursiva em menos de 50% — o que significa que mais da metade das palavras estão erradas. Mesmo em escritura manual impressa e ordenada, a precisão fica em torno de 70–75%. Os modelos de IA de visão, por outro lado, alcanzan 85–95% em escritura manual de qualidade razoável — a mesma entrada, resultados muito diferentes.
"Qualidade razoável" definida: 300 DPI ou superior, iluminação frontal uniforme, sem obstruções (dedos, sombras, dobras), documento plano, texto aproximadamente horizontal. Essa é a base para um bom resultado de qualquer ferramenta, incluindo a IA de visão.
Solução: Passe de um motor de OCR tradicional a uma ferramenta de extração com IA de visão que usa grandes modelos de linguagem para ler documentos. A diferença não é incremental — é categórica. O OCR tradicional tenta corresponder padrões de píxeles. A IA de visão lê o contexto, entende a estrutura do documento e maneja a variabilidade natural da escritura manual. Para um detalhe da brecha de precisão, veja nuestra comparación de precisión de IA vs. escritura manual tradicional.
Por que isso importa
Se sua ferramenta usa OCR tradicional, você não está falhando na extração de escritura manual — a ferramenta nunca foi projetada para isso. As seis causas acima se acumulam umas sobre outras: corrija primeiro a qualidade da imagem, depois o estilo de escritura, depois a estrutura do documento e, por último, a arquitetura da ferramenta. A maioria das falhas de extração de escritura manual se resolve apenas com a camada 1 ou 2.
Quando Escalar — O Que Ainda Precisa de Inserção Manual
Honestidade é essencial aqui. Mesmo as melhores ferramentas de IA visual têm limites com caligrafia. Planeje o tratamento manual nestes casos:
- Caligrafia extremamente bagunçada ou ilegível — do tipo que um colega teria dificuldade para ler. Nenhuma ferramenta consegue extrair texto que um humano não consegue decifrar.
- Caligrafia com idiomas misturados — caligrafia que alterna entre alfabetos (ex.: latino e árabe, ou inglês e kanji) na mesma frase. A maioria dos modelos de visão é treinada principalmente em documentos de um único idioma.
- Campos numéricos críticos sem contexto de validação — números de conta bancária, CPF/CNPJ ou números de peça escritos à mão, onde um único caractere errado causa danos reais. Estes devem sempre ser verificados por humanos, mesmo que a IA os extraia.
- Originais muito desbotados ou danificados — tinta que desbotou ao longo de décadas, papel com danos causados por água ou texto escrito em fundo escuro ou estampado. A IA às vezes consegue recuperar mais que o OCR tradicional, mas há um limite abaixo do qual nenhuma ferramenta funciona.
O fluxo de trabalho prático: use a extração por IA para obter automaticamente 85–95% dos dados e, em seguida, direcione os campos difíceis restantes para uma etapa de revisão humana. Isso é mais rápido que a inserção manual em todos os campos e mais confiável do que confiar na IA em todos eles.
Perguntas Frequentes
Por que o OCR funciona em texto impresso, mas falha na caligrafia?
O OCR tradicional usa correspondência de padrões com modelos de caracteres fixos — a mesma abordagem que lê fontes impressas perfeitamente porque cada "A" na mesma fonte é idêntico. A caligrafia não tem um modelo fixo; cada escritor forma letras de maneira diferente, e até a mesma pessoa varia sua escrita com base na velocidade, caneta e humor. A abordagem que funciona para texto impresso simplesmente não se aplica à caligrafia.
Qual qualidade de imagem eu preciso para OCR de manuscritos?
Resolução mínima de 300 DPI, iluminação frontal uniforme (sem sombras sobre o texto), documento plano e sem obstruções, texto aproximadamente horizontal. Isso se aplica tanto a ferramentas de OCR tradicionais quanto a IA de visão — nenhuma ferramenta consegue ler o que não consegue ver.
A IA realmente consegue ler letras ilegíveis?
Sim, dentro de limites. Modelos de IA de visão alcançam 85–95% de precisão em caligrafia moderada e 65–75% em cursiva bagunçada. O segredo é que a IA lê o contexto — ela usa as palavras ao redor e a estrutura do documento para interpretar caracteres ambíguos. Um mecanismo de OCR tradicional não tem esse contexto; ele só vê pixels. Se você quiser saber os números exatos por tipo de caligrafia, nossa comparação de precisão cobre exatamente o que a IA consegue e não consegue ler.
Vale a pena migrar para uma ferramenta de IA de visão, ou devo continuar com o que já tenho?
Se manuscritos fazem parte regular do seu fluxo de trabalho com documentos — notas de entrega escritas à mão, formulários de inspeção, folhas de ponto ou relatórios de campo — então sim. A diferença entre OCR tradicional (~50% de precisão em cursiva) e IA de visão (~85-95%) não é marginal; é a diferença entre uma saída inutilizável e um processo funcional. Se manuscritos são raros, tente melhorar a qualidade da imagem primeiro — isso sozinho resolve muitos casos.
As seis causas acima se acumulam umas sobre as outras. A maioria das falhas de extração de manuscritos é resolvida pelas duas primeiras camadas — melhor qualidade de imagem já faz diferença. Quando não resolve, a resposta não é uma configuração melhor de OCR; é uma ferramenta feita para manuscritos, não para texto impresso. Experimente com seu próprio documento manuscrito e veja em qual camada o seu problema está.