OCRが手書き文字を読み取れないのはなぜ?
よくある原因6つと対処法
OCRが印刷テキストは問題なく読み取れるのに、手書き文字では失敗してしまう——そんな経験はありませんか?これは最も一般的な抽出失敗のパターンで、原因は少なくとも4つあり、それぞれ対処法が異なります。良い知らせは、そのほとんどが新しいソフトウェアを購入せずに解決できることです。ポイントは、問題がどの層にあるかを見極めることです:画像品質、手書きのスタイル、文書の種類、それともツール自体。最もコストのかからない対処法から始めて、徐々に深く掘り下げていきましょう。
重要なポイント
- OCRツールは印刷テキストでは完璧に機能する——だから手書き文字を静かにスキップされると、スキャンが悪いのか、自分が何か間違えたのかと思ってしまいます。
- 従来のOCR(画像からテキストをパターンマッチングする方式)は、印刷された文字を固定テンプレートに分割するように作られています。筆記体には分割できる文字境界がなく、精度は50%未満にまで低下します。
- 文字を分割する代わりに文脈で単語全体を読むビジョンAIツールで同じ文書をテストしてみてください——手書き精度が推測レベルから85〜95%に向上すれば、最初からツールがボトルネックだったことになります。
原因1:画像のぼやけ・低解像度
まず確認すべきは、ほぼ間違いなくソフトウェアではありません。 従来のOCRエンジンは文字間の鮮明な境界に依存します。低照度や至近距離で撮影したスマホ写真によくあるように画像がぼやけると、文字の境界が不明瞭になります。ぼやけた「e」は「c」に見え、柔らかい「m」は「n」になり、手書きの数字は互いに潰れて判別不能になります。
解像度も同様に重要です。ほとんどのOCRエンジンは最低300 DPIを必要とします。書類のスマホ写真は、カメラが遠すぎたり、照明が暗くてシャッタースピードが遅くなると、通常72~150 DPI程度になります。200 DPIを下回ると、手書きのストロークがピクセル化し、文字を区別する微妙な曲線が失われます。
対策: 書類を最低300 DPIで再スキャンまたは再撮影してください。可能であればフラットベッドスキャナーを使用しましょう。均一な照明と安定した焦点が保証されます。スマホカメラを使用する場合は、書類を平らな面に置き、十分な光(天井灯ではなく自然光)の下で、カメラを紙と平行に構え、撮影前にテキスト部分をタップしてピントを合わせてください。
原因2:傾き・照明不良による撮影
テキストが平らで均一に照らされていなければ、鮮明な画像でも失敗します。 書類を斜めから撮影すると文字が歪みます。傾いた「a」はOCRエンジンが認識できない形状に変わります。影も同様に有害です。手書きの単語に影がかかると、ストロークが暗くなり、エンジンが文字ではなく隙間と認識してしまいます。
これは特に、デスクの上で単一のデスクライトの下で手書きのフォームを撮影する場合によく見られます。書き手の手や書類自体の反りによる影が暗い帯を作り、テキストの流れを分断します。
対策: 前方からの照明を使用してください。光源をカメラと同じ側に配置し、書類の後ろや横に置かないでください。多くのモバイルスキャナーアプリ(Google ドライブ スキャン、Adobe Scan、Microsoft Lens)には、自動傾き補正と影除去機能が含まれています。OCRツールに入力する前に、これらのアプリで画像を処理してください。使用しているツールにすでに自動補正機能がある場合でも、元の画像にアルゴリズムでは修復できないほど深い影がないか確認してください。
原因3:筆記体・つながった手書き文字
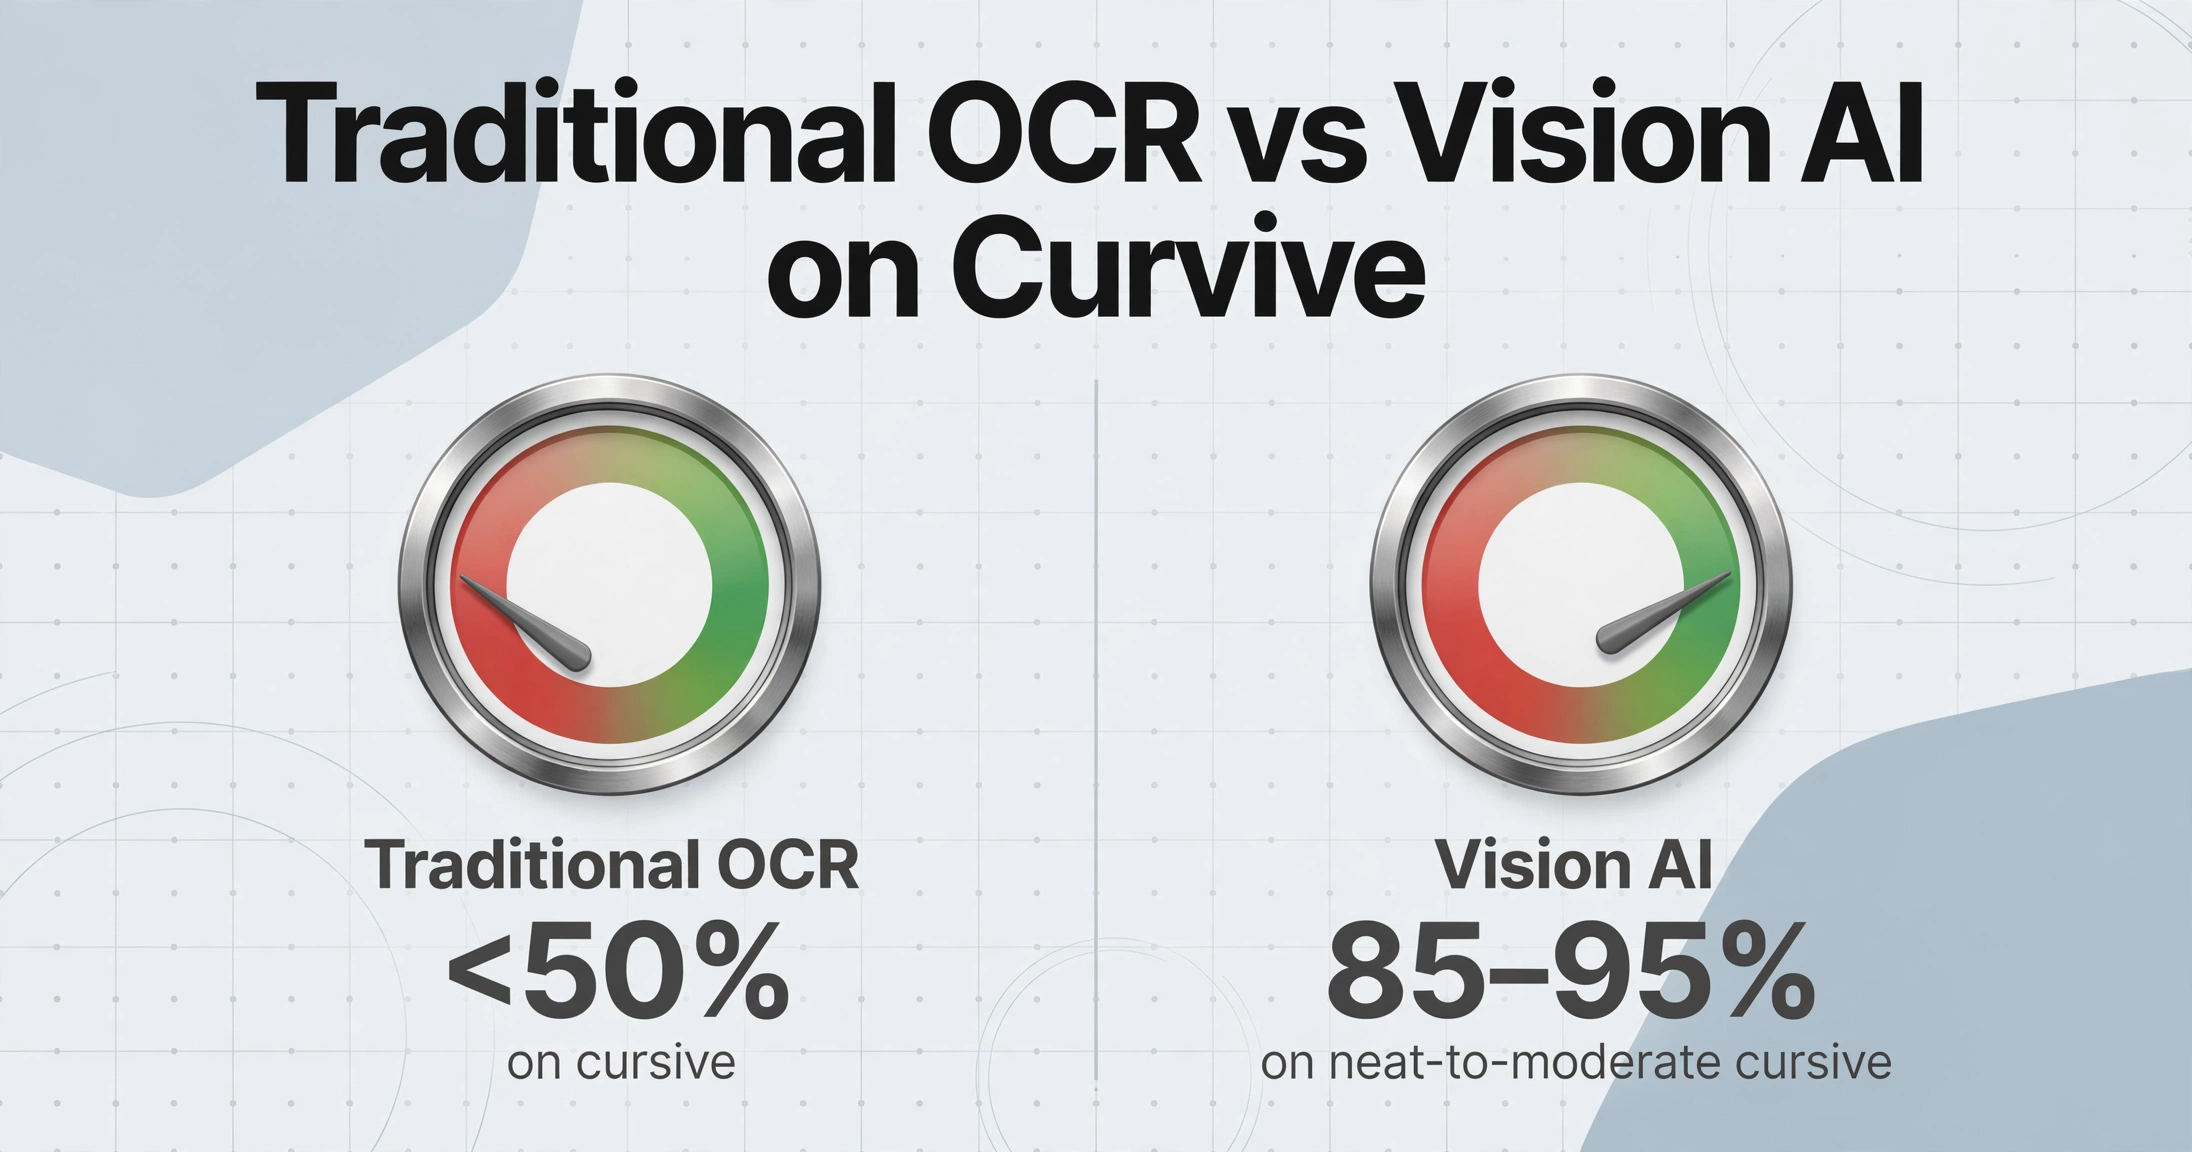
ここで、ほとんどのOCRツールが根本的な限界を露呈します。従来のOCRエンジンはセグメント化によって動作します。つまり、文字間の境界を見つけ、それぞれを分離し、既知の形状と照合します。筆記体は、設計上、単語内のすべての文字がつながっています。見つけるべき境界が存在しないのです。「Monday」と一筆書きで書かれた手書き文字は、OCRエンジンが個々の文字に分割できない形状を生み出し、結果として推測に頼ることになります——そしてその推測は大きく外れます。
これはソフトウェアのバグではなく、アーキテクチャ上の限界です。従来のOCR(Tesseract、Adobe AcrobatのOCRエンジン、ほとんどのクラウドドキュメントAPIの基本モードを含む)は、きれいに分離された活字を対象に作られています。手書き文字はその対象外です。
解決策:ここでの修正は前処理の改善ではなく、別の種類のツールを使うことです。Vision AIモデル(VLMベースまたはLLM OCRとも呼ばれます)は文字をセグメント化しません。人間が手書きのメモを読むのと同じように、単語全体の形状、周囲のテキスト、ドキュメントの目的を文脈ごと読むのです。最新のVision AIモデルは、整った〜中程度の筆記体で85〜95%の精度を達成します。一方、従来のOCRは同じ入力に対して50%未満です。
まだお読みでない方は、Vision AIが従来のOCRとどう違う方法で手書き文字を読むかをご覧ください。このアーキテクチャ上の違いが、一方が失敗し、もう一方が成功する理由を説明しています。
原因4:間隔・サイズ・ベースラインの不揃い
手書き文字でも、均一なグリッドがなければOCRは誤認識しやすくなります。機械印字と違い、手書き文字が完璧な水平ベースラインに沿うことはほとんどありません。文字はラインの上下にずれ、サイズもバラバラです。同じ筆跡でも、大文字の「S」が小文字の「c」の3倍の高さになることもあります。単語間の間隔も不規則で、時には間隔がまったくないこともあります。
従来のOCRエンジンは、x-height(エックスハイト)、アセンダーの高さ、一貫したベースラインといった予測可能な指標に依存しています。これらの指標が一文の中で変動すると、文字の切り出しと認識ロジックにエラーが発生し、それが連鎖します。最初の文字を誤読すると単語全体のマッチングが狂い、行全体の認識が崩れてしまいます。
対策:不揃いな手書き文字を「修正」する画像処理テクニックは存在しません。解決策は原因3と同じで、テンプレートではなく文脈で読むツールを使うことです。Vision AIツールは、固定の文字グリッドを前提としないため、ベースラインのずれやサイズのばらつきを自然に処理します。不規則な手書き文字を「修正すべきエラー」ではなく「通常の入力」として扱うのです。
原因5:非構造化文書への手書き文字
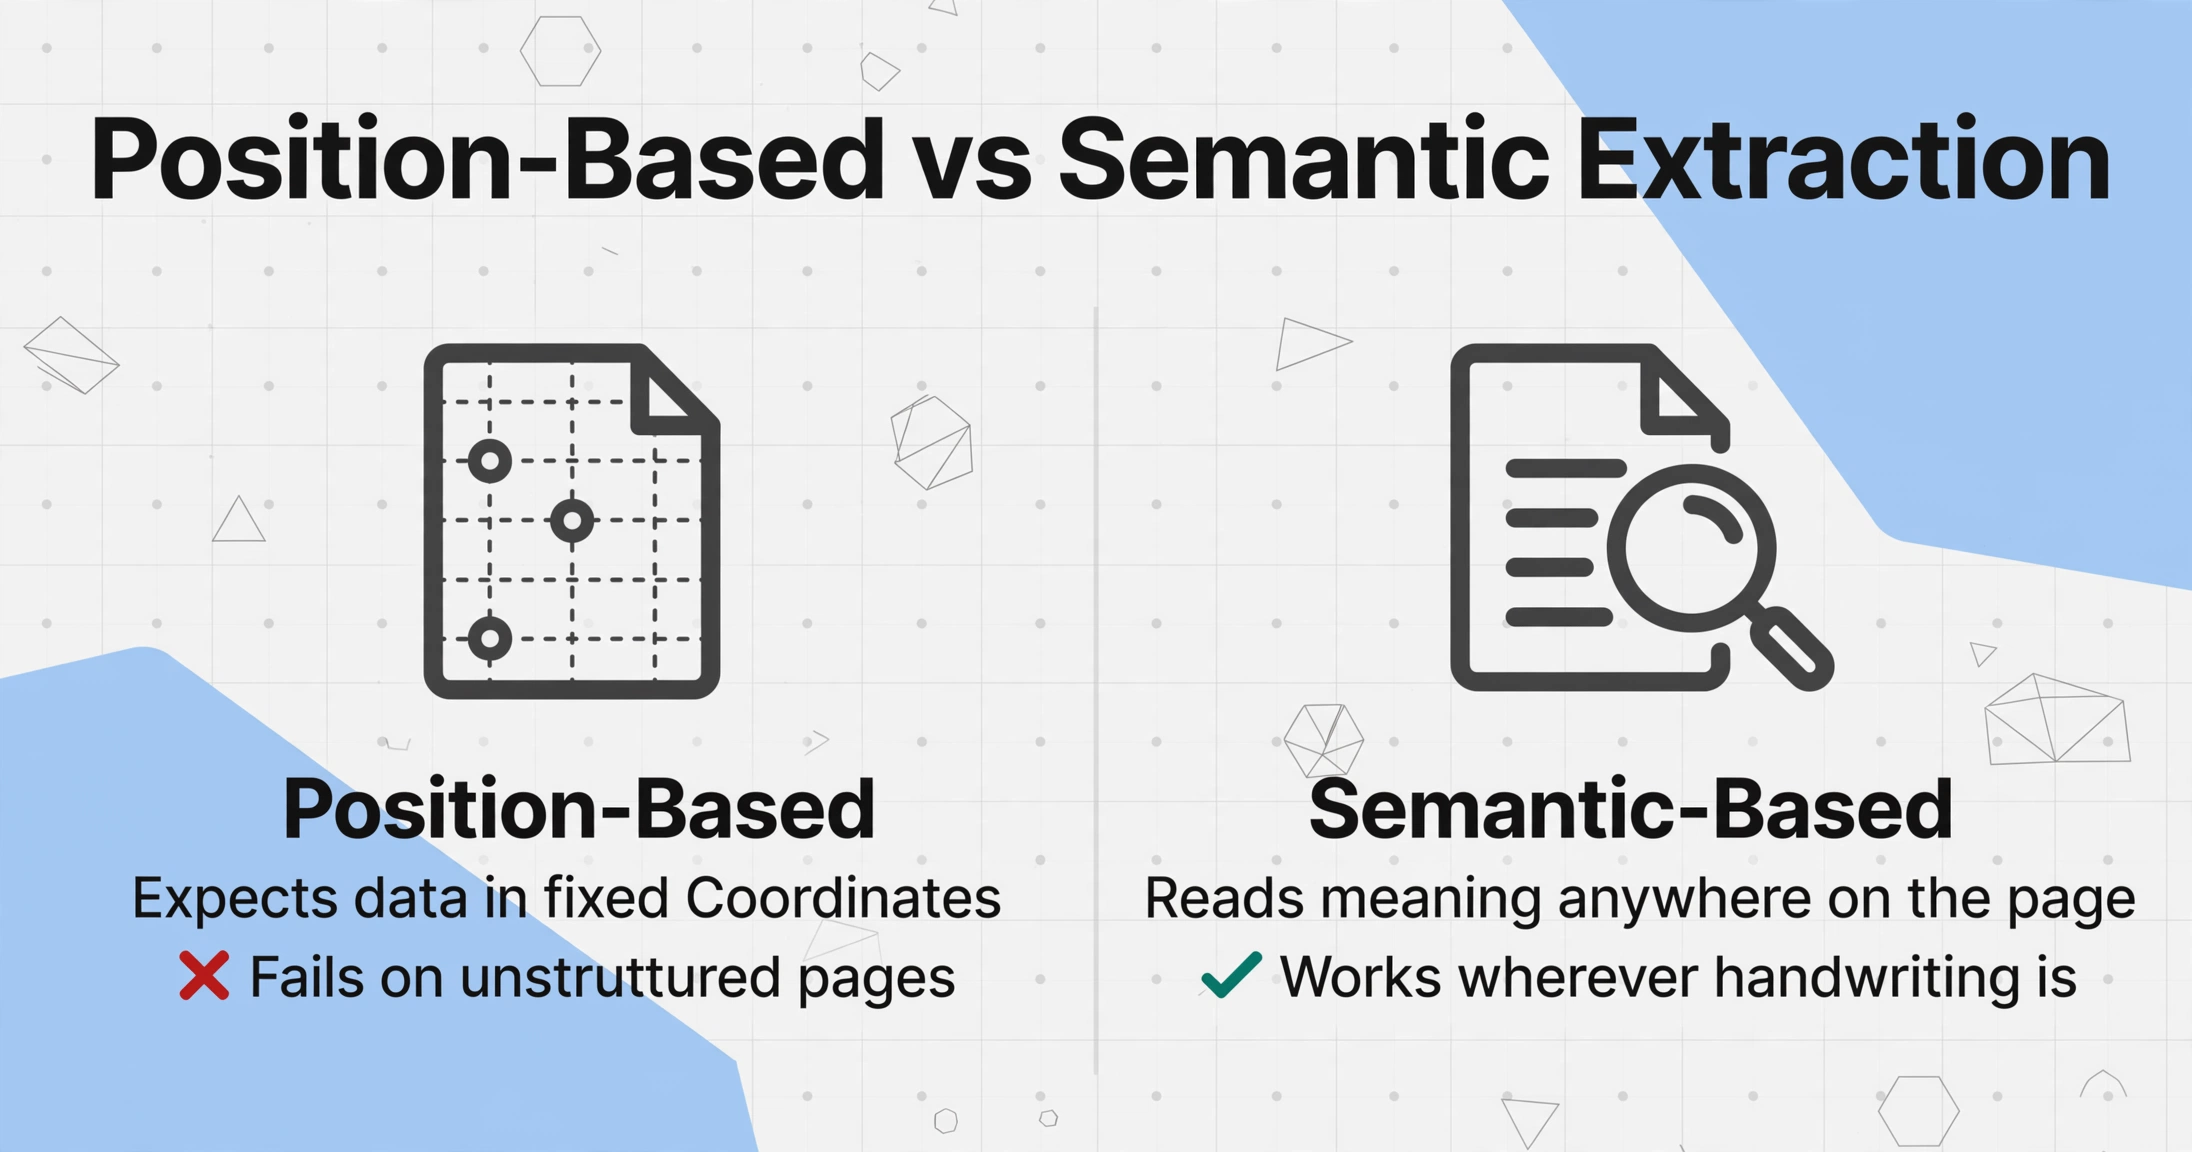
手書き文字がページのどこにあるかは、書き方と同じくらい重要です。多くのOCRツール、特にテンプレートベースのツールは、「どこを見ればよいか」を知っていることに依存しています。印刷された請求書フォームの3行目2列目から「顧客名」を抽出するように設定されたツールは、その名前が余白や白紙の紙に手書きされた場合、まったく機能しません。
非構造化文書には、現場メモ、点検シート、空きスペースに走り書きされたコメントのある納品書、会議メモなどが含まれます。これらの文書には、OCRが基準にできる予測可能なレイアウト領域がありません。手書き文字がページのどこにでも現れ得る場合、位置ベースの抽出は破綻します。
対策:固定座標でデータを期待するのではなく、ページ全体を意味的に読むテンプレート不要の抽出ツールを使用してください。例えばImageToTable.aiは、カスタム列抽出を使用します。「配送先住所」や「検査員メモ」などの列名を入力すると、AIは各フィールドの意味を理解することで、ページ上のどこにある手書きコンテンツでも照合します。位置ではなく意味で探すのです。これが、位置ベース抽出(非構造化文書では脆弱)と意味ベース抽出(手書き文字がどこにあっても機能する)の違いです。
原因6:ツールが手書きではなく印刷用に作られている
これは最も深い層であり、ツールが「OCR対応」と表示しているために、ほとんどのユーザーが見落としている点です。 従来のOCR — Tesseract、ほとんどのPDFエディタ、一般的な文書スキャナの背後にある技術 — は、1970年代に機械印刷テキスト用に発明されました。これは固定された文字テンプレートに対するパターンマッチングを使用します。印刷された「A」はフォントであるため常に同じに見えます。手書きの「A」は、書き手、気分、ペンの角度、前の文字によって異なります。
業界ベンチマークによると、従来のOCRの筆記体認識精度は50%未満 — つまり、単語の半分以上が誤認識されます。きれいな活字体の手書きでも、精度は約70〜75%です。対照的に、Vision AIモデルは、適切な品質の手書きで85〜95%の精度を達成します — 同じ入力でも、結果は大きく異なります。
「適切な品質」の定義: 300 DPI以上、均一な正面照明、遮蔽物なし(指、影、折り目)、文書が平らで、テキストがほぼ水平。これは、Vision AIを含むあらゆるツールで良い結果を得るための基準です。
修正方法: 従来のOCRエンジンから、大規模言語モデルを使用して文書を読み取るVision AI抽出ツールに切り替えます。その違いは漸進的ではなく、カテゴリ的に異なります。従来のOCRはピクセルパターンのマッチングを試みます。Vision AIは文脈を読み取り、文書構造を理解し、手書きの自然なばらつきを処理します。精度の差の詳細な内訳については、AIと従来の手書き認識精度の比較をご覧ください。
これが重要な理由
ツールが従来のOCRを使用している場合、手書き抽出に失敗しているのではありません — ツールがそもそもそのために設計されていないのです。上記の6つの原因は互いに積み重なります:まず画像品質を修正し、次に手書きスタイル、文書構造、そしてツールのアーキテクチャの順に修正します。ほとんどの手書き抽出の失敗は、レイヤー1または2だけで解決されます。
エスカレーションのタイミング — 手動入力が必要なケース
正直さが重要です。 最高のビジョンAIツールでも手書き文字には限界があります。以下のケースでは手動対応を計画してください。
- 極端に乱雑または判読不能な手書き — 同僚でも読むのに苦労するようなもの。人間が解読できない文字をツールが確実に抽出することはできません。
- 複数言語が混在した手書き — 同じ文の中でラテン文字とアラビア文字、英語と漢字など、異なる文字体系が切り替わるもの。ほとんどのビジョンモデルは単一言語の文書を主な学習データとしています。
- 検証コンテキストのない重要な数値フィールド — 手書きの銀行口座番号、納税者番号、部品番号など、1文字の誤りが重大な損害につながるもの。AIが抽出した場合でも、必ず人間による確認が必要です。
- 非常に薄い、または損傷した原本 — 数十年で薄れたインク、水濡れのある紙、暗い背景や柄のある背景に書かれた文字。AIが従来のOCRよりも多くの情報を復元できる場合もありますが、どのツールも機能しなくなる限界があります。
実用的なワークフロー:AI抽出でデータの85~95%を自動取得し、残りの困難なフィールドを人間によるレビューステップに回します。これは全フィールドを手動入力するより速く、全フィールドをAIに任せるより信頼性が高くなります。
よくある質問
OCRは印刷テキストでは機能するのに、手書きではなぜ失敗するのですか?
従来のOCRは固定された文字テンプレートに対するパターンマッチングを使用します。これは、同じフォントの「A」がすべて同一であるため、印刷フォントを完璧に読み取るアプローチです。手書きには固定テンプレートがなく、書き手ごとに文字の形が異なり、同じ人でも速度、ペン、気分によって字が変わります。印刷に有効なアプローチは、手書きには単純に適用できません。
手書きOCRにはどの程度の画質が必要ですか?
最低300 DPIの解像度、均一な正面照明(文字に影がかからないこと)、平らで遮蔽物のないドキュメント、テキストがほぼ水平であること。これは従来のOCRにもビジョンAIツールにも当てはまります。見えないものはどのツールでも読み取れません。
AIは本当に読みにくい手書き文字を読めるのですか?
はい、限界はありますが可能です。ビジョンAIモデルは、中程度の手書き文字で85〜95%、読みにくい筆記体で65〜75%の精度を達成します。重要なのは、AIが文脈を読むことです。周囲の単語やドキュメント構造を利用して、不明瞭な文字を判別します。従来のOCRエンジンにはそのような文脈がなく、ピクセルしか見えません。手書き文字の種類ごとの正確な数値に興味がある場合は、精度比較でAIが正確に読めるものと読めないものを詳しく解説しています。
ビジョンAIツールにアップグレードする価値はありますか、それとも今のツールを使い続けるべきですか?
手書き文字がドキュメントワークフローの定番部分である場合(手書きの納品書、点検フォーム、タイムシート、現場レポートなど)、答えはイエスです。従来のOCR(筆記体で約50%の精度)とビジョンAI(85〜95%)の差はわずかなものではなく、使えない出力と機能するプロセスの違いです。手書き文字がまれな場合は、まず画質の改善を試してください。それだけで多くのケースが解決します。
上記の6つの原因は互いに重なり合っています。手書き文字抽出の失敗のほとんどは、最初の2つのレイヤーで解決できます。画質を改善するだけで大きな違いが生まれます。それでも解決しない場合、答えはより良いOCR設定ではなく、印刷文字ではなく手書き文字向けに作られたツールです。ご自身の手書きドキュメントで試して、問題がどのレイヤーにあるかを確認してください。