Cómo extraer datos de
formularios de reclamación médica CMS-1500 a Excel
El formulario CMS-1500 captura todo lo que una aseguradora necesita para procesar una reclamación profesional: datos demográficos del paciente, cobertura de seguro, códigos de diagnóstico ICD-10-CM, códigos de procedimiento CPT con modificadores, fechas de servicio, cargos e identificadores del proveedor en 33 casillas numeradas. Todo cabe en una sola página en una cuadrícula densa diseñada para la lectura humana, no para la extracción automática. Esa densidad es la razón por la que el formulario funciona tan eficientemente para la adjudicación de reclamaciones, y exactamente por qué escribir manualmente sus datos en una hoja de cálculo o sistema de facturación genera tantos errores.
Conclusiones clave
- Usted se culpa cuando una reclamación CMS-1500 es rechazada, pero un puntero de diagnóstico en la casilla 24E que no hace referencia a un código ICD-10 válido en la casilla 21 es un error invisible para el ojo humano en el momento de la entrada.
- Ese único desajuste entre campos volverá como rechazo de 30 a 60 días después, y el tiempo dedicado a investigarlo borra cada minuto que la entrada manual de datos debía ahorrar.
- La extracción con IA semántica que lee el formulario comprendiendo lo que significa cada campo le permite auditar la salida estructurada contra las reglas del pagador en lugar de escribir cada valor, detectando errores de dependencia antes de que lo haga el pagador.
¿Qué es el formulario CMS-1500?
El CMS-1500 — aún conocido comúnmente como HCFA-1500 — es el formulario estandarizado de reclamaciones de seguro de salud utilizado por médicos, terapeutas, clínicas y otros proveedores de atención médica no institucionales para facturar a Medicare, Medicaid y aseguradoras comerciales por servicios profesionales. Es mantenido por el Comité Nacional de Reclamaciones Uniformes (NUCC), un organismo de estándares voluntario presidido por la Asociación Médica Estadounidense con los Centros de Servicios de Medicare y Medicaid como socio clave. La versión actual — formulario 02/12 — fue aprobada en febrero de 2012 y se convirtió en el formato impreso obligatorio en abril de 2014. El NUCC publicó el manual de instrucciones Versión 13.0 en julio de 2025, reflejando las actualizaciones más recientes a las reglas de campos y requisitos de codificación.
Las 33 casillas numeradas del formulario se dividen en tres zonas funcionales:
- Casillas 1–13 — Información del paciente y del seguro: nombre del paciente, fecha de nacimiento, sexo, dirección, número de póliza de seguro, nombre del asegurado, relación con el asegurado, detalles de coordinación de beneficios.
- Casillas 14–23 — Detalles de la condición y autorización: fechas de enfermedad o lesión, fechas de hospitalización, fecha del último día trabajado, información de referencia, códigos de diagnóstico ICD-10-CM (hasta 12), número de autorización previa, códigos de reenvío de Medicaid.
- Casillas 24–33 — Líneas de servicio y datos del proveedor facturador: seis filas de líneas de servicio (fechas de servicio, lugar de servicio, código CPT/HCPCS, modificadores, indicador de diagnóstico, cargos, unidades), nombre del proveedor facturador, NPI, identificación fiscal, firma del proveedor.
Entre estas casillas, aproximadamente 90 puntos de datos individuales deben estar presentes en una reclamación completa y presentable. Esto no es una exageración: el manual de especificaciones del formulario tiene más de 60 páginas detallando las reglas de formato para cada campo.
Por qué la entrada manual de datos del CMS-1500 es un cuello de botella
Un especialista en facturación que procesa formularios CMS-1500 en papel sigue el mismo ciclo, formulario tras formulario: mira el documento, identifica el valor de cada campo, encuentra el campo correspondiente en el software de facturación o la hoja de cálculo, lo escribe, lo verifica contra la fuente y pasa a la siguiente entrada. Con aproximadamente 90 puntos de datos por reclamación, y con las líneas de servicio en el Bloque 24A–J repitiéndose en seis líneas, la carga cognitiva se acumula rápidamente. Una sola fila en el Bloque 24 incluye las fechas de servicio desde y hasta (24A), el código de lugar de servicio (24B), el indicador de emergencia (24C), el código CPT o HCPCS con hasta cuatro modificadores (24D), un puntero de diagnóstico que enlaza con el Bloque 21 (24E), el cargo facturado (24F), el número de días o unidades (24G) y el NPI del proveedor que factura (24J).
Lo que hace que el CMS-1500 sea diferente de la entrada de documentos genérica es la cadena de dependencias entre campos. El puntero de diagnóstico en el Bloque 24E debe hacer referencia a un código ICD-10 válido que exista en el Bloque 21. El código CPT en el Bloque 24D debe ser apropiado para el código de lugar de servicio en el Bloque 24B. El NPI en el Bloque 24J debe coincidir con los registros de inscripción del proveedor en el Bloque 33. Estas relaciones entre campos son invisibles para la persona que escribe; solo salen a la luz cuando la reclamación regresa denegada, semanas después, con un código de rechazo que dice "El puntero de diagnóstico no hace referencia a un código de diagnóstico válido".
La comunidad r/CodingandBilling en Reddit expone regularmente estas frustraciones: facturadores preguntando si un modificador debe ir en una línea específica, si el código de taxonomía en el Bloque 33b coincide con el registro NPPES, o si un centro de compensación rechazará una reclamación donde el NPI de la instalación de servicio en el Bloque 32a no coincide con el proveedor que factura. Estas no son brechas de conocimiento — son la consecuencia natural de un formulario que agrupa docenas de campos interdependientes en una sola página y depende de la transcripción manual para acertar cada vez.
Para una visión más amplia de cómo la extracción de CMS-1500 se integra con EOB, reclamaciones UB-04 y otros documentos de pagadores, consulte nuestra guía de OCR para el sector salud. Si está comparando herramientas específicamente en la precisión de extracción de formularios de reclamación, nuestro resumen de herramientas de extracción de documentos de salud prueba siete plataformas con documentos CMS-1500 y EOB reales.
Tres razones por las que la extracción de CMS-1500 es más difícil que la de otros documentos médicos
La extracción de CMS-1500 presenta desafíos que la mayoría de las herramientas OCR de documentos generales no están diseñadas para manejar. Comprenderlos es el primer paso para elegir una solución viable.
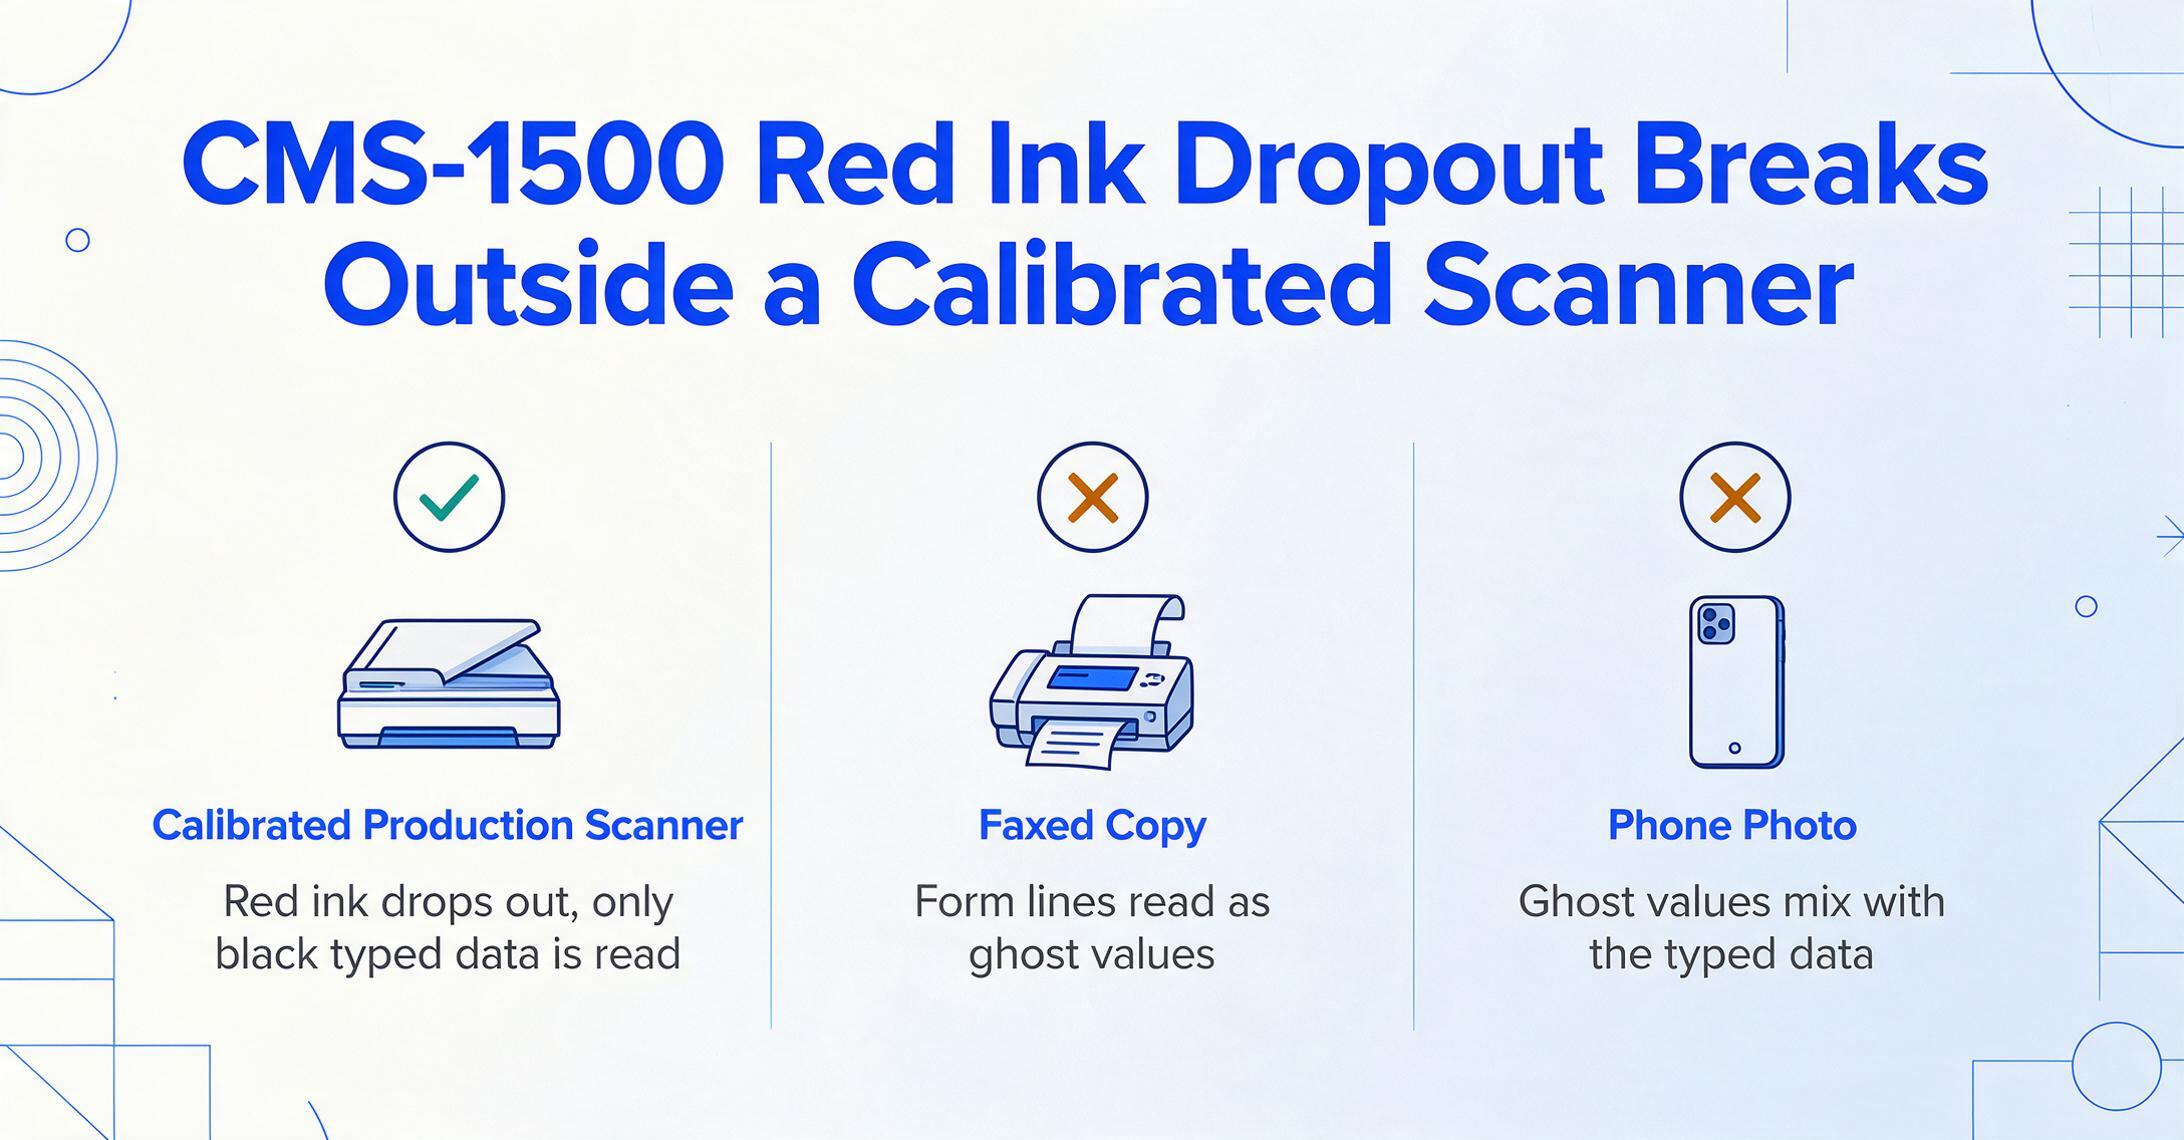
1. Caída de tinta roja. Los formularios CMS-1500 están impresos en tinta Flint OCR Red (J6983), una formulación específica diseñada para desaparecer durante el escaneo OCR de alta velocidad, de modo que solo se lean los datos ingresados (escritos en negro), mientras que las líneas del formulario, las etiquetas de campo y los bordes de las casillas son invisibles para el escáner. Esto funciona en los centros de procesamiento de contratistas administrativos de Medicare con escáneres de producción calibrados. Pero cuando un CMS-1500 llega como copia por fax, una fotocopia escaneada en una impresora multifunción o una foto de teléfono de una reclamación en papel, la tinta roja no desaparece limpiamente. El resultado: las herramientas OCR genéricas leen las etiquetas de campo y las líneas del formulario como texto, produciendo una mezcla ruidosa de valores fantasma mezclados con datos reales.
2. Diseño de cuadrícula densa con restricciones de un carácter por casilla. La tabla de líneas de servicio de la casilla 24 empaqueta seis filas de datos en un espacio fijo de aproximadamente 4 por 6 pulgadas, con 10 columnas por fila. Muchos campos — especialmente los números NPI en la casilla 24J y los indicadores de diagnóstico en la casilla 24E — requieren precisión a nivel de carácter dentro de casillas impresas pequeñas. Las entradas manuscritas que cruzan los límites de las casillas o se extienden a columnas adyacentes hacen que el OCR tradicional basado en zonas lea mal el campo por completo. El problema no es que los caracteres sean ilegibles — es que su ubicación espacial relativa a los límites de las columnas es ambigua.
3. Requisitos de precisión a nivel de campo con tolerancia cero. Un código CPT en la casilla 24D debe incluir el modificador correcto, o la reclamación es rechazada. Un código ICD-10-CM en la casilla 21 debe informarse al nivel más alto de especificidad — "E11.9" para diabetes tipo 2 sin complicaciones, no solo "E11." Un NPI de 10 dígitos en la casilla 17 (proveedor remitente) no debe tener dígitos transpuestos. El Manual de Procesamiento de Reclamaciones de Medicare (Capítulo 26) especifica exactamente cómo debe formatearse cada campo, y los pagadores hacen cumplir estas reglas en el punto de presentación. La precisión de la extracción no se mide en "corrección general" — o pasa la validación del pagador o no.
Cómo la extracción de IA sin plantilla maneja estos desafíos
Las herramientas tradicionales de OCR basadas en plantillas requieren que dibuje zonas de campo en un formulario en blanco — "El recuadro 21 comienza en la coordenada de píxel (x, y) y termina en (x₂, y₂)" — y que mantenga plantillas separadas para cada versión del formulario, calibración del escáner y orientación del papel. Cuando llega un CMS-1500 con una ligera inclinación, un encabezado de fax estampado en la parte superior o una variante de diseño diferente, las coordenadas de las zonas se desvían y la calidad de la extracción se desploma.
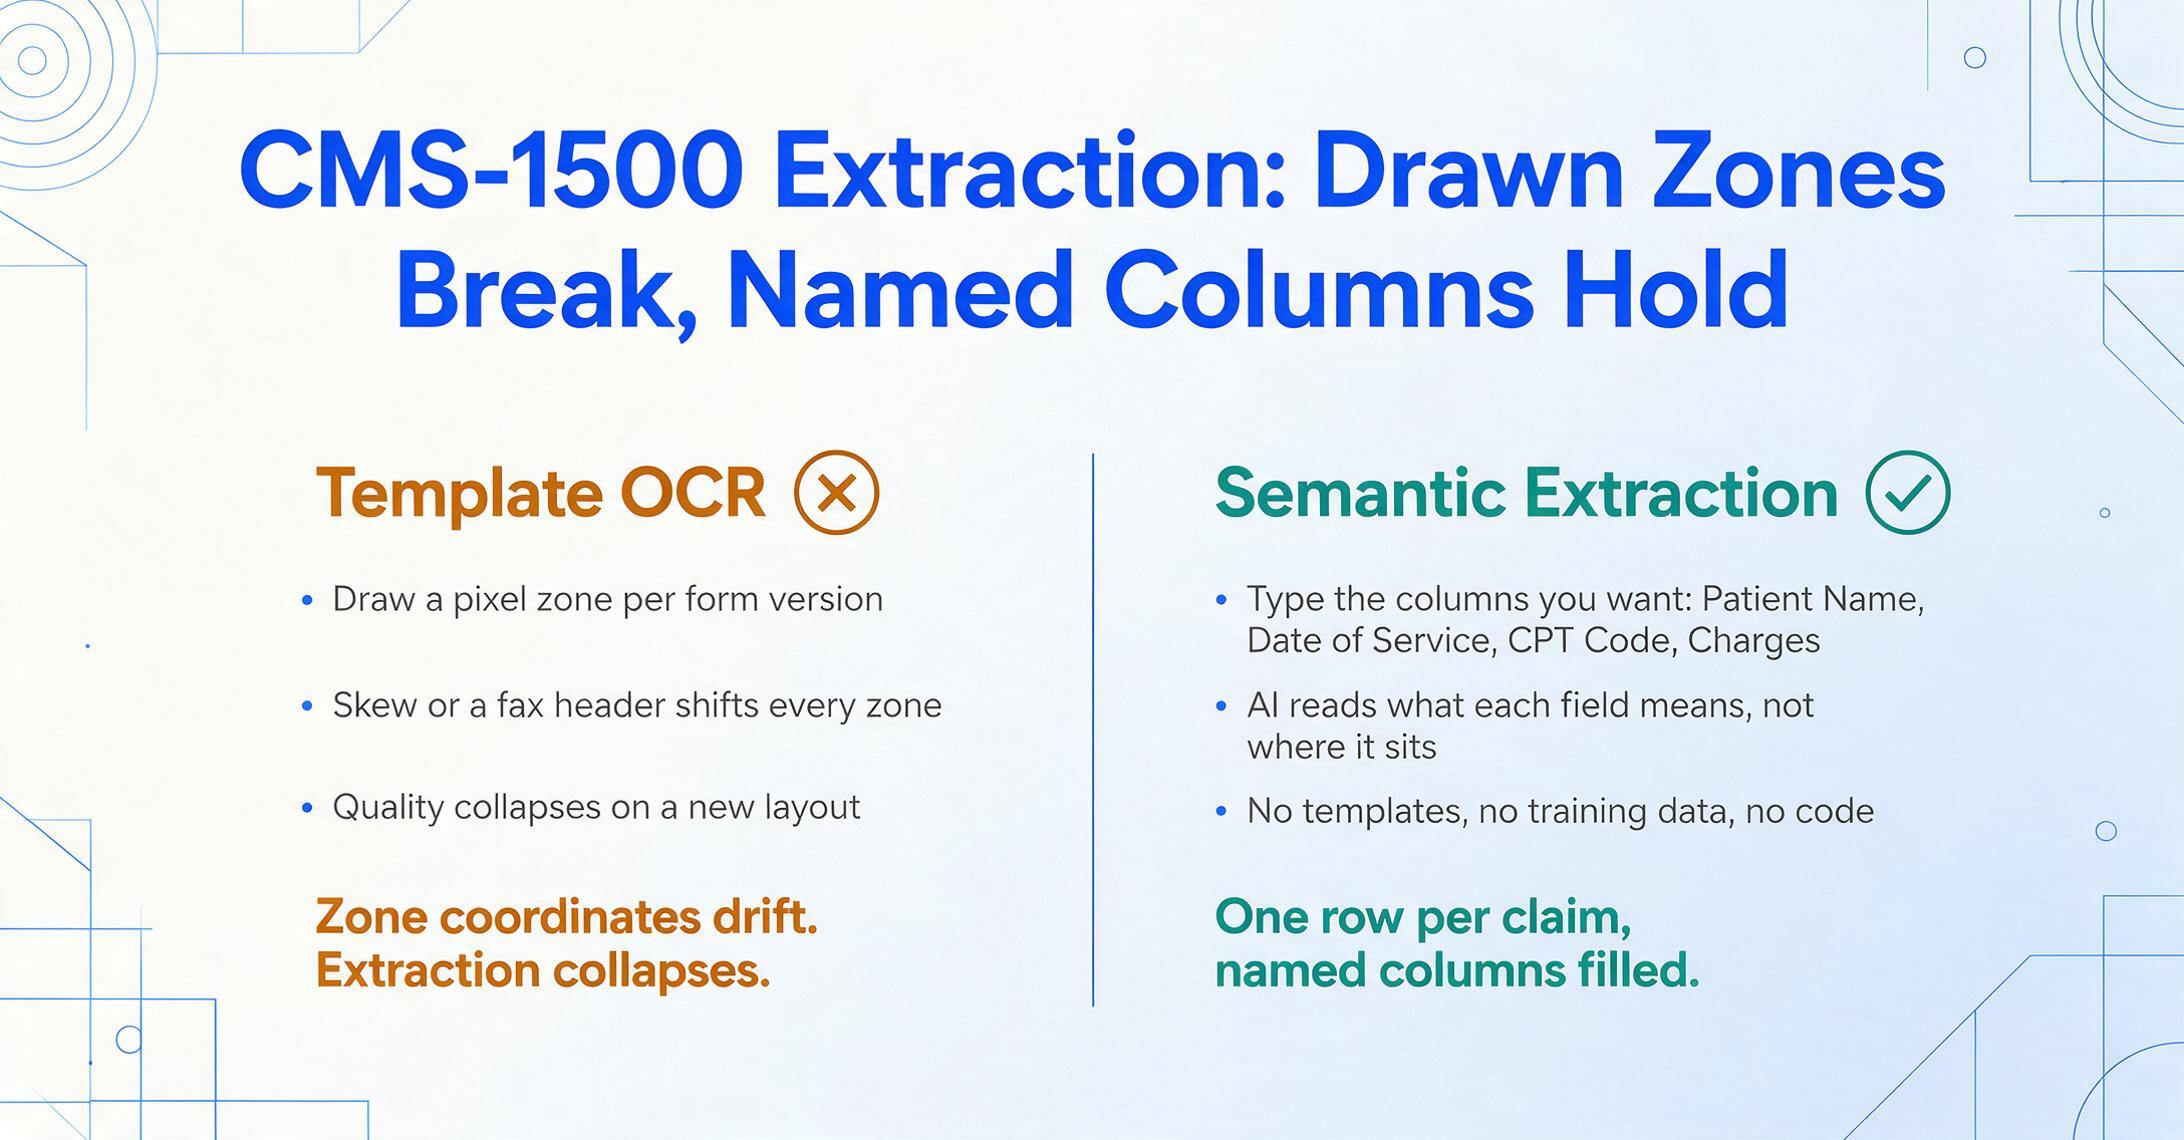
Un enfoque de extracción semántica sin plantilla funciona de manera diferente. En lugar de preguntar "¿dónde está este campo en la página?", pregunta "¿qué significa este campo en el documento?". Usted define la salida nombrando las columnas que desea — "Nombre del paciente", "Fecha del servicio", "Código CPT", "Código de diagnóstico", "Cargos" — y la IA localiza cada valor al comprender la estructura del documento y la semántica de los campos, no al hacer coincidir coordenadas de píxeles. Esto se conoce como Extracción de Columnas Personalizadas: usted escribe los nombres de los puntos de datos que desea, y la IA lee el formulario y llena cada columna al reconocer qué significa cada dato en contexto.
Para los equipos de facturación que son nuevos en la extracción automatizada, este enfoque sin código significa sin datos de entrenamiento, sin configuración de modelo y sin participación de desarrolladores — solo cargue, nombre columnas y exporte. La IA maneja la comprensión del documento; el equipo de facturación maneja la validación y el envío de la reclamación.
Este enfoque maneja directamente los desafíos específicos del CMS-1500:
- Eliminación de tinta roja: Debido a que la IA lee lo que los datos significan (no dónde se encuentran en una zona pre-dibujada), puede distinguir el "99213" escrito en el recuadro 24D de la etiqueta impresa "CPT/HCPCS" arriba, incluso cuando la tinta roja no ha sido filtrada por un escáner especializado.
- Diseño de cuadrícula densa: La comprensión semántica de la estructura del formulario significa que la IA reconoce que el recuadro 24 tiene seis filas y diez columnas de datos de servicio. Lee cada celda al comprender qué tipo de valor pertenece allí — un código CPT, una fecha, un monto de cargo — no al depender de una alineación perfecta de píxeles.
- Precisión a nivel de campo: La misma IA que localiza el campo también valida su formato, extrayendo códigos CPT con sus modificadores y códigos ICD-10 al nivel de especificidad correcto. La salida son datos estructurados que pueden verificarse antes del envío, no texto sin procesar que requiera reingreso.
Debido a que la extracción es procesamiento por lotes prioritario por diseño, puede cargar múltiples formularios CMS-1500 — docenas o cientos — en un solo lote y recibir una tabla de Excel unificada con los datos de cada formulario en columnas consistentes. Cada formulario se procesa de forma independiente, y todos los resultados se fusionan en una sola hoja de cálculo sin consolidación manual.
Cómo extraer datos de CMS-1500 a Excel: paso a paso
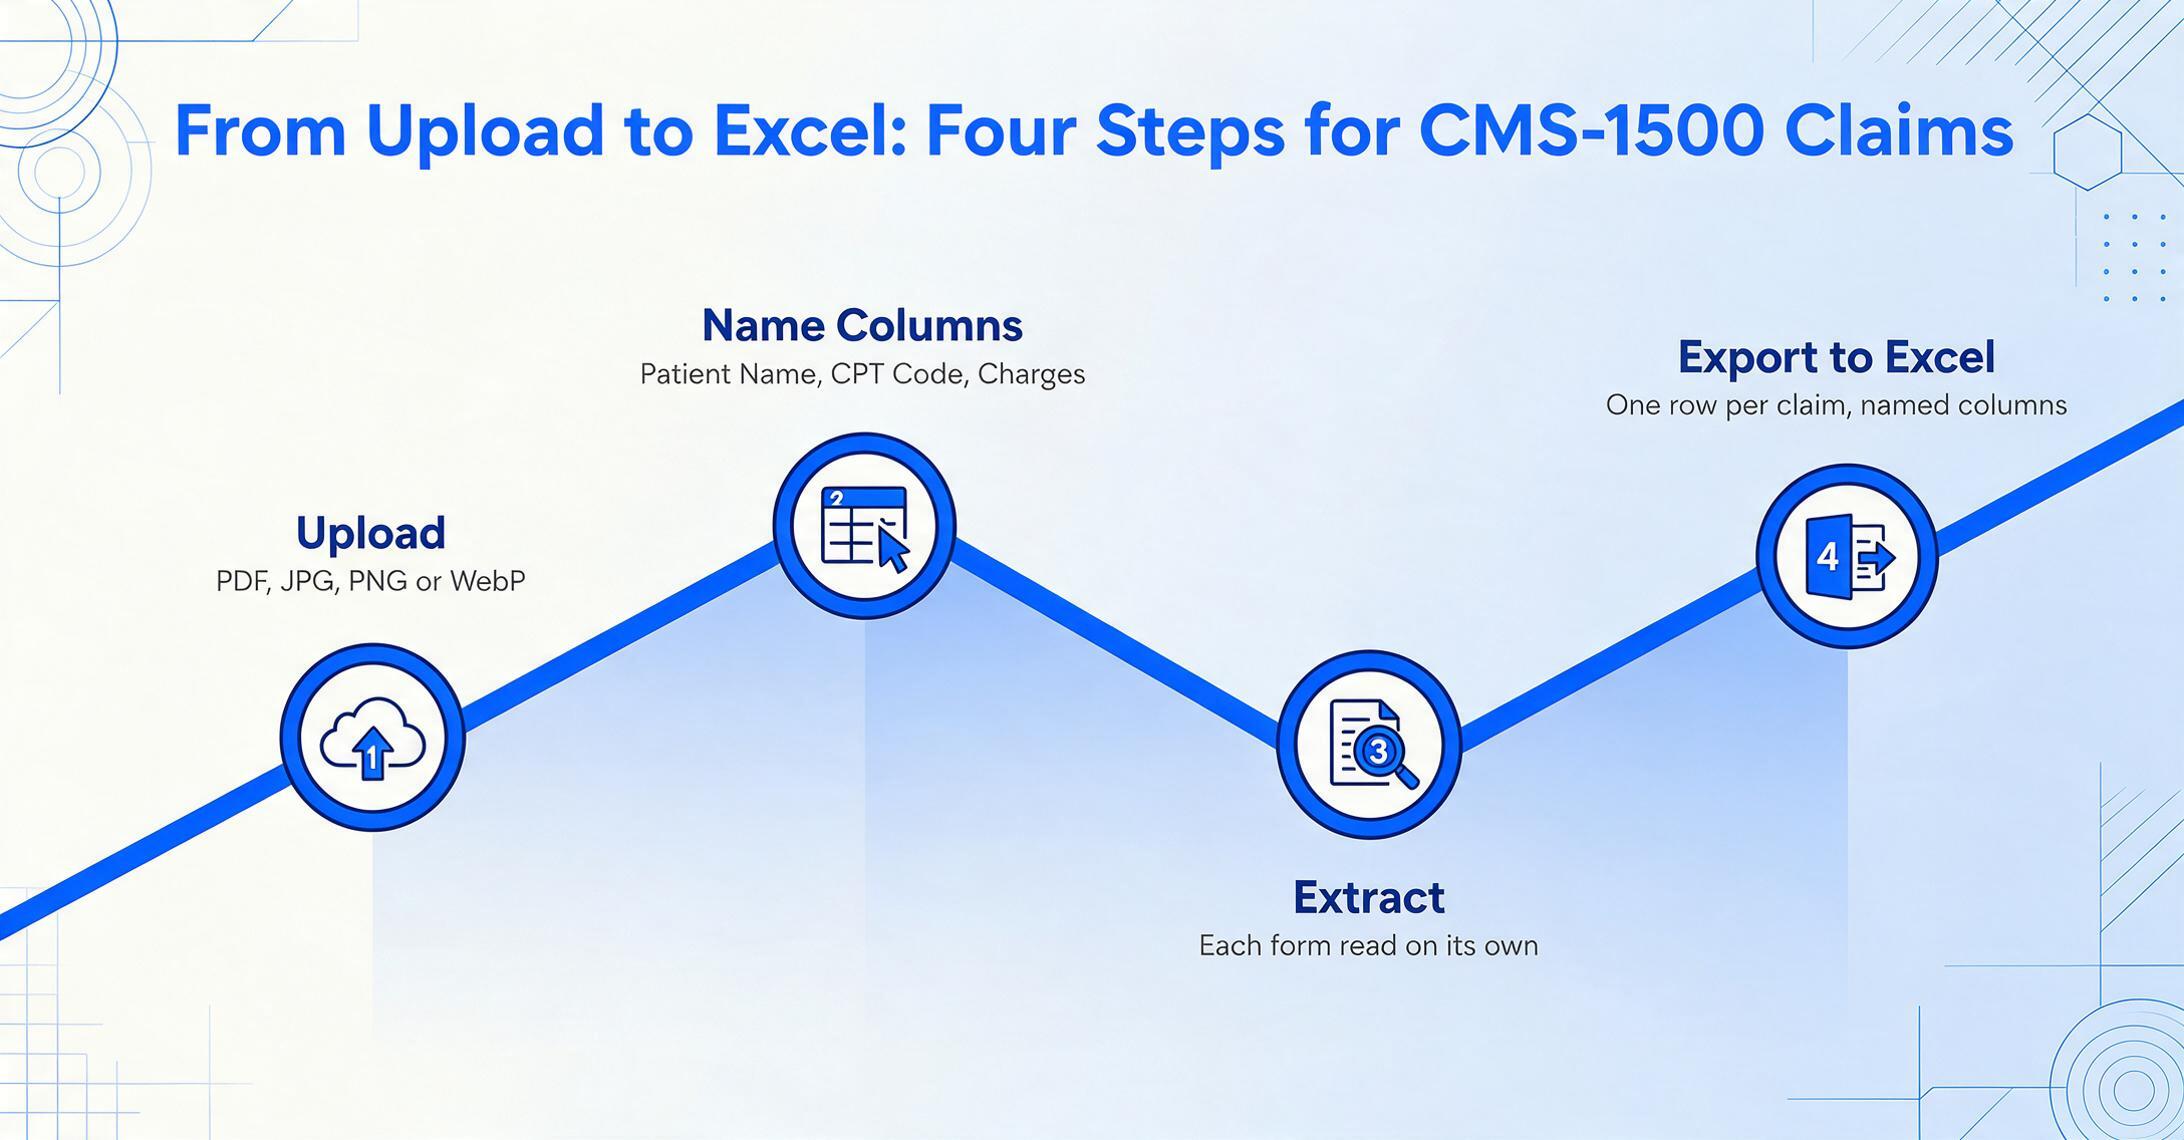
El siguiente recorrido no requiere configuración de plantilla, ni preparación de entrenamiento, ni código. Puede probar el proceso con un formulario CMS-1500 de muestra sin crear una cuenta.
Los archivos se procesan de forma segura y no se almacenan.
Campos Clave para Extraer de Formularios CMS-1500
Los campos que extraiga dependen de lo que su equipo de facturación necesite para conciliación, auditoría o migración de datos. Para la mayoría de los flujos de trabajo, las siguientes columnas cubren los puntos de datos esenciales del CMS-1500:
| Nombre de Columna | Casilla | Descripción |
|---|---|---|
| Nombre del Paciente | Casilla 2 | Apellido, nombre e inicial del segundo nombre del paciente |
| Fecha de Nacimiento | Casilla 3 | Fecha de nacimiento del paciente (formato MMDDAAAA) |
| Tipo de Seguro | Casilla 1 | Medicare, Medicaid, TRICARE, CHAMPVA, Seguro Grupal, FECA, Otro |
| Número de Póliza/ID | Casilla 1a / Casilla 11 | Número de ID del asegurado tal como aparece en la tarjeta de seguro |
| Códigos de Diagnóstico | Casilla 21 | Códigos ICD-10-CM (hasta 12), reportados con la máxima especificidad |
| Fecha del Servicio | Casilla 24A | Fechas de inicio y fin para cada línea de servicio |
| Lugar del Servicio | Casilla 24B | Código POS que indica dónde se prestó el servicio (11 = consultorio, 22 = hospital ambulatorio, etc.) |
| Código CPT/HCPCS | Casilla 24D | Código de procedimiento con hasta cuatro modificadores |
| Indicador de Diagnóstico | Casilla 24E | Letra (A–L) que vincula esta línea de servicio con un código de diagnóstico en la Casilla 21 |
| Cargos | Casilla 24F | Monto facturado por esta línea de servicio |
| Unidades | Casilla 24G | Días o unidades para esta línea de servicio |
| NPI del Proveedor que Rinde | Casilla 24J | NPI de 10 dígitos del proveedor que rinde el servicio |
| NPI del Proveedor Facturador | Casilla 33A | NPI de 10 dígitos del proveedor facturador |
| Cargo Total | Casilla 28 | Cargos totales facturados en todas las líneas de servicio |
Esta no es una lista exhaustiva; dependiendo de su flujo de trabajo, también puede necesitar el NPI del proveedor remitente (Casilla 17), el número de autorización previa (Casilla 23) o el número de cuenta del paciente (Casilla 26). El enfoque de nombrar columnas le permite definir exactamente lo que es importante para su proceso.
¿Qué hay sobre la precisión? Una mirada honesta a las limitaciones
Para los formularios CMS-1500 mecanografiados o impresos por computadora — la mayoría de las reclamaciones en papel enviadas a los Contratistas Administrativos de Medicare — el motor de extracción maneja de manera confiable las 33 casillas con la alta precisión que usted esperaría de una IA de visión entrenada en documentos médicos estructurados. El reconocimiento de texto impreso se acerca al rango de precisión documentado en las especificaciones del producto para datos impresos claros.
Hay dos escenarios donde la precisión puede ser menor, y ser transparentes al respecto ayuda a los equipos de facturación a planificar su proceso de revisión:
Formularios manuscritos. Los formularios CMS-1500 completados a mano introducen una variabilidad que incluso una IA avanzada no siempre puede resolver al 100%. Un código de diagnóstico en cursiva del médico, un modificador escrito rápidamente, o un NPI donde los dígitos individuales se tocan entre sí pueden reducir la precisión por campo. La IA de visión maneja la escritura a mano mejor que el OCR tradicional, y para escritura clara en letras de molde la extracción es confiable — pero los equipos de facturación que procesan un alto volumen de formularios manuscritos deben presupuestar tiempo para verificar los valores extraídos contra los documentos fuente. Esta es la misma realidad que se aplica a cualquier escenario de reconocimiento de escritura a mano en el sector salud, desde formularios de admisión de pacientes hasta notas clínicas.
Calidad del formulario. Un CMS-1500 que llega como un fax de baja resolución (200 DPI o menos), una fotocopia de una fotocopia, o una foto tomada en ángulo con sombras tendrá una precisión de extracción menor que un escaneo limpio. El problema de la supresión de tinta roja agrava esto, porque la IA tiene que separar los datos mecanografiados de las líneas del formulario sin el beneficio de un escáner calibrado con filtro rojo. Las técnicas de preprocesamiento pueden recuperar parte de esta calidad perdida, pero los formularios en condiciones visiblemente malas deben marcarse para revisión manual prioritaria.
Orientación práctica
El flujo de trabajo recomendado para los equipos de facturación que procesan formularios CMS-1500 es: ejecutar todos los formularios a través de la extracción con IA primero, luego verificar una muestra de los resultados contra los documentos fuente. Para el equipo de facturación típico, esto significa revisar el 10–20% de los formularios extraídos para confirmar la precisión de los campos — no escribir cada valor de cada formulario. Este es el mismo enfoque de verificación por muestreo utilizado en las operaciones profesionales de facturación médica, y ofrece un ahorro de tiempo significativo en comparación con la entrada manual completa, manteniendo una precisión auditable.
Preguntas Frecuentes
¿La misma herramienta puede procesar formularios CMS-1500 y UB-04?
Sí, dado que la extracción se basa en la comprensión semántica en lugar de la coincidencia de plantillas, puede procesar ambos tipos de formularios en el mismo lote sin reconfiguración. El CMS-1500 (reclamación profesional, utilizado por médicos y clínicas) tiene un diseño diferente al UB-04 (reclamación institucional, utilizado por hospitales), pero el mismo enfoque de nombres de columnas funciona para ambos: la IA identifica qué tipo de formulario está leyendo y ajusta su reconocimiento de campos en consecuencia.
¿La extracción de CMS-1500 cumple con HIPAA?
Cualquier herramienta que procese formularios CMS-1500 debe manejar información de salud protegida (PHI): nombres de pacientes, fechas de nacimiento, identificadores de seguro, números de expediente médico. ImageToTable.ai procesa archivos de forma segura con transmisión cifrada y no utiliza documentos cargados para el entrenamiento de IA. Para equipos de facturación con requisitos formales de cumplimiento HIPAA, la guía de extracción de documentos médicos HIPAA cubre las consideraciones específicas de cumplimiento para el procesamiento de datos de salud. Las organizaciones que requieren un Acuerdo de Asociado Comercial (BAA) firmado deben verificar la cobertura antes de procesar datos de pacientes.
¿Extraer datos de CMS-1500 ayuda si ya presentamos reclamaciones electrónicamente?
Incluso cuando la mayoría de sus reclamaciones se envían electrónicamente mediante 837P, los formularios CMS-1500 en papel siguen apareciendo en varios flujos de trabajo: reclamaciones corregidas que requieren reenvío, apelaciones con documentación de respaldo, reclamaciones de proveedores que califican para la exención por dificultad ASCA y escenarios de coordinación de beneficios donde se requiere papel. Extraer datos de estos formularios en papel a Excel para revisarlos antes del envío le brinda la misma validación estructurada que los flujos de trabajo electrónicos ya proporcionan.
¿Cómo maneja la extracción el Bloque 24 con múltiples líneas de servicio?
La IA reconoce que el Bloque 24 se repite en hasta seis filas de datos de líneas de servicio. Cada fila se extrae de forma independiente — con sus propias fechas de servicio, código CPT, cargos y puntero de diagnóstico — y las columnas de salida reflejan esta granularidad a nivel de fila. Obtiene una fila en la tabla de salida por cada línea de servicio y por cada formulario, lo que facilita la auditoría de cada partida individual.
¿Puede la extracción ayudarnos a identificar por qué se rechazó una reclamación?
Indirectamente, sí. Al extraer el conjunto completo de valores de campo de un formulario CMS-1500 en papel de una reclamación rechazada a una hoja de cálculo estructurada, su equipo puede comparar los valores enviados contra los requisitos del pagador de forma masiva: verificar si el puntero de diagnóstico en el Bloque 24E hace referencia a un código en el Bloque 21, confirmar que el formato del NPI es correcto y verificar que el modificador de CPT coincida con el código de lugar de servicio. La salida estructurada convierte la investigación de rechazos de una búsqueda manual documento por documento en una tarea de análisis de datos filtrable. Una vez que la reclamación se paga, el mismo flujo de trabajo puede extenderse a la extracción de datos del EOB resultante para conciliación, lo que brinda a su equipo de facturación datos estructurados en ambos lados del ciclo de vida de la reclamación.
¿Cuál es la diferencia entre el NPI del proveedor de facturación (Bloque 33) y el NPI del proveedor que presta el servicio (Bloque 24J)?
El NPI del proveedor de facturación identifica a la entidad que presenta la reclamación y recibe el pago — generalmente el consultorio, la clínica o la corporación profesional. El NPI del proveedor que presta el servicio identifica al clínico individual que realmente realizó el servicio. En consultorios con múltiples proveedores, estos suelen ser NPI diferentes. El formulario CMS-1500 requiere ambos, y los pagadores verifican que el proveedor que presta el servicio esté afiliado al registro del NPI del proveedor de facturación. Las salidas de extracción deben preservar esta distinción para que los equipos de facturación puedan verificar la coincidencia antes del envío.
Sus datos del CMS-1500 están listos para la hoja de cálculo
El diseño del formulario CMS-1500 — 33 casillas, aproximadamente 90 puntos de datos, distribución de cuadrícula densa, campos interdependientes — lo convierte en uno de los documentos médicos más difíciles de procesar manualmente. Cada campo importa. Cada dependencia de campo debe cumplirse. Y cada reclamación que falla por un error de ingreso de datos añade de 30 a 60 días al ciclo de reembolso.
Las herramientas de extracción que dependen de la coincidencia de plantillas o coordenadas de zona estática fallan en cuanto el formulario llega con diferente calidad de escaneo, artefactos de fax o escritura a mano. La extracción semántica — leer el formulario entendiendo lo que significa cada campo, no dónde está — maneja los desafíos específicos del CMS-1500 sin configuración, sin plantillas y sin entrenamiento. El resultado es un archivo Excel estructurado que su equipo de facturación puede auditar, validar según los requisitos del pagador e importar en su flujo de trabajo de gestión de consultorios.
Pruebe el proceso con sus propios formularios CMS-1500. Vea si 90 puntos de datos por formulario toman 5 minutos de escritura manual o 5 segundos de extracción con IA — y decida qué flujo de trabajo tiene sentido para su operación de facturación.