So verarbeiten Sie Dokumente im Batch
ohne Code zu schreiben
Sie müssen keine Python-Skripte schreiben, um Dokumente im Batch zu verarbeiten. Die Annahme, dass die Automatisierung der Dokumentextraktion Programmierkenntnisse erfordert – das Schreiben von for-Schleifen durch ein Verzeichnis von PDFs, das Arbeiten mit PyPDF2 oder pdfplumber, das Einrichten von Tesseract-OCR und das anschließende Zusammenführen der Ausgabe in einen pandas-DataFrame – ist eine erlernte Annahme, die aus einer Ära stammt, in der Dokumentverarbeitungstools nur APIs und SDKs bereitstellten. Diese Ära geht zu Ende. Drag-and-Drop-Plattformen mit KI-Extraktion übernehmen jetzt den Kern-Batch-Workflow: mehrere Dateien hochladen, Ausgabespalten benennen und eine zusammengeführte Tabelle erhalten – ganz ohne import-Anweisung.
Die wichtigsten Erkenntnisse
- 78 Stunden pro Jahr – so viel Zeit verbringt eine Person damit, 30 wöchentliche Rechnungen per Copy-Paste in eine Tabelle zu übertragen, in der Annahme, dass Batch-Verarbeitung Python-Kenntnisse erfordert, die sie nicht hat.
- Ein einziger Anbieter, der das Rechnungslayout stillschweigend ändert, bringt Ihr selbstgebautes Extraktionsskript zum Scheitern – und Wartung, nicht Programmierkenntnis, ist der Punkt, an dem die meisten DIY-Automatisierungen sterben.
- Ändern Sie die Frage, nicht die Sprache: Hören Sie auf, dem Code zu sagen, wie er Felder auf einer Seite finden soll, und beginnen Sie stattdessen, die gewünschten Spalten zu benennen – die Batch-Zusammenführung und die parallele Verarbeitung erledigen sich von selbst.
Warum Batch-Verarbeitung keinen Code erfordert
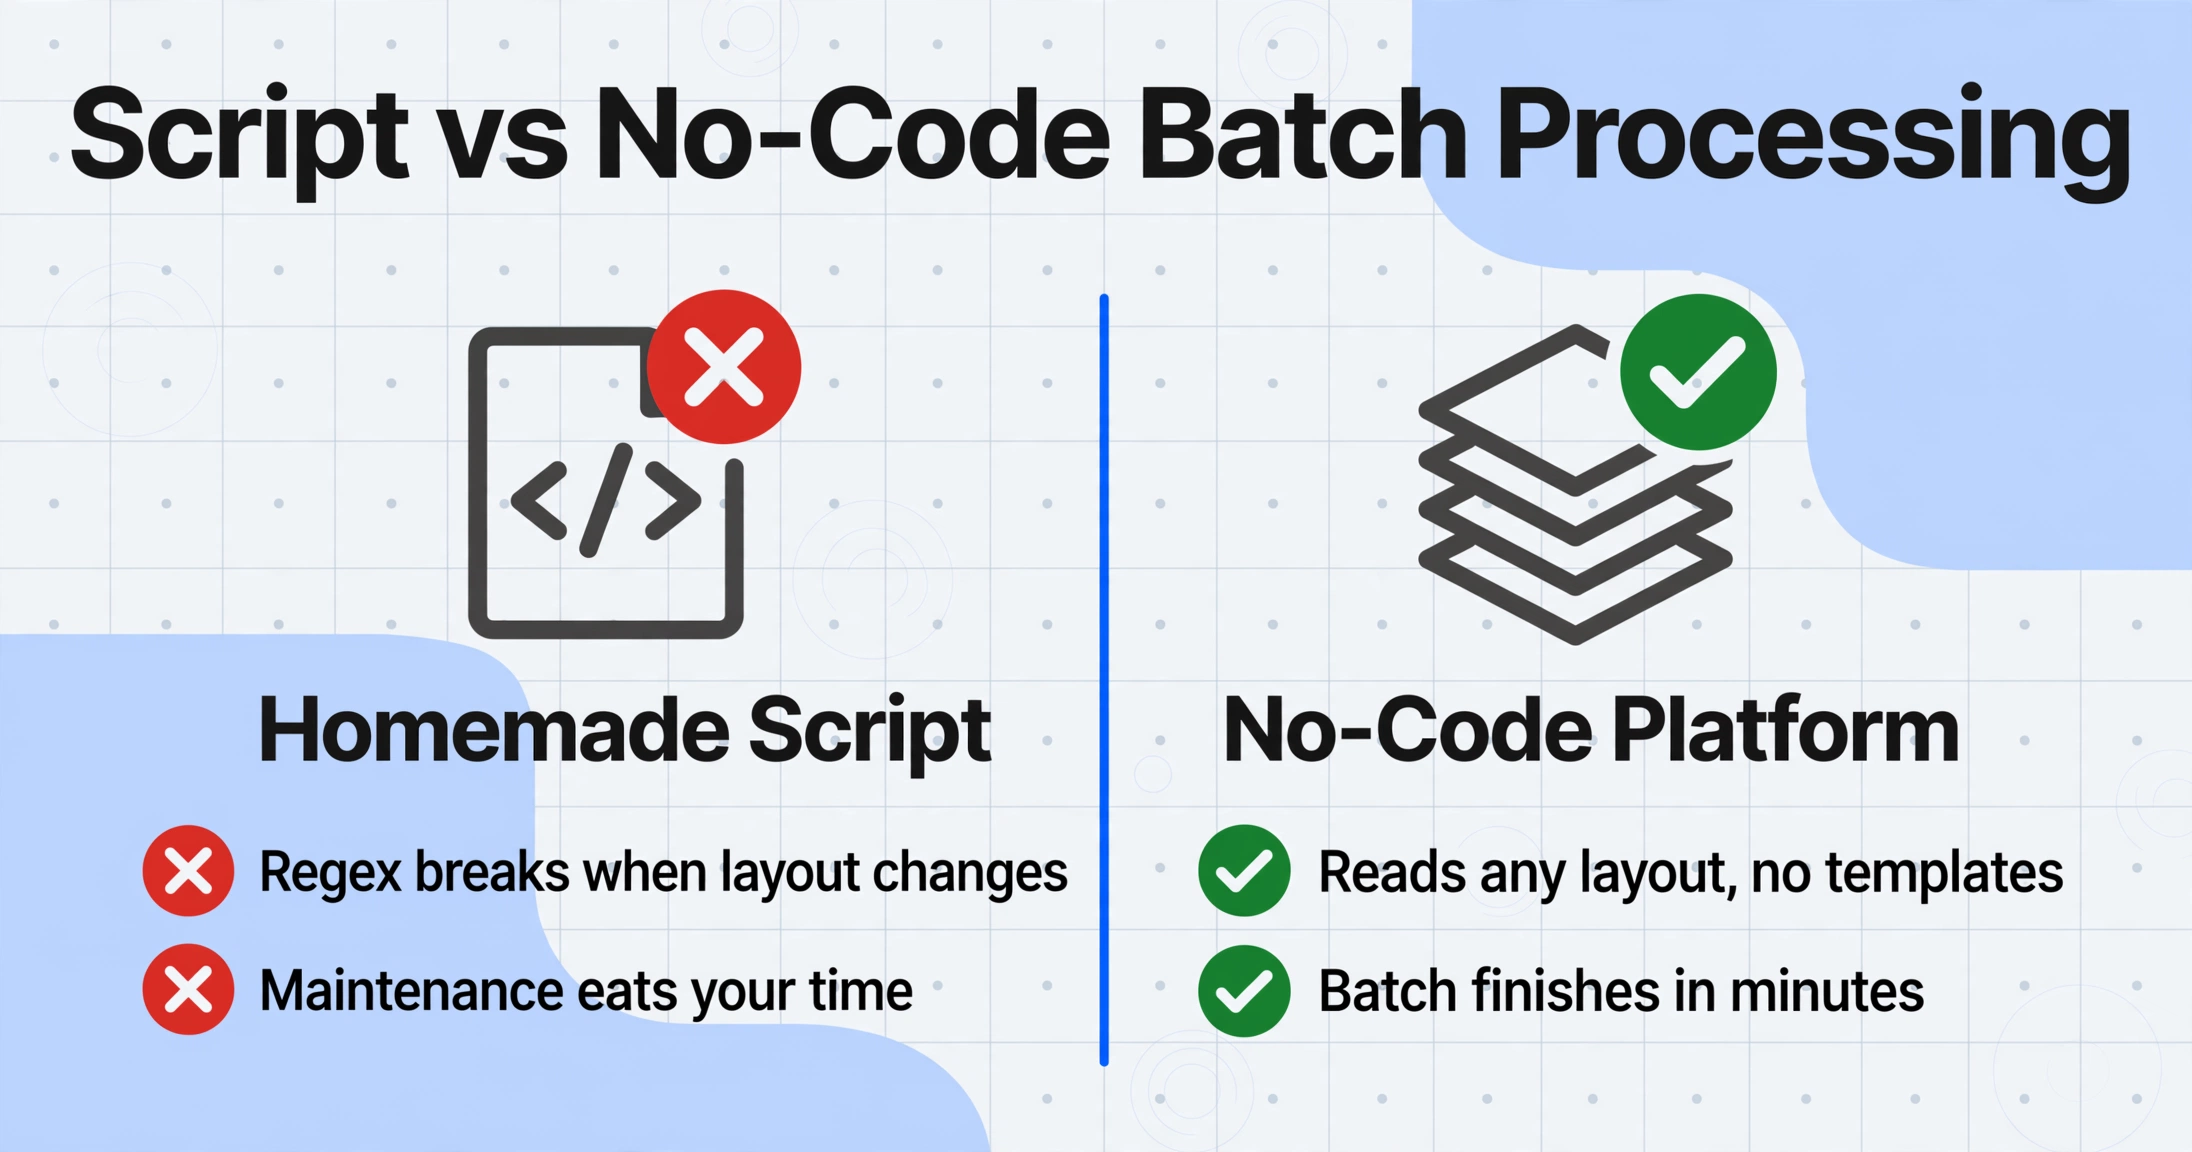
Die Verbindung zwischen Batch-Verarbeitung und Programmierung ist kein Zufall. Jahrelang war das Schreiben eines Skripts der einzige Weg, mehrere Dokumente in einem Durchgang zu verarbeiten. Dieses Skript öffnete jede Datei, extrahierte Text mit einer OCR-Bibliothek wie Tesseract oder einem PDF-Parser wie PyPDF2 oder pdfplumber, analysierte den Rohtext mit Regex oder Positionslogik in Felder und schrieb die Ergebnisse mit pandas oder openpyxl in eine CSV- oder Excel-Datei.
Diese Pipeline funktioniert – aber sie erfordert Fähigkeiten, die die meisten kleinen Teams nicht haben. Laut dem Small Business Profile 2025 des SBA Office of Advocacy sind 99,9 % der US-Unternehmen kleine Unternehmen, und 82 % von ihnen arbeiten ohne Angestellte, ganz zu schweigen von einem dedizierten Entwickler. Selbst unter Arbeitgeberfirmen haben 61,6 % weniger als 5 Angestellte (Census Bureau, 2019). Das BLS zählt etwa 1,7 Millionen Softwareentwickler in den USA – überwiegend konzentriert in Technologiefirmen und großen Unternehmen, nicht in den 36 Millionen kleinen Unternehmen, die 99,9 % der Unternehmen des Landes ausmachen.
„Ich habe ein Skript geschrieben, das alle PDFs in Bilder konvertierte, pytesseract zum Lesen verwendete, Regex zum Durchsuchen der Zeichenfolge nach den benötigten Daten nutzte und die Daten in eine CSV schrieb", beschrieb ein Nutzer auf r/learnpython seinen Ansatz zur Datenextraktion aus zwei PDFs. Das Setup funktioniert. Dann ändert ein Anbieter sein Rechnungslayout, und der Regex bricht. Die Tesseract-Ausgabe bei einem neuen Scan ist verstümmelt. Das Skript muss gewartet werden – und Wartung ist der Punkt, an dem die meisten selbstgebauten Automatisierungen sterben.
No-Code-Batch-Verarbeitung durchbricht diesen Kreislauf nicht, indem sie das Skript durch ein einfacheres Skript ersetzt, sondern indem sie das Paradigma komplett ändert: Statt dem Computer zu sagen, wie er Daten auf einer Seite finden soll (Koordinaten, Regex-Muster, Tag-Namen), sagen Sie ihm, welche Daten Sie möchten, und die KI lokalisiert sie, indem sie den Inhalt des Dokuments versteht. Die Batch-Logik – „alle Dateien in dieser Gruppe verarbeiten und die Ausgabe zusammenführen" – ist in die Plattform integriert, nicht vom Benutzer geschrieben. Das Ergebnis ist für 80 % der gängigen Dokumentverarbeitungsszenarien funktional äquivalent zu einer halbautomatischen Python-Pipeline – ohne dass ein einziger Code geschrieben wird.
Was Sie tatsächlich benötigen
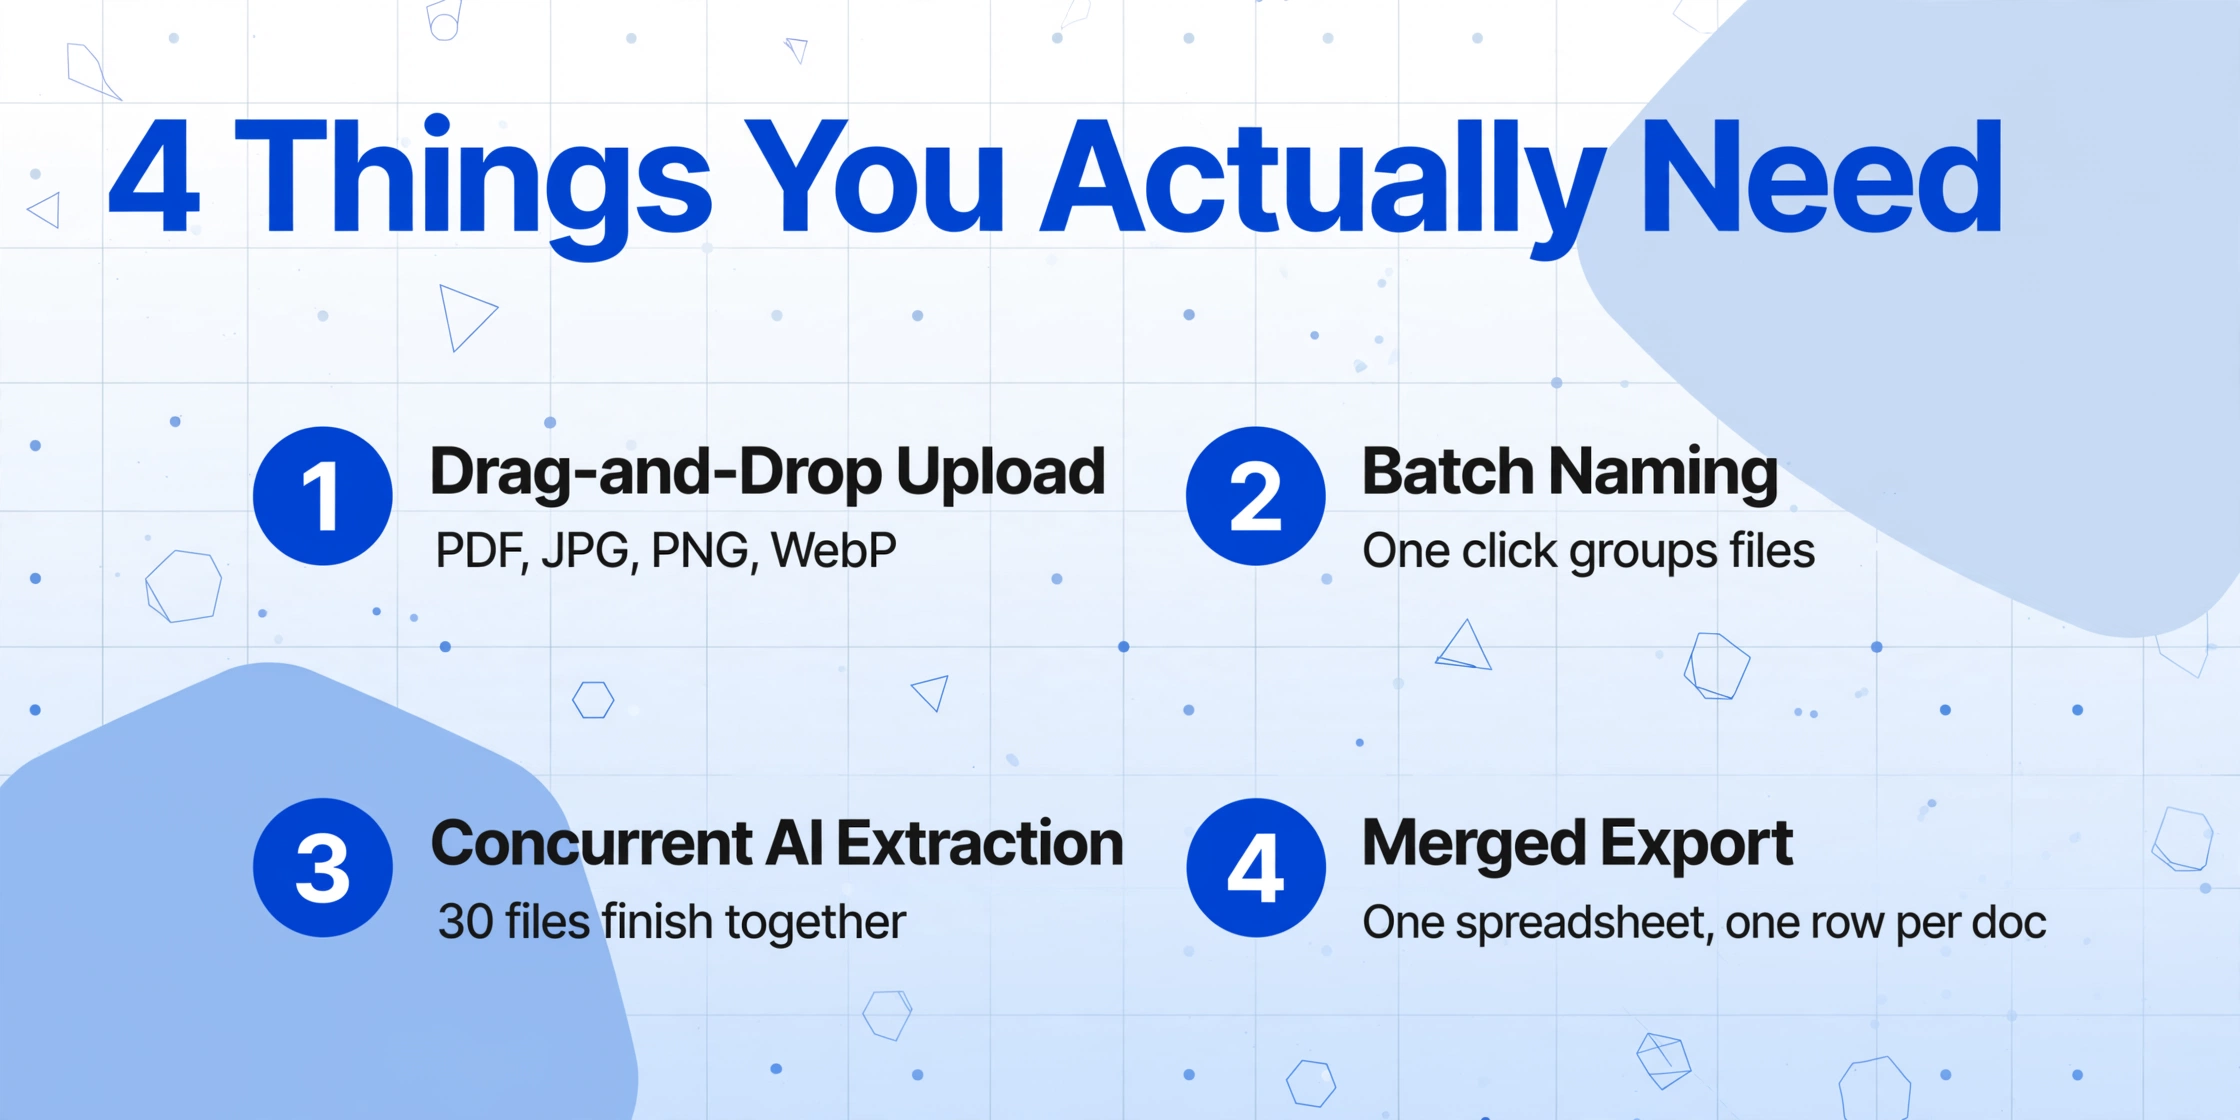
Die minimale Einrichtung für die No-Code-Batch-Dokumentenverarbeitung ist kürzer, als die meisten erwarten. Sie benötigen vier Dinge:
- Eine Drag-and-Drop-Upload-Oberfläche, die die Dateiformate akzeptiert, mit denen Sie arbeiten — PDF, JPG, PNG, WebP. Die meisten No-Code-Extraktionstools bieten eine browserbasierte oder in Google Tabellen eingebettete Upload-Oberfläche. Keine lokale Softwareinstallation erforderlich.
- Einen Batch-Benennungsmechanismus, der zusammengehörige Dateien gruppiert. In einer No-Code-Plattform bedeutet dies in der Regel einen einzigen Klick, um einen Batch-Namen zuzuweisen — das Äquivalent zum Benennen eines Ordners — statt ein Skript zum Durchlaufen von Verzeichnissen zu schreiben.
- Gleichzeitige KI-Extraktion, die alle Dateien im Batch gleichzeitig verarbeitet. Dies ist die verborgene Engine: Während ein Mensch nur ein Dokument nach dem anderen öffnen und lesen kann, verteilt eine batch-fähige Plattform die Verarbeitung auf alle Dateien in der Gruppe, sodass 30 Rechnungen ungefähr zur gleichen Zeit fertig sind wie eine.
- Einen zusammengeführten Export, der die extrahierten Daten jedes Dokuments in einer Datei konsolidiert — eine Excel-Tabelle, eine CSV, einen Google-Tabellen-Tab — wobei jede Zeile ein Dokument und jede Spalte ein von Ihnen definiertes Feld darstellt.
Das ist alles. Keine Python-for-Schleifen. Keine API-Endpunkte zu konfigurieren. Keine Trainingsbeispiele zu beschriften. Die Spaltennamen, die Sie eingeben, werden zu den Kopfzeilen Ihrer Ausgabetabelle. Die KI übernimmt den Rest.
Dies ist der zentrale Paradigmenwechsel, der moderner No-Code-Dokumentenextraktion zugrunde liegt — im Gegensatz zu vorlagenbasierten Tools oder Machine-Learning-Plattformen, die weiterhin eine anfängliche Konfiguration erfordern. Plattformen, die auf Benutzerdefinierte Spaltenextraktion basieren — bei denen Sie Feldnamen wie „Rechnungsnummer, Lieferant, Gesamtbetrag, Fälligkeitsdatum" eingeben und die KI jeden Wert durch semantisches Verständnis lokalisiert — eliminieren die Einrichtungssteuer, die stillschweigend die Zeit auffrisst, die No-Code sparen soll.
Der No-Code-Batch-Verarbeitungs-Workflow
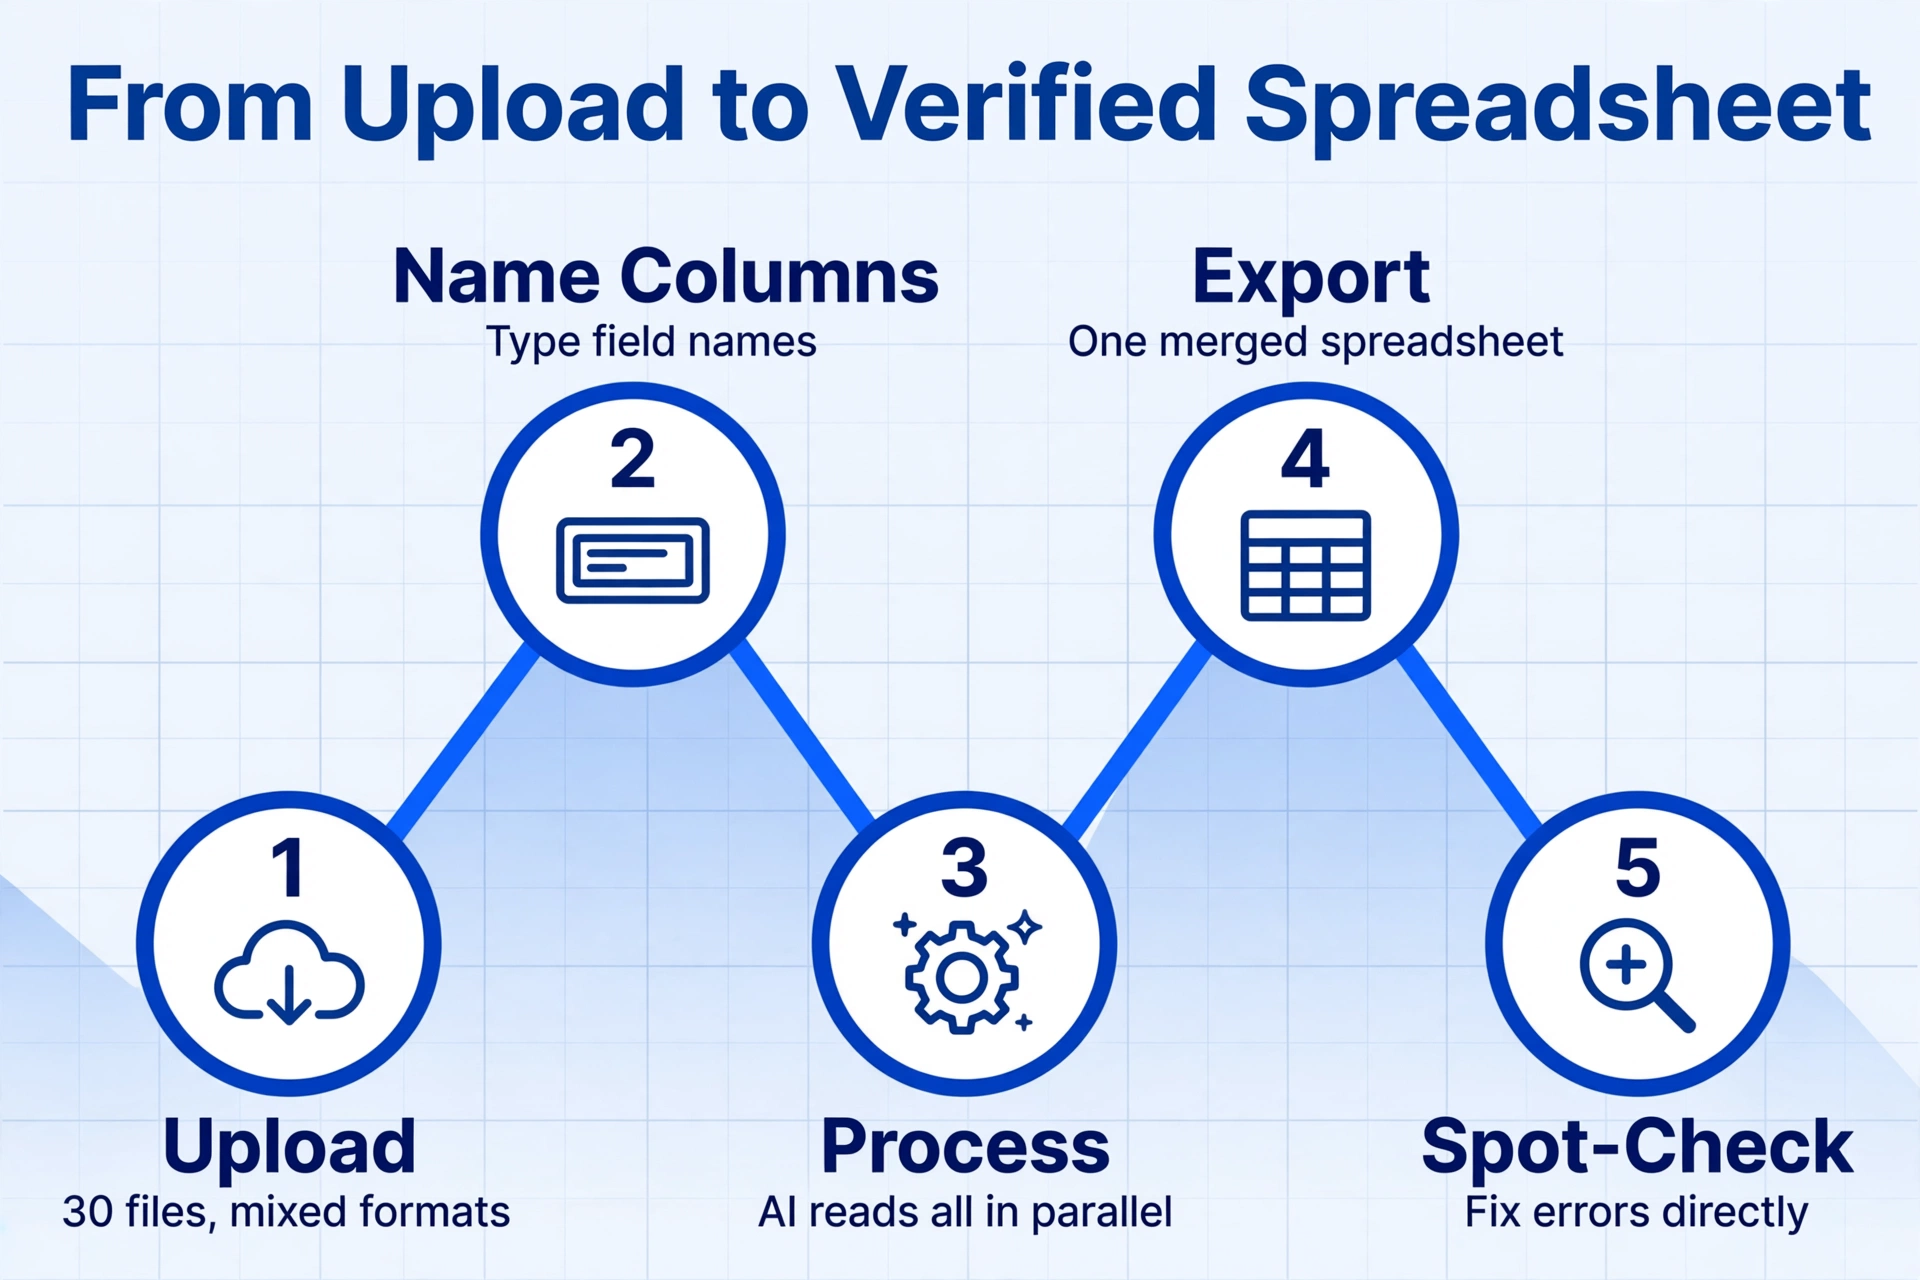
Hier ist der End-to-End-Workflow für ein reales Szenario: ein Kreditorenbuchhalter, der jeden Mittwoch 30 Lieferantenrechnungen verarbeitet. Die Rechnungen kommen als PDFs und JPEG-Scans von 12 verschiedenen Lieferanten, jeweils mit einem anderen Layout – einige positionsgenau, einige pauschal, einige mit Tabellen, einige ohne.
Invoice Number, Vendor Name, Invoice Date, Due Date, Total Amount, Subtotal, Tax. Diese Namen werden zu den Spaltenüberschriften Ihrer Ausgabe. Wenn Sie unsicher sind, welche Felder ein Dokument enthält, lassen Sie die KI die Spalten automatisch erkennen und basierend auf dem Inhalt aller 30 Dateien vorschlagen.2026-06-Wednesday-Vendors. Klicken Sie auf Start. Die KI beginnt, Daten aus allen 30 Dateien gleichzeitig zu extrahieren. Jede Datei dauert unabhängig von der Rechnungskomplexität etwa 5–10 Sekunden.Gesamtzeit für den Sachbearbeiter: etwa 5 Minuten für Hochladen und Konfigurieren, danach läuft die Verarbeitung im Hintergrund. Die manuelle Alternative – jede PDF öffnen, Felder in eine Excel-Vorlage kopieren, Genauigkeit prüfen – würde je nach Rechnungskomplexität 30–90 Minuten dauern. Das ist ein Effizienzgewinn von 6–18x, konsistent mit der 18-fachen Geschwindigkeitsverbesserung, die in Benchmark-Vergleichen von KI-Extraktion gegenüber manueller Eingabe dokumentiert wurde.
Derselbe Workflow gilt für alle Dokumenttypen. Ersetzen Sie „Lieferantenrechnungen" durch „Lieferscheine aus fünf Lagern", „Spesenbelege von 40 Mitarbeitern" oder „Kontoauszüge von mehreren Konten". Das Einzige, was sich ändert, sind die Spaltennamen, die Sie eingeben. Schritt-für-Schritt-Tutorials zu bestimmten Dokumenttypen finden Sie unter So extrahieren Sie Rechnungsdaten per Batch nach Excel oder So übertragen Sie Geschäftsbelege per Batch in eine Steuertabelle.
Was Sie ohne Code aufgeben
Ehrlichkeit über Kompromisse unterscheidet einen nützlichen Vergleich von einem Verkaufsgespräch. No-Code-Batch-Verarbeitung bewältigt die zentrale Extraktions- und Zusammenführungsschleife zuverlässig, aber die folgenden Funktionen erfordern einen Programmieransatz:
Benutzerdefinierte Verarbeitungspipelines. Ein Skript kann die Extraktion mit nachgelagerten Aktionen verketten – „Rechnungsdaten extrahieren → gegen Sachkontocode-Liste validieren → über API an QuickBooks übermitteln → CFO per E-Mail benachrichtigen, wenn die Summe $10.000 übersteigt." In einer No-Code-Plattform sind Extraktion und Export das Ende des automatisierten Pfads. Alles danach erfordert manuelles Eingreifen oder ein separates Tool wie Zapier oder Make (ehemals Integromat), die eigene Komplexität und Kosten mit sich bringen.
Benutzerdefinierte Fehlerbehandlung. Wenn ein Skript auf ein Dokument stößt, das es nicht parsen kann, entscheidet der Entwickler, was passiert: mit anderen Parametern erneut versuchen, den Fehler in einer Datenbank protokollieren, die Datei überspringen und weitermachen oder zur manuellen Prüfung markieren. No-Code-Plattformen zeigen in der Regel Statusindikatoren pro Dokument an – Erfolg, Verarbeitung, Fehler – aber Sie kontrollieren die Fehlerbehandlungslogik nicht. Wenn die Konfidenz grenzwertig ist, erfahren Sie es erst bei der Stichprobenprüfung.
API-Automatisierung und Zeitplanung. Ein Python-Skript kann als Cron-Job laufen, durch eine neue Datei in einem S3-Bucket ausgelöst oder über einen Webhook aufgerufen werden. Es integriert sich direkt in Ihre Infrastruktur. No-Code-Plattformen bieten API-Zugriff in höheren Tarifen, aber die Trigger-und-Reaktions-Automatisierung, die Entwickler als selbstverständlich betrachten – „Wenn eine PDF in diesem Ordner ankommt, extrahiere sie und füge sie dieser Datenbanktabelle hinzu" – erfordert eine separate Automatisierungsebene (Zapier, Power Automate, n8n), die Kosten und Wartung erhöht.
Das sind echte Einschränkungen. Wenn der Workflow Ihres Teams mehrstufige Validierung, bedingte Weiterleitung oder ereignisgesteuerte Trigger umfasst, deckt No-Code-Batch-Verarbeitung allein nicht den gesamten Ablauf ab. Aber für die große Mehrheit der Dokumentverarbeitung mit kleinem bis mittlerem Volumen – wie sie in Buchhaltungskanzleien, kleinen Logistikteams, Hausverwaltungen und freiberuflichen Buchhaltungspraxen vorkommt – sind das Randfälle, keine Hindernisse.
Wann Programmieren wirklich sinnvoll ist
No-Code-Stapelverarbeitung ist kein universeller Ersatz für Skripte. Es gibt drei Situationen, in denen Programmieren die bessere Wahl ist:
Mehr als 500 Dokumente pro Tag. Ab dieser Menge verschiebt sich die Wirtschaftlichkeit. Ein Skript auf einem Server kostet Centbeträge pro tausend Dokumente, während No-Code-Plattformen pro Dokument oder Seite abrechnen. Noch wichtiger: Bei hohem Volumen ändern sich die Fehlermodi: Eine Fehlerquote von 1 % bei 500 Dokumenten bedeutet, dass 5 Dateien erneut verarbeitet werden müssen. Skripte können programmatisch auf Randfälle abgestimmt werden; No-Code-Plattformen wenden dieselbe Extraktions-Engine auf jedes Dokument an und schränken so Ihre Optimierungsmöglichkeiten ein.
Individuelle Validierungsregeln, die an Ihre Daten geknüpft sind. Wenn Ihr Prozess erfordert, extrahierte Werte mit Ihrer eigenen Datenbank abzugleichen – „Ist diese Lieferanten-USt-IdNr. in unserer genehmigten Liste?" oder „Stimmt die Summe auf diesem Auftrag mit der Summe der Positionen überein?" – gibt Ihnen Code die vollständige Kontrolle über die Validierungslogik. No-Code-Plattformen bieten berechnete Spalten und Nachbearbeitung, aber die Validierungstiefe ist geringer als das, was ein Skript mit vollem Datenbankzugriff erreichen kann.
Tiefe API-Integration mit bestehenden Systemen. Ein Skript kann Daten aus einem Dokument extrahieren, transformieren und in einem einzigen atomaren Vorgang direkt in Ihr ERP, CRM oder Ihre Buchhaltungssoftware POSTen. No-Code-Plattformen exportieren typischerweise in Zwischenformate (Excel, CSV, JSON), die einen zweiten Schritt zum Import in Ihr System erfordern. Für Teams, die Extraktion → Integration → Auslösung in einem automatisierten Ablauf benötigen, ist ein API-basierter Ansatz – entweder eine speziell entwickelte Extraktions-API oder ein Skript, das einen KI-Extraktionsdienst umschließt – die richtige Wahl.
Für einen detaillierten Vergleich, wann API-basierte vs. No-Code-Ansätze verwendet werden sollten, siehe API vs. No-Code-Dokumentenextraktion: Welche Architektur passt zu Ihrem Team.
Der ehrliche Mittelweg ist ein hybrider Ansatz: Verwenden Sie No-Code-Extraktion für den Schritt des Dokumentenlesens (den Teil, der von visueller KI profitiert und keine benutzerdefinierte Logik benötigt) und ein leichtgewichtiges Skript oder eine Automatisierungsplattform für die nachfolgenden Schritte der Weiterleitung und Validierung. Dies ist die Architektur, die viele wachsende Teams übernehmen – No-Code für den schweren KI-Einsatz und eine dünne Schicht aus Code oder Konnektoren für die Geschäftslogik.
Häufig gestellte Fragen
Kann ich Dokumente in verschiedenen Formaten stapelweise verarbeiten – einige PDFs, einige gescannte Bilder, einige Fotos?
Ja. Moderne No-Code-KI-Extraktionstools akzeptieren gemischte Dateitypen in einem einzigen Batch. PDF, JPG, PNG, WebP und sogar Screenshots können zusammen hochgeladen und mit denselben Extraktionsregeln verarbeitet werden. Die KI liest das Dokument visuell, nicht aus den Metadaten der Datei, daher beeinträchtigt das Format die Extraktionslogik nicht.
Wie verarbeitet die No-Code-Stapelverarbeitung Dokumente mit unterschiedlichen Layouts von verschiedenen Anbietern?
Dies ist der Kernvorteil der vorlagenfreien KI-Extraktion gegenüber herkömmlicher OCR oder zonalem Parsing. Anstatt sich zu merken, wo Felder auf der Seite sitzen – was bei Layoutänderungen versagt – liest die KI die Feld-Semantik: Sie versteht anhand des Kontexts, wie eine „Rechnungsnummer" aussieht, nicht anhand der Position. So werden 30 Rechnungen von 30 verschiedenen Anbietern in einem Durchlauf korrekt extrahiert, ohne anbieterspezifische Vorlagen oder Trainingsbeispiele.
Was passiert, wenn die KI bei einigen Dokumenten einige Felder falsch extrahiert?
Kein Extraktionssystem – codiert oder nicht – erreicht 100 % Genauigkeit bei jedem Dokument. Der Unterschied liegt in der Geschwindigkeit der Korrektur. Wenn Sie einen No-Code-Batch manuell stichprobenartig prüfen (Schritt 5 im obigen Workflow), können Sie Fehler direkt in der heruntergeladenen Tabelle korrigieren, einzelne fehlgeschlagene Dateien erneut verarbeiten oder Spaltendefinitionen für knifflige Felder anpassen. Die Zeitersparnis ist selbst unter Berücksichtigung von Korrekturen immer noch um Größenordnungen größer als bei der manuellen Extraktion. Eine detaillierte Anleitung zu möglichen Fehlern und deren Erkennung finden Sie unter Warum die Stapel-Extraktion Dateien übersieht – und was Sie dagegen tun können.
Muss ich etwas auf meinem Computer installieren?
Nein. Die No-Code-Stapelverarbeitung läuft vollständig im Browser oder über eine Google Sheets-Add-on-Seitenleiste. Es muss keine Software installiert, kein lokaler Server gestartet und keine Python-Umgebung eingerichtet werden. Einzige Voraussetzung ist eine Internetverbindung und ein moderner Webbrowser.
Ist die No-Code-Stapelverarbeitung günstiger als das Schreiben eines Skripts?
Das hängt vom Volumen ab. Für Teams, die bis zu ein paar hundert Dokumente pro Monat verarbeiten, sind No-Code-Plattformen günstiger als die Entwicklerzeit, die für die Erstellung und Wartung eines benutzerdefinierten Skripts erforderlich ist – insbesondere unter Berücksichtigung der Wartungskosten für Skripte, die bei Formatänderungen der Dokumente versagen. Bei sehr hohem Volumen (tausende Dokumente täglich) hat ein Skript, das auf Ihrer eigenen Infrastruktur läuft, niedrigere Kosten pro Dokument, wobei das Entwicklergehalt und der Wartungsaufwand in diesen Vergleich einfließen sollten.
Starten Sie Ihre erste No-Code-Stapelverarbeitung
Die Annahme, dass Stapelverarbeitung Programmierkenntnisse erfordert, hat viele kleine Teams länger als nötig zur manuellen Dateneingabe gezwungen. Die Werkzeuge, um Daten aus 30, 50 oder 200 Dokumenten in einem Durchgang zu extrahieren – ohne eine einzige Zeile Code zu schreiben – existieren bereits und sind von jedem Browser aus zugänglich. Der Arbeitsablauf ist: Hochladen, Benennen, Verarbeiten, Exportieren, Stichprobenprüfung. Der schwierigste Teil ist zu wissen, welche Daten Sie extrahieren möchten. Den Rest erledigt die KI.
Wenn Sie regelmäßig Dokumente verarbeiten und bisher davon abgeschreckt wurden, dass Sie Python lernen oder einen Entwickler einstellen müssten, ist der praktische Test einfach: Nehmen Sie Ihren nächsten Stapel Dokumente – auch nur 5 oder 10 Dateien – laden Sie sie auf eine No-Code-Extraktionsplattform hoch und sehen Sie sich das Ergebnis an. Der erste Durchlauf kostet nichts außer der Zeit, die Sie ohnehin schon für die manuelle Eingabe aufwenden.