Comment traiter des documents par lots
sans écrire de code
Vous n'avez pas besoin d'écrire des scripts Python pour traiter des documents par lots. L'idée que l'automatisation de l'extraction de documents exige de coder — écrire des boucles for sur un dossier de PDF, batailler avec PyPDF2 ou pdfplumber, configurer Tesseract OCR, puis assembler le résultat dans un DataFrame pandas — est une idée apprise, ancrée dans l'ère où les outils de traitement de documents n'exposaient que des API et des SDK. Cette ère touche à sa fin. Les plateformes glisser-déposer avec extraction IA gèrent désormais le flux de travail par lots de base : téléversez plusieurs fichiers, nommez vos colonnes de sortie, et obtenez un seul tableur fusionné — sans aucune instruction import.
Points clés à retenir
- 78 heures par an — c'est ce qu'une personne passe à copier-coller 30 factures hebdomadaires dans un tableur, en supposant que le traitement par lots exige Python qu'elle ne connaît pas.
- Un seul fournisseur qui modifie silencieusement la mise en page de ses factures casse votre script d'extraction maison — et c'est la maintenance, pas la compétence en codage, qui tue la plupart des automatisations DIY.
- Changez la question, pas le langage : arrêtez de dire au code comment trouver les champs sur une page, et commencez à nommer les colonnes que vous voulez — la fusion par lots et le traitement concurrent s'occupent du reste.
Pourquoi le traitement par lots ne nécessite pas de code
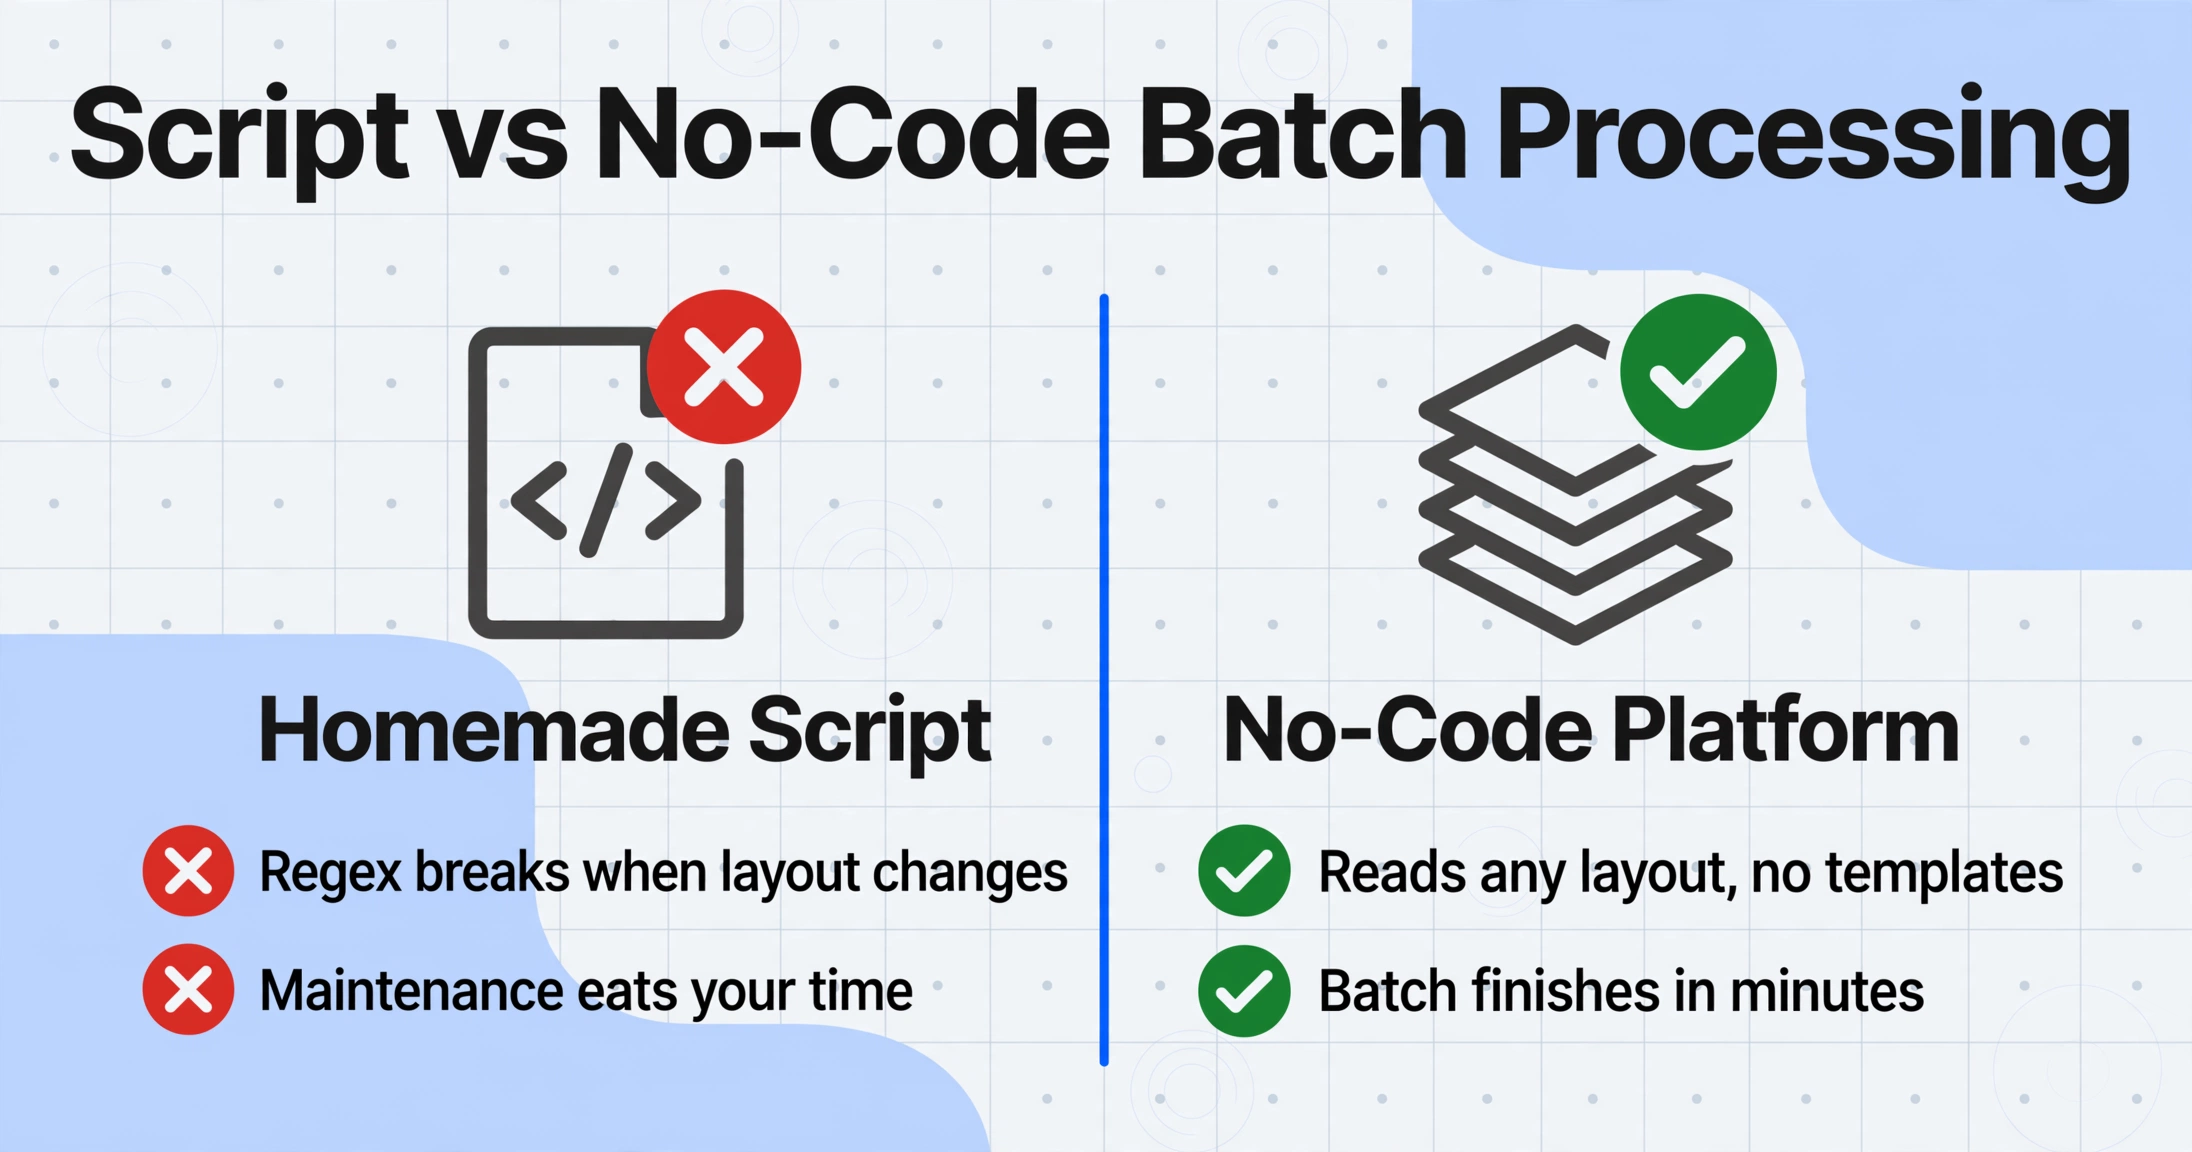
L'association entre traitement par lots et programmation n'est pas un hasard. Pendant des années, la seule façon de traiter plusieurs documents en une seule passe était d'écrire un script. Ce script ouvrait chaque fichier, extrayait le texte à l'aide d'une bibliothèque OCR comme Tesseract ou d'un analyseur PDF comme PyPDF2 ou pdfplumber, analysait le texte brut en champs à l'aide de regex ou de logique positionnelle, et écrivait les résultats dans un fichier CSV ou Excel à l'aide de pandas ou openpyxl.
Ce pipeline fonctionne — mais il exige des compétences que la plupart des petites équipes ne possèdent pas. Selon le profil 2025 des petites entreprises du SBA Office of Advocacy, 99,9 % des entreprises américaines sont des petites entreprises, et 82 % d'entre elles fonctionnent sans aucun employé, sans parler d'un développeur dédié. Même parmi les entreprises avec employés, 61,6 % comptent moins de 5 employés (Census Bureau, 2019). Le BLS recense environ 1,7 million de développeurs de logiciels aux États-Unis — concentrés en grande majorité dans les entreprises technologiques et les grandes sociétés, et non dans les 36 millions de petites entreprises qui représentent 99,9 % des entreprises du pays.
« J'ai écrit un script qui convertissait tous les PDF en images, utilisé pytesseract pour les lire, utilisé regex pour rechercher les données dont j'avais besoin dans la chaîne, et écrit les données dans un CSV », a décrit un utilisateur sur r/learnpython, expliquant son approche pour extraire des données de deux PDF. Le système fonctionne. Puis un fournisseur modifie la mise en page de sa facture, et la regex casse. La sortie de Tesseract sur un nouveau scan est illisible. Le script nécessite une maintenance — et la maintenance est là où la plupart des automatisations maison meurent.
Le traitement par lots sans code brise ce cycle non pas en remplaçant le script par un script plus simple, mais en changeant entièrement le paradigme : au lieu de dire à un ordinateur comment trouver des données sur une page (coordonnées, motifs regex, noms de balises), vous lui dites quelles données vous voulez, et l'IA les localise en comprenant le contenu du document. La logique de lot — « traiter tous les fichiers de ce groupe et fusionner la sortie » — est intégrée à la plateforme, non écrite par l'utilisateur. Le résultat est fonctionnellement équivalent à un pipeline Python semi-automatisé pour 80 % des scénarios courants de traitement de documents, avec zéro code écrit.
Ce dont vous avez réellement besoin
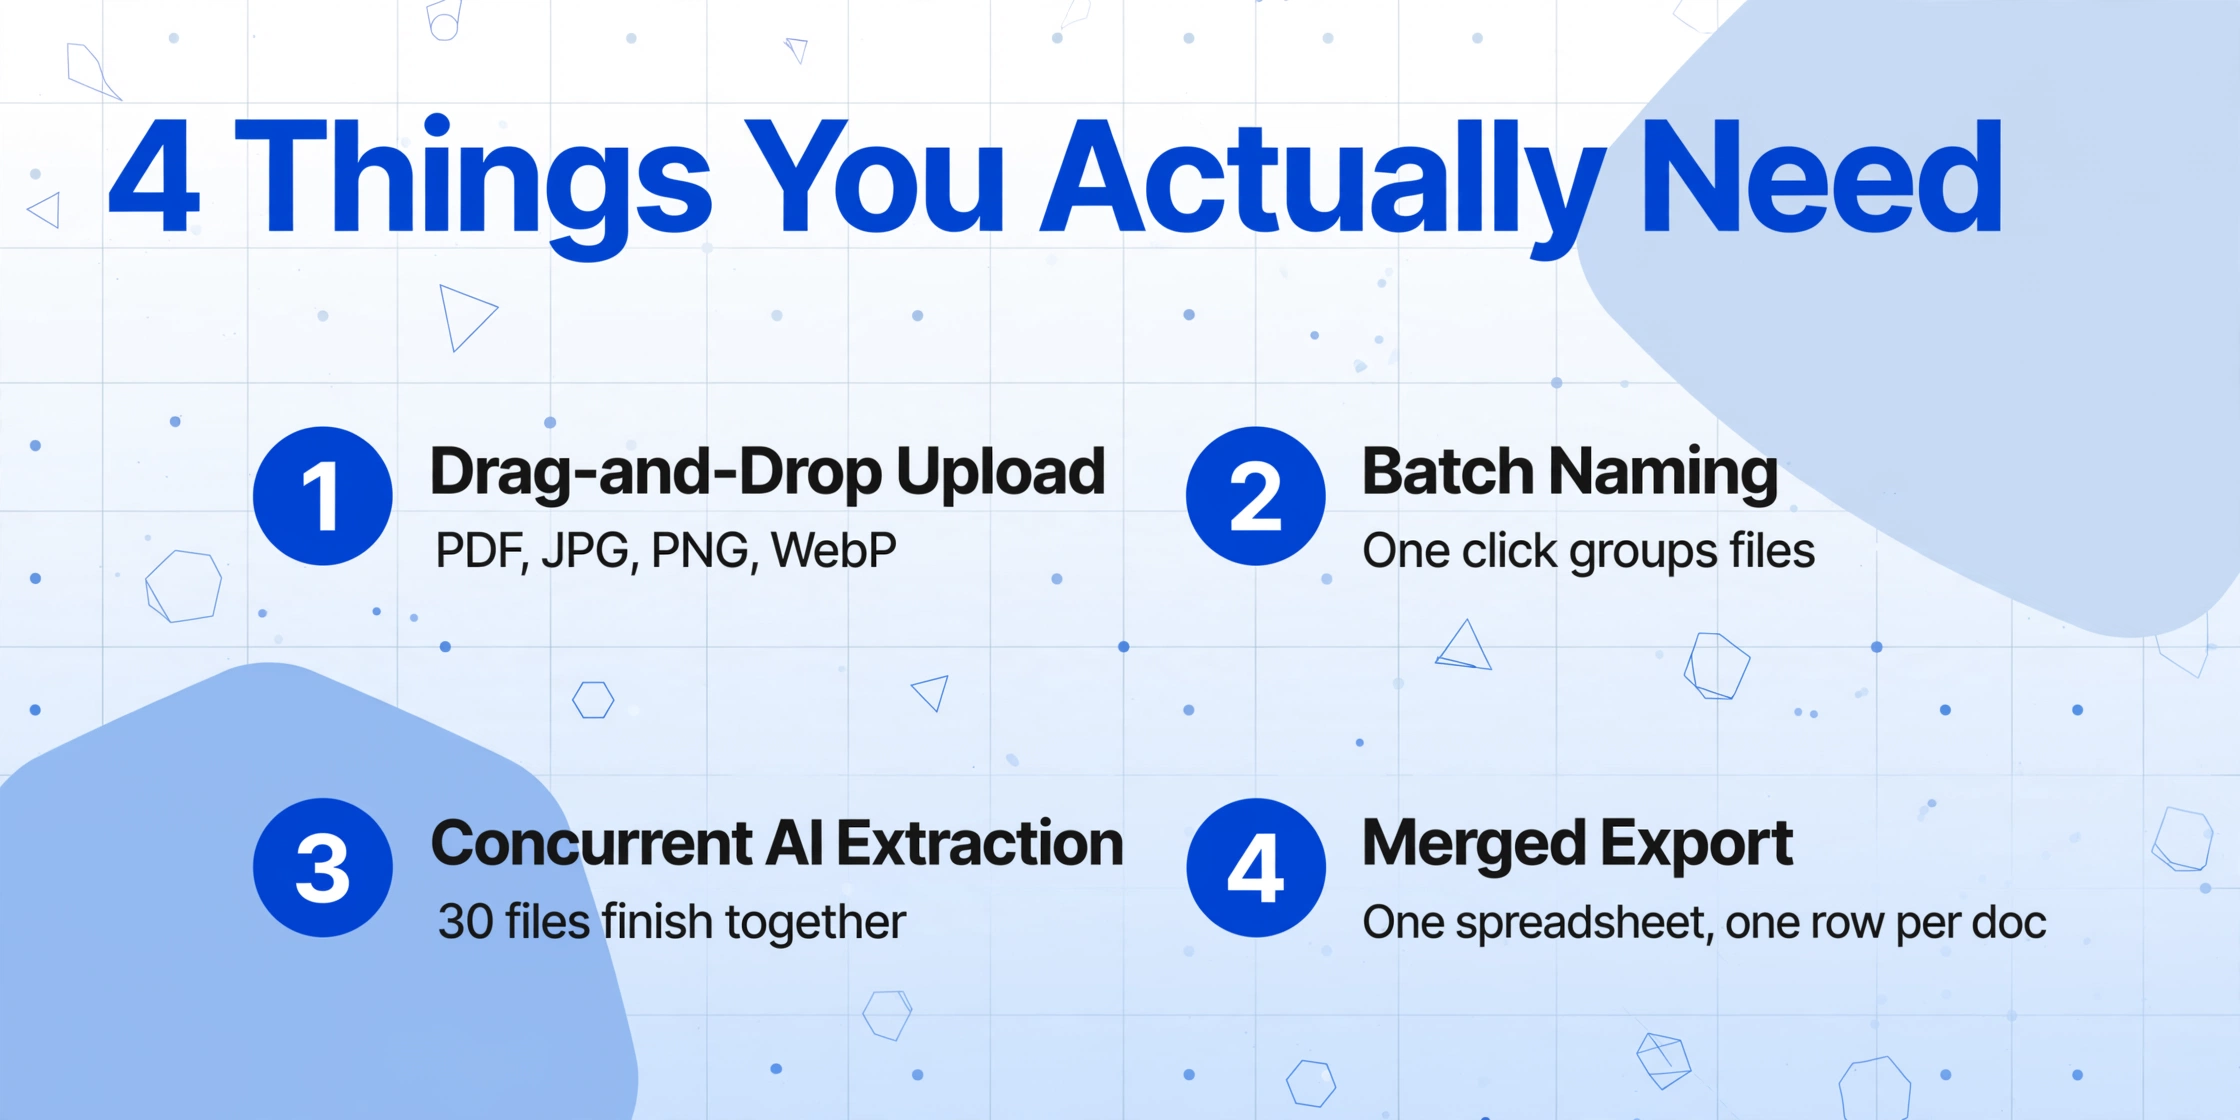
La configuration minimale viable pour le traitement par lots de documents sans code est plus courte que ce que la plupart des gens imaginent. Vous avez besoin de quatre éléments :
- Une interface de glisser-déposer qui accepte les formats de fichiers que vous utilisez — PDF, JPG, PNG, WebP. La plupart des outils d'extraction sans code proposent une surface de dépôt basée sur le navigateur ou intégrée à Google Sheets. Aucune installation de logiciel local requise.
- Un mécanisme de nommage des lots qui regroupe les fichiers associés. Sur une plateforme sans code, cela signifie généralement un simple clic pour attribuer un nom de lot — l'équivalent de nommer un dossier — plutôt que d'écrire un script de parcours de répertoire.
- Une extraction IA simultanée qui traite tous les fichiers du lot en même temps. C'est le moteur caché : alors qu'un humain ne peut ouvrir et lire qu'un document à la fois, une plateforme adaptée aux lots répartit le traitement sur tous les fichiers du groupe, de sorte que 30 factures se terminent à peu près en même temps qu'une seule.
- Un export fusionné qui consolide les données extraites de chaque document dans un seul fichier — une feuille de calcul Excel, un CSV, un onglet Google Sheets — où chaque ligne représente un document et chaque colonne représente un champ que vous avez défini.
C'est tout. Pas de boucles Python. Pas de points de terminaison API à configurer. Pas d'échantillons d'entraînement à étiqueter. Les noms de colonnes que vous saisissez deviennent les en-têtes de votre feuille de calcul de sortie. L'IA s'occupe du reste.
C'est le changement de paradigme fondamental qui sous-tend l'extraction moderne de documents sans code, par opposition aux outils basés sur des modèles ou aux plateformes d'apprentissage automatique qui exigent encore une configuration initiale. Les plateformes construites sur l'Extraction de colonnes personnalisées — où vous saisissez des noms de champs comme « Numéro de facture, Fournisseur, Total, Date d'échéance » et l'IA localise chaque valeur par compréhension sémantique — éliminent la taxe de configuration qui grignote silencieusement le temps que le sans code est censé faire gagner.
Le flux de traitement par lots sans code
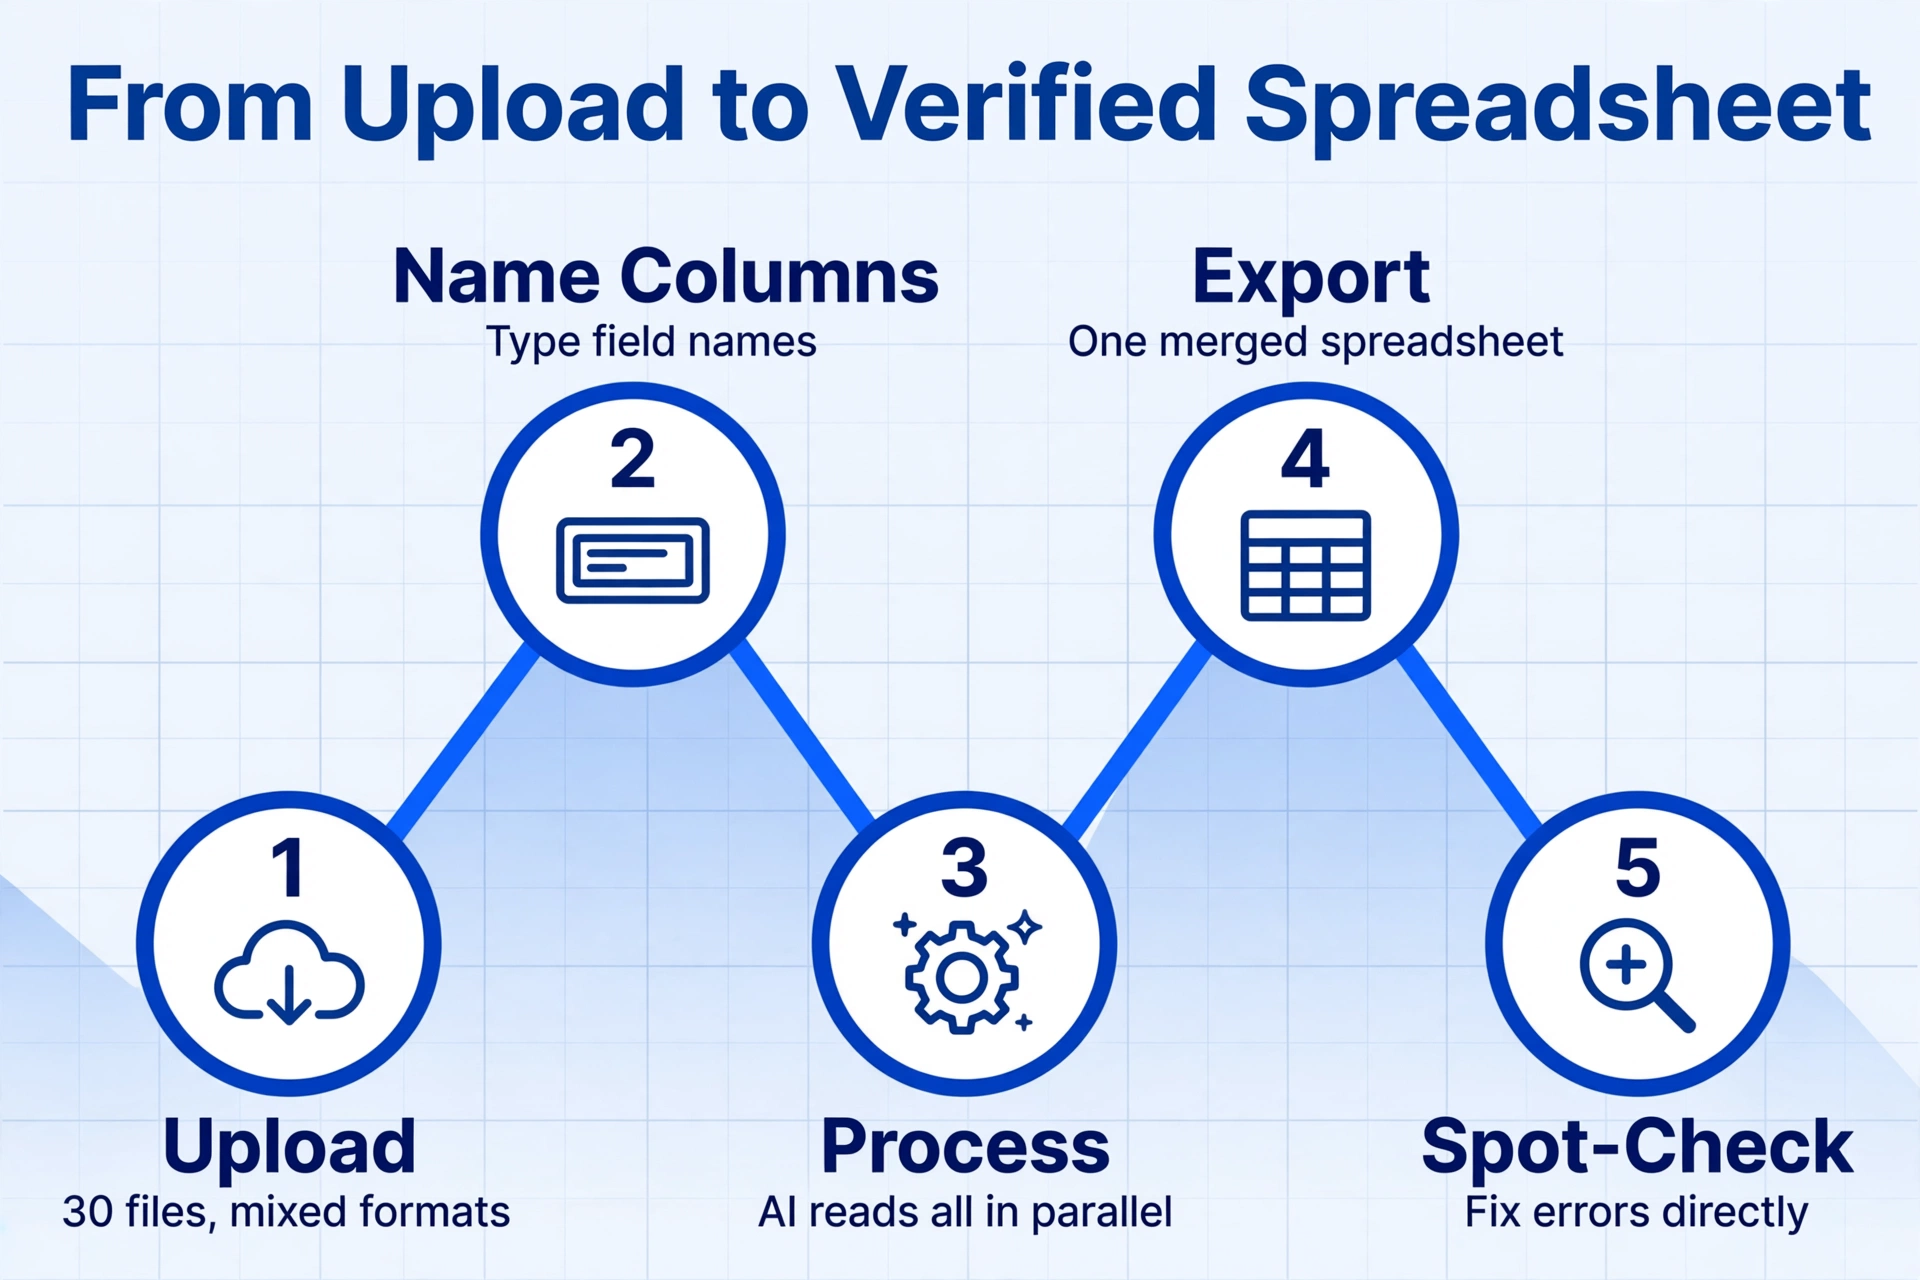
Voici le flux de travail de bout en bout pour un scénario réel : un comptable fournisseurs qui traite 30 factures fournisseurs chaque mercredi. Les factures arrivent sous forme de PDF et de scans JPEG provenant de 12 fournisseurs différents, chacun avec une mise en page différente — certaines détaillées, certaines forfaitaires, certaines avec des tableaux de lignes, d'autres sans.
Numéro de facture, Nom du fournisseur, Date de facture, Date d'échéance, Montant total, Sous-total, Taxe. Ces noms deviennent les en-têtes de colonnes de votre sortie. Si vous n'êtes pas sûr des champs contenus dans un document, laissez l'IA détecter automatiquement et suggérer des colonnes en fonction de ce qu'elle lit dans les 30 fichiers.2026-06-Mercredi-Fournisseurs. Cliquez sur Démarrer. L'IA commence à extraire les données des 30 fichiers simultanément. Chaque fichier prend environ 5 à 10 secondes, quelle que soit la complexité de la facture.Durée totale pour l'employé : environ 5 minutes de téléversement et de configuration, puis le traitement s'exécute en arrière-plan. L'alternative manuelle — ouvrir chaque PDF, copier les champs dans un modèle Excel, vérifier l'exactitude — prendrait 30 à 90 minutes selon la complexité des factures. Cela représente un gain d'efficacité de 6 à 18 fois, cohérent avec l'amélioration de vitesse de 18 fois documentée dans les comparaisons de référence entre l'extraction par IA et la saisie manuelle.
Le même flux de travail s'applique à tous les types de documents. Remplacez « factures fournisseurs » par « bons de livraison provenant de cinq entrepôts », « reçus de frais de 40 employés » ou « relevés bancaires de plusieurs comptes ». La seule chose qui change, ce sont les noms de colonnes que vous saisissez. Pour des tutoriels étape par étape sur des types de documents spécifiques, consultez comment extraire par lots des données de factures vers Excel ou comment regrouper des reçus professionnels dans une feuille de calcul fiscale.
Ce à quoi vous renoncez sans code
La transparence sur les compromis est ce qui distingue une comparaison utile d'un argumentaire de vente. Le traitement par lots sans code gère de manière fiable la boucle d'extraction et de fusion, mais les capacités suivantes nécessitent une approche de codage :
Pipelines de traitement personnalisés. Un script peut enchaîner l'extraction avec des actions en aval — « extraire les données de facture → valider par rapport à la liste des codes GL → publier dans QuickBooks via API → envoyer un e-mail au CFO si le total dépasse 10 000 $ ». Dans une plateforme sans code, l'extraction et l'exportation sont la fin du parcours automatisé. Tout ce qui suit nécessite une intervention manuelle ou un outil séparé comme Zapier ou Make (anciennement Integromat), qui ajoutent leur propre complexité et coût.
Gestion des erreurs personnalisée. Lorsqu'un script rencontre un document qu'il ne peut pas analyser, le développeur décide de ce qui se passe : réessayer avec des paramètres différents, consigner l'échec dans une base de données, ignorer le fichier et passer au suivant, ou le signaler pour examen humain. Les plateformes sans code affichent généralement des indicateurs de statut par document — succès, traitement, erreur — mais vous ne contrôlez pas la logique de gestion des erreurs. Si la confiance est limite, vous ne le saurez pas avant la vérification ponctuelle.
Automatisation API et planification. Un script Python peut s'exécuter via une tâche cron, être déclenché par l'arrivée d'un nouveau fichier dans un compartiment S3, ou être appelé depuis un webhook. Il s'intègre directement à votre infrastructure. Les plateformes sans code offrent un accès API dans les forfaits supérieurs, mais l'automatisation déclenchée par événements que les développeurs tiennent pour acquise — « quand un PDF arrive dans ce dossier, extrayez-le et ajoutez-le à cette table de base de données » — nécessite une couche d'automatisation séparée (Zapier, Power Automate, n8n) qui ajoute coût et maintenance.
Ce sont de véritables limites. Si le flux de travail de votre équipe implique une validation en plusieurs étapes, un routage conditionnel ou des déclencheurs basés sur des événements, le traitement par lots sans code seul ne couvrira pas l'ensemble de la boucle. Mais pour la grande majorité des traitements de documents à volume petit à moyen — le genre qui se produit dans les cabinets comptables, les petites équipes logistiques, les bureaux de gestion immobilière et les pratiques de tenue de livres indépendantes — ce sont des cas limites, pas des obstacles.
Quand le code a vraiment du sens
Le traitement par lots sans code ne remplace pas universellement le scripting. Trois situations où le code est préférable :
Volume supérieur à 500 documents par jour. À cette échelle, l'économie change. Un script sur serveur coûte quelques centimes pour mille documents, tandis que les plateformes sans code facturent par document ou page. Plus important encore, à volume élevé, les modes de défaillance changent : un taux d'erreur de 1 % sur 500 documents signifie que 5 fichiers doivent être retraités. Les scripts peuvent être optimisés pour gérer les cas particuliers par programmation ; les plateformes sans code exposent le même moteur d'extraction à chaque document, limitant votre capacité d'optimisation.
Règles de validation personnalisées liées à vos données. Si votre processus nécessite de vérifier les valeurs extraites par rapport à votre propre base de données — « ce numéro de TVA fournisseur est-il dans notre liste approuvée ? » ou « le total de ce bon de commande correspond-il à la somme des lignes ? » — le code vous donne un contrôle total sur la logique de validation. Les plateformes sans code offrent des colonnes calculées et du post-traitement, mais la profondeur de validation est moindre que ce qu'un script avec accès complet à la base de données peut accomplir.
Intégration API profonde avec les systèmes existants. Un script peut extraire des données d'un document, les transformer et les poster directement dans votre ERP, CRM ou logiciel comptable en une seule opération atomique. Les plateformes sans code exportent généralement vers des formats intermédiaires (Excel, CSV, JSON) qui nécessitent une deuxième étape d'importation. Pour les équipes qui ont besoin d'un flux automatisé extraction → intégration → déclenchement, une approche basée sur une API — soit une API d'extraction dédiée, soit un script encapsulant un service d'extraction IA — est la solution adaptée.
Pour une comparaison détaillée des cas d'usage entre approches API et sans code, voir API vs extraction sans code : quelle architecture pour votre équipe.
Le juste milieu honnête est une approche hybride : utiliser l'extraction sans code pour l'étape de lecture du document (la partie qui bénéficie de l'IA visuelle et ne nécessite pas de logique personnalisée) et un script léger ou une plateforme d'automatisation pour les étapes de routage et de validation qui suivent. C'est l'architecture qu'adoptent de nombreuses équipes en croissance — sans code pour le lourd travail d'IA, et une fine couche de code ou de connecteurs pour la logique métier.
Questions fréquentes
Puis-je traiter par lots des documents de différents formats — certains PDF, d'autres des images scannées, d'autres des photos ?
Oui. Les outils modernes d'extraction IA sans code acceptent des types de fichiers mixtes dans un même lot. PDF, JPG, PNG, WebP, et même des captures d'écran peuvent être téléchargés ensemble et traités avec les mêmes règles d'extraction. L'IA lit le document visuellement, pas à partir des métadonnées du fichier, donc la variation de format n'affecte pas la logique d'extraction.
Comment le traitement par lots sans code gère-t-il des documents avec des mises en page différentes provenant de différents fournisseurs ?
C'est l'avantage clé de l'extraction IA sans modèle par rapport à l'OCR traditionnel ou à l'analyse zonale. Au lieu de mémoriser où se trouvent les champs sur la page — ce qui échoue lorsque les mises en page changent — l'IA lit la sémantique des champs : elle comprend ce qu'est un « numéro de facture » par le contexte, pas par la position. Ainsi, 30 factures de 30 fournisseurs différents sont toutes extraites correctement en un seul lot, sans modèles par fournisseur ni échantillons d'apprentissage.
Que se passe-t-il si l'IA se trompe sur certains champs de quelques documents ?
Aucun système d'extraction — codé ou non — n'atteint 100 % de précision sur tous les documents. La différence réside dans la vitesse de récupération. Lorsque vous vérifiez manuellement un lot sans code (étape 5 du flux ci-dessus), vous pouvez corriger les erreurs directement dans le tableur téléchargé, retraiter les fichiers individuels qui ont échoué, ou ajuster les définitions de colonnes pour les champs délicats. Le temps gagné reste des ordres de grandeur supérieur à l'extraction manuelle, même en tenant compte des corrections. Pour un guide détaillé sur ce qui peut mal tourner et comment le détecter, consultez pourquoi l'extraction par lots manque des fichiers — et que faire.
Dois-je installer quelque chose sur mon ordinateur ?
Non. Le traitement par lots sans code s'exécute entièrement dans le navigateur ou via un panneau latéral d'extension Google Sheets. Aucun logiciel à installer, aucun serveur local à exécuter, aucun environnement Python à configurer. La seule exigence est une connexion Internet et un navigateur Web moderne.
Le traitement par lots sans code est-il moins cher que l'écriture d'un script ?
Cela dépend du volume. Pour les équipes traitant jusqu'à quelques centaines de documents par mois, les plateformes sans code sont moins chères que le temps de développement nécessaire pour créer et maintenir un script personnalisé — surtout si l'on tient compte du coût de maintenance des scripts qui cassent lorsque les formats de documents changent. À très haut volume (des milliers de documents par jour), un script fonctionnant sur votre propre infrastructure aura des coûts par document plus faibles, bien que le salaire du développeur et le temps de maintenance doivent être pris en compte dans cette comparaison.
Lancez votre premier lot sans code
L'idée que le traitement par lots nécessite de la programmation a longtemps contraint les petites équipes à saisir des données manuellement. Pourtant, les outils pour extraire des données de 30, 50 ou 200 documents en une seule passe — sans écrire une ligne de code — existent déjà et sont accessibles depuis n'importe quel navigateur. Le processus est simple : importer, nommer, traiter, exporter, vérifier. Le plus difficile est de savoir quelles données extraire. L'IA s'occupe du reste.
Si vous traitez régulièrement des documents et que l'idée d'apprendre Python ou d'embaucher un développeur vous a freiné, le test pratique est simple : prenez votre prochain lot de documents — même 5 ou 10 fichiers — importez-les sur une plateforme d'extraction sans code, et observez le résultat. Le premier lot ne vous coûte que le temps que vous passiez déjà à la saisie manuelle.