Como Processar Documentos em Lote
Sem Escrever Código
Você não precisa escrever scripts em Python para processar documentos em lote. A suposição de que automatizar a extração de documentos exige codificação — escrever loops for em um diretório de PDFs, lidar com PyPDF2 ou pdfplumber, configurar o Tesseract OCR e depois unir a saída em um DataFrame do pandas — é algo aprendido, enraizado na era em que as ferramentas de processamento de documentos só expunham APIs e SDKs. Essa era está terminando. Plataformas de arrastar e soltar com extração por IA agora cuidam do fluxo de trabalho principal em lote: envie vários arquivos, nomeie suas colunas de saída e obtenha uma única planilha mesclada — sem necessidade de declaração import.
Principais Conclusões
- 78 horas por ano — é o que uma pessoa gasta copiando e colando 30 faturas semanais em uma planilha, presumindo que o processamento em lote exige Python que ela não conhece.
- Um único fornecedor que altera silenciosamente o layout da fatura quebra seu script caseiro de extração — e a manutenção, não a habilidade de codificação, é onde a maioria das automações caseiras morre.
- Mude a pergunta, não a linguagem: pare de dizer ao código como encontrar campos em uma página e comece a nomear as colunas que você deseja — a mesclagem em lote e o processamento simultâneo cuidam de si mesmos.
Por que o processamento em lote não exige código
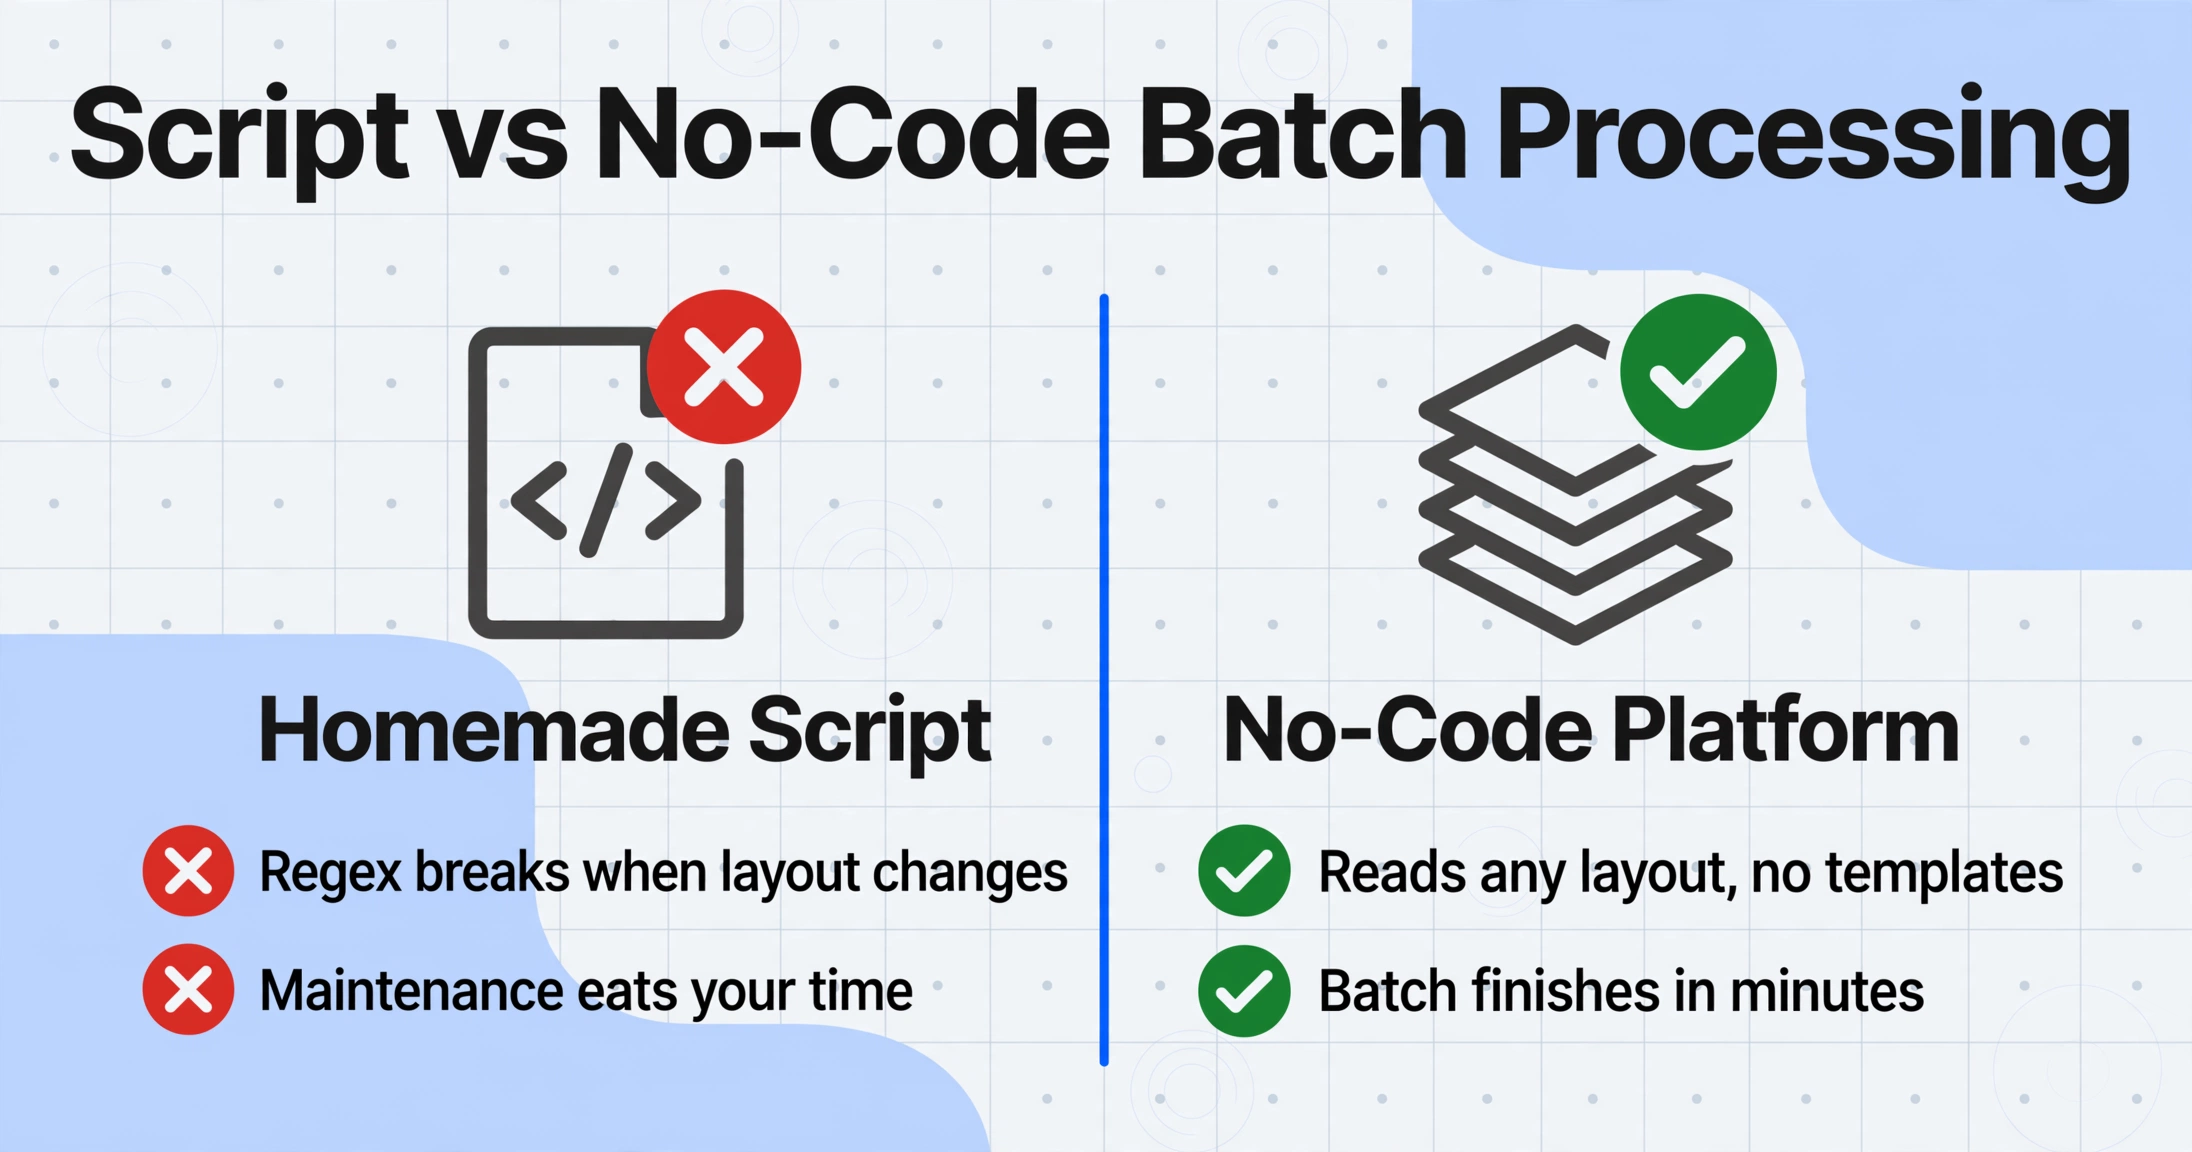
A associação entre processamento em lote e programação não é acidental. Por anos, a única maneira de processar vários documentos de uma só vez era escrever um script. Esse script abriria cada arquivo, extrairia texto usando uma biblioteca de OCR como Tesseract ou um parser de PDF como PyPDF2 ou pdfplumber, analisaria o texto bruto em campos usando regex ou lógica posicional, e escreveria os resultados em um arquivo CSV ou Excel usando pandas ou openpyxl.
Esse pipeline funciona — mas exige um conjunto de habilidades que a maioria das pequenas equipes não tem. De acordo com o Perfil de Pequenas Empresas de 2025 do Escritório de Advocacia da SBA, 99,9% das empresas dos EUA são pequenas empresas, e 82% delas operam sem nenhum funcionário, muito menos um desenvolvedor dedicado. Mesmo entre empresas com funcionários, 61,6% têm menos de 5 funcionários (Census Bureau, 2019). O BLS conta cerca de 1,7 milhão de desenvolvedores de software nos EUA — concentrados esmagadoramente em empresas de tecnologia e grandes corporações, não nas 36 milhões de pequenas empresas que compõem 99,9% dos negócios do país.
"Escrevi um script que converteu todos os PDFs em imagens, usei pytesseract para lê-los, usei regex para procurar a string pelos dados que precisava e escrevi os dados em um CSV", descreveu um usuário no r/learnpython, explicando sua abordagem para extrair dados de dois PDFs. A configuração funciona. Então um fornecedor muda o layout da fatura, e o regex quebra. A saída do Tesseract em uma nova digitalização fica ilegível. O script precisa de manutenção — e a manutenção é onde a maioria das automações caseiras morre.
O processamento em lote sem código quebra esse ciclo não substituindo o script por um script mais simples, mas mudando o paradigma completamente: em vez de dizer ao computador como encontrar dados em uma página (coordenadas, padrões de regex, nomes de tags), você diz a ele o que dados você quer, e a IA os localiza entendendo o conteúdo do documento. A lógica de lote — "processar todos os arquivos neste grupo e mesclar a saída" — está embutida na plataforma, não é escrita pelo usuário. O resultado é funcionalmente equivalente a um pipeline Python semiautomatizado para 80% dos cenários comuns de processamento de documentos, com zero código escrito.
O Que Você Realmente Precisa
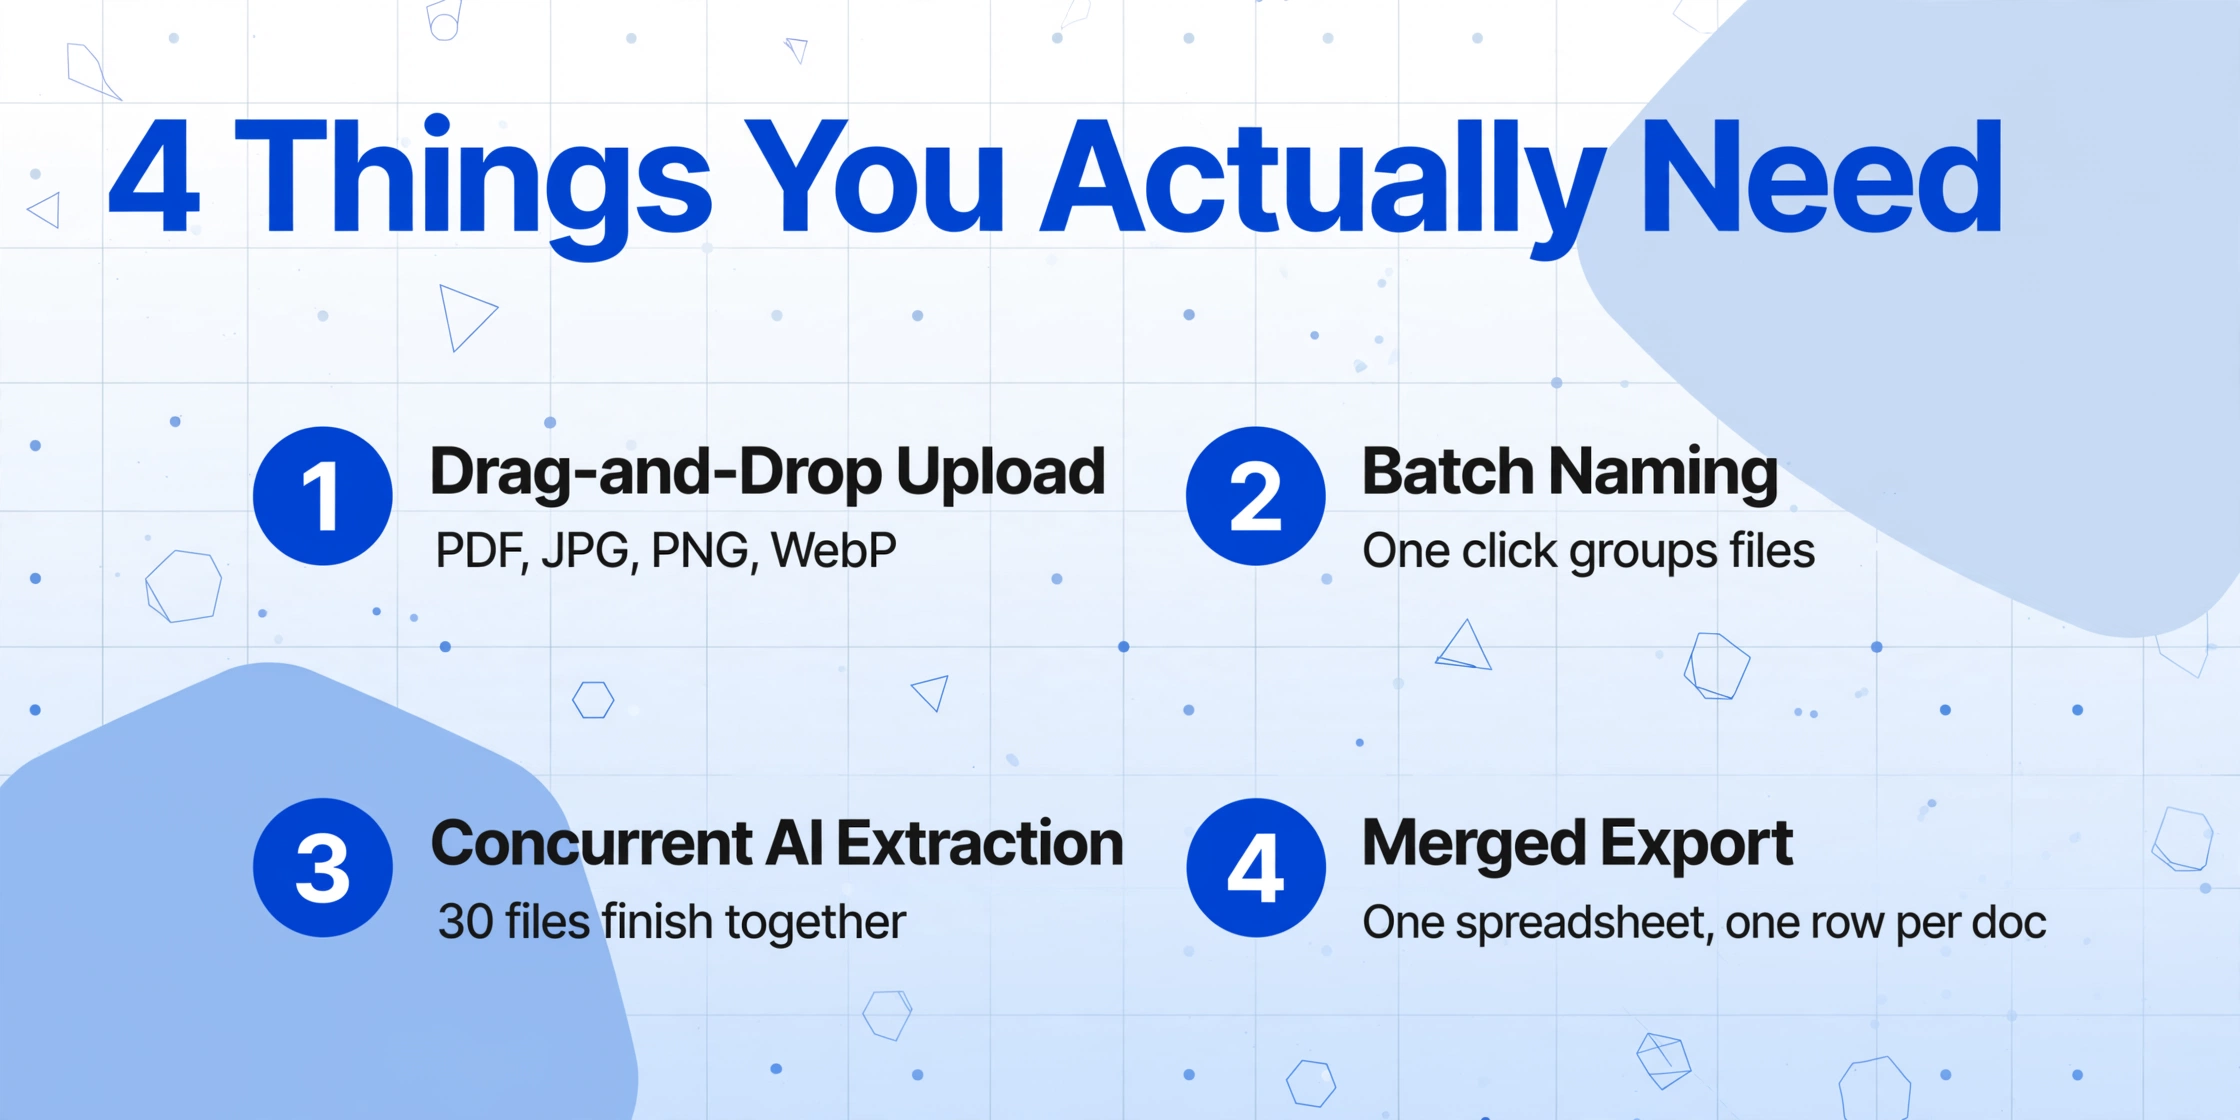
A configuração mínima viável para processamento de documentos em lote sem código é mais curta do que a maioria das pessoas espera. Você precisa de quatro coisas:
- Uma interface de upload por arrastar e soltar que aceite os formatos de arquivo com os quais você trabalha — PDF, JPG, PNG, WebP. A maioria das ferramentas de extração sem código oferece uma superfície de upload baseada em navegador ou incorporada ao Google Sheets. Nenhuma instalação de software local é necessária.
- Um mecanismo de nomeação de lote que agrupe arquivos relacionados. Em uma plataforma sem código, isso normalmente significa um único clique para atribuir um nome de lote — o equivalente a nomear uma pasta — em vez de escrever um script que percorre diretórios.
- Extração simultânea por IA que processe todos os arquivos do lote ao mesmo tempo. Este é o motor oculto: enquanto um humano só pode abrir e ler um documento por vez, uma plataforma consciente de lotes distribui o processamento por todos os arquivos do grupo, então 30 faturas terminam aproximadamente ao mesmo tempo que uma.
- Uma exportação mesclada que consolide os dados extraídos de cada documento em um único arquivo — uma planilha do Excel, um CSV, uma aba do Google Sheets — onde cada linha representa um documento e cada coluna representa um campo que você definiu.
É isso. Sem loops de Python. Sem endpoints de API para configurar. Sem amostras de treinamento para rotular. Os nomes das colunas que você digita se tornam os cabeçalhos da sua planilha de saída. A IA cuida do resto.
Este é o paradigma central que sustenta a extração moderna de documentos sem código, distinta de ferramentas baseadas em modelos ou plataformas de aprendizado de máquina que ainda exigem configuração prévia. Plataformas construídas com Extração de Colunas Personalizadas — onde você digita nomes de campos como "Número da Fatura, Fornecedor, Total, Data de Vencimento" e a IA localiza cada valor por compreensão semântica — eliminam o custo de configuração que silenciosamente consome o tempo que o sem código deveria economizar.
O Fluxo de Trabalho de Processamento em Lote Sem Código
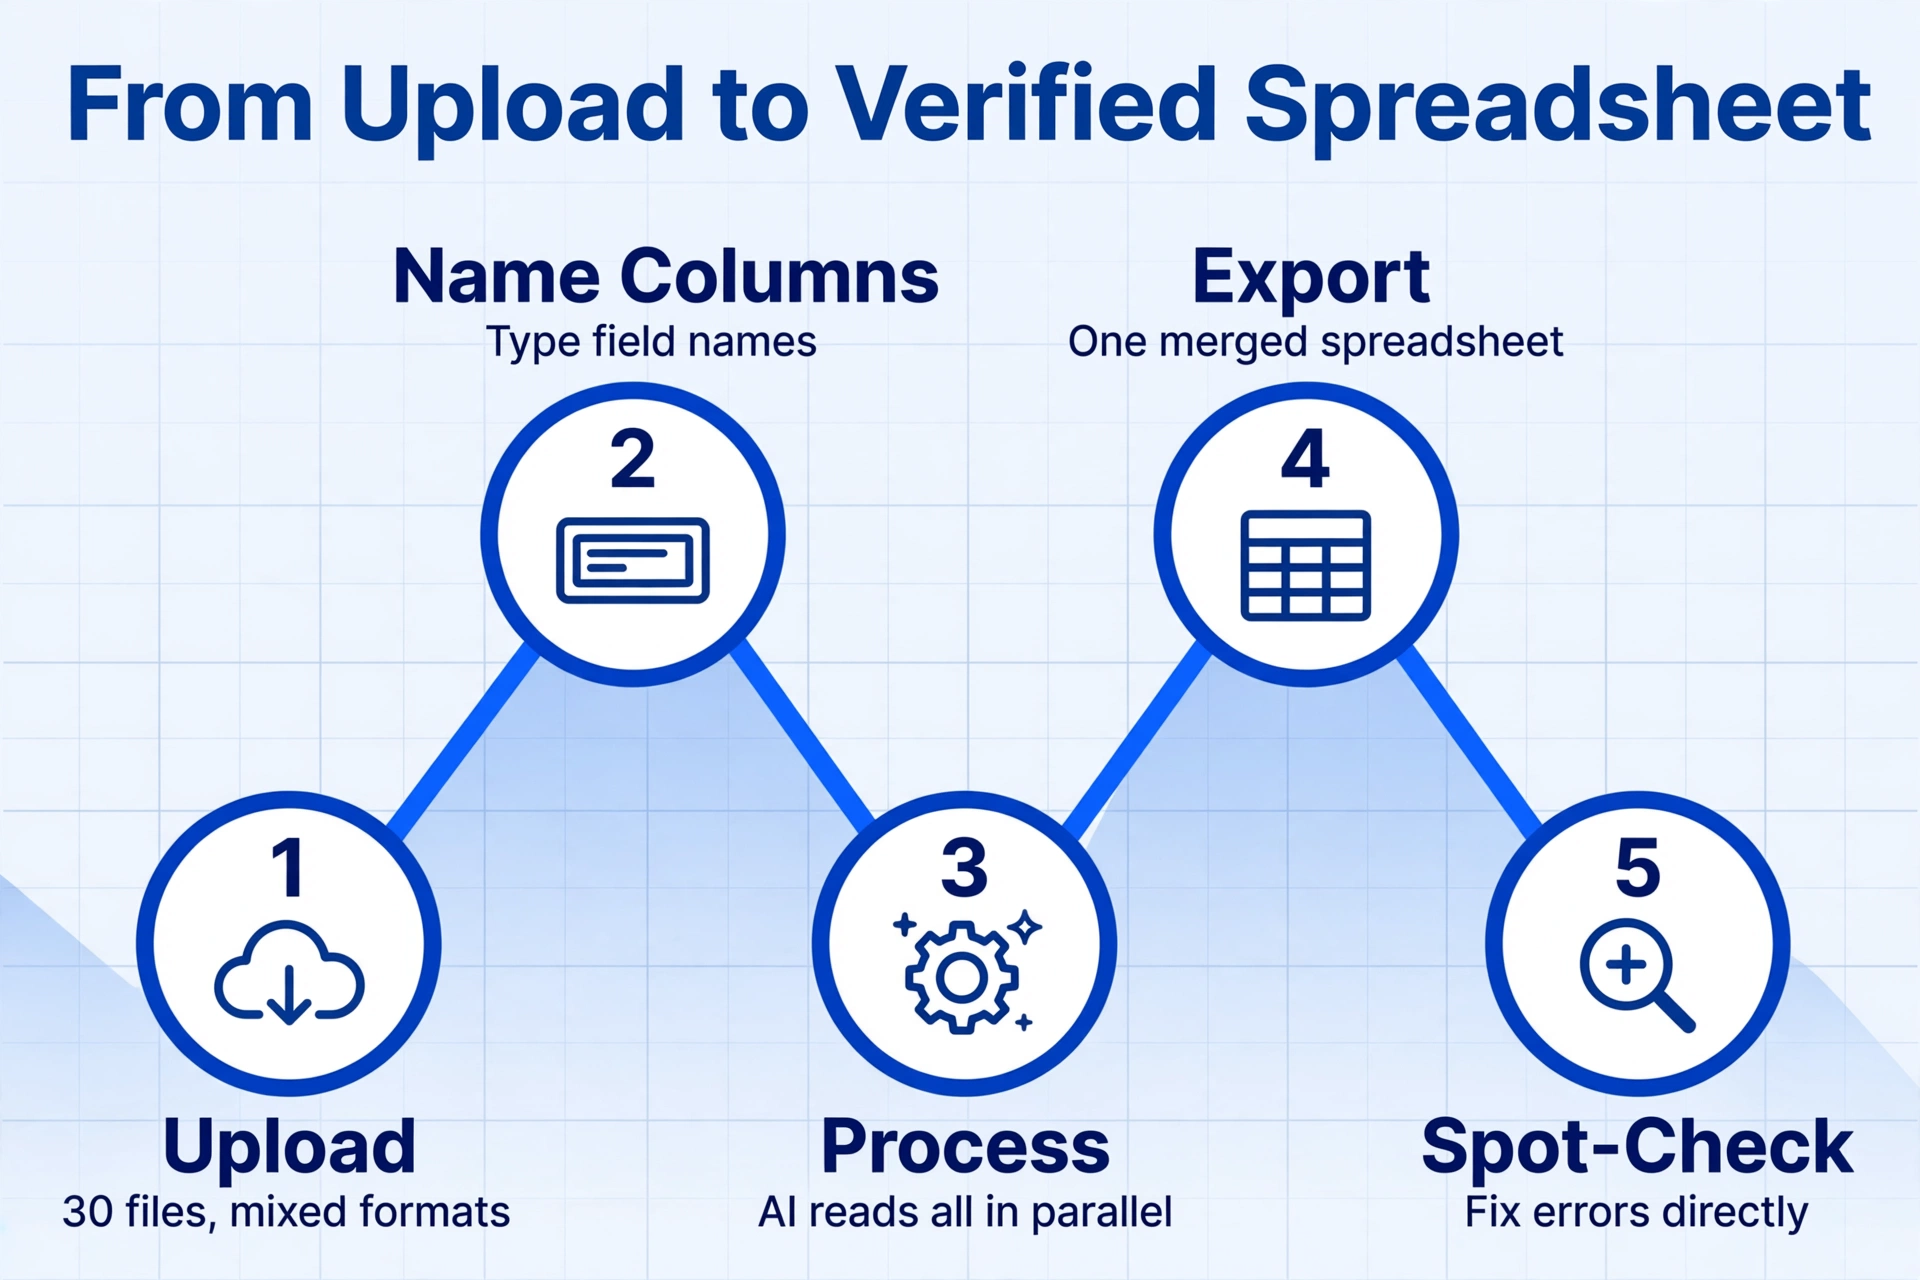
Este é o fluxo de trabalho completo para um cenário real: um auxiliar de contas a pagar que processa 30 faturas de fornecedores todo o meio-dia de quarta-feira. As faturas chegam como PDFs e digitalizações JPEG de 12 fornecedores diferentes, cada uma com um layout diferente — algumas detalhadas, algumas de montante fixo, algumas com tabelas de itens, outras sem.
Invoice Number, Vendor Name, Invoice Date, Due Date, Total Amount, Subtotal, Tax. Estes nomes se tornam os cabeçalhos das colunas da tua saída. Se não estás seguro de quais campos contém um documento, deixa que a IA detecte e sugiera colunas automaticamente com base no que lê em todos os 30 arquivos.2026-06-Wednesday-Vendors. Clica em iniciar. A IA começa a extrair dados de todos os 30 arquivos simultáneamente. Cada arquivo leva aproximadamente 5–10 segundos, independentemente da complexidade da fatura.Tempo total para o funcionário: cerca de 5 minutos de upload e configuração, e o processamento roda em segundo plano. A alternativa manual — abrir cada PDF, copiar campos para um modelo do Excel, verificar a precisão — levaria de 30 a 90 minutos, dependendo da complexidade da fatura. Isso representa um ganho de eficiência de 6 a 18 vezes, consistente com a melhoria de velocidade de 18 vezes documentada em comparações de benchmark entre extração por IA e entrada manual.
O mesmo fluxo de trabalho se aplica a diferentes tipos de documento. Substitua "faturas de fornecedores" por "notas de entrega de cinco armazéns", "recibos de despesas de 40 funcionários" ou "extratos bancários de várias contas". A única coisa que muda são os nomes das colunas que você digita. Para tutoriais passo a passo sobre tipos específicos de documento, veja como extrair dados de faturas em lote para o Excel ou como agrupar recibos comerciais em uma planilha de impostos.
O Que Você Abre Mão Sem Código
Ser honesto sobre as compensações é o que separa uma comparação útil de um discurso de vendas. O processamento em lote sem código lida de forma confiável com o ciclo principal de extração e mesclagem, mas os seguintes recursos exigem uma abordagem de programação:
Pipelines de processamento personalizados. Um script pode encadear a extração com ações posteriores — "extrair dados da fatura → validar contra a lista de códigos GL → publicar no QuickBooks via API → enviar e-mail ao CFO se o total exceder $10.000". Em uma plataforma sem código, extração e exportação são o fim do caminho automatizado. Qualquer coisa depois disso exige intervenção manual ou uma ferramenta separada como Zapier ou Make (antigo Integromat), que adicionam sua própria complexidade e custo.
Tratamento de erros personalizado. Quando um script encontra um documento que não consegue analisar, o desenvolvedor decide o que fazer: tentar novamente com parâmetros diferentes, registrar a falha em um banco de dados, pular o arquivo e seguir em frente, ou sinalizá-lo para revisão humana. Plataformas sem código geralmente exibem indicadores de status por documento — sucesso, processamento, erro — mas você não controla a lógica de tratamento de erros. Se a confiança estiver no limite, você não saberá até a verificação por amostragem.
Automação de API e agendamento. Um script Python pode ser executado em um cron job, acionado por um novo arquivo que chega a um bucket S3, ou chamado a partir de um webhook. Ele se integra diretamente à sua infraestrutura. Plataformas sem código fornecem acesso à API em planos de nível superior, mas a automação de acionar-e-responder que os desenvolvedores consideram garantida — "quando um PDF chega nesta pasta, extraia-o e anexe-o a esta tabela do banco de dados" — exige uma camada de automação separada (Zapier, Power Automate, n8n) que adiciona custo e manutenção.
Estas são limitações reais. Se o fluxo de trabalho da sua equipe envolve validação em várias etapas, roteamento condicional ou gatilhos orientados a eventos, o processamento em lote sem código sozinho não cobrirá o ciclo completo. Mas para a grande maioria do processamento de documentos de volume pequeno a médio — o tipo que acontece em escritórios de contabilidade, pequenas equipes de logística, escritórios de administração de propriedades e práticas de contabilidade freelance — estes são casos extremos, não obstáculos.
Quando Escrever Código Realmente Faz Sentido
Processamento em lote sem código não substitui universalmente scripts. Existem três situações em que escrever código é a melhor escolha:
Volume acima de 500 documentos por dia. Nessa escala, a economia muda. Um script rodando em um servidor custa centavos por mil documentos, enquanto plataformas sem código cobram por documento ou página. Mais importante, em alto volume os modos de falha mudam: uma taxa de erro de 1% em 500 documentos significa que 5 arquivos precisam ser reprocessados. Scripts podem ser ajustados para lidar com casos extremos programaticamente; plataformas sem código expõem o mesmo mecanismo de extração para todos os documentos, limitando sua capacidade de otimização.
Regras de validação personalizadas vinculadas aos seus dados. Se seu processo exige verificar valores extraídos contra seu próprio banco de dados — "este CNPJ do fornecedor está na nossa lista aprovada?" ou "o total desta PO corresponde à soma dos itens?" — o código lhe dá controle total sobre a lógica de validação. Plataformas sem código oferecem colunas calculadas e pós-processamento, mas a profundidade da validação é menor do que um script com acesso total ao banco de dados pode alcançar.
Integração profunda com APIs de sistemas existentes. Um script pode extrair dados de um documento, transformá-los e enviá-los diretamente para seu ERP, CRM ou software contábil em uma única operação atômica. Plataformas sem código geralmente exportam para formatos intermediários (Excel, CSV, JSON) que exigem uma segunda etapa para importar para seu sistema. Para equipes que precisam de extração → integração → gatilho em um fluxo automatizado, uma abordagem baseada em API — seja uma API de extração dedicada ou um script que envolve um serviço de extração por IA — é a opção certa.
Para uma comparação detalhada de quando usar abordagens baseadas em API versus sem código, veja Extração de documentos por API vs. sem código: qual arquitetura se adapta à sua equipe.
O meio-termo honesto é uma abordagem híbrida: use extração sem código para a etapa de leitura do documento (a parte que se beneficia da IA visual e não precisa de lógica personalizada) e um script leve ou plataforma de automação para as etapas de roteamento e validação que se seguem. Esta é a arquitetura que muitas equipes em crescimento adotam — sem código para o pesado trabalho de IA, e uma camada fina de código ou conectores para a lógica de negócios.
Perguntas Frequentes
Posso processar em lote documentos em formatos diferentes — alguns PDF, alguns escaneados, algumas fotos?
Sim. Ferramentas modernas de extração por IA sem código aceitam tipos de arquivo mistos em um único lote. PDF, JPG, PNG, WebP e até capturas de tela podem ser enviados juntos e processados com o mesmo conjunto de regras de extração. A IA lê o documento visualmente, não pelos metadados do arquivo, então a variação de formato não afeta a lógica de extração.
Como o processamento em lote sem código lida com documentos de layouts diferentes de fornecedores distintos?
Esta é a principal vantagem da extração por IA sem modelo sobre o OCR tradicional ou análise zonal. Em vez de memorizar onde os campos estão na página — o que falha quando os layouts mudam — a IA lê a semântica dos campos: ela entende como é um "número de nota fiscal" pelo contexto, não pela posição. Assim, 30 notas fiscais de 30 fornecedores diferentes são extraídas corretamente em um único lote, sem modelos por fornecedor ou amostras de treinamento.
O que acontece se a IA errar alguns campos em alguns documentos?
Nenhum sistema de extração — codificado ou não — atinge 100% de precisão em todos os documentos. A diferença está na velocidade de recuperação. Ao verificar manualmente um lote sem código (etapa 5 do fluxo acima), você pode corrigir erros diretamente na planilha baixada, reprocessar arquivos individuais com falha ou ajustar definições de colunas para campos complicados. O tempo economizado ainda é ordens de magnitude maior que a extração manual, mesmo considerando correções. Para um guia detalhado sobre o que pode dar errado e como detectar, veja por que a extração em lote perde arquivos — e o que fazer.
Preciso instalar algo no meu computador?
Não. O processamento em lote sem código é executado inteiramente no navegador ou através de uma barra lateral de complemento do Google Sheets. Não há software para instalar, servidor local para executar ou ambiente Python para configurar. O único requisito é uma conexão com a internet e um navegador moderno.
O processamento em lote sem código é mais barato do que escrever um script?
Depende do volume. Para equipes processando até algumas centenas de documentos por mês, plataformas sem código são mais baratas que o tempo de desenvolvimento necessário para criar e manter um script personalizado — especialmente considerando o custo de manutenção de scripts que quebram quando os formatos dos documentos mudam. Em volumes muito altos (milhares de documentos diariamente), um script executado em sua própria infraestrutura terá custos menores por documento, embora o salário do desenvolvedor e o tempo de manutenção devam ser considerados nessa comparação.
Inicie Seu Primeiro Lote Sem Código
A ideia de que o processamento em lote exige programação tem mantido muitas pequenas equipes fazendo entrada manual de dados por mais tempo que o necessário. As ferramentas para extrair dados de 30, 50 ou 200 documentos de uma só vez — sem escrever uma única linha de código — já existem e são acessíveis de qualquer navegador. O fluxo de trabalho é: enviar, nomear, processar, exportar, verificar. A parte mais difícil é saber quais dados você quer extrair. A IA cuida do resto.
Se você processa documentos regularmente e tem se afastado por achar que precisa aprender Python ou contratar um desenvolvedor, o teste prático é simples: pegue seu próximo lote de documentos — mesmo 5 ou 10 arquivos —, envie-os para uma plataforma de extração sem código e veja como fica a saída. O primeiro lote não custa nada além do tempo que você já gasta com entrada manual.