Por que minha extração em lote deixou passar
metade dos arquivos? Modos de falha comuns
Você enviou 30 arquivos. Só 22 apareceram na planilha. Sem mensagem de erro, sem aviso — apenas metade dos seus dados, sumidos. Aqui está o que aconteceu, em ordem de probabilidade.
A parte inquietante não são os 8 arquivos que não chegaram. É o silêncio em torno deles. Uma ferramenta de processamento em lote que mostrou marcas verdes por toda parte, um download que parecia completo, e só depois — quando você tentou conciliar as linhas com os originais — a lacuna se revelou. Este padrão é mais comum do que a maioria dos usuários imagina, e quase nunca é aleatório. Os arquivos não desaparecem sem deixar rastro. Eles falham em etapas específicas do pipeline, e cada modo de falha deixa uma assinatura.
Este artigo percorre as três etapas onde os arquivos podem se perder — upload, processamento e mesclagem de saída — em ordem de probabilidade de ser o culpable. Ao final, você terá uma estrutura de diagnóstico e uma lista de verificação pré-upload para detectar as causas mais comuns antes que elas levem outros 8 arquivos do seu próximo lote.
Principais conclusões
- Você enviou 30 arquivos, a ferramenta mostró marcas verdes e o download parecia completo — mas só 22 linhas saíram, com zero mensagens de erro para os 8 que sumieron.
- Os arquivos não desaparecem aleatoriamente; eles falham em três portões específicos do pipeline — 60% no upload (formatos não suportados como TIFF, caracteres especiais em nomes de arquivo, bytes corrompidos), 30% durante o processamento (quedas de concorrencia, timeouts silenciosos) e 10% durante a mesclagem (incompatibilidades estruturais).
- Uma lista de verificación pré-upload de 30 segundos — ordenar por extensão, verificar arquivos acima de 30MB, sanitizar nomes de arquivo, agrupar por tipo de documento — detecta a maioria antes de que falhem, e os 8 arquivos perdidos quase certamente ainda estão na sua máquina prontos para reprocessar.
Etapa 1: O arquivo nunca passou do upload
Esta é a causa mais comum de arquivos ausentes e também a mais fácil de ignorar, porque a barra de progresso do upload se move suavemente — ela apenas para de contar antes que os arquivos problemáticos entrem na fila. A ferramenta registrou esses arquivos como "tentados" em vez de "enviados" e, sem um log de erros por arquivo, a lacuna passa despercebida.
Formato de arquivo não suportado
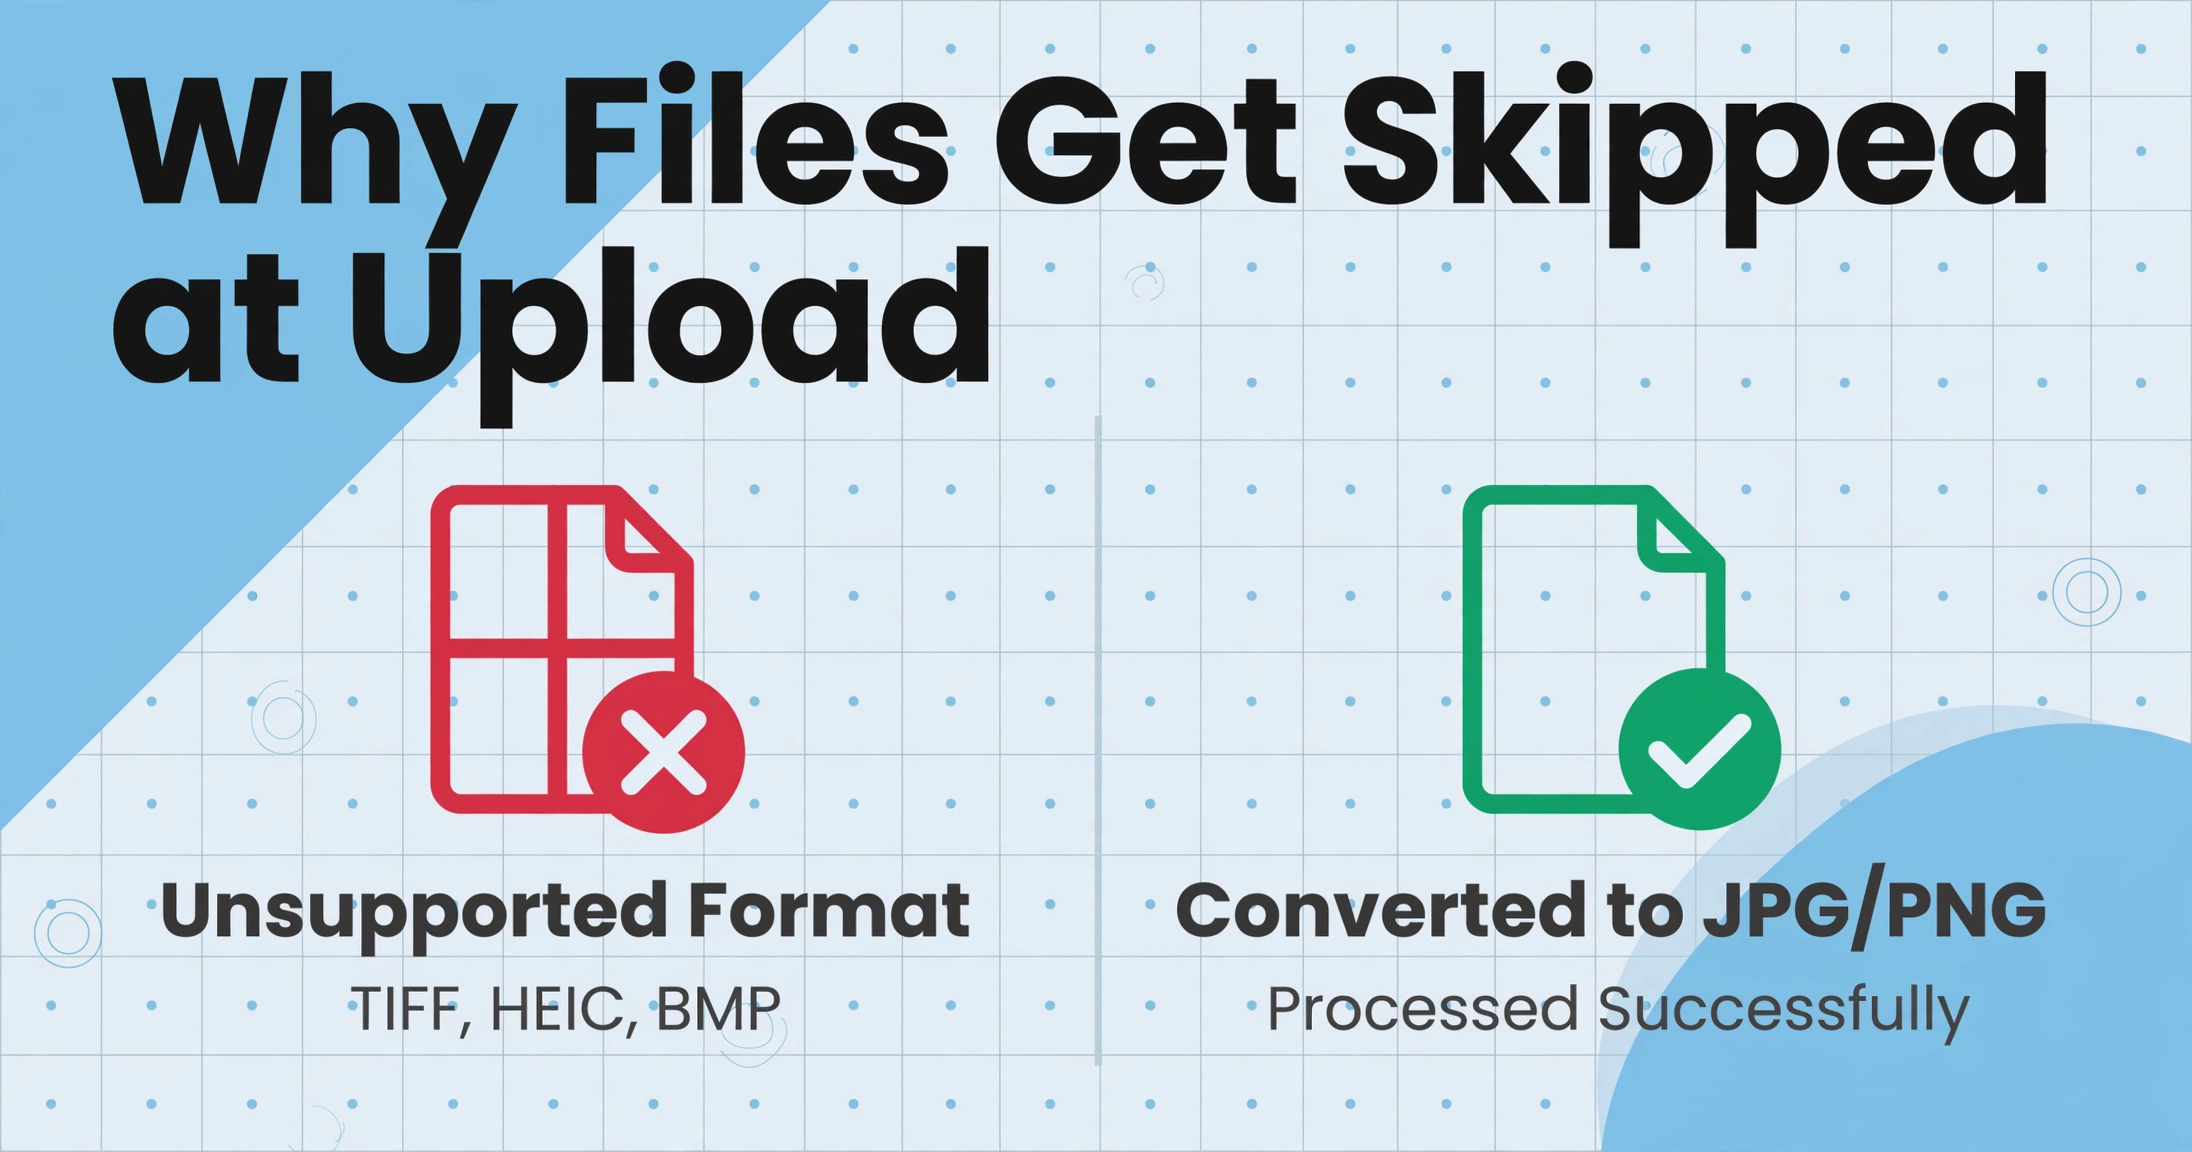
Nem todos os formatos de imagem e documento são iguais. A maioria das ferramentas de extração por IA — incluindo o ImageToTable.ai — suporta PDF, JPG, PNG, WebP e AVIF. Mas se o seu lote contém um arquivo TIFF, uma foto HEIC de um iPhone ou um screenshot BMP de um sistema mais antigo, o manipulador de upload pode simplesmente ignorá-lo. O TIFF em particular é um vilão comum: muitos scanners ainda usam TIFF de várias páginas como padrão e, embora o TIFF seja um contêiner de imagem válido, ele não está na lista de entrada da maioria das ferramentas de extração. O arquivo parece ser enviado — o navegador o envia — mas o pipeline de processamento nunca o captura.
Como verificar: Classifique sua pasta de origem por extensão de arquivo antes de enviar. Se você vir .tiff, .heic, .bmp ou .svg, converta-os para JPG ou PNG primeiro. A maioria dos sistemas operacionais pode converter em lote no Explorador de Arquivos ou no Finder. Uma etapa de conversão de 30 segundos economiza horas de quebra-cabeça depois.
O TIFF é o formato não suportado mais comum que atrapalha o processamento em lote. Se o seu scanner usa TIFF como padrão, altere a configuração de saída para JPEG ou PDF antes de digitalizar o próximo lote.
Arquivos corrompidos ou incompletos
Um arquivo que abre normalmente na sua máquina pode ainda assim falhar na verificação de integridade do upload. O PDF pode ter uma última página truncada por um download interrompido na nuvem. A imagem pode ter um cabeçalho EXIF corrompido por uma gravação falha da câmera. Um arquivo que "parece normal" na pré-visualização — porque o sistema operacional mostra uma miniatura em cache — pode falhar quando a ferramenta de extração tenta ler os bytes.
Isso é especialmente comum com arquivos baixados de anexos de e-mail ou links de armazenamento na nuvem. O arquivo abre, o conteúdo parece certo, mas o binário não está íntegro. Ferramentas de extração, ao contrário de humanos lendo uma pré-visualização, leem os bytes — e bytes quebrados produzem resultados vazios.
Como verificar: Tente abrir cada arquivo suspeito e salvá-lo novamente. No Adobe Acrobat, use "Arquivo → Salvar como → PDF otimizado" para remover corrupção latente. Para imagens, um novo salvamento rápido em qualquer editor de fotos geralmente resolve problemas de cabeçalho.
Limites de tamanho de arquivo
A maioria das ferramentas de extração limita o tamanho de arquivos individuais. No ImageToTable.ai, o limite padrão de upload acomoda documentos de escritório típicos, mas um PDF escaneado de 200 páginas ou uma foto de fatura em alta resolução tirada com 48 megapixels pode excedê-lo. A ferramenta nem sempre rejeita o upload visivelmente — ela pode aceitar os metadados do arquivo, mas pular o conteúdo real quando detecta que o limite de tamanho foi ultrapassado.
Como verificar: Revise seus arquivos antes de enviar. Se qualquer arquivo individual exceder 30-50 MB, considere dividir PDFs de várias páginas em documentos menores usando um divisor de PDF, ou reduzir a resolução da imagem antes do upload. Ferramentas como PDFsam ou o recurso "Dividir documento" do Adobe Acrobat resolvem isso em segundos.
Caracteres especiais em nomes de arquivo
Um modo de falha subestimado. Arquivos nomeados INV-2026-03-15_återbetalning.pdf ou 收据-001.jpg ou Invoice (final - DO NOT EDIT).pdf — com caracteres não ASCII, símbolos especiais ou caminhos muito longos — podem falhar durante a etapa de gravação no servidor. A solicitação de upload é concluída, o servidor aceita o fluxo do arquivo, mas quando tenta gravar o arquivo no armazenamento temporário usando o nome original, o sistema de arquivos rejeita a codificação de caracteres. O arquivo é contado como "recebido" pela camada HTTP, mas nunca chega ao disco para processamento.
Como verificar: Verifique se os nomes dos seus arquivos contêm apenas caracteres alfanuméricos padrão, hífens e sublinhados. Uma renomeação em massa rápida — INV-2026-03-15-refund.pdf em vez do original — elimina essa variável por completo.
Etapa 2: Enviado, mas Silenciosamente Descartado Durante o Processamento
Esta etapa é mais difícil de diagnosticar porque o upload confirmou sucesso. A ferramenta mostra 30 arquivos enviados, 30 indicadores verdes. Mas durante a fase de processamento — quando a IA realmente lê cada documento e extrai os dados — os arquivos podem cair da esteira sem acionar um estado de erro. A interface de processamento diz "Concluído" porque o mecanismo principal terminou seu trabalho, mas processou menos documentos do que foram enviados.
Limitação de concorrência e limites de fila
A extração por IA é computacionalmente cara. Cada documento requer uma inferência do modelo de visão, que consome memória GPU e throughput de API. Para manter a estabilidade, as ferramentas de extração impõem limites de concorrência — normalmente de 4 a 8 slots de processamento simultâneos por usuário. Quando você envia 50 arquivos, eles entram em uma fila, e a ferramenta os processa em ondas: 4 por vez, depois os próximos 4, e assim por diante.
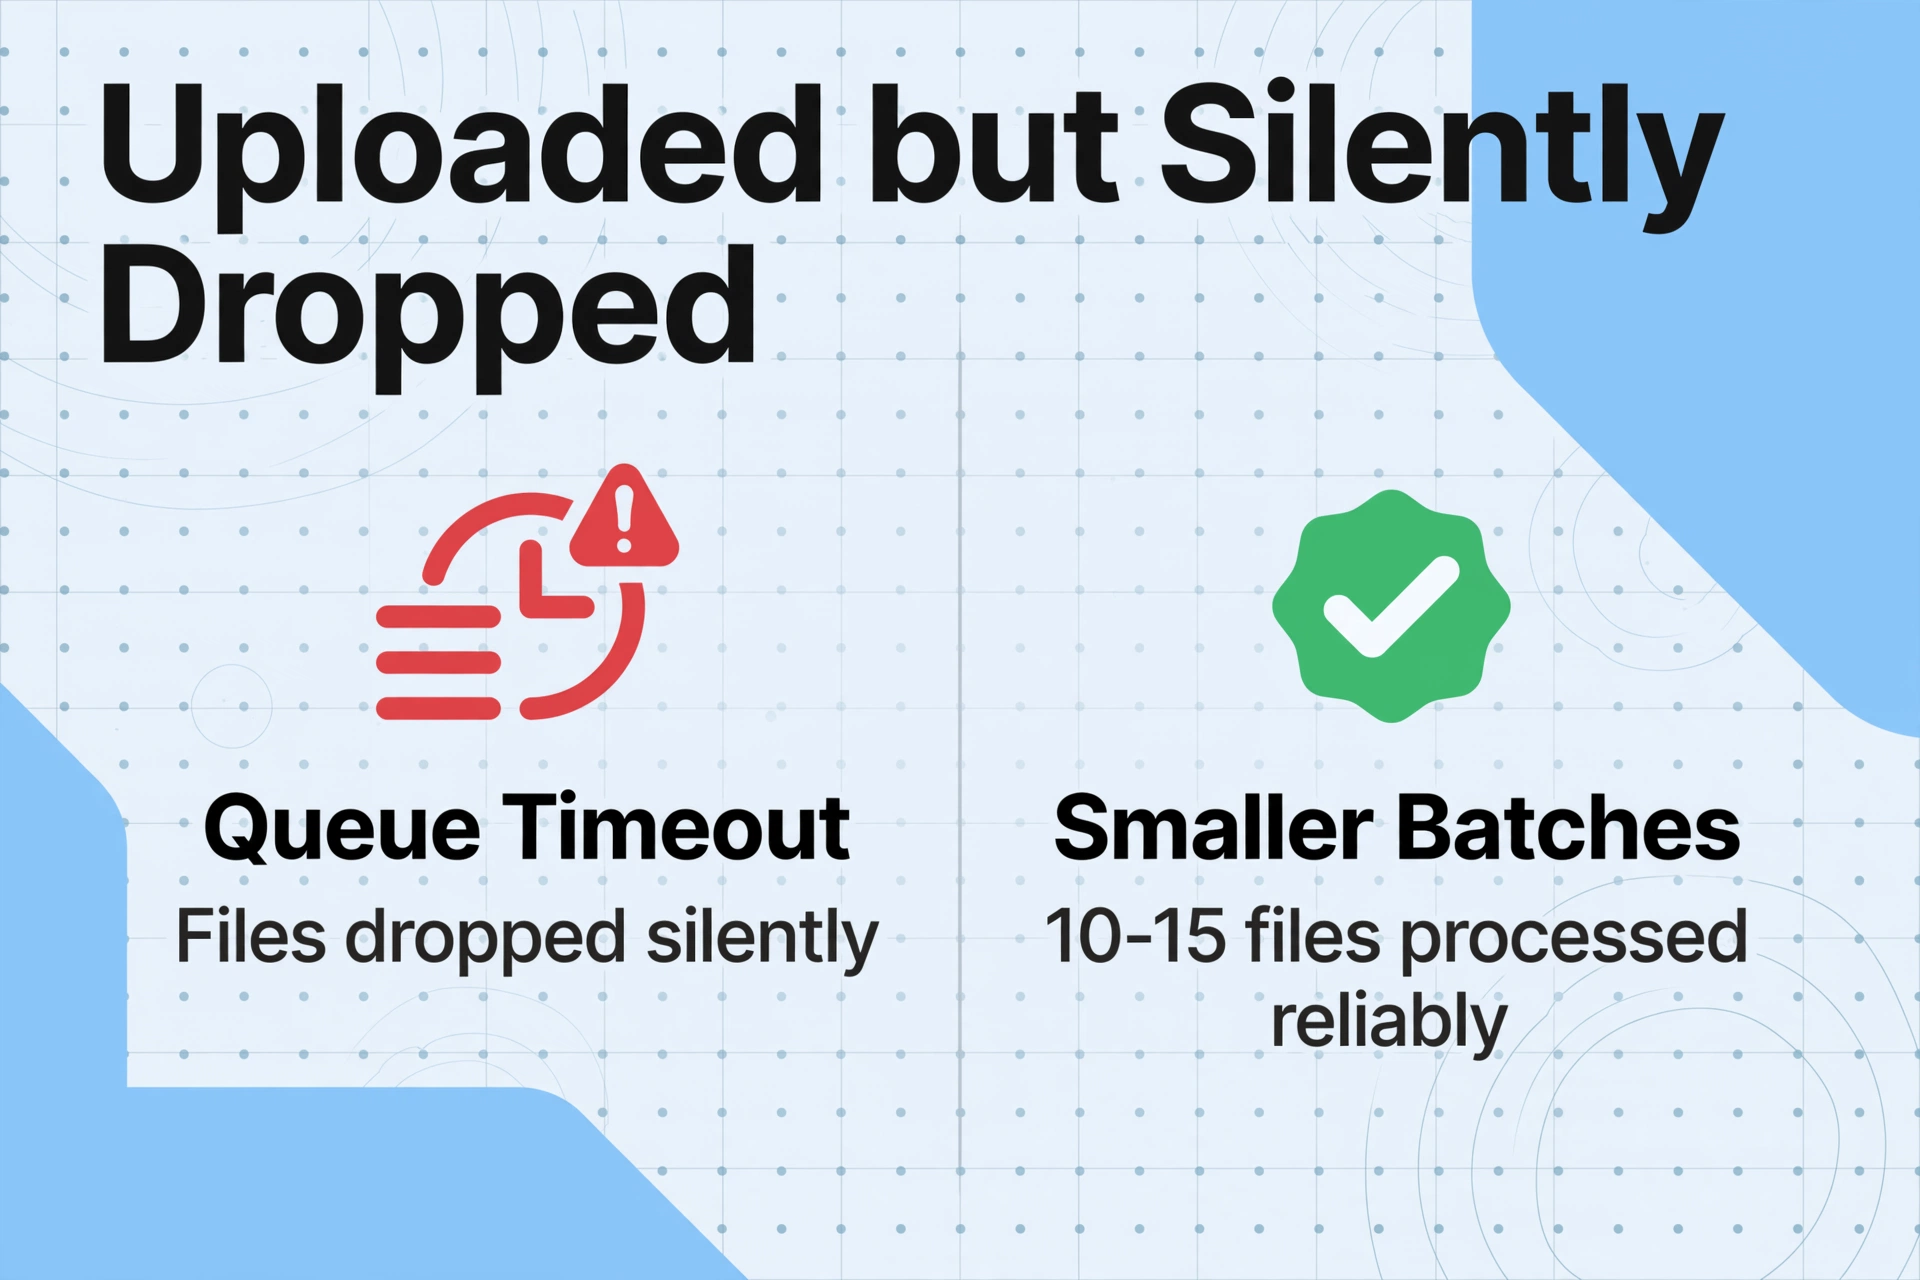
O problema surge quando a fila tem um limite máximo rígido. Alguns sistemas descartam silenciosamente arquivos que excedem a profundidade da fila. Se o seu plano permite 50 arquivos por lote, mas apenas 4 slots simultâneos, e o mecanismo de processamento encontra um erro persistente em um dos primeiros 4 arquivos — digamos, um PDF corrompido que trava o leitor — ele pode travar a onda inteira por tempo suficiente para que os arquivos restantes na fila expirem e sejam descartados. A interface ainda mostra "50 enviados, 46 processados" — mas os 4 ausentes nunca foram realmente tentados.
Como verificar: Divida seu upload em lotes menores de 10 a 15 arquivos e processe-os sequencialmente. Se um lote específico perder arquivos consistentemente enquanto lotes menores não perdem, a limitação de concorrência é a culpada. Esse comportamento é documentado em vários sistemas de processamento em lote — do Google Document AI a pipelines de OCR auto-hospedados — onde a lacuna entre as contagens de "enviados" e "processados" é quase sempre um artefato de fila.
Tempos limite silenciosos em PDFs grandes ou complexos
Um PDF com mais de 100 páginas ou gráficos incorporados complexos pode exceder o tempo limite de processamento por documento do mecanismo de extração. Diferentemente de um erro de tempo limite explícito — que informaria que o arquivo falhou — alguns sistemas lidam com isso pulando silenciosamente o arquivo e continuando com o próximo. O trabalho de processamento registra o arquivo como "concluído" porque o manipulador de tempo limite encerrou o thread normalmente, mas nenhum resultado de extração foi gerado.
Isso é especialmente comum com PDFs digitalizados que são essencialmente 100 imagens JPEG separadas agrupadas em um único arquivo. Cada página exige uma passada completa de OCR, e o tempo acumulado pode ultrapassar o limite na 70ª página — após a qual o processador descarta o trabalho acumulado e segue em frente.
Como verificar: Envie o arquivo problemático individualmente. Se ele for processado com sucesso como um envio isolado, mas for pulado no modo de lote, o tempo limite durante a fila de lote é a causa. Para PDFs com várias páginas que excedam 30 páginas, considere dividi-los em documentos menores antes do envio em lote.
Tipos de arquivo mistos se comportando de forma diferente
Nem todos os tipos de arquivo são processados na mesma velocidade. Um lote que mistura capturas de tela JPG de uma página com PDFs digitalizados de 50 páginas cria um ritmo de processamento desigual. Os JPGs leves terminam rapidamente, enquanto os PDFs pesados consomem tempo de processamento desproporcional. Se o tempo limite do lote for calculado com base no tempo total de processamento de todos os arquivos, os PDFs lentos podem fazer com que os JPGs que chegaram mais tarde na fila sejam descartados — mesmo que os JPGs fossem processados corretamente por conta própria.
Este é um problema de nível de sistema que afeta qualquer ferramenta de extração em lote, não uma peculiaridade de um produto específico. A causa subjacente é que os pipelines de processamento normalmente agrupam arquivos de forma heterogênea, mas medem o tempo limite de forma homogênea.
Como verificar: Agrupe os arquivos por tipo e tamanho antes do envio. Processe todos os arquivos JPG pequenos em um lote e, em seguida, lide com os PDFs grandes separadamente. Isso isola os arquivos lentos dos rápidos e elimina a contaminação cruzada na lógica de tempo limite.
Etapa 3: Processados, mas Perdidos na Mesclagem
O modo de falha mais raro, mas mais enganoso. Todos os 30 arquivos foram enviados com sucesso, todos os 30 foram processados pela IA, todos os 30 retornaram resultados de extração. Mas a saída final mesclada — a única planilha que você baixou — contém apenas 22 linhas. As outras 8 foram processadas como documentos individuais, mas nunca foram integradas na exportação unificada.
Estruturas de arquivo diferentes producendo linhas desalinhadas
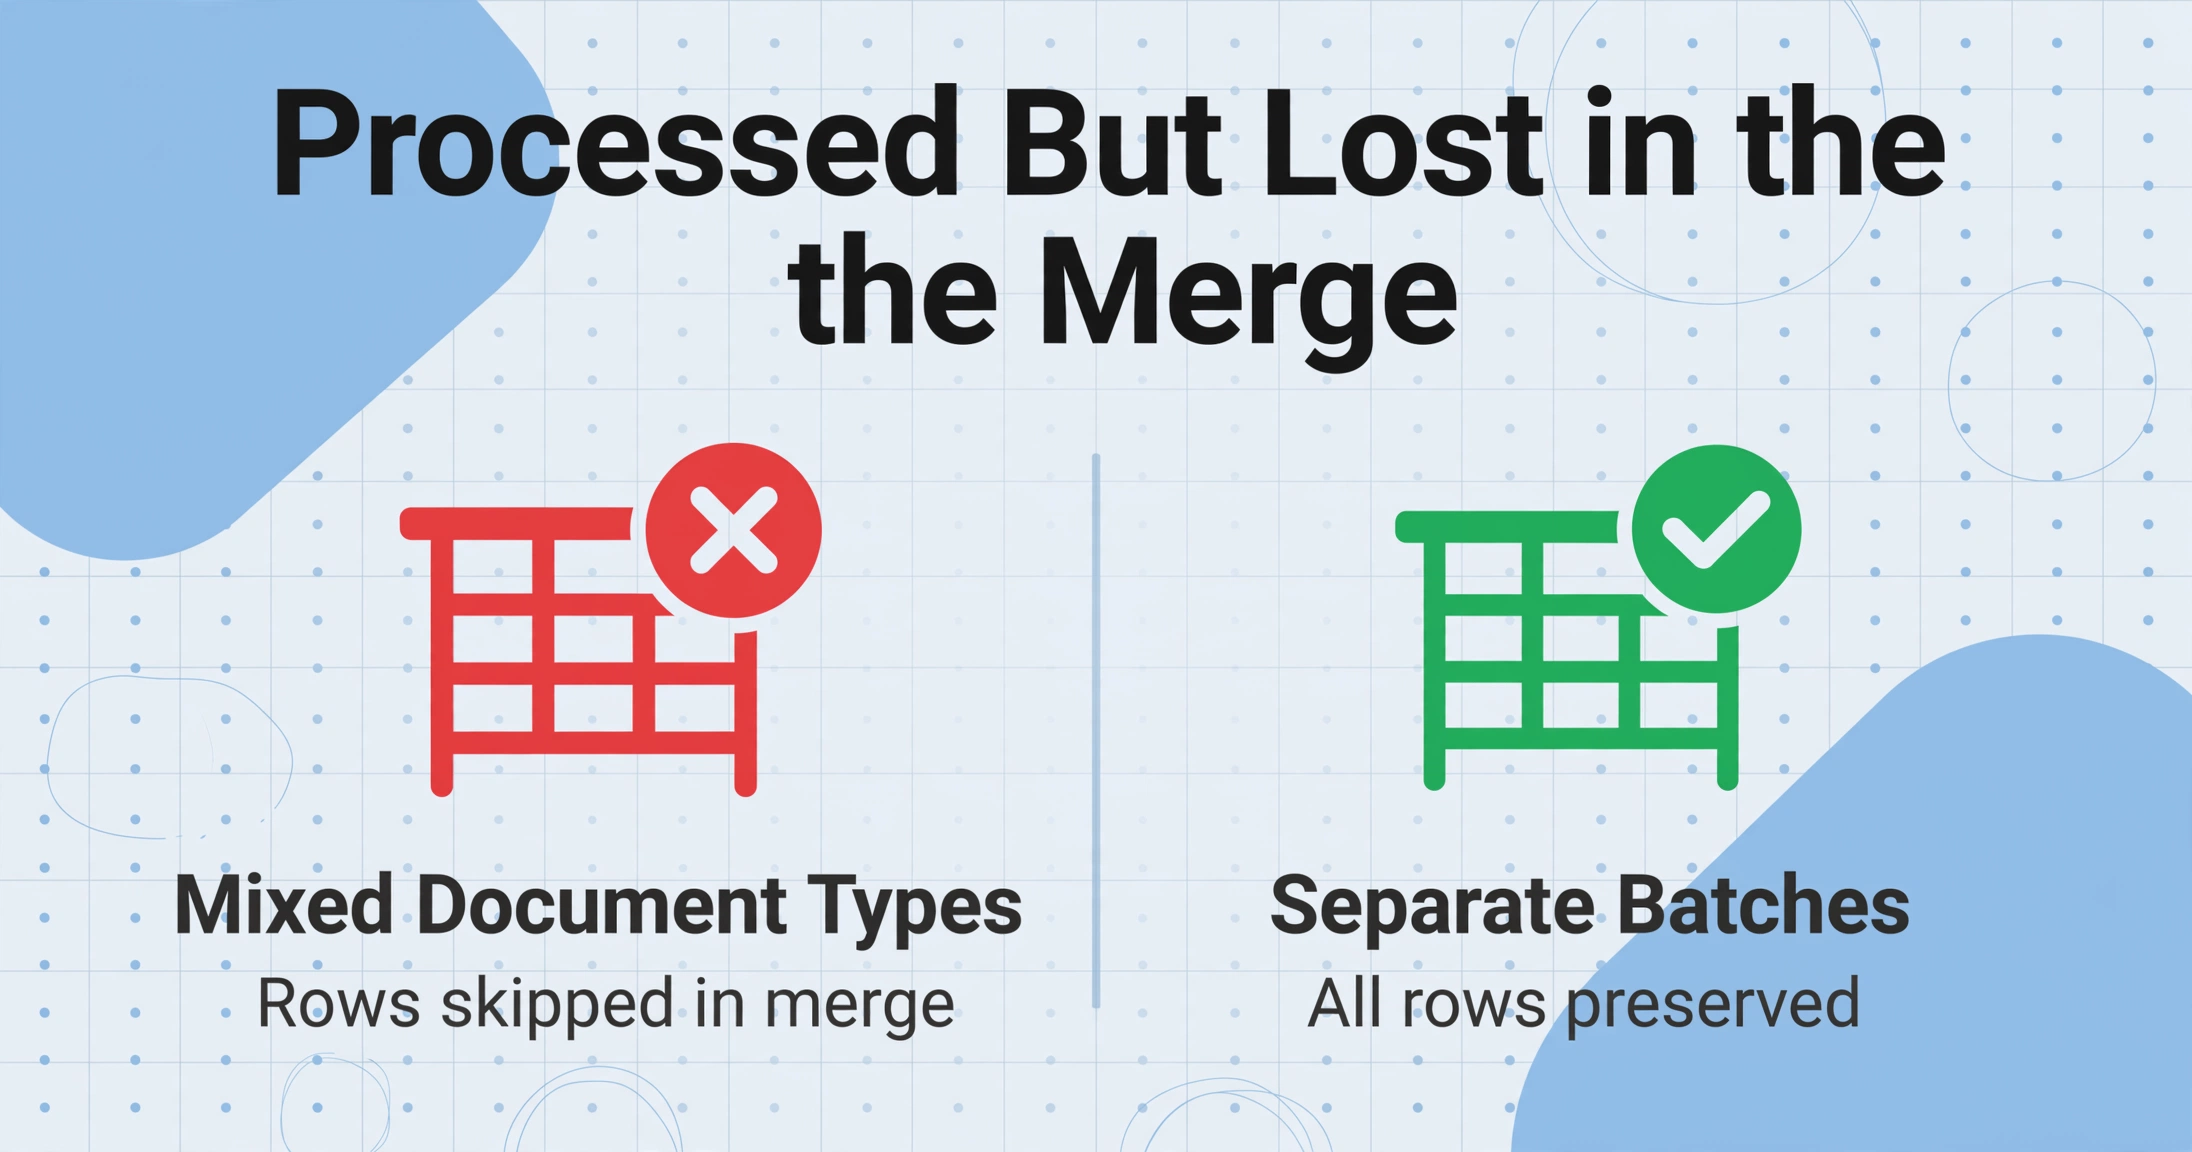
Quando você executa a extração em lote em um conjunto de documentos, o motor de processamento em lote da ferramenta tenta mesclar os resultados em uma única tabela com cabeçalhos de columna consistentes. Isso funciona perfeitamente quando todos os arquivos são do mesmo tipo — 30 faturas, por exemplo. Mas se seu lote contém 25 faturas e 5 notas de crédito, as notas de crédito podem ter campos diferentes (como "Número de Nota de Crédito" em vez de "Número de Fatura"), fazendo que o algoritmo de mesclagem crie colunas duplicadas ou — em algumas implementações — omita linhas cuja estrutura não corresponde ao esquema majoritario.
Isto não é uma perda de dados no sentido estricto; a extração foi bem-sucedida. Mas a lógica de exportação trató estas 8 arquivos como valores atípicos estruturais e os excluiu da tabela unificada para preservar a consistência das colunas. A ferramenta nunca lhe informó porque, desde sua perspectiva, entregó a mesclagem mais limpa possível.
Como verificar: Procure diferenças entre seus arquivos de origem. Se um subconjunto tem uma orientação de página diferente, um idioma diferente ou um tipo de documento fundamentalmente diferente, processe esses arquivos como um lote separado. A definição de "lote" importa — seu fluxo de trabalho deve agrupar arquivos por similaridade estrutural, não por conveniencia de carpeta.
Este problema é particularmente comum ao processar em lote documentos similares mas não idénticos, como extraer tablas de documentos con celdas combinadas o estructuras anidadas, donde el número de filas por documento varía de manera impredecible.
Checklist Pré-upload — 30 Segundos por Lote
A maioria dos modos de falha acima compartilha uma característica comum: são detectáveis antes do upload com uma rápida inspeção visual da sua pasta de origem. Trate este checklist como o portal entre "pronto para processar" e "iniciar o lote". Leva menos tempo do que solucionar 8 arquivos faltantes depois.
- Auditoria de formato — Confirme que todo arquivo é JPG, PNG ou PDF. Converta TIFF, HEIC, BMP ou WebP. Uma classificação rápida por extensão no Explorador de Arquivos revela discrepâncias imediatamente.
- Verificação de tamanho — Cheque arquivos acima de 30 MB. Se houver, divida ou comprima.
- Sanitização de nomes — Renomeie arquivos com caracteres especiais (&, %, #, parênteses) ou letras não ASCII (é, ü, å, 中). Use apenas
A-Z,0-9, hífens e underscores. - Homogeneidade de tipo — Todos os arquivos são do mesmo tipo de documento? Se estiver misturando faturas com notas de crédito, pedidos com recibos de entrega, separe-os em lotes dedicados.
- Teste pontual de arquivo pesado — Faça upload do seu maior PDF individualmente e verifique se processa corretamente. Se expirar sozinho, certamente falhará em lote.
- Sanidade do tamanho do lote — Se tiver mais de 30 arquivos, divida em lotes menores de 10 a 15. Lotes menores isolam problemas e concluem mais rápido do início ao fim.
Quando Escalar — Esta é a Ferramenta Certa para Seus Arquivos?
A honestidade sobre as limitações da ferramenta evita frustrações repetidas. Se você perde arquivos consistentemente em vários lotes e o checklist pré-upload não revela a causa, considere se seu conjunto de documentos tem características que contrariam as premissas de projeto da maioria das ferramentas de extração.
Ferramentas de extração em lote — incluindo o ImageToTable.ai — são construídas para o caso comum: documentos de escritório padrão, digitalizações limpas e fotos com conteúdo legível. Elas não são projetadas para:
- Documentos únicos extremamente grandes — PDFs com 500+ páginas pertencem a um pipeline dedicado de gerenciamento de documentos, não a uma fila de extração em lote.
- Coleções altamente heterogêneas — 15 tipos diferentes de documentos em uma pasta sobrecarregarão qualquer mecanismo de mesclagem. Separe-os.
- PDFs criptografados ou com gerenciamento de direitos — Arquivos protegidos por senha são ignorados por praticamente toda ferramenta de extração. Remova a proteção antes de fazer upload.
- Documentos que exigem posicionamento pixel-perfeito — Se seu caso de uso requer saber as coordenadas X,Y exatas de cada campo, uma ferramenta de OCR zonal baseada em template pode ser mais adequada que um mecanismo de extração semântica.
Se seus arquivos se enquadram em alguma dessas categorias, a solução não é melhor depuração — é ajustar seu fluxo de trabalho para corresponder ao design da ferramenta. Isso não é uma falha da ferramenta nem do seu processo. É um sinal de que as características específicas dos seus documentos exigem uma abordagem diferente para o pipeline de extração.
Perguntas Frequentes
Por que minha ferramenta de extração não mostra um erro quando arquivos falham?
A maioria das ferramentas de extração reporta no nível do lote ("30 arquivos enviados") em vez do nível de arquivo individual. Se um arquivo falhar durante o envio sem ser registrado na fila de processamento, a ferramenta não tem registro de que ele foi destinado ao processamento. A diferença entre sua contagem mental e a contagem da ferramenta existe no limite onde a responsabilidade passa de você para o sistema. Ferramentas que fornecem acompanhamento de status por arquivo são a exceção, não a norma. Um processamento em lote por OCR que acompanha o status por arquivo é uma dessas exceções, mostrando na fila, em processamento, concluído ou falha para cada documento.
Posso recuperar dados de arquivos que foram ignorados durante o processamento em lote?
Sim, na maioria dos casos. Arquivos que falham durante o envio ou processamento geralmente permanecem intactos em sua máquina local. Execute-os pela lista de verificação pré-envio, corrija o problema identificado (conversão de formato, renomeação, divisão) e processe-os individualmente ou em um lote menor.
A ordem dos arquivos no diálogo de envio afeta quais arquivos são ignorados?
Na maioria dos sistemas, não, mas pode parecer que sim. Se você enviar 30 arquivos e a fila de processamento os processar na ordem recebida, os arquivos que chegarem mais tarde na fila têm mais probabilidade de serem afetados por timeouts acumulados. A solução é reduzir o tamanho do lote em vez de reordenar os arquivos.
Como sei se um arquivo está corrompido antes de enviá-lo?
Tente abri-lo em seu aplicativo nativo — Adobe Acrobat para PDFs, um visualizador de fotos para imagens. Se abrir sem avisos, provavelmente está intacto. Para verificação em lote, ferramentas como pdfinfo (Linux) ou a ferramenta "Preflight" do Adobe Acrobat podem verificar vários PDFs quanto à integridade estrutural. Um novo salvamento rápido de arquivos suspeitos geralmente resolve a corrupção latente.
Qual é o número máximo de arquivos que devo incluir em um único lote?
A maioria das ferramentas suporta de 30 a 50 arquivos por lote, mas a confiabilidade geralmente atinge seu pico entre 10 e 15. Lotes menores são concluídos mais rápido, facilitam o isolamento de arquivos problemáticos e reducen o impacto da limitação de concorrencia e dos tempos limite acumulados. O tamanho do lote é uma questão de equilíbrio entre confiabilidade e desempeño, não um limite de recursos.
Não Adivine — Diagnostique
Um arquivo ausente em uma extração em lote raramente é um misterio uma vez que você sabe onde procurar. Falhas de upload representam aproximadamente 60% dos casos — formatos não suportados, corrupção e problemas de nome de arquivo. Falhas de processamento — quedas de concorrencia, tempos limite, conflitos de tipos mistos — representan outros 30%. Omissions de mesclagem, o modo de falha mais silencioso, compõen os 10% restantes. Cada uma tem uma solução, e a maioria dessas soluções leva menos de um minuto para aplicar.
Os 8 arquivos que você perdeu no seu último lote quase certamente ainda estão na sua máquina, intactos e prontos para ser processados uma vez que você identifique a porta específica que não conseguiram passar. A diferença entre "a extração em lote omite arquivos" e "a extração em lote funciona de forma confiable" é saber qual porta falhou e por quê.
Execute a lista de verificação no seu próximo lote. Você ainda terá 30 arquivos entrando — mas obterá 30 filas saindo.
Sem registro necessário · Funciona com JPG, PNG e PDF