Documentos Redigidos em Lote:
O Que o OCR Lê e o Que se Perdeu
De tempos em tempos, uma comunidade de automação recebe o mesmo pedido: pegar milhares de documentos fortemente redigidos e torná-los legíveis novamente. Em um tópico no r/n8n perguntando às pessoas qual automação elas realmente precisavam, uma resposta foi direta. "Gostaria de poder enviar vários milhares de documentos altamente redigidos e fazê-los ficarem sem redação."
Nenhuma ferramenta faz isso, e o motivo merece ser dito antes de qualquer outra coisa. Uma redação feita corretamente removeu o conteúdo do arquivo. Ele não está escondido atrás da barra preta esperando para ser recuperado. Ele se foi. O que resta, no entanto, é um grande conjunto de documentos em que a maioria dos campos úteis nunca foi coberta, e extraí-los manualmente é a parte que realmente não escala.
Principais Conclusões
- Uma barra preta não diz nada sobre o que aconteceu por baixo dela — se o texto sobreviveu é uma propriedade do arquivo, não da imagem.
- O texto removido por uma redação real desapareceu do arquivo, então um modelo de IA solicitado a preenchê-lo inventará um valor plausível em vez de encontrar o verdadeiro.
- Os números de caso, datas e nomes de agências que você realmente precisa nunca foram redigidos — nomeie esses campos e extraia-os de todo o lote de uma só vez.
Nem Todas as Redações São a Mesma Operação
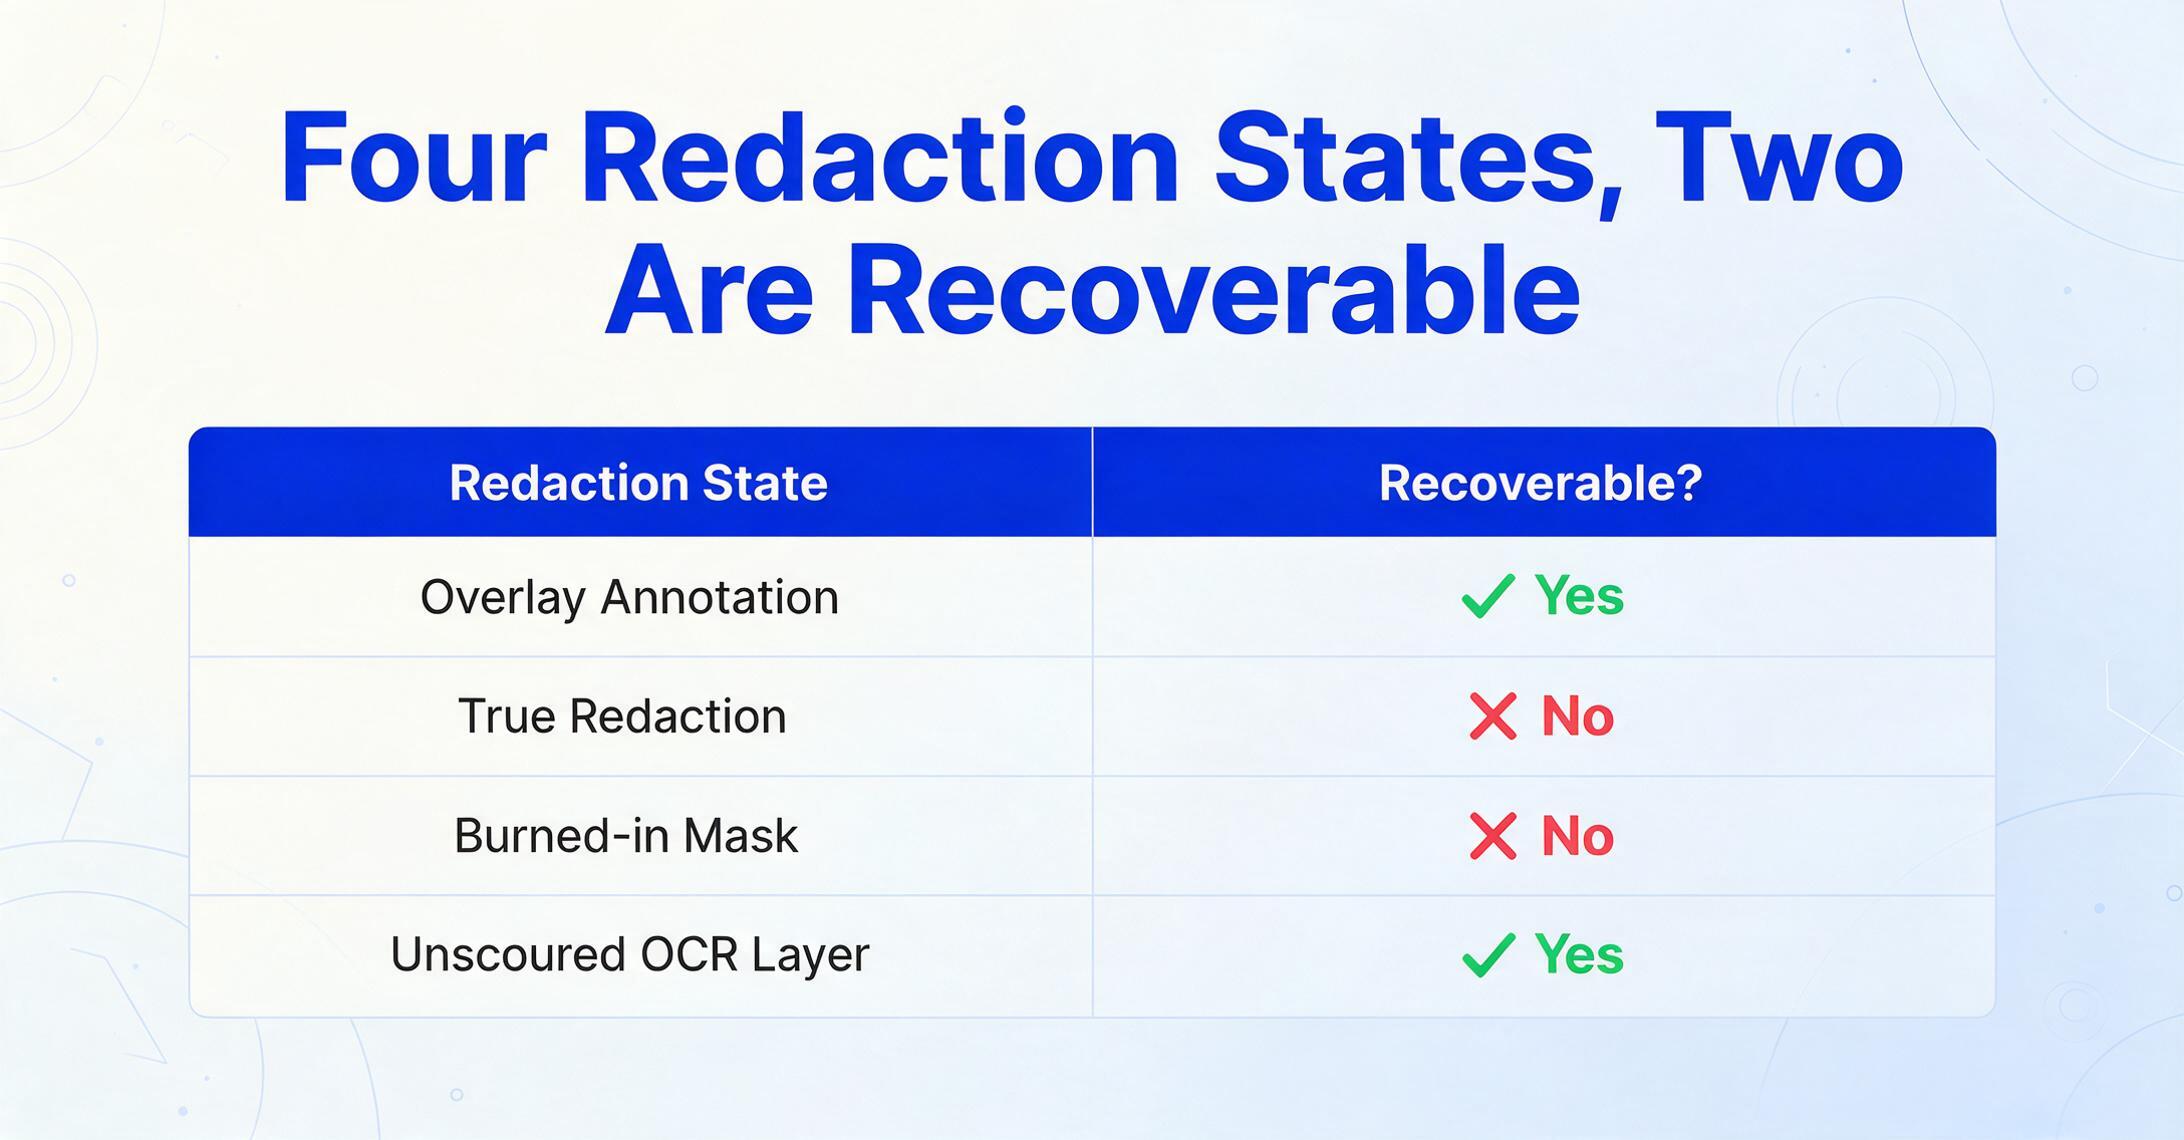
Uma barra preta quase não diz nada sobre o que aconteceu por baixo dela. "Redação" é usada como se fosse uma única ação, mas em um PDF ela produz pelo menos quatro estados físicos diferentes, e apenas alguns deles realmente removem o conteúdo. O estado que você tem em mãos decide se algo é recuperável ou não.
| O que você está vendo | Onde o conteúdo está | Recuperável? |
|---|---|---|
| Anotação de sobreposição (um retângulo preto ou marcador desenhado sobre texto ativo) | A camada de texto está intacta sob a forma | Sim. Selecione e copie, ou pesquise |
| Redação real (texto removido do fluxo de conteúdo e substituído por uma caixa) | Removido do arquivo | Não |
| Máscara incrustada (página rasterizada e os pixels sobrescritos) | Não existe camada de texto | Não |
| Camada OCR não limpa (uma caixa desenhada em uma imagem escaneada, mas o texto invisível pesquisável deixado no lugar) | Camada de texto oculta atrás da imagem | Sim. Pesquise ou extraia o texto |
| Metadados, comentários, marcadores | Propriedades do documento, não da página | Às vezes. As mesmas strings podem persistir |
A distinção não é acadêmica. A própria orientação da Adobe separa um comentário ou retângulo de marcação da ferramenta Redact, precisamente porque uma forma desenhada apenas muda o que você vê. A ferramenta Redact remove o conteúdo permanentemente, e mesmo assim apenas depois que você escolhe Apply e permite que ela limpe as informações ocultas. Quando essa segunda etapa é ignorada, o arquivo mantém uma cópia do que deveria desaparecer.
Se os dados foram removidos é uma propriedade do arquivo, não uma propriedade da imagem. A barra é apenas uma escolha de renderização.
Como Descobrir Qual Você Está Segurando em Cerca de um Minuto
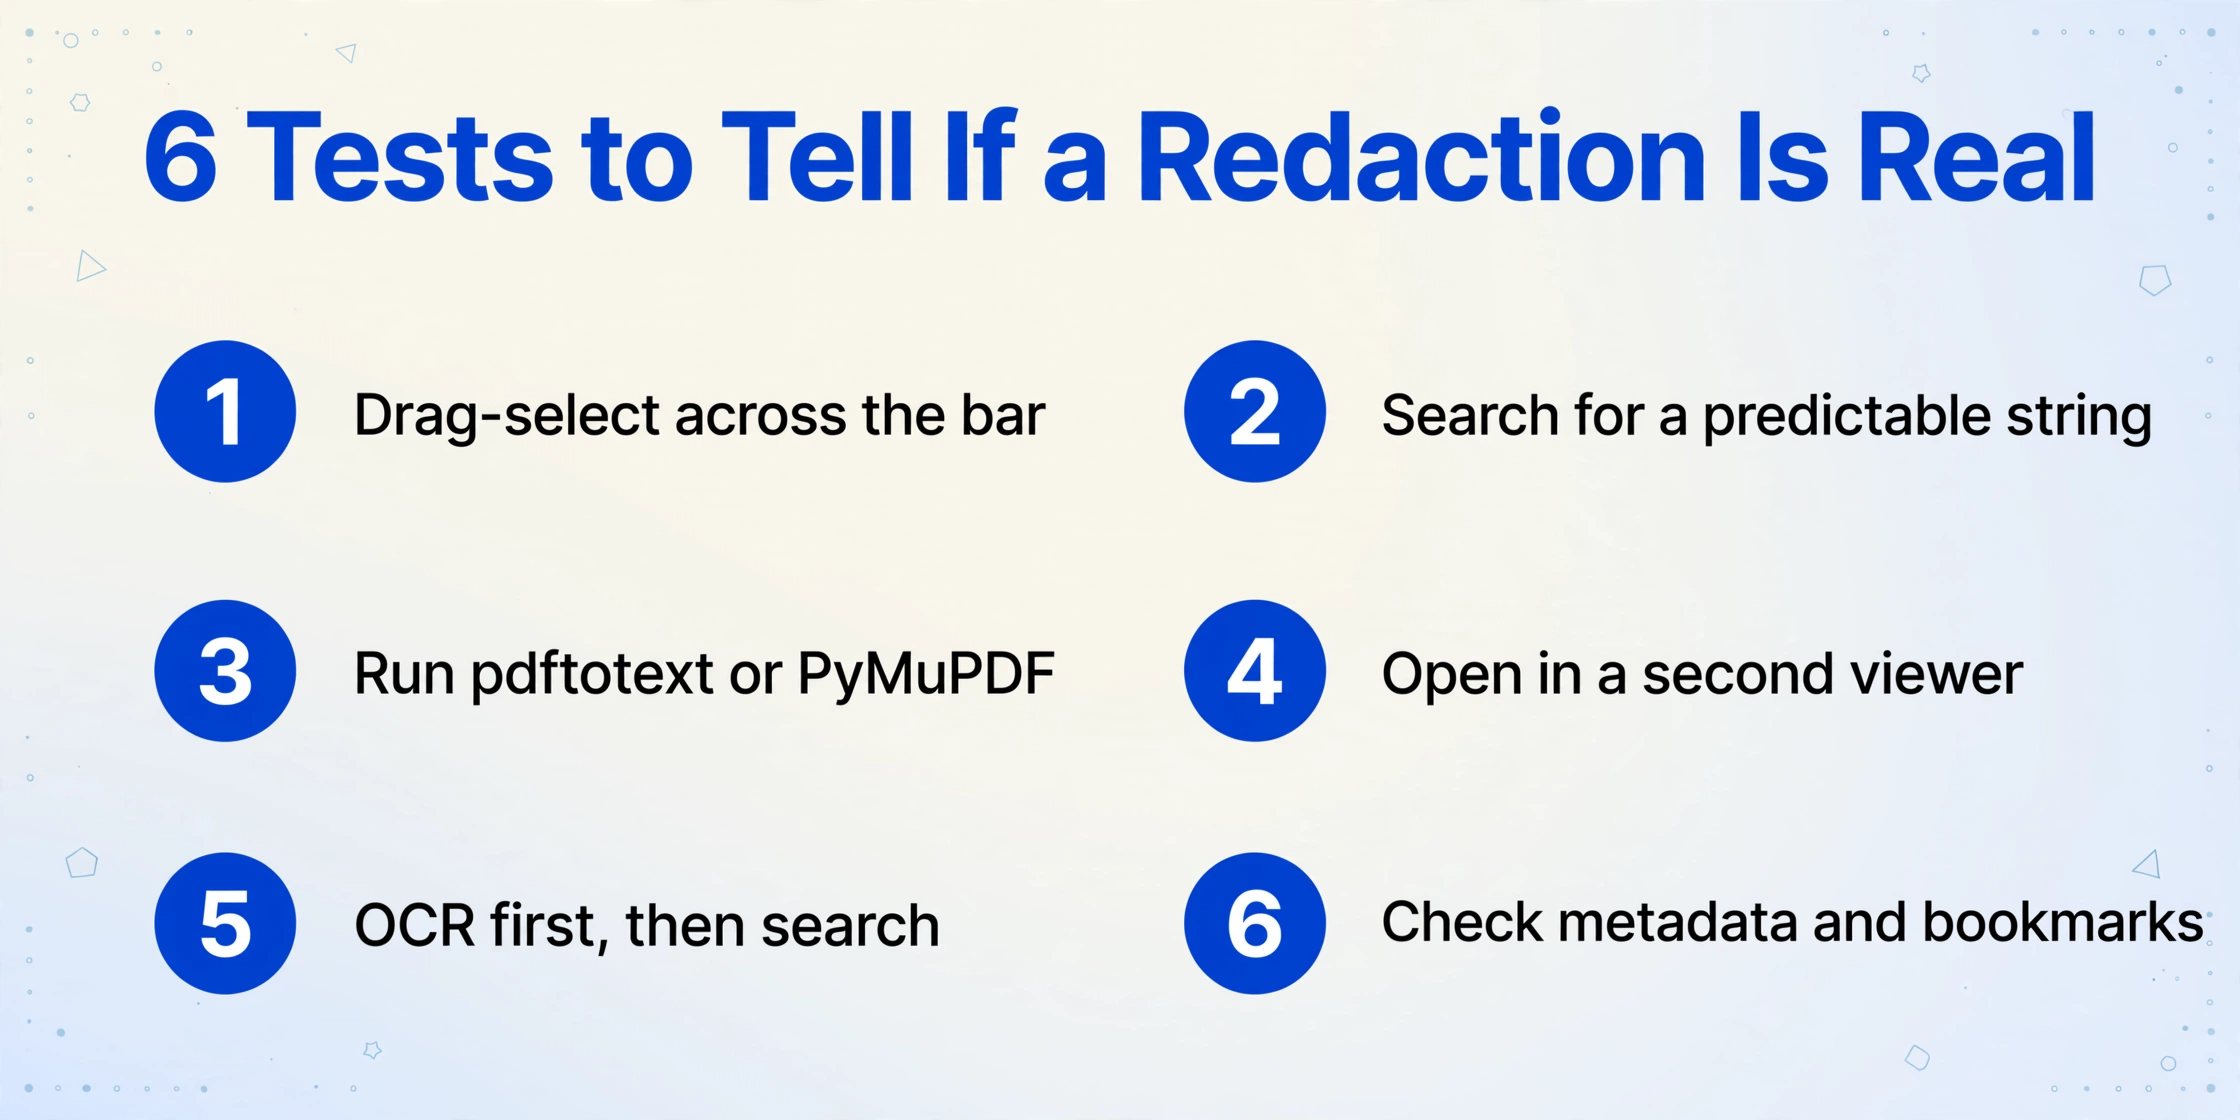
Você geralmente consegue identificar o estado de uma redação com as ferramentas que já possui. Nenhum desses testes exige software especial, e um documento que falha em vários deles não está de fato redigido.
Clique e arraste sobre a barra
Se o texto for destacado sob a caixa preta, o conteúdo ainda está lá. Copie e cole em um editor de texto simples para confirmar. Este teste simples é como jornalistas leram o arquivamento de Manafort em 2019, depois que os advogados desenharam retângulos pretos em vez de fazer a redação.
Pesquise por uma string que você pode prever
Use Localizar para um termo que possa aparecer na área coberta: um número de caso conhecido, uma sigla de agência, "Account" ou um sobrenome. Uma ocorrência de uma palavra que está visivelmente encoberta de preto significa que a camada de texto nunca foi limpa.
Execute um extrator de texto
O pdftotext das ferramentas poppler, ou uma biblioteca Python como PyMuPDF, lê o fluxo de conteúdo diretamente, em vez da tela. Como diz um comentário no r/pdf: "Você pode usar uma ferramenta como pdftotext, do poppler, para extrair texto do PDF e verificar se ainda vê o texto que deveria ter sido redigido."
Abra em um segundo visualizador
Alguns visualizadores ocultam ou removem camadas de anotação. Se as caixas pretas desaparecerem em outro aplicativo e deixarem texto legível, elas sempre foram formas.
Para digitalizações, faça OCR primeiro e depois pesquise
Uma página digitalizada é uma imagem, geralmente com uma camada de texto OCR invisível adicionada para busca. Se um produtor cobriu a imagem com uma caixa, mas deixou essa camada intacta, as palavras ainda estão no arquivo. Em um tópico no r/datacurator, um usuário enfrentou o problema inverso com o Mathpix: "ele não detecta texto barrado e, em vez disso, o retorna como imagens."
Verifique metadados, comentários e marcadores
As propriedades do documento e os comentários de revisão podem repetir exatamente as strings que foram removidas da página. Uma página limpa não garante um arquivo limpo.
Um PDF sem anotações, sem texto selecionável sob as barras e sem strings correspondentes nos metadados é o resultado saudável. É assim que se parece uma redação correta.
Uma ressalva sobre a intenção: essas verificações existem para que a pessoa que produz um documento possa verificar o próprio trabalho. Se você receber um documento cuja redação falhou, a resposta de responsabilidade profissional é notificar o remetente, não coletar o conteúdo exposto. As duas ações são tecnicamente idênticas e completamente diferentes em todos os outros aspectos. Se o texto que você extrai sair embaralhado em vez de ausente, isso é um modo de falha separado: um mapa de fontes quebrado ou um mapeamento de caracteres com falha, que é abordado em por que o OCR produz texto ilegível.
Até uma Redação de Aparência Limpa Pode Vazar
Remover o texto não torna automaticamente um documento à prova de falhas, porque um PDF carrega mais do que os caracteres que você pode ver. Um estudo de segurança de 2023 da Universidade de Illinois, publicado na PETS, descobriu que os glifos restantes ao redor de uma caixa de redação ainda codificam informações. Deslocamentos horizontais de subpixel nos caracteres de cada lado revelam a largura do que foi removido, o que muitas vezes é suficiente para recuperar nomes e sobrenomes.
A equipe testou onze ferramentas populares de redação e localizou 778 redações vulneráveis de "excisão" em corpora de documentos da FOIA, do Inspetor-Geral e de documentos desclassificados, além de mais de 700 documentos judiciais públicos em que o texto nunca havia sido removido em primeiro lugar. Duas ferramentas online amplamente usadas, PDFescape Online e PDFzorro, deixaram o texto supostamente oculto totalmente acessível. O artigo está disponível em arXiv:2206.02285.
O arquivamento de Manafort é o caso que a maioria das pessoas lembra. Retângulos pretos foram desenhados com ferramentas de marcação em vez da função de redação, e repórteres selecionaram as barras, copiaram e colaram o texto em um novo documento, expondo detalhes que o arquivamento pretendia ocultar (WIRED, 2019). Fechar essas lacunas é trabalho do produtor. Para quem está no lado do recebimento, a lição prática é mais restrita: não presuma que uma barra significa que o texto se foi, e não construa um fluxo de trabalho que dependa de ele estar lá.
O que o OCR Realmente Retorna Sobre uma Barra Preta
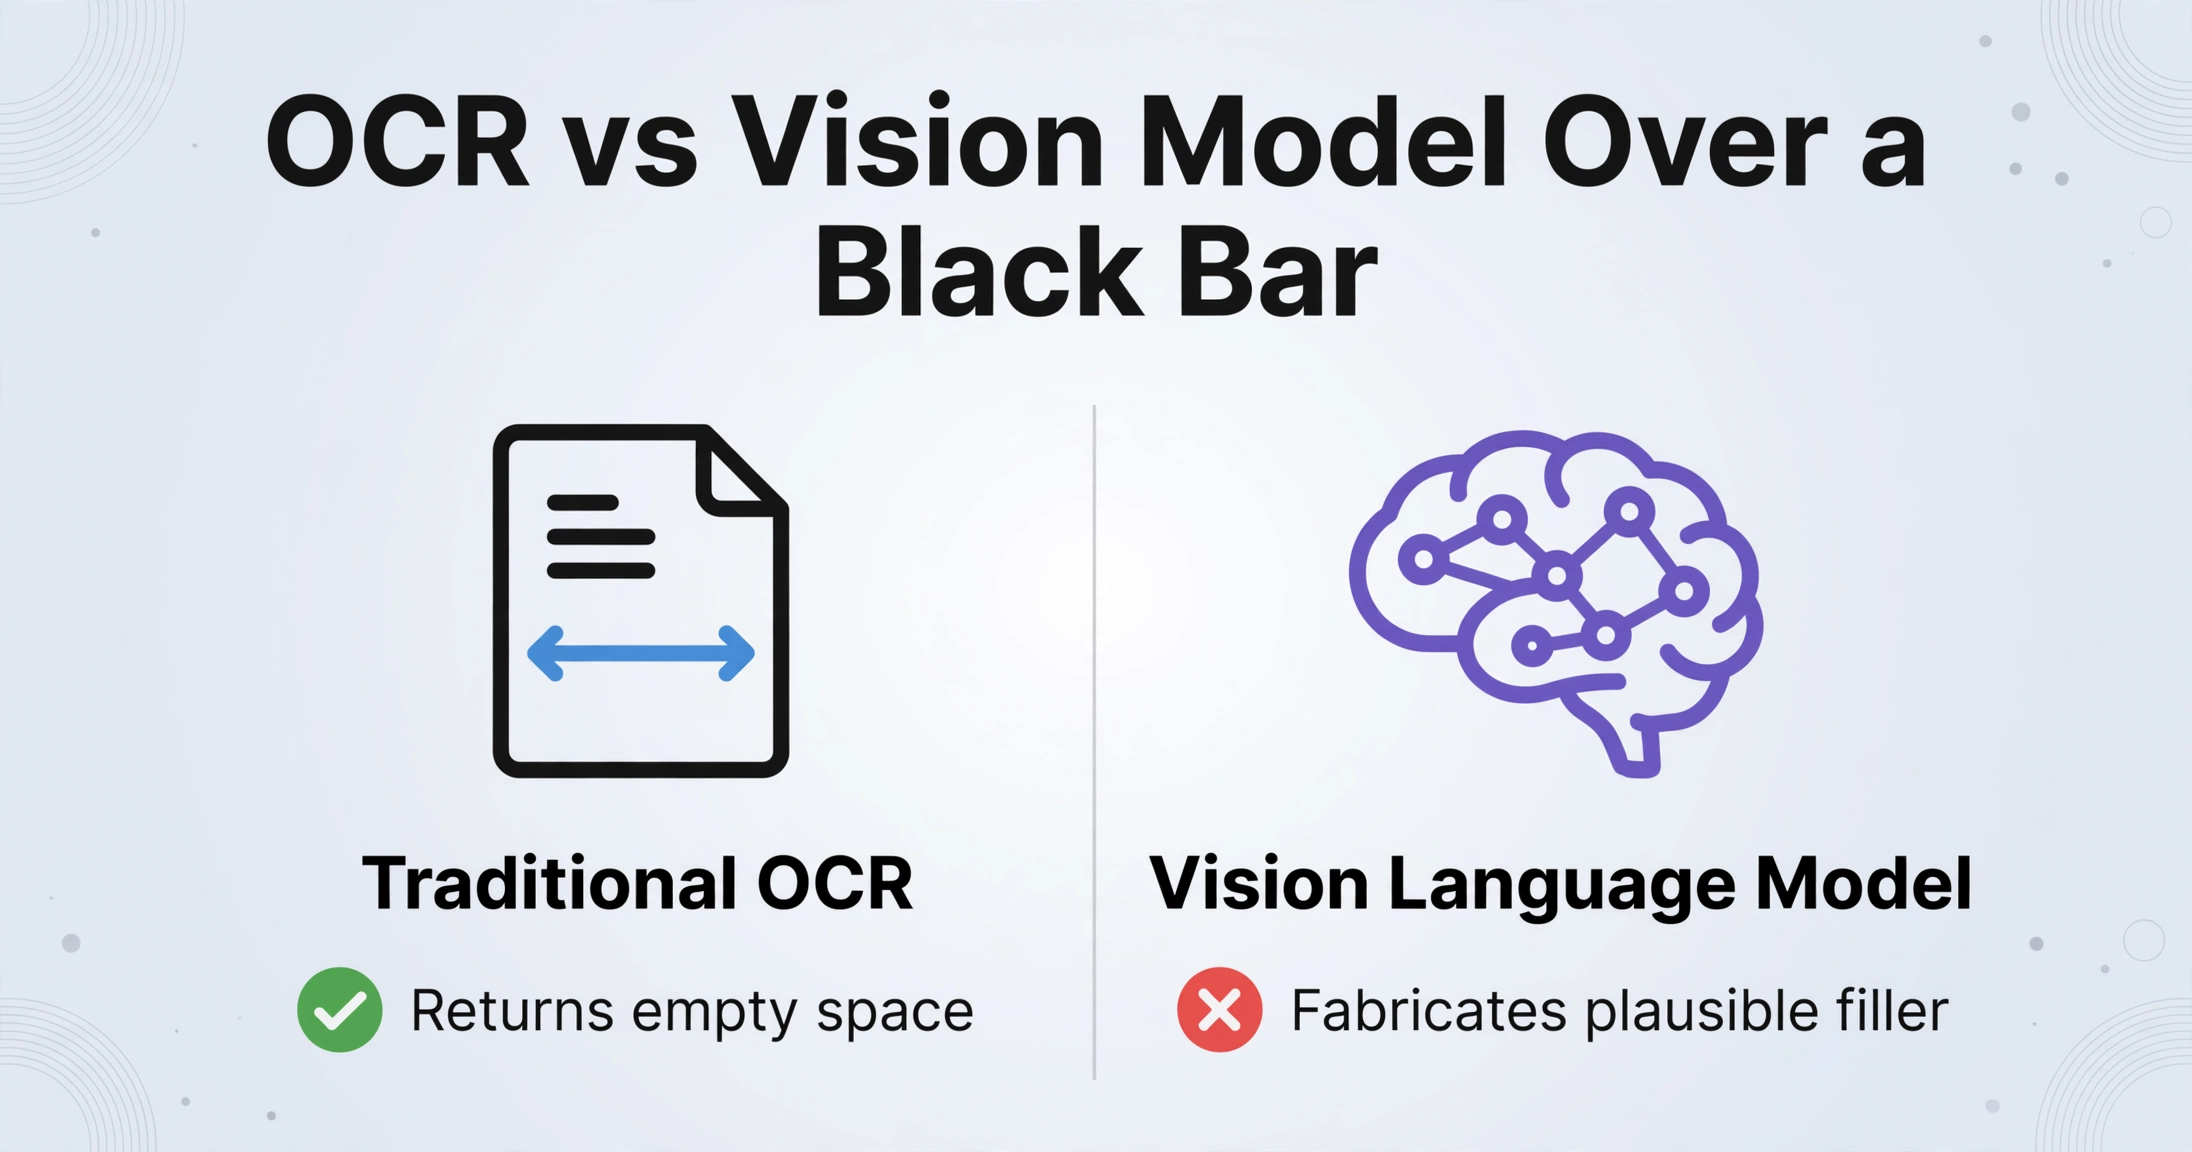
Aponte um mecanismo de OCR para um retângulo preto sólido e a saída correta é nada. O OCR tradicional, como o Tesseract ou um serviço de OCR em nuvem, lê pixels, e pixels pretos não contêm caracteres. Ele retorna espaço vazio, que é exatamente o que você quer. Os limites das ferramentas de OCR de código aberto são bem documentados, e lidar com texto ausente não é uma de suas fraquezas.
Um modelo de linguagem visual, a classe de modelo por trás da extração moderna de dados, é mais capaz e mais perigoso neste ponto específico. Ao ser solicitado a "extrair todo o texto" de uma página que não consegue ler completamente, um modelo capaz pode produzir um preenchimento plausível para a lacuna. Essa saída é fabricada, não recuperada, e é o único modo de falha contra o qual se deve projetar.
Um modelo que preenche uma célula redigida com um palpite confiante é pior do que um que a deixa em branco, porque o palpite parece dado.
A solução é restringir a tarefa. Nomeie os campos que você quer e deixe a ferramenta relatar apenas o que ela consegue ler. Não peça "tudo na página" e nunca pergunte a um modelo o que está atrás de uma barra. Vale a pena entender a mecânica de ler uma página digitalizada: a extração aqui funciona sobre pixels renderizados, e não sobre uma camada de texto, que é o mesmo motivo pelo qual a IA consegue extrair dados de PDFs digitalizados que derrotam um leitor de PDF comum.
A Metade que Escala: Extraindo os Campos Visíveis de um Lote
A pergunta útil não é como ler atrás das barras, é quanto do que está na frente delas você consegue extrair sem ler manualmente. Isso importa porque as divulgações chegam em volume. As agências federais receberam um recorde de 1.501.432 pedidos de FOIA no ano fiscal de 2024, um aumento de 25 por cento em relação ao ano anterior, e o pedido simples médio levou 44 dias para ser respondido, acima dos 39 (Escritório de Política de Informação do DOJ, AF2024). Uma única produção pode chegar a centenas ou milhares de páginas, e os campos que você realmente precisa para um índice ou uma estatística tendem a ser os simples: data do documento, agência, número do caso, número do anexo, a isenção citada, um valor que nunca foi sensível o suficiente para ser coberto. Ler cada página para coletá-los é o gargalo, e não é um problema de redação.
A redação neste material não é opcional. A FOIA (5 U.S.C. § 552) permite que uma agência retenha conteúdo isento, e os arquivamentos em tribunais federais devem redigir parcialmente identificadores como números de Seguro Social, datas de nascimento, números de contas financeiras e nomes de menores de acordo com a FRCP 5.2, com a contraparte criminal na Regra 49.1. As barras não vão desaparecer, e o volume de páginas ao redor delas também não.
É aqui que a extração em massa mostra seu valor. A Extração de Colunas Personalizadas começa pelo que você quer, e não pelo que a página oferece. Você digita os nomes das colunas, como Agência, Data do Documento, Número do Caso ou Exceção Citada, e o modelo localiza cada valor pelo significado em todas as páginas e layouts. Um campo que foi redigido não tem nada para ler, então ele volta em branco em vez de ser preenchido com uma suposição. O espaço em branco é o recurso. Ele mantém a planilha honesta e torna um valor ausente visível entre milhares de linhas.
O Processamento Prioritário em Lote lida com o volume. Você envia a liberação inteira de uma vez, em vez de um arquivo por vez, e os resultados são mesclados em uma única planilha com uma linha por página ou documento. Isso produz um índice classificável e filtrável das partes legíveis da liberação, que é o que a maioria das pessoas realmente procura quando busca por um fluxo de trabalho de OCR em lote. Material governamental tem suas próprias limitações além da própria redação, e as compensações envolvendo formulários de cidadãos, conjuntos de FOIA e arquivos legados estão descritas em extração de documentos para agências governamentais.
O Que Nenhuma Ferramenta Pode Fazer
Nenhuma ferramenta recupera texto removido no nível do arquivo, e qualquer produto que afirme o contrário está apenas adivinhando. O limite vale a pena ser declarado sem rodeios:
- Conteúdo removido ou incrustado é irrecuperável. Se os caracteres não estão nem no fluxo de conteúdo nem nos pixels, nada os reconstrói. A pesquisa sobre espaçamento de glifos recupera comprimentos e candidatos plausíveis a partir de artefatos de layout, não o texto em si, e é uma técnica de ataque, não um fluxo de trabalho.
- Uma caixa branca é o mesmo problema, menos visível. Um retângulo branco sobre texto preto ainda é uma sobreposição se o texto embaixo nunca foi removido. O teste é idêntico.
- Uma digitalização achatada é apenas uma imagem. Imprimir, marcar fisicamente e redigitalizar produz uma página sem camada de texto. O OCR lê o que permanece visível, com a precisão que a digitalização permite, que é a faixa descrita no guia geral de precisão de extração de documentos.
- Em branco é uma resposta válida. Se um campo foi redigido, a saída correta é vazia. Espere uma mistura de células preenchidas e vazias, e projete o fluxo de trabalho em torno disso em vez de lutar contra.
Há também uma linha que não é técnica. Usar uma redação falha para ler conteúdo que você não deveria ter pode violar regras de confidencialidade e conduta profissional, o que é um problema de ordem diferente de um erro de OCR.
FAQ
O OCR consegue ler texto oculto por barras pretas?
Somente quando o texto ainda está no arquivo, e nesse caso não é o OCR que o encontra. Se a redação removeu o conteúdo, o OCR vê pixels pretos e não retorna nada. Se foi uma anotação de sobreposição, as palavras estão na camada de texto, e copiar e colar, buscar ou um extrator de texto as revelará.
A IA consegue desfazer a redação de um PDF?
Não. Um modelo que recebe a tarefa de preencher uma região redigida produzirá texto plausível, não o original, e não há forma de distinguir os dois apenas pela saída. Trate qualquer resultado desse tipo como fabricado.
Como extraigo apenas as partes visíveis de um PDF redigido?
Nomee os campos que deseja e processe todo o conjunto em um único lote. Os valores presentes na página são extraídos, e os campos redigidos voltam em branco. Isso mantiene o resultado utilizável sem fingir que o conteúdo oculto foi lido.
É legal recuperar texto de um documento redigido?
Depende de como você o obteve e do que faz com ele. Uma redação falha não torna o conteúdo público, e usá-lo pode criar problemas de confidencialidade e de conduta profissional. Verifique os documentos que você produz; não extraiga conteúdo de documentos que você recebeu.
O OCR ainda funciona em um documento digitalizado com redações?
Sim. O OCR lê o texto visível ao redor das barras da mesma forma que lê qualquer outra digitalização, e as regiões redigidas não contêm nada a reconhecer. Uma página digitalizada com uma camada OCR não limpa é o caso raro em que o próprio texto coberto ainda é pesquisable.
O valor em uma divulgação redigida não está atrás das barras. Está nos números de caso, datas e nomes de agências visíveis na mesma página, e essa é a parte que vale a pena automatizar. Teste qualquer fluxo de trabalho que você cree contra um padrão: se ele preenche um campo redigido com um valor confiante em vez de deixá-lo em branco, deixou de extraer e começou a adivinar.