Documents caviardés en masse :
Ce que l'OCR lit, et ce qui est perdu
De temps en temps, une communauté d'automatisation reçoit la même demande : prendre des milliers de documents fortement caviardés et les rendre à nouveau lisibles. Dans un fil r/n8n demandant aux gens quelle automatisation ils souhaitaient vraiment, une réponse était directe : « J'aimerais pouvoir télécharger plusieurs milliers de documents fortement caviardés et les faire décaviarder. »
Aucun outil ne fait cela, et la raison mérite d'être énoncée avant toute chose. Un caviardage correctement effectué a supprimé le contenu du fichier. Il ne se cache pas derrière la barre noire en attendant d'être récupéré. Il est perdu. Ce qui reste, en revanche, c'est un grand ensemble de documents où la plupart des champs utiles n'ont jamais été masqués, et les extraire à la main est ce qui ne passe vraiment pas à l'échelle.
Points clés à retenir
- Une barre noire ne vous dit rien sur ce qui se trouve en dessous — la survie du texte est une propriété du fichier, pas de l'image.
- Le texte supprimé par un caviardage réel est absent du fichier ; un modèle d'IA invité à le combler inventera donc une valeur plausible au lieu de trouver la vraie.
- Les numéros de dossier, dates et noms d'agences dont vous avez réellement besoin n'ont jamais été caviardés — nommez ces champs et extrayez-les de l'ensemble de la publication en un seul lot.
Toutes les caviardages ne sont pas la même opération
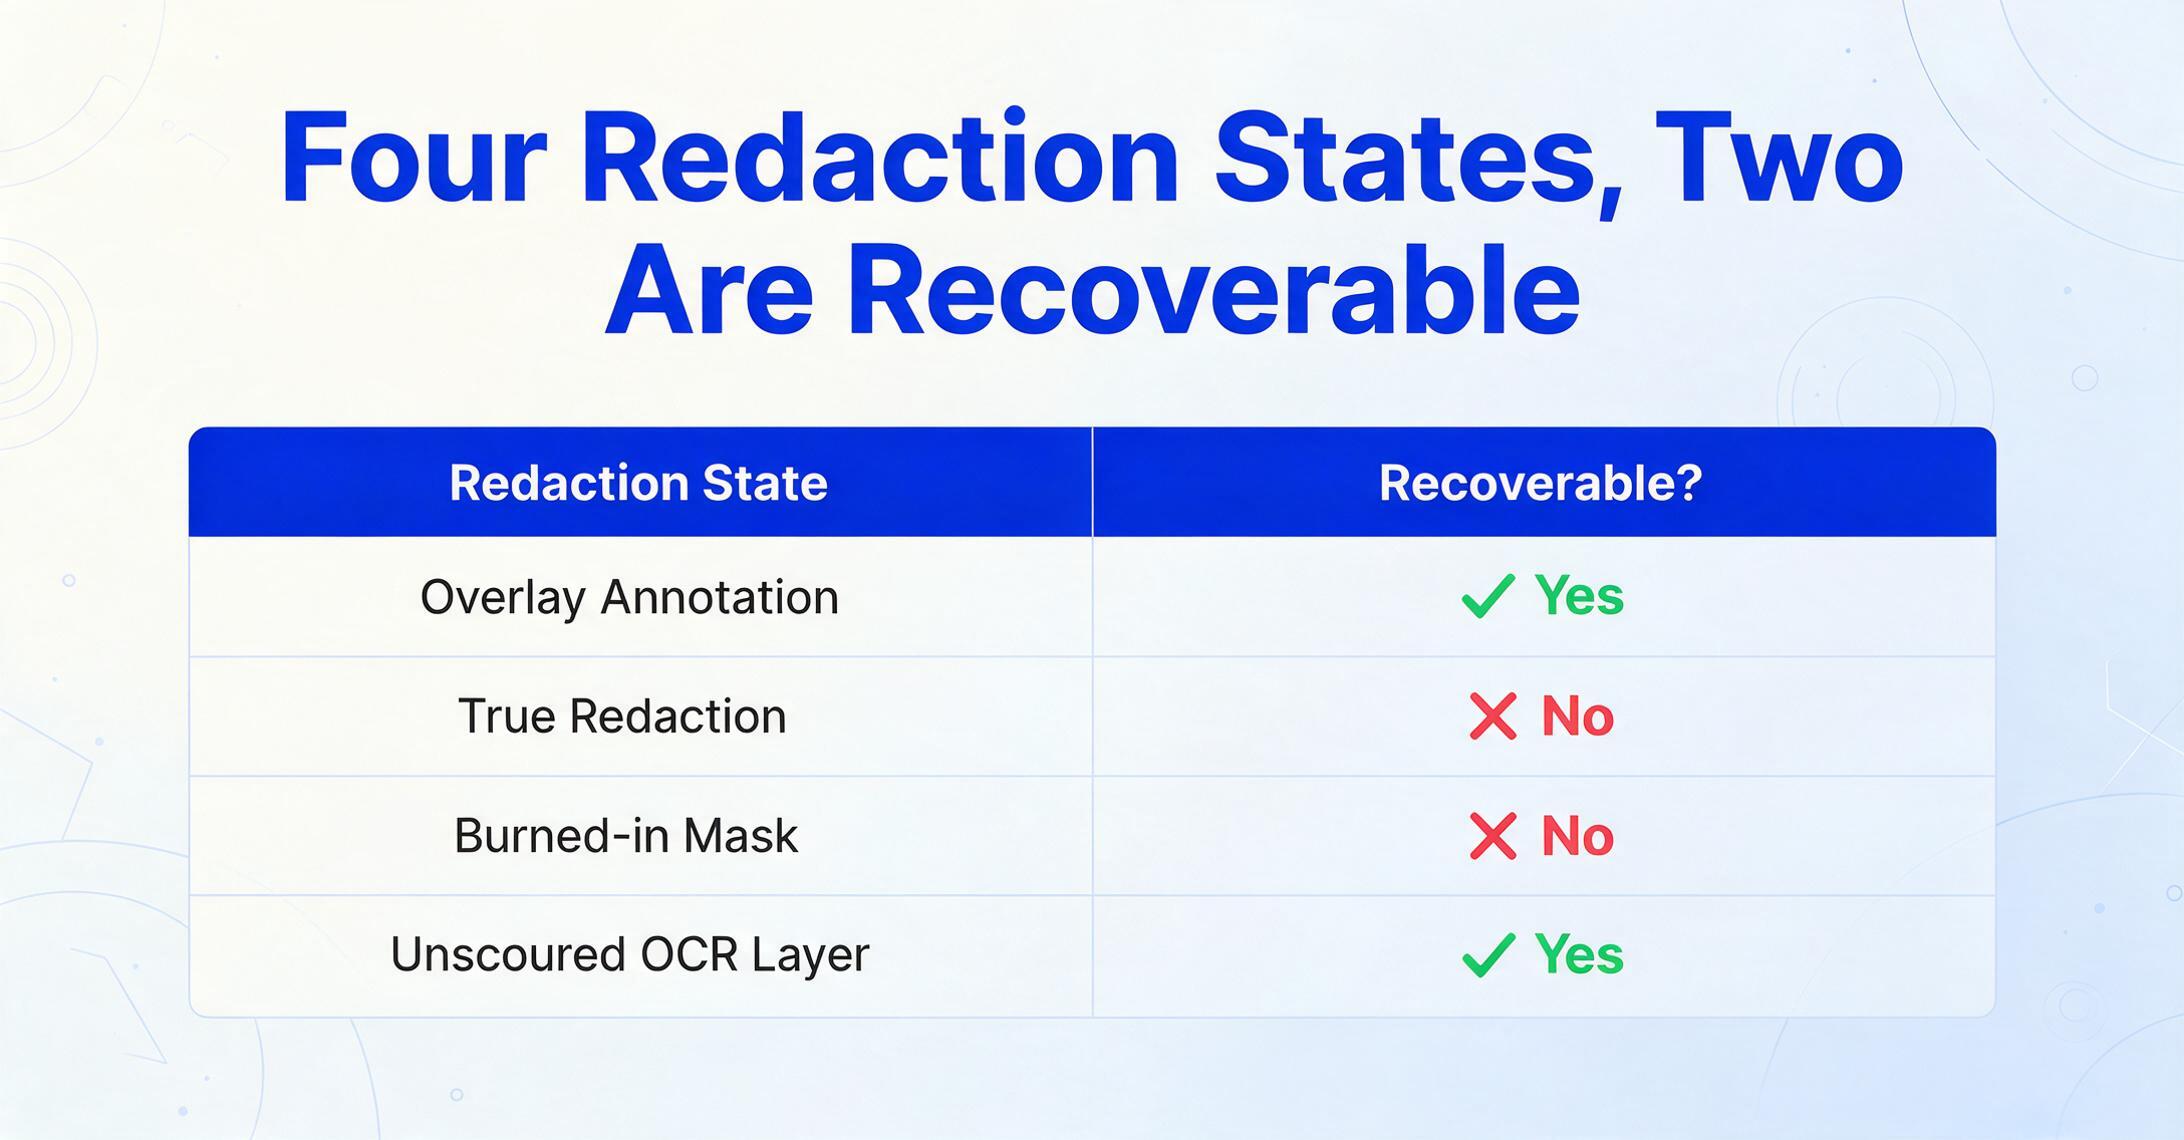
Une barre noire ne vous dit presque rien sur ce qui se trouve en dessous. Le terme « caviardage » est utilisé comme s'il s'agissait d'une seule action, mais dans un PDF, il produit au moins quatre états physiques différents, et seuls certains d'entre eux suppriment réellement le contenu. L'état que vous avez entre les mains détermine si quoi que ce soit est récupérable.
| Ce que vous voyez | Où se trouve le contenu | Récupérable ? |
|---|---|---|
| Annotation de superposition (un rectangle noir ou un surligneur dessiné par-dessus du texte en direct) | La couche de texte est intacte sous la forme | Oui. Sélectionner et copier, ou rechercher |
| Caviardage réel (texte excisé du flux de contenu et remplacé par une boîte) | Supprimé du fichier | Non |
| Masque incrusté (page pixellisée et pixels écrasés) | Aucune couche de texte n'existe | Non |
| Couche OCR non purgée (une boîte dessinée sur une image scannée, mais le texte invisible et recherchable laissé en place) | Couche de texte cachée derrière l'image | Oui. Rechercher ou extraire le texte |
| Métadonnées, commentaires, signets | Propriétés du document, pas la page | Parfois. Les mêmes chaînes peuvent persister |
La distinction n'est pas théorique. Les propres recommandations d'Adobe séparent un commentaire ou un rectangle de marquage de son outil Redact, précisément parce qu'une forme dessinée ne change que ce que vous voyez. L'outil Redact supprime le contenu définitivement, et encore seulement après avoir choisi Appliquer et laissé l'outil assainir les informations cachées. Lorsque cette deuxième étape est ignorée, le fichier conserve une copie de ce qui était censé disparaître.
Que les données soient supprimées est une propriété du fichier, pas une propriété de l'image. La barre n'est qu'un choix de rendu.
Comment savoir lequel vous tenez, en environ une minute
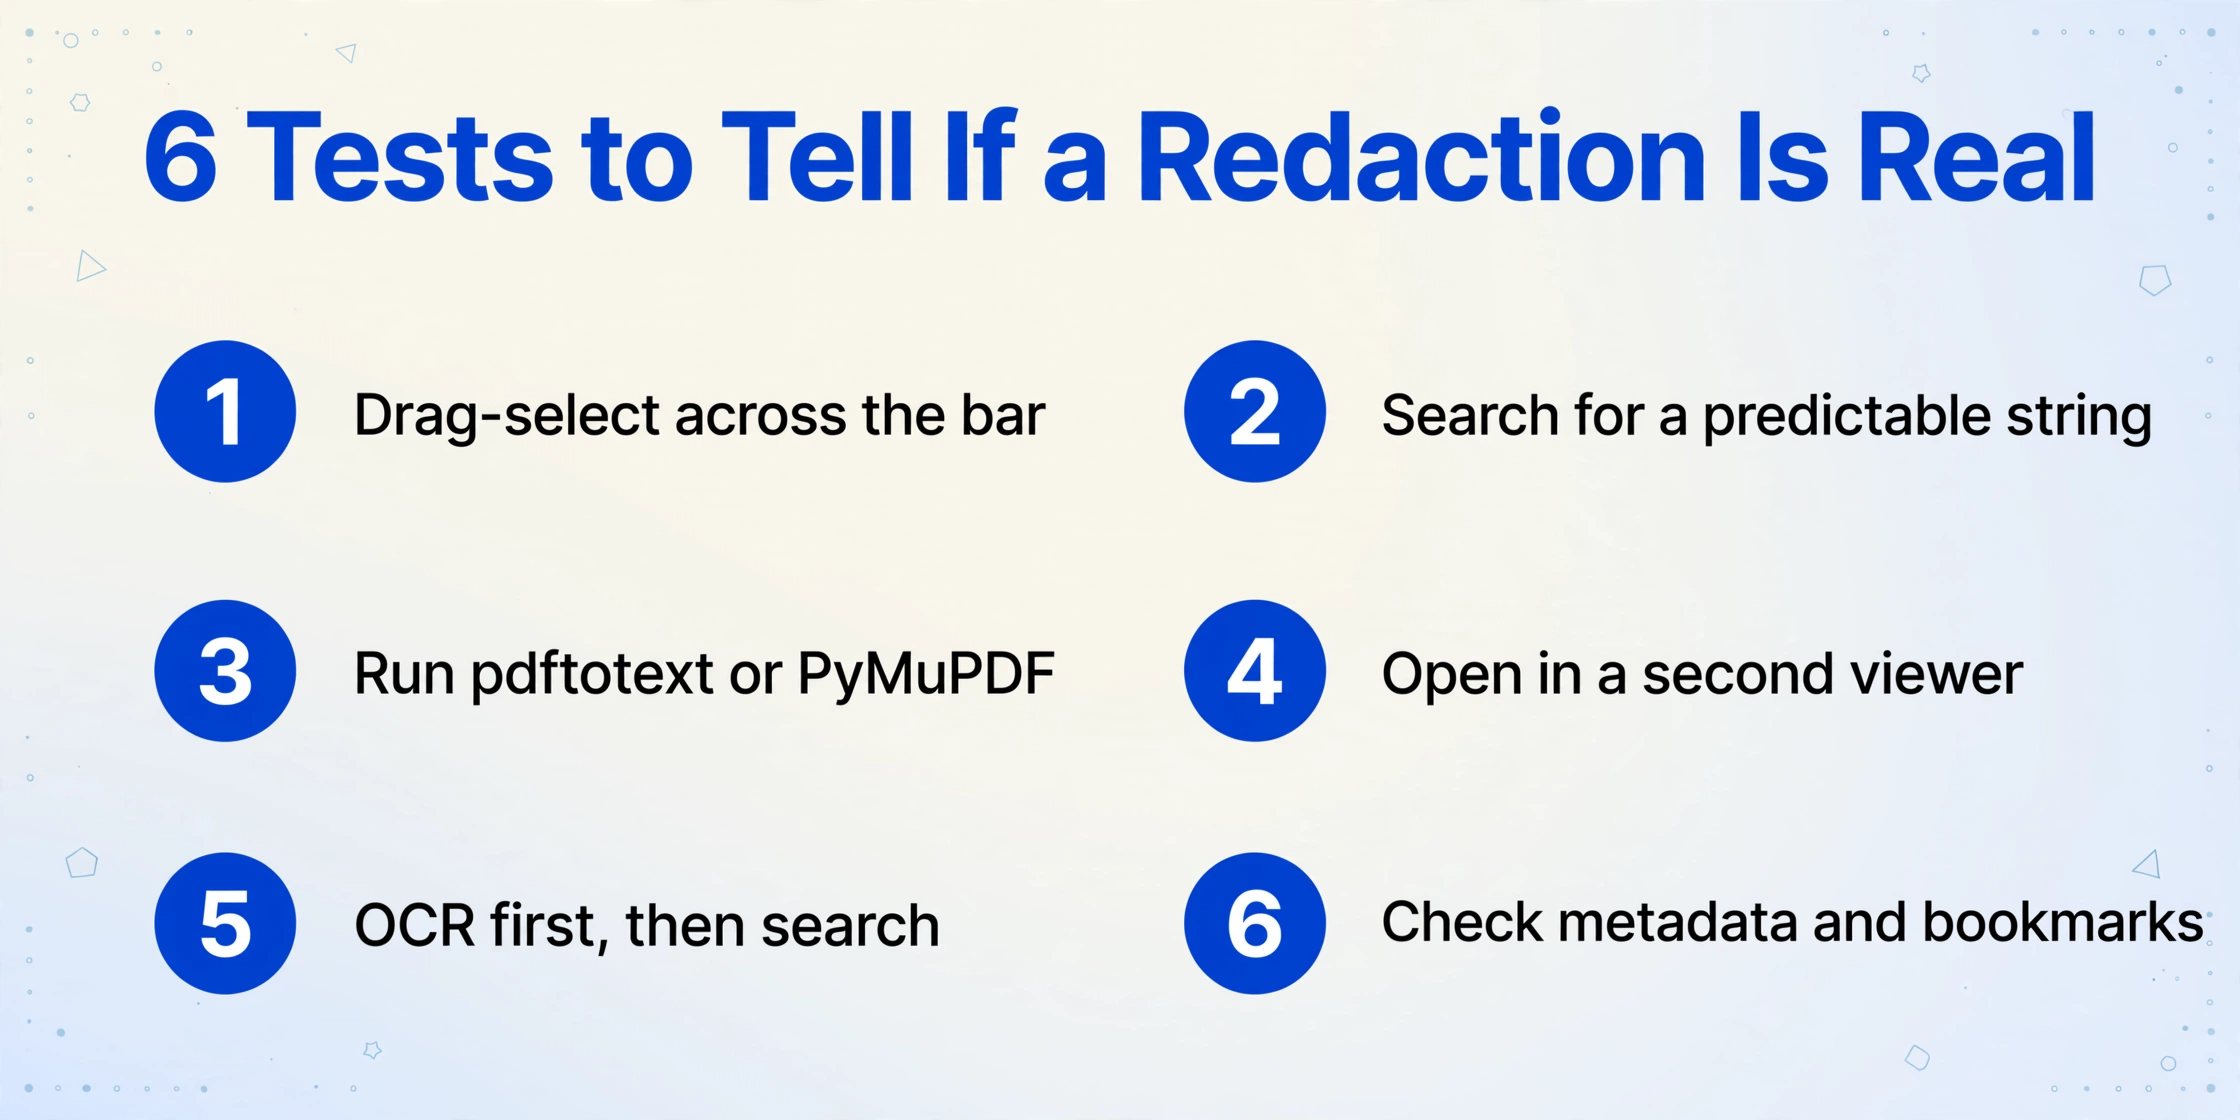
Vous pouvez généralement identifier l'état d'un caviardage avec les outils dont vous disposez déjà. Aucun de ces tests ne nécessite de logiciel spécial, et un document qui échoue à plusieurs d'entre eux n'est pas réellement caviardé.
Cliquez et faites glisser sur la barre
Si le texte apparaît en surbrillance sous la barre noire, le contenu est toujours là. Copiez-le et collez-le dans un éditeur de texte brut pour le confirmer. C'est ce test unique qui a permis aux journalistes de lire le dossier Manafort en 2019 après que les avocats eurent dessiné des rectangles noirs au lieu de procéder à un caviardage.
Recherchez une chaîne que vous pouvez prédire
Utilisez la fonction Rechercher pour un terme qui apparaîtrait plausiblement dans la zone couverte : un numéro de dossier connu, un acronyme d'agence, « Account » ou un nom de famille. Un résultat sur un mot visiblement masqué signifie que la couche de texte n'a jamais été purgée.
Exécutez un extracteur de texte
pdftotext des outils poppler, ou une bibliothèque Python telle que PyMuPDF, lit le flux de contenu directement plutôt que l'écran. Comme le dit un commentaire r/pdf, « Vous pouvez utiliser un outil comme pdftotext de poppler pour extraire le texte d'un PDF et vérifier si vous voyez encore le texte qui devrait être caviardé. »
Ouvrez-le dans un deuxième visualiseur
Certains visualiseurs masquent ou suppriment les couches d'annotation. Si les barres noires disparaissent dans une autre application et laissent un texte lisible, c'étaient des formes depuis le début.
Pour les scans, OCR d'abord, puis recherche
Une page scannée est une image, souvent avec une couche OCR invisible ajoutée pour la recherche. Si un producteur a couvert l'image avec une boîte mais a laissé cette couche intacte, les mots sont toujours dans le fichier. Dans un fil r/datacurator, un utilisateur a rencontré le problème inverse avec Mathpix : « il ne détecte pas le texte barré et le renvoie plutôt comme des images. »
Vérifiez les métadonnées, les commentaires et les signets
Les propriétés du document et les commentaires de révision peuvent répéter les chaînes mêmes qui ont été supprimées de la page. Une page propre ne garantit pas un fichier propre.
Un PDF sans annotations, sans texte sélectionnable sous les barres et sans chaînes correspondantes dans ses métadonnées est le résultat sain. Voilà à quoi ressemble un caviardage correct.
Une réserve sur l'intention : ces vérifications existent pour que la personne qui produit un document puisse vérifier son propre travail. Si vous recevez un document dont le caviardage a échoué, la réponse professionnelle consiste à avertir l'expéditeur, et non à exploiter le contenu exposé. Les deux actions sont techniquement identiques et complètement différentes à tous les autres égards. Si le texte que vous extrayez sort brouillé plutôt qu'absent, il s'agit d'un mode de défaillance distinct : une table de polices cassée ou un mappage de caractères défaillant, ce qui est traité dans pourquoi l'OCR produit un texte brouillé.
Même un caviardage d'apparence propre peut fuiter
Supprimer le texte ne rend pas automatiquement un document étanche, car un PDF contient plus que les caractères visibles. Une étude de sécurité de 2023 de l'Université de l'Illinois, publiée à PETS, a constaté que les glyphes résiduels entourant une barre de caviardage encodent encore des informations. Les décalages horizontaux de sous-pixels dans les caractères de chaque côté révèlent la largeur de ce qui a été supprimé, ce qui suffit souvent à retrouver les prénoms et noms.
L'équipe a testé onze outils de caviardage populaires et a localisé 778 caviardages « excisants » vulnérables dans des corpus de documents FOIA, d'inspecteurs généraux et déclassifiés, ainsi que plus de 700 documents judiciaires publics où le texte n'avait jamais été supprimé en premier lieu. Deux outils en ligne largement utilisés, PDFescape Online et PDFzorro, laissaient le texte prétendument masqué entièrement accessible. L'article est disponible sur arXiv:2206.02285.
Le dossier Manafort est le cas dont la plupart des gens se souviennent. Des rectangles noirs ont été dessinés avec des outils d'annotation plutôt qu'avec la fonction de caviardage, et des journalistes ont sélectionné les barres, copié et collé le texte dans un nouveau document, exposant des détails que le dossier entendait dissimuler (WIRED, 2019). Combler ces lacunes relève de la responsabilité du producteur. Pour toute personne du côté récepteur, la leçon pratique est plus étroite : ne supposez pas qu'une barre signifie que le texte a disparu, et ne construisez pas un flux de travail qui dépend de sa présence.
Ce que l'OCR renvoie réellement au-dessus d'une barre noire
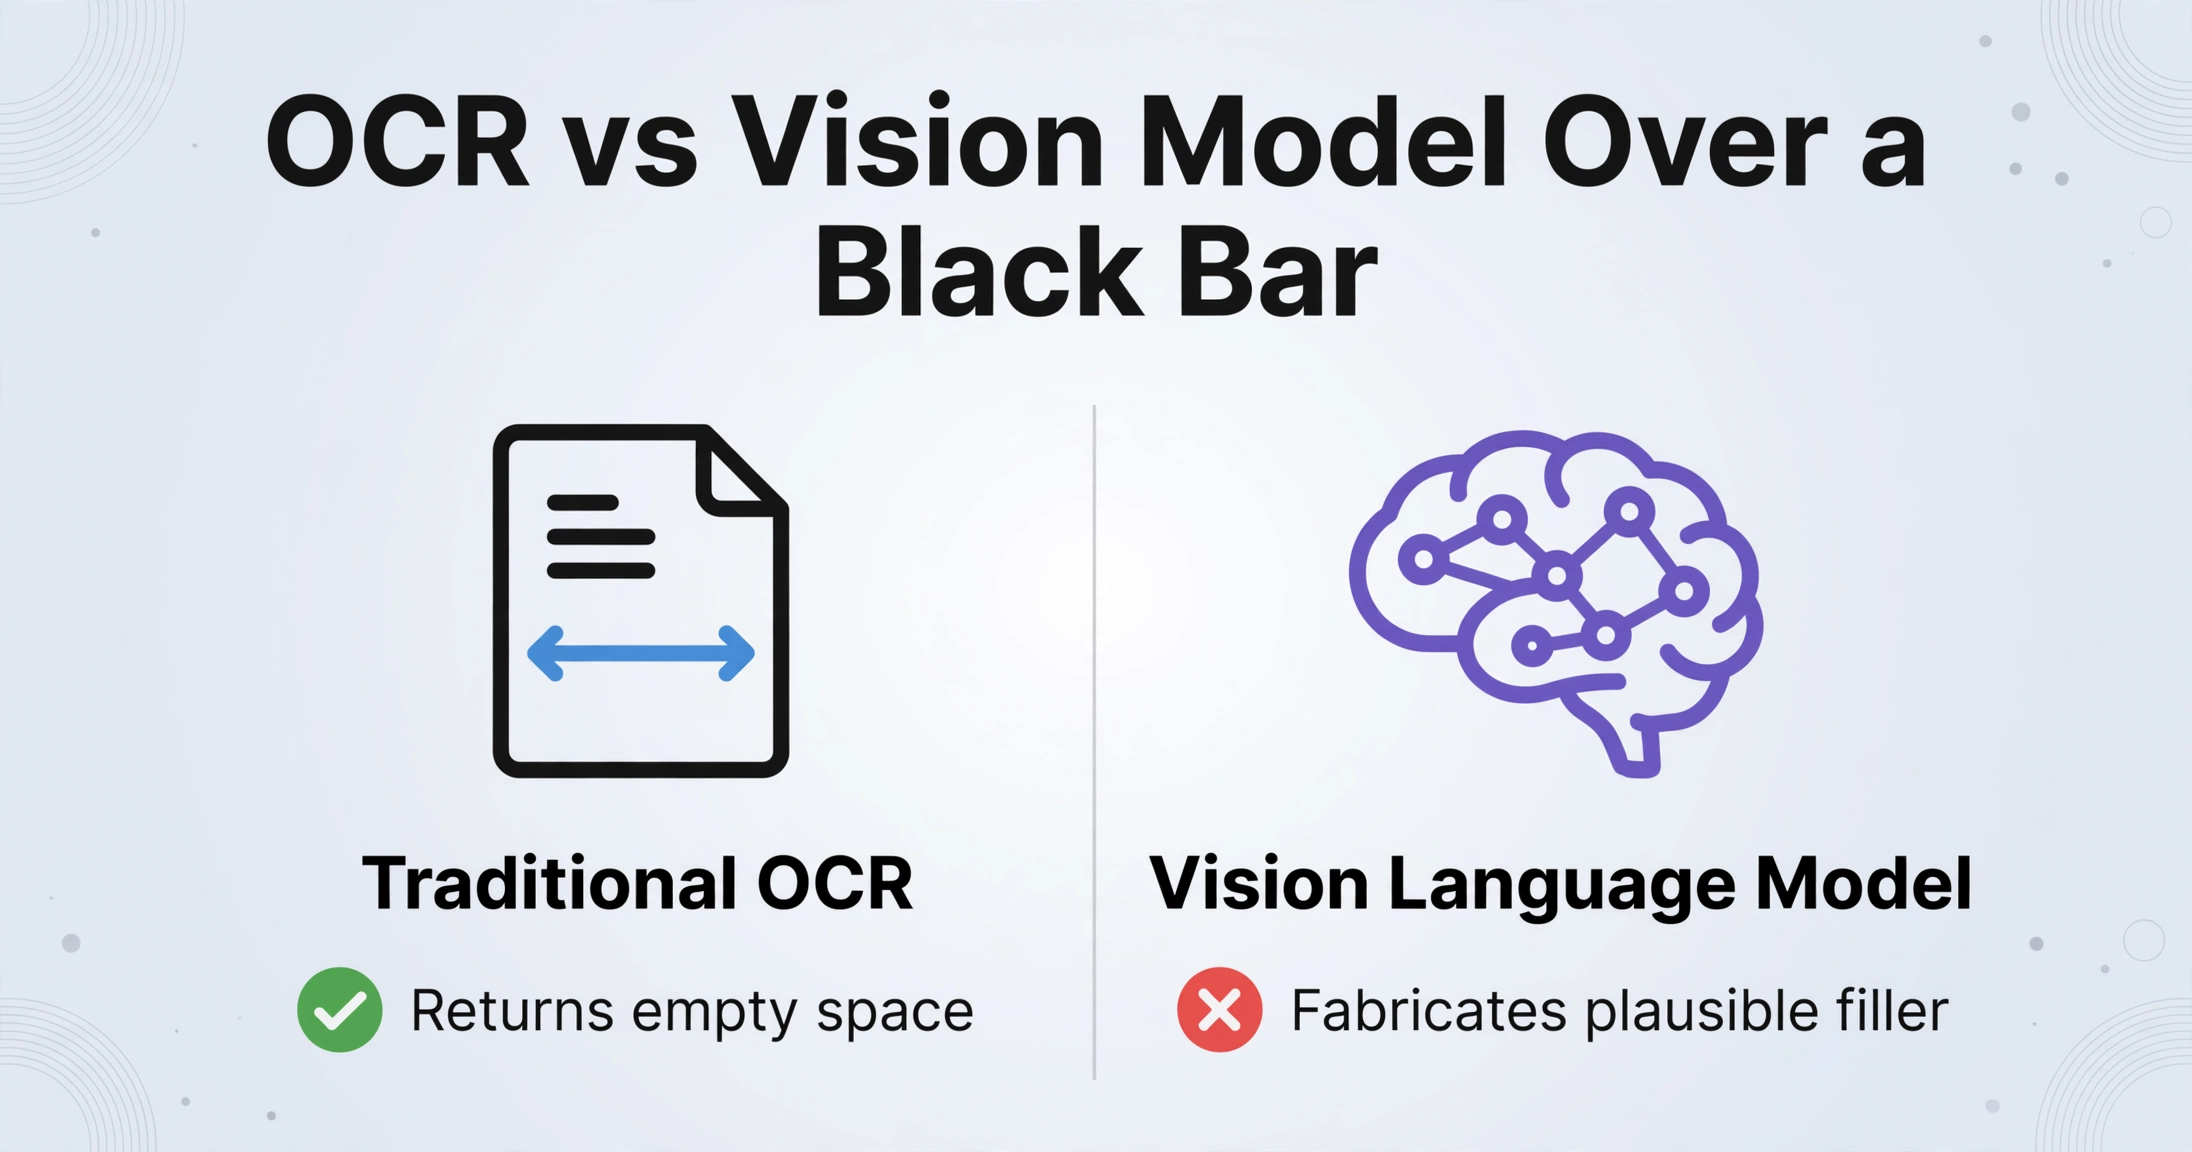
Pointez un moteur d'OCR sur un rectangle noir uni et la sortie correcte est vide. L'OCR traditionnel comme Tesseract ou un service d'OCR cloud lit les pixels, et les pixels noirs ne portent aucun caractère. Il renvoie un espace vide, ce qui est exactement ce que vous voulez. Les limites des outils d'OCR open source sont bien documentées, et la gestion du texte absent n'est pas l'une de leurs faiblesses.
Un modèle de vision par langage, la catégorie de modèles derrière l'extraction de données moderne, est plus performant et plus dangereux à cet endroit précis. Si on lui demande d'« extraire tout le texte » d'une page qu'il ne peut pas lire entièrement, un modèle performant peut produire un contenu plausible pour combler le vide. Cette sortie est inventée, pas récupérée, et c'est le mode de défaillance unique contre lequel il faut concevoir.
Un modèle qui remplit une cellule caviardée avec une supposition assurée est pire qu'un modèle qui la laisse vide, car la supposition ressemble à des données.
La solution est de contraindre la tâche. Nommez les champs que vous voulez et laissez l'outil ne rapporter que ce qu'il peut lire. Ne demandez pas « tout ce qui est sur la page » et ne demandez jamais à un modèle ce qui se trouve derrière une barre. Il vaut la peine de comprendre le fonctionnement de la lecture d'une page scannée : l'extraction fonctionne ici sur des pixels rendus plutôt que sur une couche de texte, ce qui explique aussi pourquoi l'IA peut extraire des données de PDF scannés qui déjouent un lecteur PDF classique.
La moitié qui passe à l'échelle : extraire les champs visibles d'un lot
La question utile n'est pas de savoir comment lire derrière les barres, mais quelle part de ce qui se trouve devant elles vous pouvez extraire sans le lire à la main. Cela compte parce que les publications arrivent en volume. Les agences fédérales ont reçu un nombre record de 1 501 432 demandes FOIA au cours de l'exercice 2024, soit une augmentation de 25 pour cent par rapport à l'année précédente, et la demande simple moyenne a pris 44 jours pour recevoir une réponse, contre 39 (Bureau de la politique d'information du DOJ, exercice 2024). Une seule production peut atteindre des centaines ou des milliers de pages, et les champs dont vous avez réellement besoin pour un index ou une statistique ont tendance à être les plus simples : date du document, agence, numéro de dossier, numéro de pièce, exemption invoquée, montant qui n'a jamais été assez sensible pour être couvert. Lire chaque page pour les collecter est le goulot d'étranglement, et ce n'est pas un problème de caviardage.
Le caviardage dans ce type de document n'est pas facultatif. La FOIA (5 U.S.C. § 552) permet à une agence de retenir un contenu exempté, et les mémoires déposés devant les tribunaux fédéraux doivent partiellement caviarder les identifiants tels que les numéros de sécurité sociale, les dates de naissance, les numéros de compte financier et les noms de mineurs conformément à la FRCP 5.2, avec la contrepartie pénale à la règle 49.1. Les barres ne vont pas disparaître, et le volume de pages qui les entourent non plus.
C'est ici que l'extraction en masse prend tout son sens. Extraction de colonnes personnalisées part de ce que vous voulez plutôt que de ce que la page propose. Vous saisissez les noms de colonnes, tels que Agence, Date du document, Numéro de dossier ou Exemption citée, et le modèle localise chaque valeur par le sens dans chaque page et chaque mise en page. Un champ qui a été caviardé n'a rien à lire, il revient donc vide au lieu d'être rempli par une supposition. Le vide est la fonctionnalité. Il garde le tableur honnête et rend une valeur manquante visible parmi des milliers de lignes.
Traitement par lots en priorité gère le volume. Vous téléversez l'ensemble de la publication en une seule fois plutôt que fichier par fichier, et les résultats fusionnent dans un tableur unique avec une ligne par page ou document. Cela produit un index triable et filtrable des parties lisibles de la publication, ce que la plupart des gens recherchent vraiment quand ils cherchent un flux de travail OCR par lots. Le matériel gouvernemental comporte ses propres contraintes au-delà du caviardage lui-même, et les compromis concernant les formulaires citoyens, les ensembles FOIA et les archives héritées sont détaillés dans l'extraction de documents pour les agences gouvernementales.
Ce qu'aucun outil ne peut faire
Aucun outil ne récupère le texte supprimé au niveau du fichier, et tout produit qui prétend le contraire devine. La limite mérite d'être énoncée sans détour :
- Le contenu excisé ou incrusté est irrécupérable. Si les caractères ne sont ni dans le flux de contenu ni dans les pixels, rien ne les reconstruit. La recherche sur l'espacement des glyphes récupère des longueurs et des candidats plausibles à partir d'artefacts de mise en page, pas le texte lui-même, et c'est une technique d'attaque plutôt qu'un flux de travail.
- Une boîte blanche est le même problème, moins visible. Un rectangle blanc sur du texte noir reste une superposition si le texte en dessous n'a jamais été supprimé. Le test est identique.
- Un scan aplati n'est qu'une image. Imprimer, marquer physiquement et renumériser produit une page sans couche de texte. L'OCR lit ce qui reste visible, avec la précision que le scan permet, ce qui correspond à la plage décrite dans le guide général de précision de l'extraction de documents.
- Le vide est une réponse valide. Si un champ a été caviardé, la sortie correcte est vide. Attendez-vous à un mélange de cellules remplies et vides, et concevez le flux de travail en conséquence plutôt que de le combattre.
Il existe aussi une limite qui n'est pas technique. Utiliser un caviardage raté pour lire un contenu auquel vous n'étiez pas destiné peut enfreindre la confidentialité et les règles de conduite professionnelle, ce qui est un problème d'un ordre différent d'une erreur d'OCR.
FAQ
L'OCR peut-il lire un texte caviardé ?
Uniquement si le texte est toujours présent dans le fichier, et dans ce cas, ce n'est pas l'OCR qui le trouve. Si le caviardage a supprimé le contenu, l'OCR voit des pixels noirs et ne renvoie rien. S'il s'agit d'une annotation de superposition, les mots se trouvent dans la couche de texte, et un copier-coller, une recherche ou un extracteur de texte les fera apparaître.
L'IA peut-elle décaviarder un PDF ?
Non. Un modèle chargé de combler une zone caviardée produira un texte plausible, pas l'original, et il est impossible de distinguer les deux à partir du seul résultat. Traitez tout résultat de ce type comme une fabrication.
Comment extraire uniquement les parties visibles d'un PDF caviardé ?
Nommez les champs souhaités et traitez l'ensemble en un seul lot. Les valeurs présentes sur la page sont extraites, et les champs caviardés reviennent vides. Cela permet d'obtenir un résultat exploitable sans prétendre avoir lu le contenu masqué.
Est-il légal de récupérer du texte d'un document caviardé ?
Cela dépend de la manière dont vous l'avez obtenu et de ce que vous en faites. Un caviardage raté ne rend pas le contenu public, et son utilisation peut créer des problèmes de confidentialité et de déontologie professionnelle. Vérifiez les documents que vous produisez ; n'exploitez pas les documents que vous recevez.
L'OCR fonctionne-t-il toujours sur un document scanné avec des caviardages ?
Oui. L'OCR lit le texte visible autour des barres noires de la même manière qu'il lit tout autre scan, et les zones caviardées ne contiennent rien à reconnaître. Une page scannée avec une couche OCR non purgée est le cas rare où le texte masqué lui-même reste recherchable.
La valeur d'une publication caviardée ne se trouve pas derrière les barres noires. Elle réside dans les numéros de dossier, les dates et les noms d'agences qui figurent en clair sur la même page, et c'est cette partie qui mérite d'être automatisée. Testez tout flux de travail que vous créez selon un critère unique : s'il remplit un champ caviardé avec une valeur confiante au lieu de le laisser vide, il a cessé d'extraire et a commencé à deviner.