Geschwärzte Dokumente im Batch:
Was OCR liest und was verloren ist
Immer wieder kommt in Automatisierungs-Communities dieselbe Anfrage auf: Tausende stark geschwärzte Dokumente sollen wieder lesbar gemacht werden. In einem r/n8n-Thread, in dem Leute gefragt wurden, welche Automatisierung sie wirklich brauchen, lautete eine Antwort direkt: „Ich möchte mehrere tausend stark geschwärzte Dokumente hochladen und sie entschwärzen lassen.“
Kein Tool kann das, und der Grund sollte vor allem anderen genannt werden. Eine korrekt ausgeführte Schwärzung hat den Inhalt aus der Datei entfernt. Er liegt nicht hinter dem schwarzen Balken und wartet darauf, wiederhergestellt zu werden. Er ist weg. Was bleibt, ist allerdings eine große Menge Dokumente, bei denen die meisten nützlichen Felder nie abgedeckt wurden – und diese manuell herauszuziehen, ist der Teil, der wirklich nicht skaliert.
Die wichtigsten Erkenntnisse
- Ein schwarzer Balken sagt nichts darüber aus, was darunter passiert ist – ob der Text überlebt hat, ist eine Eigenschaft der Datei, nicht des Bildes.
- Text, der durch eine echte Schwärzung entfernt wurde, ist aus der Datei verschwunden. Ein KI-Modell, das ihn rekonstruieren soll, erfindet also einen plausiblen Wert, statt den echten zu finden.
- Die Fallnummern, Daten und Behördennamen, die Sie tatsächlich benötigen, wurden meist nie geschwärzt – benennen Sie diese Felder und extrahieren Sie sie in einem Batch aus der gesamten Veröffentlichung.
Nicht alle Schwärzungen sind derselbe Vorgang
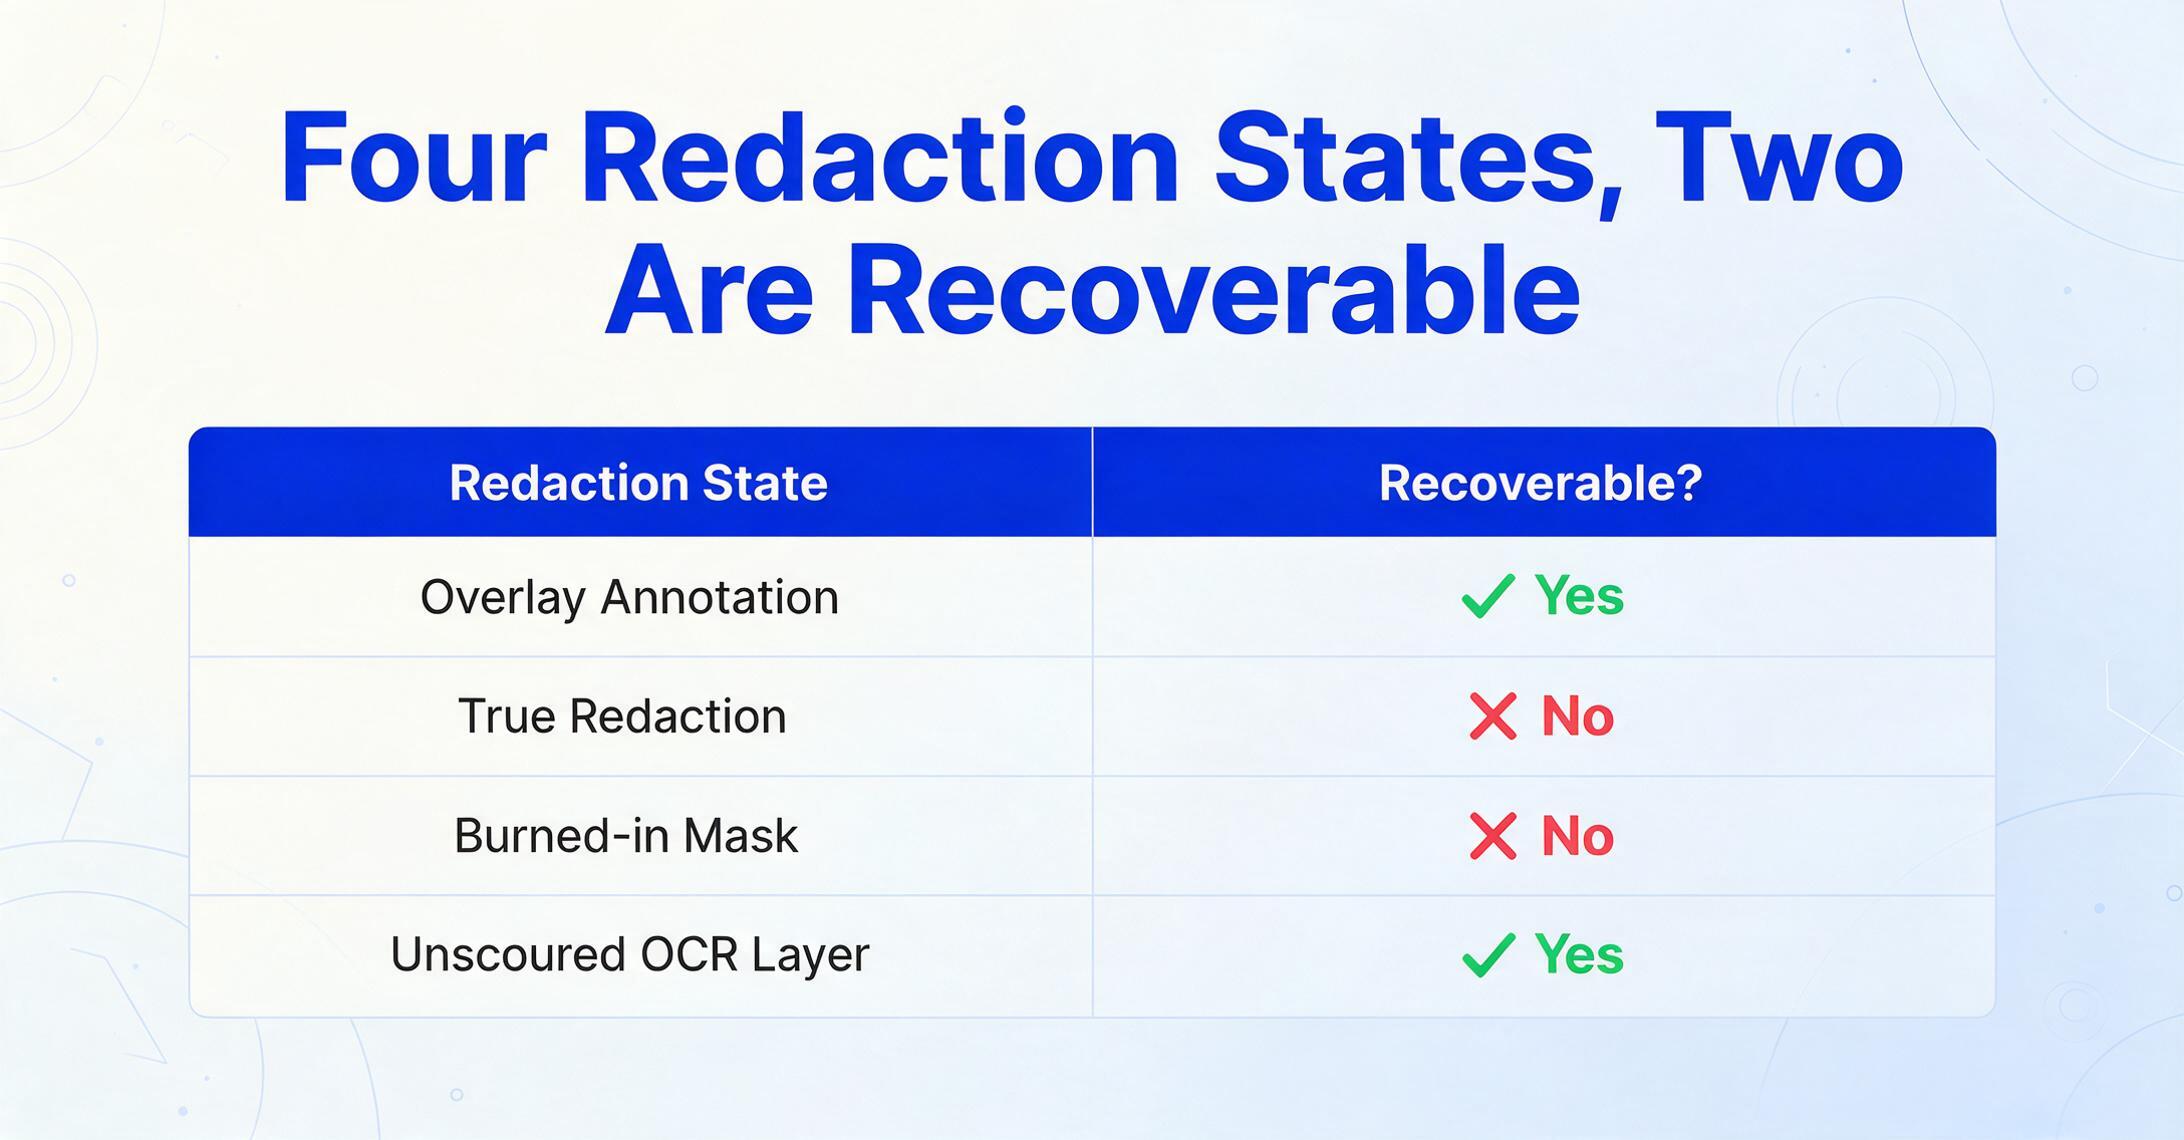
Ein schwarzer Balken verrät fast nichts darüber, was darunter passiert ist. „Schwärzung" wird verwendet, als wäre es eine einzige Aktion, aber in einem PDF erzeugt sie mindestens vier verschiedene physische Zustände, und nur einige davon entfernen tatsächlich Inhalte. Welcher Zustand vorliegt, entscheidet darüber, ob überhaupt etwas wiederherstellbar ist.
| Was Sie sehen | Wo der Inhalt liegt | Wiederherstellbar? |
|---|---|---|
| Overlay-Anmerkung (ein schwarzes Rechteck oder Textmarker, der über live Text gezeichnet wurde) | Textebene ist unter der Form intakt | Ja. Auswählen und kopieren oder suchen |
| Echte Schwärzung (Text aus dem Inhaltsstrom entfernt und durch eine Box ersetzt) | Aus der Datei entfernt | Nein |
| Eingebrannte Maske (Seite gerastert und die Pixel überschrieben) | Es existiert keine Textebene | Nein |
| Nicht bereinigte OCR-Ebene (eine Box auf einem gescannten Bild, aber der unsichtbare durchsuchbare Text bleibt erhalten) | Versteckte Textebene hinter dem Bild | Ja. Text suchen oder extrahieren |
| Metadaten, Kommentare, Lesezeichen | Dokumenteigenschaften, nicht die Seite | Manchmal. Dieselben Zeichenfolgen können bestehen bleiben |
Der Unterschied ist nicht akademisch. Adobes eigene Anleitung trennt eine Kommentar- oder Markup-Rechteck von seinem Schwärzungswerkzeug, gerade weil eine gezeichnete Form nur ändert, was Sie sehen. Das Schwärzungswerkzeug entfernt den Inhalt dauerhaft, und auch dann nur, nachdem Sie „Anwenden" wählen und es die versteckten Informationen bereinigen lassen. Wenn dieser zweite Schritt übersprungen wird, behält die Datei eine Kopie dessen, was verschwinden sollte.
Ob die Daten weg sind, ist eine Eigenschaft der Datei, nicht eine Eigenschaft des Bildes. Der Balken ist nur eine Darstellungsentscheidung.
So erkennen Sie in etwa einer Minute, welches Sie in der Hand halten
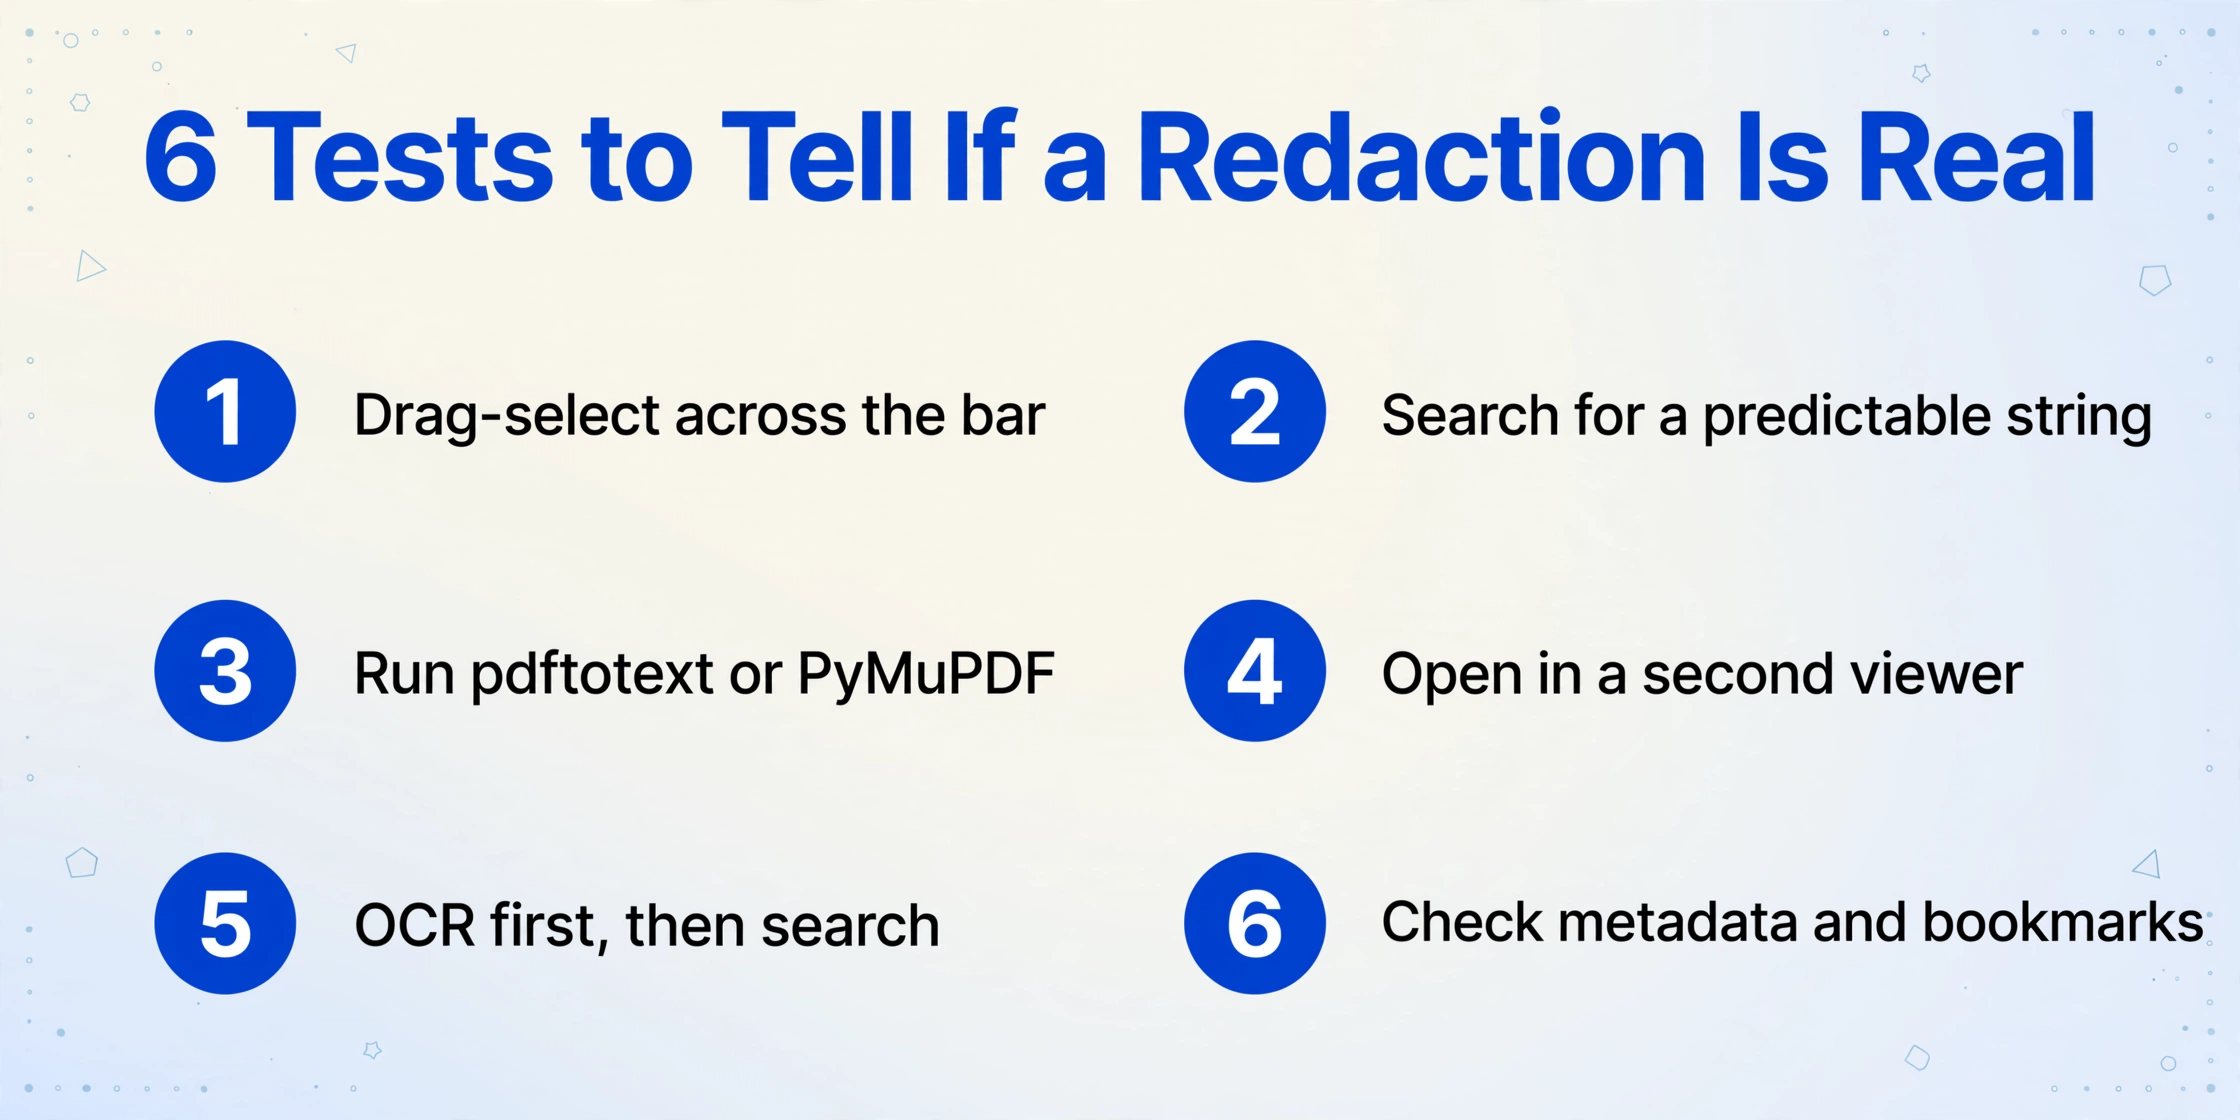
Den Zustand einer Schwärzung können Sie in der Regel mit Werkzeugen feststellen, die Sie bereits besitzen. Keiner dieser Tests erfordert spezielle Software, und ein Dokument, das bei mehreren davon durchfällt, ist nicht wirklich geschwärzt.
Klicken und über den Balken ziehen
Wenn Text unterhalb des schwarzen Kastens hervorgehoben wird, ist der Inhalt noch vorhanden. Kopieren Sie ihn und fügen Sie ihn in einen einfachen Texteditor ein, um dies zu bestätigen. Mit diesem einfachen Test lasen Journalisten 2019 die Manafort-Einreichung, nachdem die Anwälte schwarze Rechtecke gezeichnet hatten, statt echte Schwärzungen vorzunehmen.
Nach einem vorhersehbaren Begriff suchen
Verwenden Sie die Suchfunktion für einen Begriff, der plausibel im abgedeckten Bereich erscheinen würde: eine bekannte Aktennummer, eine Behördenabkürzung, „Account" oder ein Nachname. Ein Treffer bei einem Wort, das sichtbar geschwärzt ist, bedeutet, dass die Textebene nie bereinigt wurde.
Einen Textextraktor ausführen
pdftotext aus den poppler-Tools oder eine Python-Bibliothek wie PyMuPDF liest den Inhaltsstrom direkt statt des Bildschirms. Wie ein r/pdf-Kommentar es formuliert: „You can use a tool like pdftotext from poppler to extract text from PDF and check if you still see the text that should be redacted."
In einem zweiten Viewer öffnen
Manche Viewer blenden Anmerkungsebenen aus oder entfernen sie. Wenn die schwarzen Balken in einer anderen Anwendung verschwinden und lesbaren Text hinterlassen, waren sie die ganze Zeit nur Formen.
Bei Scans zuerst OCR, dann suchen
Eine gescannte Seite ist ein Bild, oft mit einer unsichtbaren OCR-Textebene für die Suche. Wenn ein Ersteller das Bild mit einem Kasten abdeckte, diese Ebene aber unangetastet ließ, sind die Wörter weiterhin in der Datei. In einem r/datacurator-Thread stieß ein Nutzer mit Mathpix auf das umgekehrte Problem: „it doesn't detect barred out text and instead returns them as images."
Metadaten, Kommentare und Lesezeichen prüfen
Dokumenteigenschaften und Überprüfungskommentare können genau die Zeichenfolgen wiederholen, die von der Seite entfernt wurden. Eine saubere Seite garantiert keine saubere Datei.
Ein PDF ohne Anmerkungen, ohne auswählbaren Text unter den Balken und ohne passende Zeichenfolgen in den Metadaten ist das gesunde Ergebnis. So sieht eine korrekte Schwärzung aus.
Ein Hinweis zur Absicht: Diese Prüfungen dienen dazu, dass die Person, die ein Dokument erstellt, ihre eigene Arbeit verifizieren kann. Wenn Sie ein Dokument erhalten, dessen Schwärzung fehlgeschlagen ist, besteht die berufsethisch korrekte Reaktion darin, den Absender zu informieren, nicht die offengelegten Inhalte zu nutzen. Die beiden Handlungen sehen technisch identisch aus und sind in jeder anderen Hinsicht völlig verschieden. Wenn der extrahierte Text eher verstümmelt als abwesend ist, handelt es sich um einen separaten Fehlermodus: eine defekte Schriftzuordnung oder eine fehlgeschlagene Zeichenzuordnung, die unter warum OCR verstümmelten Text erzeugt behandelt wird.
Selbst eine sauber aussehende Schwärzung kann undicht sein
Das Entfernen des Textes macht ein Dokument nicht automatisch wasserdicht, denn eine PDF-Datei enthält mehr als nur die sichtbaren Zeichen. Eine Sicherheitsstudie der University of Illinois aus dem Jahr 2023, veröffentlicht bei PETS, ergab, dass die verbleibenden Glyphen rund um ein Schwärzungsfeld weiterhin Informationen kodieren. Subpixel-genaue horizontale Verschiebungen der Zeichen auf beiden Seiten verraten die Breite des Entfernten, was oft ausreicht, um Vor- und Nachnamen zu rekonstruieren.
Das Team testete elf gängige Schwärzungswerkzeuge und lokalisierte 778 anfällige „excising"-Schwärzungen in FOIA-, Inspector-General- und freigegebenen Dokumentenkorpus, sowie mehr als 700 öffentliche Gerichtsdokumente, in denen der Text von vornherein nie entfernt worden war. Zwei weit verbreitete Online-Tools, PDFescape Online und PDFzorro, ließen den vermeintlich verborgenen Text vollständig zugänglich. Das Papier ist verfügbar unter arXiv:2206.02285.
Die Manafort-Einreichung ist der Fall, an den sich die meisten erinnern. Schwarze Rechtecke wurden mit Markup-Werkzeugen statt mit der Schwärzungsfunktion gezeichnet, und Reporter wählten die Balken aus, kopierten und fügten den Text in ein neues Dokument ein, wodurch Details offengelegt wurden, die die Einreichung zurückhalten sollte (WIRED, 2019). Diese Lücken zu schließen, ist Aufgabe des Erstellers. Für alle, die Dokumente empfangen, ist die praktische Lehre enger gefasst: Gehen Sie nicht davon aus, dass ein Balken bedeutet, dass der Text entfernt wurde, und bauen Sie keinen Workflow, der darauf angewiesen ist.
Was OCR über einem schwarzen Balken tatsächlich zurückgibt
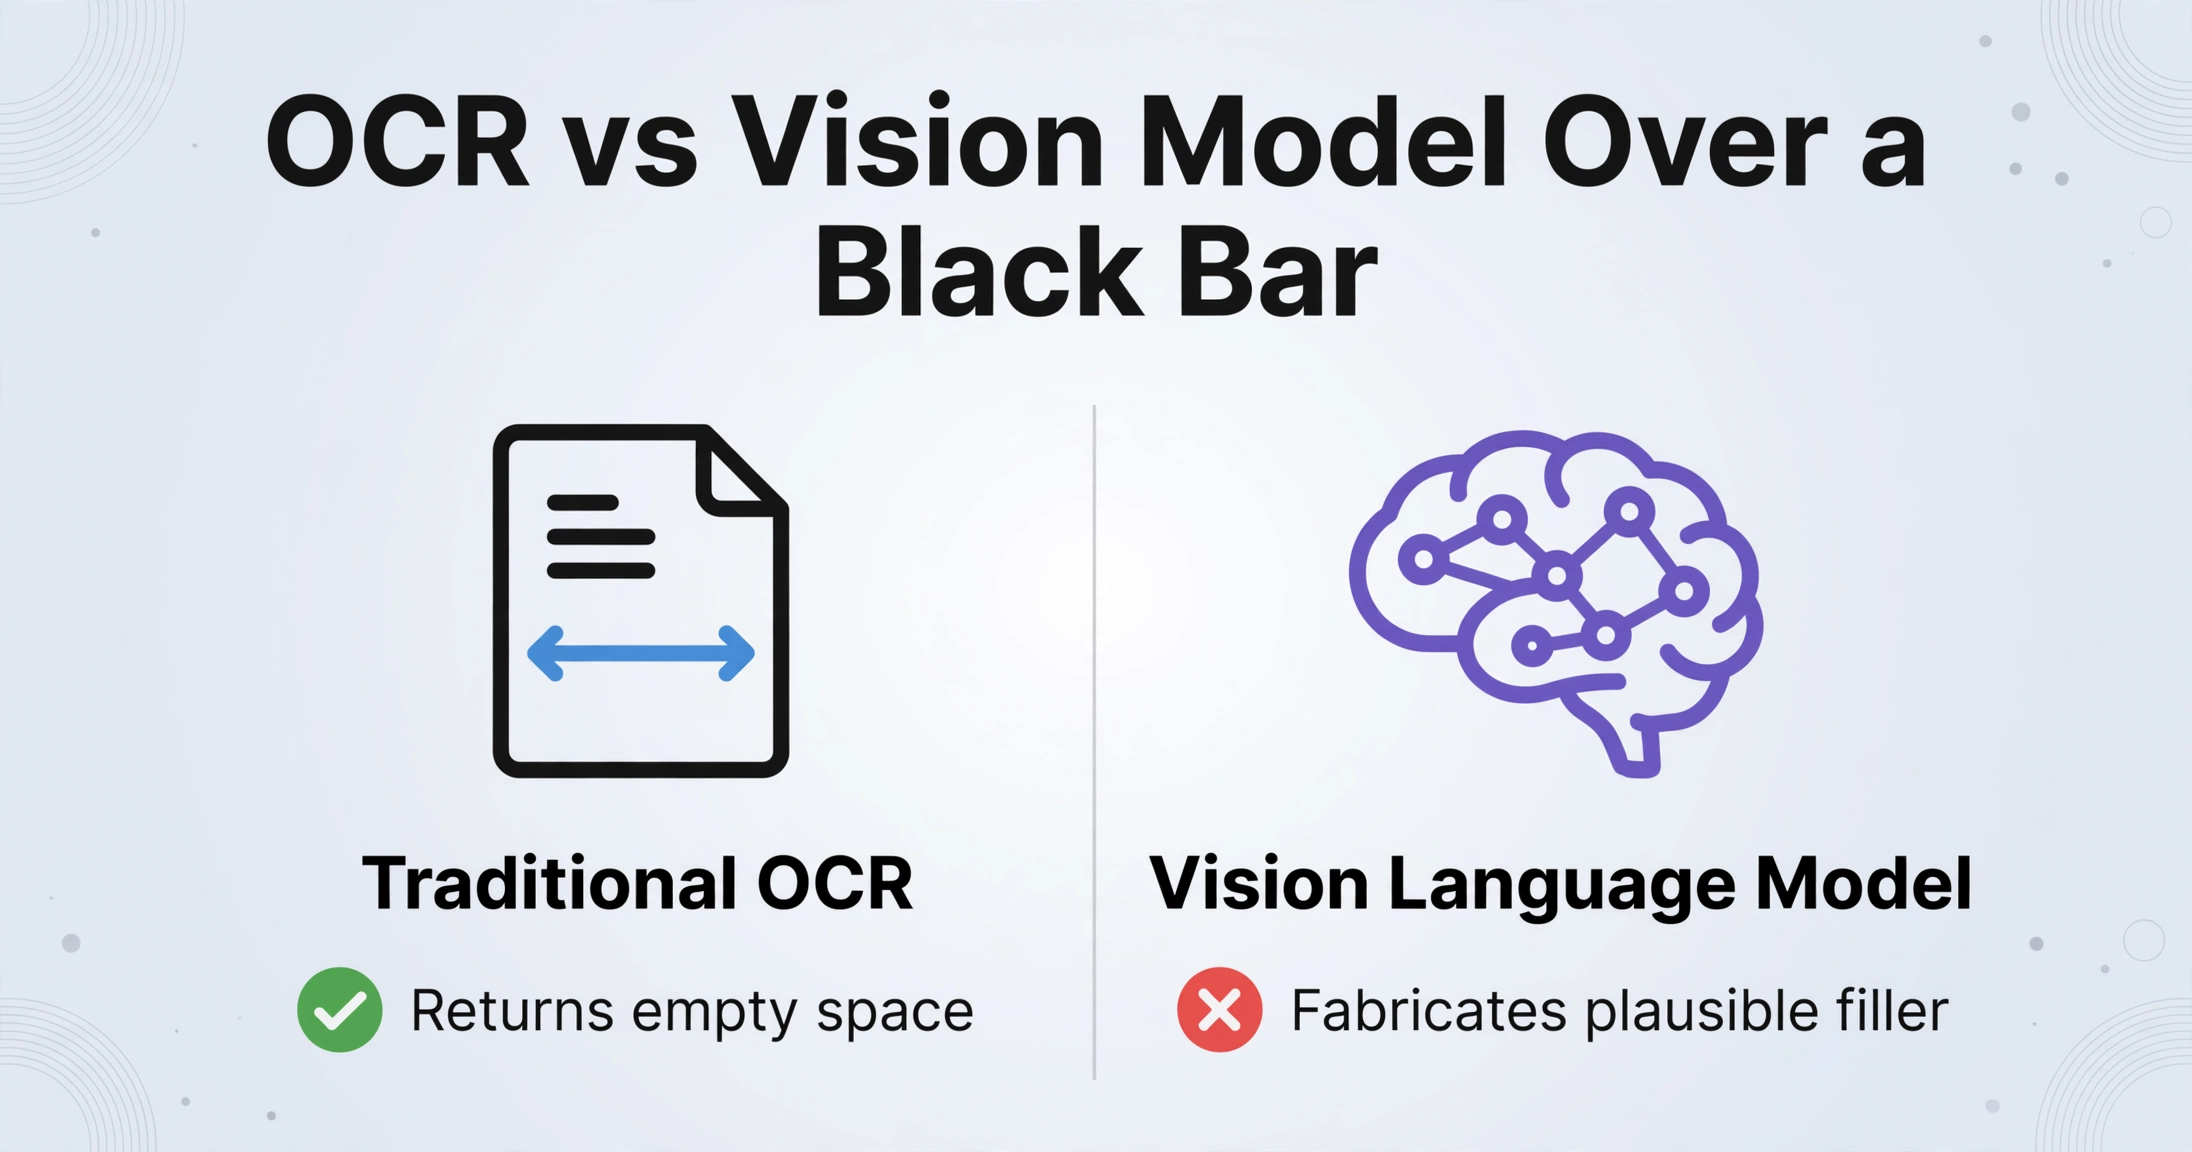
Richten Sie eine OCR-Engine auf ein solides schwarzes Rechteck, und die korrekte Ausgabe ist nichts. Traditionelle OCR wie Tesseract oder ein Cloud-OCR-Dienst liest Pixel, und schwarze Pixel enthalten keine Zeichen. Sie gibt leeren Raum zurück, was genau das ist, was Sie wollen. Die Grenzen von Open-Source-OCR-Werkzeugen sind gut dokumentiert, und der Umgang mit fehlendem Text gehört nicht zu ihren Schwächen.
Ein Vision-Language-Modell, die Modellklasse hinter moderner Datenextraktion, ist an dieser speziellen Stelle leistungsfähiger und gefährlicher. Wenn es darum gebeten wird, "den gesamten Text" aus einer Seite zu extrahieren, die es nicht vollständig lesen kann, kann ein leistungsfähiges Modell einen plausiblen Fülltext für die Lücke erzeugen. Diese Ausgabe ist erfunden, nicht wiederhergestellt, und sie ist die einzige Fehlerquelle, gegen die man entwerfen sollte.
Ein Modell, das eine geschwärzte Zelle mit einer selbstbewussten Vermutung füllt, ist schlimmer als eines, das sie leer lässt, denn die Vermutung sieht wie Daten aus.
Die Lösung besteht darin, die Aufgabe einzuschränken. Benennen Sie die Felder, die Sie möchten, und lassen Sie das Werkzeug nur das melden, was es lesen kann. Fragen Sie nicht nach "allem auf der Seite" und fragen Sie ein Modell niemals, was sich hinter einem Balken befindet. Die Mechanik des Lesens einer gescannten Seite überhaupt ist es wert, verstanden zu werden: Die Extraktion funktioniert hier auf gerenderten Pixeln und nicht auf einer Textebene, was derselbe Grund ist, warum KI Daten aus gescannten PDFs extrahieren kann, die einen normalen PDF-Reader überfordern.
Die Hälfte, die skaliert: Sichtbare Felder aus einem Batch ziehen
Die nützliche Frage ist nicht, wie man hinter den Balken liest, sondern wie viel von dem, was davor liegt, man extrahieren kann, ohne es von Hand zu lesen. Das ist wichtig, weil Veröffentlichungen in großen Mengen anfallen. Bundesbehörden erhielten im Haushaltsjahr 2024 eine Rekordzahl von 1.501.432 FOIA-Anfragen, ein Anstieg von 25 Prozent gegenüber dem Vorjahr, und die durchschnittliche einfache Anfrage dauerte 44 Tage bis zur Beantwortung, gegenüber 39 (DOJ Office of Information Policy, FY2024). Eine einzelne Produktion kann Hunderte oder Tausende von Seiten umfassen, und die Felder, die Sie tatsächlich für einen Index oder eine Statistik benötigen, sind tendenziell die einfachen: Dokumentdatum, Behörde, Aktenzeichen, Beweisstücknummer, die zitierte Ausnahme, ein Betrag, der nie sensibel genug war, um abgedeckt zu werden. Jede Seite zu lesen, um sie zu sammeln, ist der Engpass, und das ist kein Schwärzungsproblem.
Schwärzung ist in diesem Material nicht optional. FOIA (5 U.S.C. § 552) erlaubt einer Behörde, ausgenommenen Inhalt zurückzuhalten, und bundesstaatliche Gerichtsdokumente müssen Kennungen wie Sozialversicherungsnummern, Geburtsdaten, Finanzkontonummern und die Namen Minderjähriger gemäß FRCP 5.2 teilweise schwärzen, mit dem strafrechtlichen Gegenstück in Regel 49.1. Die Balken werden nicht verschwinden, und auch nicht die Menge der Seiten um sie herum.
Hier zeigt sich der Wert der Massenextraktion. Benutzerdefinierte Spaltenextraktion geht von dem aus, was Sie möchten, statt von dem, was die Seite bietet. Sie geben die Spaltennamen ein, etwa Behörde, Dokumentdatum, Aktenzeichen oder angeführte Ausnahme, und das Modell findet jeden Wert anhand der Bedeutung über alle Seiten und Layouts hinweg. Ein Feld, das geschwärzt wurde, enthält nichts zum Lesen, daher bleibt es leer, statt mit einer Vermutung gefüllt zu werden. Die Leerstelle ist das Feature. Sie hält die Tabelle ehrlich und macht einen fehlenden Wert unter Tausenden von Zeilen sichtbar.
Batch-First-Verarbeitung bewältigt das Volumen. Sie laden die gesamte Veröffentlichung auf einmal hoch statt Datei für Datei, und die Ergebnisse werden in einer einzigen Tabelle mit einer Zeile pro Seite oder Dokument zusammengeführt. Das ergibt einen sortier- und filterbaren Index der lesbaren Teile der Veröffentlichung, was die meisten tatsächlich suchen, wenn sie nach einem Batch-OCR-Workflow fragen. Behördliches Material bringt über die Schwärzung hinaus eigene Einschränkungen mit sich; die Abwägungen bei Bürgerformularen, FOIA-Sets und Altarchiven sind in Dokumentextraktion für Behörden dargelegt.
Was kein Tool leisten kann
Kein Tool stellt Text wieder her, der auf Dateiebene entfernt wurde, und jedes Produkt, das das behauptet, rät. Diese Grenze sollte ohne Einschränkung klar benannt werden:
- Entfernter oder eingebrannter Inhalt ist nicht wiederherstellbar. Wenn die Zeichen weder im Inhaltsstrom noch in den Pixeln vorhanden sind, kann nichts sie rekonstruieren. Die Glyphenabstands-Forschung gewinnt Längen und plausible Kandidaten aus Layout-Artefakten, nicht den Text selbst, und sie ist eine Angriffstechnik statt eines Workflows.
- Ein weißes Feld ist dasselbe Problem, nur weniger sichtbar. Ein weißes Rechteck über schwarzem Text ist weiterhin eine Overlay-Anmerkung, wenn der Text darunter nie entfernt wurde. Der Test ist identisch.
- Ein flacher Scan ist nur ein Bild. Drucken, physisch markieren und erneut scannen erzeugt eine Seite ohne Textebene. OCR liest, was sichtbar bleibt, mit der Genauigkeit, die der Scan erlaubt – das ist der Bereich, den der allgemeine Leitfaden zur Dokumentextraktions-Genauigkeit beschreibt.
- Leer ist eine gültige Antwort. Wenn ein Feld geschwärzt wurde, ist die korrekte Ausgabe leer. Erwarten Sie eine Mischung aus gefüllten und leeren Zellen und gestalten Sie den Workflow entsprechend, statt dagegen anzukämpfen.
Es gibt auch eine Grenze, die nicht technischer Natur ist. Die Nutzung einer fehlgeschlagenen Schwärzung, um Inhalte zu lesen, die Sie nicht sehen sollten, kann Vertraulichkeits- und Berufsethikregeln verletzen – das ist eine andere Art von Problem als ein OCR-Fehler.
FAQ
Kann OCR geschwärzten Text lesen?
Nur wenn der Text noch in der Datei vorhanden ist – und dann ist es nicht OCR, das ihn findet. Wenn die Schwärzung den Inhalt entfernt hat, sieht OCR schwarze Pixel und liefert nichts zurück. Handelt es sich um eine Overlay-Anmerkung, befinden sich die Wörter in der Textebene, und Kopieren, Suchen oder ein Textextraktor fördern sie zutage.
Kann KI eine Schwärzung in einem PDF rückgängig machen?
Nein. Ein Modell, das eine geschwärzte Region auffüllen soll, erzeugt plausiblen Text, nicht das Original, und es gibt keine Möglichkeit, die beiden allein anhand der Ausgabe zu unterscheiden. Behandeln Sie jedes solche Ergebnis als erfunden.
Wie extrahiere ich nur die sichtbaren Teile eines geschwärzten PDFs?
Benennen Sie die gewünschten Felder und verarbeiten Sie den gesamten Satz in einem Batch. Werte, die auf der Seite vorhanden sind, werden extrahiert, geschwärzte Felder kommen leer zurück. So bleibt das Ergebnis nutzbar, ohne so zu tun, als wäre der verborgene Inhalt gelesen worden.
Ist es legal, Text aus einem geschwärzten Dokument wiederherzustellen?
Das hängt davon ab, wie Sie es erhalten haben und was Sie damit tun. Eine fehlgeschlagene Schwärzung macht den Inhalt nicht öffentlich, und die Nutzung kann Vertraulichkeits- und Berufspflichtprobleme schaffen. Prüfen Sie Dokumente, die Sie erstellen; durchsuchen Sie nicht Dokumente, die Sie erhalten haben.
Funktioniert OCR bei einem gescannten Dokument mit Schwärzungen weiterhin?
Ja. OCR liest den sichtbaren Text um die Balken herum genauso wie bei jedem anderen Scan, und die geschwärzten Bereiche enthalten nichts zu Erkennendes. Eine gescannte Seite mit einer nicht bereinigten OCR-Ebene ist der seltene Fall, in dem der abgedeckte Text selbst noch durchsuchbar ist.
Der Wert einer geschwärzten Veröffentlichung liegt nicht hinter den Balken. Er liegt in den Aktenzeichen, Daten und Behördennamen, die auf derselben Seite offen sichtbar sind – und genau dieser Teil lohnt die Automatisierung. Testen Sie jeden Workflow, den Sie bauen, an einem Maßstab: Wenn er ein geschwärztes Feld mit einem selbstsicheren Wert füllt, statt es leer zu lassen, hat er aufgehört zu extrahieren und begonnen zu raten.