Documentos redactados de forma masiva:
Qué lee el OCR y qué se ha perdido
De vez en cuando una comunidad de automatización recibe la misma petición: tomar miles de documentos muy redactados y hacerlos legibles de nuevo. En un hilo de r/n8n preguntando qué automatización necesitaban de verdad, una respuesta fue directa: "Me gustaría poder subir varios miles de documentos muy redactados y que se desredactaran".
Ninguna herramienta hace eso, y el motivo merece enunciarse antes que cualquier otra cosa. Una redacción bien hecha eliminó el contenido del archivo. No está esperando detrás de la barra negra a ser recuperado. Se ha ido. Lo que queda, no obstante, es un gran conjunto de documentos donde la mayoría de los campos útiles nunca fueron cubiertos, y extraerlos a mano es la parte que de verdad no escala.
Conclusiones clave
- Una barra negra no le dice nada sobre lo que ocurrió debajo: si el texto sobrevivió es una propiedad del archivo, no de la imagen.
- El texto eliminado por una redacción real ya no está en el archivo, así que un modelo de IA al que se le pida rellenarlo inventará un valor plausible en lugar de encontrar el real.
- Los números de caso, las fechas y los nombres de agencia que realmente necesita nunca fueron redactados: nombre esos campos y extráigalos de toda la publicación en un solo lote.
No Todas las Redacciones Son la Misma Operación
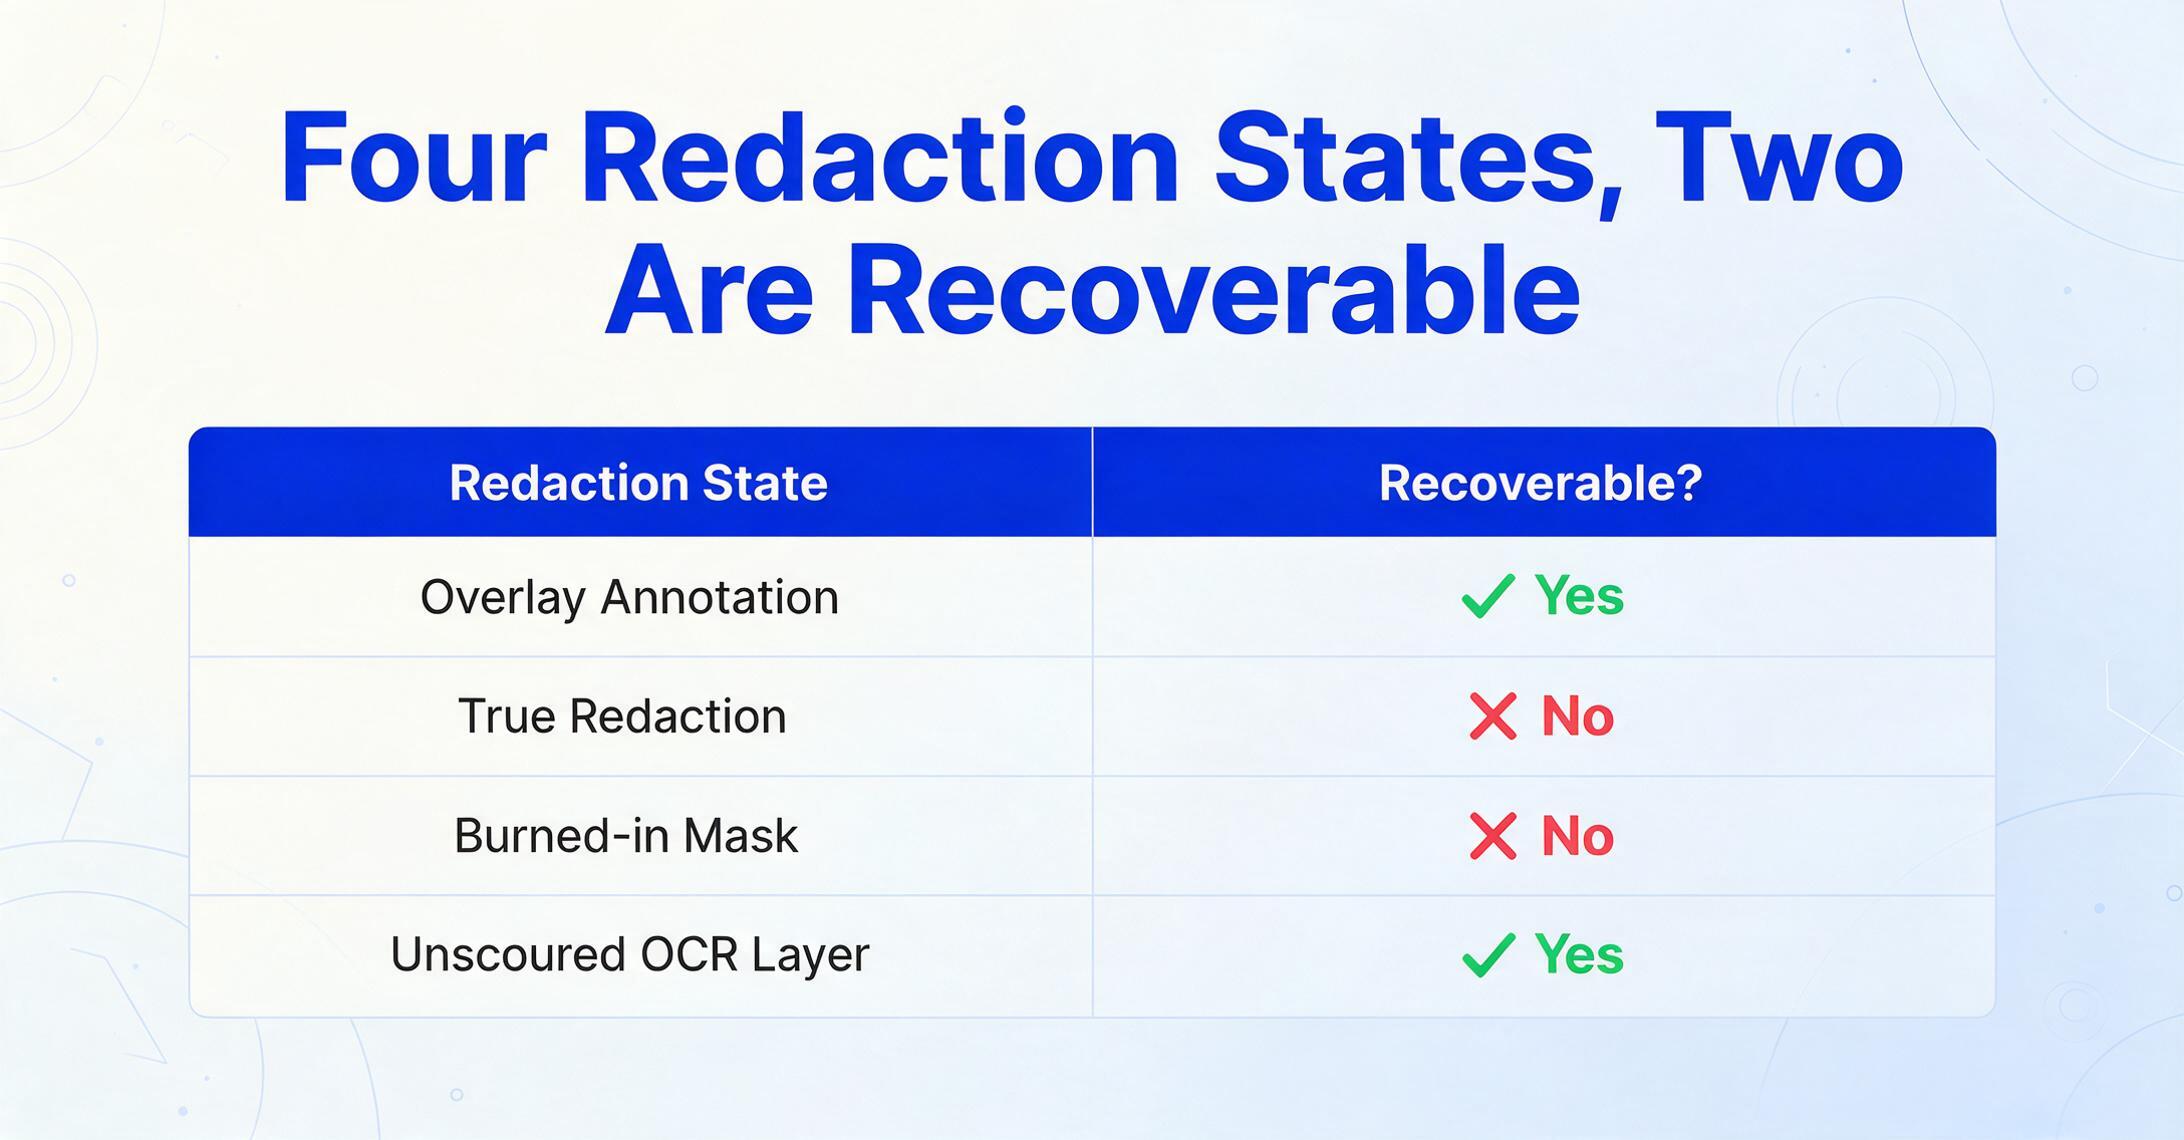
Una barra negra no le dice casi nada sobre lo que ocurrió debajo de ella. "Redacción" se usa como si fuera una sola acción, pero en un PDF produce al menos cuatro estados físicos diferentes, y solo algunos de ellos eliminan contenido de verdad. El estado que tenga en sus manos determina si algo es recuperable o no.
| Lo que está viendo | Dónde vive el contenido | ¿Recuperable? |
|---|---|---|
| Anotación superpuesta (un rectángulo negro o resaltador dibujado sobre texto vivo) | La capa de texto está intacta debajo de la forma | Sí. Seleccionar y copiar, o buscar |
| Redacción real (texto eliminado del flujo de contenido y reemplazado por un recuadro) | Eliminado del archivo | No |
| Máscara incrustada (página rasterizada y píxeles sobrescritos) | No existe capa de texto | No |
| Capa OCR no depurada (un recuadro dibujado sobre una imagen escaneada, pero el texto invisible buscable se dejó en su lugar) | Capa de texto oculta detrás de la imagen | Sí. Buscar o extraer texto |
| Metadatos, comentarios, marcadores | Propiedades del documento, no de la página | A veces. Las mismas cadenas pueden persistir |
La distinción no es académica. La propia guía de Adobe separa un comentario o rectángulo de marcado de su herramienta Redact, precisamente porque una forma dibujada solo cambia lo que se ve. La herramienta Redact elimina el contenido de forma permanente, y solo después de que usted elija Aplicar y le permita depurar la información oculta. Cuando se omite ese segundo paso, el archivo conserva una copia de lo que se suponía que debía desaparecer.
Que los datos hayan desaparecido es una propiedad del archivo, no una propiedad de la imagen. La barra es solo una elección de renderizado.
Cómo saber cuál tiene en la mano, en aproximadamente un minuto
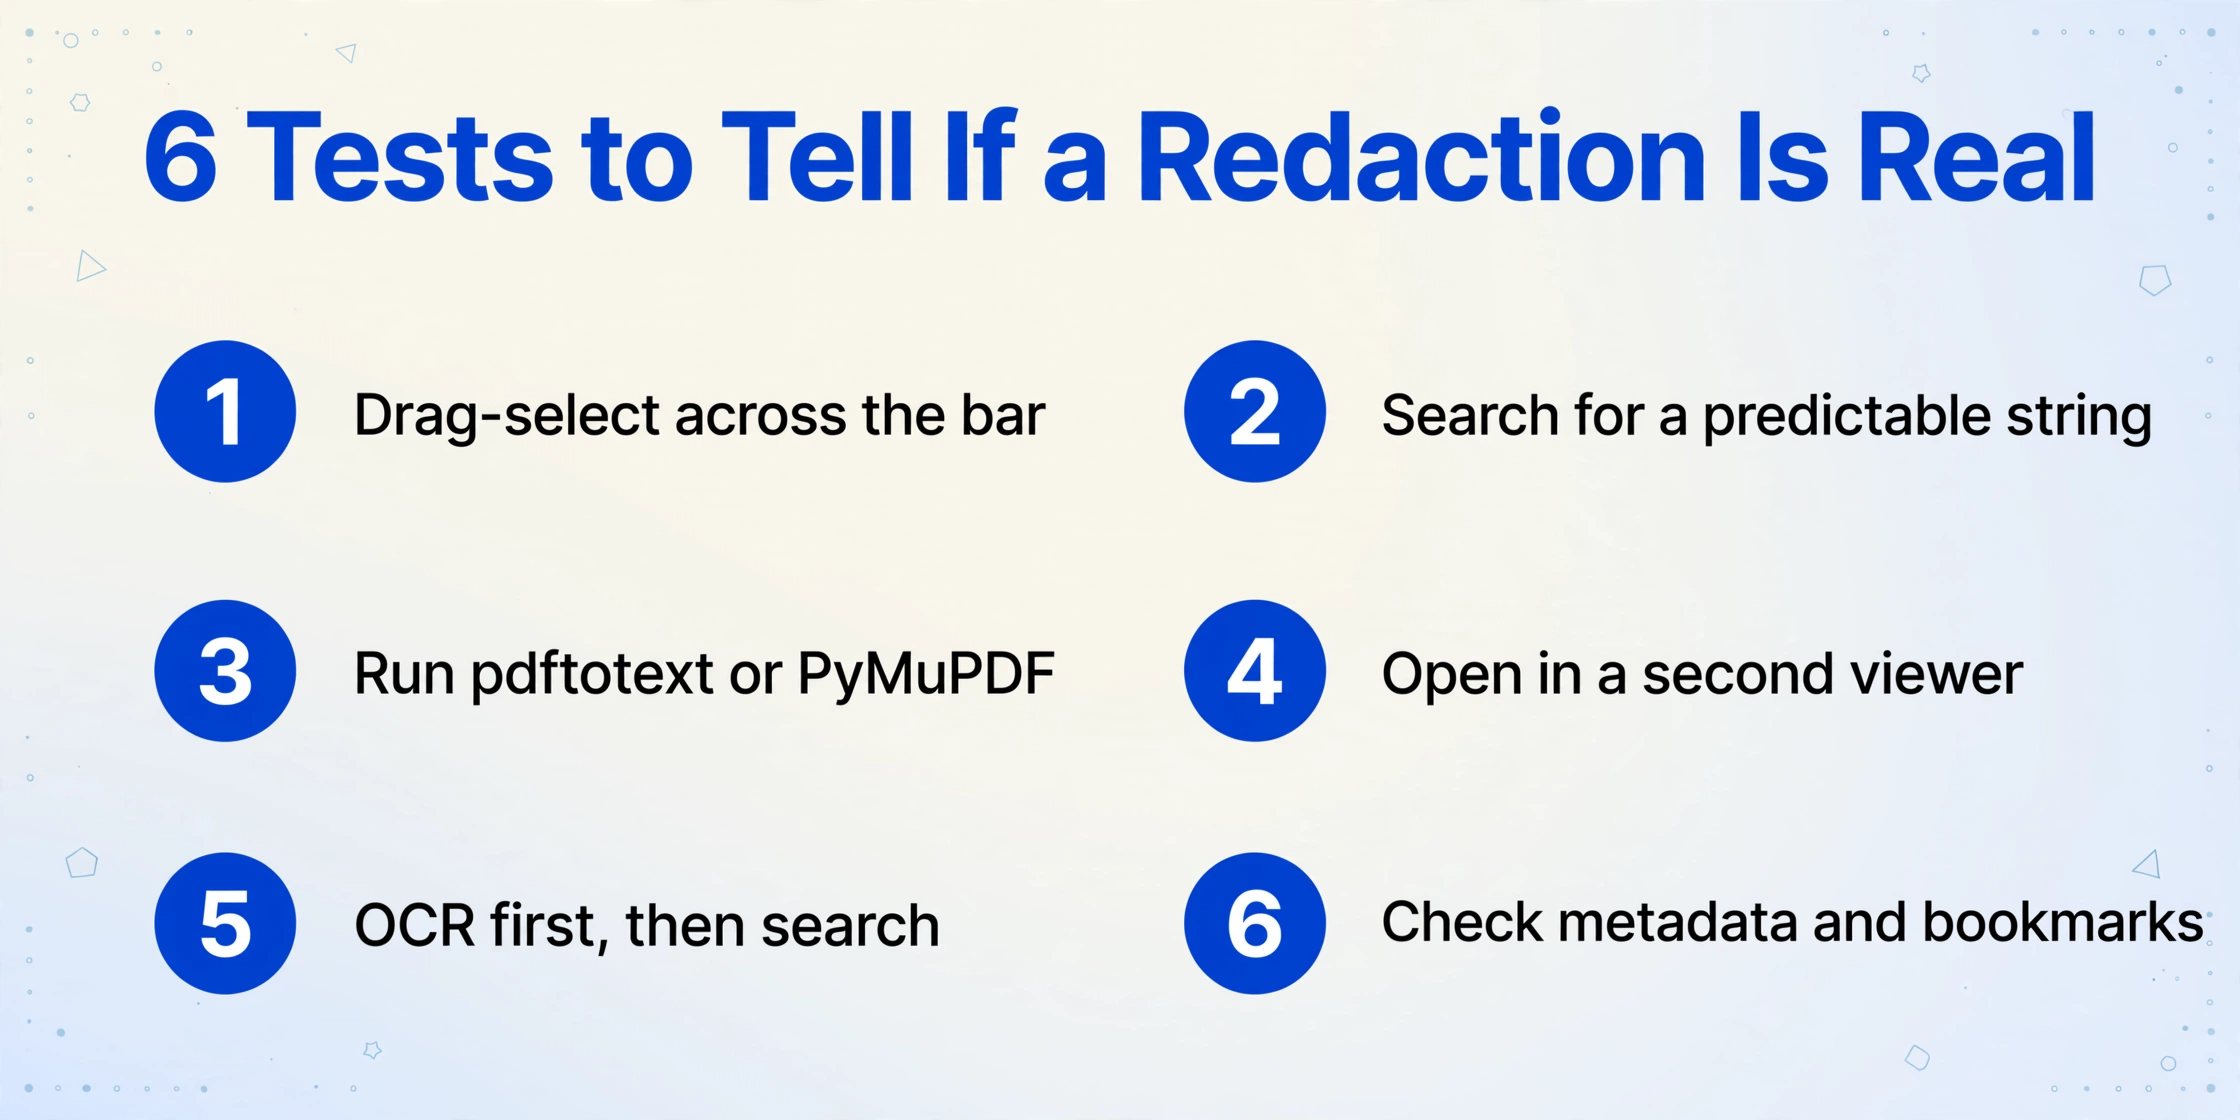
Por lo general, puede identificar el estado de una redacción con las herramientas que ya tiene. Ninguna de estas pruebas requiere software especial, y un documento que no supere varias de ellas no está realmente redactado.
Haz clic y arrastra sobre la barra
Si el texto se resalta debajo de la caja negra, el contenido sigue ahí. Cópialo y pégalo en un editor de texto sin formato para confirmarlo. Esta prueba es la misma que usaron los periodistas para leer la presentación de Manafort en 2019, cuando los abogados dibujaron rectángulos negros en lugar de redactar.
Busca una cadena que puedas predecir
Usa Buscar para localizar un término que probablemente aparezca en el área cubierta: un número de caso conocido, una sigla de agencia, "Account" o un apellido. Si encuentras una palabra que está visiblemente tachada en negro, significa que la capa de texto nunca se depuró.
Ejecuta un extractor de texto
pdftotext de las herramientas poppler, o una biblioteca de Python como PyMuPDF, lee el flujo de contenido directamente en lugar de la pantalla. Como dice un comentario de r/pdf, "Puedes usar una herramienta como pdftotext de poppler para extraer texto del PDF y comprobar si todavía ves el texto que debería estar redactado".
Ábrelo en un segundo visor
Algunos visores ocultan o eliminan las capas de anotación. Si las cajas negras desaparecen en otra aplicación y dejan texto legible, eran formas, nada más.
Para escaneos, primero OCR y luego búsqueda
Una página escaneada es una imagen, a menudo con una capa de texto OCR invisible añadida para la búsqueda. Si un productor cubrió la imagen con una caja pero dejó esa capa intacta, las palabras siguen en el archivo. En un hilo de r/datacurator, un usuario se topó con el problema inverso con Mathpix: "no detecta el texto tachado y en su lugar lo devuelve como imágenes".
Revisa metadatos, comentarios y marcadores
Las propiedades del documento y los comentarios de revisión pueden repetir las mismas cadenas que se eliminaron de la página. Una página limpia no garantiza un archivo limpio.
Un PDF sin anotaciones, sin texto seleccionable bajo las barras y sin cadenas coincidentes en sus metadatos es el resultado saludable. Así es como se ve una redacción correcta.
Una salvedad sobre la intención: estas comprobaciones existen para que la persona que produce un documento pueda verificar su propio trabajo. Si usted recibe un documento cuya redacción falló, la respuesta profesionalmente responsable es notificar al remitente, no aprovechar el contenido expuesto. Las dos acciones se ven idénticas técnicamente y son completamente diferentes en todos los demás aspectos. Si el texto que extrae sale codificado en lugar de ausente, ese es un modo de fallo aparte: un mapa de fuentes roto o una asignación de caracteres fallida, lo cual se cubre en por qué la OCR produce texto codificado.
Incluso una Redacción de Aspecto Limpio Puede Filtrar
Eliminar el texto no hace automáticamente que un documento sea hermético, porque un PDF contiene más que los caracteres que usted puede ver. Un estudio de seguridad de 2023 de la Universidad de Illinois, publicado en PETS, descubrió que los glifos sobrantes alrededor de un cuadro de redacción aún codifican información. Los desplazamientos horizontales de subpíxel en los caracteres de cada lado revelan el ancho de lo que se eliminó, lo cual a menudo es suficiente para recuperar nombres y apellidos.
El equipo probó once herramientas de redacción populares y localizó 778 redacciones vulnerables de "excición" en corpus de FOIA, del Inspector General y de documentos desclasificados, además de más de 700 documentos judiciales públicos donde el texto nunca se había eliminado en primer lugar. Dos herramientas en línea muy utilizadas, PDFescape Online y PDFzorro, dejaron el texto supuestamente oculto totalmente accesible. El artículo está disponible en arXiv:2206.02285.
La presentación de Manafort es el caso que la mayoría de la gente recuerda. Se dibujaron rectángulos negros con herramientas de marcado en lugar de la función de redacción, y los periodistas seleccionaron las barras, las copiaron y pegaron el texto en un documento nuevo, exponiendo detalles que la presentación pretendía ocultar (WIRED, 2019). Cerrar estas brechas es trabajo del productor. Para cualquier persona en el lado receptor, la lección práctica es más limitada: no asuma que una barra significa que el texto ha desaparecido, y no construya un flujo de trabajo que dependa de que esté ahí.
Lo que el OCR realmente devuelve sobre una barra negra
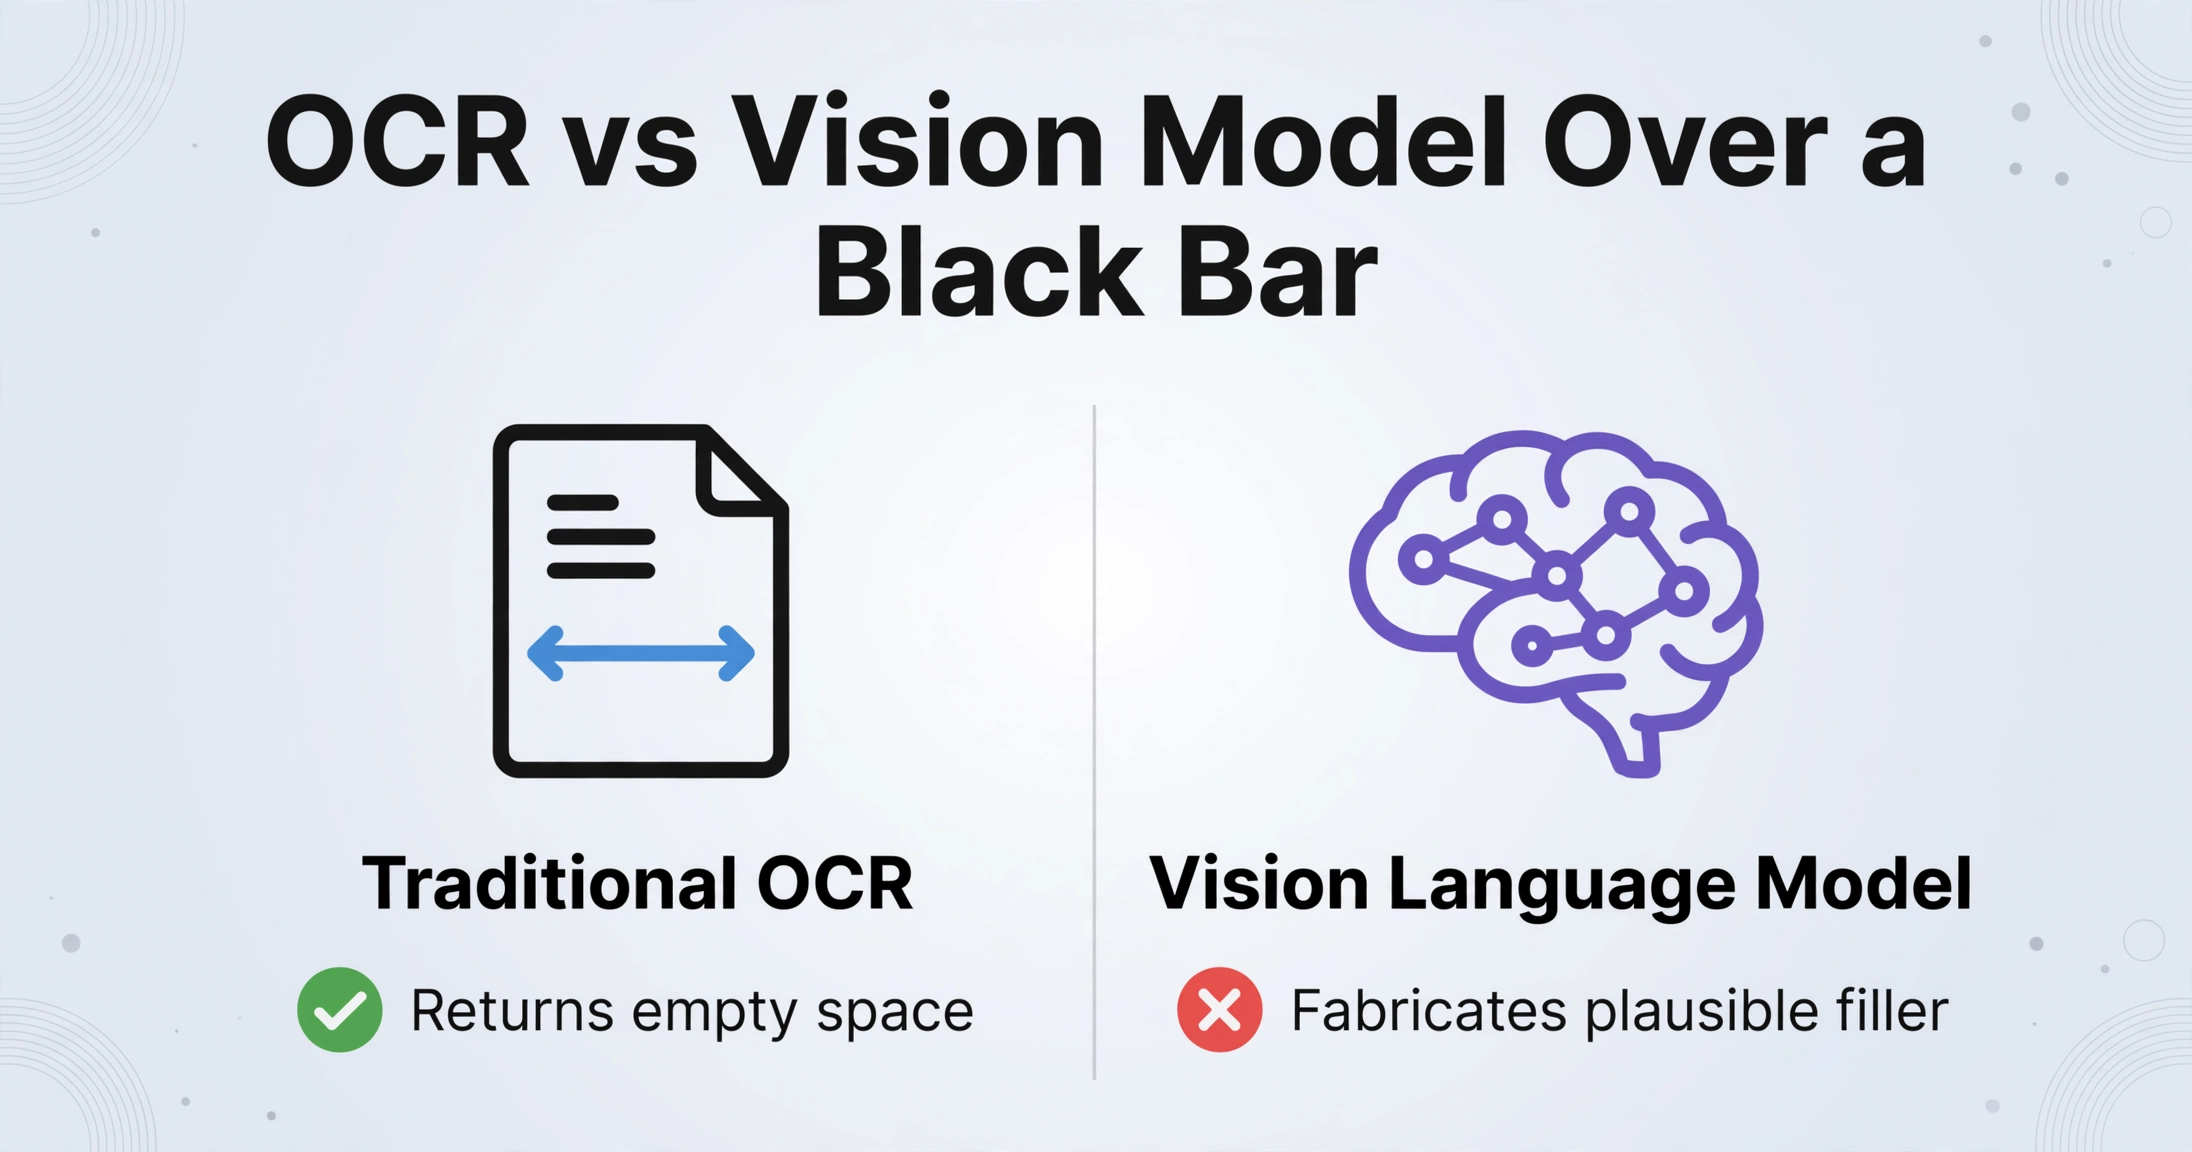
Si se apunta un motor de OCR a un rectángulo negro sólido, la salida correcta es nada. El OCR tradicional, como Tesseract o un servicio de OCR en la nube, lee píxeles, y los píxeles negros no contienen caracteres. Devuelve un espacio vacío, que es exactamente lo que se desea. Los límites de las herramientas de OCR de código abierto están bien documentados, y manejar texto ausente no es una de sus debilidades.
Un modelo de lenguaje de visión, la clase de modelo detrás de la extracción de datos moderna, es más capaz y más peligroso en este punto concreto. Si se le pide "extraer todo el texto" de una página que no puede leer por completo, un modelo capaz puede producir un relleno plausible para el hueco. Esa salida es inventada, no recuperada, y es el único modo de fallo contra el que hay que diseñar.
Un modelo que rellena una celda redactada con una suposición segura es peor que uno que la deja en blanco, porque la suposición parece un dato.
La solución es restringir la tarea. Nombre los campos que desea y deje que la herramienta informe solo de lo que puede leer. No pida "todo en la página" y nunca pregunte a un modelo qué hay detrás de una barra. Vale la pena entender la mecánica de leer una página escaneada: la extracción aquí funciona sobre píxeles renderizados en lugar de una capa de texto, que es la misma razón por la que la IA puede extraer datos de PDF escaneados que derrotan a un lector de PDF normal.
La mitad que sí escala: extraer los campos visibles de un lote
La pregunta útil no es cómo leer detrás de las barras, sino cuánto de lo que está delante de ellas se puede extraer sin leerlo a mano. Esto importa porque las publicaciones llegan en volumen. Las agencias federales recibieron un récord de 1,501,432 solicitudes FOIA en el año fiscal 2024, un aumento del 25 por ciento respecto al año anterior, y la solicitud simple promedio tardó 44 días en responderse, frente a los 39 (Oficina de Política de Información del DOJ, FY2024). Una sola publicación puede llegar a cientos o miles de páginas, y los campos que realmente se necesitan para un índice o una estadística tienden a ser los simples: fecha del documento, agencia, número de caso, número de anexo, la exención citada, un importe que nunca fue lo bastante sensible como para cubrirlo. Leer cada página para recopilarlos es el cuello de botella, y no es un problema de redacción.
La redacción en este material no es opcional. La FOIA (5 U.S.C. § 552) permite a una agencia retener contenido exento, y las presentaciones judiciales federales deben redactar parcialmente identificadores como números de Seguro Social, fechas de nacimiento, números de cuentas financieras y los nombres de menores según la FRCP 5.2, con la contraparte penal en la Regla 49.1. Las barras no van a desaparecer, y tampoco el volumen de páginas que las rodean.
Aquí es donde la extracción masiva demuestra su valor. La Extracción de Columnas Personalizadas parte de lo que usted quiere, no de lo que ofrece la página. Usted escribe los nombres de las columnas, como Agencia, Fecha del Documento, Número de Caso o Exención Citada, y el modelo localiza cada valor por significado en cada página y diseño. Un campo que fue redactado no tiene nada que leer, por lo que regresa en blanco en lugar de llenarse con una suposición. El espacio en blanco es la característica. Mantiene la hoja de cálculo honesta y hace visible un valor omitido entre miles de filas.
El Procesamiento por lotes prioritario maneja el volumen. Usted sube toda la publicación de una vez en lugar de un archivo a la vez, y los resultados se fusionan en una sola hoja de cálculo con una fila por página o documento. Eso produce un índice ordenable y filtrable de las partes legibles de la publicación, que es lo que la mayoría de las personas realmente buscan cuando consultan un flujo de trabajo de OCR por lotes. El material gubernamental conlleva sus propias restricciones más allá de la redacción en sí, y las ventajas y desventajas en torno a formularios ciudadanos, conjuntos de FOIA y archivos heredados se detallan en extracción de documentos para agencias gubernamentales.
Lo Que Ninguna Herramienta Puede Hacer
Ninguna herramienta recupera texto que fue eliminado a nivel de archivo, y cualquier producto que afirme lo contrario está adivinando. El límite vale la pena expresarlo sin rodeos:
- El contenido eliminado o incrustado es irrecuperable. Si los caracteres no están ni en el flujo de contenido ni en los píxeles, nada los reconstruye. La investigación sobre espaciado de glifos recupera longitudes y candidatos plausibles a partir de artefactos de diseño, no el texto en sí, y es una técnica de ataque más que un flujo de trabajo.
- Una caja blanca es el mismo problema, menos visible. Un rectángulo blanco sobre texto negro sigue siendo una superposición si el texto debajo nunca fue eliminado. La prueba es idéntica.
- Un escaneo aplanado es solo una imagen. Imprimir, marcar físicamente y volver a escanear produce una página sin capa de texto. El OCR lee lo que permanece visible, con la precisión que el escaneo permite, que es el rango que describe la guía general de precisión en extracción de documentos.
- El espacio en blanco es una respuesta válida. Si un campo fue redactado, la salida correcta es vacía. Espere una mezcla de celdas llenas y vacías, y diseñe el flujo de trabajo en torno a eso en lugar de combatirlo.
También hay una línea que no es técnica. Usar una redacción fallida para leer contenido que no debía tener puede violar la confidencialidad y las reglas de conducta profesional, lo cual es un problema de un orden diferente al de un error de OCR.
Preguntas frecuentes
¿Puede el OCR leer texto oculto?
Solo cuando el texto sigue en el archivo, y entonces no es el OCR el que lo encuentra. Si la redacción eliminó el contenido, el OCR ve píxeles negros y no devuelve nada. Si fue una anotación superpuesta, las palabras están en la capa de texto, y copiar y pegar, buscar o un extractor de texto las sacará a la luz.
¿Puede la IA desredactar un PDF?
No. Un modelo al que se le pida rellenar una región redactada producirá texto plausible, no el original, y no hay forma de distinguirlos solo por el resultado. Trate cualquier resultado de este tipo como inventado.
¿Cómo extraigo solo las partes visibles de un PDF redactado?
Nombre los campos que quiere y procese todo el conjunto en un solo lote. Se extraen los valores presentes en la página y los campos redactados vuelven vacíos. Esto mantiene el resultado utilizable sin pretender que se leyó el contenido oculto.
¿Es legal recuperar texto de un documento redactado?
Depende de cómo lo haya obtenido y de qué haga con él. Una redacción fallida no hace público el contenido, y usarlo puede generar problemas de confidencialidad y de conducta profesional. Verifique los documentos que produce; no extraiga datos de los documentos que recibe.
¿El OCR sigue funcionando en un documento escaneado con redacciones?
Sí. El OCR lee el texto visible alrededor de las barras igual que lee cualquier otro escaneo, y las regiones redactadas no contienen nada que reconocer. Una página escaneada con una capa OCR no depurada es el caso poco frecuente en el que el propio texto cubierto sigue siendo buscable.
El valor de una publicación redactada no está detrás de las barras. Está en los números de caso, las fechas y los nombres de agencias que están a la vista en la misma página, y esa es la parte que merece la pena automatizar. Pruebe cualquier flujo de trabajo que cree con un estándar: si rellena un campo redactado con un valor seguro en lugar de dejarlo en blanco, ha dejado de extraer y ha empezado a adivinar.