墨消し済みドキュメントの一括処理:
OCRが読めるものと、消えてしまったもの
自動化コミュニティでは、定期的に同じリクエストが寄せられます。何千もの墨消しが施されたドキュメントを、再び読めるようにしてほしいというものです。r/n8nのスレッドで、本当に必要だった自動化について尋ねたところ、ある回答は率直でした。「高度に墨消しされた何千ものドキュメントをアップロードして、墨消しを解除できるようにしたい」というものでした。
そのようなことを実現するツールはありません。その理由を最初に明確にしておく価値があります。正しく行われた墨消しは、ファイルからコンテンツを削除しています。黒いバーの背後に復元を待つデータが隠れているわけではありません。それは消えてしまったのです。しかし、残っているのは、有用なフィールドのほとんどがそもそも墨消しされていない大量のドキュメント群であり、それらを手作業で抽出する作業こそが、本当にスケールしない部分なのです。
重要なポイント
- 黒いバーは、その下で何が起きたかについては何も教えてくれません。テキストが生き残ったかどうかは、画像ではなくファイルの性質によるものです。
- 本物の墨消しによって削除されたテキストはファイルから消えているため、AIモデルにそれを埋めるよう求めると、実際の値を見つける代わりに、もっともらしい値をでっち上げてしまいます。
- 実際に必要な事件番号、日付、機関名は墨消しされていないことがほとんどです。それらのフィールドを指定して、リリース全体から一括で抽出しましょう。
墨消しはすべて同じ操作ではない
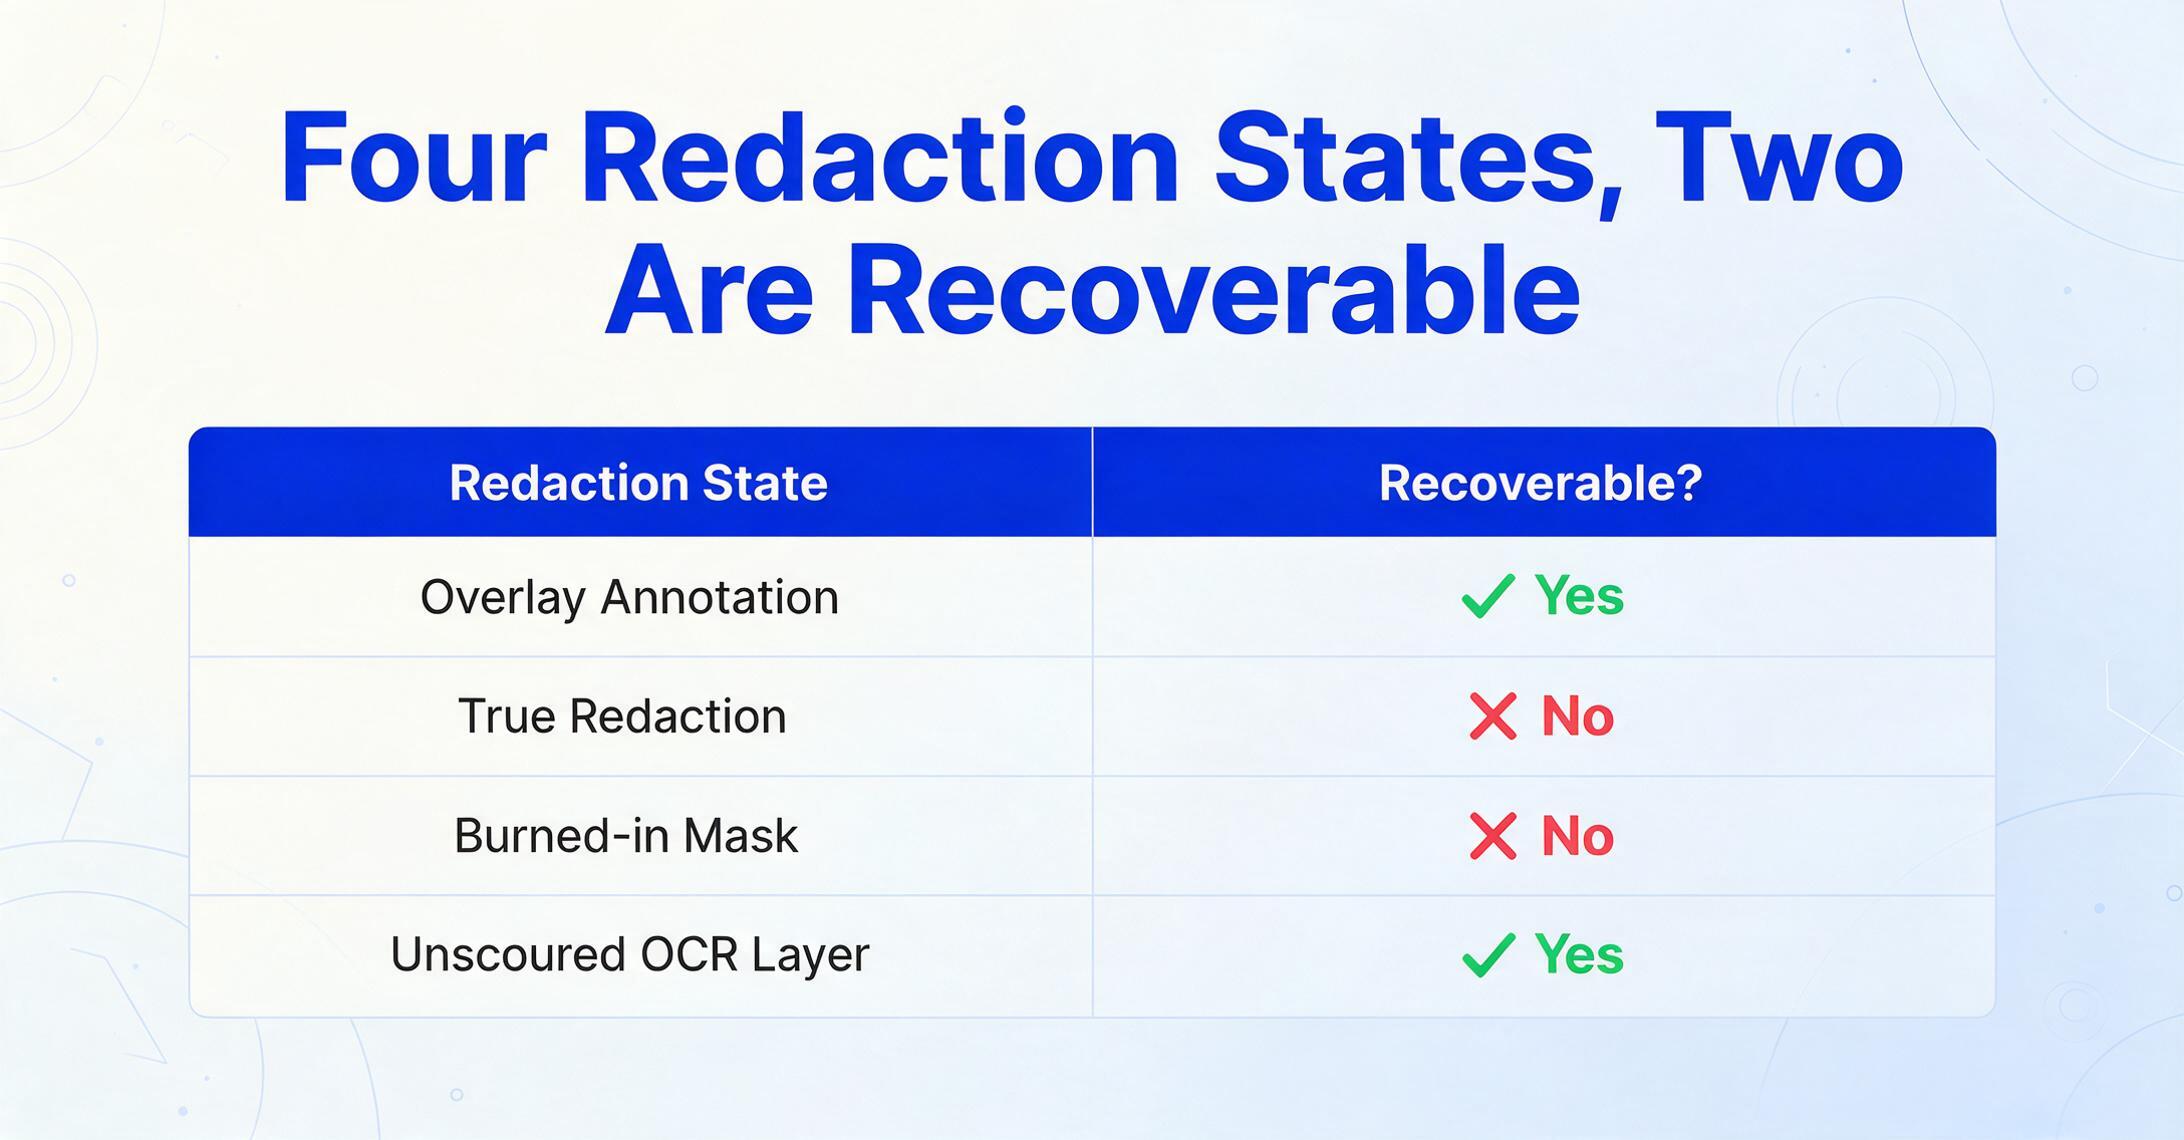
黒いバーを見ても、その下で何が起きたかはほとんどわかりません。「墨消し」はひとつの操作であるかのように使われていますが、PDFでは少なくとも4つの異なる物理的状態が生じ、そのうち実際にコンテンツを削除するのは一部だけです。どの状態にあるかによって、何かが復元できるかどうかが決まります。
| 見ているもの | コンテンツの所在 | 復元可能? |
|---|---|---|
| オーバーレイ注釈(ライブテキストの上に描かれた黒い矩形やハイライター) | テキストレイヤーは図形の下に無傷で残っている | 可。選択・コピー、または検索が可能 |
| 完全墨消し(コンテンツストリームからテキストが削除され、ボックスに置き換えられた状態) | ファイルから削除されている | 不可 |
| 焼き込みマスク(ページがラスタライズされ、ピクセルが上書きされた状態) | テキストレイヤーは存在しない | 不可 |
| 未除去のOCRレイヤー(スキャン画像にボックスが描かれているが、見えない検索可能テキストが残された状態) | 画像の背後に隠れたテキストレイヤー | 可。検索またはテキスト抽出が可能 |
| メタデータ、コメント、ブックマーク | ドキュメントのプロパティであり、ページではない | 場合による。同じ文字列が残ることがある |
この区別は理論上の話ではありません。Adobe自身のガイダンスも、コメントやマークアップ矩形をRedactツールから分離しています。描かれた図形は見た目を変えるだけだからです。Redactツールはコンテンツを完全に削除しますが、それも「適用」を選択して隠れた情報をサニタイズした後だけです。この2番目のステップを省略すると、ファイルは消えるはずだった情報のコピーを保持し続けます。
データが消えたかどうかはファイルの性質であり、画像の性質ではありません。バーは単なる描画上の選択にすぎません。
約1分で、どちらの状態かを判断する方法
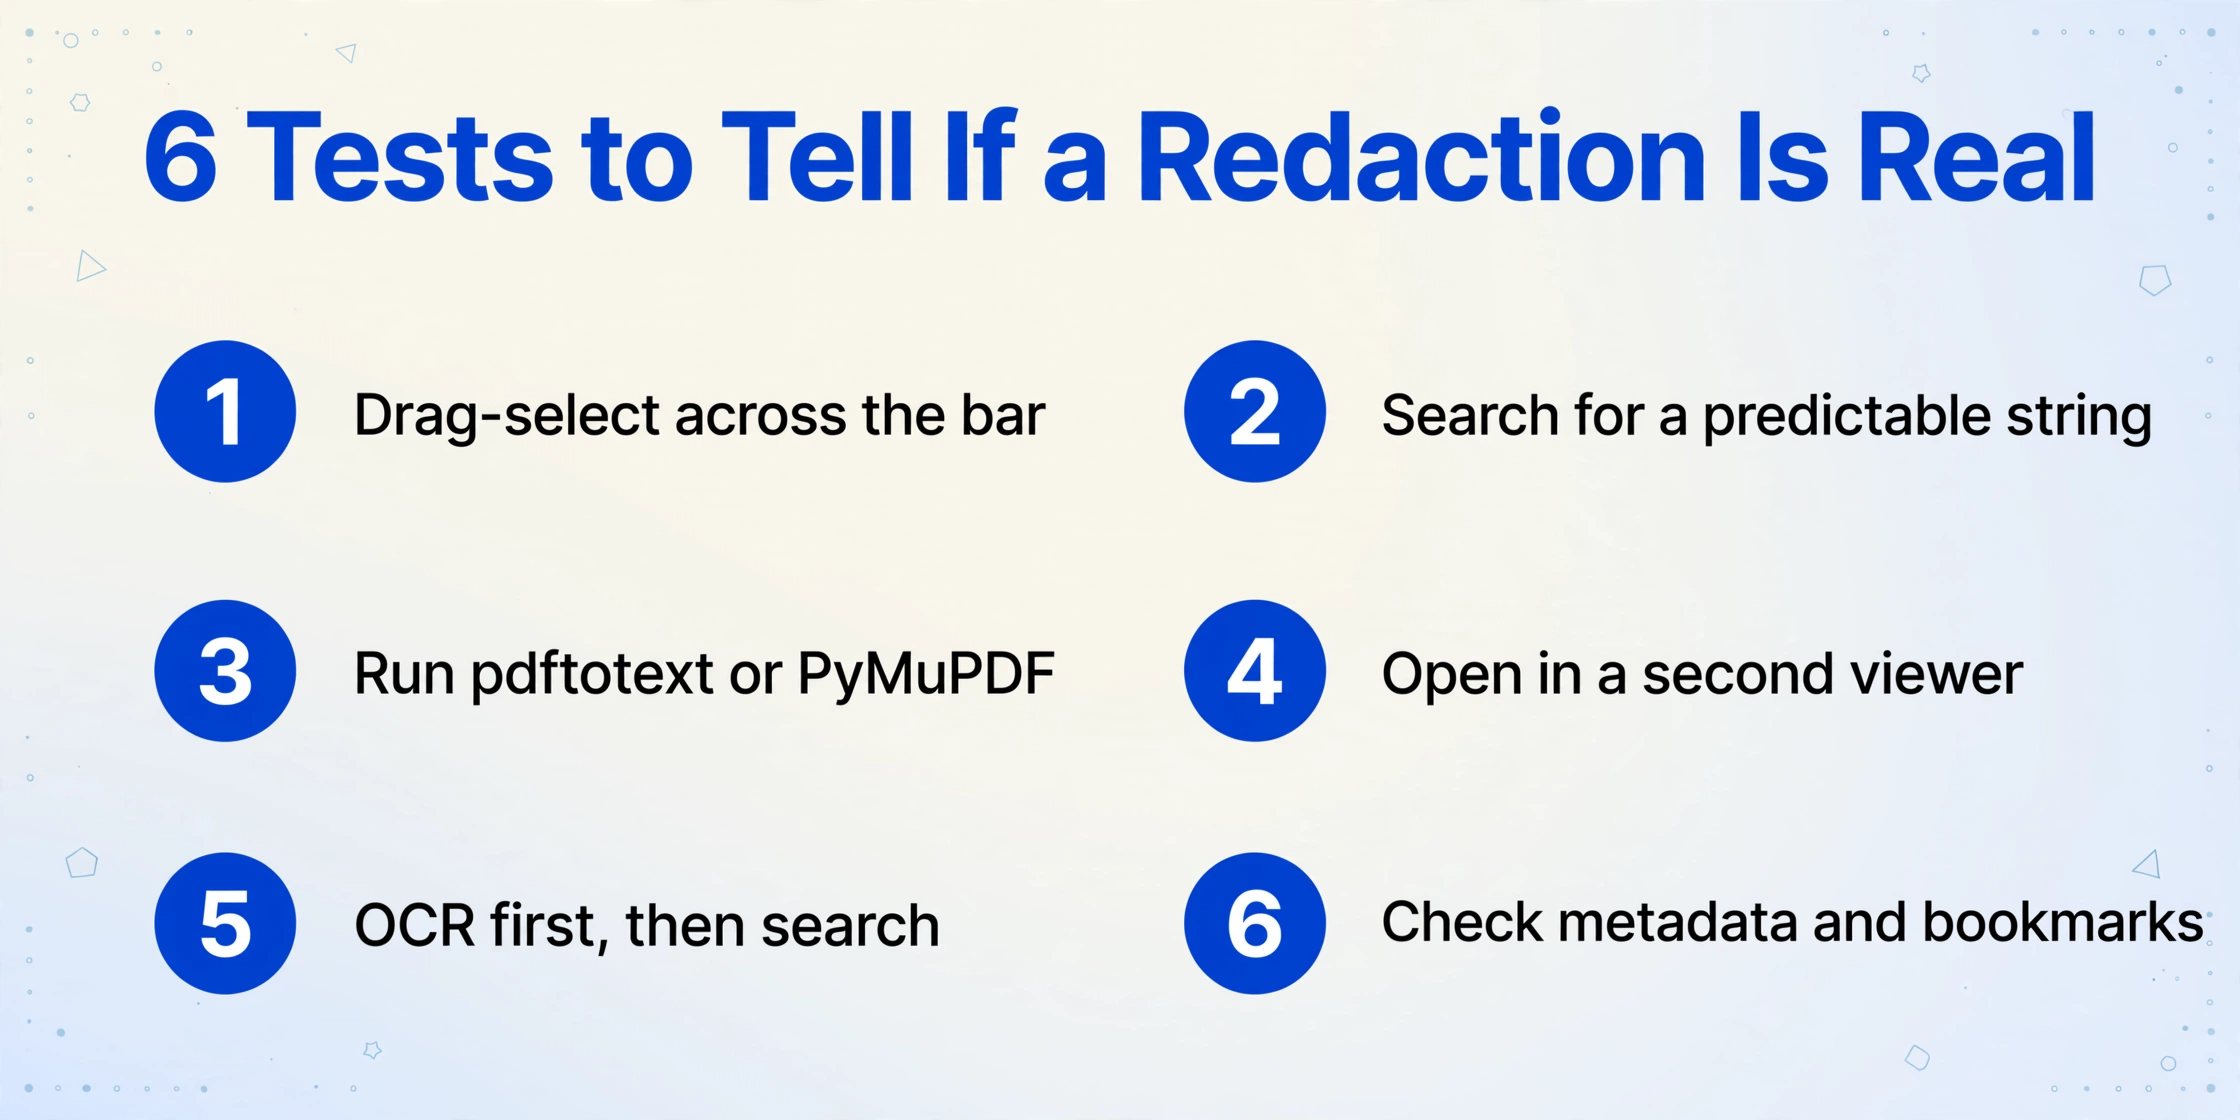
通常、お持ちのツールだけで墨消しの状態を判断できます。これらのテストには特別なソフトウェアは不要で、複数のテストに不合格となるドキュメントは、実際には墨消しされていないことになります。
バーの上をクリックしてドラッグする
黒いバーの下でテキストがハイライトされる場合、コンテンツはまだそこにあります。それをコピーしてプレーンテキストエディタに貼り付け、確認してください。この単一のテストは、2019年に弁護士が墨消しの代わりに黒い長方形を描いた後、ジャーナリストがマナフォート提出書類を読んだ方法です。
予測できる文字列を検索する
カバーされた領域に存在しそうな用語を検索機能で探します:既知の事件番号、機関の略語、「Account」、または姓などです。視覚的に黒く塗られた単語にヒットした場合、テキストレイヤーが除去されていないことを意味します。
テキスト抽出ツールを実行する
popplerツールのpdftotext、またはPyMuPDFなどのPythonライブラリは、画面ではなくコンテンツストリームを直接読み取ります。r/pdfのコメントが述べるように、「popplerのpdftotextのようなツールを使ってPDFからテキストを抽出し、墨消しされるべきテキストがまだ見えるかどうかを確認できます。」
別のビューアで開く
一部のビューアは注釈レイヤーを非表示にしたり削除したりします。別のアプリケーションで黒いボックスが消えて読み取り可能なテキストが残る場合、それらは最初から図形だったことになります。
スキャン文書の場合、まずOCR、次に検索
スキャンされたページは画像であり、検索用に不可視のOCRテキストレイヤーが追加されていることがよくあります。作成者が画像をボックスで覆ってもそのレイヤーを放置した場合、単語はまだファイル内にあります。r/datacuratorのスレッドで、ユーザーがMathpixで逆の問題に遭遇しました:「バーで消されたテキストを検出せず、代わりに画像として返します。」
メタデータ、コメント、ブックマークを確認する
ドキュメントのプロパティやレビューコメントに、ページから削除された文字列そのものが含まれていることがあります。きれいなページはきれいなファイルを保証しません。
注釈がなく、バーの下に選択可能なテキストがなく、メタデータに一致する文字列がないPDFが健全な結果です。それが正しい墨消しの姿です。
意図に関する注意点が1つあります。これらのチェックは、ドキュメントを作成する人が自分の作業を検証できるようにするためのものです。墨消しが失敗したドキュメントを受け取った場合、専門職としての責任ある対応は送信者に通知することであり、露出したコンテンツを収集することではありません。この2つの行為は技術的には同一に見えますが、他のすべての点で完全に異なります。抽出したテキストが欠落ではなく文字化けしている場合、それは別の障害モードです。フォントマップの破損または文字マッピングの失敗であり、OCRが文字化けしたテキストを生成する理由で説明しています。
きれいに見える墨消しでも情報が漏れることがある
テキストを削除しても、ドキュメントが自動的に完璧になるわけではありません。PDFには、表示されている文字以上の情報が含まれているからです。 イリノイ大学による2023年のセキュリティ研究(PETSで発表)では、墨消しボックスの周囲に残ったグリフが依然として情報をエンコードしていることが判明しました。両側の文字のサブピクセル単位の水平シフトは、削除された内容の幅を明らかにし、多くの場合、姓名を復元するのに十分な情報となります。
研究チームは11の一般的な墨消しツールをテストし、FOIA、監察総監、機密解除ドキュメントのコーパス全体で778件の脆弱な「切除型」墨消しを特定しました。さらに、テキストがそもそも削除されていなかった700件以上の公開裁判所文書も見つかりました。広く使用されている2つのオンラインツール、PDFescape OnlineとPDFzorroは、隠されているはずのテキストを完全にアクセス可能な状態にしていました。この論文はarXiv:2206.02285で入手できます。
マナフォート提出書類は、多くの人が覚えている事例です。黒い長方形は墨消し機能ではなくマークアップツールで描画され、記者がバーを選択してテキストをコピーし、新しいドキュメントに貼り付けて、提出書類が秘匿しようとした詳細を暴露しました(WIRED、2019年)。これらのギャップを埋めるのは作成者の仕事です。受け取る側にとっての実践的な教訓はより限定的です。バーがあってもテキストが消えているとは限らないと想定せず、テキストが存在することに依存するワークフローを構築しないでください。
OCRが黒いバーの上で実際に返すもの
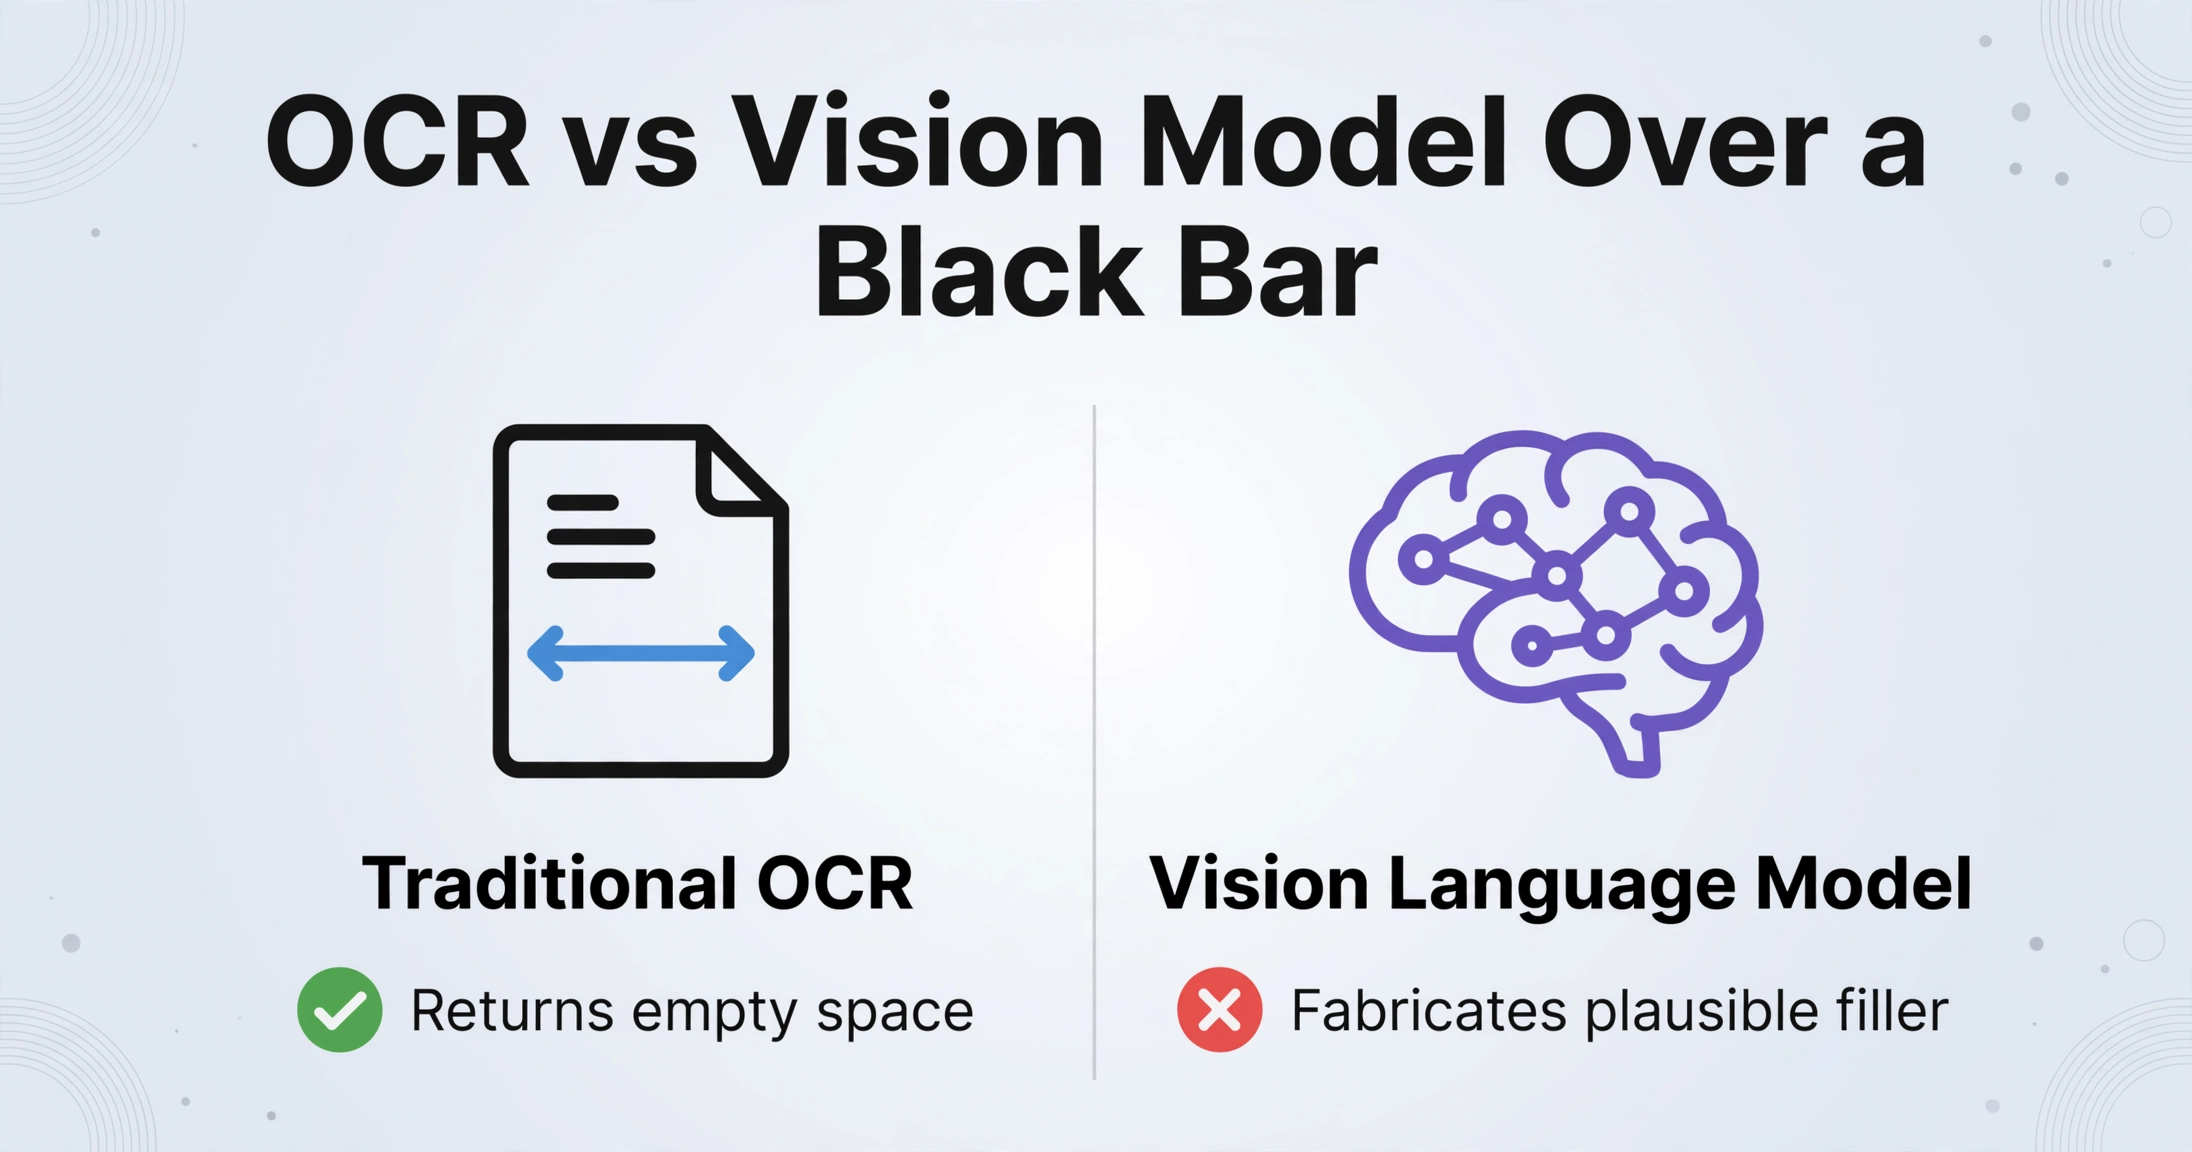
OCRエンジンを真っ黒な長方形に向けると、正しい出力は「何もない」です。TesseractやクラウドOCRサービスなどの従来のOCRはピクセルを読み取り、黒いピクセルには文字が含まれません。空のスペースを返しますが、これはまさに望ましい結果です。オープンソースOCRツールの限界はよく知られており、テキストが存在しない場合の処理はその弱点の一つではありません。
現代のデータ抽出の背後にあるモデル群である視覚言語モデルは、この特定の箇所ではより高性能であり、より危険です。完全に読み取れないページから「すべてのテキストを抽出」するよう求められた場合、高性能なモデルはその隙間に対するもっともらしい埋め草を生成できます。その出力は復元されたものではなく、捏造されたものであり、設計時に防ぐべき唯一の障害モードです。
墨消しされたセルを自信ありげな推測で埋めるモデルは、空白のままにするモデルよりも悪いです。その推測はデータのように見えるからです。
対策はタスクを制約することです。必要なフィールドを指定し、ツールが読み取れるものだけを報告させます。「ページ上のすべて」を求めず、バーの背後にあるものをモデルに尋ねてはいけません。スキャンされたページを読み取る仕組み自体を理解することは価値があります。ここでの抽出はテキストレイヤーではなくレンダリングされたピクセルに対して行われるため、通常のPDFリーダーでは扱えないスキャンPDFからのAIデータ抽出が可能になるのと同じ理由です。
スケールする半分: バッチから可視フィールドを引き出す
有用な問いは、バーの背後を読む方法ではなく、バーの前に存在する情報のうち、手作業で読まずにどれだけ抽出できるかです。これは、公開資料が大量に届くため重要です。連邦機関は2024会計年度に記録的な1,501,432件のFOIAリクエストを受け取り、前年比25パーセント増となり、単純なリクエストへの平均回答日数は39日から44日に増加しました(DOJ情報政策室、FY2024)。単一の公開資料は数百ページから数千ページに及ぶことがあり、インデックスや統計のために実際に必要なフィールドは、文書日付、機関名、事件番号、証拠番号、引用された免除条項、機密性が低く墨消しされなかった金額など、単純なものが多い傾向があります。すべてのページを読んでそれらを収集することがボトルネックであり、これは墨消しの問題ではありません。
この資料において墨消しは必須です。FOIA(5 U.S.C. § 552)は機関が免除対象コンテンツを保留することを認めており、連邦裁判所への提出書類はFRCP 5.2に基づき、社会保障番号、生年月日、金融口座番号、未成年者の氏名などの識別情報を部分的に墨消しする必要があり、刑事事件の対応規定はRule 49.1にあります。バーはなくならず、その周囲のページ量も減りません。
ここで一括抽出の価値が発揮されます。カスタム列抽出は、ページが提供する内容ではなく、ユーザーが求める内容から始まります。Agency、Document Date、Case Number、Exemption Citedなどの列名を入力すると、モデルが各ページやレイアウト全体で意味に基づいて各値を特定します。墨消しされたフィールドには読み取るべき内容がないため、推測で埋めるのではなく空白で返されます。その空白こそが特徴です。スプレッドシートの正確性を保ち、数千行の中でも欠落した値を明確にします。
バッチファースト処理がボリュームを処理します。ファイルを1つずつではなく、リリース全体を一度にアップロードすると、結果は1ページまたは1ドキュメントにつき1行の単一のスプレッドシートに統合されます。これにより、リリースの読み取り可能な部分の並べ替え・フィルタリング可能なインデックスが生成され、バッチOCRワークフローを検索する多くのユーザーが実際に求めているものになります。政府資料には墨消し以外にも独自の制約があり、市民フォーム、FOIAセット、レガシーアーカイブに関するトレードオフは政府機関向けドキュメント抽出で説明されています。
どのツールにもできないこと
ファイルレベルで削除されたテキストを復元できるツールはなく、それを主張する製品は推測しているにすぎません。この境界線は曖昧にせず明確に述べる価値があります。
- 切除または焼き込みされたコンテンツは復元できません。文字がコンテンツストリームにもピクセルにも存在しない場合、それらを再構築する方法はありません。グリフ間隔の研究は、レイアウトの痕跡から長さと可能性のある候補を復元するものであり、テキスト自体を復元するものではなく、ワークフローではなく攻撃手法です。
- 白いボックスも同じ問題で、見えにくいだけです。黒いテキストの上に白い長方形を置いても、下のテキストが削除されていなければオーバーレイです。テストは同じです。
- フラット化されたスキャンは単なる画像です。印刷し、物理的にマークし、再スキャンすると、テキストレイヤーのないページが生成されます。OCRは、スキャンが許す精度で、表示されているものを読み取ります。これは一般的なドキュメント抽出精度ガイドで説明されている範囲です。
- 空白は有効な回答です。フィールドが墨消しされた場合、正しい出力は空です。埋まったセルと空のセルが混在することを想定し、それに対抗するのではなく、それに基づいてワークフローを設計してください。
また、技術的ではない線引きもあります。失敗した墨消しを利用して閲覧が許可されていないコンテンツを読むことは、機密保持および職業倫理規定に違反する可能性があり、これはOCRのミスとは異なる種類の問題です。
FAQ
OCRは墨消しされたテキストを読み取れますか?
テキストがまだファイル内に残っている場合のみ可能ですが、その場合でもOCRがそれを見つけるわけではありません。墨消しがコンテンツを削除した場合、OCRは黒いピクセルを認識し、何も返しません。オーバーレイだった場合、単語はテキストレイヤーに残っており、コピー&ペースト、検索、またはテキスト抽出ツールで表示できます。
AIはPDFの墨消しを解除できますか?
いいえ。墨消しされた領域を埋めるように求められたモデルは、元のテキストではなくもっともらしいテキストを生成し、出力だけから両者を区別する方法はありません。そのような結果はすべて捏造されたものとして扱ってください。
墨消し済みPDFの表示部分だけを抽出するにはどうすればよいですか?
必要なフィールドを指定し、セット全体を1つのバッチで処理します。ページ上に存在する値は抽出され、墨消しされたフィールドは空白で返されます。これにより、隠されたコンテンツを読んだふりをせずに、結果を活用できます。
墨消しされた文書からテキストを復元することは合法ですか?
入手方法とその後の利用方法によります。墨消しの失敗はコンテンツを公開するものではなく、それを利用すると守秘義務や職業倫理上の問題が生じる可能性があります。作成する文書は検証し、受け取った文書を採掘しないでください。
墨消しのあるスキャン文書でもOCRは機能しますか?
はい。OCRは他のスキャンと同様にバーの周囲の表示テキストを読み取り、墨消しされた領域には認識するものは何もありません。未除去のOCRレイヤーがあるスキャン済みページは、覆われたテキスト自体が依然として検索可能な稀なケースです。
墨消しされた公開文書の価値はバーの背後にはありません。同じページに平文で存在する事件番号、日付、機関名にあり、そこが自動化する価値のある部分です。構築するワークフローは1つの基準でテストしてください。墨消しされたフィールドを空白のままにせず、確信を持った値で埋める場合、それは抽出をやめて推測を始めていることになります。