AI OCRは手書きを読み取る
従来のOCRが対応できない領域
300 DPIでスキャンされたきれいな印刷済み請求書は、TesseractやGoogle Cloud Visionで処理すると99%の文字精度が得られます。媒体を変えるだけで—同じ請求書に手書きで記入した場合—精度は50%を下回ります。この差はキャリブレーションの問題ではありません。構造上の問題です。従来のOCRは、既知のテンプレートに対して静的な文字形状をマッチングするように設計されています。手書きにはテンプレートがありません。同じ人が同じ文字を2回書いても、2つの異なる形状が生成されます。AIビジョンモデルはまったく逆の方向からこの問題にアプローチします。単語を視覚パターンとして読み取り、周囲の文脈を使って、そうでなければ曖昧なストロークを明確化するのです。
重要なポイント
- 300 DPIの印刷済み請求書は従来のOCRで99%の文字精度を返しますが、同じ請求書に手書きで記入すると50%を下回ります。スキャン品質が悪くなったからではなく、ツールが筆記体を意図的につなげる文字を分離するように設計されているからです。
- 筆記体の文書に対するクラウドOCRでは、100語中30〜50語が誤って返され、コントラスト調整では修正できません。問題は画像パイプラインではなく、文字セグメンテーションの構造にあります。
- 人間は個々の文字をつなぎ合わせるのではなく、単語全体を見て手書きを読み取ります。AIビジョンモデルも現在は同様の方法を採用しており、ImageToTable.aiではフィールド精度が85〜95%に向上し、手書きのタイムシート100枚の検証が300分ではなく3分で完了します。
手書きで文字単位の読み取りが崩れる理由
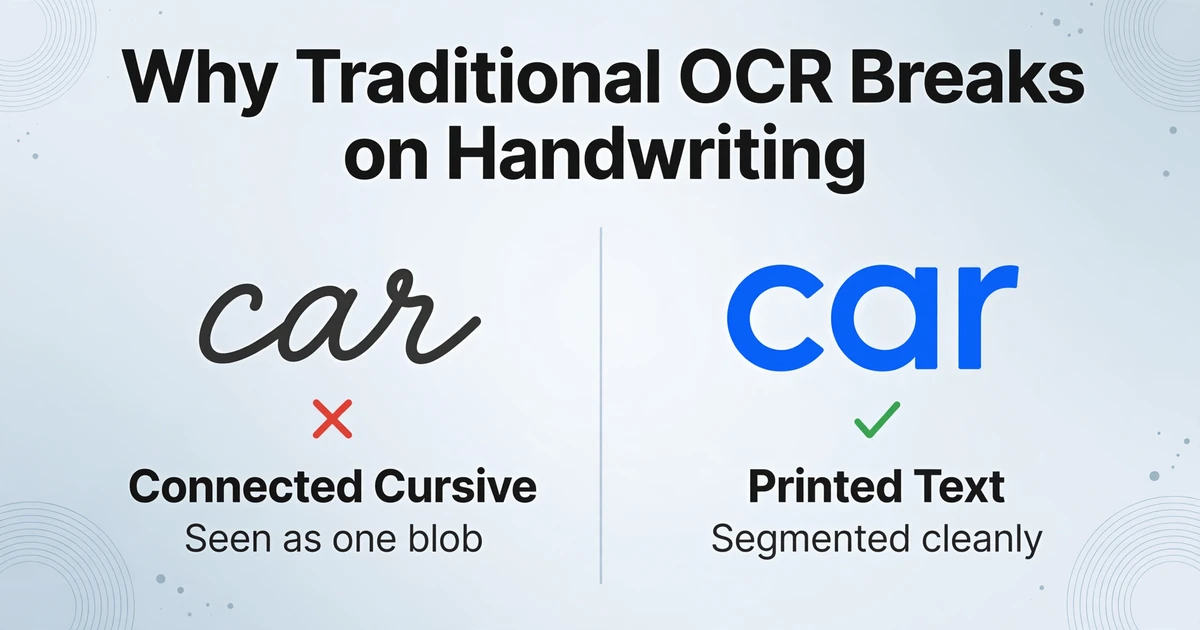
従来のOCRはセグメンテーション優先のモデルで動作します。エンジンは画像をスキャンし、空白の境界を検出して各文字を分離し、分離した形状を既知のグリフのライブラリと照合します。このパイプラインは文字が予測可能な場合——印刷されたArialの「A」が保存済みのArialの「A」テンプレートにきれいに一致する場合——に機能します。しかし文字が予測可能なボックスに収まらない場合、崩壊します。
手書き文字を従来のOCRにとってのセグメンテーションの悪夢にする構造的な問題は3つあります。連結文字——筆記体は隣接する文字をリガチャで結合するため、「car」の「a」と「r」の間のスペースを境界検出アルゴリズムが見つけることは不可能です。エンジンは人間が4文字と認識する箇所を1つの連続したグリフとして認識します。可変のストローク幅——ボールペンを下線で強く、上線で弱く押すと線幅の変化が生じ、1つの文字が別々の検出セグメントに断片化されます。「5」がブロブと別のダッシュになります。不安定なベースライン——人は斜めに書き、ページ全体で上方向にずれ、同じ単語内でも文字の高さが変わります。活字テキストで機能する行検出ステップは、「apple」が15度の角度で書かれ、「p」がベースラインの下に沈み、「l」がその上に上がっている場合には失敗します。
下流への影響は連鎖的です。International Journal of Computer Scientific Technology & Electronics Engineeringに掲載された2025年の研究では、手書き文書に対する従来のOCRの精度は、きれいな手書き活字体で92%から、中程度の劣化で55%、深刻な条件下では30%にまで低下することが判明しました——これは印刷テキスト処理ではノイズとしてほとんど認識されない条件です。一方、AIMultipleの2026年筆記体ベンチマークは、14モデルで100サンプルをテストし、Google Cloud VisionやAmazon Textractなどの従来のクラウドOCRサービスが筆記体で50%から70%の範囲に留まることを明らかにしました——つまり100語中30〜50語が誤りということです。
Redditのデータ入力コミュニティは、このギャップを何年も記録してきました。2024年のr/Automateでの手書き請求書からのデータ抽出に関する議論は、この問題を簡潔に表現しています。「手書きデータだけでなく、非構造化された手書きデータを取得し、それを理解可能にする必要がある」。r/computervisionコミュニティの2025年の手書きOCRツールのレビューは、新しいAIモデルの「手書き精度(約65〜85%)は、業務上重要な用途向けの専門ソリューションに依然として遅れを取っている」と率直に指摘しました。これらはマーケターではなく実務者です。彼らの数値は重要です。
AIビジョンモデルが手書きを文字列ではなく視覚パターンとして読む仕組み
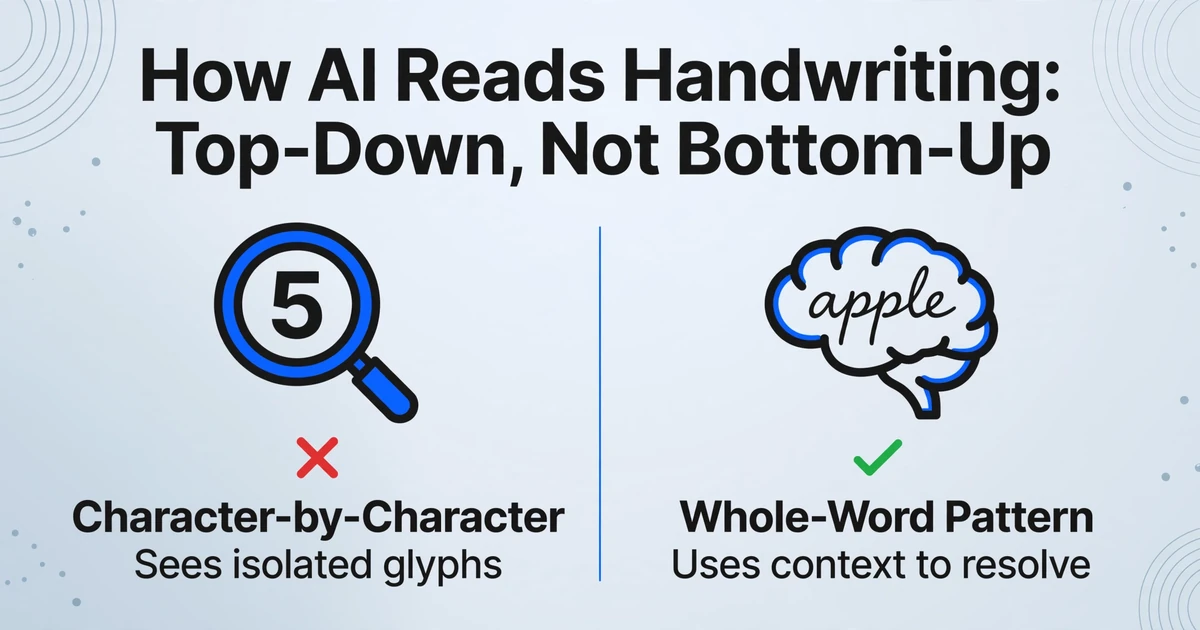
AIビジョンモデル — より正確には、GPT-5、Gemini、Claudeなどのビジョン言語モデル — は文字セグメンテーションを一切行いません。画像を全体的に処理し、単語全体の形を統一された視覚パターンとして捉え、そのパターンを、その単語が含まれる文章を理解するのと同じ言語モデルで解釈します。これが重要な逆転です:文字から単語を構築するのではなく(ボトムアップ)、単語を視覚的な全体として認識し、理解した単語を使って個々の文字の形を曖昧さなく特定します(トップダウン)。
実際の違いは、フォームの名前欄のようなありふれたもので最もわかりやすく確認できます。書き手のペンが「Sm_th」の途中でわずかに浮き上がり、「m」と「t」の間に薄い文字や欠落した文字が残る手書き入力を想像してください。従来のOCRは文字単位で処理するため、「Sm」+認識できないグリフ+「th」を返します。エラーは積み重なり、完全な名前は後段で認識不能になる可能性があります。AIビジョンモデルは「Sm_th」という単語の形と周囲の文脈を見ます — これはフォームの「名前」欄で、フルネームは「John Smith」です。言語モデルは、あなたが自分の目で見た場合と同じように、文脈からギャップを埋めます。同じ仕組みで、手書きの「1」と小文字の「l」、「0」と「O」、「9」に見える手書きの「4」も、「ここでは何が意味を成すか?」と問いかけることで解決します。
これが、現代のAIビジョンモデルが手書き文字において従来のOCRを劇的に上回る理由です。AIMultipleのベンチマークでは、筆記体認識でGPT-5とGemini 3 Pro Previewがトップに位置しました — それは文字検出器が優れているからではなく、テキストの意味を理解することで、人間と同じようにドキュメントを読むからです。同じベンチマークで、Google Cloud Visionは筆記体で約63%でした。95%と63%の差は、「スポットチェックで使える」と「完全な手動再入力が必要」の差です。
この意味論的アプローチこそが、AIによるデータ入力を設計上テンプレート不要にしている理由です。抽出したい列名 — 「従業員名」「労働時間」「日付」 — を入力すると、AIはその意味を理解することで、ページ上のどこにあっても各フィールドに対応する手書きの値を特定します。ピクセル座標は不要。フォームごとのテンプレートも不要。誰かの手書きが変わっても再トレーニングは不要。これが私たちがカスタム列抽出と呼ぶ仕組みです:抽出したい列に名前を付けて出力スキーマを定義すると、AIは各手書き値がページのどこにあっても、ドキュメントのコンテンツをスキーマにマッピングします。
ファイルは安全に処理され、保存されることはありません。
印刷と手書きの混在:誰も語らない、最も一般的なドキュメント形式
実際の手書きドキュメントのほとんどは、完全な手書きではありません。それらはフォームです。つまり、ラベル、ボックス、指示が印刷されたテンプレートに、ペンで記入されたものです。「患者名:」というラベルはHelveticaで印刷されています。「James Peterson」という値はボールペンの筆記体で書かれています。印刷用に調整された従来のOCRエンジンは、ラベルを完璧に読み取り、値の読み取りに失敗します。その結果、テキストの80%は正しく、実際に必要な20%が欠落したドキュメントが生成されます。
この印刷と手書きの混在フォーマットこそ、AIビジョンモデルが競合他社に対して最も強い優位性を発揮する分野です。モデルは「印刷モード」と「手書きモード」を切り替えるわけではありません。ページ全体を単一の視覚シーンとして読み取り、「患者名」がフィールドラベル(印刷、鮮明)であり、その下の走り書きがフィールド値(手書き、乱雑)であることを認識し、両方を正しい出力列にマッピングします。印刷されたラベルのコンテキストは、手書き認識を積極的に支援します。ラベルが「電話番号」と表示されていれば、モデルは値フィールドに数字の連続を期待し、認識問題を制約します。ラベルが「コメント」と表示されていれば、モデルは完全な文章を期待し、それに応じて調整します。
このフォーマットは至る所に存在します。医療用問診票(印刷された人口統計の質問、手書きの回答)、現場点検報告書(印刷された安全チェックリスト項目、メモ欄の手書きの所見)、配送確認書(印刷された追跡番号、手書きの受取人の署名とタイムスタンプ)、ベンダー見積書(印刷された明細項目、手書きの数量修正)。これらすべてにおいて、ワークフローのボトルネックは「ドキュメントを読むこと」ではありません。「実行可能なデータを含む手書き部分を読むこと」です。従来のOCRはラベルテキストを無料で提供し、値に対して高いコストを請求します。AIビジョンは両方を1回のパスで読み取ります。
ラベルと値をコンテキストで読み取るという概念は、単なる手書きソリューションではありません。これはAI OCRと従来のOCR精度の違いの根本的な差です。従来のOCRは「日付:03/15/2026」を文字列として認識します。AI抽出は、セマンティックタイプ(カレンダー日付)を持つフィールドラベル(「日付」)を認識し、同じページに他の5つの日付が存在する場合でも、値を正しいスプレッドシートの列に配置します。どの日付がどのラベルに属するかを理解しているからです。
チェックボックス、チェックマーク、丸印:形ではなく意図を読む
紙のフォームのチェック済みボックスは、塗りつぶし、斜線、×印、チェックマーク、丸で囲んだ回答、誤った選択肢への走り書きの取り消し線、正解の下への二重下線など、さまざまな形をとります。従来のOCRエンジンにとって、これらはどれもテキストではなく、画像ノイズです。エンジンはこれらを無視するか、さらに悪いことに、マークを文字として誤読します。チェックマークは「V」に、斜線は「/」に、丸で囲んだ選択肢は回答テキストの前に「O」が付いたように読まれます。
この問題は構造化フォームではさらに深刻です。Yes/Noチェックボックスが20個ある安全点検チェックリストには、コンプライアンス、保守スケジュール、責任の所在を左右する20の二択判断が含まれています。エンジンが20個中5個を誤読したら、自動化は役に立たないどころか、正しく見える誤ったデータを静かに生成してしまいます。「安全」とマークされた項目が、エンジンがチェックマーク✓を誤った選択肢の横の文字「V」として解釈したために「不安全」になってしまいます。
AIビジョンモデルは、文字検出ではなく空間的関係に基づいて動作するため、チェックボックスの扱いが異なります。モデルは質問テキスト(「消火器は点検済みか?」)と回答選択肢(「はい/いいえ」)を特定し、どの回答領域にマークがあるかを判断します。マークは何でも構いません。チェック、×、塗りつぶした丸、走り書きの線——すべて「この選択肢が選択されている」として認識されます。モデルはマークの種類を分類する必要はありません。マークとそれが修飾する選択肢との空間的なつながり、つまり選択の意図を分類するのです。
GoogleのDocument AIチームは、開発者フォーラムでこの課題を直接取り上げています。実務者によると、フォームが印刷・記入・スキャンのパイプラインを通過する場合、チェックボックスを大きくしても検出は失敗することが報告されています。推奨されるチェックボックス寸法(12〜15mm)は、フォームのデザインを管理できる場合にのみ適用されます。すでに流通している、より小さなボックスを持つ何千もの既存フォームについては、答えは形状の幾何学ではなく空間的意図を読み取るAIモデルです。
AIがまだ確実に読めないもの
限界を正直に認めることが、AI手書き文字抽出の信頼性を高めることにつながります。ここでは、まだ対応が難しいケースを紹介します。
大きく重なり合う筆記。ある行の手書き文字が別の行の上に直接書かれている場合(元の記入の上に修正を重ねて書くことが一般的な帳簿など)は、従来のOCRもAIビジョンモデルも苦戦します。モデルには、2つの意味の層がある場所が1つの視覚的な塊として見えます。文書の経緯に関する文脈を持つ人間なら、それらを区別できるかもしれません。現在のAIにはそれができません。
極端に様式化された署名。署名は、読めるテキストではなく、本人確認の印として機能します。装飾、判読不能なループ、個人的なグリフを組み合わせた、意図的にユニークなパターンです。AIモデルは署名が存在することを検出できます(文書上の署名領域を特定できます)が、署名の形状自体から署名者の名前を抽出することはできません。名前は、文書の別の場所にある印刷テキストまたは手書きテキストに表示される必要があります。
暗い背景の薄い鉛筆書き。低コントラストでスキャンされたコピー用紙の鉛筆書きは、紙の粒子とほとんど区別がつかない文字のストロークを生成します。2025年の手書き文字認識技術に関する学術調査では、「ノイズ耐性」が依然として主要な未解決問題の1つであると指摘されており、「研究者は、OCRシステムの耐性を高める方法の調査を継続すべきである」と、最適とは言えない実世界の条件に対して述べています。これは従来型システムとAIベースのシステムの両方に当てはまります。
非ラテン文字。パフォーマンスはモデルに大きく依存します。GPT-5とGeminiは、アラビア文字、デーヴァナーガリー文字、漢字を含む主要な文字で優れたパフォーマンスを発揮します。特に、モデルがこれらの文字体系でトレーニングされている場合に顕著です。小規模または特殊なモデルは、ラテン文字の筆記体では良好なパフォーマンスを発揮しても、他の文字体系ではパフォーマンスが急激に低下する場合があります。文書に複数の文字体系の手書きテキストが含まれている場合は、導入前に特定のモデルを文書でテストしてください。複数文字対応の手書き文字認識は、まだ均一に解決されていません。
劣化した紙の歴史的文書。裏抜け(紙を通して裏面のインクが見える状態)、狐状斑点(経年による斑点)、水濡れ、破れのある文書は、文字レベルと全体認識の両方を混乱させる視覚的アーティファクトを生み出します。AIMultipleのベンチマークでは、最高性能のモデルでも文書の状態が悪化すると10〜15パーセントポイントの精度低下が見られることが判明しました。アーカイブ品質のデジタル化には、汎用AI抽出ツールには含まれない専門ツールと個別の前処理パイプラインが必要になる場合があります。
手書き抽出が重要となる実際のワークフロー
テクノロジーは、実際のワークフローを変える場合にのみ意味を持ちます。ここでは、手動での再入力からAI手書き抽出に切り替えることで、測定可能な時間節約が実現するシナリオを紹介します。
手書きのタイムシート。建設現場の作業員、フィールドサービスの技術者、交代制の労働者は、紙のタイムシートに記入します。名前、日付、時間、ジョブコードなどが、シフト終了時に窮屈で乱雑な手書きで書かれることがよくあります。週に80枚のタイムシートを処理する給与管理者は、1枚あたり約3分を手動データ入力に費やします。各フィールドを読み、給与システムに入力し、合計を検証するのです。これは週に4時間、つまり丸々1朝分を手書きの再入力に費やしていることになります。AI抽出を使えば、同じ80枚のタイムシートをバッチでアップロードし、「従業員名」「日付」「時間」「ジョブコード」という列名を持つ単一のスプレッドシートに抽出し、1分以内にエクスポートできます。管理者の役割はデータ入力から例外処理へと移行します。手書きが本当に曖昧だった5〜10件のエントリをスポットチェックするだけです。
FLSA第11条(c)に基づき、雇用主は労働時間や支払われた賃金を含む正確な給与記録を保持する義務があります。給与に反映される手書きタイムシートのエラーはコンプライアンス上のリスクを生み出し、事後修正は入力時の発見よりもコストがかかります。
現場点検フォーム。安全検査官、品質監査人、現場監督者は、現場で紙のチェックリストに記入します。多くの場合、クリップボードに、雨の中で、インクが少なくなったペンで記入します。各フォームには、チェックボックス(機器の合格/不合格)、手書きの数値読み取り(圧力、温度、電圧)、自由記述のメモ(観察事項、是正措置)が含まれます。50枚の点検フォームを手動で処理するには丸1営業日かかります。ノーコードAIデータ入力を使えば、同じバッチが数分で抽出されます。チェックボックスの状態、数値読み取り、記述メモがそれぞれ独自のスプレッドシート列に流れ込みます。金曜日の午後を費やしていたコンプライアンスレポートが、金曜日の朝には完成します。
患者受付フォーム。医療クリニックは1日あたり60件の新規患者受付フォームを処理します。病歴、現在の服薬、アレルギー一覧、保険情報など、すべて待合室で患者が手書きで記入します。フロントデスクのスタッフは各フォームを手動でEHRシステムに入力します。このプロセスは1フォームあたり5〜7分かかり、スタッフが読みにくい手書きと医療用語データベースの間を行き来するため、転記エラーが発生します。AI抽出は手書きフィールドを読み取り、「薬剤名」「投与量」「頻度」などの正しいEHRデータカテゴリにマッピングし、信頼度の低い値は患者記録に入る前に人間による検証用にフラグを立てます。
手書きの台帳とレシート帳。小規模事業者(フードトラック、市場の販売業者、個人事業主)は、手書きの台帳を維持することがよくあります。販売業者のカーボンコピー式レシート帳には、日付、商品説明、金額、顧客名など、すべてペンで書かれた何百ものエントリが含まれます。確定申告の時期には、これらをデジタル化する必要があります。従来のOCRはカーボンコピー紙では役に立ちません。かすれた青みがかった文字は、コントラストベースの検出を混乱させるからです。AIビジョンモデルは、多様な実世界の画像でトレーニングされており、ピクセルを白黒に閾値処理するのではなく、ページをシーンとして理解することで(かすんだ文字、紙の質感、行と列のレイアウトパターン)、エントリを読み取ります。
配達確認書。物流企業は、署名済みの配達確認書(印刷された配送明細に、手書きの受取人名、タイムスタンプ、状態メモが記載されたもの)を受け取ります。手書きの受取人名は、配達証明の法的記録です。AI抽出により、フォームから受取人名とタイムスタンプを取得し、手動での再入力なしに配達確認データベースへ入力します。
手書きのレシピカードと個人記録。すべての手書き文書がビジネス書類というわけではありません。家族のレシピカードには、筆記体のメモ、分数の数量(「1½カップ」)、略語が、フォーム設計者が計画していないレイアウトで混在しています。フィールドメモを読み取るのと同じ意味抽出が、写真内の手書きレシピカードを読み取り、材料、数量、手順を、手で打ち直したページではなく、スプレッドシートの列として返します。
精度の期待値: 生産環境における手書き文字認識の85〜95%とは
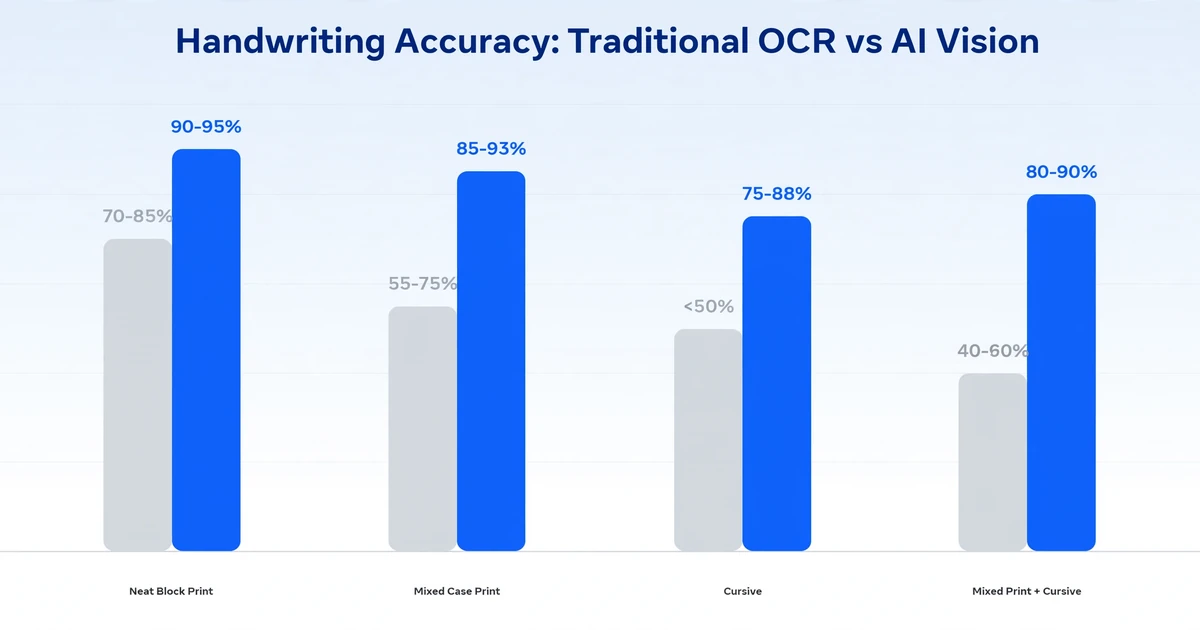
AI業界の標準的な精度に関する免責事項「印刷テキストで最大99%」は、手書き文字には当てはまらない期待値を生み出します。手書き文字の精度は、根本的に異なる尺度での根本的に異なる数値です。実際に期待すべきことは次のとおりです。
| 手書きスタイル | 従来のOCR | AIビジョンモデル | 実際の運用結果 |
|---|---|---|---|
| 整ったブロック体(大文字のみ) | 70-85% | 90-95% | 10フィールドに1つをスポットチェック |
| 大文字小文字混在のブロック体 | 55-75% | 85-93% | 7フィールドに1つをスポットチェック |
| 筆記体 | 50%未満 | 75-88% | 4フィールドに1つをスポットチェック |
| ブロック体と筆記体の混在 | 40-60% | 80-90% | 5フィールドに1つをスポットチェック |
| 劣化・低コントラスト | 30%未満 | 65-80% | ベストエフォート抽出。人間によるレビューが必要 |
出典: AIMultiple 筆記体ベンチマーク(2026年); IJCSTEE 従来のOCRとAI OCRの精度比較研究(2025年); クラウドOCRサービス全体での実地ベンチマーク。すべての数値はフィールドレベルの精度を反映しています。つまり、スプレッドシートで抽出された値が手書きの原本と一致するかどうかであり、文字レベルの精度ではありません。
この表で最も重要な数字は、個々の精度の数値ではありません。AI抽出時間と手動検証時間の比率です。きれいなブロック体で書かれた手書きのタイムシート100枚の場合、AI抽出は30秒未満で完了し、検証が必要なフィールドはおよそ5〜10個で、人間によるレビューは3分です。同じ100枚を手動で入力する場合: およそ300分かかります。AIの精度が100%である必要はなく、検証がゼロから打ち直すよりも速くなる程度に高ければ、90%以上の時間削減を実現できます。
これこそが、精度の議論を学術的なものではなく実用的なものにする点です。AIデータ入力の精度は、マーケティング上の数値を達成することではありません。AI出力の検証コストが手動入力のコストを下回る閾値を超えることです。印刷テキストの場合、その閾値は何年も前に超えられました。きれいなブロック体の手書きの場合、GPT-4レベルのビジョンモデルで超えられました。読みにくい筆記体の場合、今まさに超えられようとしていますが、検証ステップは必須です。
FAQ
AI OCRはあらゆる手書きスタイルを読めますか?
あらゆるスタイルというわけではありませんが、一般的なスタイルのほとんどは読めます。きれいなブロック体と大文字小文字混在の活字体は、現在のAIビジョンモデルで85〜95%のフィールド精度を達成します。筆記体は75〜88%です。装飾が強く、重なり合っていたり、極端に読みにくい手書きは70%を下回る可能性があります。スキャンから自分で自信を持って読めない場合、AIもおそらく読めません。実用的なアプローチ: すべてをバッチアップロードし、AIに抽出できるものを抽出させ、低信頼度のエントリのみを手動でレビューします。
AIはチェックボックスやフォーム要素も処理できますか、それともテキストだけですか?
AIビジョンモデルは、文字の形ではなく空間的な意図を読み取ることで、チェックボックス、ラジオボタン、丸で囲んだ選択肢、その他のフォーム記号を処理します。選択肢の横にあるチェック、バツ、塗りつぶし、丸はすべて「選択済み」として認識されます。これはフォームのレイアウトが明確な場合に最も効果的です—隣接する選択肢から視覚的に明確に分離された回答領域がある場合です。密度の高いフォームに密集したチェックボックスは、人間による確認が必要な曖昧さを生じる可能性があります。
AI手書き文字認識と従来のICRの違いは何ですか?
従来のICR(インテリジェント文字認識)は、手書きデータセットでトレーニングされた機械学習でOCRを拡張しますが、それでも文字セグメンテーションモデルに基づいて動作します—個々の文字を分離して分類します。AIビジョンモデルはセグメンテーションを完全にスキップし、単語全体の形を視覚パターンとして読み取り、言語コンテキストを使用して曖昧な文字を解決します。実際の違い:ICRは整ったブロック体では機能しますが、筆記体では精度が低下します。AIビジョンは両方で機能し、その間の精度低下はより小さくなります。
手書き文書と印刷文書を同じバッチで処理できますか?
はい。AIビジョンモデルは各ドキュメントをシーンとして読み取ります—テキストが印刷か手書きかを事前に知る必要はありません。同じバッチに、タイプされた請求書、手書きのタイムシート、混合形式の検査フォームを含めることができます。モデルはバッチ単位ではなく、ドキュメント単位で読み取り戦略を適応させます。これは、印刷入力と手書き入力で別々の設定を必要とすることが多い従来のOCRパイプラインとの重要な違いです。
手書き抽出は英語以外の言語でも利用できますか?
モデルによって異なります。GPT-5とGeminiは、主要なラテンアルファベット言語(フランス語、スペイン語、ドイツ語、ポルトガル語)の印刷および手書きの両方で良好に機能します。非ラテン文字(アラビア語、デーヴァナーガリー語、中国語、日本語、韓国語)はモデル依存度が高く、採用前に特定のドキュメントでテストしてください。文字ベースの書記体系(中国語、日本語)における手書きスタイルのばらつきは、ラテン語の筆記体とは異なる認識上の課題をもたらすため、精度の期待値はそれに応じて調整する必要があります。
ワークフローを構築する前に、自分のドキュメントで抽出をテストしてください。きれいなデモサンプルと実際のチームの手書きとの間のギャップに、実際の精度の数字があります。