AIはどのようにドキュメントを「読む」のか
非技術者向けガイド(2026年)
請求書を見るとき、あなたは左から右へ、上から下へ、文字を一文字ずつ読んでいるわけではありません。ひと目見ただけで、合計金額がどこにあるかがわかります。意識して視線を動かす前に、目は右下の角に飛んでいきます。1秒もかからずに、脳はページ全体を把握します。上部にロゴ、中央に明細項目、下部に数字。そして、重要な箇所に注意を向けます。AIも今ではそれができます。請求書のどこに合計金額が載っているかというルールをプログラムされるのではなく、あなたと同じようにドキュメントを見て理解することを学習することで実現しているのです。
重要なポイント
- AIはドキュメントを一行ずつスキャンするのではなく、ページ全体を一度に見ます。まるで、意識して見ようとする前に請求書の合計金額を見つけてしまうあなたの目のように。
- 3つのステップ(ページ全体を「見る」、さまざまなラベル表記の中から「請求書番号」の意味を「理解する」、正しい値を正しい列に「取得する」)が機能するのは、位置よりも意味が常に優先されるからです。
- 形式やレイアウトが重要でなくなると、問いは「これを自動化できるか?」から「どのドキュメントからデータを抽出すべきか?」へと変わります。
従来の方法:コンピュータに「読む」のではなく「スキャン」を教える
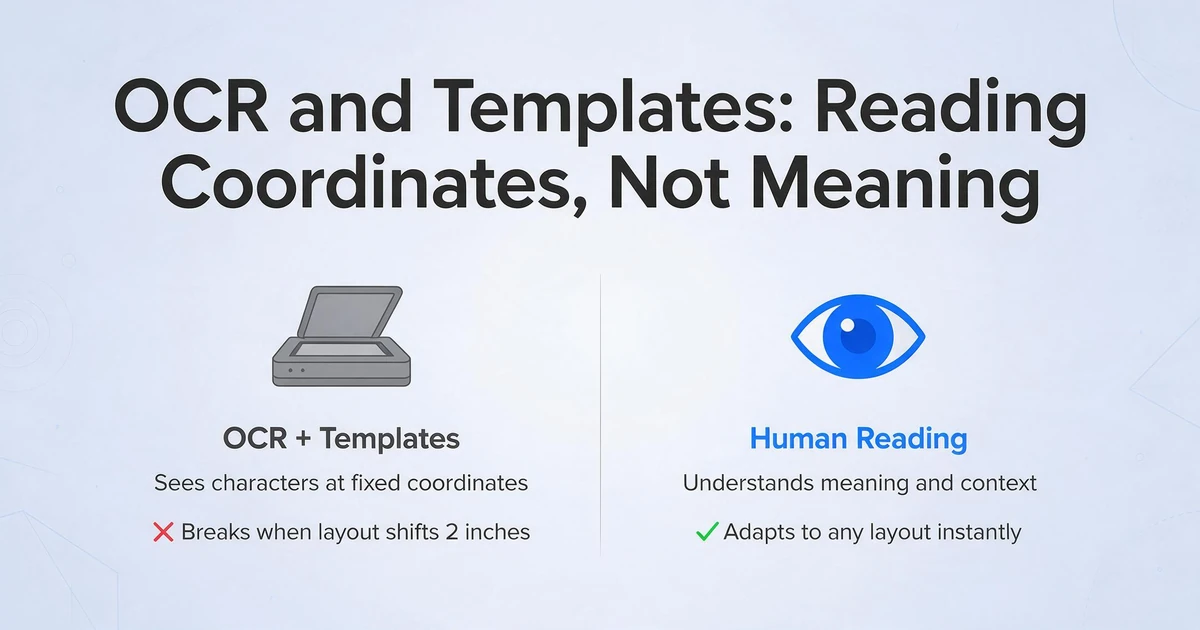
何十年もの間、ドキュメントからデータを取り出すにはOCR(光学文字認識)を使うのが一般的でした。OCRは画像を見て、文字の形をテキストに変換します。これは読んでいるように聞こえますが、実際には違います。どちらかというと、画像の代わりにテキストを出力するコピー機のようなものです。白い背景の黒い印を見て、「この印はAという文字、これは7という数字」と判断します。しかし、請求書が何であるかは理解していません。「Total」という単語の横にある$4,230.50が支払うべき金額だということも分からないのです。
この問題を回避するために、次世代のツールはテンプレートを使用しました。あるベンダーの請求書の請求番号フィールドの周りにボックスを描き、日付の周りにもう一つ、合計金額の周りにもう一つ描くという具合です。レイアウトが異なる新しいベンダーごとに、新しいボックスのセットが必要でした。新しいサプライヤーからPDFが届くと、ツールは意味不明な出力を返します。なぜなら、合計金額が左に2インチ移動したからです。これはドキュメントの理解ではなく、ドキュメントの座標の暗記でした。
どちらのアプローチも同じ致命的な前提を共有しています:ドキュメントは空間に配置された単なる文字の集まりだということです。それらの文字が意味を形成していること—「Invoice #」がラベルであり、その隣の値が識別子であり、下部にあるドル記号付きの数字がおそらく支払うべき金額であること—を理解していないのです。
ステップ1:SEE(見る)— AIがページ全体を一度に取り込む
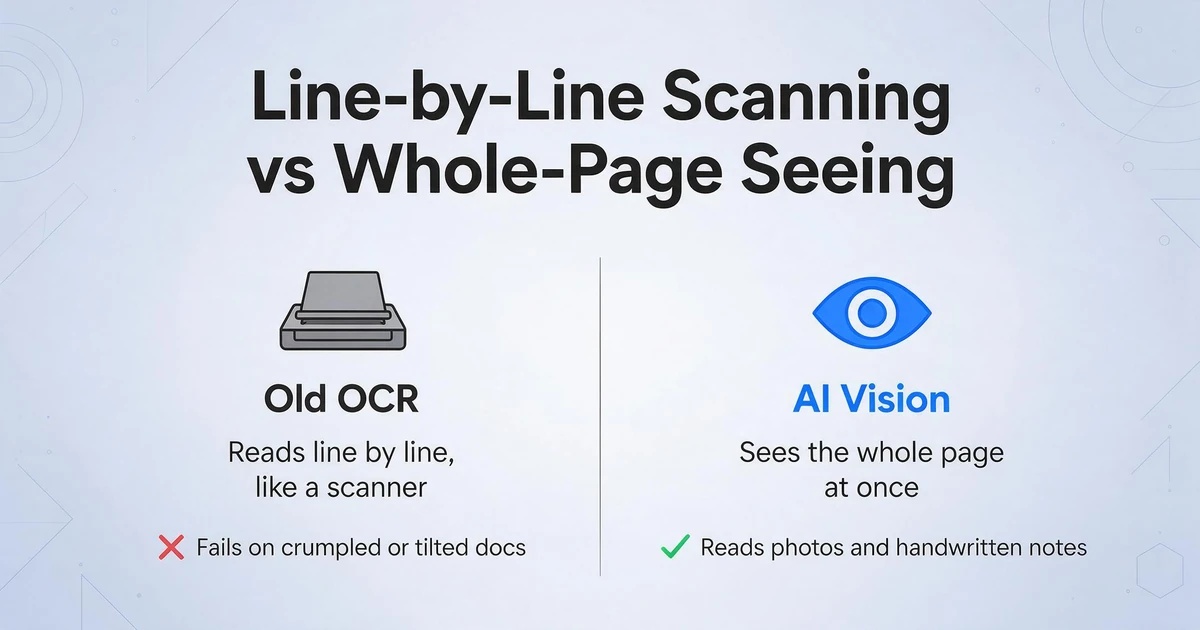
最新のAIがドキュメントに対して最初に行うことは、従来のアプローチとは根本的に異なります。フラットベッドスキャナのように一行ずつスキャンする代わりに、ページ全体を一つの完全な画像として認識します。
レストランのメニューを見るときのことを考えてみてください。「前菜」から「デザート」まで全ての単語を読むわけではありません。一目で全体のレイアウトを把握します:右側に価格、中央に説明、セクション見出しは太字。視覚システムがシーン全体を同時に処理するため、最も高価な料理を1秒以内に見つけられます。AIの視覚能力も同じように機能します。空間的な関係性—このテキストブロックはあの上にある、この数字は表のセルの中にある、このロゴはヘッダー領域にある—を、意識的な思考が始まる前に目が捉えるのと同じ方法で認識します。
これが、照明が悪い状態で撮影したしわくちゃのレシートの写真でも処理できる理由です。AIはきれいなテキストのグリッドを読んでいるのではなく、視覚的なシーンを再構築しているのです。傾いていてコーヒーマグに半分隠れた友人の手書きの付箋を読めるのと同じように、AIはテキスト文字列だけでなく全体像を見ることで、不完全な入力も理解できるのです。
ステップ2:理解する — 「請求書番号」が実際に何を意味するのかを知る
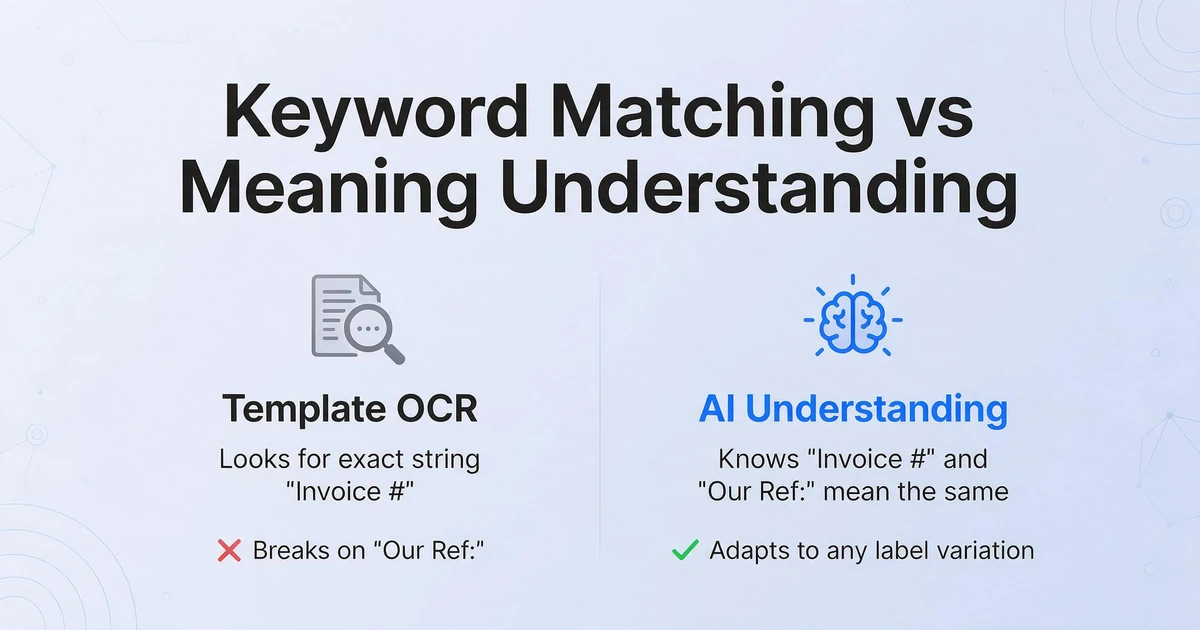
ページを「見る」ことは最初のステップにすぎません。本当の飛躍は、見えた要素が何を意味するのかを理解することです。ここでAIは従来のツールから完全に離れ、プログラムというより人間のように振る舞い始めます。
あなたが言葉のわからない言語で書かれた書類を渡されても、見てきたすべての書類で「Invoice #」という語の隣に番号INV-2024-0891があることに気づいたと想像してください。あなたはすぐに学ぶでしょう。「Invoice #」を見たら、その隣の値が請求書IDだと。次に、別の業者が「Invoice #」ではなく「Our Ref:」と書いてきたとします。テンプレートベースのツールはここで失敗します。正確な文字列「Invoice #」を探すように指示されていたからです。しかし人間であるあなたは即座に適応します。「Our Ref:」が同じ目的を果たすと認識するのは、そのフィールドが書類の中で果たす役割を理解しているからであり、単なる文字通りのテキストを見ているからではありません。
AIの書類理解も同じ原理で機能します。「Invoice Number」「Inv No」「Invoice #」「Our Ref:」がすべて同じことを言う別の言い方だと知っています。それぞれのバリエーションを教えてもらう必要はありません。何百万もの書類に触れることで、情報がどのようにラベル付けされ構造化されるかのパターンを学習しているのです。それは、請求書の右下にある数字がおそらく合計金額だとあなたが学んだのと同じ方法です。
これが文字を認識することと書類を理解することの違いです。AIはキーワードの一致を探しているのではありません。「この書類にはどのような情報があり、それぞれの要素はどのような役割を果たすのか?」という問いに答えているのです。
理解に役立つ考え方: 従来のツールは「データはどこにあるか?」に答え、AIは「データは何か?」に答えます。前者のアプローチは「どこ」が変わると失敗します。後者は「どこ」をまったく気にしません。
ステップ3: FETCH — 正しい値を正しい列に入れる
AIがドキュメントを読み取り、内容を理解したら、最後のステップは驚くほどシンプルです。必要なものを指定するだけで、AIがそれを見つけ出します。
実際の流れはこうです。異なる業者からの請求書の山があるとします。ツールに「請求書番号」「日付」「合計金額」「仕入先名」の4つの列名を入力するだけです。これで、AIに何を探すべきか伝えたことになります。AIは各請求書を確認し、列名に一致する値を — 位置ではなく意味で — 見つけ出し、スプレッドシートに入力します。
重要なポイントは、出力を定義するのはあなたで、AIは入力データをナビゲートしてそれを見つけ出すということです。各業者の請求書のどこにどのフィールドがあるかを教える必要はありません。テンプレートを作成する必要も、枠を描く必要もありません。必要な列に名前を付けるだけで、AIが残りを処理します。このアプローチ — カスタム列抽出と呼んでいます — は、従来のワークフローを覆します。ドキュメントが取得するデータ(とその取得元)を決めるのではなく、必要なデータをあなたが指定し、AIが各ドキュメント上のどこにあるかを判断します。
同じ原則は、単純な抽出を超えて応用できます。抽出と同時に分類を依頼することもできます。例えば、「カテゴリ(選択肢: 飲食/交通/オフィス/その他)」という列を追加すれば、AIは各レシートを読み取り、どのカテゴリに該当するかを判断します。レシートに「カテゴリ」という欄が印刷されていなくてもです。さらに、抽出中に計算を実行させることもできます。例えば、総額のみが印刷されている場合に、小計から税額を計算するといった具合です。AIは単に数字をコピーするだけでなく、それについて推論するのです。
ファイルは安全に処理され、保存されることはありません。
なぜこれがドキュメント形式の常識を変えるのか
AIがデータの位置ではなく意味を理解してデータを見つけるなら、ドキュメントのレイアウトは無関係になります。これこそが、この3ステップのプロセスを実際に革新的にする結果です。
10社の異なるベンダーからの10枚の請求書、それぞれ異なるレイアウト — 日付の位置も、合計フィールドの名前も、テーブル構造も異なります。テンプレートベースのツールにとっては、それは10の別々の設定プロジェクトです。人間と同じように見て理解するAIにとっては、それは1つのバッチジョブです。10枚すべてをアップロードし、列に名前を一度付けるだけで、すべてのデータが1つのテーブルに統合された単一のスプレッドシートが得られます。
これは単に速いだけではありません — 実用性そのものを変えます。この機能が存在する前は、クライアントが手書きの領収書の写真を送ってきた場合、手動で入力するか、適切なPDFを送るよう伝える必要がありました。今では、スマホの写真もスキャンしたドキュメントと同じように機能します。PDFのスクリーンショットもPDF自体と同じように機能します。AIがレイアウトを解析するのではなくコンテンツを理解し始めた瞬間、入力形式は門番ではなくなりました。
これを可能にしているのは、より大きな辞書や高速な文字認識ではありません。それは、位置ベースの抽出 — 「請求書番号は座標(x, y)にある」— から意味ベースの抽出 — 「請求書の識別子として機能する値を、それがどこにあっても見つける」— への移行です。前者のアプローチはもろいものです。後者は、人間の読み方とまったく同じように柔軟です。テーブル内でも、文の中でも、欄外に手書きでも、合計を認識できます。
よくある質問
AIは実際に私のドキュメントを理解しているのでしょうか、それとも単にパターンに基づいて推測しているだけなのでしょうか?
それは、ランダムなコイン投げのような意味での推測ではありません。何千もの請求書を見てきた経験豊富な会計士を想像してみてください。その会計士は合計がどこにあるかを「推測」しているのではありません — パターンを即座に認識するので、知っているのです。AIも同じような訓練された直感を持っており、膨大な範囲のドキュメントタイプとレイアウトに触れることで構築されています。違いは、AIが3分ではなく10秒未満で見たものを処理することです。印刷されたドキュメントの場合、この訓練された認識は最大99%の精度に達します。
AIは手書き文字を読めますか?
はい、読めます。AIはドキュメントをまず画像として捉えるため、入力された文字の集合ではなく、手書き文字も解釈すべき視覚パターンの一つとして扱います。印刷されたテキスト、筆記体、ブロック体、さらにはフォームのチェックボックスや丸で囲んだ選択肢にも対応します。ただし、非常に読みにくい手書き文字(人間でも解読に苦労するようなもの)は精度が低下する可能性があります。文字がきれいであればあるほど、結果も良くなります。これは人間の場合と同じです。
AIが誤った結果を出した場合はどうなりますか?
完璧なAIは存在せず、責任あるツールはそのことを隠しません。出力は検証しやすい構造になっています。抽出された各値はラベル付きの列に配置されるため、元のドキュメントとフィールドごとに照合する代わりに、異常をすばやく確認できます。一貫したエラーパターンに気づいた場合は、列名をより具体的にすることで解決することがよくあります。AIは、列名が探している内容を明確に示しているときに最もよく機能します。
最初に自分のドキュメントでトレーニングする必要がありますか?
いいえ、その必要はありません。これは従来のAIアプローチとの最大の違いの一つです。エンタープライズ向けドキュメント処理ツールでは、サンプルドキュメントのバッチをアップロードし、フィールドを手動でラベル付けし、システムがカスタムモデルをトレーニングするのを待つ必要があることがよくあります。このプロセスには数日から数週間かかる場合があります。最新のビジョンAIは、多種多様なドキュメントタイプで事前トレーニングされており、すぐに使用できます。アップロードして列名を指定すれば、結果が得られます。セットアップフェーズも、ツールの学習曲線もありません。学習は、あなたが使い始める前にすでに完了しているのです。
AIがドキュメントを読み取る際、データは安全ですか?
これは使用するツールに完全に依存します。ドキュメントAIサービスを評価する際は、データの取り扱いに関する明確な記載を探してください。データがAIのさらなるトレーニングに使用されますか?処理後も保存されますか?暗号化されていますか?信頼できるサービスは、ファイルを処理して抽出データを返すだけで、ドキュメントを保持したり学習に使用したりしません。機密ドキュメントをアップロードする前に、必ずプロバイダーのプライバシーポリシーとデータ取り扱い方針を確認してください。
これがあなたにとって意味すること
SEE(見る)→ UNDERSTAND(理解する)→ FETCH(取得する)のプロセスは、単なる興味深い技術的な詳細ではありません。これこそが、1ドキュメントあたり3分かかっていた手作業が、5秒から10秒で完了するようになった理由です。時間の節約は、2種類の作業を同時に排除することから生まれます。それは、各ドキュメントの各フィールドを探すという頭脳的な作業と、値を正しいセルに入力するという物理的な作業です。
しかし、より大きな変化は、何が可能になるかという点にあります。1つのドキュメントの処理が速くなれば、以前ならわざわざ処理しなかったドキュメントも処理するようになるかもしれません。フォーマットが重要でなくなれば、クライアントやサプライヤーに「正しい方法で」送ってもらうよう求めるのをやめられます。セットアップにトレーニングが不要になれば、「これを自動化すべきだ」と「実際にやっている」の間の障壁はなくなります。
技術的な側面をもっと深く知りたい場合(内部で何が起こっているのか、従来のOCRとどう違うのか、精度の数値がどこから来るのか)は、AIデータ入力の実際の意味に関するガイドが、この記事の続きを説明しています。また、コーディングなしでこの機能を既存のワークフローに取り入れたい場合は、ノーコードのドキュメントAIが、列に名前を付けられる人なら誰でも抽出を利用できるようにする方法をご覧ください。
ご自身の請求書でお試しください。列名を3つ(請求書番号、日付、合計)入力するだけで、AIが見て、理解し、取得する様子をリアルタイムで確認できます。このプロセスを理解する最良の方法は、あなたのドキュメントで実際に起こるのを見ることです。