Como a IA "Lê" Seus Documentos
Um Guia Não Técnico (2026)
Quando você olha para uma fatura, não lê da esquerda para a direita, de cima para baixo, caractere por caractere. Você dá uma olhada e já sabe onde está o total. Seus olhos pulam para o canto inferior direito antes mesmo de você decidir conscientemente olhar para lá. Em menos de um segundo, seu cérebro mapeou a página inteira — logo no topo, itens no meio, números na parte de baixo — e direcionou sua atenção para o que importa. A IA também consegue fazer isso agora. Não por ser programada com regras sobre onde ficam os totais nas faturas, mas por aprender a ver e entender documentos como você.
Principais Conclusões
- A IA não escaneia documentos linha por linha — ela vê a página inteira de uma vez, como seus olhos encontrando o total em uma fatura antes mesmo de você decidir conscientemente olhar para lá.
- O processo de três etapas — VER a página inteira, ENTENDER o que "Invoice #" significa em uma dúzia de variações de rotulagem, BUSCAR o valor certo na coluna certa — funciona porque o significado supera a posição todas as vezes.
- Quando formato e layout deixam de importar, a pergunta muda de "posso automatizar isso?" para "de quais documentos eu deveria estar extraindo dados?".
O Método Antigo: Ensinar os Computadores a Escanear, Não a Ler
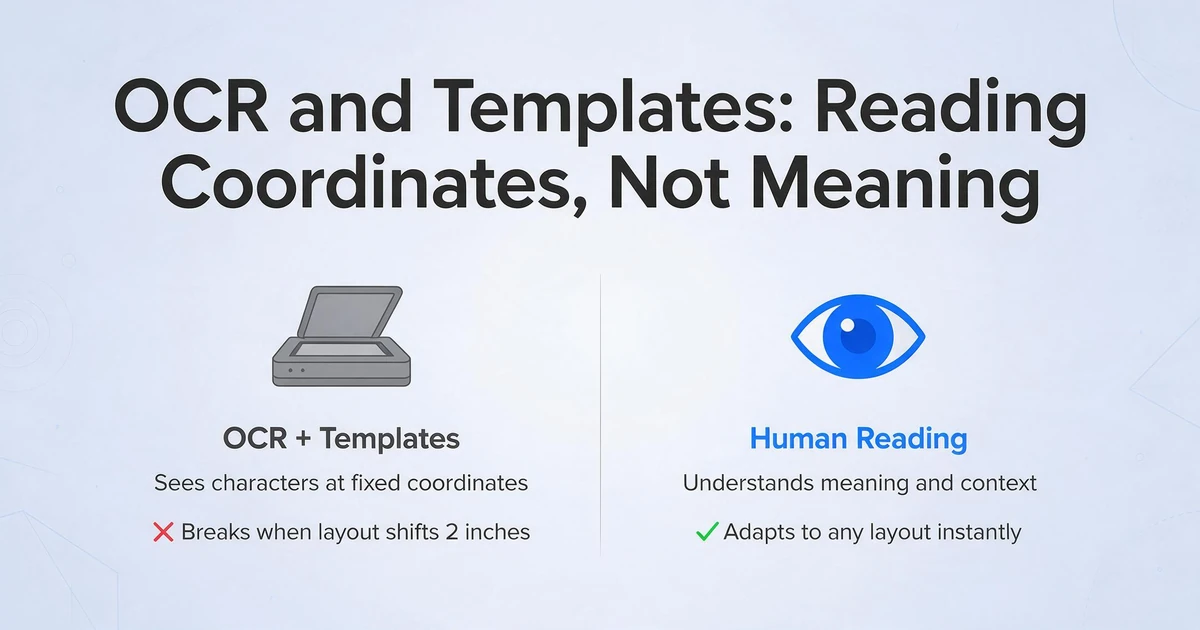
Durante décadas, extrair dados de um documento significava usar OCR — reconhecimento óptico de caracteres. O OCR analisa uma imagem e converte as formas das letras em texto. Parece leitura, mas não é. É mais como uma fotocopiadora que produz texto em vez de outra imagem. Ele vê marcas pretas sobre um fundo branco e diz: "essas marcas formam a letra A, aquelas formam o número 7." Ele não sabe o que é uma fatura. Não sabe que $4,230.50 ao lado da palavra "Total" é o valor que você deve.
Para contornar isso, a geração seguinte de ferramentas usava modelos. Você desenhava uma caixa ao redor do campo do número da fatura na fatura de um fornecedor. Depois outra caixa ao redor da data. Depois outra ao redor do total. Cada novo fornecedor com um layout diferente precisava de um novo conjunto de caixas. Um novo fornecedor envia um PDF, e a ferramenta devolve algo sem sentido — porque o total se moveu cinco centímetros para a esquerda. Isso não era compreensão de documentos. Era memorização de coordenadas de documentos.
As duas abordagens compartilham a mesma suposição fatal: a de que um documento é apenas caracteres dispostos no espaço. Elas não entendem que esses caracteres formam significados — que "Invoice #" é um rótulo, que o valor ao lado dele é um identificador, que o número na parte de baixo com um cifrão provavelmente é o que você precisa pagar.
Etapa 1: VER — A IA Absorve a Página Inteira de Uma Só Vez
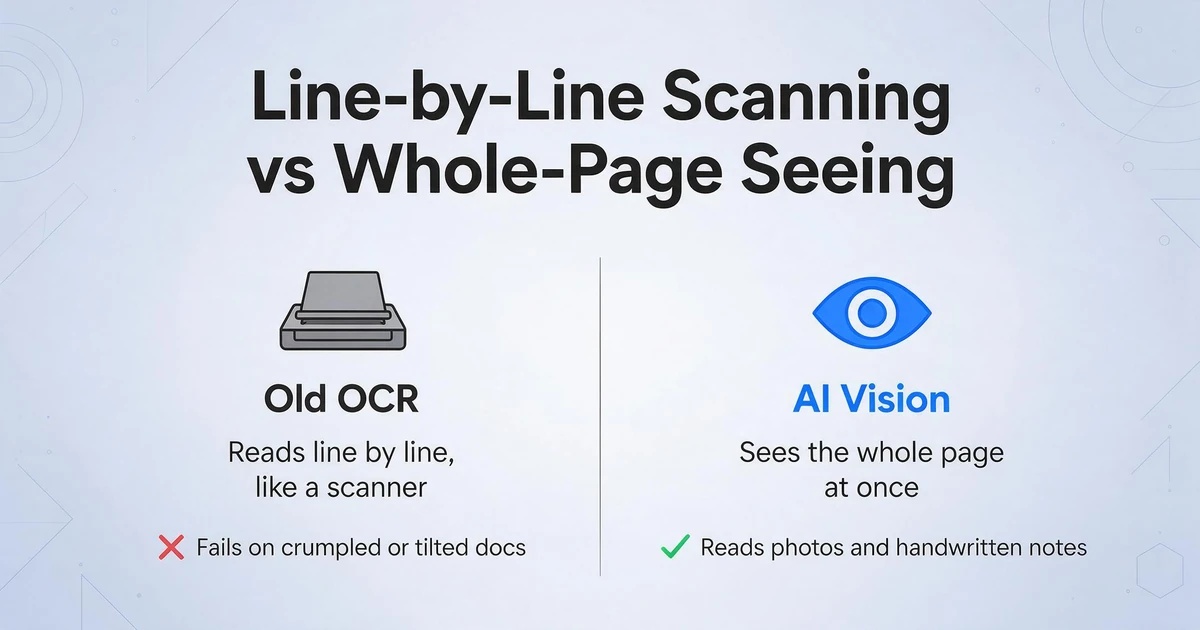
A primeira coisa que a IA moderna faz com o seu documento é fundamentalmente diferente da abordagem antiga. Em vez de escanear linha por linha — lendo o texto como um scanner de mesa faz —, ela vê a página inteira como uma imagem completa.
Pense em como você olha um menu de restaurante. Você não lê cada palavra de "Entradas" a "Sobremesas". Seus olhos absorvem o layout completo em um relance: preços à direita, descrições no meio, títulos de seção em negrito. Você consegue encontrar o prato mais caro em menos de um segundo porque seu sistema visual processa a cena inteira simultaneamente. A capacidade de visão da IA funciona do mesmo jeito. Ela percebe relações espaciais — este bloco de texto está acima daquele, este número está dentro de uma célula de tabela, este logotipo fica na área do cabeçalho — da mesma forma que seus olhos fazem antes mesmo de seu cérebro consciente entrar em ação.
É por isso que uma foto de um recibo amassado tirada com pouca luz ainda pode ser processada. A IA não está lendo uma grade limpa de texto; está reconstruindo uma cena visual. Assim como você consegue ler um bilhete manuscrito de um amigo mesmo quando ele está torto e meio coberto por uma caneca de café, a IA consegue dar sentido a entradas imperfeitas porque vê a imagem inteira, não apenas as sequências de texto.
Etapa 2: ENTENDER — Sabendo o que "Invoice #" Realmente Significa
Ver a página é apenas o primeiro passo. O verdadeiro salto é entender o que os elementos vistos significam. É aqui que a IA se afasta completamente das ferramentas mais antigas — e onde ela começa a se comportar mais como uma pessoa do que como um programa.
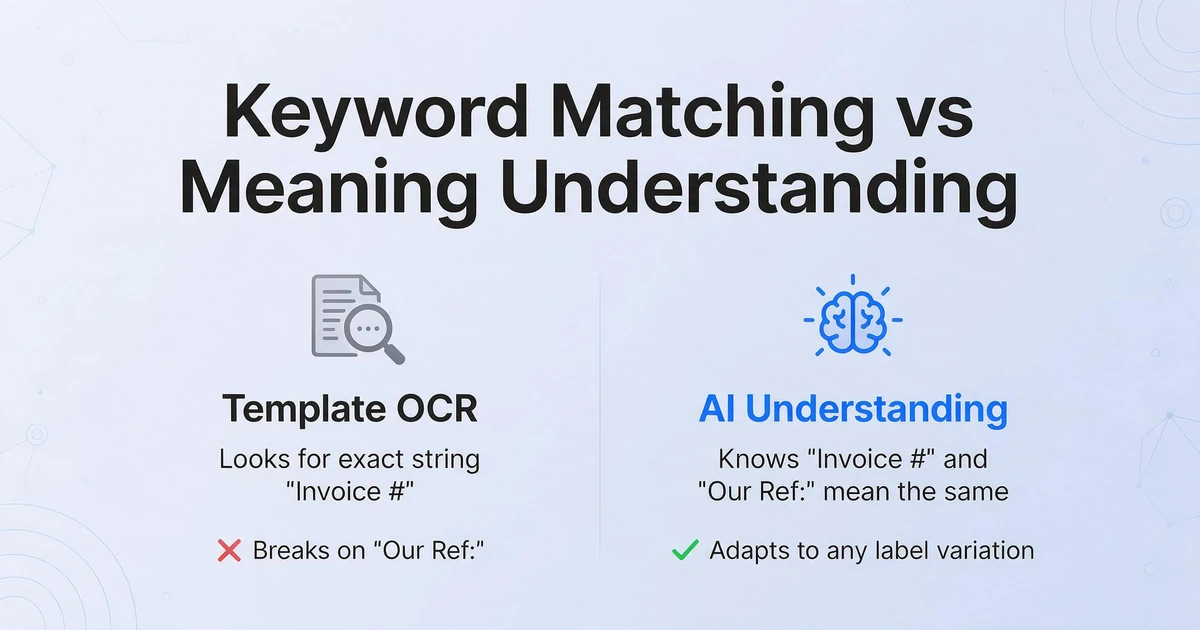
Imagine que você receba um documento em um idioma que não fala, mas percebe que o número INV-2024-0891 fica ao lado da frase "Invoice #" em todos os documentos que já viu. Você rapidamente aprenderia: quando vejo "Invoice #", o valor ao lado é o identificador da fatura. Agora imagine que o próximo fornecedor escreva "Our Ref:" em vez de "Invoice #". Uma ferramenta baseada em modelo falha aqui — foi instruída a procurar a string exata "Invoice #". Mas você, como humano, se adapta instantaneamente. Você reconhece que "Our Ref:" cumpre a mesma função, porque entende o papel que esse campo desempenha no documento, não apenas seu texto literal.
O entendimento de documentos por IA funciona com esse mesmo princípio. Ele sabe que "Invoice Number", "Inv No", "Invoice #" e "Our Ref:" são todas formas diferentes de dizer a mesma coisa. Não precisa que cada variação seja informada. Ele aprendeu — a partir da exposição a milhões de documentos — os padrões de como as informações são rotuladas e estruturadas, da mesma forma que você aprendeu que um número no canto inferior direito de uma conta provavelmente é o total.
Essa é a diferença entre reconhecer caracteres e compreender um documento. A IA não está procurando uma correspondência de palavra-chave. Ela está respondendo à pergunta: "que informação existe neste documento, e qual papel cada parte desempenha?"
O modelo mental que ajuda: As ferramentas antigas respondem "onde estão os dados?" A IA responde "o que são os dados?" A primeira abordagem falha quando o "onde" muda. A segunda não se importa com o "onde".
Etapa 3: FETCH — Colocando o Valor Certo na Coluna Certa
Depois que a IA viu o documento e entendeu o que há nele, a etapa final é enganosamente simples: você diz o que quer, e ela encontra.
Veja como isso funciona na prática. Você tem uma pilha de faturas de fornecedores diferentes. Você digita quatro nomes de colunas na ferramenta: "Número da Fatura", "Data", "Total" e "Nome do Fornecedor". Só isso. Você acabou de dizer à IA o que procurar. Ela percorre cada fatura, localiza o valor que corresponde a cada nome de coluna — pelo significado, não pela posição — e preenche sua planilha.
O insight crítico: você define a saída, e a IA navega pela entrada para encontrá-la. Você não ensina onde cada campo fica na fatura de cada fornecedor. Você não cria modelos. Você não desenha caixas. Você apenas nomeia as colunas que quer, e a IA faz o resto. Essa abordagem — que chamamos de Extração de Colunas Personalizadas — inverte o fluxo de trabalho tradicional. Em vez de o documento ditar quais dados você recebe (e de onde vêm), você dita quais dados precisa, e a IA descobre onde encontrá-los em cada documento.
O mesmo princípio se estende além da extração simples. Você pode pedir à IA para categorizar enquanto extrai — por exemplo, adicionando uma coluna chamada "Categoria (opções: Refeições/Transporte/Escritório/Outros)" e a IA lerá cada recibo e decidirá qual categoria se encaixa, mesmo que nenhum recibo tenha um campo "Categoria" impresso nele. Você pode até pedir que ela faça cálculos durante a extração, como calcular o valor do imposto a partir de um subtotal quando apenas o total geral está impresso. A IA não apenas copia números — ela raciocina sobre eles.
Os arquivos são processados com segurança e não são armazenados.
Por Que Isso Muda Tudo Sobre Formatos de Documento
Se a IA encontra dados entendendo o que eles significam, e não onde estão, então o layout do documento se torna irrelevante. Essa é a consequência que torna o processo de três etapas tão transformador na prática.
Dez faturas de dez fornecedores diferentes, cada uma com seu próprio layout — posições diferentes para a data, nomes diferentes para o campo de total, estruturas de tabela diferentes. Para uma ferramenta baseada em modelo, isso são dez projetos de configuração separados. Para uma IA que vê e entende como uma pessoa, é um único trabalho em lote. Você envia todas as dez, nomeia suas colunas uma vez e recebe uma única planilha com todos os dados mesclados em uma tabela.
Isso não é apenas mais rápido — muda o que é prático. Antes dessa capacidade existir, se um cliente enviasse a foto de um recibo manuscrito, você teria que digitá-lo manualmente ou dizer que ele precisava enviar um PDF adequado. Agora, uma foto tirada do celular funciona igual a um documento digitalizado. Uma captura de tela de um PDF funciona igual ao próprio PDF. O formato de entrada deixou de ser um obstáculo no momento em que a IA começou a entender o conteúdo em vez de analisar layouts.
O que torna isso possível não é um dicionário maior ou um reconhecimento de caracteres mais rápido. É a mudança da extração baseada em posição — "o número da fatura fica nas coordenadas (x, y)" — para a extração baseada em significado — "encontre o valor que serve como identificador da fatura, onde quer que ele esteja." A primeira abordagem é frágil. A segunda é flexível exatamente como a leitura humana é flexível: você consegue reconhecer um total esteja ele em uma tabela, em uma frase ou escrito à mão na margem.
Perguntas Frequentes
A IA realmente entende meus documentos, ou está apenas adivinhando com base em padrões?
Não é adivinhação no sentido de um cara ou coroa aleatório. Pense nisso como um contador experiente que já viu milhares de faturas. Esse contador não "adivinha" onde está o total — ela sabe, porque reconhece o padrão instantaneamente. A IA tem o mesmo tipo de intuição treinada, construída a partir da exposição a uma enorme variedade de tipos e layouts de documentos. A diferença é que a IA processa o que vê em menos de dez segundos, não três minutos. Para documentos impressos, esse reconhecimento treinado atinge até 99% de precisão.
A IA consegue ler escrita à mão?
Sim. Como a IA vê o documento primeiro como imagem — e não como um conjunto de caracteres digitados — a escrita à mão é apenas mais um padrão visual a interpretar. Ela funciona com texto impresso, letra cursiva, letras de forma e até caixas de seleção e marcações circuladas em formulários. Dito isso, escrita extremamente confusa (do tipo que um humano também teria dificuldade em entender) pode reduzir a precisão. Quanto mais limpa a escrita, melhor o resultado — igual a com uma pessoa.
O que acontece se a IA errar algo?
Nenhuma IA é perfeita, e uma ferramenta responsável não finge o contrário. A saída é estruturada de forma que facilita a verificação — cada valor extraído fica em uma coluna rotulada, para que você possa identificar anomalias rapidamente em vez de comparar campo por campo com o documento original. Se você notar um padrão de erro consistente, ajustar os nomes das colunas para serem mais específicos geralmente resolve. A IA funciona melhor quando os nomes das suas colunas descrevem claramente o que você está procurando.
Preciso treiná-la com meus documentos primeiro?
Não. Essa é uma das maiores diferenças em relação a abordagens mais antigas de IA. Ferramentas empresariais de processamento de documentos geralmente exigem que você envie lotes de documentos de exemplo, rotule campos manualmente e espere enquanto o sistema treina um modelo personalizado — um processo que pode levar dias ou semanas. A IA moderna baseada em visão já vem pré-treinada em uma vasta gama de tipos de documentos e funciona imediatamente. Você faz o upload, nomeia suas colunas e obtém os resultados. Não há fase de configuração nem curva de aprendizado para a ferramenta — o aprendizado já aconteceu antes de você chegar.
Meus dados estão seguros quando a IA os lê?
Isso depende inteiramente da ferramenta que você usa. Ao avaliar qualquer serviço de IA para documentos, procure declarações explícitas sobre o tratamento de dados: seus dados são usados para treinar mais a IA? Eles são armazenados após o processamento? São criptografados? Um serviço confiável processa seus arquivos, retorna os dados extraídos e não retém nem aprende com seus documentos. Sempre verifique as políticas de privacidade e de tratamento de dados do fornecedor antes de enviar documentos sensíveis.
O que isso significa para você
O processo VER → ENTENDER → BUSCAR não é apenas um detalhe técnico interessante. É o motivo pelo qual uma ferramenta que levava três minutos de trabalho manual por documento agora leva de cinco a dez segundos. A economia de tempo vem de eliminar dois tipos de trabalho ao mesmo tempo: o trabalho mental de encontrar cada campo em cada documento e o trabalho físico de digitar os valores nas células certas.
Mas a mudança maior está no que se torna possível. Quando processar um documento é rápido, você pode processar documentos que antes nem se daria ao trabalho de considerar. Quando o formato não importa, você para de pedir a clientes e fornecedores que enviem as coisas "do jeito certo". Quando a configuração não exige nenhum treinamento, a barreira entre "eu deveria automatizar isso" e "eu realmente estou fazendo isso" desaparece.
Se você quiser se aprofundar no lado técnico — o que acontece nos bastidores, como isso se compara ao OCR tradicional em mais detalhes e de onde vêm os números de precisão — nosso guia sobre o que a entrada de dados por IA realmente significa continua de onde este artigo para. E se você tiver curiosidade sobre como trazer essa capacidade para seus fluxos de trabalho existentes sem nenhuma programação, veja como o documento por IA sem código torna a extração acessível a qualquer pessoa que saiba nomear uma coluna.
Experimente com sua própria fatura. Digite três nomes de coluna — Número da Fatura, Data, Total — e veja a IA ver, entender e buscar em tempo real. A melhor maneira de entender o processo é vê-lo acontecer no seu documento.