A IA consegue ler documentos borrados?
Parcialmente — onde fica o limite de precisão
Parcialmente. A IA consegue extrair dados de digitalizações de qualidade moderadamente baixa — incluindo fotos levemente borradas, documentos em resolução de fax e imagens com pouca luz — com a precisão caindo gradualmente, e não de forma catastrófica. Abaixo de aproximadamente 150 DPI equivalentes, ou quando o desfoque de movimento severo borra as bordas do texto além do reconhecimento, a precisão degrada significativamente. A distinção principal: os modelos de visão da IA degradam com elegância porque entendem o contexto do documento. O OCR tradicional, em contraste, colapsa bruscamente — sua arquitetura de segmentação de caracteres pressupõe bordas nítidas e, quando essas bordas ficam borradas, ele não tem plano B.
Principais Conclusões
- Em todos os tipos de degradação — baixa resolução, desfoque de movimento, ruído de fax — a IA perde 2–3x menos precisão do que o OCR tradicional e permanece em 85–95% onde as ferramentas antigas caem abaixo de 50%.
- A IA não tem visão melhor — ela lê o contexto do documento do mesmo jeito que você lê um recibo borrado: você pode não ver cada dígito, mas sabe onde fica o total e como um valor em dólar se parece.
- Uma única melhoria — aumentar a resolução de 100 para 200 DPI — pode elevar a precisão de inutilizável para utilizável, porque a degradação composta colapsa quando a restrição mais limitante é removida.
Como a IA Lida com Diferentes Tipos de Degradação
Nem todos os problemas de qualidade de imagem afetam a extração por IA igualmente. Alguns tipos de degradação são surpreendentemente toleráveis; outros reduzem a precisão abaixo do limite em que a automação economiza mais tempo do que o custo da correção manual. A tabela abaixo mapeia cada tipo de degradação para seu impacto real na precisão, com base em benchmarks independentes de OCR e relatos de profissionais (benchmark Sparkco 2025; OmniDocBench, CVPR 2025).
| Tipo de Degradação | Impacto na Precisão da IA | Impacto no OCR Tradicional | Recuperável? |
|---|---|---|---|
| Baixa resolução moderada (150–200 DPI) | Queda de 5–10% em relação à referência | Queda de 15–25% | Sim — a compreensão contextual da IA compensa |
| Baixa resolução severa (<150 DPI) | Queda de 15–30% | Queda de 40–60%, muitas vezes inutilizável | Parcialmente — o pré-processamento de super-resolução ajuda, mas não consegue recuperar detalhes perdidos |
| Leve desfoque de movimento (celular na mão, leve tremor) | Queda de 5–12% | Queda de 20–35% | Sim — a IA lê formas de palavras, não traços de caracteres individuais |
| Desfoque de movimento severo (veículo em movimento, panorâmica rápida) | Queda de 25–40% | Queda de 60–80% | Limitado — a IA de desfoque pode recuperar parte; recapturar é o melhor |
| Baixo contraste (tinta desbotada, lápis claro, papel amarelado) | Queda de 3–8% | Queda de 10–20% | Sim — o pré-processamento de aumento de contraste é altamente eficaz |
| Qualidade de fax (100–200 DPI + artefatos de compressão) | Queda de 10–20% | Queda de 30–50% | Parcialmente — a redução de ruído específica para fax ajuda; alguns dados são permanentemente perdidos |
| Artefatos de compressão JPEG | Queda de 5–10% | Queda de 15–25% | Parcialmente — os artefatos de blocos podem ser suavizados, mas os detalhes perdidos não voltam |
| Iluminação irregular / sombras | Queda de 5–10% | Queda de 15–25% | Sim — a binarização adaptativa lida bem com sombras |
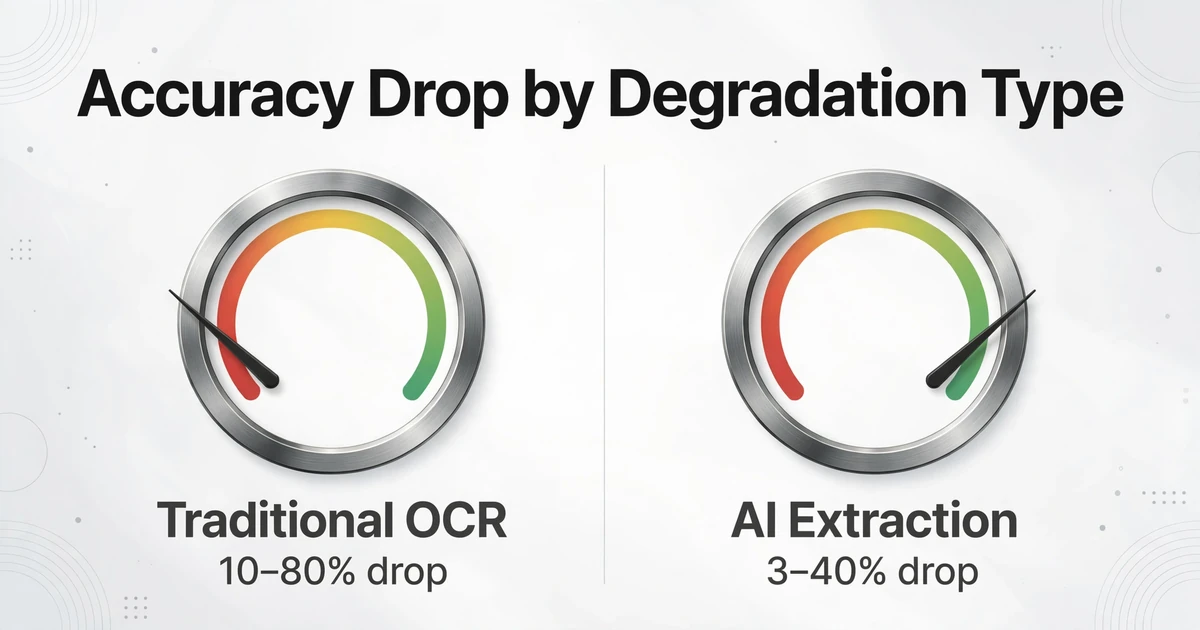
Dois padrões se destacam. Primeiro, a IA degrada 2–3x menos que o OCR tradicional em todas as categorias — a lacuna de compreensão contextual aumenta conforme a qualidade da imagem diminui. O OCR tradicional depende de bordas de caracteres nítidas para segmentar e classificar letras individuais; quando as bordas ficam borradas, a etapa de segmentação falha e os erros se acumulam. Os modelos de visão por IA analisam palavras inteiras, rótulos de campos e a estrutura do documento — então um "T" borrado em "Total" ainda é lido corretamente porque o modelo sabe que este campo deve conter um valor em dólar, não uma string aleatória.
Em segundo lugar, múltiplos defeitos moderados combinados são piores do que um único defeito grave. Um documento com baixo contraste (queda de 3–8%) mais leve inclinação (queda de 2–10%) mais artefatos JPEG (queda de 5–10%) pode perder 15–25% de precisão, mesmo que nenhum fator isolado seja grave. Isso importa porque documentos do mundo real raramente têm apenas um problema — uma fatura enviada por fax é simultaneamente de baixa resolução, ruidosa e com artefatos de compressão. A etapa de pré-processamento mais importante é identificar qual degradação é o principal fator e resolvê-la primeiro.
O que a IA acerta em documentos de baixa qualidade
A vantagem da IA em documentos degradados não é que ela tem melhor "visão" — é que ela tem melhor contexto. O OCR tradicional lê um documento como uma criança soletrando letras uma a uma. A IA lê da mesma forma que você lê uma foto borrada de um recibo: você pode não ver cada dígito claramente, mas sabe como um recibo se parece, onde o total geralmente fica e como um valor em dólar deve ser.
Formulários estruturados com campos rotulados são o caso mais forte da IA em entradas degradadas. Quando um documento tem rótulos de campo — "Número da Fatura", "Data", "Total Devido" — mesmo que o texto esteja parcialmente borrado, a IA usa o rótulo como uma âncora semântica. Ela sabe que tipo de valor esperar naquela região. Este é o mecanismo por trás da Extração de Colunas Personalizadas: você define os nomes das colunas que deseja (por exemplo, "Fornecedor", "Valor", "Número do Pedido"), e a IA localiza cada valor entendendo o que ele significa, não medindo distâncias de pixels. Um "$1.247,50" borrado ao lado de um rótulo que diz "Total" é extraído corretamente com muito mais frequência do que um "$1.247,50" borrado em um canto sem rótulo.
Documentos de resolução moderadamente baixa (150–200 DPI) estão dentro da zona de conforto da IA. Nessa faixa — típica de fotos de smartphone tiradas a uma distância razoável, ou digitalizações planas mais antigas em qualidade "rascunho" — caracteres individuais podem parecer suaves, mas as formas das palavras permanecem distinguíveis. O benchmark Sparkco 2025 descobriu que sistemas de OCR baseados em IA mantêm mais de 90% de precisão de caracteres a 200 DPI, enquanto mecanismos tradicionais caem para 80% ou menos. A diferença é mais visível em texto pequeno: uma fonte de 10pt a 200 DPI tem ~28 pixels de altura, suficiente para a IA resolver, mas marginal para OCR baseado em segmentação.
Documentos com conteúdo de texto em qualidade de fax se beneficiam de uma força inesperada da IA: preservação do layout. Os algoritmos de compressão de fax (MH, MR, MMR) distorcem traços finos de caracteres, mas preservam a relação espacial entre blocos de texto. Como a IA lê entendendo a estrutura do documento — cabeçalhos, texto do corpo, tabelas — em vez de caractere por caractere, ela muitas vezes pode recuperar texto enviado por fax que um mecanismo de OCR tradicional fragmentaria em algo sem sentido. O pré-processamento de redução de ruído específico para fax (LlamaIndex, 2026) melhora ainda mais os resultados ao remover o ruído de transmissão antes que a IA processe o documento.
Fotos de telefone com pouca luz com iluminação uniforme (sem sombras fortes) são processadas surpreendentemente bem. Modelos modernos de IA foram treinados em diversas imagens do mundo real e são robustos aos padrões de ruído e matizes de cor típicos da fotografia em ambientes internos. O problema é que sombras — especialmente sombras fortes de uma mão segurando o telefone sobre o documento — criam bordas de contraste artificiais que confundem a detecção de layout. Difunda a luz (aproxime-se de uma janela, evite flash direto) e a precisão se mantém dentro de 5–8% de uma digitalização limpa.
Onde a IA Ainda Enfrenta Dificuldades
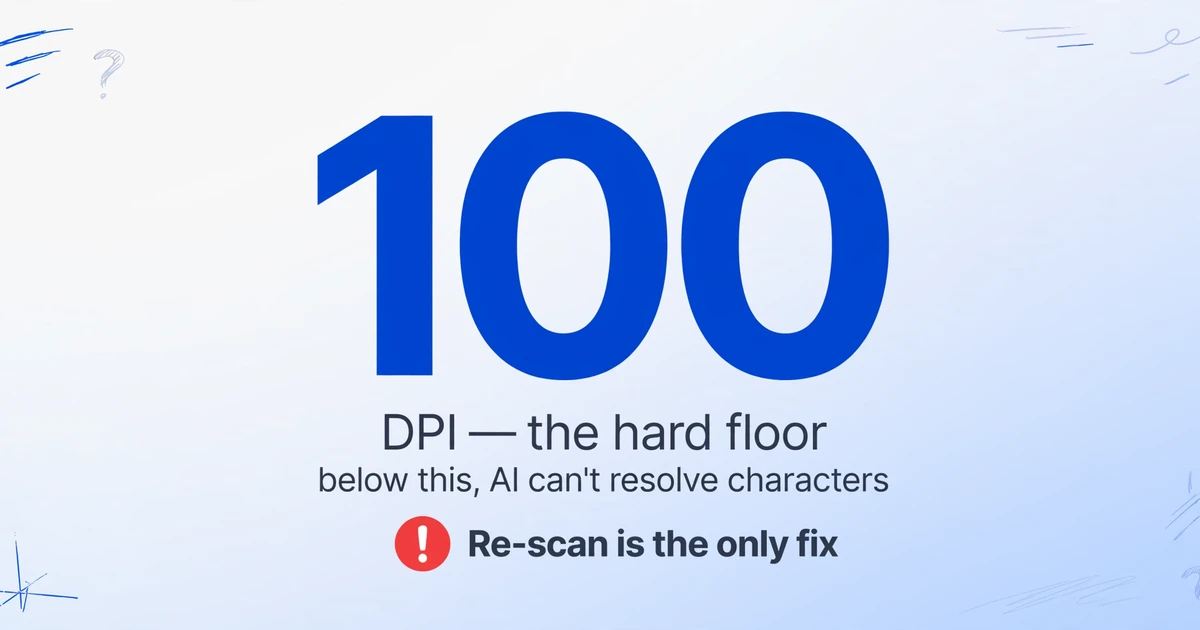
A lista honesta dos modos de falha importa mais do que os casos de sucesso — porque enviar um documento e receber uma saída inútil é como você perde a confiança em uma ferramenta permanentemente.
Resolução abaixo de 100 DPI é o limite mínimo. Abaixo de aproximadamente 100 DPI — comum em documentos fotografados de muito longe, PDFs muito compactados ou imagens em tamanho de miniatura — caracteres individuais ocupam poucos pixels para qualquer modelo resolver. Um caractere de 10pt a 100 DPI tem apenas cerca de 14 pixels de altura, e os traços finos que distinguem "8" de "3" ou "5" de "6" têm 2–3 pixels de largura. A super-resolução de IA pode interpolar detalhes ausentes, mas a interpolação inventa informações — ela adivinha o que os pixels ausentes deveriam ser, e essas suposições às vezes estão erradas. Como o guia de OCR de baixa resolução da LlamaIndex observa: "Aumentar a resolução não pode recuperar detalhes que nunca foram capturados." Nesse nível de resolução, re-digitalizar ou re-fotografar é o único caminho confiável.
Desfoque de movimento severo — o tipo causado ao fotografar um documento enquanto caminha, ou de um veículo em movimento — é o tipo de degradação mais prejudicial. O desfoque de movimento borra o texto em uma direção consistente, mesclando caracteres em faixas contínuas. Diferente da baixa resolução, onde os caracteres mantêm sua forma com fidelidade reduzida, o desfoque de movimento destrói completamente os limites dos caracteres. Benchmarks independentes mostram consistentemente o desfoque de movimento como o fator de qualidade mais prejudicial, com quedas de precisão de 10–20% mesmo em casos moderados (benchmark de OCR da Sparkco 2025; análise de OCR de baixa resolução da LlamaIndex). Os modelos de desfoque de IA melhoraram, mas enfrentam um limite fundamental da teoria da informação: pixels que foram borrados em várias posições de caracteres não podem ser desborrados com certeza.
Documentos danificados por água e fisicamente degradados — sangramento de tinta, manchas de água, manchas de mofo, papel térmico desbotado — apresentam um problema composto. A degradação não é uniforme: um canto da página pode estar perfeitamente legível enquanto outro é um borrão desbotado. Os modelos de IA enfrentam dificuldades com essa inconsistência espacial porque sua compreensão do layout espera um documento coerente. Um estudo de 2025 sobre OCR de documentos degradados (IJSAT, 2026) descobriu que documentos amassados reduziram a precisão do OCR em 30–45% em todos os mecanismos testados, e documentos molhados/borrados em 25–40%, com modelos de IA superando o OCR tradicional, mas ainda muito abaixo dos limites de produção. Para digitalização de qualidade arquivística de documentos danificados, ferramentas especializadas com verificação humana no processo continuam sendo necessárias.
Documentos dobrados, vincados e rasgados criam distorções geométricas que quebram os formatos dos caracteres. Um vinco sobre uma linha de texto cria uma saliência visível onde os caracteres são comprimidos verticalmente; a IA pode ler a seção comprimida como um caractere diferente ou ignorá-la completamente. Achatar o documento sob peso antes de fotografar ajuda significativamente, mas vincos profundos que deformaram permanentemente o papel ainda causarão erros. O guia de OCR da Biblioteca da Universidade de Pittsburgh recomenda escanear documentos vincados em modo RGB em vez de escala de cinza para preservar as informações sutis de sombreamento que ajudam a distinguir sombras de vincos da tinta.
Degradação composta — o caso do mundo real em que um documento é simultaneamente de baixa resolução, inclinado, ruidoso e mal iluminado — derrota até os melhores pipelines de pré-processamento. Cada etapa de aprimoramento (correção de inclinação, redução de ruído, nitidez, normalização de contraste) introduz seus próprios artefatos, e esses artefatos se acumulam. Um usuário do Reddit em r/MachineLearning documentou isso com precisão: o Tesseract alcançou 80–90% em imagens boas, 60% em imagens médias e 0% em imagens de baixa qualidade onde múltiplos defeitos ocorriam simultaneamente. O efeito de acumulação significa que melhorar até mesmo um fator — digamos, aumentar a resolução de 100 para 200 DPI enquanto mantém inclinação e ruído inalterados — pode elevar a precisão de "inutilizável" para "revisável", porque remove a restrição mais limitante.
Como Obter os Melhores Resultados de Documentos Imperfeitos
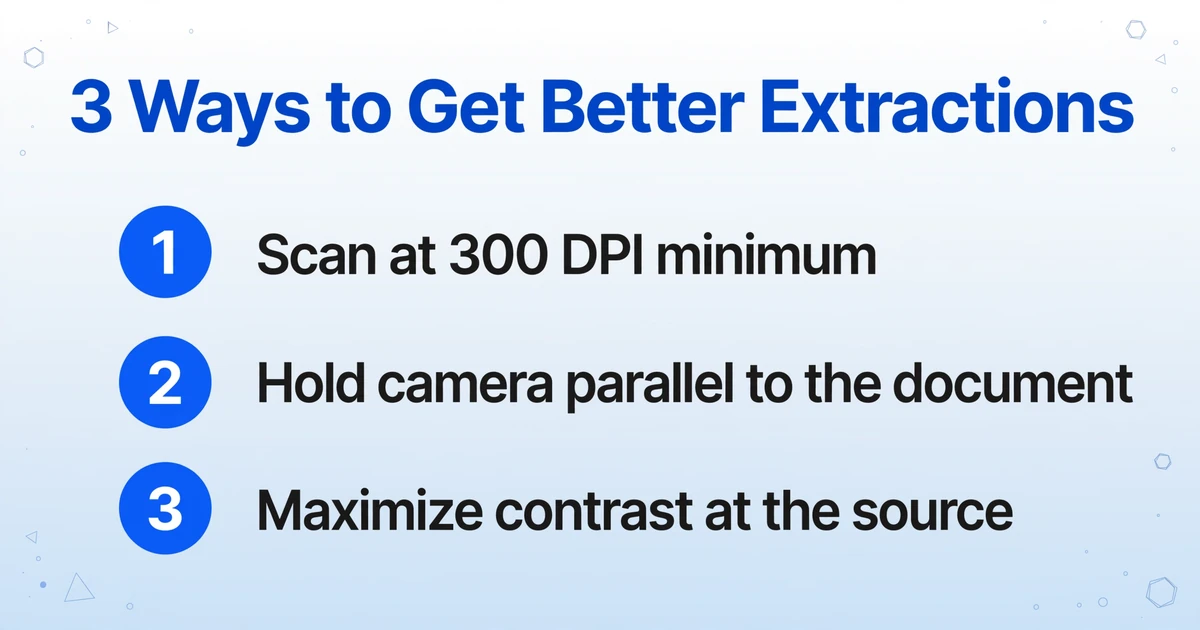
A ação de maior alavancagem é melhorar a entrada antes que ela chegue à IA. O pré-processamento pode recuperar 10–20% da precisão perdida em documentos moderadamente degradados — muitas vezes o suficiente para empurrar uma imagem limítrofe para a faixa utilizável.
1. Escaneie ou fotografe com mínimo de 300 DPI. Esta é a recomendação mais repetida em todos os benchmarks de OCR e guias de bibliotecas — e por um bom motivo. A 300 DPI, um caractere de 10pt abrange aproximadamente 42 pixels, dando à IA resolução suficiente para distinguir traços finos. O guia de OCR da Biblioteca da Universidade de Illinois e o da Universidade de Pittsburgh convergem independentemente em 300 DPI como o limite onde os ganhos de precisão se estabilizam. Acima de 300 DPI, os retornos são decrescentes para texto padrão; abaixo de 200 DPI, a precisão cai de forma mensurável para todos os mecanismos testados.
2. Mantenha a câmera paralela ao documento. A inclinação de perspectiva força a IA a corrigir a inclinação da imagem antes de ler — adicionando uma etapa de pré-processamento onde erros se acumulam. Uma inclinação de apenas 5 graus pode causar uma queda de 2–10% na precisão. A maioria dos aplicativos de câmera de smartphones tem um modo de escaneamento de documentos que corrige automaticamente a perspectiva; use-o. Para scanners de mesa, alinhe a borda do documento contra a régua do leito do scanner.
3. Maximize o contraste na origem. Tinta escura em papel branco é o ideal. Se você controla a entrada — equipe de campo preenchendo formulários, técnicos escrevendo notas de inspeção — exija canetas esferográficas escuras. Lápis claro, tinta vermelha em papel colorido e papel térmico desbotado reduzem a taxa de contraste da qual os modelos de IA dependem. Uma configuração de brilho de 50% em scanners captura a maior faixa dinâmica sem lavar traços finos.
4. Elimine sombras com iluminação difusa. A luz natural de uma janela — indireta, não sol direto — produz a iluminação mais uniforme. Se usar luz artificial, posicione duas fontes em ângulos de 45 graus em cada lado do documento. O flash direto cria pontos de brilho que apagam o texto; uma mão segurando o telefone projeta uma sombra forte sobre metade da página. Ambos são evitáveis com dois segundos de reflexão sobre o posicionamento da luz.
5. Achate documentos dobrados antes de fotografar. Vincos e dobras criam distorções geométricas que quebram o formato dos caracteres. Se um documento foi dobrado, coloque-o sob um livro pesado por algumas horas antes de fotografar. Para documentos com vincos permanentes, digitalizar em modo RGB (não em escala de cinza ou preto e branco) preserva as informações tonais sutis que ajudam a IA a distinguir sombras de vincos do texto impresso.
6. Para documentos enviados por fax, remova o ruído antes da extração. Máquinas de fax usam algoritmos de compressão (MH, MR, MMR) que reduzem o tamanho do arquivo aproximando padrões de pixels — criando os artefatos "quadriculados" característicos ao redor do texto. Executar um filtro de mediana ou uma etapa de limiar adaptativo no fax antes da extração por IA remove o ruído de transmissão sem degradar ainda mais o texto. A melhoria não é dramática — um ganho de precisão de 5–10% é típico — mas em um fax de 50 páginas, isso se traduz em 20–30 erros a menos para corrigir manualmente.
Documentos Reais Onde a IA Lida com Qualidade Imperfeita
A diferença entre a precisão de benchmarks controlados e o desempenho no mundo real é maior em documentos de baixa qualidade — e é exatamente por isso que analisar casos de uso reais importa mais do que citar números de benchmarks.
Notas de entrega em campo fotografadas na cabine de um caminhão. Um motorista de logística tira uma foto de uma nota de entrega assinada no painel antes de seguir para a próxima parada. A foto tem desfoque de movimento devido ao motor vibrando, iluminação irregular da luz interna da cabine e um leve ângulo. Esta é uma entrada realista de pior caso — e a IA lida com ela melhor do que você esperaria. A natureza estruturada do formulário (número de entrega, nome do destinatário, data, bloco de assinatura) fornece âncoras semânticas. Com Custom Column Extraction, a IA extrai os campos impressos — número de entrega e data — com precisão quase normal, pois eles geralmente estão em posições consistentes com formatação clara. Nomes e assinaturas manuscritos do destinatário são mais difíceis: a IA os captura como indicadores de presença, em vez de transcrições precisas. O fluxo de trabalho prático: deixe a IA extrair os campos estruturados automaticamente e verifique manualmente as partes manuscritas.
Faturas enviadas por fax de fornecedores anteriores a 2020. Muitos fornecedores na construção, manufatura e atacado ainda enviam faturas por fax — especialmente fornecedores menores que não se digitalizaram. Uma fatura enviada por fax combina baixa resolução (100–200 DPI), artefatos de compressão e, às vezes, ruído de linha de transmissão. Em um teste documentado no benchmark Sparkco 2025, documentos enviados por fax processados com OCR alimentado por IA alcançaram aproximadamente 85–90% de precisão em nível de campo no texto impresso — em comparação com 60–70% para OCR tradicional. Os erros restantes se concentram em itens de linha com fonte pequena e impressão fraca. Para equipes de contas a pagar que processam dezenas de faturas por fax semanalmente, a extração por IA reduz a entrada manual à correção de erros, em vez de redigitar tudo — uma economia de tempo de 3–5x mesmo com saída imperfeita.
Documentos de arquivo amarelados dos anos 1990. Escritórios de advocacia, seguradoras e órgãos governamentais mantêm arquivos em papel com décadas de existência. Quando são digitalizados para fins de digitalização, o papel original amarelou, a tinta desbotou, e furos de grampo e anotações nas margens adicionam ruído. A IA lida bem com o amarelamento — a normalização de contraste durante o pré-processamento pode recuperar texto que parece quase invisível ao olho humano. O verdadeiro desafio é a tinta desbotada: em documentos em que o original era uma impressão matricial ou uma cópia carbono clara, simplesmente não há contraste suficiente para qualquer ferramenta recuperar de forma confiável. Nesses casos, a IA extrai o que consegue e sinaliza campos de baixa confiança para revisão humana — um fluxo de triagem muito mais eficiente do que a revisão manual de todos os campos.
Fotos de recibos tiradas com smartphone na iluminação de restaurantes. Um freelancer em um jantar de negócios tira uma foto do recibo sob iluminação quente e fraca de restaurante. A câmera do telefone compensa com ISO alto, introduzindo ruído; o papel é brilhante, criando um ponto de reflexo sobre parte do total; o recibo está levemente curvado por ter ficado na carteira. Apesar dos três problemas, a IA extrai os campos-chave — data, total, nome do fornecedor — corretamente na maioria dos casos porque recibos têm uma estrutura fortemente previsível. O total é quase sempre o maior número próximo ao rodapé, a data segue um formato reconhecível, e o nome do fornecedor fica no topo. A IA usa essas convenções de layout como âncoras implícitas mesmo quando caracteres individuais são difíceis de ler. Um teste de 2025 com 100 fotos de recibos tiradas com smartphone constatou que a extração por IA alcançou ~92% de precisão em nível de campo para totais e datas, caindo para ~80% em descrições de itens de linha, onde o texto é menor e mais afetado por reflexos.
Perguntas Frequentes
A IA consegue ler documentos digitalizados a 100 DPI?
De forma confiável, não. A 100 DPI, um caractere padrão de 10pt ocupa aproximadamente 14 pixels — não o suficiente para qualquer modelo de IA distinguir entre caracteres semelhantes como "8" e "3" ou "5" e "6". Algumas ferramentas de IA com pré-processamento de super-resolução conseguem recuperar texto parcial, mas espere precisão abaixo de 75% e altas taxas de erro em números e fontes pequenas. Re-digitalizar a 300 DPI é quase sempre a melhor resposta.
A IA lida melhor com desfoque de movimento do que o OCR tradicional?
Significativamente melhor — mas "melhor" não significa "resolve". A IA lê formas em nível de palavra e o contexto do documento, então um rótulo "Número da Fatura" levemente desfocado ainda é compreendido. O OCR tradicional segmenta caracteres individuais e falha quando os limites dos caracteres ficam borrados. A diferença é maior em desfoque moderado (a IA perde 5–12%, o tradicional perde 20–35%) e diminui em desfoque severo, onde nenhuma abordagem funciona de forma confiável. Para desfoque de movimento severo — o tipo de fotografar enquanto se move — recapturar a imagem é a única solução prática.
A IA consegue extrair dados de documentos enviados por fax?
Sim, com ressalvas. A IA alcança aproximadamente 85–90% de precisão em nível de campo em texto impresso via fax, em comparação com 60–70% do OCR tradicional. Os erros restantes concentram-se em itens de linha com fonte pequena, impressão fraca e documentos com ruído intenso de transmissão. Executar documentos enviados por fax em uma etapa de pré-processamento de redução de ruído (filtro de mediana ou limiar adaptativo) antes da extração melhora os resultados em 5–10%. Para documentos de alto valor, onde erros são custosos, planeje a verificação humana dos campos extraídos.
Qual é a qualidade mínima de imagem necessária para uma extração útil com IA?
Como limite prático: resolução equivalente a 200 DPI, ângulo reto (menos de 5 graus de inclinação) e contraste suficiente para que uma pessoa leia o texto sem apertar os olhos. Abaixo desses três limites simultaneamente, a precisão cai abaixo de 80% — o ponto em que o tempo de correção manual se aproxima do tempo de entrada manual. Se o seu documento atender a quaisquer dois dos três, vale a pena tentar a extração com IA. Se não atender a nenhum, melhore a entrada primeiro.
A IA consegue lidar com documentos danificados por água ou manchados?
Parcialmente, e de forma imprevisível. Danos por água não são uniformes: uma seção pode estar intacta enquanto outra é um borrão desbotado. A IA extrai as seções limpas normalmente e tem dificuldade nas danificadas — o mesmo que um leitor humano. O aprimoramento de contraste pode recuperar áreas moderadamente desbotadas, mas sangramento severo de tinta, onde os caracteres se fundiram fisicamente, não pode ser desfeito por nenhum software. Para documentos de arquivo, espere combinar a extração com IA com revisão manual das seções danificadas.
A compressão JPEG afeta a precisão da extração por IA?
Sim — e o dano é permanente. A compressão JPEG descarta detalhes finos para reduzir o tamanho do arquivo e, uma vez descartados, esses detalhes não podem ser recuperados por nenhuma etapa de pré-processamento. A compressão JPEG pesada (configuração de qualidade abaixo de 50%) cria "artefatos de blocos" — blocos de pixels de 8×8 visíveis ao redor do texto — que confundem os limites dos caracteres. Os modelos de IA lidam bem com compressão leve (qualidade 70+), mas em imagens fortemente comprimidas, a precisão cai de 5 a 10%. Se você tiver o escaneamento ou a foto original, use-o em vez de uma cópia re-comprimida.
Fotos de celular são tão boas quanto escaneamentos de mesa para extração por IA?
Em uma foto de celular bem tirada — de frente, com boa iluminação, sem desfoque de movimento, equivalente a 200+ DPI — a precisão fica dentro de 3 a 5 pontos percentuais de um escaneamento de mesa. A diferença aumenta conforme as condições pioram: uma foto de celular mal iluminada com desfoque de movimento pode ser de 15 a 25% menos precisa do que um escaneamento limpo. A diferença prática é a consistência: um escaneador de mesa a 300 DPI produz qualidade quase idêntica todas as vezes, enquanto fotos de celular variam enormemente com base na técnica. Se você processa documentos regularmente, um escaneador se paga em tempo reduzido de correção de erros.
A extração de documentos por IA em 2026 lida com entradas de baixa qualidade muito melhor do que as ferramentas de OCR que a maioria das pessoas já experimentou — mas "muito melhor" não é o mesmo que "perfeito". A curva de degradação é gradual em vez de catastrófica: a 200 DPI com desfoque moderado, você obtém dados utilizáveis. Abaixo de 150 DPI com desfoque severo ou defeitos compostos, você obtém frustração. A resposta honesta para "a IA consegue ler meus documentos borrados?" é "experimente um e veja" — porque sua combinação específica de tipo de documento, degradação e importância do campo determina se a saída está pronta para produção ou precisa de revisão humana. Envie seu pior documento e descubra onde sua qualidade se encontra na curva.
Se você está lidando com documentos que misturam conteúdo impresso e manuscrito — comum em formulários de campo de baixa qualidade — veja nosso guia sobre como a IA lê escrita manual em fotos. Para documentos onde a variabilidade de formato agrava problemas de qualidade, como a IA extrai dados de PDFs aborda a abordagem de extração independente de formato. E se você está avaliando se seu volume de documentos justifica automação, comece com o que é extração de documentos por IA e como funciona.