L'IA peut-elle lire des documents flous ?
Partiellement — où se situe la limite de précision
Partiellement. L'IA peut extraire des données de scans de qualité modérément faible — y compris des photos légèrement floues, des documents en résolution fax et des images en faible luminosité — avec une précision qui diminue progressivement plutôt que de façon catastrophique. En dessous d'environ 150 DPI équivalents, ou lorsque le flou de mouvement brouille les bords du texte au point de les rendre méconnaissables, la précision se dégrade considérablement. La distinction clé : les modèles de vision IA se dégradent en douceur parce qu'ils comprennent le contexte du document. L'OCR traditionnel, en revanche, s'effondre brutalement — son architecture de segmentation des caractères suppose des bords nets, et lorsque ces bords sont flous, il n'a aucun recours.
Points clés
- Pour chaque type de dégradation — basse résolution, flou de mouvement, bruit de fax — l'IA perd 2–3x moins de précision que l'OCR traditionnel et reste à 85–95% là où les anciens outils tombent sous les 50%.
- L'IA n'a pas une meilleure vue — elle lit le contexte du document comme vous lisez un reçu flou : vous ne voyez peut-être pas chaque chiffre, mais vous savez où se trouve le total et à quoi ressemble un montant en dollars.
- Une seule amélioration — passer la résolution de 100 à 200 DPI — peut faire passer la précision d'inutilisable à utilisable, car la dégradation combinée s'effondre lorsque la contrainte la plus limitante est levée.
Comment l'IA gère les différents types de dégradation
Tous les problèmes de qualité d'image n'affectent pas l'extraction par IA de la même manière. Certains types de dégradation sont étonnamment supportables ; d'autres font chuter la précision sous le seuil où l'automatisation fait gagner plus de temps que le coût de la correction manuelle. Le tableau ci-dessous associe chaque type de dégradation à son impact réel sur la précision, d'après des benchmarks OCR indépendants et des rapports de praticiens (Benchmark Sparkco 2025 ; OmniDocBench, CVPR 2025).
| Type de dégradation | Impact sur la précision de l'IA | Impact sur l'OCR traditionnel | Récupérable ? |
|---|---|---|---|
| Résolution modérément faible (150–200 DPI) | Baisse de 5–10 % par rapport à la référence | Baisse de 15–25 % | Oui — la compréhension contextuelle de l'IA compense |
| Résolution très faible (<150 DPI) | Baisse de 15–30 % | Baisse de 40–60 %, souvent inutilisable | Partiellement — le prétraitement par super-résolution aide mais ne peut pas récupérer les détails perdus |
| Léger flou de mouvement (téléphone tenu à la main, légère secousse) | Baisse de 5–12 % | Baisse de 20–35 % | Oui — l'IA lit les formes des mots, pas les traits de caractères individuels |
| Flou de mouvement important (véhicule en mouvement, panoramique rapide) | Baisse de 25–40 % | Baisse de 60–80 % | Limité — l'IA de débruitage peut récupérer une partie, une nouvelle capture est préférable |
| Faible contraste (encre délavée, crayon léger, papier jauni) | Baisse de 3–8 % | Baisse de 10–20 % | Oui — le prétraitement d'amélioration du contraste est très efficace |
| Qualité fax (100–200 DPI + artefacts de compression) | Baisse de 10–20 % | Baisse de 30–50 % | Partiellement — le débruitage spécifique au fax aide ; certaines données sont définitivement perdues |
| Artefacts de compression JPEG | Baisse de 5–10 % | Baisse de 15–25 % | Partiellement — les artefacts de blocage peuvent être lissés, mais les détails perdus sont irrécupérables |
| Éclairage inégal / ombres | Baisse de 5–10 % | Baisse de 15–25 % | Oui — la binarisation adaptative gère bien les ombres |
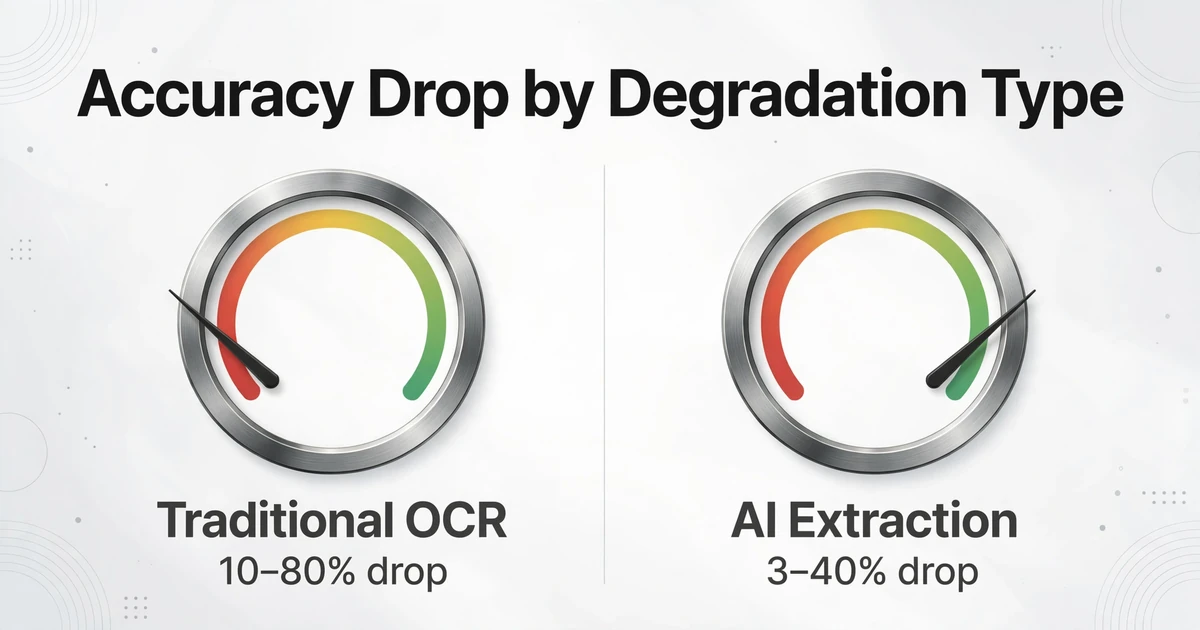
Deux tendances se dégagent. Premièrement, l'IA se dégrade 2 à 3 fois moins que l'OCR traditionnel dans chaque catégorie — l'écart de compréhension contextuelle se creuse à mesure que la qualité de l'image diminue. L'OCR traditionnel repose sur des contours de caractères nets pour segmenter et classer les lettres individuelles ; lorsque les contours sont flous, l'étape de segmentation échoue et les erreurs se propagent. Les modèles de vision par IA examinent des mots entiers, des étiquettes de champs et la structure du document — ainsi, un « T » flou dans « Total » est quand même lu correctement parce que le modèle sait que ce champ doit contenir un montant en dollars, pas une chaîne aléatoire.
Deuxièmement, plusieurs défauts modérés combinés sont pires qu'un seul défaut grave. Un document à faible contraste (baisse de 3 à 8 %) avec une légère inclinaison (baisse de 2 à 10 %) et des artefacts JPEG (baisse de 5 à 10 %) peut perdre 15 à 25 % de précision, même si aucun facteur n'est grave à lui seul. Cela importe car les documents du monde réel présentent rarement un seul problème — une facture reçue par fax est simultanément de faible résolution, bruitée et dégradée par la compression. L'étape de prétraitement la plus importante consiste à identifier quelle dégradation est le principal facteur et à la traiter en premier.
Ce que l'IA réussit bien sur les documents de faible qualité
L'avantage de l'IA sur les documents dégradés ne tient pas à une meilleure « vue » — c'est qu'elle a un meilleur contexte. L'OCR traditionnel lit un document comme un enfant qui épelle les lettres une par une. L'IA le lit comme vous liriez une photo floue d'un reçu : vous ne voyez peut-être pas chaque chiffre clairement, mais vous savez à quoi ressemble un reçu, où se trouve généralement le total et à quoi doit ressembler un montant en dollars.
Les formulaires structurés avec champs étiquetés sont le cas le plus solide de l'IA sur des entrées dégradées. Lorsqu'un document comporte des étiquettes de champs — « Numéro de facture », « Date », « Total dû » — même si le texte est partiellement flou, l'IA utilise l'étiquette comme ancre sémantique. Elle sait quel type de valeur attendre dans cette zone. C'est le mécanisme derrière Custom Column Extraction : vous définissez les noms de colonnes souhaités (par exemple, « Fournisseur », « Montant », « N° de bon de commande »), et l'IA localise chaque valeur en comprenant ce qu'elle signifie, et non en mesurant des distances de pixels. Un « 1 247,50 $ » flou à côté d'une étiquette « Total » est correctement extrait bien plus souvent qu'un « 1 247,50 $ » flou dans un coin sans étiquette.
Les documents de résolution modérément faible (150–200 DPI) sont dans la zone de confort de l'IA. Dans cette plage — typique des photos de smartphone prises à une distance raisonnable, ou des scans de platine plus anciens en qualité « brouillon » — les caractères individuels peuvent paraître flous, mais les formes des mots restent distinguables. Le benchmark Sparkco 2025 a constaté que les systèmes OCR basés sur l'IA maintiennent une précision de caractères supérieure à 90 % à 200 DPI, tandis que les moteurs traditionnels chutent vers 80 % ou moins. La différence est plus visible sur les petits textes : une police de 10 pt à 200 DPI fait ~28 pixels de haut, suffisant pour que l'IA la résolve, mais marginal pour l'OCR basé sur la segmentation.
Les documents de qualité fax avec contenu textuel bénéficient d'une force inattendue de l'IA : la préservation de la mise en page. Les algorithmes de compression fax (MH, MR, MMR) déforment les traits fins des caractères mais préservent la relation spatiale entre les blocs de texte. Comme l'IA lit en comprenant la structure du document — en-têtes, corps de texte, tableaux — plutôt que caractère par caractère, elle peut souvent récupérer un texte faxé qu'un moteur OCR traditionnel fragmenterait en charabia. Le prétraitement de débruitage spécifique au fax (LlamaIndex, 2026) améliore encore les résultats en supprimant le bruit de transmission avant que l'IA ne traite le document.
Les photos de téléphone en faible lumière avec un éclairage uniforme (sans ombres dures) sont traitées étonnamment bien. Les modèles d'IA modernes ont été entraînés sur des images réelles variées et sont robustes aux motifs de bruit et aux dominantes de couleur typiques de la photographie en intérieur. L'inconvénient est que les ombres — en particulier les ombres dures projetées par la main tenant le téléphone au-dessus du document — créent des bords de contraste artificiels qui perturbent la détection de la mise en page. Diffusez la lumière (rapprochez-vous d'une fenêtre, évitez le flash direct) et la précision se maintient à 5–8 % près d'un scan propre.
Là où l'IA a encore des difficultés
La liste honnête des modes de défaillance importe plus que les cas de réussite — car télécharger un document et obtenir un résultat inexploitable est ce qui vous fait perdre définitivement confiance en un outil.
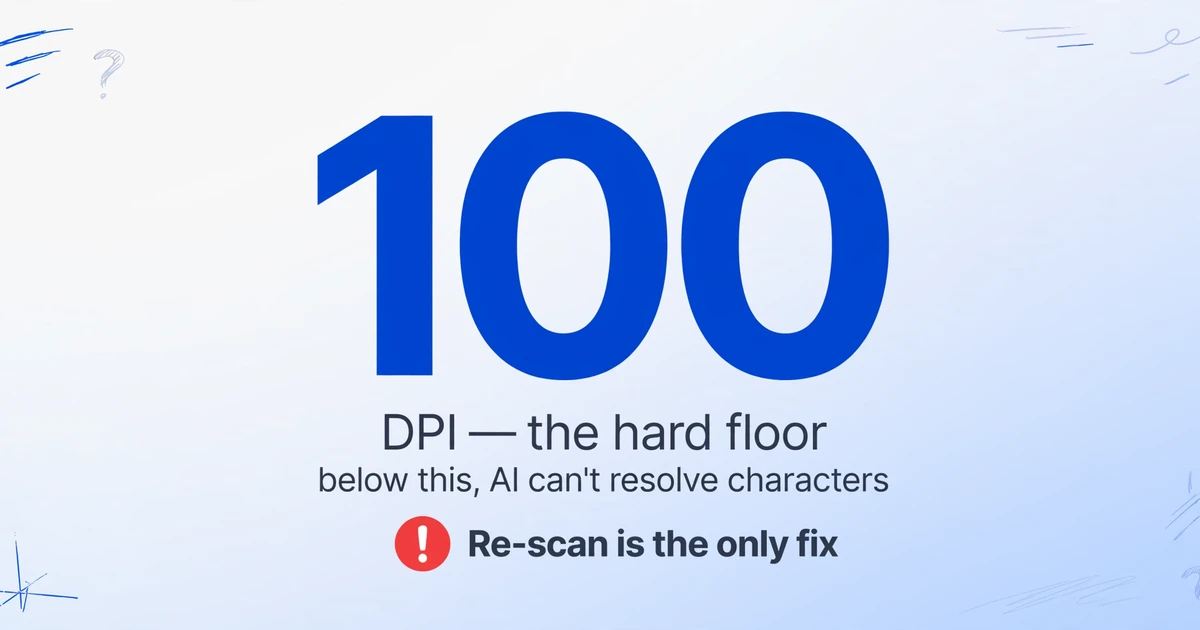
Résolution inférieure à 100 DPI est le seuil minimal. En dessous d'environ 100 DPI — courant avec des documents photographiés de trop loin, des PDF fortement réduits, ou des images de taille miniature — les caractères individuels occupent trop peu de pixels pour qu'un modèle puisse les résoudre. Un caractère de 10 points à 100 DPI ne fait qu'environ 14 pixels de haut, et les traits fins qui distinguent le « 8 » du « 3 » ou le « 5 » du « 6 » font 2 à 3 pixels de large. La super-résolution IA peut interpoler les détails manquants, mais l'interpolation invente des informations — elle devine ce que devraient être les pixels manquants, et ces suppositions sont parfois erronées. Comme le guide OCR basse résolution de LlamaIndex le note : « L'upscaling ne peut pas récupérer des détails qui n'ont jamais été capturés. » À ce niveau de résolution, renumériser ou rephotographier est la seule voie fiable.
Flou de mouvement sévère — le genre causé par la photographie d'un document en marchant, ou depuis un véhicule en mouvement — est le type de dégradation le plus dommageable. Le flou de mouvement étale le texte dans une direction cohérente, fusionnant les caractères en traînées continues. Contrairement à la basse résolution, où les caractères conservent leur forme avec une fidélité réduite, le flou de mouvement détruit entièrement les limites des caractères. Des benchmarks indépendants montrent systématiquement que le flou de mouvement est le facteur de qualité le plus dommageable, avec des baisses de précision de 10 à 20 % même dans les cas modérés (benchmark OCR Sparkco 2025 ; analyse OCR basse résolution de LlamaIndex). Les modèles de débruitage IA se sont améliorés, mais ils font face à une limite fondamentale de la théorie de l'information : des pixels étalés sur plusieurs positions de caractères ne peuvent pas être désétalés avec certitude.
Documents endommagés par l'eau et physiquement dégradés — bavures d'encre, taches d'eau, moisissures, papier thermique décoloré — présentent un problème composé. La dégradation est non uniforme : un coin de la page peut être parfaitement lisible tandis qu'un autre est une tache délavée. Les modèles IA peinent face à cette incohérence spatiale car leur compréhension de la mise en page suppose un document cohérent. Une étude de 2025 sur l'OCR de documents dégradés (IJSAT, 2026) a constaté que les documents froissés réduisaient la précision de l'OCR de 30 à 45 % sur tous les moteurs testés, et les documents mouillés/tachés de 25 à 40 %, les modèles IA surpassant l'OCR traditionnel mais restant bien en dessous des seuils de production. Pour une numérisation de qualité archivistique de documents endommagés, des outils spécialisés avec vérification humaine restent nécessaires.
Documents pliés, cornés et déchirés créent des distorsions géométriques qui brisent la forme des caractères. Un pli traversant une ligne de texte crée une crête visible où les caractères se compriment verticalement ; l'IA peut lire la section compressée comme un caractère différent ou la manquer entièrement. Aplatir le document sous un poids avant la photographie aide considérablement, mais les plis profonds qui ont déformé le papier de façon permanente continueront de causer des erreurs. Le guide OCR de la bibliothèque de l'Université de Pittsburgh recommande de numériser les documents pliés en mode RVB plutôt qu'en niveaux de gris pour préserver les subtiles informations d'ombrage qui aident à distinguer les ombres des plis de l'encre.
Dégradation composée — le cas réel où un document est simultanément en basse résolution, incliné, bruité et mal éclairé — défait même les meilleurs pipelines de prétraitement. Chaque étape d'amélioration (redressement, débruitage, netteté, normalisation du contraste) introduit ses propres artefacts, et ces artefacts se cumulent. Un utilisateur de Reddit sur r/MachineLearning a documenté cela précisément : Tesseract atteignait 80–90 % sur de bonnes images, 60 % sur des images moyennes, et 0 % sur des images de mauvaise qualité où plusieurs défauts coexistaient. L'effet de cumul signifie qu'améliorer ne serait-ce qu'un facteur — par exemple, augmenter la résolution de 100 à 200 DPI tout en laissant l'inclinaison et le bruit inchangés — peut faire passer la précision de « inutilisable » à « vérifiable », car cela supprime la contrainte la plus limitante.
Comment obtenir les meilleurs résultats avec des documents imparfaits
L'action la plus efficace est d'améliorer l'entrée avant qu'elle n'atteigne l'IA. Le prétraitement peut récupérer 10–20 % de la précision perdue sur des documents modérément dégradés — souvent assez pour faire passer une image limite dans la plage utilisable.
1. Numérisez ou photographiez à 300 DPI minimum. C'est la recommandation la plus fréquemment répétée dans tous les benchmarks OCR et guides de bibliothèque — et pour cause. À 300 DPI, un caractère de 10 pt s'étend sur environ 42 pixels, donnant à l'IA suffisamment de résolution pour distinguer les traits fins. Le guide OCR de l'Université de l'Illinois et celui de l'Université de Pittsburgh convergent tous deux indépendamment vers 300 DPI comme seuil où les gains de précision plafonnent. Au-dessus de 300 DPI, les rendements sont décroissants pour le texte standard ; en dessous de 200 DPI, la précision chute de manière mesurable pour chaque moteur testé.
2. Tenez la caméra parallèle au document. L'inclinaison en perspective force l'IA à redresser l'image avant de la lire — ajoutant une étape de prétraitement où les erreurs se cumulent. Une inclinaison de 5 degrés seule peut entraîner une baisse de précision de 2 à 10 %. La plupart des applications de caméra de smartphone ont un mode de numérisation de document qui corrige automatiquement la perspective ; utilisez-le. Pour les scanners à plat, alignez le bord du document contre la règle du plateau.
3. Maximisez le contraste à la source. De l'encre foncée sur du papier blanc est idéal. Si vous contrôlez l'entrée — le personnel de terrain remplissant des formulaires, les techniciens écrivant des notes d'inspection — imposez des stylos à bille foncés. Le crayon clair, l'encre rouge sur papier coloré et le papier thermique délavé réduisent tous le rapport de contraste dont dépendent les modèles d'IA. Un réglage de luminosité de 50 % sur les scanners capture la plage dynamique la plus large sans délaver les traits fins.
4. Éliminez les ombres avec un éclairage diffus. La lumière naturelle du jour provenant d'une fenêtre — indirecte, pas en plein soleil — produit l'éclairage le plus uniforme. Si vous utilisez une lumière artificielle, placez deux sources à des angles de 45 degrés de chaque côté du document. Le flash direct crée des zones surexposées qui effacent le texte ; une main tenant le téléphone projette une ombre dure sur la moitié de la page. Les deux sont évitables avec deux secondes de réflexion sur le placement de la lumière.
5. Aplatissez les documents pliés avant de les photographier. Les plis et les replis créent des distorsions géométriques qui brisent la forme des caractères. Si un document a été plié, placez-le sous un livre épais pendant quelques heures avant de le photographier. Pour les documents présentant des plis permanents, la numérisation en mode RGB (pas en niveaux de gris ni en noir et blanc) préserve les informations tonales subtiles qui aident l'IA à distinguer les ombres des plis du texte imprimé.
6. Pour les documents faxés, débruitez avant l'extraction. Les télécopieurs utilisent des algorithmes de compression (MH, MR, MMR) qui réduisent la taille des fichiers en approximant les motifs de pixels — créant les artefacts « en blocs » caractéristiques autour du texte. Faire passer un fax par un filtre médian ou une étape de seuillage adaptatif avant l'extraction par IA élimine le bruit de transmission sans dégrader davantage le texte. L'amélioration n'est pas spectaculaire — un gain de précision de 5 à 10 % est typique — mais sur un fax de 50 pages, cela se traduit par 20 à 30 erreurs en moins à corriger manuellement.
Documents réels où l'IA gère une qualité imparfaite
L'écart entre la précision des benchmarks contrôlés et les performances réelles est le plus important sur les documents de faible qualité — c'est précisément pour cela qu'examiner des cas d'usage réels importe plus que de citer des chiffres de benchmark.
Notes de livraison sur le terrain photographiées dans une cabine de camion. Un chauffeur logistique prend une photo d'un bon de livraison signé sur le tableau de bord avant de se rendre à l'arrêt suivant. La photo présente un flou de mouvement dû au moteur qui vibre, un éclairage inégal provenant de la lampe de cabine et un léger angle. C'est une entrée réaliste dans le pire des cas — et l'IA la gère mieux que ce que l'on pourrait attendre. La nature structurée du formulaire (numéro de livraison, nom du destinataire, date, bloc de signature) fournit des ancres sémantiques. Avec l'Extraction de colonnes personnalisées, l'IA extrait les champs imprimés — numéro de livraison et date — avec une précision quasi normale, car ils se trouvent généralement à des positions cohérentes avec un formatage clair. Les noms et signatures manuscrits du destinataire sont plus difficiles : l'IA les capture comme indicateurs de présence plutôt que comme transcriptions précises. Le flux de travail pratique : laissez l'IA extraire automatiquement les champs structurés, puis vérifiez ponctuellement les parties manuscrites.
Factures faxées de fournisseurs d'avant 2020. De nombreux fournisseurs dans la construction, la fabrication et le gros œuvre envoient encore des factures par fax — en particulier les petits fournisseurs qui n'ont pas numérisé leurs processus. Une facture faxée combine une faible résolution (100–200 DPI), des artefacts de compression et parfois du bruit de ligne de transmission. Lors d'un test documenté dans le benchmark Sparkco 2025, les documents faxés traités par OCR assistée par IA ont atteint une précision au niveau des champs d'environ 85 à 90 % sur le texte imprimé — contre 60 à 70 % pour l'OCR traditionnel. Les erreurs restantes se concentrent sur les lignes en petite police et les impressions faibles. Pour les équipes de comptabilité fournisseurs qui traitent des dizaines de factures faxées chaque semaine, l'extraction par IA réduit la saisie manuelle à une simple correction d'erreurs plutôt qu'à une ressaisie complète — un gain de temps de 3 à 5 fois même sur une sortie imparfaite.
Documents d'archives jaunis datant des années 1990. Les cabinets d'avocats, les compagnies d'assurance et les agences gouvernementales conservent des archives papier vieilles de plusieurs décennies. Lorsqu'ils sont numérisés, le papier d'origine a jauni, l'encre a pâli, et les trous d'agrafeuse ainsi que les annotations en marge ajoutent du bruit. L'IA gère bien le jaunissement — la normalisation du contraste lors du prétraitement peut récupérer un texte quasi invisible à l'œil humain. Le vrai défi réside dans l'encre pâlie : sur les documents issus d'impressions matricielles ou de copies carbone légères, le contraste est tout simplement insuffisant pour qu'un outil puisse récupérer le texte de manière fiable. Dans ces cas, l'IA extrait ce qu'elle peut et signale les champs à faible confiance pour une vérification humaine — un flux de tri bien plus efficace qu'une vérification manuelle de chaque champ.
Photos de reçus prises au smartphone sous un éclairage de restaurant. Un travailleur indépendant photographie un reçu lors d'un dîner d'affaires sous un éclairage chaud et tamisé. L'appareil photo compense avec un ISO élevé, introduisant du bruit ; le papier est brillant, créant une zone de reflet sur une partie du total ; le reçu est légèrement courbé après avoir été dans un portefeuille. Malgré ces trois problèmes, l'IA extrait correctement les champs clés — date, total, nom du vendeur — dans la plupart des cas, car les reçus ont une structure fortement prévisible. Le total est presque toujours le plus grand nombre près du bas, la date suit un format reconnaissable et le nom du vendeur se trouve en haut. L'IA utilise ces conventions de mise en page comme ancres implicites, même lorsque les caractères individuels sont difficiles à lire. Un test réalisé en 2025 sur 100 photos de reçus prises au smartphone a montré que l'extraction par IA atteignait ~92 % de précision au niveau des champs pour les totaux et les dates, tombant à ~80 % pour les descriptions de lignes où le texte est le plus petit et le plus affecté par les reflets.
Questions fréquemment posées
L'IA peut-elle lire des documents numérisés à 100 DPI ?
De manière fiable, non. À 100 DPI, un caractère standard de 10 points occupe environ 14 pixels — insuffisant pour qu'un modèle d'IA distingue des caractères similaires comme « 8 » et « 3 » ou « 5 » et « 6 ». Certains outils d'IA avec prétraitement par super-résolution peuvent récupérer un texte partiel, mais attendez-vous à une précision inférieure à 75 % et à des taux d'erreur élevés sur les chiffres et les petites polices. Une nouvelle numérisation à 300 DPI est presque toujours la meilleure solution.
L'IA gère-t-elle mieux le flou de mouvement que l'OCR traditionnel ?
Nettement mieux — mais « mieux » ne signifie pas « résout ». L'IA lit les formes au niveau des mots et le contexte du document, donc une étiquette « Numéro de facture » légèrement floue est tout de même comprise. L'OCR traditionnel segmente les caractères individuellement et échoue lorsque les limites des caractères sont floues. L'écart est le plus important sur un flou modéré (l'IA perd 5–12 %, le traditionnel perd 20–35 %) et se réduit sur un flou sévère où aucune approche ne fonctionne de manière fiable. Pour un flou de mouvement sévère — le genre obtenu en photographiant en mouvement — la seule solution pratique est de reprendre l'image.
L'IA peut-elle extraire des données de documents faxés ?
Oui, avec des réserves. L'IA atteint environ 85–90 % de précision au niveau des champs sur du texte imprimé faxé, contre 60–70 % pour l'OCR traditionnel. Les erreurs restantes se concentrent sur les lignes en petite police, l'impression faible et les documents avec un bruit de transmission important. Faire passer les documents faxés par une étape de prétraitement de débruitage (filtre médian ou seuillage adaptatif) avant l'extraction améliore les résultats de 5–10 %. Pour les documents à forte valeur où les erreurs coûtent cher, prévoyez une vérification humaine des champs extraits.
Quelle est la qualité d'image minimale requise pour une extraction IA exploitable ?
Comme seuil pratique : une résolution équivalente à 200 DPI, un angle droit (moins de 5 degrés d'inclinaison) et un contraste suffisant pour qu'un humain puisse lire le texte sans plisser les yeux. Si ces trois seuils sont simultanément sous ces niveaux, la précision tombe sous 80 % — le point où le temps de correction manuelle approche le temps de saisie manuelle. Si votre document satisfait deux des trois critères, l'extraction IA vaut la peine d'être tentée. S'il n'en satisfait aucun, améliorez d'abord l'entrée.
L'IA peut-elle traiter les documents endommagés par l'eau ou tachés ?
Partiellement, et de manière imprévisible. Les dégâts des eaux ne sont pas uniformes : une section peut être intacte tandis qu'une autre est une tache délavée. L'IA extrait normalement les sections propres et a du mal sur les sections endommagées — comme un lecteur humain. L'amélioration du contraste peut récupérer les zones modérément délavées, mais un saignement d'encre sévère où les caractères ont physiquement fusionné ne peut être annulé par aucun logiciel. Pour les documents d'archives, prévoyez de combiner l'extraction IA avec une relecture manuelle des sections endommagées.
La compression JPEG affecte-t-elle la précision de l'extraction par IA ?
Oui — et les dégâts sont permanents. La compression JPEG supprime les détails fins pour réduire la taille du fichier, et une fois supprimés, ces détails ne peuvent être récupérés par aucune étape de prétraitement. Une forte compression JPEG (réglage de qualité inférieur à 50 %) crée des « artefacts de blocage » — des blocs de pixels de 8×8 visibles autour du texte — qui perturbent les limites des caractères. Les modèles d'IA gèrent bien une compression légère (qualité 70+), mais sur des images fortement compressées, la précision chute de 5 à 10 %. Si vous disposez du scan ou de la photo d'origine, utilisez-les plutôt qu'une copie recompressée.
Les photos de téléphone sont-elles aussi bonnes que les scans à plat pour l'extraction par IA ?
Sur une photo de téléphone bien prise — à angle droit, bon éclairage, sans flou de mouvement, équivalent 200+ DPI — la précision se situe à moins de 3 à 5 points de pourcentage d'un scan à plat. L'écart se creuse à mesure que les conditions se dégradent : une photo de téléphone mal éclairée avec flou de mouvement peut être 15 à 25 % moins précise qu'un scan propre. La différence pratique réside dans la constance : un scanner à plat à 300 DPI produit une qualité quasi identique à chaque fois, tandis que les photos de téléphone varient énormément selon la technique. Si vous traitez des documents régulièrement, un scanner s'amortit grâce à la réduction du temps de correction des erreurs.
L'extraction de documents par IA en 2026 gère bien mieux les entrées de faible qualité que les outils OCR que la plupart des gens ont essayés — mais « bien mieux » n'est pas la même chose que « parfait ». La courbe de dégradation est progressive plutôt que catastrophique : à 200 DPI avec un flou modéré, vous obtiendrez des données exploitables. En dessous de 150 DPI avec un flou sévère ou des défauts combinés, vous obtiendrez de la frustration. La réponse honnête à « l'IA peut-elle lire mes documents flous ? » est « essayez-en un et voyez » — car votre combinaison spécifique de type de document, de dégradation et d'importance des champs détermine si le résultat est prêt pour la production ou nécessite une relecture humaine. Téléchargez votre pire document et découvrez où se situe votre qualité sur la courbe.
Si vous traitez des documents qui mélangent contenu imprimé et manuscrit — courant dans les formulaires de terrain de faible qualité — consultez notre guide sur comment l'IA lit l'écriture manuscrite à partir de photos. Pour les documents où la variabilité du format aggrave les problèmes de qualité, comment l'IA extrait les données des PDF couvre l'approche d'extraction indépendante du format. Et si vous évaluez si votre volume de documents justifie l'automatisation, commencez par ce qu'est l'extraction de documents par IA et comment elle fonctionne.