AIはぼやけた文書を読めるのか?
部分的に読める — 精度の限界線はここだ
部分的に読めます。AIは中程度の低品質スキャン(少しぼやけた写真、FAX解像度の文書、暗い場所で撮影した画像など)からデータを抽出でき、精度は急激に落ちるのではなく徐々に低下します。およそ150 DPI相当を下回る場合や、激しいモーションブラーで文字のエッジが認識できないほど潰れている場合は、精度が大幅に低下します。重要な違いは、AIビジョンモデルは文書のコンテキストを理解するため、精度が緩やかに低下する点です。一方、従来のOCRは急激に性能が落ちます。文字分割アーキテクチャが鮮明なエッジを前提としており、エッジがぼやけると代替手段がないからです。
重要なポイント
- 低解像度、モーションブラー、FAXノイズなど、あらゆる劣化タイプにおいて、AIは従来のOCRより2〜3倍精度の低下が少なく、従来ツールが50%未満に落ち込む場面でも85〜95%を維持します。
- AIの視力が優れているわけではありません。ぼやけたレシートを読むときと同じように文書のコンテキストを読み取ります。すべての数字が見えなくても、合計金額がどこにあるか、ドル金額がどのような形かを知っているのです。
- 解像度を100 DPIから200 DPIに引き上げるという単一の改善だけで、精度が実用不可から実用可能に向上します。最も制約の強い要因を取り除けば、複合的な劣化が解消されるからです。
AIはさまざまな種類の劣化にどの程度対応できるか
画像品質の問題がAI抽出に与える影響は、すべて同じではありません。ある種の劣化は驚くほど耐性があり、他の劣化は自動化が手動修正のコストを上回る精度の閾値を下回ります。以下の表は、独立したOCRベンチマークと実務者の報告に基づき、各劣化タイプと実際の精度への影響を対応付けたものです(Sparkco 2025ベンチマーク;OmniDocBench、CVPR 2025)。
| 劣化タイプ | AIの精度への影響 | 従来型OCRの影響 | 復元可能か? |
|---|---|---|---|
| 中程度の低解像度(150〜200 DPI) | ベースラインから5〜10%低下 | 15〜25%低下 | はい — AIの文脈理解が補完 |
| 深刻な低解像度(<150 DPI) | 15〜30%低下 | 40〜60%低下、多くの場合使用不能 | 部分的 — 超解像前処理は役立つが、失われた詳細は復元できない |
| 軽度のモーションブラー(手持ちスマホ、軽い手ブレ) | 5〜12%低下 | 20〜35%低下 | はい — AIは個々の文字のストロークではなく単語の形状を読む |
| 深刻なモーションブラー(走行中の車両、高速パン) | 25〜40%低下 | 60〜80%低下 | 限定的 — デブラーAIである程度復元可能だが、再撮影が最善 |
| 低コントラスト(かすれたインク、薄い鉛筆、黄ばんだ紙) | 3〜8%低下 | 10〜20%低下 | はい — コントラスト強調の前処理が非常に効果的 |
| ファックス品質(100〜200 DPI+圧縮アーティファクト) | 10〜20%低下 | 30〜50%低下 | 部分的 — ファックス専用ノイズ除去は役立つが、一部のデータは永久に失われる |
| JPEG圧縮アーティファクト | 5〜10%低下 | 15〜25%低下 | 部分的 — ブロックノイズは平滑化できるが、失われた詳細は戻らない |
| 不均一な照明/影 | 5〜10%低下 | 15〜25%低下 | はい — 適応的二値化が影をうまく処理 |
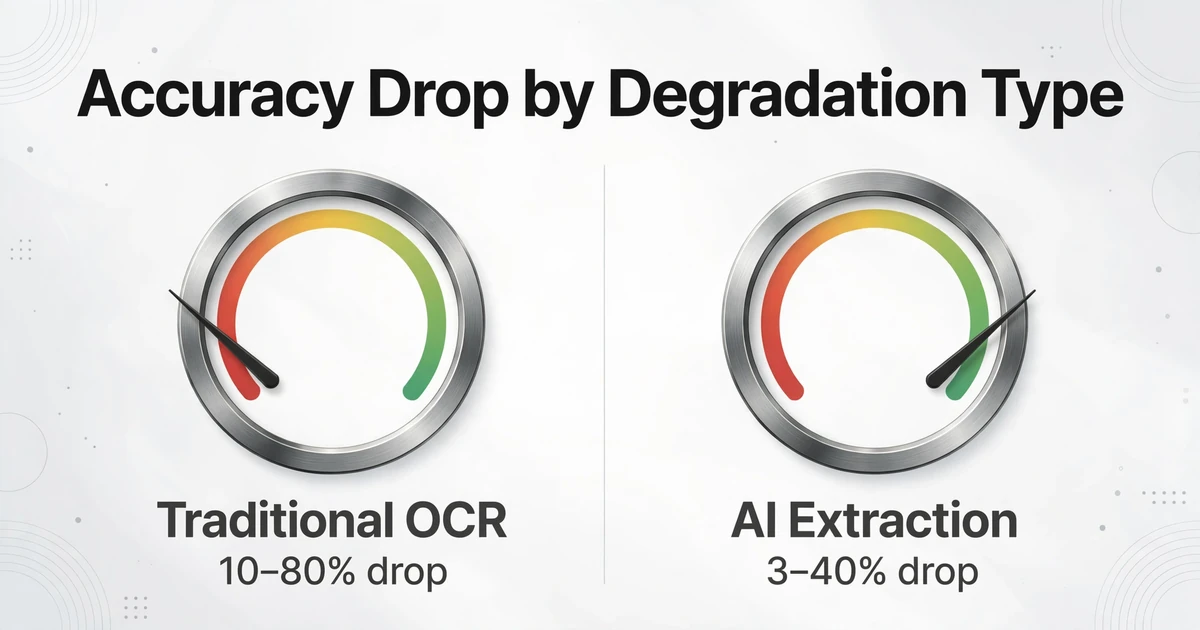
2つのパターンが際立ちます。第一に、AIはすべてのカテゴリで従来型OCRより2〜3倍劣化が少ない — 画像品質が低下するにつれて、文脈理解のギャップは広がります。従来型OCRは個々の文字を分割・分類するためにクリーンな文字エッジに依存します。エッジがぼやけると分割ステップが失敗し、エラーが連鎖します。AIビジョンモデルは単語全体、フィールドラベル、文書構造を見るため、「Total」のぼやけた「T」も、このフィールドにランダムな文字列ではなく金額が入るべきだとモデルが知っているため、正しく読み取られます。
次に、中程度の欠陥が複数重なると、単一の深刻な欠陥よりも悪影響が大きくなります。コントラスト低下(3〜8%の低下)にわずかな傾き(2〜10%の低下)、JPEGアーティファクト(5〜10%の低下)が加わると、単一の要因が深刻でなくても、精度が15〜25%低下する可能性があります。これは、実際の文書には単一の問題しかないことがほとんどないため重要です。ファックスで送られた請求書は、低解像度、ノイズ、圧縮アーティファクトが同時に発生しています。最も重要な前処理ステップは、どの劣化が主因であるかを特定し、それを最初に対処することです。
AIが低品質文書で得意とすること
劣化した文書に対するAIの利点は、「視力」が優れていることではなく、「文脈」を理解できることです。従来のOCRは、子供が文字を一文字ずつ音読するように文書を読み取ります。AIは、ぼやけたレシートの写真を読むときと同じように読み取ります。すべての数字がはっきり見えなくても、レシートがどのようなものか、合計金額が通常どこにあるか、金額がどのように見えるべきかを知っています。
ラベル付きフィールドを持つ構造化フォームは、劣化した入力に対するAIの最も強いケースです。文書に「請求書番号」「日付」「合計請求額」などのフィールドラベルがある場合、テキストが部分的にぼやけていても、AIはラベルを意味的なアンカーとして使用します。その領域にどのような種類の値が期待されるかを知っています。これがカスタム列抽出の背後にあるメカニズムです。抽出したい列名(例:「仕入先」「金額」「発注番号」)を定義すると、AIはピクセル距離を測定するのではなく、意味を理解することで各値を特定します。「合計」というラベルの隣にあるぼやけた「$1,247.50」は、ラベルのない隅にあるぼやけた「$1,247.50」よりもはるかに高い頻度で正確に抽出されます。
中程度の低解像度文書(150〜200 DPI)は、AIの得意範囲内です。この範囲(スマートフォンを適度な距離から撮影した写真や、「下書き」品質の古いフラットベッドスキャナに典型的)では、個々の文字は柔らかく見えるかもしれませんが、単語の形状は判別可能です。Sparkco 2025ベンチマークでは、AIベースのOCRシステムは200 DPIで90%以上の文字精度を維持する一方、従来のエンジンは80%以下に低下することがわかりました。この差は小さなテキストで最も顕著です。200 DPIでの10ptフォントは高さ約28ピクセルで、AIが解像するには十分ですが、セグメンテーションベースのOCRにはぎりぎりです。
テキストコンテンツを含むファックス品質の文書は、予想外のAIの強みであるレイアウト保持の恩恵を受けます。ファックス圧縮アルゴリズム(MH、MR、MMR)は細かい文字のストロークを歪めますが、テキストブロック間の空間的関係は保持します。AIは文字ごとではなく、文書構造(ヘッダー、本文、表)を理解して読み取るため、従来のOCRエンジンが意味不明な断片に分割してしまうファックステキストを回復できることがよくあります。ファックス固有のノイズ除去前処理(LlamaIndex、2026年)により、AIが文書を処理する前に伝送ノイズを除去することで、結果がさらに向上します。
照明が均一な(強い影のない)暗い場所でのスマートフォン写真は、驚くほど良好に処理されます。最新のAIモデルは多様な実世界の画像でトレーニングされており、屋内写真に典型的なノイズパターンや色かぶりに対して堅牢です。問題は影、特に文書の上にスマートフォンをかざした手による強い影が、レイアウト検出を混乱させる人工的なコントラストエッジを作り出すことです。光を拡散させると(窓の近くに移動する、直接フラッシュを避ける)、精度はクリーンなスキャンの5〜8%以内に維持されます。
AIがまだ苦手とする領域
成功事例よりも、正直な失敗モードのリストの方が重要です。なぜなら、文書をアップロードしてゴミのような出力を得ることは、ツールへの信頼を永久的に失うきっかけになるからです。
100 DPI未満の解像度はハードな下限です。約100 DPI未満 — 遠すぎる距離から撮影された文書、大幅にダウンサンプリングされたPDF、またはサムネイルサイズの画像によく見られる状態 — では、個々の文字がどのモデルでも解像できないほど少ないピクセルしか占めません。100 DPIでの10pt文字は高さ約14ピクセルしかなく、「8」と「3」や「5」と「6」を区別する細いストロークは幅2〜3ピクセルです。AI超解像は欠落した詳細を補間できますが、補間は情報を発明します — 欠落したピクセルがどうあるべきかを推測し、その推測は時々間違っています。LlamaIndexの低解像度OCRガイドが指摘するように:「アップスケーリングは、決してキャプチャされなかった詳細を回復することはできません。」この解像度レベルでは、再スキャンまたは再撮影が唯一の信頼できる方法です。
深刻なモーションブラー — 歩きながら文書を撮影したり、移動中の車両から撮影したりする際に発生する種類 — は、最も破壊的な劣化タイプです。モーションブラーはテキストを一貫した方向にぼかし、文字を連続した筋に融合させます。低解像度では文字が縮小された忠実度で形状を保つのに対し、モーションブラーは文字の境界を完全に破壊します。独立したベンチマークは一貫して、モーションブラーが最も破壊的な品質要因であり、中程度のケースでも精度が10〜20%低下することを示しています(Sparkco 2025 OCRベンチマーク;LlamaIndex低解像度OCR分析)。AIデブラリングモデルは改善されましたが、根本的な情報理論上の限界に直面しています:複数の文字位置にわたってぼやけたピクセルは、確実に元に戻すことはできません。
水損や物理的に劣化した文書 — インクのにじみ、水染み、カビの斑点、色あせた感熱紙 — は複合的な問題を提示します。劣化は不均一です:ページの一角は完全に読み取れる一方、別の一角は洗い流されたようなスミアになっている場合があります。AIモデルは、レイアウト理解が一貫した文書を想定しているため、この空間的不整合性に苦労します。劣化文書OCRに関する2025年の研究(IJSAT、2026年)では、しわくちゃの文書はテストされたすべてのエンジンでOCR精度を30〜45%低下させ、濡れた/汚れた文書では25〜40%低下させ、AIモデルは従来のOCRを上回るものの、依然として本番環境のしきい値を大幅に下回ることが判明しました。損傷した文書のアーカイブ品質のデジタル化には、人間が検証に関与する専門ツールが引き続き必要です。
折り目、しわ、破損のあるドキュメントは、文字の形状を崩す幾何学的な歪みを生み出します。文字列を横切る折り目は、文字が垂直方向に圧縮される目に見える稜線を作り出します。AIは圧縮された部分を別の文字として読んだり、完全に見逃したりする可能性があります。撮影前に文書を重しで平らにすると大幅に改善されますが、紙が恒久的に変形する深い折り目は依然としてエラーを引き起こします。ピッツバーグ大学図書館のOCRガイドでは、折り目のある文書をグレースケールではなくRGBモードでスキャンし、折り目の影とインクを区別するのに役立つ微妙な陰影情報を保持することを推奨しています。
複合的な劣化 — 文書が同時に低解像度で、傾き、ノイズ、照明不良を抱える現実的なケース — は、最良の前処理パイプラインでさえも打ち負かします。各強調ステップ(傾き補正、ノイズ除去、シャープ化、コントラスト正規化)は独自のアーティファクトを導入し、これらのアーティファクトは複合的に悪化します。r/MachineLearningのRedditユーザーはこれを正確に記録しています。Tesseractは良好な画像で80〜90%、中程度で60%、複数の欠陥が同時に発生する低品質画像では0%の精度でした。複合効果とは、1つの要素だけを改善する — 例えば、傾きとノイズをそのままにして解像度を100から200 DPIに上げる — ことで、最も制約の強い要因を取り除くため、精度を「使用不可」から「確認可能」に引き上げられることを意味します。
不完全なドキュメントから最良の結果を得る方法
最も効果の高いアクションは、AIに渡す前に入力を改善することです。前処理は、中程度に劣化した文書で失われた精度の10〜20%を回復できます — 多くの場合、境界線上にある画像を使用可能な範囲に押し上げるのに十分です。
1. 最低300 DPIでスキャンまたは撮影する。 これは、すべてのOCRベンチマークとライブラリガイドで最も頻繁に繰り返される推奨事項です — それには十分な理由があります。300 DPIでは、10ptの文字は約42ピクセルに及び、AIが細かいストロークを区別するのに十分な解像度を提供します。イリノイ大学図書館のOCRガイドとピッツバーグ大学は、どちらも独立して、精度向上が頭打ちになる閾値として300 DPIに収束しています。300 DPIを超えると標準テキストでは収穫逓減になります。200 DPI未満では、テストされたすべてのエンジンで精度が測定可能なほど低下します。
2. カメラを文書と平行に保つ。 透視歪みがあると、AIは読み取り前に画像の傾きを補正する必要があり、エラーが複合する前処理ステップが追加されます。5度の傾きだけで、2〜10%の精度低下を引き起こす可能性があります。ほとんどのスマートフォンのカメラアプリには、透視を自動補正するドキュメントスキャンモードがあります。それを使用してください。フラットベッドスキャナーの場合は、文書の端をスキャナー台の定規に合わせてください。
3. 元画像でコントラストを最大化する。 白い紙に濃いインクが理想的です。入力を管理できる場合 — 現場スタッフがフォームに記入する、技術者が検査メモを書く — 濃いボールペンを指定してください。薄い鉛筆、色付きの紙に赤インク、色あせた感熱レシート紙は、すべてAIモデルが依存するコントラスト比を低下させます。スキャナーの明るさ設定50%は、細かいストロークを白飛びさせることなく、最も広いダイナミックレンジを捉えます。
4. 影をなくすには、拡散照明を使いましょう。窓からの自然光(直射日光ではなく間接光)が最も均一な照明になります。人工光を使う場合は、ドキュメントの両側45度の角度に2つの光源を配置します。直接フラッシュはテキストを白飛びさせるホットスポットを作り、スマホを持つ手がページ半分に影を落とします。どちらも照明の配置について2秒考えれば避けられます。
5. 折り目のあるドキュメントは、撮影前に平らにしましょう。折り目やシワは文字の形を崩す幾何学的な歪みを生みます。ドキュメントが折りたたまれていた場合は、撮影前に数時間、厚い本の下に置いてください。永久的な折り目があるドキュメントの場合は、RGBモード(グレースケールや白黒ではなく)でスキャンすると、AIが折り目の影と印刷されたテキストを区別するのに役立つ微妙な階調情報が保持されます。
6. ファックス送信されたドキュメントは、抽出前にノイズ除去を行いましょう。ファックス機は圧縮アルゴリズム(MH、MR、MMR)を使用して、ピクセルパターンを近似することでファイルサイズを削減します。これにより、テキスト周辺に特徴的な「ブロック状の」アーティファクトが生じます。AI抽出の前に、ファックス文書をメディアンフィルターや適応的しきい値処理にかけると、テキストをさらに劣化させることなく伝送ノイズを除去できます。改善は劇的ではありません(通常5〜10%の精度向上)が、50ページのファックスでは、手動で修正するエラーが20〜30件減ることになります。
AIが不完全な品質を処理する実際のドキュメント
管理されたベンチマーク精度と実世界のパフォーマンスの差は、低品質のドキュメントで最も大きくなります。そのため、ベンチマーク数値を引用するよりも、実際のユースケースを見ることが重要です。
トラックの運転席で撮影された現場納品書。物流ドライバーが、次の停留所へ向かう前に、ダッシュボード上の署名済み納品書の写真を撮ります。その写真には、エンジンの振動によるブレ、キャビンの天井灯による不均一な照明、わずかな角度があります。これは現実的な最悪のケースの入力ですが、AIは予想以上にうまく処理します。フォームの構造化された性質(納品番号、受取人名、日付、署名欄)が意味的なアンカーを提供します。カスタム列抽出を使用すると、AIは印刷されたフィールド(納品番号と日付)をほぼ通常の精度で抽出します。これらは通常、一貫した位置に明確な書式で配置されているためです。手書きの受取人名と署名はより困難で、AIはこれらを正確な文字起こしではなく存在の指標として捉えます。実用的なワークフローは、AIに構造化フィールドを自動抽出させ、手書き部分をスポットチェックすることです。
2020年以前の取引先からのファックス請求書。建設、製造、卸売業の多くの取引先は、今でもファックスで請求書を送ってきます。特に、デジタル化していない小規模サプライヤーに多く見られます。ファックス請求書は、低解像度(100〜200 DPI)、圧縮アーティファクト、場合によっては伝送回線ノイズを組み合わせたものです。Sparkco 2025ベンチマークに記載されたテストでは、AIによるOCRで処理されたファックス文書は、印刷テキストで約85〜90%のフィールドレベル精度を達成しました。従来のOCRの60〜70%と比較されます。残りのエラーは、小さなフォントの明細項目とかすれた印刷に集中しています。毎週多数のファックス請求書を処理する買掛金チームにとって、AI抽出は手動入力を完全な再入力ではなくエラー修正に減らし、不完全な出力でも3〜5倍の時間節約になります。
1990年代の黄ばんだアーカイブ文書。法律事務所、保険会社、政府機関は数十年分の紙のアーカイブを保管しています。これらをデジタル化のためにスキャンすると、元の紙は黄ばみ、インクは薄れ、ホッチキスの穴や余白のメモがノイズとして加わります。AIは黄ばみをうまく処理します。前処理中のコントラスト正規化により、人間の目にはほぼ見えない文字を復元できます。本当の課題は薄れたインクです。元の文書がドットマトリックス印刷や薄いカーボンコピーだった場合、どのツールでも確実に復元できるほどのコントラストがありません。このような場合、AIは抽出できるものを抽出し、信頼度の低いフィールドを人間のレビュー用にフラグ付けします。これは、すべてのフィールドを手動でレビューするよりもはるかに効率的なトリアージワークフローです。
レストランの照明下で撮影したスマートフォンのレシート写真。フリーランサーがビジネスディナーで、暖かく薄暗いレストランの照明の下でレシートの写真を撮ります。スマートフォンのカメラは高ISOで補正するためノイズが発生します。紙は光沢があり、合計金額の一部にグレアのスポットが生じます。レシートは財布に入っていたため、わずかに湾曲しています。これら3つの問題があるにもかかわらず、AIは日付、合計金額、ベンダー名などの主要フィールドをほとんどの場合正しく抽出します。これは、レシートが強く予測可能な構造を持つためです。合計金額はほとんどの場合、下部付近にある最大の数字であり、日付は認識可能な形式に従い、ベンダー名は上部にあります。AIは、個々の文字が読みにくい場合でも、これらのレイアウト規則を暗黙のアンカーとして使用します。2025年にスマートフォンのレシート写真100枚で実施されたテストでは、AI抽出は合計金額と日付で約92%のフィールドレベルの精度を達成し、最も小さくグレアの影響を受けやすい明細項目の説明では約80%に低下しました。
よくある質問
AIは100 DPIでスキャンした文書を読めますか?
確実には読めません。100 DPIでは、標準的な10ptの文字は約14ピクセルを占めるため、どのAIモデルでも「8」と「3」や「5」と「6」のような類似した文字を区別するには不十分です。超解像度の前処理を備えた一部のAIツールは部分的なテキストを復元できますが、精度は75%未満で、数字や小さなフォントではエラー率が高くなることが予想されます。300 DPIで再スキャンすることが、ほとんどの場合、はるかに良い解決策です。
AIは従来のOCRより動きのぼやけに強いですか?
はるかに強いです。ただし、「強い」は「解決する」という意味ではありません。AIは単語レベルの形状と文書の文脈を読み取るため、少しぼやけた「請求書番号」ラベルでも理解できます。従来のOCRは個々の文字を分割して認識するため、文字の境界がぼやけると崩れてしまいます。差が最も大きいのは中程度のぼやけで(AIは5〜12%の低下、従来は20〜35%の低下)、深刻なぼやけではどちらの手法も信頼性が低くなり、差は縮まります。移動中に撮影したような深刻な動きのぼやけの場合、画像を撮り直すことが唯一の実用的な解決策です。
AIはファックス文書からデータを抽出できますか?
はい、ただし条件付きです。AIはファックスされた印刷テキストで約85〜90%のフィールド精度を達成します。従来のOCRは60〜70%です。残りのエラーは、小さなフォントの明細項目、かすかな印刷、伝送ノイズが多い文書に集中します。ファックス文書を抽出前にノイズ除去の前処理(メディアンフィルタや適応しきい値処理)にかけると、結果が5〜10%向上します。エラーによるコストが大きい高価値文書では、抽出フィールドの人的検証を計画してください。
AI抽出を利用可能にするための最小画像品質は?
実用的な目安は次のとおりです。200 DPI相当の解像度、正面からの角度(5度未満の傾き)、そして人間が目を細めずに読める十分なコントラストです。この3つのしきい値を同時に下回ると、精度は80%未満に低下します。これは、手動修正の時間が手動入力の時間に近づくポイントです。文書が3つの条件のうち2つを満たす場合は、AI抽出を試す価値があります。どれも満たさない場合は、まず入力を改善してください。
AIは水濡れや汚れのある文書を処理できますか?
部分的に、そして予測不能に処理できます。水濡れは不均一です。ある部分は無傷でも、別の部分はにじんでかすれてしまうことがあります。AIはきれいな部分は正常に抽出し、損傷した部分では苦労します。人間の読者と同じです。コントラスト強調で中程度に色あせた領域は回復できますが、文字が物理的に融合してしまった深刻なインクのにじみは、どのソフトウェアでも修正できません。アーカイブ文書では、AI抽出と損傷部分の手動レビューを組み合わせることを想定してください。
JPEG圧縮はAI抽出精度に影響しますか?
はい、そしてその影響は永続的です。JPEG圧縮はファイルサイズを減らすために細部を破棄し、一度破棄された詳細は前処理では復元できません。強いJPEG圧縮(品質設定50%未満)では、テキスト周辺に8×8ピクセルの「ブロックノイズ」が発生し、文字の境界が曖昧になります。AIモデルは軽い圧縮(品質70以上)にはうまく対応しますが、強く圧縮された画像では精度が5〜10%低下します。元のスキャンや写真がある場合は、再圧縮されたコピーではなくそちらを使用してください。
AI抽出において、スマホの写真はフラットベッドスキャンと同じくらい良いですか?
適切に撮影されたスマホ写真(正面から、良好な照明、ブレなし、200 DPI相当以上)であれば、精度はフラットベッドスキャンと3〜5ポイント以内の差です。条件が悪化すると差は広がります。照明が不十分でブレのあるスマホ写真は、きれいなスキャンより15〜25%精度が低くなることがあります。実際の違いは一貫性です。300 DPIのフラットベッドスキャナーは毎回ほぼ同じ品質を生み出しますが、スマホ写真は撮影技術によって大きくばらつきます。文書を定期的に処理する場合、スキャナーはエラー修正時間の短縮で元が取れます。
2026年のAIによる文書抽出は、多くの人が試したことのあるOCRツールよりも低品質の入力をはるかにうまく処理します。ただし、「はるかに優れている」ことは「完璧」と同じではありません。劣化曲線は破滅的ではなく緩やかです。200 DPIで中程度のブレなら、実用的なデータが得られます。150 DPI未満で深刻なブレや複合的な欠陥があると、ストレスがたまります。「AIはぼやけた文書を読めるのか?」という質問への正直な答えは「試してみればわかる」です。文書の種類、劣化の度合い、フィールドの重要度の組み合わせによって、出力が本番利用可能か、人間のレビューが必要かが決まるからです。最も品質の悪い文書をアップロードして、あなたの品質が曲線上のどこにあるかを確認してください。
印刷と手書きが混在する文書(低品質の現場フォームでよく見られます)を扱う場合は、AIが写真から手書きをどの程度読めるかのガイドをご覧ください。フォーマットのばらつきが品質問題を悪化させる文書については、AIがPDFからデータを抽出する方法でフォーマット非依存の抽出アプローチを説明しています。また、文書量が自動化を正当化するかどうかを評価している場合は、AIによる文書抽出とは何か、その仕組みから始めることをお勧めします。