Kann KI unscharfe Dokumente lesen?
Teilweise – Wo die Genauigkeitsgrenze liegt
Teilweise. KI kann Daten aus Scans mittlerer Qualität extrahieren – einschließlich leicht unscharfer Fotos, Dokumenten in Fax-Auflösung und Aufnahmen bei schwachem Licht – wobei die Genauigkeit allmählich statt katastrophal abnimmt. Unterhalb von etwa 150 DPI Äquivalent oder bei starker Bewegungsunschärfe, die Textkanten bis zur Unkenntlichkeit verschmiert, nimmt die Genauigkeit deutlich ab. Der entscheidende Unterschied: KI-Vision-Modelle degradieren elegant, weil sie den Dokumentkontext verstehen. Traditionelle OCR hingegen bricht abrupt ein – ihre Architektur zur Zeichensegmentierung setzt saubere Kanten voraus, und wenn diese Kanten verschwimmen, gibt es keinen Rückfall.
Wichtigste Erkenntnisse
- Bei jeder Art von Qualitätsverlust – niedrige Auflösung, Bewegungsunschärfe, Fax-Rauschen – verliert KI 2–3x weniger Genauigkeit als traditionelle OCR und bleibt bei 85–95 %, während alte Tools unter 50 % fallen.
- KI hat keine besseren Augen – sie liest den Dokumentkontext so, wie Sie eine unscharfe Quittung lesen: Sie sehen vielleicht nicht jede Ziffer, aber Sie wissen, wo die Summe steht und wie ein Dollar-Betrag aussieht.
- Eine einzige Verbesserung – die Erhöhung der Auflösung von 100 auf 200 DPI – kann die Genauigkeit von unbrauchbar auf brauchbar heben, weil sich die kombinierte Qualitätsminderung auflöst, wenn die stärkste Einschränkung beseitigt wird.
Wie gut KI mit verschiedenen Arten von Bildqualitätsproblemen umgeht
Nicht alle Bildqualitätsprobleme beeinträchtigen die KI-Extraktion gleichermaßen. Einige Arten von Verschlechterung sind überraschend gut überlebbar; andere drücken die Genauigkeit unter die Schwelle, ab der Automatisierung mehr Zeit spart, als manuelle Korrektur kostet. Die folgende Tabelle ordnet jedem Verschlechterungstyp seine reale Auswirkung auf die Genauigkeit zu, basierend auf unabhängigen OCR-Benchmarks und Praxiserfahrungen (Sparkco 2025 Benchmark; OmniDocBench, CVPR 2025).
| Verschlechterungstyp | Auswirkung auf KI-Genauigkeit | Auswirkung auf traditionelle OCR | Wiederherstellbar? |
|---|---|---|---|
| Mäßig niedrige Auflösung (150–200 DPI) | 5–10 % Abfall gegenüber Basislinie | 15–25 % Abfall | Ja — KI-Kontextverständnis gleicht aus |
| Sehr niedrige Auflösung (<150 DPI) | 15–30 % Abfall | 40–60 % Abfall, oft unbrauchbar | Teilweise — Super-Resolution-Vorverarbeitung hilft, kann aber verlorene Details nicht wiederherstellen |
| Leichte Bewegungsunschärfe (Handy in der Hand, leichtes Verwackeln) | 5–12 % Abfall | 20–35 % Abfall | Ja — KI liest Wortformen, nicht einzelne Zeichenstriche |
| Starke Bewegungsunschärfe (fahrendes Fahrzeug, schneller Schwenk) | 25–40 % Abfall | 60–80 % Abfall | Begrenzt — Entschärfungs-KI kann einiges wiederherstellen, Neuaufnahme ist am besten |
| Geringer Kontrast (verblasste Tinte, heller Bleistift, vergilbtes Papier) | 3–8 % Abfall | 10–20 % Abfall | Ja — Kontrastverstärkungs-Vorverarbeitung ist sehr effektiv |
| Faxqualität (100–200 DPI + Kompressionsartefakte) | 10–20 % Abfall | 30–50 % Abfall | Teilweise — Fax-spezifisches Entrauschen hilft; einige Daten gehen dauerhaft verloren |
| JPEG-Kompressionsartefakte | 5–10 % Abfall | 15–25 % Abfall | Teilweise — Blockartefakte können geglättet werden, aber verlorene Details sind weg |
| Ungleichmäßige Beleuchtung / Schatten | 5–10 % Abfall | 15–25 % Abfall | Ja — adaptive Binarisierung kommt gut mit Schatten zurecht |
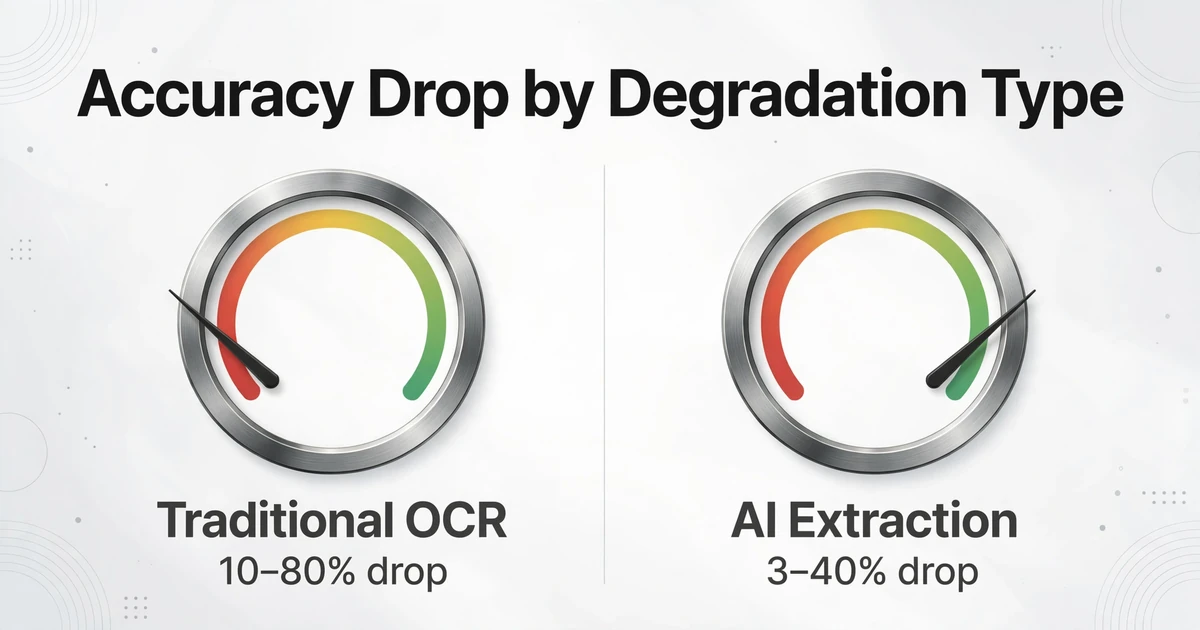
Zwei Muster fallen auf. Erstens: KI verschlechtert sich in jeder Kategorie 2–3x weniger als traditionelle OCR — die Kluft beim Kontextverständnis wird größer, je schlechter die Bildqualität wird. Traditionelle OCR verlässt sich auf saubere Zeichenkanten, um einzelne Buchstaben zu segmentieren und zu klassifizieren; wenn Kanten verschwimmen, schlägt der Segmentierungsschritt fehl und Fehler pflanzen sich fort. KI-Visionsmodelle betrachten ganze Wörter, Feldbeschriftungen und Dokumentstruktur — so wird ein verschwommenes „T" in „Total" trotzdem korrekt gelesen, weil das Modell weiß, dass dieses Feld einen Dollar-Betrag enthalten sollte, keine zufällige Zeichenfolge.
Zweitens: Mehrere mittlere Mängel wirken sich schlimmer aus als ein einzelner schwerwiegender Fehler. Ein Dokument mit geringem Kontrast (3–8 % Abfall) plus leichter Schräglage (2–10 % Abfall) plus JPEG-Artefakten (5–10 % Abfall) kann 15–25 % Genauigkeit verlieren, obwohl kein einzelner Faktor schwerwiegend ist. Das ist wichtig, weil reale Dokumente selten nur ein Problem haben – eine gefaxte Rechnung ist gleichzeitig niedrig aufgelöst, verrauscht und mit Kompressionsartefakten behaftet. Der wichtigste Vorverarbeitungsschritt ist zu erkennen, welche Beeinträchtigung der Haupttreiber ist, und diese zuerst zu beheben.
Was KI bei minderwertigen Dokumenten richtig macht
Der Vorteil von KI bei beschädigten Dokumenten liegt nicht darin, dass sie besser „sehen" kann – sondern darin, dass sie mehr Kontext hat. Traditionelle OCR liest ein Dokument wie ein Kind, das Buchstaben einzeln vor sich hin buchstabiert. KI liest es so, wie Sie ein unscharfes Foto einer Quittung lesen: Sie sehen vielleicht nicht jede Ziffer klar, aber Sie wissen, wie eine Quittung aussieht, wo die Summe normalerweise steht und wie ein Dollar-Betrag aussehen sollte.
Strukturierte Formulare mit beschrifteten Feldern sind der stärkste Fall für KI bei minderwertigen Eingaben. Wenn ein Dokument Feldbeschriftungen hat – „Rechnungsnummer", „Datum", „Gesamtbetrag" – nutzt die KI die Beschriftung auch bei teilweise unscharfem Text als semantischen Anker. Sie weiß, welche Art von Wert in diesem Bereich zu erwarten ist. Dies ist der Mechanismus hinter Benutzerdefinierte Spaltenextraktion: Sie definieren die gewünschten Spaltennamen (z. B. „Lieferant", „Betrag", „Bestellnummer"), und die KI lokalisiert jeden Wert, indem sie versteht, was er bedeutet, nicht indem sie Pixelabstände misst. Ein unscharfer „$1.247,50" neben einer Beschriftung mit „Gesamt" wird weitaus häufiger korrekt extrahiert als ein unscharfer „$1.247,50" in einer unbeschrifteten Ecke.
Mäßig niedrig aufgelöste Dokumente (150–200 DPI) liegen im Wohlfühlbereich der KI. In diesem Bereich – typisch für Smartphone-Fotos aus angemessener Entfernung oder ältere Flachbettscans in „Entwurfs"-Qualität – können einzelne Zeichen weich erscheinen, aber Wortformen bleiben unterscheidbar. Der Sparkco-2025-Benchmark ergab, dass KI-basierte OCR-Systeme bei 200 DPI über 90 % Zeichengenauigkeit halten, während traditionelle Engines auf etwa 80 % oder weniger abfallen. Der Unterschied ist bei kleinem Text am deutlichsten sichtbar: Eine 10-Punkt-Schrift bei 200 DPI ist etwa 28 Pixel hoch – genug für KI, um sie aufzulösen, aber grenzwertig für segmentierungsbasierte OCR.
Faxqualitäts-Dokumente mit Textinhalt profitieren von einer unerwarteten KI-Stärke: Layout-Erhaltung. Fax-Kompressionsalgorithmen (MH, MR, MMR) verzerren feine Zeichenstriche, bewahren aber die räumliche Beziehung zwischen Textblöcken. Da KI durch das Verständnis der Dokumentstruktur liest – Kopfzeilen, Fließtext, Tabellen – statt Zeichen für Zeichen, kann sie oft gefaxten Text wiederherstellen, den eine traditionelle OCR-Engine in Kauderwelsch zerlegen würde. Faxspezifische Entrauschungs-Vorverarbeitung (LlamaIndex, 2026) verbessert die Ergebnisse zusätzlich, indem Übertragungsrauschen entfernt wird, bevor die KI das Dokument verarbeitet.
Schwach beleuchtete Handyfotos mit gleichmäßiger Ausleuchtung (ohne harte Schatten) werden überraschend gut verarbeitet. Moderne KI-Modelle wurden mit vielfältigen realen Bildern trainiert und sind robust gegenüber den Rauschmustern und Farbstichen, die für Innenaufnahmen typisch sind. Der Haken: Schatten – insbesondere harte Schatten von einer Hand, die das Telefon über das Dokument hält – erzeugen künstliche Kontrastkanten, die die Layout-Erkennung verwirren. Verteilen Sie das Licht (gehen Sie in die Nähe eines Fensters, vermeiden Sie direktes Blitzlicht), und die Genauigkeit bleibt innerhalb von 5–8 % eines sauberen Scans.
Wo KI noch scheitert
Die ehrliche Liste der Fehlermodi ist wichtiger als die Erfolgsfälle – denn ein Dokument hochzuladen und fehlerhafte Ausgaben zu erhalten, führt dazu, dass man einem Tool dauerhaft das Vertrauen entzieht.
Auflösung unter 100 DPI ist die harte Grenze. Unterhalb von etwa 100 DPI – üblich bei Dokumenten, die aus zu großer Entfernung fotografiert, stark herunterskalierte PDFs oder Miniaturbilder sind – belegen einzelne Zeichen zu wenige Pixel, als dass ein Modell sie auflösen könnte. Ein 10-Punkt-Zeichen bei 100 DPI ist nur etwa 14 Pixel hoch, und die feinen Striche, die „8" von „3" oder „5" von „6" unterscheiden, sind 2–3 Pixel breit. KI-Superauflösung kann fehlende Details interpolieren, aber Interpolation erfindet Informationen – sie rät, wie die fehlenden Pixel aussehen sollten, und diese Vermutungen sind manchmal falsch. Wie der LlamaIndex-Leitfaden zur OCR bei niedriger Auflösung anmerkt: „Hochskalieren kann Details, die nie erfasst wurden, nicht wiederherstellen." Bei dieser Auflösungsstufe ist erneutes Scannen oder Fotografieren der einzige zuverlässige Weg.
Starke Bewegungsunschärfe – die Art, die beim Fotografieren eines Dokuments beim Gehen oder aus einem fahrenden Fahrzeug entsteht – ist die schädlichste Art der Beeinträchtigung. Bewegungsunschärfe verschmiert Text in eine konsistente Richtung und verschmilzt Zeichen zu durchgehenden Streifen. Anders als bei niedriger Auflösung, wo Zeichen ihre Form bei reduzierter Wiedergabetreue behalten, zerstört Bewegungsunschärfe die Zeichengrenzen vollständig. Unabhängige Benchmarks zeigen durchweg, dass Bewegungsunschärfe der schädlichste Qualitätsfaktor ist, mit Genauigkeitsverlusten von 10–20 % selbst in moderaten Fällen (Sparkco-OCR-Benchmark 2025; LlamaIndex-Analyse zur OCR bei niedriger Auflösung). KI-Entschärfungsmodelle haben sich verbessert, stoßen jedoch an eine grundlegende informationstheoretische Grenze: Pixel, die über mehrere Zeichenpositionen verschmiert wurden, können nicht mit Sicherheit entschmiert werden.
Wassergeschädigte und physisch beschädigte Dokumente – Tintenverlauf, Wasserflecken, Schimmelflecken, verblasstes Thermopapier – stellen ein zusammengesetztes Problem dar. Die Beschädigung ist ungleichmäßig: Eine Ecke der Seite kann perfekt lesbar sein, während eine andere ein ausgewaschener Fleck ist. KI-Modelle haben mit dieser räumlichen Inkonsistenz zu kämpfen, weil ihr Layoutverständnis ein kohärentes Dokument erwartet. Eine Studie von 2025 zur OCR beschädigter Dokumente (IJSAT, 2026) ergab, dass zerknitterte Dokumente die OCR-Genauigkeit bei allen getesteten Engines um 30–45 % reduzierten und nasse/verschmierte Dokumente um 25–40 %, wobei KI-Modelle die traditionelle OCR übertrafen, aber immer noch deutlich unter den Produktionsschwellen lagen. Für die archivqualitative Digitalisierung beschädigter Dokumente bleiben spezialisierte Tools mit Mensch-in-der-Schleife-Verifizierung notwendig.
Gefaltete, geknickte und zerrissene Dokumente erzeugen geometrische Verzerrungen, die die Zeichenformen brechen. Ein Knick über einer Textzeile erzeugt einen sichtbaren Grat, an dem die Zeichen vertikal gestaucht werden; die KI kann den gestauchten Abschnitt als ein anderes Zeichen lesen oder ganz übersehen. Das Glätten des Dokuments unter Gewicht vor dem Fotografieren hilft erheblich, aber tiefe Falten, die das Papier dauerhaft verformt haben, verursachen weiterhin Fehler. Der OCR-Leitfaden der University of Pittsburgh Library empfiehlt, geknickte Dokumente im RGB-Modus statt im Graustufenmodus zu scannen, um die subtilen Schattierungsinformationen zu erhalten, die helfen, Knickschatten von Tinte zu unterscheiden.
Kombinierte Beeinträchtigung – der reale Fall, in dem ein Dokument gleichzeitig niedrig aufgelöst, schief, verrauscht und schlecht beleuchtet ist – schlägt selbst die besten Vorverarbeitungspipelines. Jeder Verbesserungsschritt (Entzerren, Entrauschen, Schärfen, Kontrastnormalisierung) führt eigene Artefakte ein, und diese Artefakte verstärken sich gegenseitig. Ein Reddit-Nutzer auf r/MachineLearning dokumentierte dies präzise: Tesseract erreichte 80–90 % bei guten Bildern, 60 % bei mittleren und 0 % bei Bildern schlechter Qualität, bei denen mehrere Defekte gleichzeitig auftraten. Der Verstärkungseffekt bedeutet, dass die Verbesserung selbst nur eines Faktors – etwa die Erhöhung der Auflösung von 100 auf 200 DPI, während Schiefe und Rauschen unverändert bleiben – die Genauigkeit von „unbrauchbar" auf „prüfbar" anheben kann, weil die stärkste Einschränkung beseitigt wird.
So erzielen Sie die besten Ergebnisse mit unvollkommenen Dokumenten
Die wirksamste Einzelmaßnahme ist die Verbesserung der Eingabe, bevor sie die KI erreicht. Vorverarbeitung kann 10–20 % der verlorenen Genauigkeit bei mäßig beeinträchtigten Dokumenten wiederherstellen – oft genug, um ein Grenzbild in den brauchbaren Bereich zu bringen.
1. Mit mindestens 300 DPI scannen oder fotografieren. Dies ist die am häufigsten wiederholte Empfehlung in jedem OCR-Benchmark und Bibliotheksleitfaden – und das aus gutem Grund. Bei 300 DPI umfasst ein 10-Punkt-Zeichen etwa 42 Pixel, was der KI genügend Auflösung bietet, um feine Striche zu unterscheiden. Der OCR-Leitfaden der University of Illinois Library und die University of Pittsburgh kommen unabhängig voneinander auf 300 DPI als Schwelle, an der die Genauigkeitsgewinne ein Plateau erreichen. Über 300 DPI hinaus bringt bei Standardtext nur noch abnehmende Erträge; unter 200 DPI sinkt die Genauigkeit bei jeder getesteten Engine messbar.
2. Die Kamera parallel zum Dokument halten. Perspektivische Verzerrung zwingt die KI, das Bild vor dem Lesen zu entzerren – ein zusätzlicher Vorverarbeitungsschritt, bei dem sich Fehler verstärken. Eine Schiefe von nur 5 Grad kann einen Genauigkeitsverlust von 2–10 % verursachen. Die meisten Smartphone-Kamera-Apps haben einen Dokumentenscanmodus, der die Perspektive automatisch korrigiert; nutzen Sie ihn. Bei Flachbettscannern richten Sie die Dokumentkante am Lineal des Scannerbetts aus.
3. Den Kontrast an der Quelle maximieren. Dunkle Tinte auf weißem Papier ist ideal. Wenn Sie die Eingabe kontrollieren – Außendienstmitarbeiter, die Formulare ausfüllen, Techniker, die Inspektionsnotizen schreiben – schreiben Sie dunkle Kugelschreiber vor. Heller Bleistift, rote Tinte auf farbigem Papier und verblasstes Thermopapier von Quittungen reduzieren alle das Kontrastverhältnis, auf das KI-Modelle angewiesen sind. Eine Helligkeitseinstellung von 50 % bei Scannern erfasst den breitesten Dynamikbereich, ohne feine Striche auszuwaschen.
4. Schatten durch diffuse Beleuchtung eliminieren. Natürliches Tageslicht von einem Fenster – indirekt, nicht direkte Sonne – erzeugt die gleichmäßigste Ausleuchtung. Bei künstlichem Licht zwei Lichtquellen in 45-Grad-Winkeln auf beiden Seiten des Dokuments positionieren. Direkter Blitz erzeugt helle Flecken, die den Text auswaschen; eine Hand, die das Telefon hält, wirft einen harten Schatten über die halbe Seite. Beides lässt sich mit zwei Sekunden Nachdenken über die Lichtplatzierung vermeiden.
5. Gefaltete Dokumente vor dem Fotografieren glätten. Knicke und Falten erzeugen geometrische Verzerrungen, die Zeichenformen brechen. Wenn ein Dokument gefaltet wurde, legen Sie es vor dem Fotografieren für einige Stunden unter ein schweres Buch. Bei Dokumenten mit dauerhaften Falten bewahrt das Scannen im RGB-Modus (nicht Graustufen oder Schwarzweiß) die subtilen Toninformationen, die der KI helfen, Faltenschatten von gedrucktem Text zu unterscheiden.
6. Bei gefaxten Dokumenten vor der Extraktion entrauschen. Faxgeräte verwenden Komprimierungsalgorithmen (MH, MR, MMR), die die Dateigröße reduzieren, indem sie Pixelmuster annähern – wodurch die charakteristischen „blockigen" Artefakte um den Text entstehen. Wenn Sie ein Fax vor der KI-Extraktion durch einen Medianfilter oder eine adaptive Schwellenwertstufe laufen lassen, wird Übertragungsrauschen entfernt, ohne den Text weiter zu verschlechtern. Die Verbesserung ist nicht dramatisch – ein typischer Genauigkeitsgewinn von 5–10 % – aber bei einem 50-seitigen Fax bedeutet das 20–30 weniger Fehler, die manuell korrigiert werden müssen.
Reale Dokumente, bei denen KI mit unvollkommener Qualität umgeht
Die Kluft zwischen kontrollierter Benchmark-Genauigkeit und realer Leistung ist bei Dokumenten mit geringer Qualität am größten – genau deshalb ist es wichtiger, sich reale Anwendungsfälle anzusehen, als Benchmark-Zahlen zu zitieren.
Feldliefernotizen, die in einer Lkw-Kabine fotografiert wurden. Ein Logistikfahrer knipst ein Foto einer unterschriebenen Liefernotiz auf dem Armaturenbrett, bevor er zur nächsten Station fährt. Das Foto hat Bewegungsunschärfe durch einen vibrierenden Motor, ungleichmäßige Beleuchtung durch die Innenraumleuchte der Kabine und einen leichten Winkel. Das ist ein realistischer Worst-Case-Input – und KI kommt damit besser zurecht, als man erwarten würde. Die strukturierte Natur des Formulars (Liefernummer, Empfängername, Datum, Unterschriftenblock) bietet semantische Anker. Mit Benutzerdefinierte Spaltenextraktion extrahiert die KI die gedruckten Felder – Liefernummer und Datum – mit nahezu normaler Genauigkeit, da diese typischerweise an konsistenten Positionen mit klarer Formatierung stehen. Handschriftliche Empfängernamen und Unterschriften sind schwieriger: Die KI erfasst sie als Präsenzindikatoren und nicht als genaue Transkriptionen. Der praktische Workflow: Lassen Sie die KI die strukturierten Felder automatisch extrahieren und prüfen Sie die handschriftlichen Teile stichprobenartig.
Gefaxte Rechnungen von Lieferanten vor 2020. Viele Lieferanten im Bau-, Fertigungs- und Großhandelsbereich senden Rechnungen weiterhin per Fax – insbesondere kleinere Zulieferer, die nicht digitalisiert haben. Eine gefaxte Rechnung kombiniert niedrige Auflösung (100–200 DPI), Komprimierungsartefakte und manchmal Übertragungsleitungsrauschen. In einem im Sparkco-2025-Benchmark dokumentierten Test erreichten gefaxte Dokumente, die mit KI-gestützter OCR verarbeitet wurden, etwa 85–90 % Feldgenauigkeit bei gedrucktem Text – verglichen mit 60–70 % bei traditioneller OCR. Die verbleibenden Fehler konzentrieren sich auf Positionen mit kleiner Schrift und blassem Druck. Für Kreditorenbuchhaltungsteams, die wöchentlich Dutzende gefaxter Rechnungen verarbeiten, reduziert die KI-Extraktion die manuelle Eingabe auf Fehlerkorrektur statt vollständiges Neuabtippen – eine 3–5-fache Zeitersparnis selbst bei unvollkommener Ausgabe.
Vergilbte Archivdokumente aus den 1990er-Jahren. Anwaltskanzleien, Versicherungsunternehmen und Behörden unterhalten jahrzehntealte Papierarchive. Wenn diese für die Digitalisierung gescannt werden, ist das ursprüngliche Papier vergilbt, die Tinte verblasst, und Heftlöcher sowie Randnotizen erzeugen Störungen. KI kommt mit der Vergilbung gut zurecht – eine Kontrastnormalisierung während der Vorverarbeitung kann Text wiederherstellen, der für das menschliche Auge nahezu unsichtbar erscheint. Die eigentliche Herausforderung ist die verblasste Tinte: Bei Dokumenten, bei denen das Original ein Nadeldruck oder ein blasser Durchschlag war, fehlt schlicht der Kontrast, den jedes Werkzeug zuverlässig wiederherstellen könnte. In diesen Fällen extrahiert die KI, was möglich ist, und markiert Felder mit geringer Konfidenz zur manuellen Prüfung – ein Triage-Workflow, der weitaus effizienter ist als die manuelle Prüfung jedes einzelnen Felds.
Smartphone-Fotos von Belegen bei Restaurantbeleuchtung. Ein Freiberufler fotografiert bei einem Geschäftsessen den Beleg unter warmem, gedimmtem Restaurantlicht. Die Handykamera kompensiert mit hohem ISO-Wert, was Rauschen erzeugt; das Papier ist glänzend, wodurch ein Blendeffekt einen Teil der Summe überdeckt; der Beleg ist durch die Geldbörse leicht gebogen. Trotz aller drei Probleme extrahiert die KI die Kernfelder – Datum, Gesamtsumme, Händlername – in den meisten Fällen korrekt, weil Belege eine stark vorhersehbare Struktur haben. Die Gesamtsumme ist fast immer die größte Zahl in der Nähe des unteren Endes, das Datum folgt einem erkennbaren Format, und der Händlername steht oben. Die KI nutzt diese Layout-Konventionen als implizite Anker, selbst wenn einzelne Zeichen schwer lesbar sind. Ein Test aus dem Jahr 2025 mit 100 Smartphone-Belegfotos ergab, dass die KI-Extraktion eine Feldgenauigkeit von ~92 % bei Summen und Daten erreichte, die bei Positionsbeschreibungen auf ~80 % fiel, wo der Text am kleinsten und am stärksten von Blendeffekten betroffen ist.
Häufig gestellte Fragen
Kann KI Dokumente lesen, die mit 100 DPI gescannt wurden?
Zuverlässig nein. Bei 100 DPI belegt ein standardmäßiges 10-Punkt-Zeichen etwa 14 Pixel – nicht genug für ein KI-Modell, um zwischen ähnlichen Zeichen wie „8“ und „3“ oder „5“ und „6“ zu unterscheiden. Einige KI-Tools mit Super-Resolution-Vorverarbeitung können Teile des Texts wiederherstellen, aber rechnen Sie mit einer Genauigkeit unter 75 % und hohen Fehlerraten bei Zahlen und kleinen Schriftarten. Ein erneuter Scan mit 300 DPI ist fast immer die bessere Lösung.
Bewältigt KI Bewegungsunschärfe besser als herkömmliche OCR?
Deutlich besser – aber „besser" bedeutet nicht „löst das Problem". KI liest Wortformen und Dokumentkontext, sodass ein leicht unscharfes Etikett „Rechnungsnummer" trotzdem verstanden wird. Herkömmliche OCR segmentiert einzelne Zeichen und bricht zusammen, wenn die Zeichengrenzen verschwimmen. Der Unterschied ist bei mittlerer Unschärfe am größten (KI verliert 5–12 %, herkömmliche OCR 20–35 %) und verringert sich bei starker Unschärfe, wo kein Ansatz zuverlässig funktioniert. Bei starker Bewegungsunschärfe – etwa beim Fotografieren während der Bewegung – ist das erneute Aufnehmen des Bildes die einzige praktikable Lösung.
Kann KI Daten aus Faxdokumenten extrahieren?
Ja, mit Einschränkungen. KI erreicht etwa 85–90 % Feldgenauigkeit bei gefaxtem gedrucktem Text, verglichen mit 60–70 % bei herkömmlicher OCR. Die verbleibenden Fehler konzentrieren sich auf Zeilenpositionen mit kleiner Schrift, blassem Druck und Dokumenten mit starkem Übertragungsrauschen. Wenn Faxdokumente vor der Extraktion einen Entrauschungs-Vorverarbeitungsschritt (Medianfilter oder adaptive Schwellenwertbildung) durchlaufen, verbessert sich das Ergebnis um 5–10 %. Bei Dokumenten mit hohem Wert, bei denen Fehler kostspielig sind, planen Sie eine menschliche Überprüfung der extrahierten Felder ein.
Welche Mindestbildqualität ist für eine brauchbare KI-Extraktion erforderlich?
Als praktischer Schwellenwert: 200 DPI äquivalente Auflösung, gerade Aufnahme (weniger als 5 Grad Schräglage) und ausreichender Kontrast, sodass eine Person den Text ohne Schielen lesen kann. Wenn diese drei Schwellenwerte gleichzeitig unterschritten werden, fällt die Genauigkeit unter 80 % – der Punkt, an dem die manuelle Korrekturzeit die manuelle Eingabezeit erreicht. Wenn Ihr Dokument zwei der drei Kriterien erfüllt, lohnt sich ein Versuch der KI-Extraktion. Wenn es keines erfüllt, verbessern Sie zuerst die Eingabe.
Kann KI wassergeschädigte oder fleckige Dokumente verarbeiten?
Teilweise und unvorhersehbar. Wasserschäden sind ungleichmäßig: Ein Abschnitt kann makellos sein, während ein anderer ein ausgewaschener Fleck ist. KI extrahiert die sauberen Abschnitte normal und hat bei den beschädigten Schwierigkeiten – genau wie ein menschlicher Leser. Kontrastverstärkung kann mäßig verblasste Bereiche wiederherstellen, aber starke Tintenverläufe, bei denen Zeichen physisch verschmolzen sind, kann keine Software rückgängig machen. Bei Archivdokumenten sollten Sie KI-Extraktion mit manueller Überprüfung der beschädigten Abschnitte kombinieren.
Beeinflusst JPEG-Komprimierung die Genauigkeit der KI-Extraktion?
Ja – und der Schaden ist dauerhaft. JPEG-Komprimierung verwirft feine Details, um die Dateigröße zu reduzieren, und einmal verworfen, können diese Details durch keinen Vorverarbeitungsschritt wiederhergestellt werden. Starke JPEG-Komprimierung (Qualitätseinstellung unter 50 %) erzeugt „Blockartefakte“ – 8×8-Pixel-Blöcke, die um Text sichtbar sind – und die Zeichengrenzen verwirren. KI-Modelle kommen mit leichter Komprimierung gut zurecht (Qualität 70+), aber bei stark komprimierten Bildern sinkt die Genauigkeit um 5–10 %. Wenn Sie den ursprünglichen Scan oder das ursprüngliche Foto haben, verwenden Sie das anstelle einer erneut komprimierten Kopie.
Sind Handyfotos für die KI-Extraktion so gut wie Flachbettscans?
Bei einem gut aufgenommenen Handyfoto – geradeaus, gutes Licht, keine Bewegungsunschärfe, 200+ DPI-Äquivalent – liegt die Genauigkeit innerhalb von 3–5 Prozentpunkten eines Flachbettscans. Die Lücke vergrößert sich, wenn die Bedingungen schlechter werden: Ein schlecht beleuchtetes Handyfoto mit Bewegungsunschärfe kann 15–25 % weniger genau sein als ein sauberer Scan. Der praktische Unterschied liegt in der Konsistenz: Ein Flachbettscanner bei 300 DPI erzeugt jedes Mal nahezu identische Qualität, während Handyfotos je nach Technik stark variieren. Wenn Sie regelmäßig Dokumente verarbeiten, zahlt sich ein Scanner durch reduzierte Korrekturzeit aus.
Die KI-Dokumentextraktion im Jahr 2026 kommt mit Eingaben geringer Qualität weit besser zurecht als die OCR-Tools, die die meisten Menschen ausprobiert haben – aber „weit besser“ ist nicht dasselbe wie „perfekt“. Die Verschlechterungskurve ist allmählich statt katastrophal: Bei 200 DPI mit mäßiger Unschärfe erhalten Sie brauchbare Daten. Unter 150 DPI mit starker Unschärfe oder mehreren Defekten erhalten Sie Frustration. Die ehrliche Antwort auf „Kann KI meine unscharfen Dokumente lesen?“ lautet „Probieren Sie es aus und sehen Sie“ – denn Ihre spezifische Kombination aus Dokumenttyp, Verschlechterung und Feldwichtigkeit bestimmt, ob die Ausgabe produktionsreif ist oder eine menschliche Überprüfung benötigt. Laden Sie Ihr schlechtestes Dokument hoch und finden Sie heraus, wo Ihre Qualität auf der Kurve liegt.
Wenn Sie mit Dokumenten arbeiten, die gedruckte und handschriftliche Inhalte mischen – häufig bei Formularen mit geringer Qualität –, lesen Sie unseren Leitfaden zu wie gut KI Handschrift aus Fotos liest. Für Dokumente, bei denen Formatvariabilität Qualitätsprobleme verstärkt, behandelt wie KI Daten aus PDFs extrahiert den formatunabhängigen Extraktionsansatz. Und wenn Sie bewerten möchten, ob Ihr Dokumentvolumen eine Automatisierung überhaupt rechtfertigt, beginnen Sie mit was KI-Dokumentextraktion ist und wie sie funktioniert.