¿Puede la IA leer documentos borrosos?
Parcialmente: dónde está el límite de precisión
Parcialmente. La IA puede extraer datos de escaneos de calidad moderadamente baja —incluidos fotos ligeramente borrosas, documentos de resolución de fax e imágenes con poca luz— con una precisión que disminuye gradualmente en lugar de catastróficamente. Por debajo de aproximadamente 150 DPI equivalentes o cuando el desenfoque por movimiento severo difumina los bordes del texto más allá del reconocimiento, la precisión se degrada significativamente. La distinción clave: los modelos de visión de IA se degradan con elegancia porque comprenden el contexto del documento. El OCR tradicional, en cambio, colapsa bruscamente: su arquitectura de segmentación de caracteres asume bordes nítidos y, cuando esos bordes se desenfocan, no tiene alternativa.
Conclusiones clave
- En cada tipo de degradación —baja resolución, desenfoque por movimiento, ruido de fax— la IA pierde 2-3 veces menos precisión que el OCR tradicional y se mantiene en 85-95% donde las herramientas antiguas caen por debajo del 50%.
- La IA no tiene mejor vista: lee el contexto del documento como usted lee un recibo borroso: puede que no vea cada dígito, pero sabe dónde está el total y cómo se ve un monto en dólares.
- Una sola mejora —aumentar la resolución de 100 a 200 DPI— puede elevar la precisión de inutilizable a utilizable porque la degradación compuesta colapsa cuando se elimina la restricción más limitante.
Qué tan bien maneja la IA los diferentes tipos de degradación
No todos los problemas de calidad de imagen afectan la extracción con IA por igual. Algunos tipos de degradación son sorprendentemente tolerables; otros reducen la precisión por debajo del umbral donde la automatización ahorra más tiempo del que cuesta la corrección manual. La tabla a continuación mapea cada tipo de degradación a su impacto real en la precisión, basado en evaluaciones independientes de OCR e informes de profesionales (evaluación comparativa de Sparkco 2025; OmniDocBench, CVPR 2025).
| Tipo de degradación | Impacto en la precisión de la IA | Impacto en el OCR tradicional | ¿Recuperable? |
|---|---|---|---|
| Resolución baja moderada (150–200 DPI) | Caída del 5–10% respecto a la línea base | Caída del 15–25% | Sí: la comprensión contextual de la IA lo compensa |
| Resolución muy baja (<150 DPI) | Caída del 15–30% | Caída del 40–60%, a menudo inutilizable | Parcialmente: el preprocesamiento de superresolución ayuda, pero no puede recuperar el detalle perdido |
| Desenfoque de movimiento leve (teléfono en mano, ligera vibración) | Caída del 5–12% | Caída del 20–35% | Sí: la IA lee formas de palabras, no trazos de caracteres individuales |
| Desenfoque de movimiento severo (vehículo en movimiento, paneo rápido) | Caída del 25–40% | Caída del 60–80% | Limitado: la IA de desenfoque puede recuperar algo; lo mejor es volver a capturar |
| Bajo contraste (tinta desvanecida, lápiz claro, papel amarillento) | Caída del 3–8% | Caída del 10–20% | Sí: el preprocesamiento de mejora de contraste es muy eficaz |
| Calidad de fax (100–200 DPI + artefactos de compresión) | Caída del 10–20% | Caída del 30–50% | Parcialmente: la reducción de ruido específica para fax ayuda; algunos datos se pierden permanentemente |
| Artefactos de compresión JPEG | Caída del 5–10% | Caída del 15–25% | Parcialmente: los artefactos de bloqueo se pueden suavizar, pero el detalle perdido ya no está |
| Iluminación desigual / sombras | Caída del 5–10% | Caída del 15–25% | Sí: la binarización adaptativa maneja bien las sombras |
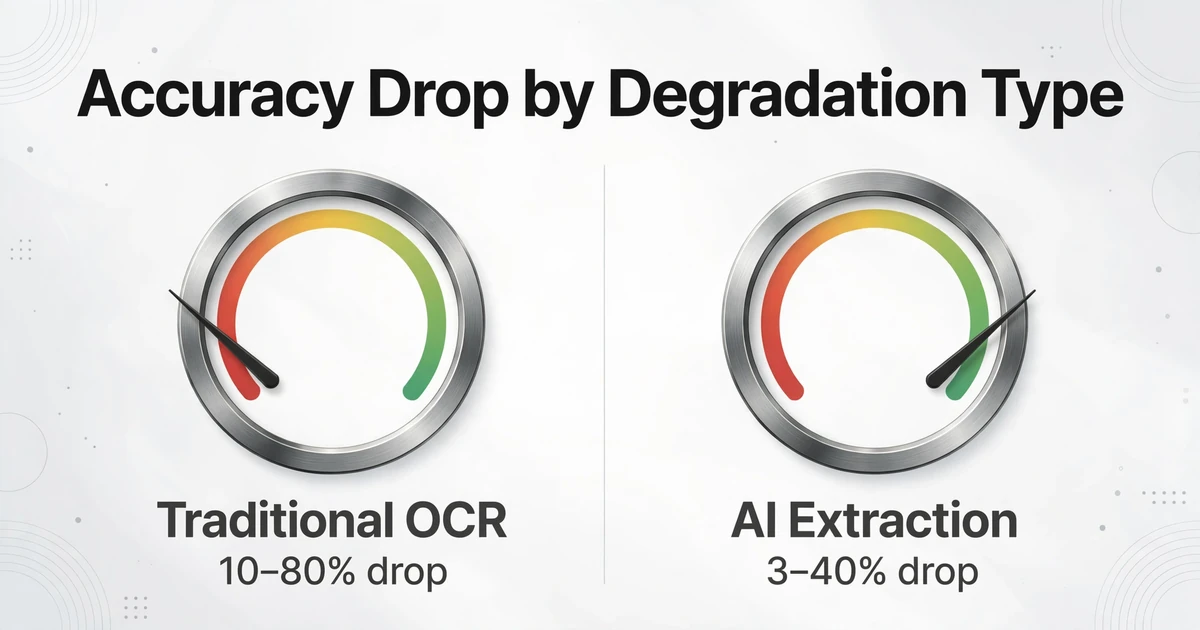
Dos patrones destacan. Primero, la IA se degrada 2–3 veces menos que el OCR tradicional en todas las categorías — la brecha de comprensión contextual se amplía a medida que baja la calidad de la imagen. El OCR tradicional depende de bordes de caracteres nítidos para segmentar y clasificar letras individuales; cuando los bordes se desenfocan, el paso de segmentación falla y los errores se acumulan. Los modelos de visión de IA observan palabras completas, etiquetas de campo y la estructura del documento — por lo que una "T" borrosa en "Total" se sigue leyendo correctamente porque el modelo sabe que este campo debe contener un monto en dólares, no una cadena aleatoria.
Segundo, varios defectos moderados combinados son peores que uno solo grave. Un documento con bajo contraste (caída del 3–8 %) más una ligera inclinación (caída del 2–10 %) más artefactos JPEG (caída del 5–10 %) puede perder un 15–25 % de precisión, aunque ningún factor individual sea grave. Esto importa porque los documentos del mundo real rara vez tienen un solo problema: una factura enviada por fax es simultáneamente de baja resolución, ruidosa y con artefactos de compresión. El paso de preprocesamiento más importante es identificar qué degradación es el factor principal y abordarla primero.
Lo que la IA hace bien en documentos de baja calidad
La ventaja de la IA en documentos degradados no es que tenga mejor "vista", sino que tiene mejor contexto. El OCR tradicional lee un documento como un niño que deletrea letras una por una. La IA lo lee como usted lee una foto borrosa de un recibo: quizá no vea cada dígito con claridad, pero sabe cómo es un recibo, dónde suele estar el total y cómo debería verse un monto en dólares.
Los formularios estructurados con campos etiquetados son el caso más sólido de la IA con entrada degradada. Cuando un documento tiene etiquetas de campo —"Número de factura", "Fecha", "Total adeudado"—, incluso si el texto está parcialmente borroso, la IA usa la etiqueta como ancla semántica. Sabe qué tipo de valor esperar en esa región. Este es el mecanismo detrás de Custom Column Extraction: usted define los nombres de columna que desea (por ejemplo, "Proveedor", "Monto", "Número de PO"), y la IA localiza cada valor al comprender su significado, no al medir distancias de píxeles. Un "$1,247.50" borroso junto a una etiqueta que dice "Total" se extrae correctamente con mucha más frecuencia que un "$1,247.50" borroso en una esquina sin etiqueta.
Los documentos de resolución moderadamente baja (150–200 DPI) están dentro de la zona de confort de la IA. En este rango —típico de fotos de teléfonos inteligentes tomadas a una distancia razonable o escaneos planos más antiguos en calidad "borrador"—, los caracteres individuales pueden verse suaves, pero las formas de las palabras siguen siendo distinguibles. El punto de referencia de Sparkco 2025 encontró que los sistemas de OCR basados en IA mantienen una precisión de caracteres superior al 90 % a 200 DPI, mientras que los motores tradicionales caen hacia el 80 % o menos. La diferencia es más visible en texto pequeño: una fuente de 10 pt a 200 DPI tiene ~28 píxeles de alto, suficiente para que la IA la resuelva, pero marginal para el OCR basado en segmentación.
Los documentos con contenido de texto de calidad de fax se benefician de una fortaleza inesperada de la IA: la preservación del diseño. Los algoritmos de compresión de fax (MH, MR, MMR) distorsionan los trazos finos de los caracteres, pero preservan la relación espacial entre los bloques de texto. Dado que la IA lee al comprender la estructura del documento —encabezados, texto del cuerpo, tablas— en lugar de carácter por carácter, a menudo puede recuperar texto enviado por fax que un motor de OCR tradicional fragmentaría en galimatías. El preprocesamiento de eliminación de ruido específico para fax (LlamaIndex, 2026) mejora aún más los resultados al eliminar el ruido de transmisión antes de que la IA procese el documento.
Las fotos de teléfono con poca luz e iluminación uniforme (sin sombras duras) se procesan sorprendentemente bien. Los modelos modernos de IA se han entrenado con diversas imágenes del mundo real y son robustos a los patrones de ruido y los matices de color típicos de la fotografía en interiores. El inconveniente es que las sombras —especialmente las sombras duras de una mano que sostiene el teléfono sobre el documento— crean bordes de contraste artificiales que confunden la detección del diseño. Difunda la luz (acérquese a una ventana, evite el flash directo) y la precisión se mantiene dentro del 5–8 % de un escaneo limpio.
Dónde la IA todavía falla
La lista honesta de modos de fallo importa más que los casos de éxito, porque subir un documento y obtener resultados basura es como se pierde la confianza en una herramienta para siempre.
Resolución inferior a 100 DPI es el límite mínimo. Por debajo de aproximadamente 100 DPI — común en documentos fotografiados desde demasiado lejos, PDFs muy reducidos en tamaño o imágenes en miniatura — los caracteres individuales ocupan muy pocos píxeles para que cualquier modelo los resuelva. Un carácter de 10 puntos a 100 DPI tiene solo unos 14 píxeles de alto, y los trazos finos que distinguen "8" de "3" o "5" de "6" tienen 2–3 píxeles de ancho. La superresolución de IA puede interpolar detalles faltantes, pero la interpolación inventa información: adivina cómo deberían ser los píxeles faltantes, y esas suposiciones a veces son incorrectas. Como señala la guía de OCR de baja resolución de LlamaIndex: "El escalado no puede recuperar detalles que nunca fueron capturados." En este nivel de resolución, volver a escanear o volver a fotografiar es la única vía fiable.
Desenfoque de movimiento severo — el tipo que se produce al fotografiar un documento mientras se camina o desde un vehículo en movimiento — es el tipo de degradación más dañino. El desenfoque de movimiento mancha el texto en una dirección consistente, fusionando caracteres en rayas continuas. A diferencia de la baja resolución, donde los caracteres conservan su forma con fidelidad reducida, el desenfoque de movimiento destruye por completo los límites de los caracteres. Los análisis comparativos independientes muestran consistentemente que el desenfoque de movimiento es el factor de calidad más dañino, con caídas de precisión del 10–20% incluso en casos moderados (análisis comparativo de OCR de Sparkco 2025; análisis de OCR de baja resolución de LlamaIndex). Los modelos de eliminación de desenfoque con IA han mejorado, pero enfrentan un límite fundamental de teoría de la información: los píxeles que se extendieron sobre múltiples posiciones de caracteres no pueden revertirse con certeza.
Documentos dañados por agua y físicamente degradados — sangrado de tinta, manchas de agua, manchas de moho, papel térmico desvanecido — presentan un problema compuesto. La degradación no es uniforme: una esquina de la página puede ser perfectamente legible mientras otra es una mancha borrosa. Los modelos de IA tienen dificultades con esta inconsistencia espacial porque su comprensión del diseño espera un documento coherente. Un estudio de 2025 sobre OCR de documentos degradados (IJSAT, 2026) encontró que los documentos arrugados redujeron la precisión del OCR entre un 30 y un 45% en todos los motores probados, y los documentos mojados o manchados entre un 25 y un 40%, con modelos de IA superando al OCR tradicional pero aún muy por debajo de los umbrales de producción. Para la digitalización de calidad de archivo de documentos dañados, siguen siendo necesarias herramientas especializadas con verificación humana en el circuito.
Documentos doblados, con pliegues y rasgados crean distorsiones geométricas que rompen las formas de los caracteres. Un pliegue a lo largo de una línea de texto crea una cresta visible donde los caracteres se comprimen verticalmente; la IA puede leer la sección comprimida como un carácter diferente u omitirla por completo. Aplanar el documento bajo peso antes de fotografiarlo ayuda significativamente, pero los pliegues profundos que han deformado permanentemente el papel seguirán causando errores. La guía de OCR de la Biblioteca de la Universidad de Pittsburgh recomienda escanear documentos con pliegues en modo RGB en lugar de escala de grises para preservar la información sutil de sombreado que ayuda a distinguir las sombras de los pliegues de la tinta.
Degradación compuesta — el caso del mundo real donde un documento es simultáneamente de baja resolución, sesgado, ruidoso y mal iluminado — supera incluso a los mejores procesos de preprocesamiento. Cada paso de mejora (enderezar, eliminar ruido, afinar, normalizar contraste) introduce sus propios artefactos, y estos artefactos se acumulan. Un usuario de Reddit en r/MachineLearning documentó esto con precisión: Tesseract logró 80–90% en imágenes buenas, 60% en medianas y 0% en imágenes de mala calidad donde múltiples defectos coincidían. El efecto acumulativo significa que mejorar incluso un factor — por ejemplo, aumentar la resolución de 100 a 200 DPI mientras se dejan el sesgo y el ruido sin cambios — puede elevar la precisión de "inutilizable" a "revisable", porque elimina la restricción más limitante.
Cómo Obtener los Mejores Resultados de Documentos Imperfectos
La acción de mayor impacto es mejorar la entrada antes de que llegue a la IA. El preprocesamiento puede recuperar 10–20% de la precisión perdida en documentos moderadamente degradados — a menudo suficiente para llevar una imagen límite al rango utilizable.
1. Escanee o fotografie a un mínimo de 300 DPI. Esta es la recomendación más repetida en todos los puntos de referencia de OCR y guías de bibliotecas — y con buena razón. A 300 DPI, un carácter de 10 puntos abarca aproximadamente 42 píxeles, dando a la IA suficiente resolución para distinguir trazos finos. La guía de OCR de la Biblioteca de la Universidad de Illinois y la de Pittsburgh convergen de forma independiente en 300 DPI como el umbral donde las ganancias de precisión se estabilizan. Por encima de 300 DPI hay rendimientos decrecientes para texto estándar; por debajo de 200 DPI, la precisión cae notablemente para cada motor probado.
2. Mantenga la cámara paralela al documento. El sesgo de perspectiva obliga a la IA a enderezar la imagen antes de leerla — añadiendo un paso de preprocesamiento donde los errores se acumulan. Un sesgo de 5 grados por sí solo puede causar una caída de precisión del 2–10%. La mayoría de las aplicaciones de cámara de teléfonos inteligentes tienen un modo de escaneo de documentos que corrige automáticamente la perspectiva; úselo. Para escáneres planos, alinee el borde del documento contra la regla de la cama del escáner.
3. Maximice el contraste en el origen. Tinta oscura sobre papel blanco es ideal. Si usted controla la entrada — personal de campo llenando formularios, técnicos escribiendo notas de inspección — exija bolígrafos de tinta oscura. Lápiz claro, tinta roja sobre papel de color y papel térmico de recibo desvanecido reducen la relación de contraste de la que dependen los modelos de IA. Un ajuste de brillo del 50% en los escáneres captura el rango dinámico más amplio sin lavar los trazos finos.
4. Elimine las sombras con iluminación difusa. La luz natural de una ventana —indirecta, no sol directo— produce la iluminación más uniforme. Si usa luz artificial, coloque dos fuentes en ángulos de 45 grados a cada lado del documento. El flash directo crea puntos brillantes que borran el texto; una mano que sostiene el teléfono proyecta una sombra dura sobre la mitad de la página. Ambos problemas se evitan con dos segundos de reflexión sobre la colocación de la luz.
5. Aplane los documentos doblados antes de fotografiarlos. Los pliegues y dobleces crean distorsiones geométricas que rompen la forma de los caracteres. Si un documento ha estado doblado, colóquelo bajo un libro pesado durante unas horas antes de fotografiarlo. Para documentos con pliegues permanentes, escanear en modo RGB (no en escala de grises ni blanco y negro) conserva la información tonal sutil que ayuda a la IA a distinguir las sombras de los pliegues del texto impreso.
6. Para documentos de fax, elimine el ruido antes de extraer. Las máquinas de fax usan algoritmos de compresión (MH, MR, MMR) que reducen el tamaño del archivo aproximando patrones de píxeles —creando los característicos artefactos "bloqueados" alrededor del texto. Pasar un fax por un filtro de mediana o un paso de umbral adaptativo antes de la extracción con IA elimina el ruido de transmisión sin degradar más el texto. La mejora no es drástica —una ganancia de precisión del 5–10% es típica— pero en un fax de 50 páginas, eso se traduce en 20–30 errores menos que corregir manualmente.
Documentos reales donde la IA maneja calidad imperfecta
La brecha entre la precisión de los puntos de referencia controlados y el rendimiento en el mundo real es mayor en documentos de baja calidad —que es exactamente por qué observar casos de uso reales importa más que citar cifras de referencia.
Notas de entrega de campo fotografiadas en la cabina de un camión. Un conductor de logística toma una foto de una nota de entrega firmada en el tablero antes de dirigirse a la siguiente parada. La foto tiene desenfoque de movimiento por el motor vibrante, iluminación desigual de la luz interior de la cabina y un ligero ángulo. Esta es una entrada realista del peor caso —y la IA la maneja mejor de lo que esperaría. La naturaleza estructurada del formulario (número de entrega, nombre del destinatario, fecha, bloque de firma) proporciona anclas semánticas. Con Extracción de Columnas Personalizadas, la IA extrae los campos impresos —número de entrega y fecha— con precisión casi normal porque suelen estar en posiciones consistentes con formato claro. Los nombres manuscritos de destinatarios y firmas son más difíciles: la IA los captura como indicadores de presencia en lugar de transcripciones precisas. El flujo de trabajo práctico: deje que la IA extraiga los campos estructurados automáticamente y verifique las partes manuscritas.
Facturas por fax de proveedores anteriores a 2020. Muchos proveedores en construcción, manufactura y venta al por mayor aún envían facturas por fax —especialmente proveedores más pequeños que no se han digitalizado. Una factura por fax combina baja resolución (100–200 DPI), artefactos de compresión y, a veces, ruido de la línea de transmisión. En una prueba documentada en el punto de referencia Sparkco 2025, los documentos por fax procesados con OCR impulsado por IA lograron aproximadamente 85–90% de precisión a nivel de campo en texto impreso —en comparación con 60–70% para OCR tradicional. Los errores restantes se concentran en partidas de fuente pequeña e impresión tenue. Para equipos de cuentas por pagar que procesan docenas de facturas por fax semanalmente, la extracción con IA reduce la entrada manual a corrección de errores en lugar de volver a teclear todo —un ahorro de tiempo de 3–5x incluso con resultados imperfectos.
Documentos de archivo amarillentos de los años 1990. Los despachos de abogados, las compañías de seguros y las agencias gubernamentales mantienen archivos de papel de décadas. Cuando se escanean para su digitalización, el papel original se ha amarillento, la tinta se ha desvanecido, y los agujeros de grapas y las notas al margen añaden ruido. La IA maneja bien el amarillamiento — la normalización de contraste durante el preprocesamiento puede recuperar texto que parece casi invisible al ojo humano. El verdadero desafío es la tinta desvanecida: en documentos donde el original era una impresión de matriz de puntos o una copia carbón clara, simplemente no hay suficiente contraste para que ninguna herramienta lo recupere de manera fiable. En estos casos, la IA extrae lo que puede y marca los campos de baja confianza para revisión humana — un flujo de trabajo de triaje que es mucho más eficiente que la revisión manual de cada campo.
Fotos de recibos con teléfonos inteligentes bajo iluminación de restaurante. Un profesional independiente en una cena de negocios toma una foto del recibo bajo una iluminación cálida y tenue de restaurante. La cámara del teléfono compensa con un ISO alto, introduciendo ruido; el papel es brillante, creando un punto de reflejo sobre parte del total; el recibo está ligeramente curvado por haber estado en una cartera. A pesar de los tres problemas, la IA extrae los campos clave — fecha, total, nombre del proveedor — correctamente en la mayoría de los casos porque los recibos tienen una estructura fuertemente predecible. El total es casi siempre el número más grande cerca de la parte inferior, la fecha sigue un formato reconocible, y el nombre del proveedor está en la parte superior. La IA utiliza estas convenciones de diseño como anclas implícitas incluso cuando los caracteres individuales son difíciles de leer. Una prueba de 2025 con 100 fotos de recibos tomadas con teléfonos inteligentes encontró que la extracción con IA logró una precisión a nivel de campo de aproximadamente el 92% en totales y fechas, cayendo a aproximadamente el 80% en descripciones de partidas, donde el texto es más pequeño y más afectado por los reflejos.
Preguntas Frecuentes
¿Puede la IA leer documentos escaneados a 100 DPI?
De manera fiable, no. A 100 DPI, un carácter estándar de 10 puntos ocupa aproximadamente 14 píxeles — no es suficiente para que ningún modelo de IA distinga entre caracteres similares como "8" y "3" o "5" y "6". Algunas herramientas de IA con preprocesamiento de superresolución pueden recuperar texto parcial, pero espere una precisión inferior al 75% y altas tasas de error en números y fuentes pequeñas. Volver a escanear a 300 DPI es casi siempre la mejor respuesta.
¿La IA maneja mejor el desenfoque de movimiento que el OCR tradicional?
Significativamente mejor, pero "mejor" no significa "resuelve". La IA lee formas a nivel de palabra y el contexto del documento, por lo que una etiqueta "Número de Factura" ligeramente borrosa aún se comprende. El OCR tradicional segmenta caracteres individuales y falla cuando los límites de los caracteres se desdibujan. La brecha es mayor con desenfoque moderado (la IA pierde 5–12%, el tradicional pierde 20–35%) y se reduce con desenfoque severo, donde ningún enfoque funciona de manera confiable. Para desenfoque de movimiento severo — el tipo que ocurre al fotografiar mientras se está en movimiento — volver a capturar la imagen es la única solución práctica.
¿Puede la IA extraer datos de documentos enviados por fax?
Sí, con matices. La IA logra una precisión a nivel de campo de aproximadamente 85–90% en texto impreso por fax, en comparación con 60–70% para el OCR tradicional. Los errores restantes se concentran en partidas de fuente pequeña, impresión tenue y documentos con ruido de transmisión intenso. Procesar documentos por fax con un paso de preprocesamiento de reducción de ruido (filtro de mediana o umbral adaptativo) antes de la extracción mejora los resultados en 5–10%. Para documentos de alto valor donde los errores son costosos, planifique la verificación humana de los campos extraídos.
¿Cuál es la calidad mínima de imagen necesaria para una extracción útil con IA?
Como umbral práctico: resolución equivalente a 200 DPI, ángulo frontal (menos de 5 grados de inclinación) y contraste suficiente para que una persona pueda leer el texto sin entrecerrar los ojos. Si se fallan estos tres umbrales simultáneamente, la precisión cae por debajo del 80% — el punto donde el tiempo de corrección manual se acerca al tiempo de ingreso manual. Si su documento cumple dos de los tres criterios, vale la pena intentar la extracción con IA. Si no cumple ninguno, mejore primero la entrada.
¿Puede la IA manejar documentos dañados por agua o manchados?
Parcialmente, y de forma impredecible. El daño por agua no es uniforme: una sección puede estar impecable mientras otra es una mancha deslavada. La IA extrae las secciones limpias con normalidad y tiene dificultades con las dañadas — igual que un lector humano. El realce de contraste puede recuperar áreas moderadamente desvanecidas, pero el sangrado severo de tinta donde los caracteres se han fusionado físicamente no puede revertirse con ningún software. Para documentos de archivo, espere combinar la extracción con IA con la revisión manual de las secciones dañadas.
¿La compresión JPEG afecta la precisión de la extracción con IA?
Sí, y el daño es permanente. La compresión JPEG descarta detalles finos para reducir el tamaño del archivo y, una vez descartados, ningún paso de preprocesamiento puede recuperarlos. La compresión JPEG intensa (nivel de calidad inferior al 50 %) crea "artefactos de bloqueo": bloques de píxeles de 8×8 visibles alrededor del texto, que confunden los límites de los caracteres. Los modelos de IA manejan bien la compresión ligera (calidad 70 o superior), pero en imágenes muy comprimidas, la precisión cae entre un 5 y un 10 %. Si tiene el escaneo o la foto original, úselo en lugar de una copia recomprimida.
¿Las fotos del teléfono son tan buenas como los escaneos de cama plana para la extracción con IA?
Con una foto de teléfono bien tomada (frontal, buena iluminación, sin desenfoque de movimiento, equivalente a 200+ DPI), la precisión está dentro de 3 a 5 puntos porcentuales de un escaneo de cama plana. La brecha se amplía a medida que las condiciones se degradan: una foto de teléfono con poca luz y desenfoque de movimiento puede ser entre un 15 y un 25 % menos precisa que un escaneo limpio. La diferencia práctica es la consistencia: un escáner de cama plana a 300 DPI produce una calidad casi idéntica cada vez, mientras que las fotos de teléfono varían enormemente según la técnica. Si procesa documentos con regularidad, un escáner se paga solo al reducir el tiempo de corrección de errores.
La extracción de documentos con IA en 2026 maneja entradas de baja calidad mucho mejor que las herramientas de OCR que la mayoría de la gente ha probado, pero "mucho mejor" no es lo mismo que "perfecto". La curva de degradación es gradual en lugar de catastrófica: a 200 DPI con desenfoque moderado, obtendrá datos utilizables. Por debajo de 150 DPI con desenfoque severo o defectos combinados, obtendrá frustración. La respuesta honesta a "¿puede la IA leer mis documentos borrosos?" es "pruebe uno y vea", porque su combinación específica de tipo de documento, degradación e importancia del campo determina si el resultado está listo para producción o necesita revisión humana. Suba su peor documento y descubra dónde se encuentra su calidad en la curva.
Si trabaja con documentos que combinan contenido impreso y manuscrito (algo común en formularios de campo de baja calidad), consulte nuestra guía sobre qué tan bien lee la IA la escritura a mano en fotos. Para documentos donde la variabilidad del formato agrava los problemas de calidad, cómo extrae la IA datos de PDF cubre el enfoque de extracción independiente del formato. Y si está evaluando si su volumen de documentos justifica la automatización, comience con qué es la extracción de documentos con IA y cómo funciona.