Comment l'IA « lit » vos documents
Un guide non technique (2026)
Quand vous regardez une facture, vous ne lisez pas de gauche à droite, de haut en bas, caractère par caractère. Vous jetez un coup d'œil et vous savez déjà où se trouve le total. Vos yeux se dirigent vers le coin inférieur droit avant même que vous ayez consciemment décidé d'y regarder. En moins d'une seconde, votre cerveau a cartographié toute la page — le logo en haut, les lignes d'articles au milieu, les chiffres en bas — et a dirigé votre attention vers ce qui compte. L'IA peut faire cela maintenant, elle aussi. Non pas en étant programmée avec des règles sur l'emplacement des totaux sur les factures, mais en apprenant à voir et à comprendre les documents comme vous le faites.
Points clés à retenir
- L'IA ne scanne pas les documents ligne par ligne — elle voit toute la page d'un coup, comme vos yeux qui trouvent le total sur une facture avant que vous ayez consciemment décidé d'y regarder.
- Le processus en trois étapes — VOIR toute la page, COMPRENDRE ce que « Facture n° » signifie à travers une douzaine de variantes de libellés, RÉCUPÉRER la bonne valeur dans la bonne colonne — fonctionne parce que le sens prime toujours sur la position.
- Quand le format et la mise en page cessent d'importer, la question passe de « puis-je automatiser cela ? » à « de quels documents devrais-je extraire des données ? »
L'ancienne méthode : apprendre aux ordinateurs à scanner, pas à lire
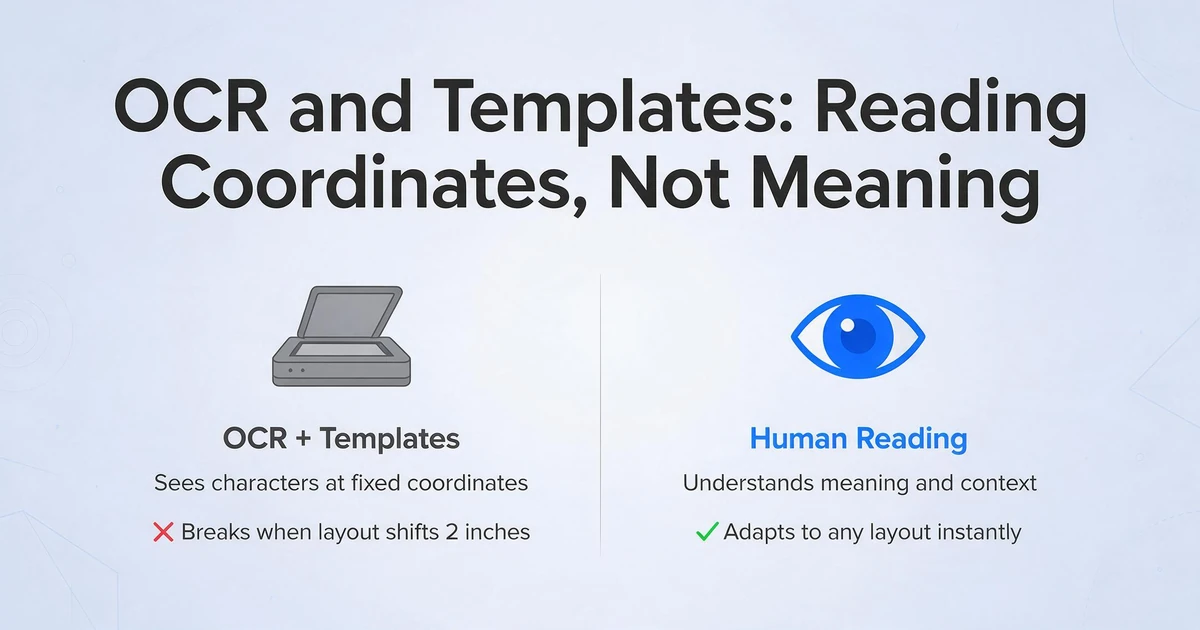
Pendant des décennies, extraire des données d'un document signifiait utiliser l'OCR — la reconnaissance optique de caractères. L'OCR examine une image et convertit les formes des lettres en texte. Cela ressemble à de la lecture, mais ce n'en est pas. C'est plutôt comme un photocopieur qui produit du texte au lieu d'une autre image. Il voit des marques noires sur un fond blanc et dit : « ces marques forment la lettre A, celles-ci forment le chiffre 7. » Il ne sait pas ce qu'est une facture. Il ne sait pas que $4 230,50 à côté du mot « Total » est le montant que vous devez.
Pour contourner ce problème, la génération suivante d'outils utilisait des modèles. Vous dessiniez une zone autour du champ numéro de facture sur la facture d'un fournisseur. Puis une autre zone autour de la date. Puis une autre autour du total. Chaque nouveau fournisseur avec une mise en page différente nécessitait un nouvel ensemble de zones. Un nouveau fournisseur vous envoie un PDF, et l'outil renvoie du charabia — parce que le total a bougé de deux centimètres vers la gauche. Ce n'était pas de la compréhension de documents. C'était de la mémorisation de coordonnées de documents.
Les deux approches partagent la même hypothèse fatale : qu'un document n'est que des caractères disposés dans l'espace. Elles ne saisissent pas que ces caractères forment des significations — que « Facture n° » est une étiquette, que la valeur à côté est un identifiant, que le nombre en bas avec un signe dollar est probablement ce que vous devez payer.
Étape 1 : VOIR — L'IA prend la page entière d'un coup
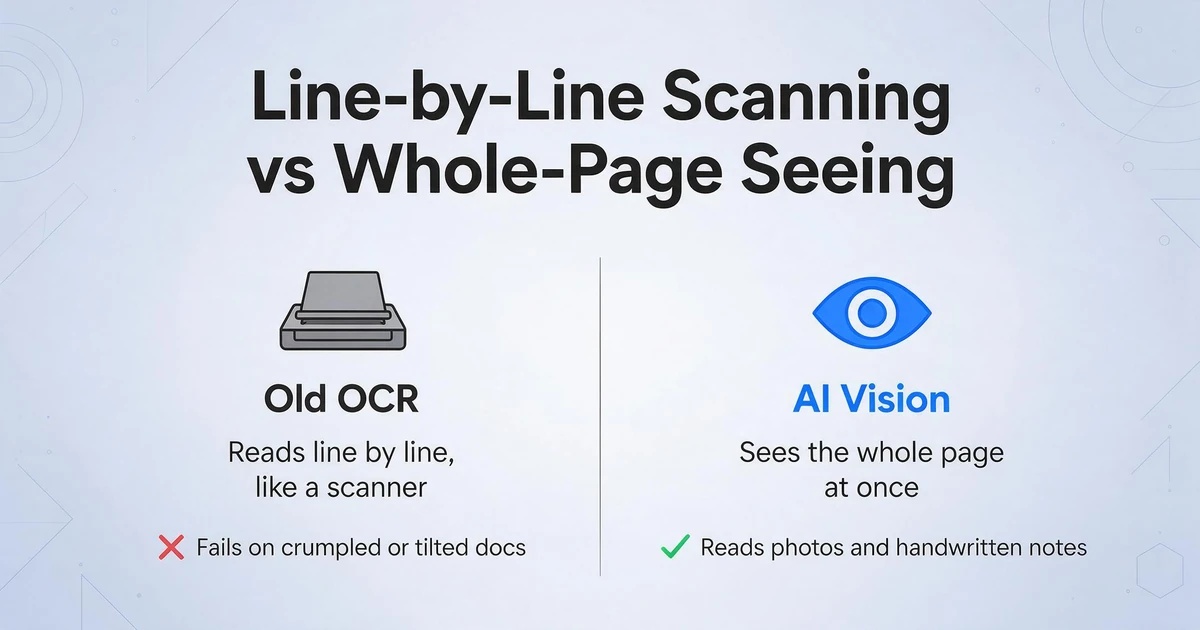
La première chose que fait l'IA moderne avec votre document est fondamentalement différente de l'ancienne approche. Au lieu de scanner ligne par ligne — lire le texte comme le fait un scanner à plat — elle voit la page entière comme une image complète.
Pensez à la façon dont vous regardez le menu d'un restaurant. Vous ne lisez pas chaque mot des « Entrées » aux « Desserts ». Vos yeux absorbent la mise en page complète en un seul coup d'œil : les prix à droite, les descriptions au milieu, les titres de sections en gras. Vous pouvez trouver le plat le plus cher en moins d'une seconde parce que votre système visuel traite toute la scène simultanément. La capacité de vision de l'IA fonctionne de la même manière. Elle perçoit les relations spatiales — ce bloc de texte est au-dessus de celui-ci, ce nombre est dans une cellule de tableau, ce logo se trouve dans la zone d'en-tête — de la même façon que vos yeux le font avant même que votre cerveau conscient ne s'en mêle.
C'est pourquoi une photo d'un reçu froissé prise dans un mauvais éclairage peut encore être traitée. L'IA ne lit pas une grille de texte propre ; elle reconstruit une scène visuelle. Tout comme vous pouvez lire une note manuscrite d'un ami même si elle est inclinée et à moitié recouverte par une tasse de café, l'IA peut donner un sens à des entrées imparfaites parce qu'elle voit l'image complète, pas seulement les chaînes de texte.
Étape 2 : COMPRENDRE — Savoir ce que « N° de facture » signifie réellement
Voir la page n'est que la première étape. Le vrai bond en avant, c'est de comprendre ce que les éléments vus signifient. C'est ici que l'IA se démarque complètement des outils plus anciens — et qu'elle commence à se comporter davantage comme une personne que comme un programme.
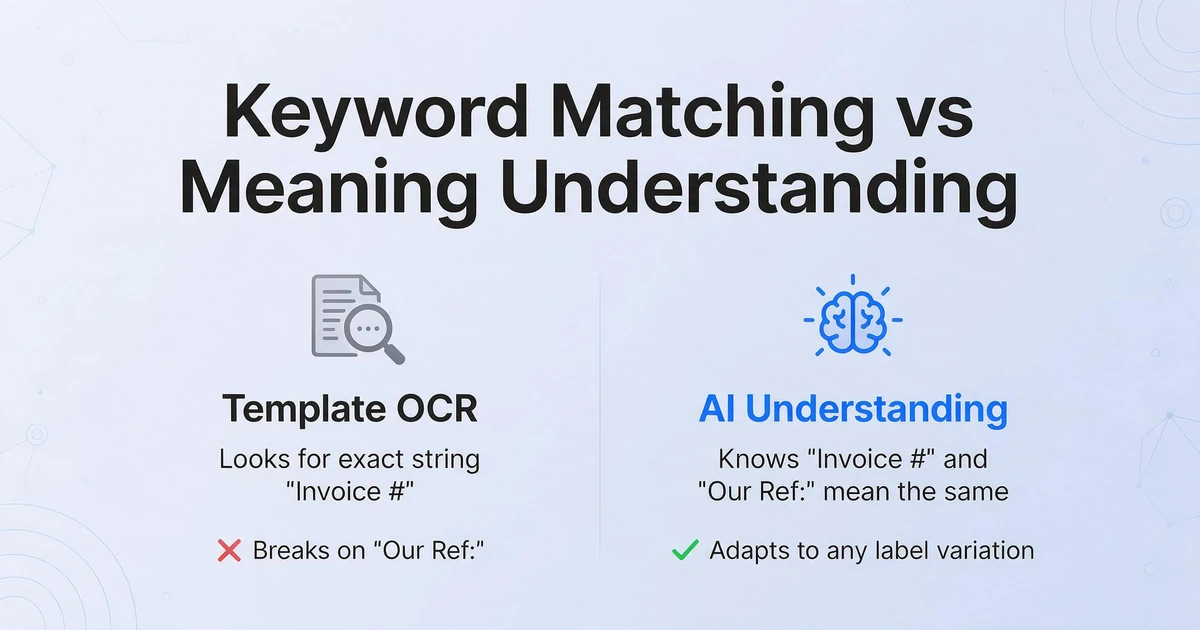
Imaginez qu'on vous remette un document dans une langue que vous ne parlez pas, mais que vous remarquez que le numéro INV-2024-0891 se trouve à côté de l'expression « N° de facture » dans chaque document que vous avez vu. Vous apprendriez vite : quand je vois « N° de facture », la valeur à côté est l'identifiant de la facture. Imaginez maintenant que le prochain fournisseur écrive « Réf. : » au lieu de « N° de facture ». Un outil basé sur un modèle échoue ici — on lui a dit de chercher la chaîne exacte « N° de facture ». Mais vous, en tant qu'humain, vous vous adaptez instantanément. Vous reconnaissez que « Réf. : » remplit le même rôle, parce que vous comprenez le rôle que joue ce champ dans le document, et pas seulement son texte littéral.
La compréhension documentaire par l'IA fonctionne sur ce même principe. Elle sait que « Numéro de facture », « N° fact. », « N° de facture » et « Réf. : » sont toutes des façons différentes de dire la même chose. Elle n'a pas besoin qu'on lui indique chaque variante. Elle a appris — grâce à l'exposition à des millions de documents — les schémas de libellés et de structuration de l'information, de la même manière que vous avez appris qu'un numéro dans le coin inférieur droit d'une facture est probablement le total.
C'est la différence entre reconnaître des caractères et comprendre un document. L'IA ne cherche pas une correspondance de mot-clé. Elle répond à la question : « quelles informations vivent dans ce document, et quel rôle joue chaque élément ? »
Le modèle mental qui aide : Les anciens outils répondent « où sont les données ? » L'IA répond « que sont les données ? » La première approche échoue quand le « où » change. La seconde se moque totalement du « où ».
Étape 3 : FETCH — placer la bonne valeur dans la bonne colonne
Une fois que l'IA a vu le document et compris son contenu, la dernière étape est d'une simplicité trompeuse : vous dites ce que vous voulez, et elle le trouve.
Voici comment cela fonctionne en pratique. Vous avez une pile de factures provenant de différents fournisseurs. Vous saisissez quatre noms de colonnes dans l'outil : « Numéro de facture », « Date », « Total » et « Nom du fournisseur ». C'est tout. Vous venez d'indiquer à l'IA ce qu'elle doit chercher. Elle parcourt chaque facture, localise la valeur qui correspond à chaque nom de colonne — par le sens, pas par la position — et remplit votre feuille de calcul.
Le point essentiel : vous définissez la sortie, et l'IA navigue dans l'entrée pour la trouver. Vous ne lui apprenez pas où se trouve chaque champ sur la facture de chaque fournisseur. Vous ne créez pas de modèles. Vous ne dessinez pas de zones. Vous nommez simplement les colonnes souhaitées, et l'IA fait le reste. Cette approche — ce que nous appelons Extraction de colonnes personnalisées — inverse le flux de travail traditionnel. Au lieu que le document dicte les données que vous obtenez (et d'où elles viennent), vous dictez les données dont vous avez besoin, et l'IA détermine où les trouver sur chaque document.
Le même principe s'étend au-delà de la simple extraction. Vous pouvez demander à l'IA de catégoriser pendant l'extraction — par exemple, en ajoutant une colonne intitulée « Catégorie (options : Repas/Transport/Bureau/Autre) » — et l'IA lira chaque reçu et décidera de la catégorie appropriée, même si aucun reçu ne comporte de champ « Catégorie » imprimé. Vous pouvez même lui demander d'effectuer des calculs pendant l'extraction, comme calculer le montant de la taxe à partir d'un sous-total lorsque seul le total général est imprimé. L'IA ne se contente pas de copier des chiffres — elle raisonne à leur sujet.
Les fichiers sont traités de manière sécurisée et ne sont pas stockés.
Pourquoi cela change tout à propos des formats de documents
Si l'IA trouve les données en comprenant leur signification plutôt que leur emplacement, alors la mise en page du document devient sans importance. C'est la conséquence qui rend le processus en trois étapes si transformateur en pratique.
Dix factures provenant de dix fournisseurs différents, chacune avec sa propre mise en page — des positions différentes pour la date, des noms différents pour le champ total, des structures de tableau différentes. Pour un outil basé sur des modèles, cela représente dix projets de configuration distincts. Pour une IA qui voit et comprend comme le ferait une personne, c'est un seul lot. Vous téléchargez les dix, nommez vos colonnes une fois, et obtenez une seule feuille de calcul avec toutes les données fusionnées dans un tableau.
Ce n'est pas seulement plus rapide — cela change ce qui est réalisable. Avant que cette capacité n'existe, si un client vous envoyait une photo d'un reçu manuscrit, vous deviez soit le saisir manuellement, soit lui dire qu'il devait envoyer un PDF approprié. Maintenant, une photo prise avec un téléphone fonctionne comme un document scanné. Une capture d'écran d'un PDF fonctionne comme le PDF lui-même. Le format d'entrée a cessé d'être un obstacle dès le moment où l'IA a commencé à comprendre le contenu au lieu d'analyser les mises en page.
Ce qui rend cela possible n'est pas un dictionnaire plus grand ou une reconnaissance de caractères plus rapide. C'est le passage de l'extraction basée sur la position — « le numéro de facture se trouve aux coordonnées (x, y) » — à l'extraction basée sur la signification — « trouvez la valeur qui sert d'identifiant de facture, où qu'elle se trouve. » La première approche est fragile. La seconde est flexible exactement de la manière dont la lecture humaine est flexible : vous pouvez reconnaître un total qu'il soit dans un tableau, dans une phrase, ou écrit à la main dans la marge.
Questions fréquemment posées
L'IA comprend-elle réellement mes documents, ou se contente-t-elle de deviner en se basant sur des schémas ?
Ce n'est pas une devinette au sens d'un tirage à pile ou face. Pensez à un comptable expérimenté qui a vu des milliers de factures. Ce comptable ne « devine » pas où se trouve le total — il le sait, parce qu'il reconnaît le schéma instantanément. L'IA possède le même type d'intuition entraînée, construite à partir d'une exposition à une gamme énorme de types de documents et de mises en page. La différence est que l'IA traite ce qu'elle voit en moins de dix secondes, pas en trois minutes. Pour les documents imprimés, cette reconnaissance entraînée atteint jusqu'à 99 % de précision.
L'IA peut-elle lire l'écriture manuscrite ?
Oui. Comme l'IA perçoit le document d'abord et avant tout comme une image — et non comme un ensemble de caractères tapés — l'écriture manuscrite n'est qu'un autre motif visuel à interpréter. Elle fonctionne avec le texte imprimé, l'écriture cursive, les majuscules, et même les cases à cocher et les sélections encerclées sur les formulaires. Cela dit, une écriture extrêmement illisible (le genre qu'un humain aurait aussi du mal à déchiffrer) peut réduire la précision. Plus l'écriture est propre, meilleur est le résultat — comme avec une personne.
Que se passe-t-il si l'IA se trompe ?
Aucune IA n'est parfaite, et un outil responsable ne prétend pas le contraire. La sortie est structurée de manière à faciliter la vérification — chaque valeur extraite se trouve dans une colonne étiquetée, ce qui permet de repérer rapidement les anomalies plutôt que de recouper champ par champ avec le document original. Si vous remarquez une erreur récurrente, ajuster vos noms de colonnes pour les rendre plus précis résout souvent le problème. L'IA fonctionne mieux lorsque vos noms de colonnes décrivent clairement ce que vous recherchez.
Dois-je d'abord l'entraîner sur mes documents ?
Non. C'est l'une des plus grandes différences par rapport aux anciennes approches d'IA. Les outils de traitement documentaire d'entreprise exigent souvent de téléverser des lots de documents d'exemple, d'étiqueter manuellement les champs et d'attendre que le système entraîne un modèle personnalisé — un processus qui peut prendre des jours ou des semaines. L'IA moderne basée sur la vision est pré-entraînée sur une vaste gamme de types de documents et fonctionne immédiatement. Vous téléversez, nommez vos colonnes et obtenez des résultats. Il n'y a ni phase de configuration ni courbe d'apprentissage pour l'outil — l'apprentissage a déjà eu lieu avant votre arrivée.
Mes données sont-elles sécurisées lorsque l'IA les lit ?
Cela dépend entièrement de l'outil que vous utilisez. Lorsque vous évaluez un service d'IA documentaire, recherchez des déclarations explicites sur le traitement des données : vos données sont-elles utilisées pour entraîner davantage l'IA ? Sont-elles stockées après le traitement ? Sont-elles chiffrées ? Un service digne de confiance traite vos fichiers, renvoie les données extraites et ne conserve ni n'apprend de vos documents. Vérifiez toujours les politiques de confidentialité et de traitement des données du fournisseur avant de téléverser des documents sensibles.
Ce que cela signifie pour vous
Le processus VOIR → COMPRENDRE → RÉCUPÉRER n'est pas qu'un simple détail technique. C'est la raison pour laquelle un outil qui demandait trois minutes de travail manuel par document prend désormais cinq à dix secondes. Le gain de temps vient de l'élimination de deux types de travail à la fois : le travail mental consistant à trouver chaque champ sur chaque document, et le travail physique consistant à saisir les valeurs dans les bonnes cellules.
Mais le changement le plus important réside dans ce qui devient possible. Lorsque le traitement d'un document est rapide, vous pouvez traiter des documents que vous n'auriez pas pris la peine de traiter auparavant. Lorsque le format n'a pas d'importance, vous cessez de demander aux clients et aux fournisseurs d'envoyer les choses « de la bonne manière ». Lorsque la configuration ne nécessite aucune formation, la barrière entre « je devrais automatiser cela » et « je le fais réellement » s'effondre.
Si vous souhaitez approfondir le côté technique — ce qui se passe sous le capot, comment cela se compare à l'OCR traditionnel plus en détail, et d'où viennent les chiffres de précision — notre guide sur ce que signifie réellement la saisie de données par IA reprend là où cet article s'arrête. Et si vous êtes curieux d'intégrer cette capacité dans vos flux de travail existants sans aucun codage, découvrez comment l'IA documentaire sans code rend l'extraction accessible à toute personne capable de nommer une colonne.
Essayez-le sur votre propre facture. Saisissez trois noms de colonnes — Numéro de facture, Date, Total — et regardez l'IA voir, comprendre et récupérer en temps réel. La meilleure façon de comprendre le processus est de le voir se dérouler sur votre document.