L'IA OCR lit l'écriture manuscrite
Là où l'OCR traditionnel devient aveugle
Une facture dactylographiée propre à 300 DPI, traitée via Tesseract ou Google Cloud Vision, revient avec une précision de caractères de 99 %. Changez uniquement le support — la même facture, remplie à la main — et la précision chute sous les 50 %. L'écart n'est pas un problème de calibrage. C'est un problème d'architecture : l'OCR traditionnel a été conçu pour comparer des formes de caractères statiques à des modèles connus. L'écriture manuscrite n'a pas de modèles. La même lettre écrite deux fois par la même personne produit deux formes différentes. Un modèle de vision par IA aborde le problème dans l'autre sens — en lisant les mots comme des motifs visuels et en utilisant le contexte environnant pour lever l'ambiguïté de traits qui seraient autrement ambigus.
Points clés à retenir
- Une facture dactylographiée à 300 DPI atteint 99 % de précision de caractères via l'OCR traditionnel, tandis que la même facture remplie à la main chute sous les 50 % — non pas parce que la numérisation s'est dégradée, mais parce que l'outil a été conçu pour séparer des caractères que l'écriture cursive relie délibérément.
- 30 à 50 mots sur 100 reviennent incorrects avec l'OCR cloud sur des documents en écriture cursive, et aucun réglage de contraste n'y remédie — la défaillance se situe dans l'architecture de segmentation des caractères, pas dans le pipeline d'image.
- Vous lisez l'écriture manuscrite en voyant des mots entiers, pas en assemblant des lettres individuelles — les modèles de vision par IA font désormais de même, et sur ImageToTable.ai, cela porte la précision des champs à 85-95 %, où la vérification de 100 feuilles de temps manuscrites prend 3 minutes au lieu de 300.
Pourquoi la lecture caractère par caractère échoue sur l'écriture manuscrite
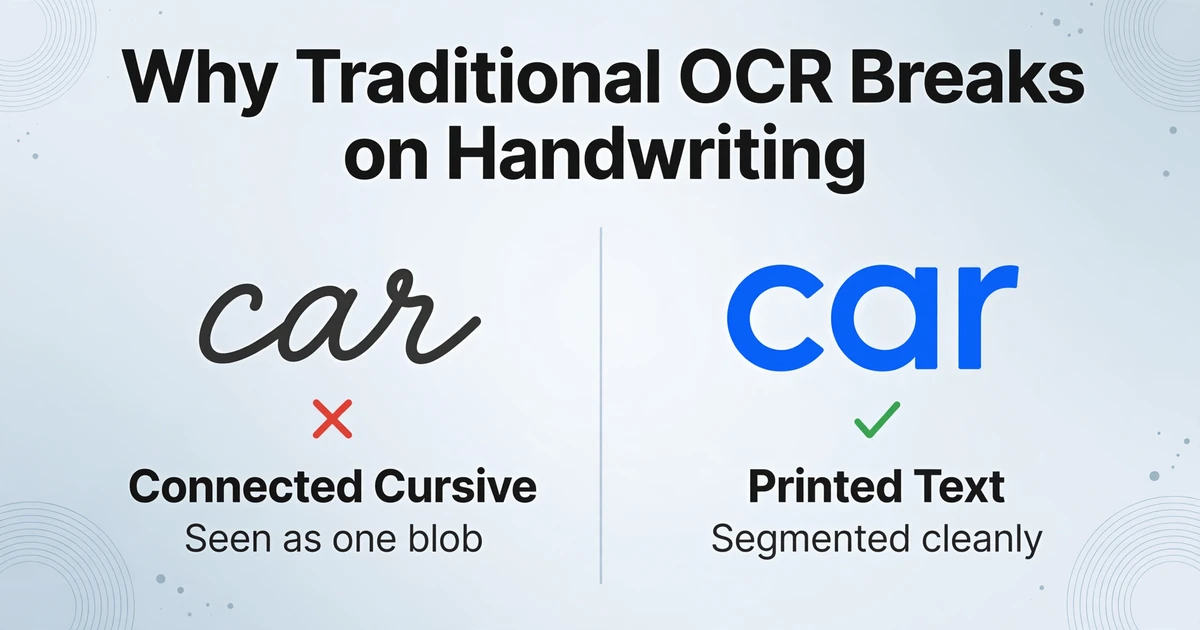
L'OCR traditionnel fonctionne sur un modèle basé sur la segmentation. Le moteur analyse une image, isole chaque caractère en détectant les limites d'espace blanc, puis compare la forme isolée à une bibliothèque de glyphes connus. Ce processus fonctionne lorsque les caractères sont prévisibles — un « A » Arial imprimé correspond proprement aux modèles « A » Arial stockés. Il s'effondre lorsque les caractères refusent de se placer dans des boîtes prévisibles.
Trois problèmes structurels font de l'écriture manuscrite un cauchemar de segmentation pour l'OCR traditionnel. Caractères connectés — l'écriture cursive joint les lettres adjacentes avec des ligatures, rendant l'espace entre « a » et « r » dans « car » impossible à trouver pour un algorithme de détection de limites. Le moteur voit un glyphe continu là où un humain voit quatre lettres. Largeurs de trait variables — un stylo à bille appuyé fort sur les pleins et légèrement sur les déliés produit des variations d'épaisseur de ligne qui fragmentent des caractères uniques en segments détectés séparés. Un « 5 » devient un bloc plus un tiret séparé. Lignes de base incohérentes — les gens écrivent en biais, dérivent vers le haut d'une page et varient la hauteur des lettres dans un même mot. L'étape de détection de ligne qui fonctionne sur du texte typographié échoue lorsque « pomme » est écrit à un angle de 15 degrés avec le « p » descendant sous la ligne de base et le « l » s'élevant au-dessus.
La conséquence en aval est une cascade. Une étude de 2025 publiée dans l'International Journal of Computer Scientific Technology & Electronics Engineering a constaté que la précision de l'OCR traditionnel sur les documents manuscrits chute de 92 % sur du texte imprimé propre à la main à 55 % en cas de dégradation modérée et à 30 % en conditions sévères — des conditions qui seraient à peine considérées comme du bruit pour le traitement de texte imprimé. Parallèlement, le benchmark d'écriture cursive 2026 d'AIMultiple, testant 100 échantillons sur 14 modèles, a constaté que les services d'OCR cloud traditionnels comme Google Cloud Vision et Amazon Textract se situent entre 50 % et 70 % sur la cursive — ce qui signifie que 30 à 50 mots sur 100 sont erronés.
La communauté de saisie de données sur Reddit documente cet écart depuis des années. Une discussion de 2024 sur r/Automate concernant l'extraction de données à partir de factures manuscrites a formulé le problème de manière succincte : « Vous devez prendre non seulement des données manuscrites, mais des données manuscrites non structurées et leur donner un sens. » La revue 2025 de la communauté r/computervision sur les outils d'OCR d'écriture manuscrite a noté sans détour que la « précision d'écriture manuscrite (~65-85 %) des nouveaux modèles d'IA reste en retard par rapport aux solutions spécialisées pour un usage critique en entreprise. » Ce sont des praticiens, pas des spécialistes du marketing. Leurs chiffres comptent.
Comment les modèles de vision par IA lisent l'écriture manuscrite comme des motifs visuels, et non comme des séquences de caractères
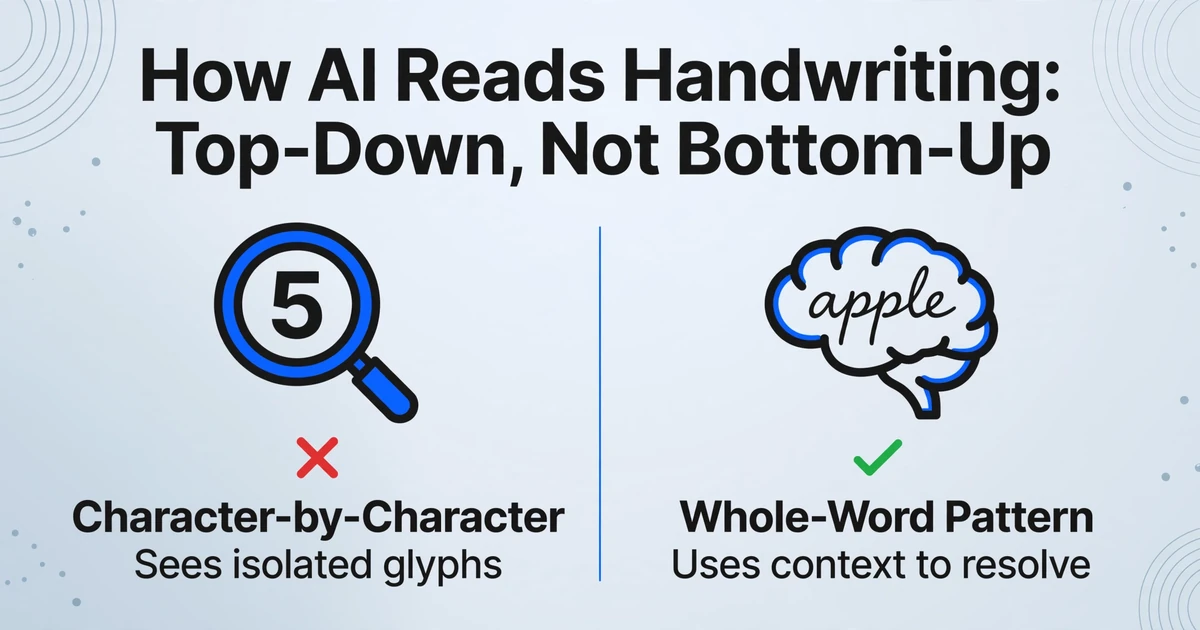
Les modèles de vision par IA — plus précisément, les modèles de vision-langage comme GPT-5, Gemini et Claude — n'effectuent aucune segmentation des caractères. Ils traitent l'image de manière holistique, voyant des formes de mots entières comme des motifs visuels unifiés, puis interprètent ces motifs avec le même modèle de langage qui comprend la phrase dans laquelle le mot apparaît. C'est l'inversion cruciale : au lieu de construire des mots à partir de caractères (de bas en haut), ils reconnaissent les mots comme des ensembles visuels et utilisent le mot compris pour lever l'ambiguïté sur les formes de lettres individuelles (de haut en bas).
La différence pratique est plus facile à voir sur quelque chose d'ordinaire — un champ de nom sur un formulaire. Imaginez une saisie manuscrite où la plume de l'écrivain se soulève légèrement au milieu de « Sm_th », laissant un caractère faible ou manquant entre le « m » et le « t ». L'OCR traditionnel, travaillant caractère par caractère, renvoie « Sm » plus un glyphe non reconnu plus « th ». L'erreur s'aggrave — le nom complet pourrait être méconnaissable en aval. Un modèle de vision par IA voit la forme du mot « Sm_th » et le contexte environnant — c'est le champ « Nom » d'un formulaire, le nom complet est « John Smith ». Le modèle de langage comble le vide à partir du contexte, tout comme vous le feriez si vous le voyiez de vos propres yeux. Le même mécanisme distingue un « 1 » manuscrit d'un « l » minuscule, un « 0 » d'un « O », et un « 4 » manuscrit qui ressemble à un « 9 » — en se demandant : qu'est-ce qui a du sens ici ?
C'est pourquoi les modèles de vision par IA modernes surpassent nettement l'OCR traditionnel sur l'écriture manuscrite. Le benchmark d'AIMultiple a placé GPT-5 et Gemini 3 Pro Preview en tête pour la reconnaissance de l'écriture cursive — non pas parce qu'ils ont de meilleurs détecteurs de caractères, mais parce qu'ils lisent le document comme le ferait une personne : en comprenant ce que le texte signifie, et pas seulement à quoi ressemblent ses pixels. Le même benchmark a trouvé Google Cloud Vision à environ 63 % sur l'écriture cursive. L'écart entre 95 % et 63 %, c'est l'écart entre « utilisable avec des vérifications ponctuelles » et « nécessite une ressaisie manuelle complète ».
Cette approche sémantique est ce qui rend la saisie de données alimentée par IA sans modèle par conception. Vous tapez les noms de colonnes que vous souhaitez extraire — « Nom de l'employé », « Heures travaillées », « Date » — et l'IA localise les valeurs manuscrites correspondant à chaque champ n'importe où sur la page en comprenant leur signification. Pas de coordonnées de pixels. Pas de modèles par formulaire. Pas de réentraînement lorsque l'écriture de quelqu'un change. C'est le mécanisme que nous appelons Extraction de colonnes personnalisées : vous définissez le schéma de sortie en nommant les colonnes souhaitées, et l'IA fait correspondre le contenu du document à votre schéma, quel que soit l'endroit où chaque valeur manuscrite se trouve sur la page.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Écriture imprimée et manuscrite mélangées : le format de document le plus courant dont personne ne parle
La plupart des documents manuscrits réels ne sont pas purement manuscrits. Ce sont des formulaires — un modèle imprimé avec des étiquettes, des cases et des instructions, remplis au stylo. L'étiquette « Nom du patient : » est imprimée en Helvetica. La valeur « James Peterson » est écrite en écriture cursive au stylo à bille. Un moteur d'OCR traditionnel, réglé pour l'impression, lit parfaitement l'étiquette et échoue sur la valeur — produisant un document où 80 % du texte est correct et où les 20 % dont vous avez réellement besoin manquent.
Ce format imprimé-plus-manuscrit est là où les modèles de vision par IA montrent leur plus grand avantage sur la concurrence. Le modèle ne bascule pas entre un « mode impression » et un « mode écriture manuscrite ». Il lit la page comme une scène visuelle unique — reconnaissant que « Nom du patient » est une étiquette de champ (imprimée, propre) et que le gribouillage en dessous est la valeur du champ (manuscrite, désordonnée) — et mappe les deux à la bonne colonne de sortie. Le contexte de l'étiquette imprimée aide activement la reconnaissance de l'écriture manuscrite : si l'étiquette dit « Numéro de téléphone », le modèle s'attend à une séquence de chiffres dans le champ de valeur, contraignant le problème de reconnaissance. Si l'étiquette dit « Commentaires », le modèle s'attend à des phrases complètes et s'ajuste en conséquence.
Ce format apparaît partout. Les formulaires d'admission médicale — questions démographiques imprimées, réponses manuscrites. Les rapports d'inspection sur le terrain — listes de contrôle de sécurité imprimées, observations manuscrites dans la colonne des notes. Les confirmations de livraison — numéros de suivi imprimés, signatures et horodatages manuscrits du destinataire. Les devis fournisseurs — lignes imprimées, ajustements de quantité manuscrits. Dans tous ces cas, le goulot d'étranglement du flux de travail n'est pas « lire le document ». C'est « lire les parties manuscrites qui contiennent les données exploitables ». L'OCR traditionnel vous donne le texte des étiquettes gratuitement et vous facture cher les valeurs. La vision par IA lit les deux en une seule passe.
Le concept de lecture des étiquettes et des valeurs en contexte n'est pas seulement une solution pour l'écriture manuscrite — c'est la différence fondamentale entre la précision de l'OCR par IA et de l'OCR traditionnel. L'OCR traditionnel voit « Date : 15/03/2026 » comme une chaîne de caractères. L'extraction par IA voit une étiquette de champ (« Date ») avec un type sémantique (date calendaire), et place la valeur dans la bonne colonne de feuille de calcul même lorsque cinq autres dates apparaissent sur la même page — parce qu'elle comprend quelle date appartient à quelle étiquette.
Cases à cocher, coches et cercles : lire l'intention, pas les formes
Une case cochée sur un formulaire papier peut prendre plusieurs formes : un remplissage plein, une ligne diagonale, une croix, une coche, une réponse entourée, une rature sur la mauvaise option, un double soulignement sous la bonne. Pour un moteur d'OCR traditionnel, aucune de ces formes n'est du texte — ce sont des parasites d'image. Le moteur les ignore ou, pire, interprète la marque comme un caractère : une coche devient un « V », une barre oblique devient « / », une option entourée se lit comme un « O » préfixé au texte de la réponse.
Le problème s'aggrave dans les formulaires structurés. Une liste de contrôle de sécurité avec 20 cases Oui/Non contient 20 décisions binaires qui déterminent la conformité, la planification de la maintenance ou la responsabilité. Si le moteur interprète mal 5 cases sur 20, l'automatisation est pire qu'inutile — elle produit silencieusement des données erronées qui semblent correctes. Un champ marqué « Sûr » devient « Dangereux » parce que le moteur a interprété une coche ✓ comme un caractère « V » à côté de la mauvaise option.
Les modèles de vision par IA traitent les cases à cocher différemment car ils fonctionnent sur des relations spatiales plutôt que sur la détection de caractères. Le modèle identifie le texte de la question (« Extincteur vérifié ? ») et les options de réponse (« Oui / Non »), puis détermine quelle zone de réponse contient une marque — quelle qu'elle soit. Une coche, une croix, un cercle rempli, une ligne griffonnée : tout est interprété comme « cette option est sélectionnée ». Le modèle n'a pas besoin de classer le type de marque. Il classe l'intention de sélection — le lien spatial entre la marque et l'option qu'elle modifie.
L'équipe Document AI de Google a documenté ce défi directement dans ses forums développeurs : les praticiens rapportent que la détection des cases à cocher échoue même avec des cases plus grandes lorsque les formulaires passent par des pipelines impression-remplissage-numérisation. La recommandation — des dimensions de case de 12 à 15 mm — ne s'applique que si vous contrôlez la conception du formulaire. Pour les milliers de formulaires existants déjà en circulation avec des cases plus petites, la solution est un modèle d'IA qui lit l'intention spatiale plutôt que la géométrie des formes.
Ce que l'IA ne peut toujours pas lire de manière fiable
Reconnaître honnêtement les limites est ce qui rend crédible l'argument en faveur de l'extraction d'écriture manuscrite par IA. Voici ce qui pose encore problème.
Écritures fortement superposées. Lorsqu'une ligne d'écriture manuscrite est écrite directement sur une autre — courant dans les livres de comptes où des corrections étaient faites en écrivant par-dessus l'entrée d'origine — l'OCR traditionnel et les modèles de vision par IA rencontrent tous deux des difficultés. Le modèle voit une seule masse visuelle là où il existe deux couches de sens. Un humain disposant du contexte de l'historique du document pourrait les distinguer. L'IA actuelle ne le peut pas.
Signatures extrêmement stylisées. Les signatures fonctionnent comme des marques d'identité, non comme un texte lisible. Ce sont des motifs volontairement uniques combinant fioritures, boucles illisibles et glyphes personnels. Les modèles d'IA détectent qu'une signature est présente — ils peuvent identifier la zone de signature sur un document — mais ils n'extraient pas le nom du signataire à partir de la forme de la signature elle-même. Le nom doit apparaître en texte imprimé ou manuscrit ailleurs sur le document.
Crayon à papier pâle sur fonds sombres. Le crayon sur papier copie, numérisé à faible contraste, produit des traits à peine distinguables du grain du papier. Une enquête académique de 2025 sur les techniques de reconnaissance d'écriture manuscrite a noté que la « robustesse au bruit » reste l'un des problèmes clés non résolus — « les chercheurs devraient continuer à étudier des méthodes qui augmentent la résilience des systèmes OCR » face à des conditions réelles sous-optimales. Cela s'applique aux systèmes traditionnels comme aux systèmes basés sur l'IA.
Écritures non latines. Les performances dépendent fortement du modèle. GPT-5 et Gemini obtiennent de bons résultats sur les principales écritures, notamment l'arabe, le devanagari et les caractères chinois — en particulier lorsque le modèle a été entraîné sur ces systèmes d'écriture. Des modèles plus petits ou spécialisés peuvent bien fonctionner sur l'écriture cursive latine mais se dégradent nettement sur d'autres systèmes d'écriture. Si vos documents contiennent du texte manuscrit dans plusieurs écritures, testez le modèle spécifique sur vos documents avant de vous engager — la reconnaissance d'écriture manuscrite multilingue n'est pas uniformément résolue.
Documents historiques au papier dégradé. Les documents présentant des transparences (encre du verso visible à travers le papier), des piqûres (taches d'âge), des dégâts des eaux ou des bords déchirés introduisent des artefacts visuels qui perturbent la reconnaissance au niveau des caractères comme au niveau global. Le benchmark AIMultiple a constaté que même les modèles les plus performants perdent 10 à 15 points de pourcentage lorsque l'état du document se dégrade. Une numérisation de qualité archivistique peut nécessiter des outils spécialisés et des pipelines de prétraitement distincts que les outils d'extraction IA à usage général n'incluent pas.
Cas d'usage réels où l'extraction d'écriture manuscrite fait la différence
La technologie n'a d'intérêt que lorsqu'elle transforme un flux de travail réel. Voici les scénarios où le passage de la saisie manuelle à l'extraction d'écriture manuscrite par IA génère des gains de temps mesurables.
Feuilles de temps manuscrites. Les équipes de construction, les techniciens de terrain et les travailleurs en équipe remplissent des feuilles de temps papier — noms, dates, heures, codes de tâche — souvent dans une écriture serrée et désordonnée en fin de quart de travail. Un gestionnaire de paie qui traite 80 feuilles de temps par semaine consacre environ 3 minutes par feuille à la saisie manuelle des données : lire chaque champ, le saisir dans le système de paie, vérifier le total. Cela représente 4 heures par semaine — une matinée entière — passées à ressaisir de l'écriture manuscrite. Avec l'extraction par IA, les mêmes 80 feuilles de temps se téléversent en un seul lot, s'extraient dans une seule feuille de calcul avec des colonnes nommées « Employee Name », « Date », « Hours » et « Job Code », et s'exportent en moins d'une minute. Le rôle du gestionnaire passe de la saisie de données à la gestion des exceptions : vérifier ponctuellement les 5 à 10 entrées où l'écriture était réellement ambiguë.
En vertu de la section 11(c) de la FLSA, les employeurs doivent conserver des registres de paie précis, y compris les heures travaillées et les salaires versés. Les erreurs des feuilles de temps manuscrites qui se propagent dans la paie créent un risque de non-conformité — et les corriger a posteriori coûte plus cher que de les détecter lors de la saisie.
Formulaires d'inspection sur le terrain. Les inspecteurs de sécurité, les auditeurs qualité et les superviseurs de site remplissent des listes de contrôle papier sur le terrain — souvent sur une planchette à pince, sous la pluie, avec un stylo à court d'encre. Chaque formulaire contient des cases à cocher (équipement conforme/non conforme), des relevés numériques manuscrits (pression, température, voltage) et des notes en texte libre (observations, actions correctives). Le traitement manuel de 50 formulaires d'inspection prend une journée entière de travail. Avec la saisie de données par IA sans code, le même lot s'extrait en quelques minutes — l'état des cases à cocher, les relevés numériques et les notes narratives se répartissent chacun dans leurs propres colonnes de la feuille de calcul. Le rapport de conformité qui prenait le vendredi après-midi est prêt vendredi matin.
Formulaires d'admission des patients. Une clinique médicale traite 60 nouveaux formulaires d'admission par jour — antécédents médicaux, médicaments actuels, listes d'allergies, coordonnées d'assurance — tous remplis à la main par les patients dans la salle d'attente. Le personnel d'accueil saisit manuellement chaque formulaire dans le système EHR, un processus qui prend 5 à 7 minutes par formulaire et introduit des erreurs de transcription lorsque le personnel hésite entre une écriture illisible et les bases de données de terminologie médicale. L'extraction par IA lit les champs manuscrits et les fait correspondre aux bonnes catégories de données EHR — « Medication Name », « Dosage », « Frequency » — tout en signalant toute valeur à faible confiance pour vérification humaine avant son intégration au dossier patient.
Registres manuscrits et carnets à souches. Les petites entreprises — food trucks, vendeurs de marché, travailleurs indépendants — tiennent souvent des registres manuscrits. Le carnet de reçus autocopiant d'un vendeur contient des centaines d'entrées : dates, descriptions d'articles, montants, noms de clients, le tout au stylo. À la saison des impôts, il faut numériser ces données. L'OCR traditionnel produit des résultats inexploitables sur du papier autocopiant — le texte pâle teinté de bleu perturbe la détection par contraste. Les modèles de vision par IA, entraînés sur des images réelles variées, lisent les entrées en comprenant la page comme une scène — le texte pâle, la texture du papier, la disposition en rangées et colonnes — plutôt qu'en seuillant les pixels en noir et blanc.
Confirmations de livraison. Les entreprises de logistique reçoivent des confirmations de livraison signées — des détails d'expédition imprimés avec les noms des destinataires écrits à la main, les horodatages et les notes sur l'état. Le nom du destinataire écrit à la main constitue la preuve légale de livraison. L'extraction par IA récupère le nom du destinataire et l'horodatage du formulaire, alimentant la base de données des confirmations de livraison sans ressaisie manuelle.
Fiches de recettes manuscrites et documents personnels. Tous les documents manuscrits ne sont pas des documents professionnels. Une fiche de recette familiale mélange des notes en écriture cursive, des quantités fractionnaires (« 1½ tasse ») et des abréviations dans une mise en page qu'aucun concepteur de formulaire n'a planifiée. La même extraction sémantique qui lit une note de champ lit la fiche de recette manuscrite sur une photo, renvoyant les ingrédients, les quantités et les instructions sous forme de colonnes de feuille de calcul plutôt qu'une page retapée à la main.
Attentes en matière de précision : ce que 85-95 % d'écriture manuscrite signifie en production
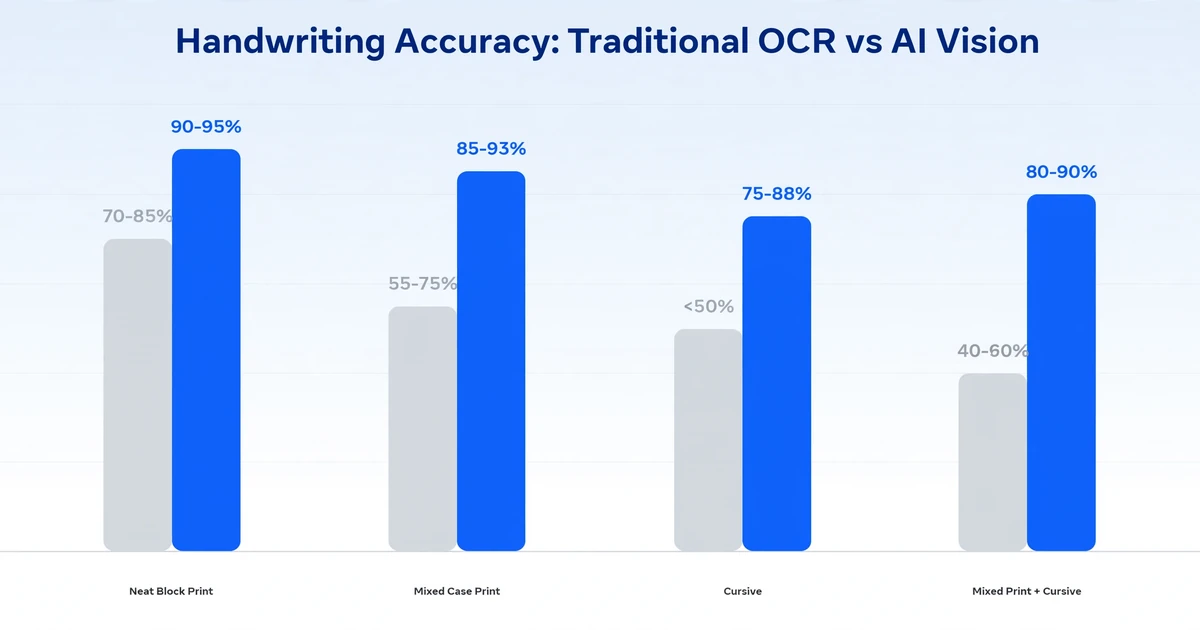
La clause de non-responsabilité standard de l'industrie de l'IA — « jusqu'à 99 % sur le texte imprimé » — crée une attente qui ne s'applique pas à l'écriture manuscrite. La précision de l'écriture manuscrite est un chiffre fondamentalement différent sur une échelle fondamentalement différente. Voici ce que vous devriez réellement attendre.
| Style d'écriture manuscrite | OCR traditionnel | Modèle de vision par IA | Résultat pratique |
|---|---|---|---|
| Écriture en capitales bien formées | 70-85 % | 90-95 % | Vérification ponctuelle de 1 champ sur 10 |
| Écriture en minuscules et majuscules | 55-75 % | 85-93 % | Vérification ponctuelle de 1 champ sur 7 |
| Écriture cursive | Moins de 50 % | 75-88 % | Vérification ponctuelle de 1 champ sur 4 |
| Mélange d'écriture et de cursive | 40-60 % | 80-90 % | Vérification ponctuelle de 1 champ sur 5 |
| Dégradé / faible contraste | Moins de 30 % | 65-80 % | Extraction au mieux ; examen humain attendu |
Sources : benchmark d’écriture cursive AIMultiple (2026) ; étude IJCSTEE sur la précision OCR traditionnel vs IA (2025) ; tests comparatifs réels sur les services OCR cloud. Tous les chiffres reflètent la précision au niveau du champ — c’est-à-dire si la valeur extraite dans le tableur correspond à l’original manuscrit — et non la précision au niveau du caractère.
Le chiffre le plus important de ce tableau n’est pas un taux de précision en particulier. C’est le rapport entre le temps d’extraction par IA et le temps de vérification manuelle. Sur 100 feuilles de temps manuscrites en écriture soignée en capitales, l’extraction par IA prend moins de 30 secondes et produit environ 5 à 10 champs à vérifier — soit une relecture humaine de 3 minutes. La saisie manuelle sur ces mêmes 100 feuilles : environ 300 minutes. La précision de l’IA n’a pas besoin d’être de 100 % pour offrir une réduction de temps de 90 % ou plus — il suffit qu’elle soit assez élevée pour que la vérification soit plus rapide qu’une ressaisie complète.
C’est ce qui rend la question de la précision concrète plutôt qu’académique. La précision de la saisie de données par IA ne consiste pas à atteindre un chiffre marketing. Il s’agit de franchir un seuil où le coût de la vérification des résultats de l’IA devient inférieur au coût de la saisie manuelle. Pour le texte imprimé, ce seuil a été franchi il y a des années. Pour une écriture soignée en capitales, il a été franchi avec les modèles de vision de niveau GPT-4. Pour une cursive difficile, il est franchi aujourd’hui — mais l’étape de vérification reste incontournable.
FAQ
L’OCR par IA peut-il lire n’importe quel style d’écriture manuscrite ?
Pas n’importe quel style — mais la plupart des styles courants. L’écriture soignée en capitales et l’écriture en minuscules mixtes atteignent 85 à 95 % de précision au niveau du champ sur les modèles de vision par IA actuels. La cursive atteint 75 à 88 %. Une écriture très stylisée, chevauchante ou extrêmement brouillonne peut tomber sous les 70 %. Si vous ne pouvez pas la lire vous-même avec confiance à partir d’un scan, l’IA ne le pourra probablement pas non plus. L’approche pratique : téléversez tout par lots, laissez l’IA extraire ce qu’elle peut, et ne vérifiez manuellement que les entrées à faible confiance.
L'IA gère-t-elle les cases à cocher et les éléments de formulaire, ou uniquement le texte ?
Les modèles de vision par IA gèrent les cases à cocher, les boutons radio, les sélections encerclées et autres éléments de formulaire en lisant l'intention spatiale plutôt que les formes des caractères. Une coche, une croix, un remplissage ou un cercle à côté d'une option est enregistré comme « sélectionné ». Cela fonctionne mieux lorsque la mise en page du formulaire est claire — des zones de réponse distinctes avec une séparation spatiale visible des options voisines. Des cases à cocher très serrées sur des formulaires denses peuvent encore produire une ambiguïté nécessitant une vérification humaine.
Quelle est la différence entre la reconnaissance d'écriture manuscrite par IA et l'ICR traditionnel ?
L'ICR traditionnel (reconnaissance intelligente de caractères) étend l'OCR avec un apprentissage automatique entraîné sur des ensembles de données d'écriture manuscrite, mais fonctionne toujours sur le modèle de segmentation des caractères — isolant les lettres individuelles et les classifiant. Les modèles de vision par IA ignorent entièrement la segmentation, lisant les formes de mots entières comme des motifs visuels et utilisant le contexte linguistique pour résoudre les caractères ambigus. La différence pratique : l'ICR fonctionne sur des lettres moulées soignées mais se dégrade sur l'écriture cursive ; la vision par IA fonctionne sur les deux, avec une baisse de précision plus faible entre les deux.
Puis-je traiter des documents manuscrits et imprimés dans le même lot ?
Oui. Les modèles de vision par IA lisent chaque document comme une scène — ils n'ont pas besoin de savoir à l'avance si le texte est imprimé ou manuscrit. Le même lot peut contenir des factures dactylographiées, des feuilles de temps manuscrites et des formulaires d'inspection à format mixte. Le modèle adapte sa stratégie de lecture par document, et non par lot. C'est une distinction clé par rapport aux pipelines OCR traditionnels, qui nécessitent souvent une configuration séparée pour les entrées imprimées vs manuscrites.
L'extraction d'écriture manuscrite est-elle disponible dans des langues autres que l'anglais ?
Cela dépend du modèle. GPT-5 et Gemini fonctionnent bien sur les principales langues à alphabet latin (français, espagnol, allemand, portugais), tant en version imprimée que manuscrite. Les écritures non latines (arabe, devanagari, chinois, japonais, coréen) dépendent davantage du modèle — testez sur vos documents spécifiques avant de vous engager. La variation du style d'écriture dans les systèmes d'écriture à base de caractères (chinois, japonais) introduit des défis de reconnaissance différents de l'écriture cursive latine, et les attentes en matière de précision doivent être calibrées en conséquence.
Testez l'extraction sur vos propres documents avant de construire un flux de travail autour d'elle. L'écart entre un échantillon de démonstration soigné et l'écriture manuscrite réelle de votre équipe est là où se trouve le véritable chiffre de précision.