KI-OCR liest Handschrift
Wo herkömmliche OCR blind ist
Eine saubere getippte Rechnung bei 300 DPI, verarbeitet mit Tesseract oder Google Cloud Vision, kommt mit 99 % Zeichengenauigkeit zurück. Ändern Sie nur das Medium – dieselbe Rechnung, von Hand ausgefüllt – und die Genauigkeit fällt unter 50 %. Die Lücke ist kein Kalibrierungsproblem. Sie ist architektonischer Natur: Herkömmliche OCR wurde entwickelt, um statische Zeichenformen mit bekannten Vorlagen abzugleichen. Handschrift hat keine Vorlagen. Derselbe Buchstabe, zweimal von derselben Person geschrieben, erzeugt zwei verschiedene Formen. Ein KI-Vision-Modell geht das Problem aus der völlig anderen Richtung an – indem es Wörter als visuelle Muster liest und den umgebenden Kontext nutzt, um zu unterscheiden, was sonst mehrdeutige Striche wären.
Die wichtigsten Erkenntnisse
- Eine getippte Rechnung bei 300 DPI erreicht mit herkömmlicher OCR 99 % Zeichengenauigkeit, während dieselbe von Hand ausgefüllte Rechnung unter 50 % fällt – nicht weil der Scan schlechter wurde, sondern weil das Tool dafür gebaut wurde, Zeichen zu trennen, die Schreibschrift bewusst verbindet.
- 30 bis 50 von 100 Wörtern kommen bei Cloud-OCR auf Schreibschrift-Dokumenten falsch zurück, und kein noch so starkes Anpassen des Kontrasts behebt das – der Fehler liegt in der Zeichensegmentierungs-Architektur, nicht in der Bildverarbeitung.
- Sie lesen Handschrift, indem Sie ganze Wörter sehen, nicht indem Sie einzelne Buchstaben zusammensetzen – KI-Vision-Modelle machen das jetzt genauso, und auf ImageToTable.ai steigt die Feldgenauigkeit dadurch auf 85–95 %, wo die Prüfung von 100 handschriftlichen Stundenzetteln 3 Minuten statt 300 dauert.
Warum die zeichenweise Erkennung bei Handschrift versagt
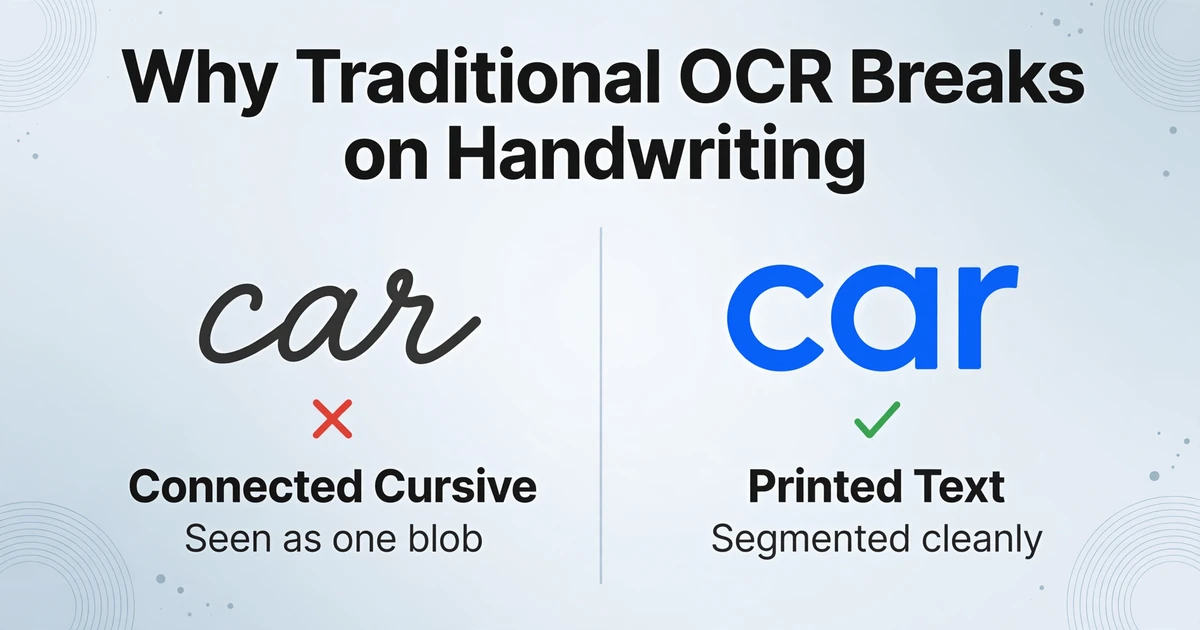
Herkömmliche OCR arbeitet nach einem Segmentierungs-zuerst-Modell. Die Engine scannt ein Bild, isoliert jedes Zeichen, indem sie Leerraum-Grenzen erkennt, und gleicht die isolierte Form mit einer Bibliothek bekannter Glyphen ab. Diese Pipeline funktioniert, wenn Zeichen vorhersehbar sind – gedrucktes Arial „A" lässt sich sauber auf gespeicherte Arial-„A"-Vorlagen abbilden. Sie bricht zusammen, wenn Zeichen sich weigern, in vorhersehbare Boxen zu passen.
Drei strukturelle Probleme machen Handschrift für herkömmliche OCR zu einem Segmentierungs-Albtraum. Verbundene Zeichen – Schreibschrift verbindet benachbarte Buchstaben mit Ligaturen, wodurch der Abstand zwischen „a" und „r" in „car" für einen Grenzerkennungsalgorithmus unmöglich zu finden ist. Die Engine sieht eine durchgehende Glyphe, wo ein Mensch vier Buchstaben sieht. Variable Strichstärken – ein Kugelschreiber, der bei Abwärtsstrichen stark und bei Aufwärtsstrichen leicht aufgedrückt wird, erzeugt Linienstärke-Schwankungen, die einzelne Zeichen in getrennte erkannte Segmente zerlegen. Eine „5" wird zu einem Klecks plus einem separaten Strich. Inkonsistente Grundlinien – Menschen schreiben schräg, driften auf einer Seite nach oben und variieren die Buchstabenhöhen innerhalb desselben Worts. Der Zeilenerkennungsschritt, der bei gesetztem Text funktioniert, versagt, wenn „apple" in einem 15-Grad-Winkel geschrieben wird, wobei das „p" unter die Grundlinie taucht und das „l" darüber hinausragt.
Die Folge davon ist eine Kaskade. Eine Studie aus dem Jahr 2025, veröffentlicht im International Journal of Computer Scientific Technology & Electronics Engineering, ergab, dass die Genauigkeit herkömmlicher OCR bei handschriftlichen Dokumenten von 92 % bei sauberem handgeschriebenem Druckschrifttext auf 55 % bei mäßiger Beeinträchtigung und 30 % unter schweren Bedingungen sinkt – Bedingungen, die bei der Verarbeitung von gedrucktem Text kaum als Rauschen auffallen würden. In der Zwischenzeit stellte AIMultiples 2026er Schreibschrift-Benchmark, der 100 Stichproben über 14 Modelle testete, fest, dass herkömmliche Cloud-OCR-Dienste wie Google Cloud Vision und Amazon Textract bei Schreibschrift zwischen 50 % und 70 % erreichen – das bedeutet, dass 30 bis 50 von 100 Wörtern falsch sind.
Die Reddit-Community für Dateneingabe dokumentiert diese Lücke seit Jahren. Eine Diskussion von 2024 auf r/Automate über das Extrahieren von Daten aus handschriftlichen Rechnungen formulierte das Problem treffend: „Man muss nicht nur handschriftliche Daten nehmen, sondern unstrukturierte handschriftliche Daten, und sie verständlich machen." Die Überprüfung von Handschrift-OCR-Tools durch die r/computervision-Community aus dem Jahr 2025 stellte unverblümt fest, dass die „Handschriftgenauigkeit (~65–85 %) neuer KI-Modelle immer noch hinter spezialisierten Lösungen für geschäftskritische Zwecke zurückbleibt." Das sind Praktiker, keine Vermarkter. Ihre Zahlen zählen.
Wie KI-Vision-Modelle Handschrift als visuelle Muster lesen, nicht als Zeichenfolgen
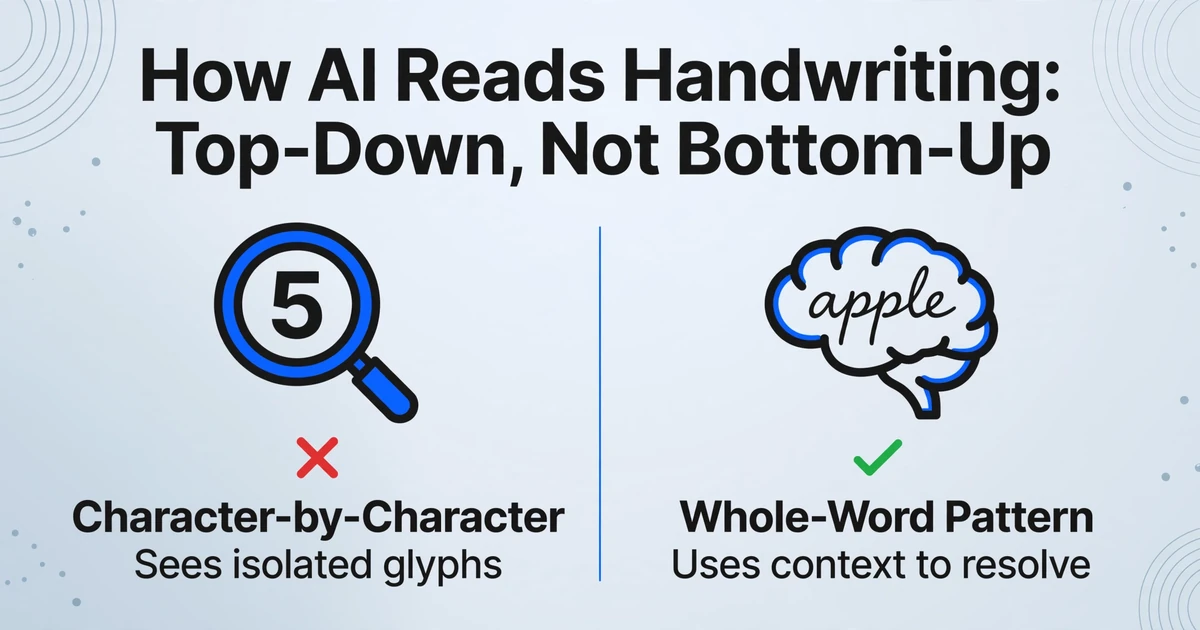
KI-Vision-Modelle – genauer gesagt Vision-Sprachmodelle wie GPT-5, Gemini und Claude – führen überhaupt keine Zeichensegmentierung durch. Sie verarbeiten das Bild ganzheitlich, sehen ganze Wortformen als einheitliche visuelle Muster und interpretieren diese Muster mit demselben Sprachmodell, das den Satz versteht, in dem das Wort vorkommt. Das ist die entscheidende Umkehrung: Statt Wörter aus Zeichen aufzubauen (Bottom-up), erkennen sie Wörter als visuelle Ganzheiten und nutzen das verstandene Wort, um einzelne Buchstabenformen zu disambiguieren (Top-down).
Der praktische Unterschied zeigt sich am einfachsten an etwas Alltäglichem – einem Namensfeld auf einem Formular. Stellen Sie sich einen handschriftlichen Eintrag vor, bei dem der Stift des Schreibers in der Mitte von „Sm_th" leicht abhebt und ein blasses oder fehlendes Zeichen zwischen „m" und „t" hinterlässt. Herkömmliche OCR, die zeichenweise arbeitet, liefert „Sm" plus ein unerkanntes Glyph plus „th". Der Fehler potenziert sich – der vollständige Name könnte nachgelagert unerkennbar sein. Ein KI-Vision-Modell sieht die Wortform „Sm_th" und den umgebenden Kontext – dies ist das Feld „Name" auf einem Formular, der vollständige Name lautet „John Smith". Das Sprachmodell füllt die Lücke aus dem Kontext, genau wie Sie es tun würden, wenn Sie es mit eigenen Augen sähen. Derselbe Mechanismus unterscheidet ein handschriftliches „1" von einem Kleinbuchstaben „l", eine „0" von einem „O" und eine handschriftliche „4", die wie eine „9" aussieht – indem er fragt: Was ergibt hier Sinn?
Deshalb übertreffen moderne KI-Vision-Modelle die Herkömmliche OCR bei Handschrift deutlich. AIMultiple's Benchmark platzierte GPT-5 und Gemini 3 Pro Preview an der Spitze bei der Schreibschrift-Erkennung – nicht weil sie bessere Zeichenerkennung haben, sondern weil sie das Dokument so lesen, wie es ein Mensch tut: indem sie verstehen, was der Text bedeutet, nicht nur, wie seine Pixel aussehen. Derselbe Benchmark ermittelte für Google Cloud Vision etwa 63 % bei Schreibschrift. Die Lücke zwischen 95 % und 63 % ist die Lücke zwischen „mit Stichproben nutzbar" und „erfordert vollständiges manuelles Abtippen".
Dieser semantische Ansatz macht KI-gestützte Datenerfassung von Natur aus ohne Vorlage. Sie geben die Spaltennamen ein, die extrahiert werden sollen – „Mitarbeitername", „Arbeitsstunden", „Datum" – und die KI lokalisiert die handschriftlichen Werte, die jedem Feld entsprechen, überall auf der Seite, indem sie deren Bedeutung versteht. Keine Pixelkoordinaten. Keine formularspezifischen Vorlagen. Kein Neulernen, wenn sich die Handschrift einer Person ändert. Das ist der Mechanismus, den wir Benutzerdefinierte Spaltenextraktion nennen: Sie definieren das Ausgabeschema, indem Sie die gewünschten Spalten benennen, und die KI ordnet den Inhalt des Dokuments Ihrem Schema zu, unabhängig davon, wo sich jeder handschriftliche Wert auf der Seite befindet.
Dateien werden sicher verarbeitet und nicht gespeichert.
Gemischte Druckschrift und Handschrift: Das häufigste Dokumentformat, über das niemand spricht
Die meisten realen handschriftlichen Dokumente sind nicht rein handschriftlich. Es sind Formulare – eine gedruckte Vorlage mit Beschriftungen, Feldern und Anweisungen, die mit einem Stift ausgefüllt werden. Die Beschriftung „Patientenname:" ist in Helvetica gedruckt. Der Wert „James Peterson" ist in Kugelschreiber-Schreibschrift geschrieben. Eine herkömmliche OCR-Engine, optimiert für Druckschrift, liest die Beschriftung perfekt und scheitert am Wert – und erzeugt ein Dokument, bei dem 80 % des Textes korrekt sind und die 20 %, die Sie tatsächlich benötigen, fehlen.
Dieses Format aus Druckschrift plus Handschrift ist der Bereich, in dem KI-Vision-Modelle ihren stärksten Vorteil gegenüber der Konkurrenz zeigen. Das Modell wechselt nicht zwischen einem „Druckmodus" und einem „Handschriftmodus". Es liest die Seite als eine einzige visuelle Szene – erkennt, dass „Patientenname" eine Feldbeschriftung ist (gedruckt, sauber) und das Gekritzel darunter der Feldwert ist (handschriftlich, unordentlich) – und ordnet beides der korrekten Ausgabespalte zu. Der Kontext der gedruckten Beschriftung unterstützt die Handschrifterkennung aktiv: Wenn die Beschriftung „Telefonnummer" lautet, erwartet das Modell eine Ziffernfolge im Wertfeld, was das Erkennungsproblem eingrenzt. Wenn die Beschriftung „Anmerkungen" lautet, erwartet das Modell ganze Sätze und passt sich entsprechend an.
Dieses Format kommt überall vor. Medizinische Aufnahmeformulare – gedruckte demografische Fragen, handschriftliche Antworten. Feldinspektionsberichte – gedruckte Sicherheitschecklistenpunkte, handschriftliche Beobachtungen in der Notizspalte. Lieferbestätigungen – gedruckte Sendungsnummern, handschriftliche Unterschriften und Zeitstempel des Empfängers. Angebote von Lieferanten – gedruckte Positionszeilen, handschriftliche Mengenanpassungen. In all diesen Fällen ist der Engpass im Arbeitsablauf nicht das „Lesen des Dokuments". Es ist das „Lesen der handschriftlichen Teile, die die verwertbaren Daten enthalten". Herkömmliche OCR liefert Ihnen die Beschriftungstexte kostenlos und verlangt viel für die Werte. KI-Vision liest beides in einem einzigen Durchgang.
Das Konzept, Beschriftungen und Werte im Kontext zu lesen, ist nicht nur eine Lösung für Handschrift – es ist der grundlegende Unterschied zwischen KI-OCR und herkömmlicher OCR-Genauigkeit. Herkömmliche OCR sieht „Datum: 15.03.2026" als Zeichenkette. KI-Extraktion sieht eine Feldbeschriftung („Datum") mit einem semantischen Typ (Kalenderdatum) und platziert den Wert in der richtigen Tabellenspalte, selbst wenn fünf andere Daten auf derselben Seite erscheinen – weil sie versteht, welches Datum zu welcher Beschriftung gehört.
Kontrollkästchen, Häkchen und Kreise: Absicht erkennen, nicht Formen
Ein angekreuztes Kästchen auf einem Papierformular kann viele Formen annehmen: eine ausgefüllte Fläche, eine diagonale Linie, ein X, ein Häkchen, eine eingekreiste Antwort, ein hingekritzeltes Durchstreichen der falschen Option, eine doppelte Unterstreichung der richtigen. Für eine herkömmliche OCR-Engine ist nichts davon Text – es ist Bildrauschen. Die Engine ignoriert es entweder oder, schlimmer noch, liest die Markierung als Zeichen: Ein Häkchen wird zu einem „V", ein diagonaler Strich zu „/", eine eingekreiste Option wird als „O" vor dem Antworttext gelesen.
Das Problem verschärft sich bei strukturierten Formularen. Eine Sicherheitsinspektions-Checkliste mit 20 Ja/Nein-Kontrollkästchen enthält 20 binäre Entscheidungen, die über Compliance, Wartungsplanung oder Haftung bestimmen. Wenn die Engine 5 von 20 falsch liest, ist die Automatisierung schlimmer als nutzlos – sie produziert stillschweigend falsche Daten, die korrekt aussehen. Ein mit „Sicher" markiertes Feld wird zu „Unsicher", weil die Engine ein Häkchen ✓ als Zeichen „V" neben der falschen Option interpretiert hat.
KI-Vision-Modelle handhaben Kontrollkästchen anders, weil sie auf räumlichen Beziehungen statt auf Zeichenerkennung basieren. Das Modell identifiziert den Fragetext („Feuerlöscher überprüft?") und die Antwortoptionen („Ja / Nein") und bestimmt dann, welcher Antwortbereich eine Markierung enthält – jede Markierung. Ein Häkchen, ein Kreuz, ein ausgefüllter Kreis, eine gekritzelte Linie: Alles wird als „diese Option ist ausgewählt" registriert. Das Modell muss die Art der Markierung nicht klassifizieren. Es klassifiziert die Auswahlabsicht – die räumliche Verbindung zwischen der Markierung und der Option, die sie modifiziert.
Das Document-AI-Team von Google hat diese Herausforderung direkt in ihren Entwicklerforen dokumentiert: Praktiker berichten, dass die Kontrollkästchen-Erkennung selbst bei größeren Kästchengrößen fehlschlägt, wenn Formulare durch Print-Fill-Scan-Pipelines laufen. Die Empfehlung – 12-15 mm Kästchengröße – gilt nur, wenn Sie das Formulardesign kontrollieren. Für die tausenden bestehenden Formulare mit kleineren Kästchen ist die Antwort ein KI-Modell, das räumliche Absicht statt Formgeometrie liest.
Was KI immer noch nicht zuverlässig lesen kann
Ehrlichkeit über Grenzen macht das Argument für KI-Handschrifterkennung glaubwürdig. Hier ist, was weiterhin scheitert.
Stark überlappende Schrift. Wenn eine Handschriftzeile direkt auf eine andere geschrieben wurde – üblich in Hauptbüchern, wo Korrekturen durch Überschreiben des ursprünglichen Eintrags vorgenommen wurden – haben sowohl herkömmliche OCR als auch KI-Vision-Modelle Schwierigkeiten. Das Modell sieht einen visuellen Fleck, wo zwei Bedeutungsebenen existieren. Ein Mensch mit Kontext zur Dokumenthistorie könnte sie vielleicht trennen. Aktuelle KI kann das nicht.
Extrem stilisierte Unterschriften. Unterschriften dienen als Identitätsmerkmale, nicht als lesbarer Text. Sie sind absichtlich einzigartige Muster aus Schnörkeln, unleserlichen Schleifen und persönlichen Zeichen. KI-Modelle erkennen, dass eine Unterschrift vorhanden ist – sie können den Unterschriftenbereich auf einem Dokument identifizieren – aber sie extrahieren den Namen des Unterzeichners nicht aus der Form der Unterschrift selbst. Der Name muss an anderer Stelle im Dokument in gedruckter oder handschriftlicher Form erscheinen.
Blasser Bleistift auf dunklem Hintergrund. Bleistift auf Kopierpapier, bei geringem Kontrast gescannt, erzeugt Textstriche, die sich kaum von der Papierstruktur unterscheiden lassen. Eine akademische Übersicht von 2025 über Handschrifterkennungstechniken stellte fest, dass „Rauschrobustheit" weiterhin eines der zentralen ungelösten Probleme bleibt – „Forscher sollten weiterhin Methoden untersuchen, die die Widerstandsfähigkeit von OCR-Systemen erhöhen" gegenüber suboptimalen realen Bedingungen. Dies gilt sowohl für traditionelle als auch für KI-basierte Systeme.
Nicht-lateinische Schriften. Die Leistung hängt stark vom Modell ab. GPT-5 und Gemini funktionieren gut bei wichtigen Schriften, einschließlich Arabisch, Devanagari und chinesischen Schriftzeichen – insbesondere wenn das Modell auf diesen Schriftsystemen trainiert wurde. Kleinere oder spezialisierte Modelle funktionieren möglicherweise gut bei lateinischer Schreibschrift, verschlechtern sich aber stark bei anderen Schriftsystemen. Wenn Ihre Dokumente handschriftlichen Text in mehreren Schriften enthalten, testen Sie das jeweilige Modell vor der Entscheidung an Ihren Dokumenten – schriftübergreifende Handschrifterkennung ist nicht einheitlich gelöst.
Historische Dokumente mit beschädigtem Papier. Dokumente mit Durchscheinen (Tinte von der Rückseite, die durch das Papier sichtbar ist), Stockflecken, Wasserschäden oder eingerissenen Kanten erzeugen visuelle Artefakte, die sowohl die zeichenbasierte als auch die ganzheitliche Erkennung verwirren. Der AIMultiple-Benchmark ergab, dass selbst leistungsstärkste Modelle 10–15 Prozentpunkte verlieren, wenn sich der Dokumentzustand verschlechtert. Archivqualitäts-Digitalisierung kann Spezialwerkzeuge und separate Vorverarbeitungspipelines erfordern, die allgemeine KI-Extraktionstools nicht enthalten.
Reale Arbeitsabläufe, bei denen Handschrift-Extraktion wichtig ist
Die Technologie ist nur dort relevant, wo sie einen realen Arbeitsablauf verändert. Hier sind die Szenarien, in denen der Wechsel von manueller Eingabe zu KI-gestützter Handschrift-Extraktion messbare Zeitersparnisse bringt.
Handschriftliche Stundenzettel. Bauarbeiter, Außendiensttechniker und Schichtarbeiter füllen Papier-Stundenzettel aus — Namen, Daten, Stunden, Auftragscodes — oft in enger, unleserlicher Handschrift am Ende einer Schicht. Ein Lohnbuchhalter, der 80 Stundenzettel pro Woche verarbeitet, verbringt etwa 3 Minuten pro Zettel mit manueller Dateneingabe: jedes Feld lesen, in das Lohnsystem tippen, die Summe prüfen. Das sind 4 Stunden pro Woche — ein ganzer Vormittag — die mit dem Abtippen von Handschrift verbracht werden. Mit KI-Extraktion werden dieselben 80 Stundenzettel als Batch hochgeladen, in eine einzige Tabelle mit Spalten wie „Name des Mitarbeiters", „Datum", „Stunden", „Auftragscode" extrahiert und in unter einer Minute exportiert. Die Rolle des Buchhalters verschiebt sich von Dateneingabe zur Ausnahmebehandlung: Stichprobenprüfung der 5-10 Einträge, bei denen die Handschrift wirklich mehrdeutig war.
Gemäß FLSA Section 11(c) müssen Arbeitgeber genaue Lohnunterlagen einschließlich geleisteter Stunden und gezahlter Löhne aufbewahren. Fehler in handschriftlichen Stundenzetteln, die in die Lohnabrechnung übernommen werden, schaffen Compliance-Risiken — und sie im Nachhinein zu korrigieren ist teurer, als sie während der Eingabe zu erkennen.
Formulare für Feldinspektionen. Sicherheitsinspektoren, Qualitätsauditoren und Bauleiter füllen Papier-Checklisten im Feld aus — oft auf einem Klemmbrett, im Regen, mit einem Stift, dessen Tinte zur Neige geht. Jedes Formular enthält Kontrollkästchen (Geräte bestanden/nicht bestanden), handschriftliche Zahlenwerte (Druck, Temperatur, Spannung) und Freitextnotizen (Beobachtungen, Korrekturmaßnahmen). Die manuelle Verarbeitung von 50 Inspektionsformularen dauert einen ganzen Arbeitstag. Mit No-Code-KI-Dateneingabe wird derselbe Batch in Minuten extrahiert — Kontrollkästchen-Status, Zahlenwerte und narrative Notizen fließen jeweils in eigene Tabellenspalten. Der Compliance-Bericht, der früher den Freitagnachmittag in Anspruch nahm, ist am Freitagmorgen fertig.
Patientenaufnahmeformulare. Eine Arztpraxis verarbeitet 60 neue Patientenaufnahmeformulare pro Tag — Krankengeschichte, aktuelle Medikamente, Allergielisten, Versicherungsdetails — alle von Patienten im Wartezimmer handschriftlich ausgefüllt. Das Empfangspersonal gibt jedes Formular manuell in das EHR-System ein, ein Prozess, der 5-7 Minuten pro Formular dauert und Übertragungsfehler verursacht, während das Personal zwischen unleserlicher Handschrift und medizinischen Terminologiedatenbanken wechselt. KI-Extraktion liest die handschriftlichen Felder und ordnet sie den richtigen EHR-Datenkategorien zu — „Medikamentenname", „Dosierung", „Häufigkeit" — und kennzeichnet dabei jeden Wert mit geringer Konfidenz zur menschlichen Überprüfung, bevor er in die Patientenakte gelangt.
Handschriftliche Hauptbücher und Quittungsbücher. Kleine Unternehmen — Food Trucks, Marktstände, freie Auftragnehmer — führen oft handschriftliche Hauptbücher. Das Durchschreibequittungsbuch eines Händlers enthält Hunderte von Einträgen: Daten, Artikelbeschreibungen, Beträge, Kundennamen, alles mit Stift. Zur Steuerzeit müssen diese digitalisiert werden. Herkömmliche OCR liefert bei Durchschreibepapier unbrauchbare Ergebnisse — der blasse, bläulich getönte Text verwirrt kontrastbasierte Erkennung. KI-Vision-Modelle, trainiert auf vielfältigen realen Bildern, lesen die Einträge, indem sie die Seite als Szene verstehen — den blassen Text, die Papierstruktur, das Layoutmuster von Zeilen und Spalten — statt Pixel in Schwarzweiß zu schwellen.
Zustellbestätigungen. Logistikunternehmen erhalten unterschriebene Zustellbestätigungen – gedruckte Sendungsdetails mit handschriftlich verfassten Empfängernamen, Zeitstempeln und Zustandsnotizen. Der handschriftliche Empfängername ist der rechtliche Nachweis der Zustellung. KI-Extraktion erfasst Empfängername und Zeitstempel aus dem Formular und befüllt die Datenbank der Zustellbestätigungen ohne manuelles Abtippen.
Handschriftliche Rezeptkarten und persönliche Aufzeichnungen. Nicht jedes handschriftliche Dokument ist Geschäftspapier. Eine Familienrezeptkarte mischt Schreibschriftnotizen, Bruchmengen („1½ Tassen") und Abkürzungen in einem Layout, das kein Formulardesigner geplant hat. Dieselbe semantische Extraktion, die eine Feldnotiz liest, liest auch die handschriftliche Rezeptkarte in einem Foto und gibt Zutaten, Mengen und Anweisungen als Tabellenspalten zurück, statt eine Seite von Hand abzutippen.
Genauigkeitserwartungen: Was 85-95 % Handschrift in der Praxis bedeutet
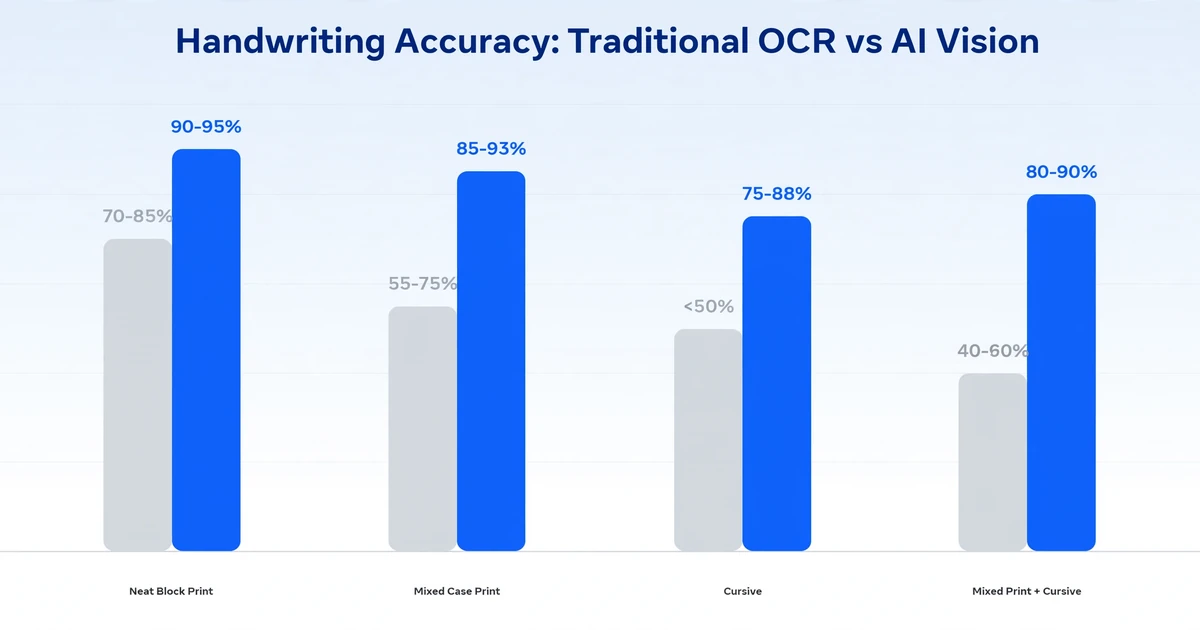
Der branchenübliche Genauigkeitshinweis der KI – „bis zu 99 % bei gedrucktem Text" – erzeugt eine Erwartung, die sich nicht auf Handschrift übertragen lässt. Die Handschriftgenauigkeit ist eine grundlegend andere Zahl auf einer grundlegend anderen Skala. Hier ist, was Sie tatsächlich erwarten sollten.
| Handschriftstil | Herkömmliche OCR | KI-Vision-Modell | Praktisches Ergebnis |
|---|---|---|---|
| Saubere Blockschrift (Großbuchstaben) | 70-85 % | 90-95 % | 1 von 10 Feldern stichprobenartig prüfen |
| Gemischte Groß-/Kleinschreibung | 55-75 % | 85-93 % | 1 von 7 Feldern stichprobenartig prüfen |
| Schreibschrift | Unter 50 % | 75-88 % | 1 von 4 Feldern stichprobenartig prüfen |
| Gemischte Druck- und Schreibschrift | 40-60 % | 80-90 % | 1 von 5 Feldern stichprobenartig prüfen |
| Beeinträchtigt / geringer Kontrast | Unter 30 % | 65-80 % | Best-Effort-Extraktion; menschliche Prüfung erwartet |
Quellen: AIMultiple-Kursivschrift-Benchmark (2026); IJCSTEE-Studie zu herkömmlicher vs. KI-OCR-Genauigkeit (2025); reale Benchmarks über Cloud-OCR-Dienste. Alle Zahlen beziehen sich auf die Feldgenauigkeit – ob der extrahierte Wert in der Tabelle mit dem handschriftlichen Original übereinstimmt – nicht auf die Zeichengenauigkeit.
Die wichtigste Zahl in dieser Tabelle ist keine einzelne Genauigkeitszahl. Es ist das Verhältnis zwischen KI-Extraktionszeit und manueller Überprüfungszeit. Bei 100 handschriftlichen Stundenzetteln mit sauberer Blockschrift benötigt die KI-Extraktion unter 30 Sekunden und erzeugt etwa 5-10 Felder, die überprüft werden müssen – eine 3-minütige menschliche Überprüfung. Manuelle Eingabe bei denselben 100 Blättern: etwa 300 Minuten. Die KI-Genauigkeit muss nicht 100 % betragen, um eine Zeitersparnis von 90 %+ zu erzielen – sie muss nur hoch genug sein, dass die Überprüfung schneller ist als das erneute Abtippen von Grund auf.
Das macht die Genauigkeitsdiskussion praktisch statt akademisch. Genauigkeit der KI-Dateneingabe dreht sich nicht darum, eine Marketingzahl zu erreichen. Es geht darum, eine Schwelle zu überschreiten, an der die Kosten für die Überprüfung der KI-Ausgabe unter die Kosten der manuellen Eingabe fallen. Bei gedrucktem Text wurde diese Schwelle vor Jahren überschritten. Bei sauberer Blockschrift wurde sie mit Vision-Modellen der GPT-4-Klasse überschritten. Bei unordentlicher Schreibschrift wird sie jetzt überschritten – aber der Überprüfungsschritt ist nicht verhandelbar.
FAQ
Kann KI-OCR jeden handschriftlichen Stil lesen?
Nicht jeden Stil – aber die meisten gängigen Stile. Saubere Blockschrift und gemischte Groß-/Kleinschreibung erreichen 85-95 % Feldgenauigkeit bei aktuellen KI-Vision-Modellen. Schreibschrift erreicht 75-88 %. Stark stilisierte, überlappende oder extrem unordentliche Handschrift kann unter 70 % fallen. Wenn Sie es selbst aus einem Scan nicht sicher lesen können, kann die KI es wahrscheinlich auch nicht. Der praktische Ansatz: Laden Sie alles in Batches hoch, lassen Sie die KI extrahieren, was sie kann, und überprüfen Sie nur die Einträge mit geringer Konfidenz manuell.
Übernimmt KI Kontrollkästchen und Formularelemente oder nur Text?
KI-Vision-Modelle verarbeiten Kontrollkästchen, Optionsfelder, eingekreiste Auswahlen und andere Formularmarkierungen, indem sie räumliche Absicht statt Zeichenformen lesen. Ein Häkchen, Kreuz, eine Füllung oder ein Kreis neben einer Option wird als „ausgewählt" registriert. Dies funktioniert am besten, wenn das Formularlayout klar ist – deutliche Antwortbereiche mit sichtbarer räumlicher Trennung von benachbarten Optionen. Eng gepackte Kontrollkästchen auf dichten Formularen können weiterhin Mehrdeutigkeiten erzeugen, die eine menschliche Überprüfung erfordern.
Was ist der Unterschied zwischen KI-Handschrifterkennung und herkömmlicher ICR?
Herkömmliche ICR (Intelligent Character Recognition) erweitert OCR um maschinelles Lernen, das auf Handschriftdatensätzen trainiert wurde, arbeitet aber weiterhin nach dem Zeichensegmentierungsmodell – es isoliert einzelne Buchstaben und klassifiziert sie. KI-Vision-Modelle überspringen die Segmentierung vollständig, lesen ganze Wortformen als visuelle Muster und nutzen Sprachkontext, um mehrdeutige Zeichen aufzulösen. Der praktische Unterschied: ICR funktioniert bei sauberen Druckbuchstaben, verschlechtert sich aber bei Schreibschrift; KI-Vision funktioniert bei beidem, mit einem geringeren Genauigkeitsabfall zwischen beiden.
Kann ich handschriftliche und gedruckte Dokumente im selben Batch verarbeiten?
Ja. KI-Vision-Modelle lesen jedes Dokument als Szene – sie müssen nicht im Voraus wissen, ob der Text gedruckt oder handschriftlich ist. Derselbe Batch kann getippte Rechnungen, handschriftliche Stundenzettel und Inspektionsformulare mit gemischtem Format enthalten. Das Modell passt seine Lesestrategie pro Dokument an, nicht pro Batch. Dies ist ein entscheidender Unterschied zu herkömmlichen OCR-Pipelines, die oft eine separate Konfiguration für gedruckte vs. handschriftliche Eingaben erfordern.
Ist die Handschriftextraktion in nicht-englischen Sprachen verfügbar?
Das hängt vom Modell ab. GPT-5 und Gemini funktionieren gut bei wichtigen lateinischen Alphabetsprachen (Französisch, Spanisch, Deutsch, Portugiesisch) sowohl in gedruckter als auch in handschriftlicher Form. Nicht-lateinische Schriften (Arabisch, Devanagari, Chinesisch, Japanisch, Koreanisch) sind stärker modellabhängig – testen Sie anhand Ihrer spezifischen Dokumente, bevor Sie sich festlegen. Unterschiede im Handschriftstil bei zeichenbasierten Schriftsystemen (Chinesisch, Japanisch) führen zu anderen Erkennungsherausforderungen als lateinische Schreibschrift, und die Genauigkeitserwartungen sollten entsprechend angepasst werden.
Testen Sie die Extraktion anhand Ihrer eigenen Dokumente, bevor Sie einen Workflow darauf aufbauen. Die Lücke zwischen einer sauberen Demo-Stichprobe und der tatsächlichen Handschrift Ihres Teams ist der Ort, an dem die tatsächliche Genauigkeitszahl liegt.