Wie KI Ihre Dokumente „liest“
Ein Leitfaden ohne Fachjargon (2026)
Wenn Sie eine Rechnung betrachten, lesen Sie nicht von links nach rechts, von oben nach unten, Zeichen für Zeichen. Sie werfen einen einzigen Blick darauf und wissen sofort, wo der Gesamtbetrag steht. Ihre Augen springen in die untere rechte Ecke, bevor Sie bewusst entschieden haben, dorthin zu schauen. In weniger als einer Sekunde hat Ihr Gehirn die gesamte Seite erfasst – Logo oben, Positionen in der Mitte, Zahlen unten – und Ihre Aufmerksamkeit auf das gelenkt, was wichtig ist. Das kann KI heute ebenfalls. Nicht, indem sie mit Regeln programmiert wird, wo sich Gesamtbeträge auf Rechnungen befinden, sondern indem sie lernt, Dokumente so zu sehen und zu verstehen wie Sie.
Die wichtigsten Erkenntnisse
- KI scannt Dokumente nicht Zeile für Zeile – sie erfasst die gesamte Seite auf einmal, so wie Ihre Augen den Gesamtbetrag auf einer Rechnung finden, bevor Sie bewusst dorthin geschaut haben.
- Der dreistufige Prozess – die ganze Seite SEHEN, verstehen, was „Rechnungsnr.“ bei einem Dutzend verschiedener Beschriftungsvarianten bedeutet, und den richtigen Wert in die richtige Spalte ABRUFEN – funktioniert, weil Bedeutung immer über Position siegt.
- Wenn Format und Layout keine Rolle mehr spielen, verschiebt sich die Frage von „Kann ich das automatisieren?“ zu „Aus welchen Dokumenten sollte ich Daten extrahieren?“
Der alte Weg: Computern beibringen, zu scannen, statt zu lesen
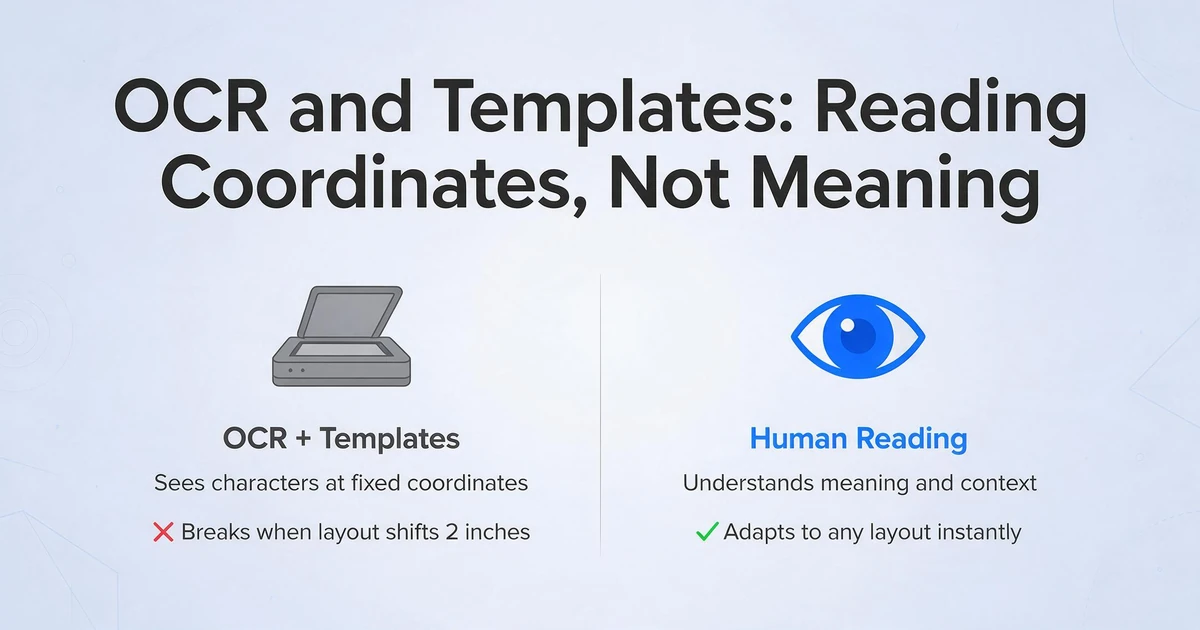
Jahrzehntelang bedeutete das Extrahieren von Daten aus einem Dokument die Verwendung von OCR – optischer Zeichenerkennung. OCR betrachtet ein Bild und wandelt die Formen von Buchstaben in Text um. Das klingt nach Lesen, ist es aber nicht. Es ist eher wie ein Fotokopierer, der Text statt eines weiteren Bildes ausgibt. Er sieht schwarze Markierungen auf weißem Hintergrund und sagt: „Diese Markierungen bilden den Buchstaben A, diese die Zahl 7.“ Er weiß nicht, was eine Rechnung ist. Er weiß nicht, dass $4.230,50 neben dem Wort „Gesamt“ der Betrag ist, den Sie schulden.
Um dieses Problem zu umgehen, verwendete die nächste Generation von Tools Vorlagen. Sie zeichneten ein Feld um das Rechnungsnummernfeld auf der Rechnung eines Anbieters. Dann ein weiteres Feld um das Datum. Dann ein weiteres um die Gesamtsumme. Jeder neue Anbieter mit einem anderen Layout benötigte einen neuen Satz von Feldern. Ein neuer Lieferant sendet Ihnen eine PDF-Datei, und das Tool liefert Unsinn – weil sich die Gesamtsumme zwei Zentimeter nach links verschoben hat. Das war kein Dokumentverständnis. Es war das Auswendiglernen von Dokumentkoordinaten.
Beide Ansätze teilen dieselbe fatale Annahme: dass ein Dokument nur aus Zeichen besteht, die im Raum angeordnet sind. Sie erfassen nicht, dass diese Zeichen Bedeutungen bilden – dass „Rechnung Nr.“ ein Label ist, dass der Wert daneben eine Kennung ist, dass die Zahl unten mit einem Dollarzeichen wahrscheinlich das ist, was Sie bezahlen müssen.
Schritt 1: SEHEN – Die KI erfasst die gesamte Seite auf einmal
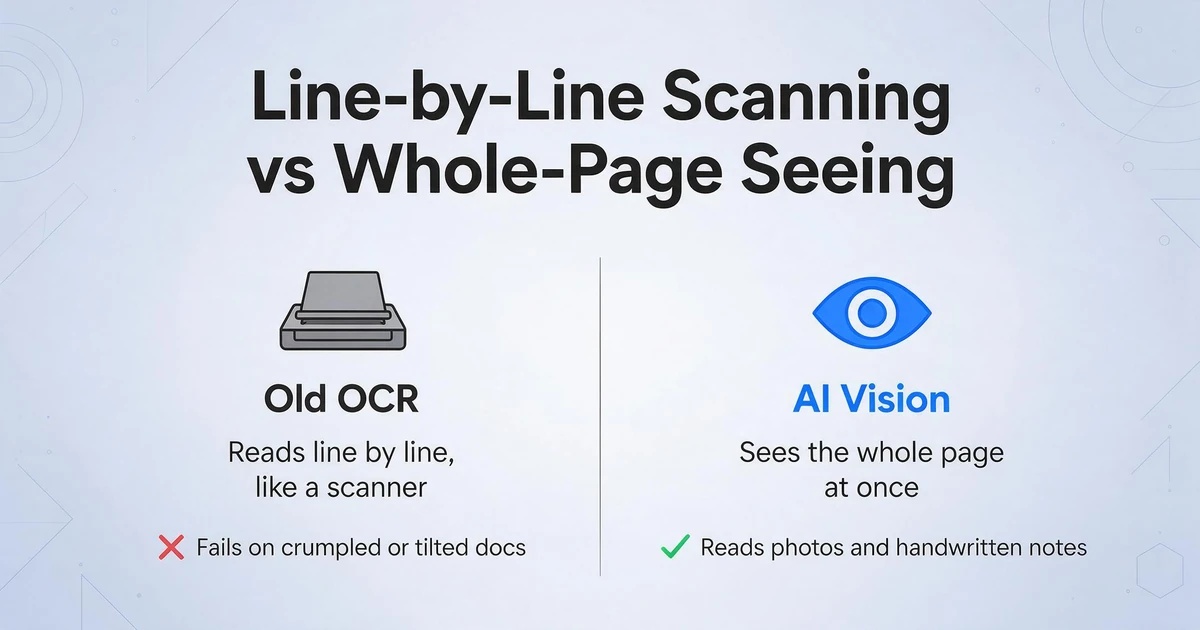
Das Erste, was moderne KI mit Ihrem Dokument macht, unterscheidet sich grundlegend vom alten Ansatz. Statt Zeile für Zeile zu scannen – Text so zu lesen, wie es ein Flachbettscanner tut – sieht sie die gesamte Seite als ein vollständiges Bild.
Denken Sie daran, wie Sie eine Speisekarte im Restaurant betrachten. Sie lesen nicht jedes Wort von „Vorspeisen“ bis „Desserts“. Ihre Augen erfassen das gesamte Layout in einem Blick: Preise rechts, Beschreibungen in der Mitte, Abschnittsüberschriften fett. Sie finden das teuerste Gericht in unter einer Sekunde, weil Ihr visuelles System die gesamte Szene gleichzeitig verarbeitet. Die Bilderkennungsfähigkeit der KI funktioniert genauso. Sie nimmt räumliche Beziehungen wahr – dieser Textblock ist über jenem, diese Zahl befindet sich in einer Tabellenzelle, dieses Logo sitzt im Kopfbereich – genauso wie Ihre Augen, bevor Ihr bewusstes Gehirn überhaupt eingreift.
Deshalb kann auch ein Foto einer zerknitterten Quittung bei schlechter Beleuchtung verarbeitet werden. Die KI liest kein sauberes Textraster; sie rekonstruiert eine visuelle Szene. So wie Sie eine handschriftliche Notiz eines Freundes lesen können, selbst wenn sie gekippt und halb von einer Kaffeetasse bedeckt ist, kann die KI unvollkommene Eingaben verstehen, weil sie das gesamte Bild sieht, nicht nur die Textzeichenfolgen.
Schritt 2: VERSTEHEN — Was „Rechnungsnr.“ tatsächlich bedeutet
Das Sehen der Seite ist nur der erste Schritt. Der eigentliche Sprung besteht darin, zu verstehen, was die erkannten Elemente bedeuten. Genau hier unterscheidet sich KI grundlegend von älteren Tools – und beginnt, sich eher wie ein Mensch zu verhalten als wie ein Programm.
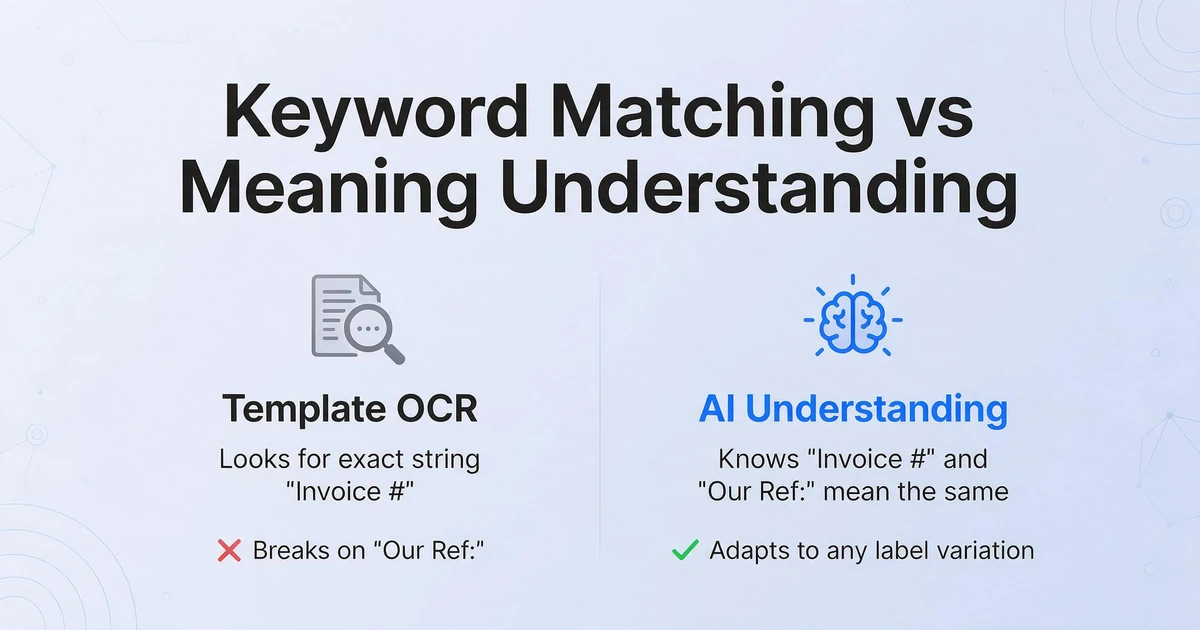
Stellen Sie sich vor, Sie erhalten ein Dokument in einer Sprache, die Sie nicht sprechen, aber Sie bemerken, dass die Nummer INV-2024-0891 in jedem Dokument, das Sie gesehen haben, neben dem Ausdruck „Rechnungsnr.“ steht. Sie würden schnell lernen: Wenn ich „Rechnungsnr.“ sehe, ist der Wert daneben die Rechnungskennung. Stellen Sie sich nun vor, der nächste Lieferant schreibt „Unser Zeichen:“ statt „Rechnungsnr.“. Ein vorlagenbasiertes Tool scheitert hier – es wurde angewiesen, exakt nach der Zeichenfolge „Rechnungsnr.“ zu suchen. Sie als Mensch passen sich jedoch sofort an. Sie erkennen, dass „Unser Zeichen:“ denselben Zweck erfüllt, weil Sie die Rolle verstehen, die dieses Feld im Dokument spielt, und nicht nur seinen wörtlichen Text.
Das Dokumentverständnis von KI funktioniert nach demselben Prinzip. Sie weiß, dass „Rechnungsnummer“, „Rechnungsnr.“, „Rechnungsnr.“ und „Unser Zeichen:“ allesamt verschiedene Arten sind, dasselbe auszudrücken. Es muss nicht jede Variante erklärt bekommen. Sie hat – durch den Kontakt mit Millionen von Dokumenten – die Muster gelernt, wie Informationen beschriftet und strukturiert werden, genauso wie Sie gelernt haben, dass eine Zahl in der unteren rechten Ecke einer Rechnung wahrscheinlich die Summe ist.
Das ist der Unterschied zwischen dem Erkennen von Zeichen und dem Verstehen eines Dokuments. Die KI sucht nicht nach einer Schlüsselwortübereinstimmung. Sie beantwortet die Frage: „Welche Informationen enthält dieses Dokument, und welche Rolle spielt jedes Element?“
Das hilfreiche Gedankenmodell: Alte Tools beantworten „Wo sind die Daten?“ KI beantwortet „Was sind die Daten?“ Der erste Ansatz scheitert, wenn sich das „Wo“ ändert. Der zweite kümmert sich überhaupt nicht um das „Wo“.
Schritt 3: FETCH — Den richtigen Wert in die richtige Spalte setzen
Sobald die KI das Dokument gesehen und verstanden hat, ist der letzte Schritt täuschend einfach: Sie sagen, was Sie möchten, und die KI findet es.
So funktioniert das in der Praxis. Sie haben einen Stapel Rechnungen von verschiedenen Lieferanten. Sie geben vier Spaltennamen in das Tool ein: „Rechnungsnummer", „Datum", „Gesamtbetrag" und „Lieferantenname". Das war's. Sie haben der KI damit gesagt, wonach sie suchen soll. Sie geht jede Rechnung durch, findet den Wert, der zu jedem Spaltennamen passt – nach Bedeutung, nicht nach Position – und füllt Ihre Tabelle.
Die entscheidende Erkenntnis: Sie definieren die Ausgabe, und die KI navigiert durch die Eingabe, um sie zu finden. Sie bringen ihr nicht bei, wo sich jedes Feld auf der Rechnung jedes Lieferanten befindet. Sie erstellen keine Vorlagen. Sie zeichnen keine Kästchen. Sie benennen nur die gewünschten Spalten, und die KI erledigt den Rest. Dieser Ansatz – den wir Benutzerdefinierte Spaltenextraktion nennen – kehrt den traditionellen Arbeitsablauf um. Statt dass das Dokument bestimmt, welche Daten Sie erhalten (und woher sie kommen), bestimmen Sie, welche Daten Sie benötigen, und die KI findet heraus, wo sie auf jedem Dokument zu finden sind.
Das gleiche Prinzip geht über die einfache Extraktion hinaus. Sie können die KI bitten, beim Extrahieren zu kategorisieren – zum Beispiel, indem Sie eine Spalte namens „Kategorie (Optionen: Mahlzeiten/Transport/Büro/Sonstiges)" hinzufügen, und die KI liest jede Quittung und entscheidet, welche Kategorie passt, auch wenn keine Quittung ein gedrucktes Feld „Kategorie" hat. Sie können sie sogar bitten, während der Extraktion Berechnungen durchzuführen, wie etwa den Steuerbetrag aus einer Zwischensumme zu berechnen, wenn nur die Gesamtsumme gedruckt ist. Die KI kopiert nicht nur Zahlen – sie denkt über sie nach.
Dateien werden sicher verarbeitet und nicht gespeichert.
Warum dies alles über Dokumentformate verändert
Wenn die KI Daten danach findet, was sie bedeuten, und nicht danach, wo sie stehen, wird das Layout des Dokuments irrelevant. Das ist die Konsequenz, die den Drei-Schritte-Prozess in der Praxis so transformativ macht.
Zehn Rechnungen von zehn verschiedenen Anbietern, jede mit ihrem eigenen Layout – unterschiedliche Positionen für das Datum, unterschiedliche Bezeichnungen für das Summenfeld, unterschiedliche Tabellenstrukturen. Für ein vorlagenbasiertes Tool sind das zehn separate Konfigurationsprojekte. Für eine KI, die sieht und versteht wie ein Mensch, ist es ein einziger Batch-Job. Sie laden alle zehn hoch, benennen Ihre Spalten einmal und erhalten eine einzige Tabelle mit allen Daten in einer Tabelle zusammengeführt.
Das ist nicht nur schneller – es verändert, was praktikabel ist. Bevor es diese Funktion gab, mussten Sie, wenn ein Kunde Ihnen ein Foto einer handschriftlichen Quittung schickte, diese entweder manuell abtippen oder ihm sagen, dass er eine ordentliche PDF senden muss. Jetzt funktioniert ein Foto vom Telefon genauso wie ein gescanntes Dokument. Ein Screenshot einer PDF funktioniert genauso wie die PDF selbst. Das Eingabeformat hat aufgehört, ein Torwächter zu sein, in dem Moment, in dem die KI begann, Inhalte zu verstehen, anstatt Layouts zu parsen.
Was dies ermöglicht, ist kein größeres Wörterbuch oder eine schnellere Zeichenerkennung. Es ist der Wechsel von positionsbasierter Extraktion – „die Rechnungsnummer befindet sich an den Koordinaten (x, y)“ – zu bedeutungsbasierter Extraktion – „finde den Wert, der als Rechnungskennung dient, wo auch immer er sich befindet.“ Der erste Ansatz ist fragil. Der zweite ist flexibel, genau wie menschliches Lesen flexibel ist: Sie erkennen eine Summe, egal ob sie in einer Tabelle, in einem Satz oder handschriftlich am Rand steht.
Häufig gestellte Fragen
Versteht die KI meine Dokumente wirklich, oder rät sie nur basierend auf Mustern?
Es ist kein Raten im Sinne eines Münzwurfs. Stellen Sie es sich wie einen erfahrenen Buchhalter vor, der Tausende von Rechnungen gesehen hat. Dieser Buchhalter „rät“ nicht, wo die Summe ist – er weiß es, weil er das Muster sofort erkennt. Die KI hat dieselbe Art von trainierter Intuition, aufgebaut durch die Exposition gegenüber einer enormen Bandbreite von Dokumenttypen und Layouts. Der Unterschied ist, dass die KI das, was sie sieht, in unter zehn Sekunden verarbeitet, nicht in drei Minuten. Bei gedruckten Dokumenten erreicht diese trainierte Erkennung eine Genauigkeit von bis zu 99 %.
Kann KI Handschrift lesen?
Ja. Da die KI das Dokument in erster Linie als Bild betrachtet – nicht als eine Sammlung getippter Zeichen – ist Handschrift nur ein weiteres visuelles Muster, das interpretiert wird. Sie funktioniert mit gedrucktem Text, Schreibschrift, Blockschrift und sogar mit Kontrollkästchen und eingekreisten Auswahlen auf Formularen. Allerdings kann extrem unleserliche Handschrift (die Art, mit der auch ein Mensch Schwierigkeiten hätte) die Genauigkeit verringern. Je sauberer die Schrift, desto besser das Ergebnis – genau wie bei einem Menschen.
Was passiert, wenn die KI etwas falsch macht?
Keine KI ist perfekt, und ein verantwortungsvolles Tool tut nicht so, als wäre sie es. Die Ausgabe ist so strukturiert, dass die Überprüfung einfach ist – jeder extrahierte Wert befindet sich in einer beschrifteten Spalte, sodass Sie schnell nach Auffälligkeiten suchen können, anstatt jedes Feld mit dem Originaldokument abzugleichen. Wenn Ihnen ein konsistentes Fehlermuster auffällt, hilft es oft, Ihre Spaltennamen spezifischer zu gestalten. Die KI funktioniert am besten, wenn Ihre Spaltennamen klar beschreiben, wonach Sie suchen.
Muss ich sie zuerst mit meinen Dokumenten trainieren?
Nein. Das ist einer der größten Unterschiede zu älteren KI-Ansätzen. Tools zur Dokumentenverarbeitung für Unternehmen erfordern oft, dass Sie Stichproben von Dokumenten hochladen, Felder manuell beschriften und warten, während das System ein benutzerdefiniertes Modell trainiert – ein Prozess, der Tage oder Wochen dauern kann. Moderne bildbasierte KI ist auf eine Vielzahl von Dokumenttypen vortrainiert und funktioniert sofort. Sie laden hoch, benennen Ihre Spalten und erhalten Ergebnisse. Es gibt keine Einrichtungsphase und keine Lernkurve für das Tool – das Lernen ist bereits vor Ihrer Ankunft passiert.
Sind meine Daten sicher, wenn die KI sie liest?
Das hängt vollständig von dem Tool ab, das Sie verwenden. Wenn Sie einen Dokument-KI-Dienst bewerten, achten Sie auf klare Aussagen zur Datenverarbeitung: Werden Ihre Daten verwendet, um die KI weiter zu trainieren? Werden sie nach der Verarbeitung gespeichert? Sind sie verschlüsselt? Ein vertrauenswürdiger Dienst verarbeitet Ihre Dateien, gibt die extrahierten Daten zurück und speichert oder lernt nicht aus Ihren Dokumenten. Überprüfen Sie immer die Datenschutz- und Datenverarbeitungsrichtlinien des Anbieters, bevor Sie vertrauliche Dokumente hochladen.
Was das für Sie bedeutet
Der SEE → UNDERSTAND → FETCH-Prozess ist nicht nur ein interessantes technisches Detail. Er ist der Grund, warum ein Tool, das früher drei Minuten manuelle Arbeit pro Dokument erforderte, jetzt nur noch fünf bis zehn Sekunden dauert. Die Zeitersparnis entsteht dadurch, dass zwei Arten von Arbeit gleichzeitig entfallen: die geistige Arbeit, jedes Feld auf jedem Dokument zu finden, und die körperliche Arbeit, die Werte in die richtigen Zellen einzutippen.
Aber die größere Veränderung liegt darin, was möglich wird. Wenn die Verarbeitung eines Dokuments schnell geht, verarbeiten Sie vielleicht Dokumente, mit denen Sie sich früher nicht befasst hätten. Wenn das Format keine Rolle spielt, müssen Sie Kunden und Lieferanten nicht mehr bitten, Dinge „auf die richtige Art" zu senden. Wenn die Einrichtung kein Training erfordert, verschwindet die Hürde zwischen „Ich sollte das automatisieren" und „Ich mache es tatsächlich".
Wenn Sie tiefer in die technische Seite eintauchen möchten – was unter der Haube passiert, wie dies im Detail mit herkömmlicher OCR verglichen wird und woher die Genauigkeitszahlen stammen –, setzt unser Leitfaden zu was KI-Dateneingabe tatsächlich bedeutet dort an, wo dieser Artikel endet. Und wenn Sie neugierig sind, diese Fähigkeit ohne Programmierung in Ihre bestehenden Arbeitsabläufe zu integrieren, sehen Sie, wie No-Code-Dokumenten-KI die Extraktion für jeden zugänglich macht, der eine Spalte benennen kann.
Probieren Sie es mit Ihrer eigenen Rechnung aus. Geben Sie drei Spaltennamen ein – Rechnungsnummer, Datum, Gesamtbetrag – und beobachten Sie, wie die KI in Echtzeit sieht, versteht und abruft. Der beste Weg, den Prozess zu verstehen, ist, ihn bei Ihrem Dokument zu beobachten.