IA OCR lê escrita manuscrita
Onde o OCR tradicional falha
Uma fatura digitada limpa a 300 DPI, processada pelo Tesseract ou Google Cloud Vision, retorna com 99% de precisão de caracteres. Mude apenas o meio — a mesma fatura, preenchida à mão — e a precisão cai para menos de 50%. A diferença não é um problema de calibração. É arquitetural: o OCR tradicional foi projetado para comparar formatos estáticos de caracteres com modelos conhecidos. A escrita manuscrita não tem modelos. A mesma letra escrita duas vezes pela mesma pessoa produz dois formatos diferentes. Um modelo de visão por IA aborda o problema pela direção oposta — lendo palavras como padrões visuais e usando o contexto ao redor para desambiguar traços que, de outra forma, seriam ambíguos.
Principais Conclusões
- Uma fatura digitada a 300 DPI retorna 99% de precisão de caracteres com OCR tradicional, enquanto a mesma fatura preenchida à mão cai para menos de 50% — não porque a digitalização piorou, mas porque a ferramenta foi criada para separar caracteres que a escrita cursiva conecta deliberadamente.
- De 30 a 50 palavras em cada 100 voltam erradas do OCR em nuvem em documentos cursivos, e nenhum ajuste de contraste resolve — a falha está na arquitetura de segmentação de caracteres, não no pipeline de imagem.
- Você lê escrita manuscrita vendo palavras inteiras, não juntando letras individuais — modelos de visão por IA agora fazem o mesmo, e no ImageToTable.ai isso eleva a precisão de campos para 85-95%, onde verificar 100 planilhas de horas manuscritas leva 3 minutos em vez de 300.
Por que a leitura caractere por caractere falha na escrita manuscrita
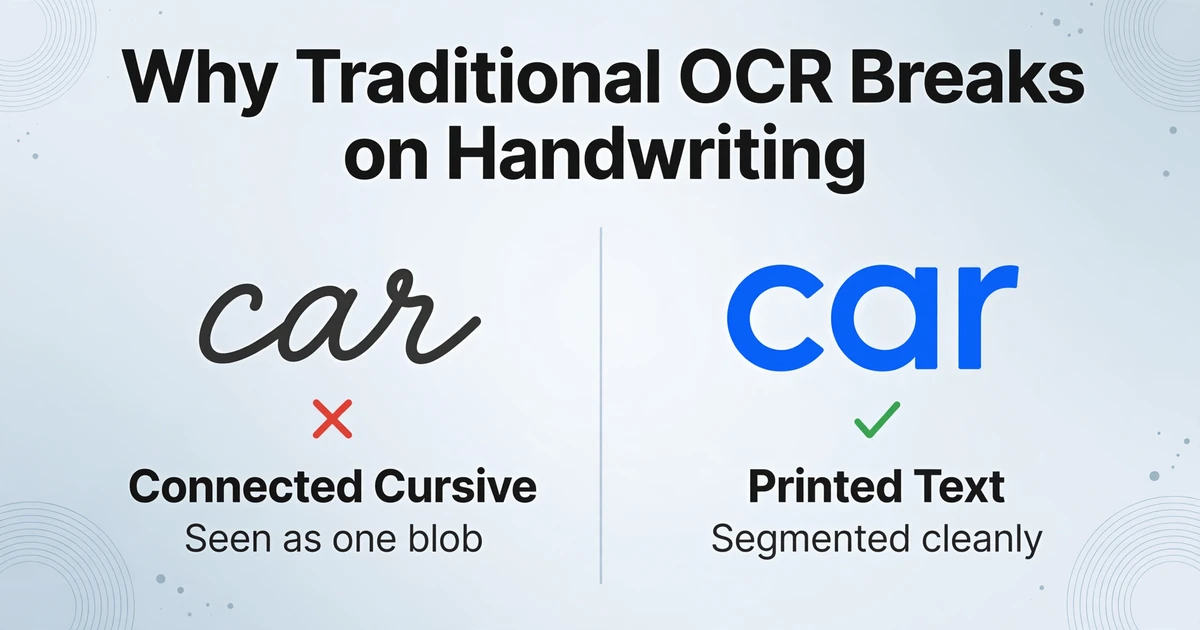
O OCR tradicional opera com um modelo de segmentação em primeiro lugar. O mecanismo examina uma imagem, isola cada caractere detectando limites de espaços em branco e compara a forma isolada com uma biblioteca de glifos conhecidos. Esse fluxo funciona quando os caracteres são previsíveis — o "A" impresso em Arial mapeia-se claramente aos modelos de "A" em Arial armazenados. Ele colapsa quando os caracteres se recusam a ficar em caixas previsíveis.
Três problemas estruturais tornam a escrita manuscrita um pesadelo de segmentação para o OCR tradicional. Caracteres conectados — a escrita cursiva une letras adjacentes com ligaduras, tornando impossível para um algoritmo de detecção de limites encontrar o espaço entre "a" e "r" em "car". O mecanismo vê um glifo contínuo onde um humano vê quatro letras. Larguras de traço variáveis — uma caneta esferográfica pressionada com força nos traços descendentes e levemente nos ascendentes produz variações de espessura de linha que fragmentam caracteres individuais em segmentos detectados separados. Um "5" vira um borrão mais um traço separado. Linhas de base inconsistentes — as pessoas escrevem inclinado, desviam-se para cima na página e variam a altura das letras dentro da mesma palavra. A etapa de localização de linhas que funciona em texto tipográfico falha quando "apple" é escrito em um ângulo de 15 graus, com o "p" mergulhando abaixo da linha de base e o "l" subindo acima dela.
A consequência a jusante é uma cascata. Um estudo de 2025 publicado no International Journal of Computer Scientific Technology & Electronics Engineering descobriu que a precisão do OCR tradicional em documentos manuscritos cai de 92% em texto impresso à mão limpo para 55% sob degradação moderada e 30% sob condições severas — condições que mal seriam consideradas ruído no processamento de texto impresso. Enquanto isso, o benchmark de escrita cursiva de 2026 da AIMultiple, testando 100 amostras em 14 modelos, descobriu que serviços tradicionais de OCR em nuvem como Google Cloud Vision e Amazon Textract ficam entre 50% e 70% na escrita cursiva — ou seja, 30 a 50 palavras em cada 100 estão erradas.
A comunidade de entrada de dados do Reddit documenta essa lacuna há anos. Uma discussão de 2024 no r/Automate sobre extração de dados de faturas manuscritas enquadrou o problema de forma sucinta: "Você precisa pegar não apenas dados manuscritos, mas dados manuscritos não estruturados e dar sentido a eles." A análise de 2025 da comunidade r/computervision sobre ferramentas de OCR para escrita manuscrita observou diretamente que a "precisão de escrita manuscrita (~65-85%) dos novos modelos de IA ainda fica atrás de soluções especializadas para uso crítico nos negócios." Esses são profissionais, não profissionais de marketing. Os números deles importam.
Como Modelos de Visão por IA Leem Escrita Manuscrita como Padrões Visuais, Não Sequências de Caracteres
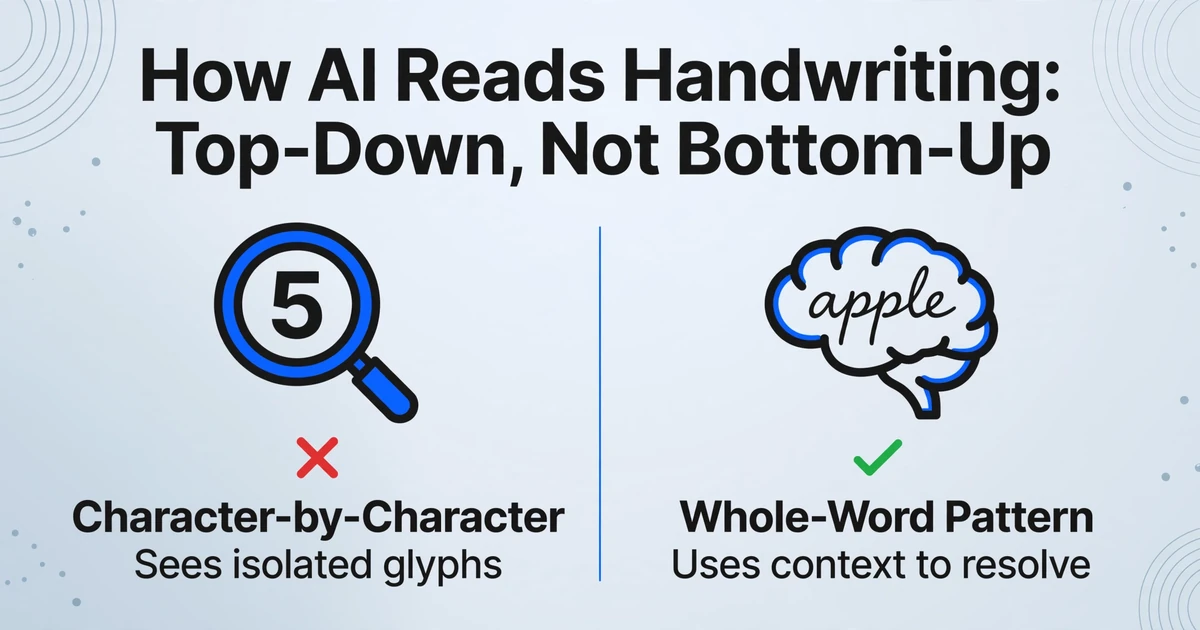
Modelos de visão por IA — mais precisamente, modelos de visão-linguagem como GPT-5, Gemini e Claude — não realizam segmentação de caracteres. Eles processam a imagem de forma holística, vendo formas de palavras inteiras como padrões visuais unificados e, em seguida, interpretando esses padrões com o mesmo modelo de linguagem que entende a frase em que a palavra aparece. Essa é a inversão crucial: em vez de construir palavras a partir de caracteres (de baixo para cima), eles reconhecem palavras como um todo visual e usam a palavra compreendida para desambiguar formatos de letras individuais (de cima para baixo).
A diferença prática é mais fácil de ver em algo comum — um campo de nome em um formulário. Imagine uma entrada manuscrita em que a caneta do escritor se levanta levemente no meio de "Sm_th," deixando um caractere fraco ou ausente entre o "m" e o "t." O OCR tradicional, trabalhando caractere por caractere, retorna "Sm" mais um glifo não reconhecido mais "th." O erro se acumula — o nome completo pode se tornar irreconhecível adiante. Um modelo de visão por IA vê a forma da palavra "Sm_th" e o contexto ao redor — este é o campo "Nome" em um formulário, o nome completo é "John Smith." O modelo de linguagem preenche a lacuna a partir do contexto, assim como você faria se visse com seus próprios olhos. O mesmo mecanismo resolve um "1" manuscrito de um "l" minúsculo, um "0" de um "O" e um "4" manuscrito que parece um "9" — perguntando: o que faz sentido aqui?
É por isso que os modelos modernos de visão por IA superam dramaticamente o OCR tradicional em escrita manuscrita. O benchmark da AIMultiple colocou GPT-5 e Gemini 3 Pro Preview no topo para reconhecimento de escrita cursiva — não porque têm melhores detectores de caracteres, mas porque leem o documento como uma pessoa lê: entendendo o que o texto significa, não apenas como seus pixels se parecem. O mesmo benchmark encontrou o Google Cloud Vision em aproximadamente 63% na escrita cursiva. A diferença entre 95% e 63% é a diferença entre "utilizável com verificações pontuais" e "exige redigitação manual completa."
Essa abordagem semântica é o que torna a entrada de dados com IA sem modelo por design. Você digita os nomes das colunas que deseja extrair — "Nome do Funcionário," "Horas Trabalhadas," "Data" — e a IA localiza os valores manuscritos correspondentes a cada campo em qualquer lugar da página, entendendo seu significado. Sem coordenadas de pixel. Sem modelos por formulário. Sem retreinamento quando a caligrafia de alguém muda. Esse é o mecanismo que chamamos de Extração de Colunas Personalizadas: você define o esquema de saída nomeando as colunas desejadas, e a IA mapeia o conteúdo do documento para o seu esquema, independentemente de onde cada valor manuscrito está na página.
Os arquivos são processados de forma segura e não são armazenados.
Impresso e Escrito à Mano Mistos: o Formato de Documento Mais Común do Qual Ninguém Fala
A maioria dos documentos manuscritos do mundo real não são puramente manuscritos. São formulários — um modelo impresso com rótulos, caixas e instruções, preenchido com uma caneta. O rótulo "Nome do Paciente:" está impresso em Helvetica. O valor "James Peterson" está escrito em escrita cursiva com caneta esferográfica. Um motor de OCR tradicional, ajustado para texto impresso, lê o rótulo perfeitamente e falha no valor — produzindo um documento onde 80% do texto está correto e os 20% que você realmente precisa estão ausentes.
Este formato de impresso mais manuscrito é onde os modelos de visão por IA mostram sua vantagem mais forte sobre a concorrência. O modelo não alterna entre um "modo impresso" e um "modo manuscrito". Ele lê a página como uma única cena visual — reconhecendo que "Nome do Paciente" é um rótulo de campo (impresso, limpo) e o rabisco abaixo é o valor do campo (manuscrito, confuso) — e mapea ambos para a coluna de saída correta. O contexto do rótulo impresso ajuda ativamente no reconhecimento da escrita manual: se o rótulo diz "Número de Telefone", o modelo espera uma sequência de dígitos no campo de valor, restringindo o problema de reconhecimento. Se o rótulo diz "Comentários", o modelo espera frases completas e se ajusta em consecuencia.
Este formato aparece em todos os lugares. Formulários de admissão médica — perguntas demográficas impressas, respostas manuscritas. Relatórios de inspeção de campo — itens de lista de verificação de segurança impressos, observações manuscritas na columna de notas. Confirmaciones de entrega — números de rastreo impressos, firmas e marcas de tempo manuscritas do receptor. Cotizaciones de proveedores — líneas de artículos impresas, ajustes de cantidad manuscritos. En todos estos, el cuello de botella del flujo de trabajo no es "leer el documento". Es "leer las partes manuscritas que contienen los datos accionables". El OCR tradicional le da el texto del rótulo gratis y le cobra caro por los valores. La visión por IA lee ambos en una sola pasada.
El concepto de leer rótulos y valores en contexto no es solo una solución para la escritura manual — es la diferencia fundamental entre la precisión del OCR por IA y el OCR tradicional. El OCR tradicional ve "Fecha: 03/15/2026" como una cadena de caracteres. La extracción por IA ve un rótulo de campo ("Fecha") con un tipo semántico (fecha de calendario), y coloca el valor en la columna correcta de la hoja de cálculo incluso cuando aparecen otras cinco fechas en la misma página — porque entiende qué fecha pertenece a qué rótulo.
Caixas de Seleção, Marcas de Verificação e Círculos: Lendo a Intenção, Não as Formas
Uma caixa marcada em um formulário de papel pode assumir várias formas: preenchimento sólido, linha diagonal, marca de X, marca de verificação, resposta circulada, risco sobre a opção errada, sublinhado duplo sob a correta. Para um OCR tradicional, nada disso é texto — é ruído de imagem. O mecanismo ignora ou, pior, interpreta a marca como um caractere: uma marca de verificação vira "V", uma barra diagonal vira "/", uma opção circulada é lida como um "O" prefixado ao texto da resposta.
O problema se agrava em formulários estruturados. Uma lista de verificação de inspeção de segurança com 20 caixas Sim/Não contém 20 decisões binárias que determinam conformidade, agendamento de manutenção ou responsabilidade. Se o mecanismo errar 5 de 20, a automação é pior que inútil — ela produz silenciosamente dados errados que parecem corretos. Um campo marcado como "Seguro" vira "Inseguro" porque o mecanismo interpretou uma marca ✓ como o caractere "V" ao lado da opção errada.
Os modelos de visão por IA lidam com caixas de seleção de forma diferente, pois operam com base em relações espaciais, e não na detecção de caracteres. O modelo identifica o texto da pergunta ("Extintor de incêndio inspecionado?") e as opções de resposta ("Sim / Não"), e então determina qual região de resposta contém uma marca — qualquer marca. Uma marca de verificação, um X, um círculo preenchido, um risco: tudo é registrado como "esta opção está selecionada". O modelo não precisa classificar o tipo de marca. Ele classifica a intenção de seleção — a conexão espacial entre a marca e a opção que ela modifica.
A equipe do Document AI do Google documentou esse desafio diretamente em seus fóruns de desenvolvedores: profissionais relatam que a detecção de caixas de seleção falha mesmo com caixas maiores quando os formulários passam por fluxos de impressão, preenchimento e digitalização. A recomendação — dimensões de 12 a 15 mm para as caixas — só se aplica quando você controla o design do formulário. Para os milhares de formulários existentes em circulação com caixas menores, a resposta é um modelo de IA que lê a intenção espacial em vez da geometria das formas.
O que a IA ainda não consegue ler com confiabilidade
Ser honesto sobre as limitações é o que torna o caso da extração de escrita manuscrita por IA crível. Aqui está o que ainda falha.
Escrita com sobreposição intensa. Quando uma linha de escrita manuscrita é escrita diretamente sobre outra — comum em livros-razão onde correções eram feitas escrevendo sobre o registro original — tanto o OCR tradicional quanto os modelos de visão por IA têm dificuldade. O modelo vê uma mancha visual onde há duas camadas de significado. Um humano com contexto sobre a história do documento pode separá-las. A IA atual não consegue.
Assinaturas extremamente estilizadas. Assinaturas funcionam como marcas de identidade, não como texto legível. Elas são padrões intencionalmente únicos que combinam floreios, loops ilegíveis e glifos pessoais. Os modelos de IA detectam que uma assinatura está presente — eles conseguem identificar a região da assinatura em um documento — mas não extraem o nome do signatário a partir do formato da assinatura em si. O nome deve aparecer em texto impresso ou manuscrito em outro lugar do documento.
Lápis fraco em fundos escuros. Lápis em papel sulfite, digitalizado com baixo contraste, produz traços de texto quase indistinguíveis do grão do papel. Uma pesquisa acadêmica de 2025 sobre técnicas de reconhecimento de escrita manuscrita observou que a "robustez a ruído" continua sendo um dos principais problemas não resolvidos — "os pesquisadores devem continuar a investigar métodos que aumentem a resiliência dos sistemas de OCR" a condições reais abaixo do ideal. Isso se aplica tanto a sistemas tradicionais quanto baseados em IA.
Escritas não latinas. O desempenho depende muito do modelo. GPT-5 e Gemini têm bom desempenho em escritas principais, incluindo árabe, devanagari e caracteres chineses — particularmente quando o modelo foi treinado nesses sistemas de escrita. Modelos menores ou especializados podem ter bom desempenho em escrita cursiva latina, mas degradam acentuadamente em outros sistemas de escrita. Se seus documentos incluem texto manuscrito em múltiplas escritas, teste o modelo específico em seus documentos antes de se comprometer — o reconhecimento de escrita manuscrita entre escritas não é uniformemente resolvido.
Documentos históricos com papel degradado. Documentos com vazamento de tinta (tinta do verso visível através do papel), foxing (manchas de idade), danos por água ou bordas rasgadas introduzem artefatos visuais que confundem o reconhecimento tanto em nível de caractere quanto holístico. O benchmark da AIMultiple descobriu que mesmo os modelos com melhor desempenho perdem 10-15 pontos percentuais quando a condição do documento se degrada. A digitalização com qualidade de arquivo pode exigir ferramentas especializadas e pipelines de pré-processamento separados que as ferramentas de extração de IA de uso geral não incluem.
Fluxos de Trabalho Reais Onde a Extração de Escrita Manuscrita Importa
A tecnologia só importa onde ela muda um fluxo de trabalho real. Aqui estão os cenários em que a mudança da inserção manual para a extração de escrita manuscrita por IA gera economias de tempo mensuráveis.
Quadros de horários manuscritos. Equipes de construção, técnicos de campo e trabalhadores por turnos preenchem quadros de horários em papel — nomes, datas, horas, códigos de trabalho — muitas vezes com caligrafia apertada e confusa no final de um turno. Um gerente de folha de pagamento que processa 80 quadros de horários por semana gasta cerca de 3 minutos por folha na inserção manual de dados: lendo cada campo, digitando no sistema de folha de pagamento e verificando o total. Isso dá 4 horas por semana — uma manhã inteira — gastas redigitando escrita manuscrita. Com a extração por IA, os mesmos 80 quadros de horários são enviados como um lote, extraídos em uma única planilha com colunas nomeadas "Nome do Funcionário", "Data", "Horas", "Código do Trabalho" e exportados em menos de um minuto. O papel do gerente passa de inserção de dados para tratamento de exceções: verificar os 5-10 registros em que a escrita manuscrita era genuinamente ambígua.
De acordo com a Seção 11(c) da FLSA, os empregadores devem manter registros precisos de folha de pagamento, incluindo horas trabalhadas e salários pagos. Erros em quadros de horários manuscritos que chegam à folha de pagamento criam exposição à conformidade — e corrigi-los depois é mais caro do que identificá-los durante o lançamento.
Formulários de inspeção de campo. Inspetores de segurança, auditores de qualidade e supervisores de obra preenchem checklists em papel no campo — muitas vezes em uma prancheta, na chuva, com uma caneta ficando sem tinta. Cada formulário contém caixas de seleção (aprovação/reprovação do equipamento), leituras numéricas manuscritas (pressão, temperatura, voltagem) e notas de texto livre (observações, ações corretivas). Processar 50 formulários de inspeção manualmente leva um dia inteiro de trabalho. Com inserção de dados por IA sem código, o mesmo lote é extraído em minutos — os estados das caixas de seleção, as leituras numéricas e as notas narrativas fluem cada um para suas próprias colunas na planilha. O relatório de conformidade que costumava levar a tarde de sexta-feira fica pronto na manhã de sexta-feira.
Formulários de admissão de pacientes. Uma clínica médica processa 60 formulários de admissão de novos pacientes por dia — histórico médico, medicamentos atuais, listas de alergias, dados do seguro — todos manuscritos pelos pacientes na sala de espera. A equipe da recepção insere manualmente cada formulário no sistema de prontuário eletrônico (EHR), um processo que leva de 5 a 7 minutos por formulário e introduz erros de transcrição conforme a equipe alterna entre escrita ilegível e bancos de dados de terminologia médica. A extração por IA lê os campos manuscritos e os mapeia para as categorias corretas de dados do EHR — "Nome do Medicamento", "Dosagem", "Frequência" — sinalizando qualquer valor com baixa confiança para verificação humana antes que entre no prontuário do paciente.
Livros-caixa e talonários manuscritos. Pequenas empresas — food trucks, vendedores de mercado, contratantes independentes — muitas vezes mantêm livros-caixa manuscritos. O talonário de recibos em papel carbono de um vendedor contém centenas de entradas: datas, descrições de itens, valores, nomes de clientes, tudo a caneta. Na época do imposto de renda, esses dados precisam ser digitalizados. O OCR tradicional produz resultados inúteis em papel carbono — o texto azulado e apagado confunde a detecção baseada em contraste. Os modelos de visão por IA, treinados em diversas imagens do mundo real, leem as entradas entendendo a página como uma cena — o texto apagado, a textura do papel, o padrão de layout de linhas e colunas — em vez de limiarizar pixels em preto e branco.
Confirmações de entrega. Empresas de logística recebem confirmações de entrega assinadas — detalhes de remessa impressos com nomes dos recebedores escritos à mão, carimbos de data/hora e anotações de condição. O nome do recebedor escrito à mão é o registro legal de comprovação de entrega. A extração por IA captura o nome do recebedor e o carimbo de data/hora do formulário, preenchendo o banco de dados de confirmações de entrega sem redigitação manual.
Receitas manuscritas e registros pessoais. Nem todo documento manuscrito é papelada empresarial. Uma receita de família mistura anotações em escrita cursiva, quantidades fracionárias ("1½ xícaras") e abreviações em um layout que nenhum designer de formulário planejou. A mesma extração semântica que lê uma anotação de campo lê a receita manuscrita em uma foto, retornando ingredientes, quantidades e instruções como colunas de planilha, em vez de uma página redigitada à mão.
Expectativas de Precisão: O Que 85-95% em Escrita Manual Significa na Prática
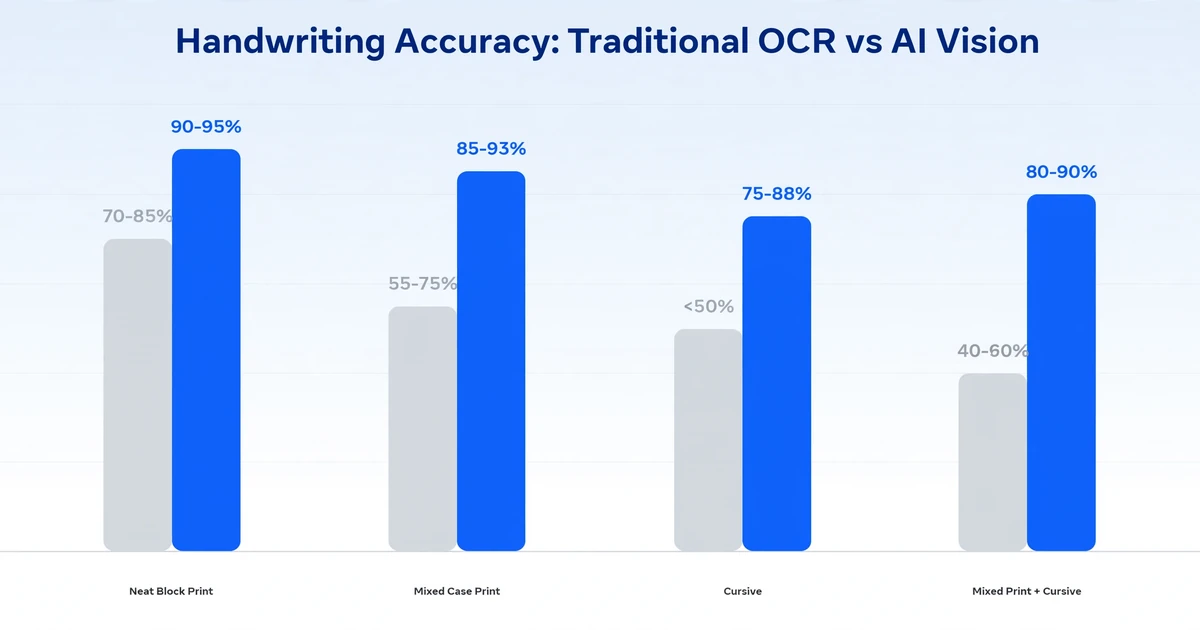
A declaração padrão de precisão da indústria de IA — "até 99% em texto impresso" — cria uma expectativa que não se transfere para a escrita manual. A precisão em escrita manual é um número fundamentalmente diferente em uma escala fundamentalmente diferente. Veja o que você deve realmente esperar.
| Estilo de Escrita Manual | OCR tradicional | Modelo de Visão por IA | Resultado Prático |
|---|---|---|---|
| Letra de forma legível (tudo em maiúsculas) | 70-85% | 90-95% | Verifique 1 em cada 10 campos |
| Letra de forma com maiúsculas e minúsculas | 55-75% | 85-93% | Verifique 1 em cada 7 campos |
| Escrita cursiva | Abaixo de 50% | 75-88% | Verifique 1 em cada 4 campos |
| Mistura de letra de forma + cursiva | 40-60% | 80-90% | Verifique 1 em cada 5 campos |
| Degradado / baixo contraste | Abaixo de 30% | 65-80% | Extração de melhor esforço; revisão humana esperada |
Fontes: benchmark de escrita cursiva da AIMultiple (2026); estudo IJCSTEE sobre precisão de OCR tradicional vs. IA (2025); benchmarking em cenários reais em serviços de OCR em nuvem. Todos os números refletem a precisão em nível de campo — se o valor extraído na planilha corresponde ao original manuscrito — e não a precisão em nível de caractere.
O número mais importante nesta tabela não é nenhum índice de precisão isolado. É a proporção entre o tempo de extração por IA e o tempo de verificação manual. Em 100 planilhas de horas manuscritas com letra de forma legível, a extração por IA leva menos de 30 segundos e gera cerca de 5 a 10 campos que precisam de verificação — uma revisão humana de 3 minutos. Digitação manual nas mesmas 100 planilhas: cerca de 300 minutos. A precisão da IA não precisa ser de 100% para proporcionar uma redução de tempo de 90% ou mais — ela só precisa ser alta o suficiente para que a verificação seja mais rápida do que redigitar do zero.
É isso que torna a conversa sobre precisão prática, e não acadêmica. Precisão de entrada de dados por IA não se trata de atingir um número de marketing. Trata-se de cruzar um limite em que o custo de verificar a saída da IA fica abaixo do custo da entrada manual. Para texto impresso, esse limite foi cruzado há anos. Para letra de forma legível, foi cruzado com modelos de visão de nível GPT-4. Para escrita cursiva confusa, está sendo cruzado agora — mas a etapa de verificação é inegociável.
FAQ
A IA OCR consegue ler qualquer estilo de escrita manual?
Não qualquer estilo — mas a maioria dos estilos comuns. Letra de forma legível e letra de forma com maiúsculas e minúsculas alcançam 85-95% de precisão de campo nos modelos atuais de visão por IA. Escrita cursiva alcança 75-88%. Escrita manual muito estilizada, sobreposta ou extremamente confusa pode cair abaixo de 70%. Se você não consegue ler com confiança a partir de uma digitalização, a IA provavelmente também não consegue. A abordagem prática: envie tudo em lote, deixe a IA extrair o que puder e revise manualmente apenas as entradas de baixa confiança.
A IA lida com caixas de seleção e elementos de formulário, ou apenas texto?
Os modelos de visão por IA lidam com caixas de seleção, botões de opção, seleções circuladas e outras marcações de formulário ao ler a intenção espacial em vez de formatos de caracteres. Uma marca, cruz, preenchimento ou círculo ao lado de uma opção é registrado como "selecionado". Isso funciona melhor quando o layout do formulário é claro — regiões de resposta distintas com separação espacial visível das opções vizinhas. Caixas de seleção muito compactas em formulários densos ainda podem gerar ambiguidade que exige verificação humana.
Qual é a diferença entre o reconhecimento de escrita manuscrita por IA e o ICR tradicional?
O ICR tradicional (Reconhecimento Inteligente de Caracteres) estende o OCR com aprendizado de máquina treinado em conjuntos de dados de escrita manuscrita, mas ainda opera no modelo de segmentação de caracteres — isolando letras individuais e classificando-as. Os modelos de visão por IA eliminam a segmentação por completo, lendo formatos de palavras inteiras como padrões visuais e usando o contexto da linguagem para resolver caracteres ambíguos. A diferença prática: o ICR funciona com letras de forma nítidas, mas degrada na escrita cursiva; a visão por IA funciona com ambas, com uma queda de precisão menor entre elas.
Posso processar documentos manuscritos e impressos no mesmo lote?
Sim. Os modelos de visão por IA leem cada documento como uma cena — eles não precisam saber antecipadamente se o texto é impresso ou manuscrito. O mesmo lote pode conter faturas digitadas, planilhas de horas manuscritas e formulários de inspeção de formato misto. O modelo adapta sua estratégia de leitura por documento, não por lote. Essa é uma distinção importante dos pipelines tradicionais de OCR, que frequentemente exigem configuração separada para entrada impressa versus manuscrita.
A extração de escrita manuscrita está disponível em idiomas diferentes do inglês?
Depende do modelo. O GPT-5 e o Gemini têm bom desempenho nos principais idiomas de alfabeto latino (francês, espanhol, alemão, português), tanto na forma impressa quanto manuscrita. Escritas não latinas (árabe, devanágari, chinês, japonês, coreano) dependem mais do modelo — teste em seus documentos específicos antes de se comprometer. A variação do estilo de escrita em sistemas de escrita baseados em caracteres (chinês, japonês) introduz desafios de reconhecimento diferentes dos da cursiva latina, e as expectativas de precisão devem ser calibradas de acordo.
Teste a extração em seus próprios documentos antes de criar um fluxo de trabalho em torno dela. A diferença entre uma amostra de demonstração organizada e a escrita manuscrita real da sua equipe é onde está o número real de precisão.