La IA OCR lee escritura manuscrita
donde el OCR tradicional falla
Una factura mecanografiada limpia a 300 DPI, procesada con Tesseract o Google Cloud Vision, vuelve con un 99% de precisión de caracteres. Cambie nada más que el medio — la misma factura, llenada a mano — y la precisión cae por debajo del 50%. La brecha no es un problema de calibración. Es uno arquitectónico: el OCR tradicional fue diseñado para comparar formas de caracteres estáticas contra plantillas conocidas. La escritura manuscrita no tiene plantillas. La misma letra escrita dos veces por la misma persona produce dos formas diferentes. Un modelo de visión por IA aborda el problema desde la dirección opuesta por completo — leyendo las palabras como patrones visuales y usando el contexto circundante para desambiguar lo que de otro modo serían trazos ambiguos.
Conclusiones Clave
- Una factura mecanografiada a 300 DPI devuelve un 99% de precisión de caracteres mediante el OCR tradicional, mientras que la misma factura llenada a mano cae por debajo del 50% — no porque el escaneo empeorara, sino porque la herramienta fue construida para separar caracteres que la cursiva conecta deliberadamente.
- De 30 a 50 palabras de cada 100 vuelven incorrectas del OCR en la nube en documentos en cursiva, y ninguna cantidad de ajuste de contraste lo arregla — la falla está en la arquitectura de segmentación de caracteres, no en el proceso de imagen.
- Usted lee escritura manuscrita viendo palabras completas, no uniendo letras individuales — los modelos de visión por IA ahora hacen lo mismo, y en ImageToTable.ai esto eleva la precisión de campo al 85-95%, donde verificar 100 hojas de tiempo manuscritas toma 3 minutos en lugar de 300.
Por qué la lectura carácter por carácter falla con la escritura manuscrita
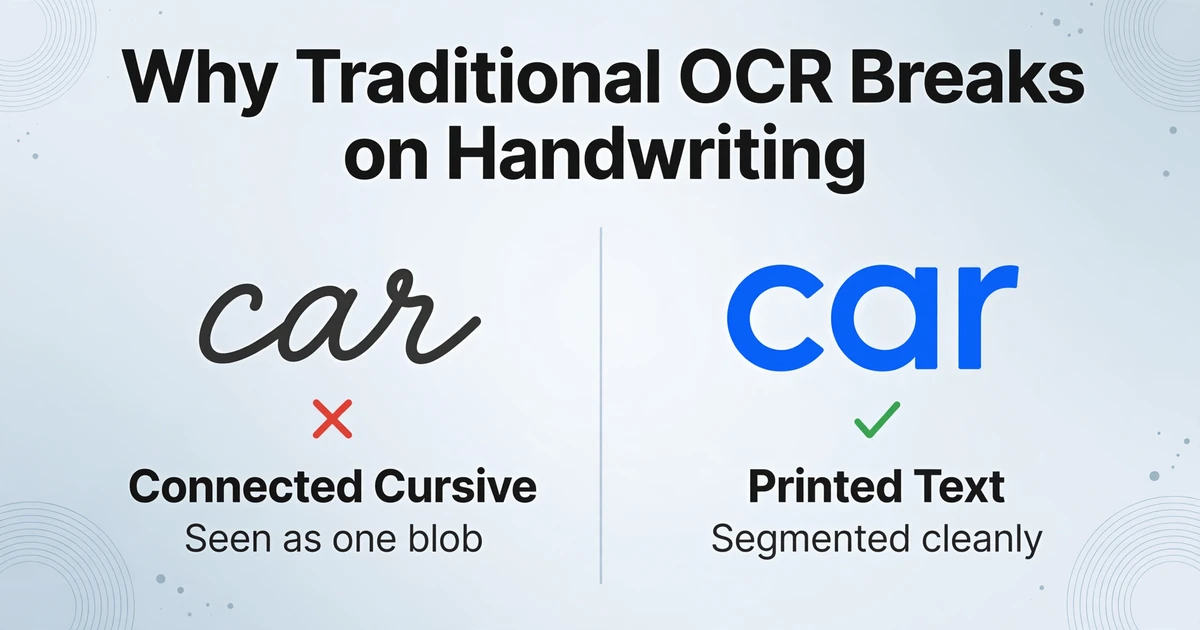
El OCR tradicional opera con un modelo de segmentación primero. El motor escanea una imagen, aísla cada carácter detectando los límites de los espacios en blanco y compara la forma aislada con una biblioteca de glifos conocidos. Este proceso funciona cuando los caracteres son predecibles: la "A" impresa en Arial se corresponde limpiamente con las plantillas de "A" en Arial almacenadas. Se derrumba cuando los caracteres se niegan a encajar en cajas predecibles.
Tres problemas estructurales convierten la escritura manuscrita en una pesadilla de segmentación para el OCR tradicional. Caracteres conectados: la escritura cursiva une letras adyacentes con ligaduras, lo que hace imposible que un algoritmo de detección de límites encuentre el espacio entre la "a" y la "r" en "car". El motor ve un glifo continuo donde un humano ve cuatro letras. Anchos de trazo variables: un bolígrafo presionado con fuerza en los trazos descendentes y con suavidad en los ascendentes produce variaciones de grosor de línea que fragmentan caracteres individuales en segmentos detectados separados. Un "5" se convierte en un bloque más un guion separado. Líneas base inconsistentes: las personas escriben en diagonal, se desvían hacia arriba en la página y varían la altura de las letras dentro de la misma palabra. El paso de detección de líneas que funciona con texto tipografiado falla cuando "apple" se escribe en un ángulo de 15 grados con la "p" hundiéndose bajo la línea base y la "l" elevándose por encima de ella.
La consecuencia posterior es una cascada. Un estudio de 2025 publicado en el International Journal of Computer Scientific Technology & Electronics Engineering encontró que la precisión del OCR tradicional en documentos manuscritos cae del 92% en texto impreso a mano limpio al 55% bajo degradación moderada y al 30% en condiciones severas, condiciones que apenas se registrarían como ruido para el procesamiento de texto impreso. Mientras tanto, el punto de referencia de escritura cursiva 2026 de AIMultiple, que probó 100 muestras en 14 modelos, encontró que los servicios tradicionales de OCR en la nube como Google Cloud Vision y Amazon Textract se sitúan entre el 50% y el 70% en cursiva, lo que significa que 30 a 50 palabras de cada 100 son incorrectas.
La comunidad de entrada de datos de Reddit ha documentado esta brecha durante años. Una discusión de 2024 en r/Automate sobre extraer datos de facturas manuscritas planteó el problema de manera sucinta: "Necesitas tomar no solo datos manuscritos, sino datos manuscritos no estructurados y darles sentido". La revisión de 2025 de la comunidad r/computervision sobre herramientas de OCR para escritura manuscrita señaló sin rodeos que la "precisión de escritura manuscrita (~65-85%) de los nuevos modelos de IA todavía va a la zaga de las soluciones especializadas para uso crítico en negocios". Estos son profesionales, no comercializadores. Sus números importan.
Cómo los modelos de visión por IA leen la escritura manuscrita como patrones visuales, no como secuencias de caracteres
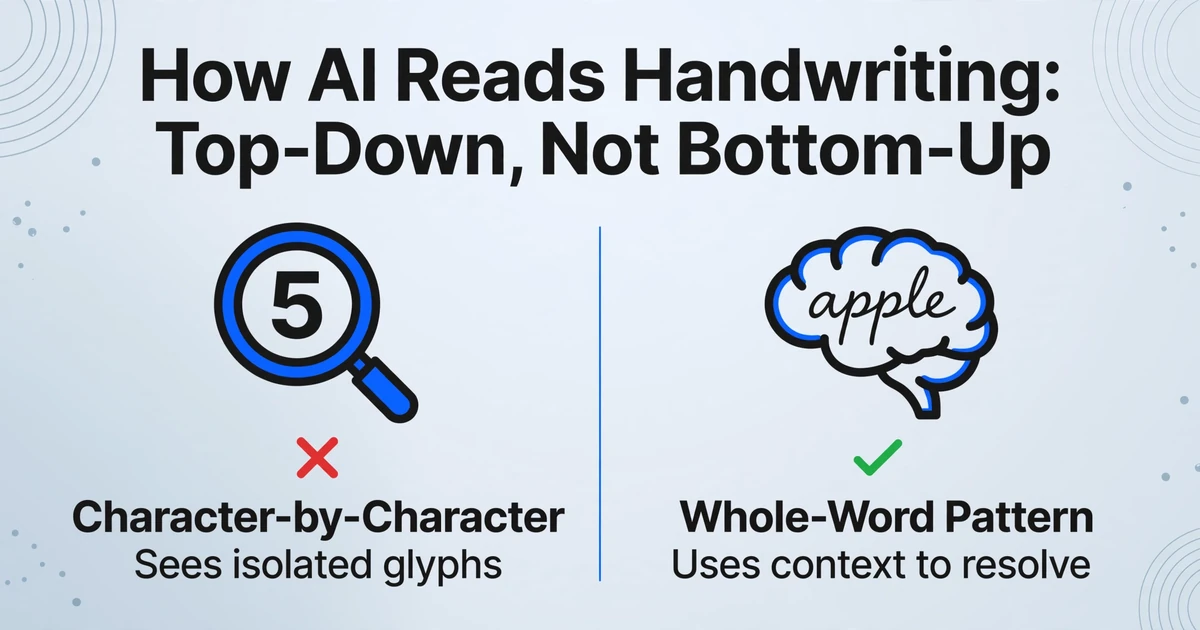
Los modelos de visión por IA — más precisamente, los modelos de visión y lenguaje como GPT-5, Gemini y Claude — no realizan segmentación de caracteres en absoluto. Procesan la imagen de forma holística, viendo formas de palabras completas como patrones visuales unificados, y luego interpretan esos patrones con el mismo modelo de lenguaje que comprende la oración en la que aparece la palabra. Esta es la inversión crucial: en lugar de construir palabras a partir de caracteres (de abajo hacia arriba), reconocen palabras como unidades visuales completas y usan la palabra comprendida para desambiguar las formas de letras individuales (de arriba hacia abajo).
La diferencia práctica es más fácil de ver en algo común: un campo de nombre en un formulario. Imagine una entrada manuscrita donde la pluma del escritor se levanta ligeramente en medio de "Sm_th," dejando un carácter tenue o faltante entre la "m" y la "t." El OCR tradicional, trabajando carácter por carácter, devuelve "Sm" más un glifo no reconocido más "th." El error se acumula — el nombre completo podría ser irreconocible en etapas posteriores. Un modelo de visión por IA ve la forma de la palabra "Sm_th" y el contexto circundante — este es el campo "Nombre" en un formulario, el nombre completo es "John Smith." El modelo de lenguaje completa el espacio desde el contexto, tal como usted lo haría si lo viera con sus propios ojos. El mismo mecanismo resuelve un "1" manuscrito de una "l" minúscula, un "0" de una "O," y un "4" manuscrito que parece un "9" — preguntándose: ¿qué tiene sentido aquí?
Por eso los modelos modernos de visión por IA superan drásticamente al OCR tradicional en escritura manuscrita. El punto de referencia de AIMultiple colocó a GPT-5 y Gemini 3 Pro Preview en la cima para el reconocimiento de escritura cursiva — no porque tengan mejores detectores de caracteres, sino porque leen el documento como lo haría una persona: comprendiendo lo que el texto significa, no solo cómo se ven sus píxeles. El mismo punto de referencia encontró a Google Cloud Vision en aproximadamente 63% en escritura cursiva. La brecha entre 95% y 63% es la brecha entre "utilizable con verificaciones puntuales" y "necesita reescritura manual completa."
Este enfoque semántico es lo que hace que la entrada de datos impulsada por IA sea sin plantilla por diseño. Usted escribe los nombres de las columnas que desea extraer — "Nombre del Empleado," "Horas Trabajadas," "Fecha" — y la IA localiza los valores manuscritos correspondientes a cada campo en cualquier parte de la página comprendiendo su significado. Sin coordenadas de píxeles. Sin plantillas por formulario. Sin reentrenamiento cuando cambia la escritura de alguien. Este es el mecanismo que llamamos Extracción de Columnas Personalizadas: usted define el esquema de salida nombrando las columnas que desea, y la IA asigna el contenido del documento a su esquema independientemente de dónde se encuentre cada valor manuscrito en la página.
Los archivos se procesan de forma segura y no se almacenan.
Impresión y escritura manuscrita combinadas: el formato de documento más común del que nadie habla
La mayoría de los documentos manuscritos del mundo real no son puramente manuscritos. Son formularios: una plantilla impresa con etiquetas, casillas e instrucciones, completada con bolígrafo. La etiqueta "Nombre del paciente:" está impresa en Helvetica. El valor "James Peterson" está escrito en cursiva a bolígrafo. Un motor de OCR tradicional, ajustado para impresión, lee la etiqueta perfectamente y falla en el valor, produciendo un documento donde el 80% del texto es correcto y el 20% que realmente necesitas falta.
Este formato de impresión más escritura manuscrita es donde los modelos de visión por IA muestran su mayor ventaja sobre la competencia. El modelo no cambia entre un "modo impresión" y un "modo escritura manuscrita". Lee la página como una única escena visual, reconociendo que "Nombre del paciente" es una etiqueta de campo (impresa, limpia) y que el garabato debajo es el valor del campo (manuscrito, desordenado), y asigna ambos a la columna de salida correcta. El contexto de la etiqueta impresa ayuda activamente al reconocimiento de escritura manuscrita: si la etiqueta dice "Número de teléfono", el modelo espera una secuencia de dígitos en el campo de valor, restringiendo el problema de reconocimiento. Si la etiqueta dice "Comentarios", el modelo espera oraciones completas y se ajusta en consecuencia.
Este formato aparece en todas partes. Formularios de admisión médica: preguntas demográficas impresas, respuestas manuscritas. Informes de inspección de campo: elementos de lista de verificación de seguridad impresos, observaciones manuscritas en la columna de notas. Confirmaciones de entrega: números de seguimiento impresos, firmas y marcas de tiempo manuscritas del receptor. Cotizaciones de proveedores: líneas de artículos impresas, ajustes de cantidad manuscritos. En todos estos casos, el cuello de botella del flujo de trabajo no es "leer el documento". Es "leer las partes manuscritas que contienen los datos procesables". El OCR tradicional te da el texto de la etiqueta gratis y te cobra caro por los valores. La visión por IA lee ambos en una sola pasada.
El concepto de leer etiquetas y valores en contexto no es solo una solución para escritura manuscrita: es la diferencia fundamental entre la precisión del OCR de IA y el OCR tradicional. El OCR tradicional ve "Fecha: 15/03/2026" como una cadena de caracteres. La extracción con IA ve una etiqueta de campo ("Fecha") con un tipo semántico (fecha de calendario) y coloca el valor en la columna correcta de la hoja de cálculo incluso cuando aparecen otras cinco fechas en la misma página, porque entiende qué fecha pertenece a qué etiqueta.
Casillas, Marcas y Círculos: Leer la Intención, No las Formas
Una casilla marcada en un formulario en papel puede adoptar cualquiera de estas formas: un relleno sólido, una línea diagonal, una X, una marca de verificación, una respuesta circulada, un tachado de la opción incorrecta, un doble subrayado bajo la correcta. Para un motor de OCR tradicional, nada de esto es texto — es ruido de imagen. El motor lo ignora o, peor, interpreta la marca como un carácter: una marca de verificación se convierte en una "V", una barra diagonal en "/", una opción circulada se lee como una "O" antepuesta al texto de la respuesta.
El problema se agrava en formularios estructurados. Una lista de verificación de inspección de seguridad con 20 casillas de Sí/No contiene 20 decisiones binarias que determinan el cumplimiento, la programación de mantenimiento o la responsabilidad. Si el motor interpreta mal 5 de 20, la automatización es peor que inútil — produce silenciosamente datos incorrectos que parecen correctos. Un campo marcado como "Seguro" se convierte en "Inseguro" porque el motor interpretó una marca ✓ como el carácter "V" junto a la opción equivocada.
Los modelos de visión por IA manejan las casillas de manera diferente porque operan sobre relaciones espaciales en lugar de detección de caracteres. El modelo identifica el texto de la pregunta ("¿Extintor inspeccionado?") y las opciones de respuesta ("Sí / No"), luego determina qué región de respuesta contiene una marca — cualquier marca. Una marca de verificación, una cruz, un círculo relleno, una línea garabateada: todo se registra como "esta opción está seleccionada". El modelo no necesita clasificar el tipo de marca. Clasifica la intención de selección — la conexión espacial entre la marca y la opción que modifica.
El equipo de Document AI de Google ha documentado este desafío directamente en sus foros de desarrolladores: los profesionales informan que la detección de casillas falla incluso con tamaños de casilla más grandes cuando los formularios pasan por flujos de imprimir-llenar-escanear. La recomendación — dimensiones de casilla de 12-15 mm — solo se aplica cuando usted controla el diseño del formulario. Para los miles de formularios existentes ya en circulación con casillas más pequeñas, la respuesta es un modelo de IA que lee la intención espacial en lugar de la geometría de la forma.
Lo que la IA aún no puede leer de forma fiable
Ser honestos sobre las limitaciones es lo que hace creíble el caso de la extracción de escritura manuscrita con IA. Esto es lo que todavía falla.
Escritura muy superpuesta. Cuando una línea de escritura manuscrita está escrita directamente encima de otra — algo común en libros de contabilidad donde se hacían correcciones escribiendo sobre la entrada original — tanto el OCR tradicional como los modelos de visión por IA tienen dificultades. El modelo ve una sola mancha visual donde hay dos capas de significado. Una persona con contexto sobre la historia del documento podría separarlas. La IA actual no puede.
Firmas extremadamente estilizadas. Las firmas funcionan como marcas de identidad, no como texto legible. Son patrones intencionalmente únicos que combinan adornos, bucles ilegibles y glifos personales. Los modelos de IA detectan que una firma está presente — pueden identificar la región de la firma en un documento — pero no extraen el nombre del firmante a partir de la forma de la firma en sí. El nombre debe aparecer en texto impreso o manuscrito en otra parte del documento.
Lápiz tenue sobre fondos oscuros. El lápiz sobre papel de copia, escaneado con bajo contraste, produce trazos de texto que apenas se distinguen del grano del papel. Una encuesta académica de 2025 sobre técnicas de reconocimiento de escritura manuscrita señaló que la "robustez frente al ruido" sigue siendo uno de los problemas clave sin resolver — "los investigadores deberían seguir investigando métodos que aumenten la resiliencia de los sistemas OCR" ante condiciones del mundo real subóptimas. Esto se aplica tanto a los sistemas tradicionales como a los basados en IA.
Escrituras no latinas. El rendimiento depende en gran medida del modelo. GPT-5 y Gemini funcionan bien con escrituras principales, incluidos los caracteres árabes, devanagari y chinos — particularmente cuando el modelo ha sido entrenado con esos sistemas de escritura. Los modelos más pequeños o especializados pueden funcionar bien con la escritura cursiva latina, pero se degradan notablemente con otros sistemas de escritura. Si sus documentos incluyen texto manuscrito en varias escrituras, pruebe el modelo específico con sus documentos antes de comprometerse — el reconocimiento de escritura manuscrita entre escrituras no está resuelto de manera uniforme.
Documentos históricos con papel deteriorado. Los documentos con traspaso de tinta (tinta del reverso visible a través del papel), foxing (manchas de edad), daños por agua o bordes rasgados introducen artefactos visuales que confunden tanto el reconocimiento a nivel de carácter como el holístico. El benchmark de AIMultiple encontró que incluso los modelos con mejor rendimiento pierden 10-15 puntos porcentuales cuando la condición del documento se deteriora. La digitalización de calidad de archivo puede requerir herramientas especializadas y procesos de preprocesamiento separados que las herramientas generales de extracción con IA no incluyen.
Flujos de trabajo reales donde la extracción de escritura manuscrita es importante
La tecnología solo importa donde cambia un flujo de trabajo real. Estos son los escenarios donde pasar de la reentrada manual a la extracción de escritura manuscrita con IA produce ahorros de tiempo medibles.
Hojas de horas manuscritas. Cuadrillas de construcción, técnicos de servicio de campo y trabajadores por turnos llenan hojas de horas en papel — nombres, fechas, horas, códigos de trabajo — a menudo con letra apretada y desordenada al final de un turno. Un gerente de nómina que procesa 80 hojas de horas por semana gasta aproximadamente 3 minutos por hoja en entrada manual de datos: leer cada campo, escribirlo en el sistema de nómina, verificar el total. Eso son 4 horas por semana — una mañana completa — dedicadas a volver a escribir escritura manuscrita. Con la extracción con IA, las mismas 80 hojas de horas se suben como un lote, se extraen en una sola hoja de cálculo con columnas llamadas "Nombre del empleado," "Fecha," "Horas," "Código de trabajo," y se exportan en menos de un minuto. El rol del gerente pasa de entrada de datos a gestión de excepciones: verificar las 5-10 entradas donde la escritura manuscrita era genuinamente ambigua.
Bajo la Sección 11(c) de la FLSA, los empleadores deben conservar registros de nómina precisos, incluyendo horas trabajadas y salarios pagados. Los errores de hojas de horas manuscritas que llegan a la nómina crean exposición al cumplimiento — y corregirlos después es más costoso que detectarlos durante la entrada.
Formularios de inspección de campo. Inspectores de seguridad, auditores de calidad y supervisores de sitio llenan listas de verificación en papel en el campo — a menudo en un portapapeles, bajo la lluvia, con un bolígrafo quedándose sin tinta. Cada formulario contiene casillas de verificación (equipo aprobado/rechazado), lecturas numéricas manuscritas (presión, temperatura, voltaje) y notas de texto libre (observaciones, acciones correctivas). Procesar 50 formularios de inspección manualmente toma un día laboral completo. Con entrada de datos con IA sin código, el mismo lote se extrae en minutos — los estados de las casillas, las lecturas numéricas y las notas narrativas fluyen cada uno a sus propias columnas de hoja de cálculo. El informe de cumplimiento que solía tomar la tarde del viernes está listo para el viernes por la mañana.
Formularios de admisión de pacientes. Una clínica médica procesa 60 formularios de admisión de pacientes nuevos por día — historial médico, medicamentos actuales, listas de alergias, detalles de seguro — todos escritos a mano por los pacientes en una sala de espera. El personal de recepción ingresa manualmente cada formulario en el sistema EHR, un proceso que toma 5-7 minutos por formulario e introduce errores de transcripción mientras el personal alterna entre escritura manuscrita ilegible y bases de datos de terminología médica. La extracción con IA lee los campos manuscritos y los asigna a las categorías correctas de datos del EHR — "Nombre del medicamento," "Dosis," "Frecuencia" — mientras marca cualquier valor con baja confianza para verificación humana antes de que entre al registro del paciente.
Libros de contabilidad manuscritos y talonarios de recibos. Las pequeñas empresas — camiones de comida, vendedores de mercado, contratistas independientes — a menudo mantienen libros de contabilidad manuscritos. El talonario de recibos con copia carbón de un vendedor contiene cientos de entradas: fechas, descripciones de artículos, montos, nombres de clientes, todo en bolígrafo. En la temporada de impuestos, estos deben digitalizarse. El OCR tradicional produce basura en papel de copia carbón — el texto tenue y azulado confunde la detección basada en contraste. Los modelos de visión por IA, entrenados en diversas imágenes del mundo real, leen las entradas entendiendo la página como una escena — el texto tenue, la textura del papel, el patrón de diseño de filas y columnas — en lugar de umbralizar píxeles en blanco y negro.
Confirmaciones de entrega. Las empresas de logística reciben confirmaciones de entrega firmadas: detalles de envío impresos con nombres de destinatarios escritos a mano, marcas de tiempo y notas sobre el estado. El nombre del destinatario escrito a mano es el registro legal que prueba la entrega. La extracción con IA obtiene el nombre del destinatario y la marca de tiempo del formulario, completando la base de datos de confirmaciones de entrega sin necesidad de reescribirlos manualmente.
Tarjetas de recetas escritas a mano y registros personales. No todos los documentos escritos a mano son trámites de negocios. Una tarjeta de receta familiar combina notas en escritura cursiva, cantidades fraccionarias («1½ tazas») y abreviaturas en un formato que ningún diseñador de formularios planeó. La misma extracción semántica que lee una nota de campo lee la tarjeta de receta escrita a mano en una foto, devolviendo ingredientes, cantidades e instrucciones como columnas de hoja de cálculo en lugar de una página reescrita a mano.
Expectativas de precisión: qué significa 85-95 % en escritura manuscrita en producción
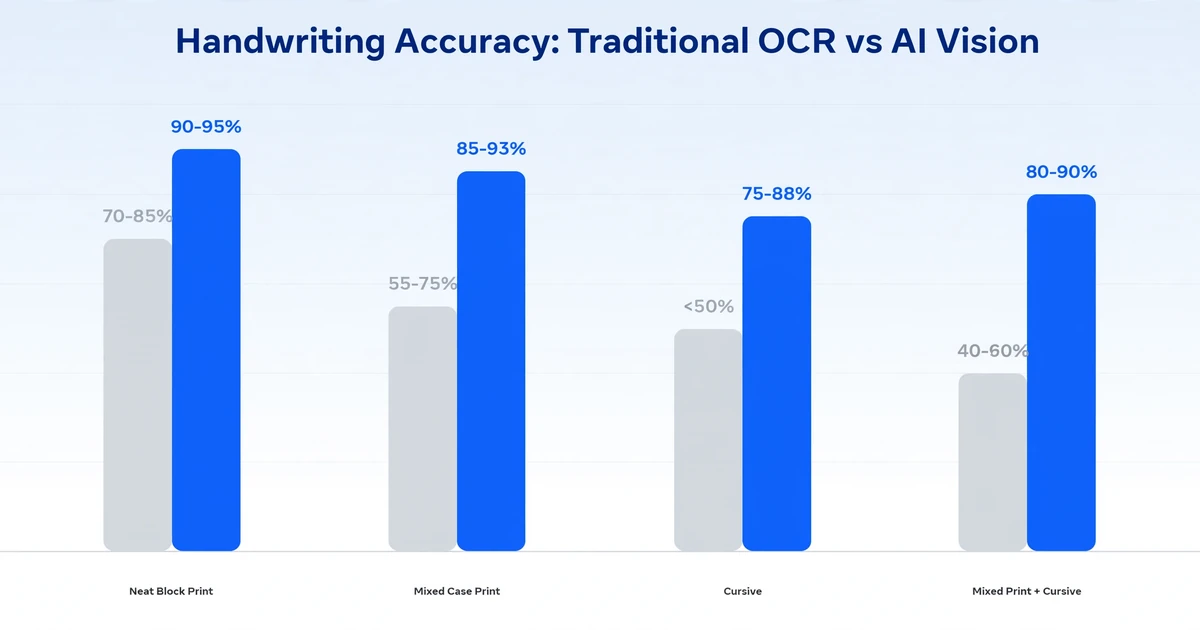
La aclaración estándar de precisión de la industria de la IA —«hasta 99 % en texto impreso»— genera una expectativa que no se traslada a la escritura manuscrita. La precisión en escritura manuscrita es un número fundamentalmente distinto en una escala fundamentalmente distinta. Esto es lo que deberías esperar realmente.
| Estilo de escritura manuscrita | OCR tradicional | Modelo de visión por IA | Resultado práctico |
|---|---|---|---|
| Letra de molde clara (todo en mayúsculas) | 70-85 % | 90-95 % | Verificar 1 de cada 10 campos |
| Letra de molde con mayúsculas y minúsculas | 55-75 % | 85-93 % | Verificar 1 de cada 7 campos |
| Escritura cursiva | Menos del 50 % | 75-88 % | Verificar 1 de cada 4 campos |
| Mezcla de letra de molde y cursiva | 40-60 % | 80-90 % | Verificar 1 de cada 5 campos |
| Degradada / bajo contraste | Menos del 30 % | 65-80 % | Extracción de mejor esfuerzo; se espera revisión humana |
Fuentes: evaluación comparativa de escritura cursiva de AIMultiple (2026); estudio de precisión de OCR tradicional frente a IA de IJCSTEE (2025); evaluación comparativa en el mundo real entre servicios de OCR en la nube. Todas las cifras reflejan precisión a nivel de campo — si el valor extraído en la hoja de cálculo coincide con el original manuscrito —, no precisión a nivel de carácter.
El número más importante de esta tabla no es ninguna cifra de precisión individual. Es la proporción entre el tiempo de extracción con IA y el tiempo de verificación manual. En 100 hojas de tiempos manuscritas con letra de imprenta clara, la extracción con IA tarda menos de 30 segundos y produce aproximadamente 5-10 campos que requieren verificación — una revisión humana de 3 minutos. La entrada manual de las mismas 100 hojas: aproximadamente 300 minutos. La precisión de la IA no necesita ser del 100% para lograr una reducción de tiempo superior al 90% — solo necesita ser lo bastante alta para que la verificación sea más rápida que volver a teclear desde cero.
Esto es lo que hace que la conversación sobre precisión sea práctica y no académica. La precisión de la entrada de datos con IA no consiste en alcanzar una cifra de marketing. Se trata de cruzar un umbral en el que el costo de verificar la salida de la IA cae por debajo del costo de la entrada manual. Para texto impreso, ese umbral se cruzó hace años. Para escritura de imprenta clara, se cruzó con los modelos de visión de nivel GPT-4. Para escritura cursiva desordenada, se cruza ahora — pero el paso de verificación no es negociable.
Preguntas frecuentes
¿Puede el OCR con IA leer cualquier estilo de escritura manuscrita?
No cualquier estilo — pero sí la mayoría de los estilos comunes. La letra de imprenta clara y la letra mixta alcanzan una precisión de campo del 85-95% en los modelos de visión por IA actuales. La escritura cursiva alcanza el 75-88%. La escritura muy estilizada, superpuesta o extremadamente desordenada puede caer por debajo del 70%. Si usted mismo no puede leerla con confianza a partir de un escaneo, es probable que la IA tampoco pueda. El enfoque práctico: cargue todo por lotes, deje que la IA extraiga lo que pueda y revise manualmente solo las entradas de baja confianza.
¿La IA maneja casillas de verificación y elementos de formulario, o solo texto?
Los modelos de visión por IA manejan casillas de verificación, botones de opción, selecciones circuladas y otros elementos de formulario al leer la intención espacial en lugar de las formas de los caracteres. Una marca, cruz, relleno o círculo junto a una opción se registra como "seleccionado". Esto funciona mejor cuando el diseño del formulario es claro: áreas de respuesta distintas con separación espacial visible de las opciones vecinas. Las casillas de verificación muy juntas en formularios densos pueden generar ambigüedad que requiere verificación humana.
¿Cuál es la diferencia entre el reconocimiento de escritura manuscrita por IA y el ICR tradicional?
El ICR tradicional (Reconocimiento Inteligente de Caracteres) extiende el OCR con aprendizaje automático entrenado en conjuntos de datos de escritura manuscrita, pero aún opera en el modelo de segmentación de caracteres: aísla letras individuales y las clasifica. Los modelos de visión por IA omiten la segmentación por completo, leyendo formas de palabras completas como patrones visuales y usando el contexto del lenguaje para resolver caracteres ambiguos. La diferencia práctica: el ICR funciona con letras de molde ordenadas pero se degrada con la escritura cursiva; la visión por IA funciona con ambas, con una caída de precisión menor entre ellas.
¿Puedo procesar documentos manuscritos e impresos en el mismo lote?
Sí. Los modelos de visión por IA leen cada documento como una escena: no necesitan saber de antemano si el texto es impreso o manuscrito. El mismo lote puede contener facturas mecanografiadas, hojas de tiempo manuscritas y formularios de inspección de formato mixto. El modelo adapta su estrategia de lectura por documento, no por lote. Esta es una distinción clave frente a los flujos de OCR tradicionales, que a menudo requieren configuración separada para entrada impresa vs. manuscrita.
¿La extracción de escritura manuscrita está disponible en idiomas distintos del inglés?
Depende del modelo. GPT-5 y Gemini funcionan bien con los principales idiomas de alfabeto latino (francés, español, alemán, portugués) tanto en forma impresa como manuscrita. Los alfabetos no latinos (árabe, devanagari, chino, japonés, coreano) dependen más del modelo: pruebe con sus documentos específicos antes de comprometerse. La variación del estilo de escritura en sistemas de escritura basados en caracteres (chino, japonés) introduce desafíos de reconocimiento diferentes a los de la cursiva latina, y las expectativas de precisión deben calibrarse en consecuencia.
Pruebe la extracción con sus propios documentos antes de construir un flujo de trabajo en torno a ella. La brecha entre una muestra de demostración ordenada y la escritura manuscrita real de su equipo es donde vive el número real de precisión.