2026年 法律文書向けOCR:
契約書・eDiscoveryデジタル化ガイド
国際法務技術協会の2025年テクノロジー調査(15万2,000人以上の弁護士を擁する580の法律事務所を対象)によると、76%がクラウドベースの文書管理システムを導入している一方で、文書ワークフローを完全にデジタル化していると回答したのはわずか31%でした。このギャップは、技術の可用性の問題ではありません。文字を読み取るだけの汎用OCRツールと、法律文書特有の要件(ベーツ番号付きのページ連番、複数カラムのブリーフ、80ページに及ぶ合併契約書のページをまたぐ条項、ABA Model Rules 1.1および1.6が課す倫理的義務)との間の構造的なミスマッチです。本ガイドでは、法律文書向けOCRに実際に求められるもの、特有の課題を生む文書タイプ、コンプライアンス対応の評価方法、そしてAIを活用した抽出が何を可能にするかについて解説します。
重要ポイント
- 年間250労働日のうち188日が、契約書の分析ではなく条項の検索に費やされています — 1,300人以上の契約実務担当者を対象としたCLOCのデータによるものです。
- 文字認識精度99.5%でも、OCRが複数カラムのブリーフを単一の破損したテキストストリームに平坦化してしまい、連邦判事がFRCP Rule 34に基づき「合理的に使用可能」ではないと判断する場合には無意味です。
- 座標テンプレートの照合ではなく、条項の意味を理解して免責上限を特定するAI OCRにより、契約ポートフォリオ分析が500ファイルにわたるクエリとなり、1件ずつの手動検索が不要になります。
法律業界にOCRが必要な理由 — 数値で見る実態
OCR技術が法務市場に登場したのは数十年前で、当時は書類スキャンユーティリティとしてでした。紙のファイルをPDFに変換し、検索可能にして、キャビネットの収納スペースを減らす。その用途は今や当然のものとなっています。法務文書ワークフローの量と複雑さは、単純な文字認識モデルの域を超えており、その理由は数字が物語っています。
eDiscoveryだけでも驚異的なボリュームが発生します。業界のベンチマークによると、訴訟におけるカストディアン1名あたり平均5GBの電子的に保存された情報(ESI)が生成され、これはカストディアン1名あたり約25万ページに相当します。20名のカストディアンが関与する中規模の商業紛争では、潜在的開示対象資料が500万ページ発生します。FRCP Rule 26(b)(1)は、開示を「事案のニーズに比例する」情報に制限していますが、比例性によって範囲内のすべてを処理・検索する必要性がなくなるわけではありません。スキャン文書から利用可能なテキストを保持するOCRがなければ、その何百万ページもの資料は検索できないだけでなく、レビューチームにとって実質的に見えないものになります。Digital War Room 2025ベンチマーク(2,000件の案件にわたる1億5,000万文書に基づく)は、平均1GBに5万文書が含まれることを確認しており、業界調査によると訴訟案件の99.9%が現在ESIを伴います。
契約レビューの時間は、分析ではなく検索に支配されています。1,300人の契約専門家を対象としたCLOC調査では、1件の契約書内の特定の条項を見つけるのに平均2時間以上かかることが判明しました。適切な文書を特定するのに45分、該当箇所を特定するのにさらに84分かかります。年間500件の契約を扱う法務部門では、250労働日のうち188日が法的分析が始まる前の検索に費やされることになります。World Commerce & Contractingは、署名済み契約書内に存在しながらフィルタリング可能なスプレッドシートに到達しない契約データによって失われる年間収益の影響を9.2%と試算しています。
法律事務所の間接費は文書処理時間に連動します。IAALSによる2025年の調査では、弁護士の59%が労働時間の3分の1以上を文書管理業務に費やしていると報告しています。1時間あたり$400〜$1,200の請求レートは、手動による文書処理の1分1分がクライアントまたは事務所の収益への直接的なコストとなることを意味します。弁護士数で法務市場の66%を占める個人事務所および小規模事務所の実務家にとって、文書処理による利益率への圧力は存亡の危機です。裁判所提出書類、契約書、開示文書への手動データ入力に費やす時間は、受任できる案件数を直接制限します。
これらの指標には共通の根源があります。法的データは、弁護士が必要とするレベルで機械可読ではない文書の中に存在するということです。OCRは変換レイヤーですが、それは法務文書が構造的に何を必要とするかを理解した場合に限ります。単にページ上にどの文字が表示されているかだけではありません。この技術の基礎となる概念については、OCRが実際に行うことと、法務ワークフローが最終的に必要とする文書抽出との違いをご覧ください。
法律文書の種類とOCRの課題
法律文書は構造が大きく異なりますが、請求書や領収書よりも汎用OCRでは処理が難しい共通の特徴があります。それは、意味がテキスト内容だけでなく、レイアウト、順序、相互参照に依存する点です。合併契約書をページごとに分割することは、デジタル化ではなく、情報の破壊です。
契約書 — 意味が分散する複数ページの合意文書
一般的な商事契約書は20~80ページに及びます。雇用契約書は5~15ページ程度です。別紙や修正条項を含むベンダーMSAは100ページを超えることもあります。法律チームがこれらの文書から必要とするデータ(相手方の名称、発効日、準拠法、補償上限、更新条件、都合による解約)は、1ページ目から78ページ目まで文書全体に散らばっています。発効日は前文にあります。準拠法条項は通常「一般条項」セクション、多くの場合署名欄の前の最後の実質条項にあります。補償上限は、第12条で参照されている別紙に記載されているものの、物理的には20ページ後ろにあるかもしれません。
各ページを独立して処理する汎用OCRは、ページをまたぐすべての関係を断ち切ります。14ページで始まり15ページで終わる条項は、2つの断片に分割されます。22~24ページにわたる支払いマイルストーンの表は、改ページで行の連続性を失います。79ページの署名欄は、1ページに記載された契約当事者名とリンクしません。法律文書向けOCRは、文書レベルのコンテキストを追跡する必要があります。つまり、全ページを読み通し、相互参照を維持し、3ページの第1.2項で導入された定義用語が47ページでの使用を規定することを認識する必要があります。
ベイツ番号はさらに別のレイヤーを追加します。提出された文書の各ページには、訴訟全体を通じて証拠識別子として機能する固有のベイツ番号が付与されます。「IMG_000123」を無関係なフッターテキストとして読み取ったり、完全に省略したりする標準的なOCRは、証拠の連鎖を断ち切ります。FRCP規則34(b)は、請求側が提出形式を指定することを認めており、ベイツ番号は事実上の標準です。これを保持しないOCRは、「合理的に使用可能な形式」の要件を満たさない文書を生成します。
裁判所提出書類と準備書面 — マルチカラム形式と引用構造
控訴趣意書、法律意見書、申立書は、各地の裁判所規則およびFRCPが定める厳格な書式ルールに従います。多くの司法管轄区では2段組が標準であり、広い段に本文、狭い段に判例引用や注釈を配置します。ページ全体を左から右に読み取る汎用OCRは、引用段を文の途中に結合し、単に乱雑なだけでなく法的に誤解を招くテキストを生成します — 準備書面が実際に主張するものとは異なる論点に属するように見える判例引用が生じます。
引用認識ももう一つの専門的要件です。法律文書はピンポイント引用に依存します — 「Smith v. Jones, 123 F.3d 456, 460 (9th Cir. 2025)」 — ここでコンマ後のページ番号は先例としての重みを持ちます。OCRがピンポイントページを失うか、周囲のテキストに結合すると、すべての訴訟実務家が依存する引用チェックワークフローが破綻します。カリフォルニアスタイルマニュアルおよびブルーブックの引用形式は、文字レベルのOCRでは捕捉できない構造的複雑さを追加します。
手書き注釈が課題をさらに複雑にします。裁判官やパートナーは準備書面の草稿に余白に注釈を書きます。パラリーガルは手書きの付箋でセクションにフラグを立てます。相手方弁護士からの裁判所提出書類には、取り消し線編集、丸で囲まれた段落番号、余白のイニシャルが含まれる場合があります。従来のOCRは手書きを完全にスキップするか、信頼性の低い文字推測を生成します。AIベースのOCRはクリーンな画像で85~95%の精度で手書きを処理します — 法的論点に関する実質的なフィードバックを含むことが多い余白注釈を捕捉するのに十分です。
eDiscovery文書 — 大規模な可変品質
eDiscovery文書群は定義上、異種混合です:電子メール、PDF、スキャンされた書簡、物理文書のスマートフォン写真、テキストメッセージ、スプレッドシート、プレゼンテーションファイル — すべてが単一のプロダクションセットに混在します。標準的な商事事件のRelativity処理レポートでは、40%がネイティブ電子ファイル、35%がスキャン紙文書、15%が様々な形式の電子メール添付ファイル、10%がレガシーメディア(古いWordPerfectファイル、スキャンファックス、マイクロフィッシュ変換)を示す場合があります。
各形式サブセットは異なるOCR障害モードを示します。何十年も前の事件ファイルからのスキャン紙文書は、低解像度、傾き、または退色している可能性があります。物理文書のスマートフォン写真は、遠近歪み、グレア、不均一な照明をもたらします。ファックス文書は200 DPIに低下し、文字認識アルゴリズムを混乱させる圧縮アーティファクトがあります。eDiscoveryのためのOCRパイプラインは、文書ごとの品質チェックを必要とせずにこの可変入力を処理する必要があります — 500万ページでは、各ページを個別にチェックすることは実行不可能だからです。
特権ログ作成は、OCRの失敗が専門的に重大な結果をもたらす場面です。特権ログでは、弁護士依頼者間秘匿特権または弁護士業務成果物保護の対象となるすべての文書を特定し、日付、作成者、受信者、件名を抽出し、特権根拠を記録する必要があります — すべてプロダクション前に行います。スキャンされた電子メールで「PRIVILEGED AND CONFIDENTIAL」ヘッダーを見逃すか、メタデータフィールドの法律事務所名を誤読するOCRは、権利放棄リスクを生み出します。FRCPは完全な特権特定を要求していませんが、Rule 26(b)(5)(A)は提出当事者に「差し控える文書の性質を説明する」ことを要求しています — これは文書の主要な識別情報の正確なOCRを前提とする基準です。
これらの文書タイプに共通する課題は、法的文書のOCRが失敗する理由が、文字の誤認識だけではないということです(もちろん誤認識も起こりますが)。むしろ構造が失われることが本質的な問題です。ベーツ番号がページから切り離される、条項がページ区切りで分割される、特権表示が本文として扱われる、複数カラムのブリーフが単一カラムの流れに平準化される——こうした構造の破壊が問題です。文字精度99.5%を達成しても文書構造を破壊する法的OCRツールの出力は、役に立たないどころか、職業上の危険すら伴います。
法的文書における従来型OCRとAI OCRの比較
従来型OCRとAI駆動型抽出の違いは、法的ワークフローにとって学術的な問題ではありません。前節で説明した構造的な複雑さをツールが処理できるかどうか、それとも毎回手作業での修正が必要になるかを左右する問題です。
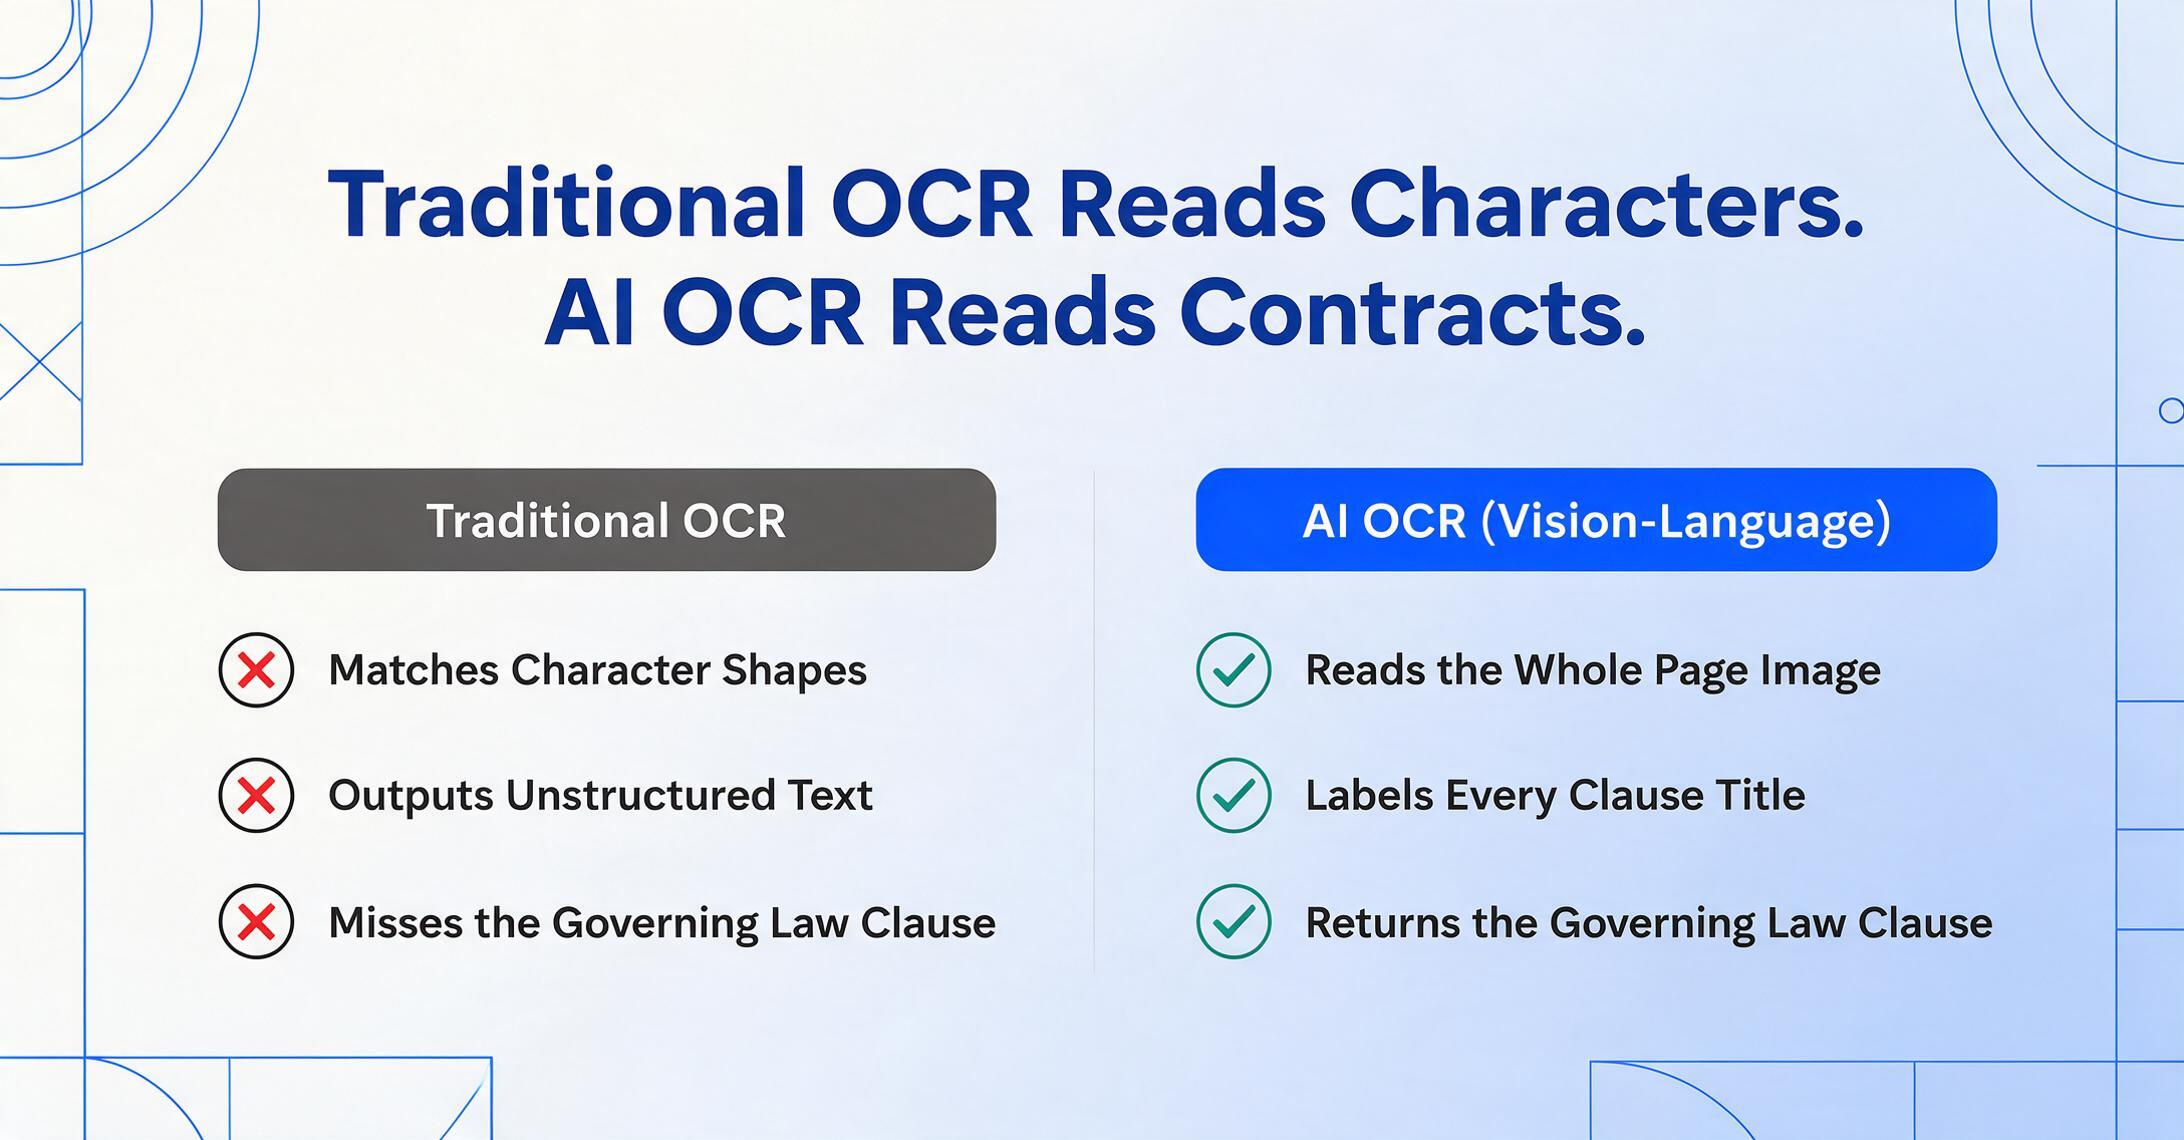
従来型OCR — 文字認識パラダイム。Tesseract、ABBYY FineReader、文書スキャナに組み込まれたOCRエンジンなどのツールは、ピクセルから文字へのパイプラインで動作します。ページ上の形状を識別し、既知の文字パターンのライブラリと照合し、テキストを出力します。出力は検索可能なPDFまたはプレーンテキストファイルで、文字が読み順に並ぶだけで、意味的な構造はありません。これはスキャンした契約書を全文検索可能にするには十分ですが、準拠法条項、賠償責任の上限、更新通知期間を個別のデータポイントとして抽出するには不十分です。なぜなら、ツールは準拠法条項が何であるかを理解していないからです。
AI OCR — ビジョン言語パラダイム。現代のAIベースの抽出は、人間の読者のようにページを読むビジョン言語モデル(VLM)を使用します。つまり、視覚的・全体的・意味的に読むのです。文字を一つずつ認識するのではなく、文書画像全体を処理し、テキストの領域を特定し、その機能的役割(ヘッダー、本文、条項タイトル、署名欄、欄外注釈)を判断し、文字だけでなく意味を抽出します。このアーキテクチャの詳細については、AI OCRとは何か、従来の文字認識とどう違うのかをご覧ください。
法律実務において、このアーキテクチャの違いは具体的な運用上の違いを生み出します。
| 要件 | 従来のOCR | AI OCR(視覚言語モデル) |
|---|---|---|
| ベイツ番号の保持 | ノイズ文字として扱い、多くは削除または統合 | ページ識別子をパターン認識し保持 |
| 条項単位の抽出 | 全テキストを順次出力、条項識別なし | 意味的役割に基づき条項境界を識別 |
| マルチカラムの書面 | 左から右へ横断、読み順が崩れる | 視覚的レイアウト解析でカラムを認識し読み順を保持 |
| ページ跨ぎの表の連続性 | 各ページを独立処理、行がページ端で途切れる | 文書全体のコンテキストを維持、表をページ跨ぎで再構成 |
| 手書き注釈 | 筆記体の精度は通常40%未満 | 明瞭な手書きで85~95% |
| 秘匿指定の検出 | 本文として読み取り、フラグなし | 秘匿ヘッダーをパターン認識しレビュー対象としてフラグ |
| テンプレート不要の運用 | フォーマットごとにゾーン定義が必要 | 設定不要で複数フォーマットに対応 |
法律業務で最も重要なパラダイムはカスタムカラム抽出です。「免責上限」「準拠法」「更新通知期間」「責任制限」など、出力に必要なカラムを定義するだけで、AIが全文書の全ページを読み取り、各フィールドに対応するテキストブロックを意味的役割から特定し、該当する出力カラムにマッピングします。ゾーン設定も、取引先ごとのテンプレートも、契約書ごとに異なる表現の条項定義を手動で調整する作業も不要です。これは位置ベースの抽出から意味ベースの抽出への転換であり、従来のツールでは契約書やeDiscovery処理が不釣り合いに高コストだった原因であるフォーマットの多様性に直接対応します。
法律文書から抽出すべき主要フィールド
法務チームが抽出する必要があるものは、デューデリジェンス、契約ポートフォリオ管理、eDiscoveryレビュー、訴訟支援など、ユースケースによって異なります。しかし、ほとんどの法的抽出ワークフローは、文書の目的に応じて整理された中核的なフィールドセットに収束します。
契約書および協定書の場合
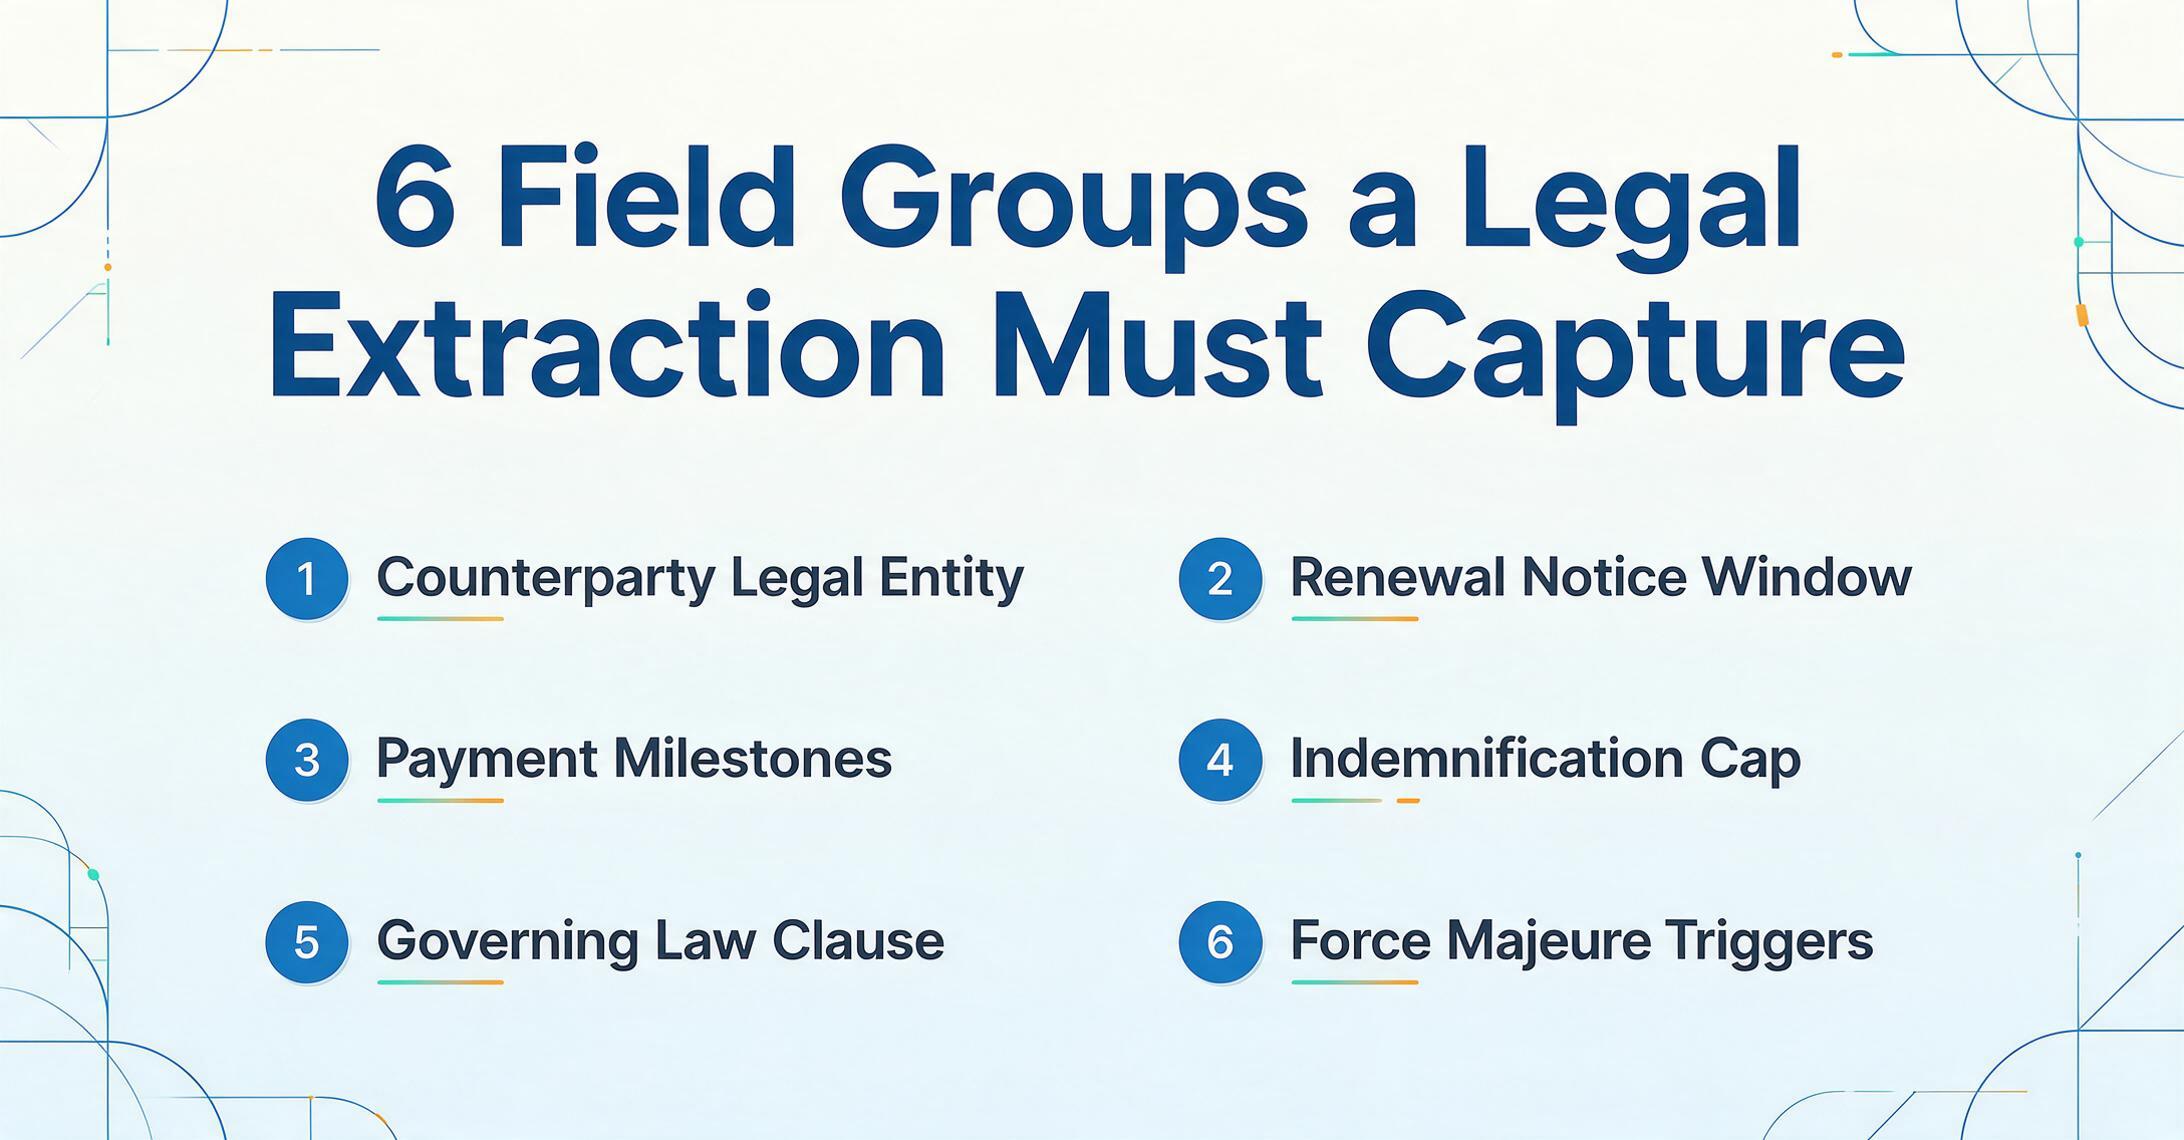
| フィールドカテゴリ | 具体的なフィールド | 重要である理由 |
|---|---|---|
| 当事者の特定 | 相手方の名称、契約締結主体、設立管轄地 | 1つの相手方が複数の子会社を通じて契約する場合があり、執行のためには正しい法的エンティティを特定することが重要です |
| 日付とタイミング | 発効日、失効日、更新通知期間、都合による終了の猶予期間 | 自動更新の罠と終了通知期間の逸失は、契約上の責任の主な原因です |
| 金銭的条件 | 契約金額、支払いスケジュール、価格調整メカニズム、延滞料金の条件 | 料金スケジュールは付属の表にまたがることが多く、抽出は相互参照を追跡する必要があります |
| リスク配分 | 補償の範囲と上限、責任の制限、結果的損害の除外 | これらの条項は金銭的エクスポージャーを決定します。「上限なしの補償」は、すべてのレビューにおける要注意フィールドです |
| 準拠条項 | 準拠法、紛争解決(仲裁 vs. 訴訟)、裁判地、陪審裁判の放棄 | 紛争がどこでどのように解決されるかに直接影響します。通常は一般条項セクションの単一の条項です |
| 運用条項 | 不可抗力の発生事由、競業避止の範囲と期間、秘密保持期間、データ保護義務 | 契約締結後の履行義務であり、事業運営に直接影響を与えます |
| 終了 | 解除事由による終了、都合による終了、終了後の義務、存続条項 | 終了条件は、関係終了のコストと、終了後に継続する義務の両方を定義します |
eDiscoveryおよび訴訟文書向け
- 文書識別子:ベーツ番号範囲、カストディアン名、ソース案件番号、作成日 — このメタデータは、FRCP Rule 34(b)に基づき提出文書を利用可能にするために最低限必要な情報です。
- 特権表示:「PRIVILEGED AND CONFIDENTIAL」「ATTORNEY WORK PRODUCT」「ATTORNEY-CLIENT PRIVILEGE」— 提出前に認識およびフラグ付けが必要なヘッダー、フッター、スタンプです。
- 主要な関係者と日付:作成者(メールヘッダーまたは署名ブロックから)、受信者(可能な場合はCCおよびBCCを含む)、作成日、送信日、提出日 — 証拠のタイムライン作成や証人準備に使用されます。
- 文書タイプの分類:契約書、メール、メモ、ブリーフ、スプレッドシート、ボイスメールの文字起こし、SMS書き出し — レビューチームが各カテゴリに適切なワークフローを適用できるよう、文書を大規模に分類します。
- 墨消し領域:墨消し(黒塗りまたは白塗り)された文書の領域、その位置と範囲 — 処理中に墨消しを保持およびマッピングし、提出の完全性を確保する必要があります。
条項レベルの抽出についてさらに詳しく知りたい場合は、法的契約書の抽出に関するガイドと、デューデリジェンスおよびポートフォリオ管理における条項識別がフィールドレベルの抽出とどのように異なるかをご覧ください。
法的OCRにおけるコンプライアンス考慮事項
法律実務におけるOCRは、単なる技術的な決定ではなく、コンプライアンス上の決定です。3つの規制枠組みが、法律事務所がデジタル化された文書をどのように取り扱うかを直接規定しています。
ABA Model Rules:テクノロジーコンピテンスと機密性
ABA Model Rule 1.1(コンピテンス)— ABA Formal Opinion 477R(2017年)によって明確化 — は、弁護士に対し「関連するテクノロジーの利点とリスクを含め、法律およびその実務の変化について最新の情報を把握する」ことを求めています。これは、クライアント文書の処理にOCRを使用する弁護士が、そのツールの精度の限界、データ処理手順、または構造保持機能を理解せずに使用した場合、コンピテンス基準を下回る業務を行っている可能性があることを意味します。この規則は完璧なOCRを要求するものではありませんが、クライアント案件で使用するテクノロジーの情報に基づく選択と適切な監督を要求しています。
ABA Model Rule 1.6(情報の機密性)は、弁護士に対し「クライアントの代理に関する情報の偶発的または不正な開示、またはアクセスを防止するための合理的な努力を行う」ことを求めています。特権資料、営業秘密、または個人識別情報を含む文書をOCRが処理し、それらの文書がOCRベンダーのサーバーを通過する場合、Rule 1.6はベンダーのデータセキュリティ、暗号化基準、およびデータ保持ポリシーを評価する義務を課します。ABA Model Rulesはオンプレミス処理を義務付けるものではありませんが、クラウドOCRツールへの文書処理の外部委託が、機密保護に関する「合理的な努力」基準を満たすことを要求しています。
FRCP — 電子的に保存された情報の提出要件
FRCP Rule 34(b)は、要求当事者がESIの提出形式を指定することを認め、提出当事者に対し「通常保存されている形式、または合理的に使用可能な形式」で提出することを要求しています。OCR処理済みドキュメントは検索可能で、ベーツ番号が保持され、テキストが抽出可能でなければなりません。OCRが重要文書を誤読した場合、またはスキャンファイルにOCRレイヤーが欠落している場合、その提出セットは「合理的に使用可能」ではないと異議を申し立てられる可能性があります。裁判所は、技術的にはアクセス可能だが実質的に使用不能な形式でESIを提出した当事者に制裁を科した事例があり、脆弱なOCRレイヤーはその一般的な要因となっています。
FRCP Rule 26(f)は、事前開示協議中に、当事者に対し「保存可能な情報の保存に関するあらゆる問題」および「電子的に保存された情報(その提出形式を含む)の開示または発見に関するあらゆる問題」を協議することを要求しています。Rule 26(f)のミート・アンド・コンファーは、OCR品質基準が確立される場です。当事者は、最低限のOCR精度しきい値、ベーツ番号の付番規則、および含めるメタデータフィールドについて合意することができます。自社のOCRツールの能力と限界を把握せずにこの協議に臨む法律事務所は、無知な立場から交渉していることになり、戦略的および倫理的リスクの両方を生み出します。
eDiscoveryプラットフォーム統合
現代の法務OCRワークフローのほとんどは、Relativity(eDiscovery処理およびレビュープラットフォームの主要製品)、Am Law 200事務所が使用するクラウド文書管理システムであるNetDocumentsおよびiManage、ならびに個人事務所および小規模事務所市場で主流の業務管理プラットフォームであるClioおよびMyCaseなどのツールを含むeDiscoveryエコシステム内で動作します。これらのプラットフォームが取り込める形式でエクスポートできないOCRツール、またはこれらのプラットフォームが必要とするメタデータレイヤーを除去するOCRツールは、手動による橋渡しステップを導入し、デジタル化の目的を損なうことになります。
たとえばRelativityは、処理パイプラインの一部として`.txt`または`.ocr`ロードファイルを通じてOCRテキストを取り込みます。OCRツールがRelativityのレビューデータベースに必要な1対1のページとテキストのマッピングを維持しない場合、ドキュメントは抽出されたテキストとの関連付けを失い、レビュー段階でOCR投資が無駄になります。iManageまたはNetDocumentsで文書管理を運用している法律事務所にとって、OCR出力はドキュメントのフォルダ構造、バージョン履歴、および権限モデルを保持する必要があります。そうでなければ、デジタルファイルキャビネットは紙のキャビネットの混乱を再現することになります。
法務ワークフロー向けに構築されたツールの包括的な比較(ベーツ番号処理、特権マーク検出、eDiscoveryプラットフォーム統合の扱いを含む)については、2026年法律文書向け最高のOCRソフトウェアの総合記事をご参照ください。
法律業務向けOCRの選び方
法律業務向けOCRの評価基準は、一般的な文書OCRとは5つの点で異なります。法律事務所がOCRツールを評価する際は、実際の自社文書を使ってこれらの要件をテストしてから導入を決定すべきです。
1. レイアウトと構造の保持
最も重要な基準です。複数カラムの準備書面、ページをまたぐ別紙付き契約書、フッターにBates番号がある文書でテストしてください。出力はカラムの読む順序を保持していますか?表はページをまたいでも正しく再現されていますか?Bates番号は検索可能な識別子として保持され、欠落していませんか?
2. 条項レベル・フィールドレベルの抽出
一般的なOCRはすべてのテキストを出力します。法律業務では特定のデータポイントが必要です。「この取引の全契約書から免責条項の上限額を抽出して」といった具合です。ツールが、異なる相手先からの文書バッチ全体に対して、定義した列(相手方、発効日、準拠法、更新条件)を文書ごとのテンプレート設定なしで抽出できるか評価してください。ここでカスタム列抽出とバッチファースト処理が、単なる機能リストではなく、運用上の要件となります。
3. セキュリティ、コンプライアンス、データ取扱い
SOC 2 Type II認証、転送中および保存中の暗号化、データ保持と削除ポリシー、処理済み文書のオンデマンド削除機能。政府機関や規制産業の案件を扱う事務所では、FedRAMP認証または同等のものが求められる場合があります。管轄区域の要件がある場合は、ベンダーのデータ処理場所を確認してください。Rule 1.6のデューデリジェンスでは、クライアントデータをアップロードする前に、これらの保護措置について書面による確認が必要です。
4. 法律業務規模でのバッチ処理
個人事務所では月50件の契約書処理が必要かもしれません。中規模訴訟事務所では1案件あたり5万件の文書。eDiscoveryベンダーは数百万件を処理します。ツールは、単一案件のワークフローから複数カストディアンのプロダクションまで、アーキテクチャを変えずにスケールできなければなりません。アップロード制限、同時処理能力、エクスポートの信頼性を、デモの5ファイルではなく、実際のボリュームで評価してください。
5. 法律テクノロジースタックとの統合
ツールはRelativity、NetDocuments、iManage、Clio、MyCaseが直接取り込める形式でエクスポートできますか?eDiscoveryプラットフォームが必要とするメタデータマッピング(Bates範囲、カストディアン、作成日)に対応していますか?それとも手動ダウンロード&再アップロードの橋渡しが必要ですか?受け渡しの回数が少ないほど、障害ポイントが減り、デジタル化の総コストも低くなります。
法的文書の複雑さを扱うことなく、ドキュメントをアップロードして出力列を定義し、構造化データを取得するだけでよい法務チーム向けに、ビジョン言語AIを基盤としたツールは、これまで法務実務におけるOCR導入を高コストにしてきたセットアップの負担を排除します。AI OCRソフトウェアのパラダイムが法務文書ワークフローにどのように適用されるかをご覧いただくか、より広範なOCRソフトウェアカテゴリで抽出アプローチ間の機能比較をご確認ください。
よくある質問
法務文書向けOCRは標準的なOCRと何が違うのですか?
標準的なOCRは文字を読み取り、テキストを出力します。法務向けOCRは文書構造を保持する必要があります — ベーツ番号、複数列フォーマット、ページをまたぐ条項の連続性、特権表示など — 法的な意味はテキスト内容だけでなくレイアウトと順序に依存するためです。文字精度99%を達成しても、複数列のブリーフを単一のテキストストリームに潰してしまう標準的なOCRツールは、法務用途としては構造的に破損した出力を生成します。
OCRは法務文書の手書き注釈を処理できますか?
従来のOCRは筆記体の手書き文字に対して40%未満の精度しか達成できません。ビジョン言語モデルを使用した最新のAIベースOCRは、明瞭な手書き文字に対して85〜95%の精度に達し、欄外注釈、署名欄、ドラフトブリーフへの裁判官の書き込みを捕捉するのに十分です。画像品質の低下、重なり合う手書き文字、極端な筆記体の装飾では精度が低下するため、重要な手書き内容は依然として人間のレビュアーによる検証が必要です。
OCRはABA Model Rulesの技術能力要件を満たしていますか?
ABA Model Rule 1.1は、Formal Opinion 477Rの解釈により、弁護士が使用するテクノロジーの利点とリスクを理解することを要求しています。これは完璧なOCR精度を義務付けるものではなく、情報に基づいた選択を要求します:ツールの精度率、構造保存能力、データセキュリティ対策、および制限事項を把握し、テクノロジーが不足する箇所には適切な人的レビューを適用することです。これらのパラメータを理解せずにOCRツールを使用することは、能力基準を下回る運用として問題視される可能性があります。
OCRはeDiscoveryの特権ログ作成にどのような影響を与えますか?
OCRは特権ログのワークフローにとって極めて重要です。eDiscoveryレビューセットに入るすべてのドキュメントは、スキャンされたページから検索可能なテキストを抽出する必要があります。そうでなければ、特権コンテンツを特定するには、すべてのドキュメントのすべてのページを開いて読む必要があります。「PRIVILEGED AND CONFIDENTIAL」ヘッダーを検出し、法律事務所名を認識し、弁護士レビューパターンを持つドキュメントをフラグ付けできるAI OCRは、特権の特定を加速します。ただし、特権の判断をOCRツールだけに依存すべきではありません。OCRは特権レビューの候補を特定するものであり、レビュー自体を代替するものではありません。
法律事務所がOCRベンダーを評価する際に注目すべき点は何ですか?
5つの優先事項:(1) 実際のドキュメントでテストする — 特に複数カラムのブリーフ、表形式の別紙を含む契約書、品質がさまざまなスキャン文書。(2) レイアウト保持を確認する:ベーツ番号は抽出後も保持されるか、表は正しく再構築されるか、複数カラムレイアウトで読み順は維持されるか。(3) 条項レベルまたはフィールドレベルの抽出機能を確認する — 必要なフィールドを定義し、ドキュメントごとの設定なしで複数のドキュメントにわたってそれらを見つけられるか。(4) セキュリティ認証(SOC 2、暗号化、データ削除ポリシー)をRule 1.6の義務に照らして確認する。(5) 既存の法務テクノロジースタック(Relativity、NetDocuments、iManage、Clio、または貴事務所が使用するプラットフォーム)との統合を検証する。
法務チームにとっての結論
法務ドキュメント向けOCRは、文字認識の問題ではありません。構造保持の問題です。ページ上のすべての文字を読み取っても、別紙と親契約書との関係、ベーツ番号とそのページとの関係、特権マーキングとそれが保護するドキュメントとの関係を失うツールは、ドキュメントをデジタル化したのではなく、データ上の負債を生み出したことになります。
位置ベースのOCRからビジョン言語AIへの技術的転換は、可能なことを根本的に変えます。ツールがテンプレート座標ではなく意味論的にドキュメントを読み取る場合、契約書抽出は数百件の契約書にわたる単一パス操作となり、eDiscovery処理はスケールで構造的コンテキストを保持し、ABA Model RulesおよびFRCPによって課されるコンプライアンス要件は、理想ではなく達成可能なものになります。法務チームにとっての問いは、OCRが法務ドキュメントを処理できるかどうかではなくなりました。選択したOCRツールが、法務ドキュメントを特別なものにしている違いを理解し、処理するすべてのページでその違いを保持できるかどうかです。
その問いを貴事務所のドキュメントでテストしてください — よく知っている契約書をアップロードし、実際に必要なフィールドを定義し、単純なキーワード検索では得られなかった結果が出力されるかどうかを確認してください。