OCR para Documentos Jurídicos 2026:
Guia de Digitalização de Contratos e eDiscovery
A Pesquisa de Tecnologia de 2025 da International Legal Technology Association — abrangendo 580 escritórios de advocacia representando mais de 152.000 advogados — constatou que 76% adotaram sistemas de gestão de documentos em nuvem, mas apenas 31% relatam que seus fluxos de trabalho com documentos são totalmente digitalizados. A lacuna não é um problema de disponibilidade de tecnologia. É um descompasso estrutural entre ferramentas de OCR genéricas que leem caracteres e os requisitos específicos de documentos jurídicos: sequências de páginas numeradas com número Bates, petições em várias colunas, cláusulas que atravessam páginas em acordos de fusão de 80 páginas e as obrigações éticas impostas pelas ABA Model Rules 1.1 e 1.6. Este guia aborda o que o OCR para documentos jurídicos realmente exige, quais tipos de documentos apresentam desafios únicos, como avaliar a prontidão para conformidade e onde a extração com IA muda o que é possível.
Principais Conclusões
- 188 de 250 dias úteis por ano são gastos procurando cláusulas em contratos — não analisando-as — segundo dados da CLOC de mais de 1.300 profissionais de contratos.
- Uma taxa de precisão de caracteres de 99,5% é inútil quando o OCR achata uma petição em várias colunas em um único fluxo de texto corrompido que um juiz federal pode considerar não "razoavelmente utilizável" sob a FRCP Rule 34.
- OCR com IA que localiza o limite de indenização entendendo o que a cláusula significa — não correspondendo a um modelo de coordenadas — torna a análise de portfólio de contratos uma consulta em quinhentos arquivos em vez de uma busca manual em cada um.
Por que o setor jurídico precisa de OCR — em números
A tecnologia OCR entrou no mercado jurídico décadas atrás como um utilitário de digitalização de documentos — transformar um arquivo em papel em PDF, torná-lo pesquisável, reduzir o espaço do arquivo físico. Esse caso de uso hoje é o mínimo esperado. O volume e a complexidade dos fluxos de trabalho de documentos jurídicos superaram o modelo simples de reconhecimento de caracteres, e os números mostram por quê.
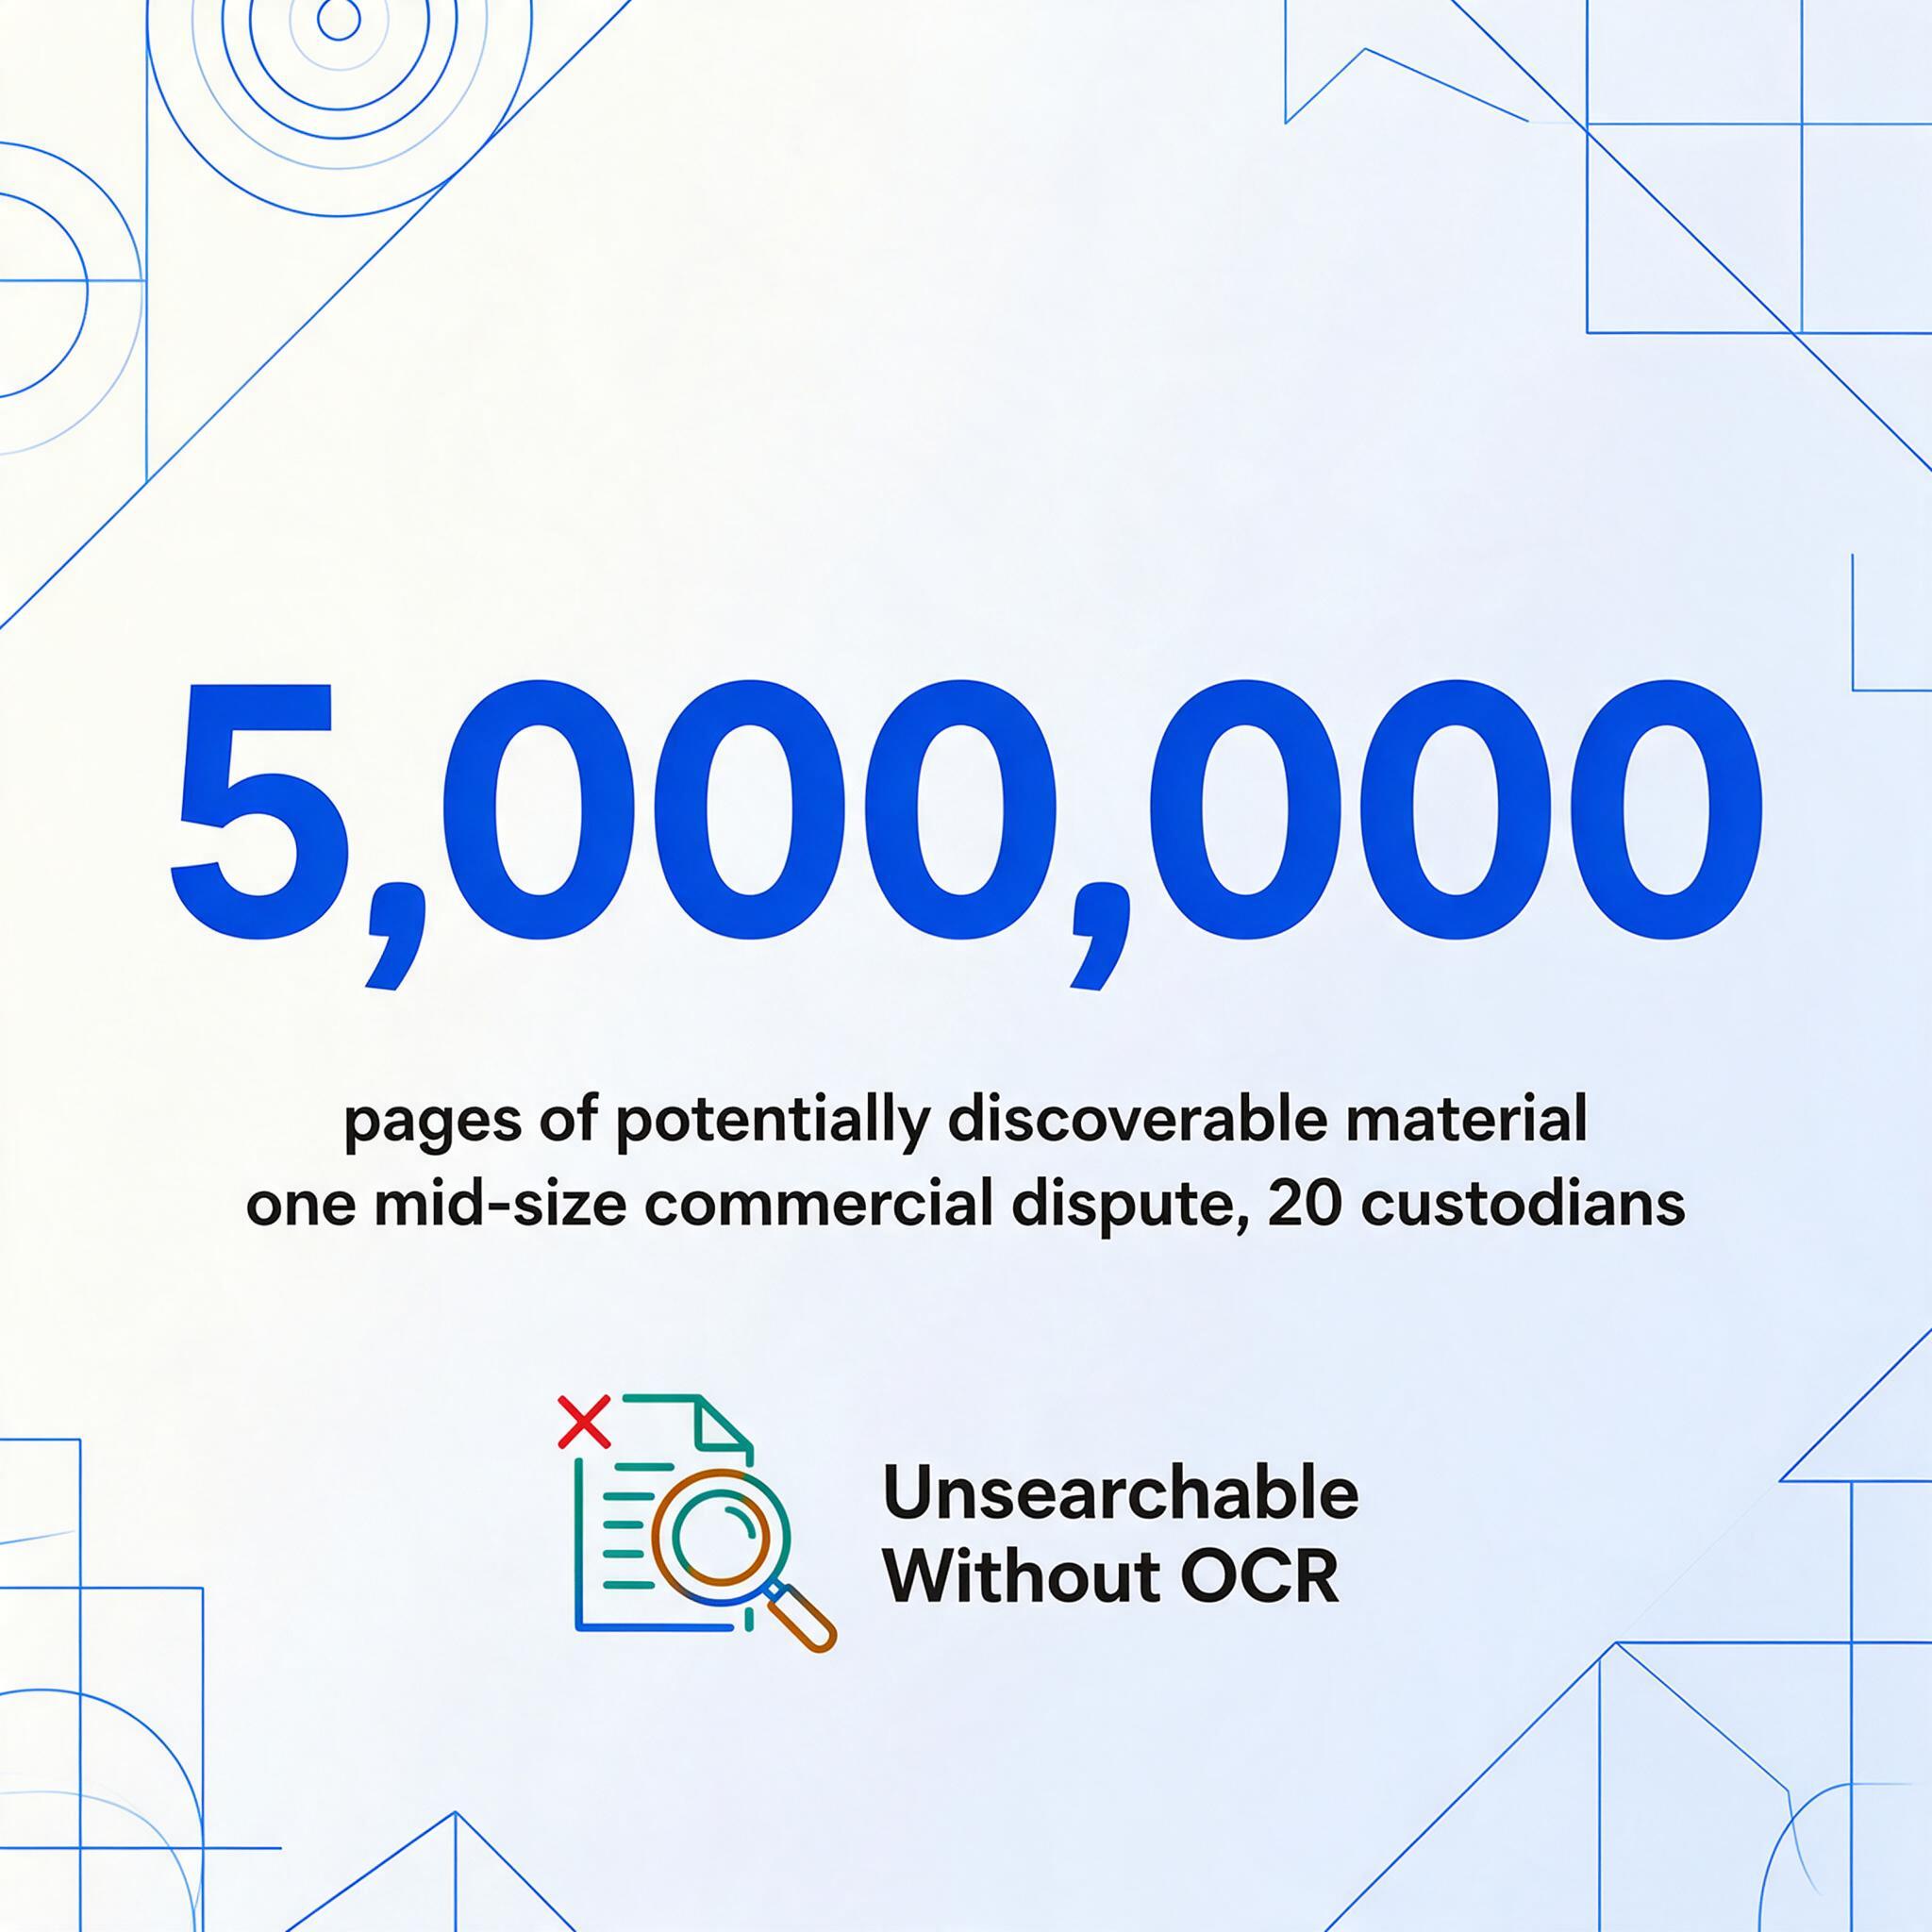
Somente o eDiscovery produz volumes impressionantes. Segundo benchmarks do setor, um único custodiante em litígio gera, em média, 5 GB de informações armazenadas eletronicamente (ESI), o que equivale a cerca de 250.000 páginas por custodiante. Uma disputa comercial de porte médio envolvendo 20 custodiantes produz 5 milhões de páginas de material potencialmente descobrível. A Regra 26(b)(1) da FRCP limita a descoberta a informações "proporcionais às necessidades do caso", mas a proporcionalidade não elimina a necessidade de processar — e pesquisar — tudo o que está no escopo. Sem OCR que preserve texto utilizável de documentos digitalizados, esses milhões de páginas não são apenas não pesquisáveis; são praticamente invisíveis para a equipe de revisão. O benchmark de 2025 do Digital War Room, baseado em 150 milhões de documentos em 2.000 casos, confirma que um GB médio contém 50.000 documentos — e 99,9% dos casos de litígio hoje envolvem ESI, segundo pesquisas do setor.
O tempo de revisão de contratos é dominado pela recuperação, não pela análise. A pesquisa do CLOC com 1.300 profissionais de contratos constatou que encontrar uma cláusula específica dentro de um único contrato leva mais de duas horas em média — 45 minutos para localizar o documento certo e mais 84 minutos para identificar a seção. Para um departamento jurídico que lida com 500 contratos por ano, isso representa 188 de 250 dias úteis consumidos pela recuperação antes que qualquer análise jurídica comece. A World Commerce & Contracting estima o impacto na receita em 9,2% da receita anual perdida com dados de contratos que existem dentro de acordos assinados, mas nunca chegam a uma planilha filtrável.
Os custos indiretos dos escritórios de advocacia acompanham o tempo de manuseio de documentos. Uma pesquisa de 2025 do IAALS constatou que 59% dos advogados relatam gastar mais de um terço de sua semana de trabalho em tarefas de gestão de documentos. Tarifas de cobrança de $400–$1.200 por hora tornam cada minuto de processamento manual de documentos um custo direto para o cliente ou para o resultado final do escritório. Para profissionais autônomos e de pequenos escritórios — que administram 66% do mercado jurídico em número de advogados —, a pressão sobre a margem decorrente do manuseio de documentos é existencial: o tempo perdido com entrada manual de dados em petições judiciais, contratos e documentos de descoberta limita diretamente o número de casos que podem aceitar.
Essas métricas compartilham uma raiz comum: os dados jurídicos existem dentro de documentos que não são legíveis por máquina no nível de que os advogados precisam. O OCR é a camada de conversão, mas somente quando entende o que os documentos jurídicos exigem estruturalmente — não apenas quais caracteres aparecem na página. Para os conceitos fundamentais por trás dessa tecnologia, veja o que o OCR realmente faz e como ele difere da extração de documentos de que os fluxos de trabalho jurídicos realmente precisam.
Tipos de Documentos Jurídicos e Seus Desafios de OCR
Os documentos jurídicos variam drasticamente em estrutura, mas compartilham uma característica que os torna mais difíceis para o OCR genérico do que faturas ou recibos: o significado depende do layout, da sequência e das referências cruzadas, não apenas do conteúdo textual. Dividir um contrato de fusão em páginas isoladas não é digitalização — é destruição de informação.
Contratos — Acordos de Várias Páginas com Semântica Distribuída
Um contrato comercial típico tem de 20 a 80 páginas. Um contrato de trabalho pode ter de 5 a 15 páginas. Um MSA de fornecedor com anexos e aditivos pode ultrapassar 100 páginas. Os dados de que uma equipe jurídica precisa nesses documentos — nome da contraparte, data de vigência, lei aplicável, limites de indenização, termos de renovação, rescisão por conveniência — estão espalhados pelo documento da página 1 à página 78. A data de vigência fica no preâmbulo. A cláusula de lei aplicável geralmente está na seção "Disposições Gerais", muitas vezes a última seção substantiva antes dos blocos de assinatura. O limite de indenização pode estar em um anexo referenciado na seção 12, mas localizado fisicamente 20 páginas depois.
O OCR genérico que trata cada página de forma independente quebra todas as relações entre páginas. Uma cláusula que começa na página 14 e termina na página 15 é dividida em dois fragmentos. Uma tabela de marcos de pagamento que abrange as páginas 22–24 perde a continuidade das linhas na quebra de página. Um bloco de assinatura na página 79 não tem vínculo com a parte signatária nomeada na página 1. O OCR jurídico deve acompanhar o contexto no nível do documento — lendo todas as páginas, mantendo referências cruzadas e reconhecendo que um termo definido introduzido na seção 1.2, na página 3, rege seu uso na página 47.
A numeração Bates acrescenta outra camada. Cada página dos documentos produzidos carrega um número Bates exclusivo que serve como identificador probatório ao longo do litígio. O OCR padrão que lê "IMG_000123" como texto de rodapé perdido ou o omite completamente quebra a cadeia de custódia da prova. A Regra 34(b) do FRCP permite que as partes solicitantes especifiquem o formato de produção, e a numeração Bates é o padrão de fato — o OCR que não a preserva produz documentos que não atendem ao requisito de "forma razoavelmente utilizável".
Petições e Memoriais Judiciais — Formatação em Várias Colunas e Estrutura de Citações
Memoriais recursais, memoriais de direito e petições seguem regras rígidas de formatação estabelecidas pelas regras locais dos tribunais e pela FRCP. Layouts em duas colunas são padrão em muitas jurisdições, com o texto principal na coluna mais larga e as citações de casos ou anotações na mais estreita. O OCR genérico, que lê da esquerda para a direita em toda a página, funde a coluna de citações no meio de uma frase, produzindo um texto que não é apenas desorganizado, mas juridicamente enganoso — uma citação de caso que parece pertencer a um argumento diferente daquele que a petição de fato apresenta.
O reconhecimento de citações é outro requisito especializado. Documentos jurídicos dependem de citações pontuais — "Smith v. Jones, 123 F.3d 456, 460 (9th Cir. 2025)" — em que o número de página após a vírgula carrega peso precedencial. O OCR que perde a página pontual, ou a funde no texto ao redor, quebra o fluxo de verificação de citações do qual todo litigante depende. Os formatos de citação do California Style Manual e do Bluebook acrescentam complexidade estrutural que o OCR em nível de caractere não consegue capturar.
Anotações manuscritas agravam o desafio. Juízes e sócios escrevem notas à margem em minutas de petições. Paralegais sinalizam seções com notas adesivas manuscritas. Petições judiciais da parte adversa podem conter edições com tachado, números de parágrafo circulados ou iniciais na margem. O OCR tradicional ou ignora completamente a escrita à mão ou produz palpites de caracteres não confiáveis. O OCR baseado em IA lida com escrita à mão com 85–95% de precisão em imagens nítidas — suficiente para capturar anotações à margem que frequentemente contêm o feedback substantivo sobre um argumento jurídico.
Documentos de eDiscovery — Qualidade Variável em Escala Massiva
Os conjuntos de documentos de eDiscovery são heterogêneos por definição: e-mails, PDFs, correspondência digitalizada, fotos de documentos físicos tiradas com smartphone, mensagens de texto, planilhas e arquivos de apresentação — todos misturados em um único conjunto de produção. Um relatório de processamento do Relativity para um caso comercial padrão pode mostrar 40% de arquivos eletrônicos nativos, 35% de documentos em papel digitalizados, 15% de anexos de e-mail em vários formatos e 10% de mídia legada (arquivos antigos do WordPerfect, faxes digitalizados, conversões de microfilme).
Cada subconjunto de formato apresenta diferentes modos de falha de OCR. Documentos em papel digitalizados de arquivos de casos com décadas de idade podem ter baixa resolução, estar inclinados ou desbotados. Fotos de documentos físicos tiradas com smartphone introduzem distorção de perspectiva, brilho e iluminação irregular. Documentos enviados por fax caem para 200 DPI com artefatos de compressão que confundem os algoritmos de reconhecimento de caracteres. Um pipeline de OCR para eDiscovery deve lidar com essa entrada variável sem exigir verificações de qualidade por documento — porque, em cinco milhões de páginas, verificar cada página individualmente não é viável.
A criação do log de privilégios é onde as falhas de OCR se tornam profissionalmente consequentes. Um log de privilégios exige identificar cada documento que contém material protegido pelo privilégio advogado-cliente ou pelo produto do trabalho, extrair a data, o autor, os destinatários e o assunto, e registrar a base do privilégio — tudo antes da produção. O OCR que deixa passar um cabeçalho "PRIVILEGED AND CONFIDENTIAL" em um e-mail digitalizado ou lê errado o nome de um escritório de advocacia em um campo de metadados cria risco de renúncia ao privilégio. A FRCP não exige identificação perfeita de privilégios, mas a Regra 26(b)(5)(A) exige que a parte produtora "descreva a natureza dos documentos" retidos — um padrão que pressupõe OCR preciso das principais informações identificadoras dos documentos.
O fio condutor entre esses tipos de documento: o OCR jurídico falha não porque os caracteres são lidos incorretamente — embora isso aconteça — mas porque a estrutura é perdida. Números Bates desvinculados das páginas, cláusulas divididas entre quebras de página, marcações de privilégio tratadas como texto corrido, petições em várias colunas achatadas em fluxos de coluna única. Uma ferramenta de OCR jurídico que atinge 99,5% de precisão de caracteres mas destrói a estrutura do documento produz um resultado pior que inútil — é profissionalmente perigoso.
OCR Tradicional vs OCR com IA para Documentos Jurídicos
A distinção entre OCR tradicional e extração com IA não é acadêmica para fluxos de trabalho jurídicos — ela determina se uma ferramenta consegue lidar com a complexidade estrutural descrita na seção anterior ou exige retrabalho manual em cada arquivo.
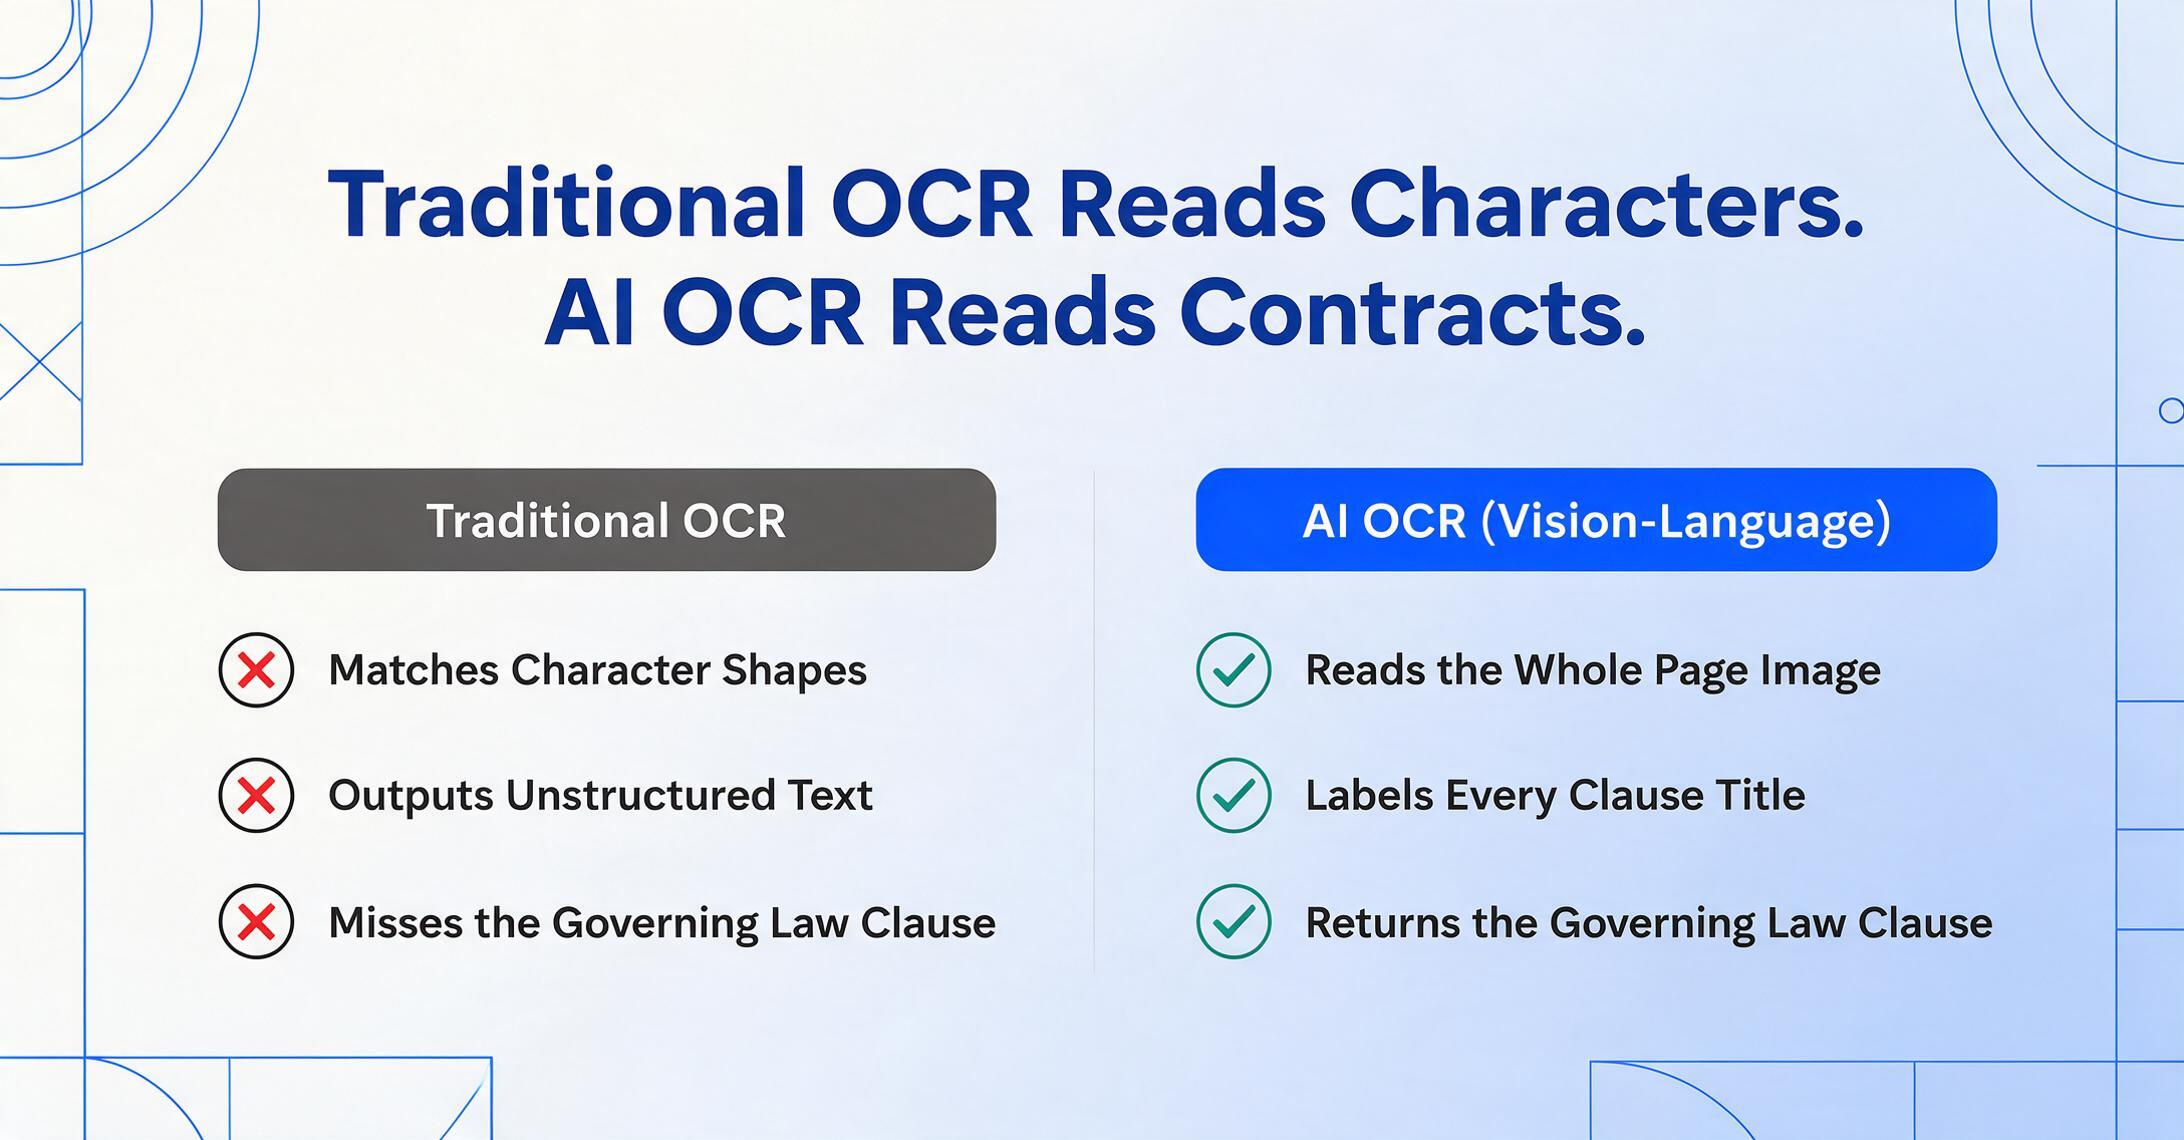
OCR tradicional — o paradigma de reconhecimento de caracteres. Ferramentas como Tesseract, ABBYY FineReader e os mecanismos de OCR incorporados em scanners de documentos operam em um pipeline de pixel para caractere: identificam formas na página, comparam-nas com uma biblioteca de padrões de caracteres conhecidos e geram texto. O resultado é um PDF pesquisável ou um arquivo de texto simples — caracteres em ordem de leitura, sem estrutura semântica. Isso é totalmente adequado para tornar um contrato digitalizado pesquisável em texto completo. Não é adequado para extrair a cláusula de lei aplicável, o limite de indenização ou o prazo de aviso de renovação como pontos de dados discretos — porque a ferramenta não sabe o que uma cláusula de lei aplicável é.
OCR com IA — o paradigma de visão-linguagem. A extração moderna baseada em IA usa modelos de visão-linguagem (VLMs) que leem uma página como um leitor humano faria: visual, holisticamente e semanticamente. Não reconhece caracteres um a um. Processa a imagem inteira do documento, identifica regiões de texto, determina sua função (cabeçalho, texto corrido, título de cláusula, bloco de assinatura, anotação marginal) e extrai significado — não apenas caracteres. Para uma explicação detalhada dessa arquitetura, veja o que é OCR com IA e como ele difere do reconhecimento tradicional de caracteres.
Na prática jurídica, essa diferença arquitetural produz diferenças operacionais concretas:
| Requisito | OCR tradicional | OCR com IA (Vision-Language) |
|---|---|---|
| Preservação do número Bates | Trata como texto disperso; muitas vezes o descarta ou o mescla | Reconhece identificadores de nível de página por padrão; preserva-os |
| Extração no nível da cláusula | Gera todo o texto em sequência; sem identificação de cláusulas | Identifica os limites das cláusulas pelo papel semântico |
| Memoriais em várias colunas | Da esquerda para a direita entre as colunas; ordem de leitura corrompida | Ordem de leitura ciente das colunas por análise do layout visual |
| Continuidade de tabelas entre páginas | Cada página processada de forma independente; linhas quebram nas bordas da página | Contexto no nível do documento mantido; tabelas reconstruídas entre páginas |
| Anotações manuscritas | Normalmente < 40% de precisão em cursiva | 85–95% em caligrafia legível |
| Detecção de marcação de privilégio | Lê como texto do corpo; sem sinalização | Reconhece por padrão cabeçalhos de privilégio e os sinaliza para revisão |
| Operação sem modelo | Exige definições de zona por formato | Funciona em vários formatos sem configuração |
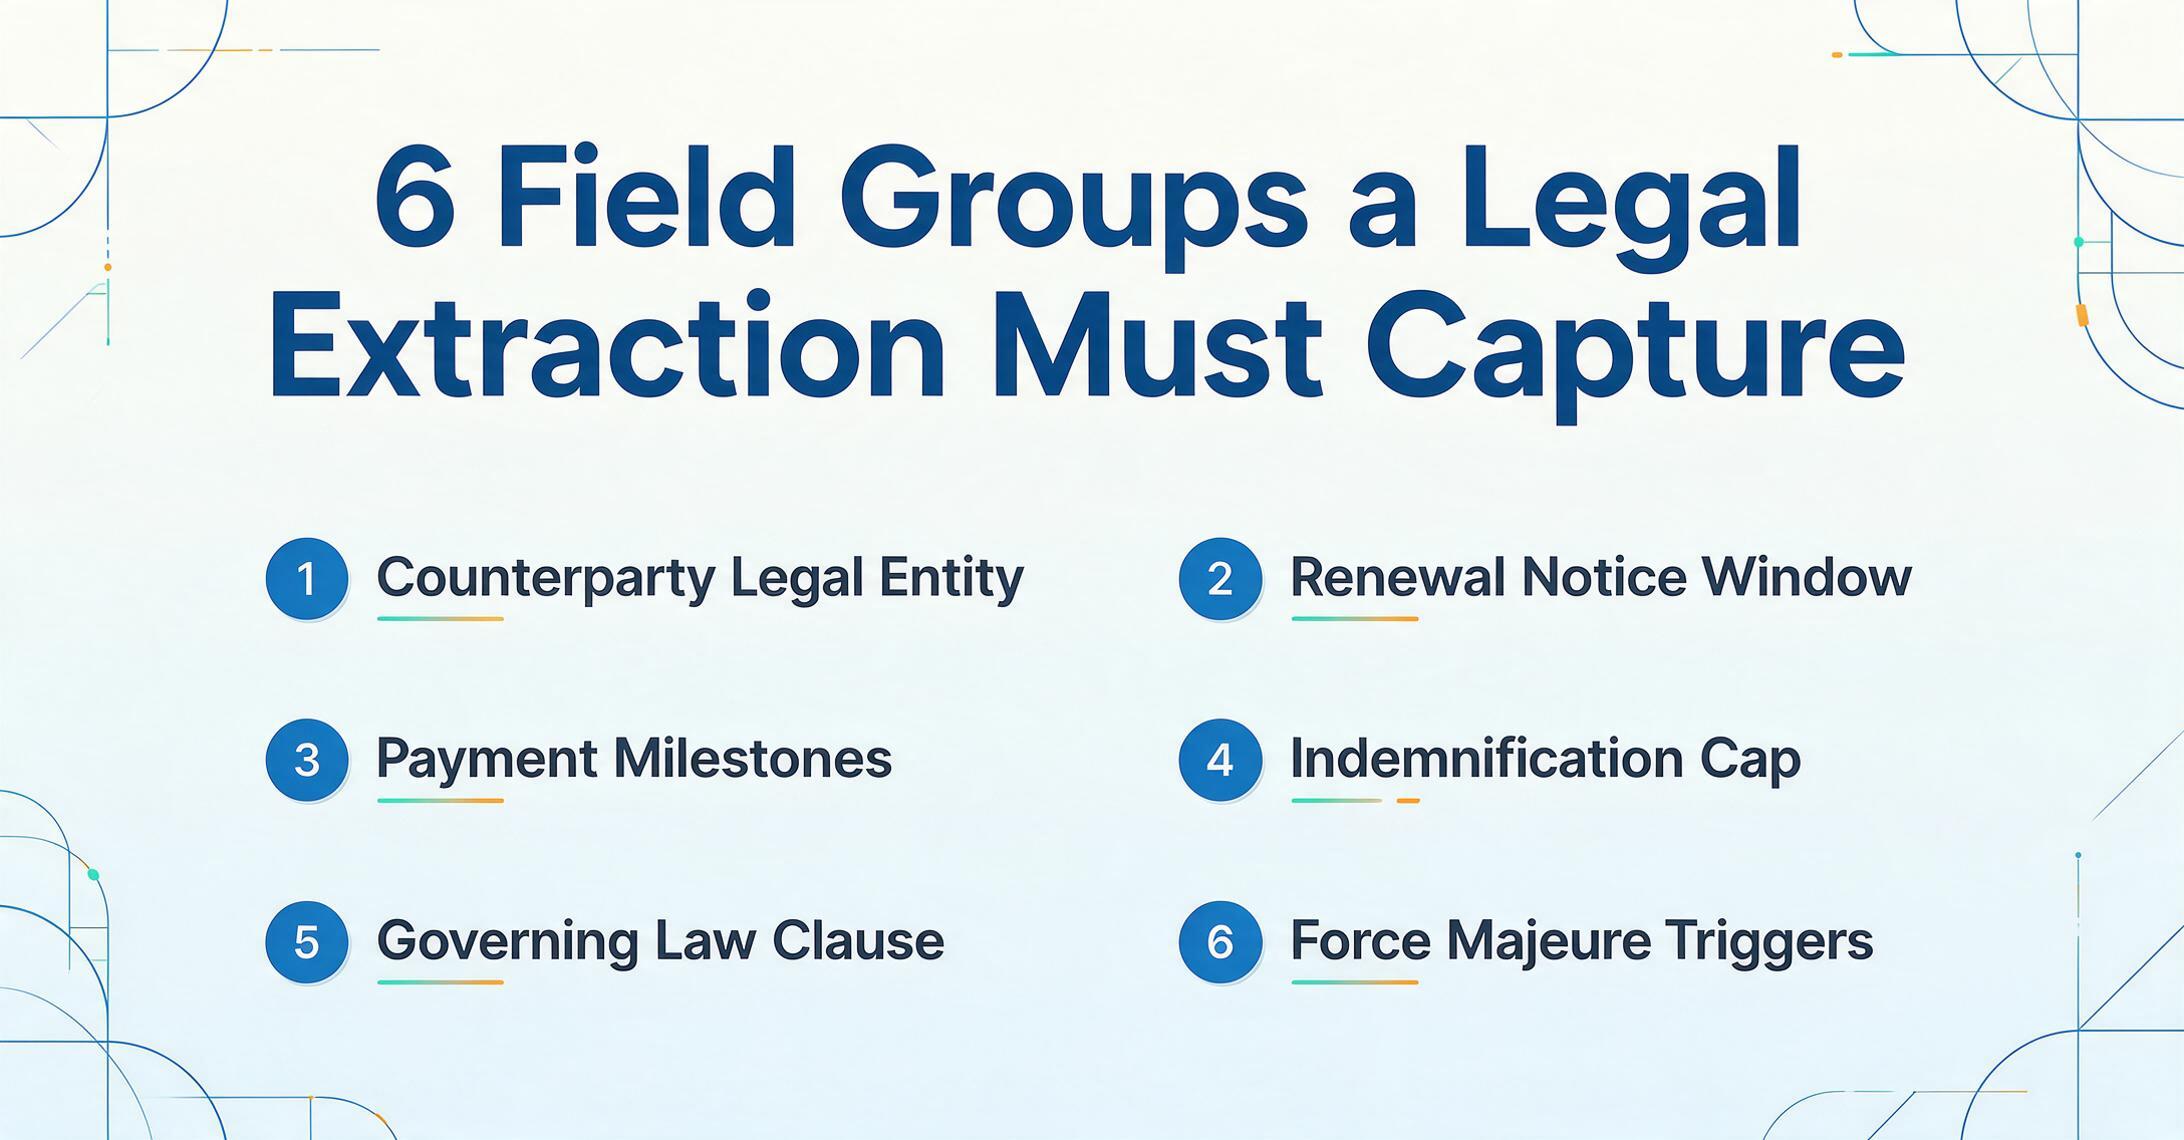
O paradigma mais importante para o jurídico é a Extração de Colunas Personalizadas: você define as colunas que deseja na sua saída — "Indemnification Cap", "Governing Law", "Renewal Notice Period", "Limitation of Liability" — e a IA lê cada página de cada documento, localiza os blocos de texto que correspondem a cada campo solicitado ao compreender seu papel semântico e mapeia cada correspondência para a coluna de saída correta. Sem desenhar zonas. Sem modelo por contraparte. Sem reconciliação manual de definições de cláusulas que usam linguagem diferente em contratos diferentes. Esta é a mudança da extração baseada em posição para a extração baseada em semântica — e ela aborda diretamente a variabilidade de formato que torna o processamento de contratos e de eDiscovery desproporcionalmente caro com ferramentas tradicionais.
Campos Principais a Extrair de Documentos Jurídicos
O que uma equipe jurídica precisa extrair depende do caso de uso — due diligence, gestão de portfólio de contratos, revisão de eDiscovery ou suporte a litígios. Mas a maioria dos fluxos de extração jurídica converge para um conjunto central de campos organizados por finalidade do documento.
Para Contratos e Acordos
| Categoria de Campo | Campos Específicos | Por Que É Importante |
|---|---|---|
| Identificação das partes | Nome da contraparte, entidade signatária, jurisdição de constituição | Uma contraparte pode contratar por meio de várias subsidiárias; identificar a entidade legal correta é essencial para a execução |
| Datas e prazos | Data de vigência, data de expiração, prazo de aviso de renovação, janela de rescisão por conveniência | Armadilhas de renovação automática e janelas de rescisão perdidas são a principal fonte de responsabilidade contratual |
| Termos financeiros | Valor do contrato, cronograma de pagamento, mecanismo de reajuste de preço, termos de multa por atraso | Cronogramas de taxas frequentemente abrangem tabelas de anexos; a extração deve seguir referências cruzadas |
| Alocação de riscos | Escopo e limite de indenização, limitação de responsabilidade, exclusão de danos consequentes | Essas cláusulas determinam a exposição financeira; "indenização sem limite" é um campo de alerta em toda revisão |
| Disposições regentes | Lei aplicável, resolução de disputas (arbitragem vs. litígio), foro, renúncia ao julgamento por júri | Afeta diretamente onde e como as disputas são resolvidas; normalmente uma única cláusula na seção de disposições gerais |
| Cláusulas operacionais | Eventos deflagradores de força maior, escopo e duração da não concorrência, prazo de confidencialidade, obrigações de proteção de dados | Obrigações de desempenho pós-assinatura que impactam diretamente as operações |
| Rescisão | Rescisão por justa causa, rescisão por conveniência, obrigações pós-rescisão, sobrevivência de cláusulas | Os termos de saída definem tanto o custo de encerrar uma relação quanto as obrigações continuadas após a rescisão |
Para Documentos de eDiscovery e Contencioso
- Identificadores de documentos: intervalo de número Bates, nome do custodiante, número do processo de origem, data de produção — esses metadados são o mínimo necessário para tornar os documentos produzidos utilizáveis sob a FRCP Rule 34(b).
- Indicadores de privilégio: "PRIVILEGED AND CONFIDENTIAL", "ATTORNEY WORK PRODUCT", "ATTORNEY-CLIENT PRIVILEGE" — cabeçalhos, rodapés e carimbos que devem ser reconhecidos e sinalizados antes da produção.
- Principais envolvidos e datas: Autor (de cabeçalhos de e-mail ou blocos de assinatura), destinatários (incluindo CC e BCC quando acessíveis), data de criação, data de envio, data de produção — usados para cronologias de evidências e preparação de testemunhas.
- Classificação do tipo de documento: Contrato, e-mail, memorando, petição, planilha, transcrição de correio de voz, exportação de SMS — classificar documentos em escala para que as equipes de revisão apliquem o fluxo de trabalho correto a cada categoria.
- Zonas de redação: Áreas de um documento que foram redigidas (tarjadas em preto ou branqueadas), sua posição e extensão — a redação deve ser preservada e mapeada durante o processamento para garantir a completude da produção.
Para um olhar mais aprofundado sobre a extração em nível de cláusula especificamente, consulte nosso guia sobre extração de contratos jurídicos e como a identificação de cláusulas difere da extração em nível de campo para due diligence e gestão de portfólio.
Considerações de Conformidade para OCR Jurídico
O OCR na prática jurídica não é apenas uma decisão tecnológica — é uma decisão de conformidade. Três estruturas regulatórias regem diretamente como os escritórios de advocacia devem lidar com documentos digitalizados.
ABA Model Rules: Competência Tecnológica e Confidencialidade
ABA Model Rule 1.1 (Competência) — esclarecida pela ABA Formal Opinion 477R (2017) — exige que os advogados "se mantenham atualizados sobre as mudanças na lei e em sua prática, incluindo os benefícios e riscos associados à tecnologia relevante". Isso significa que um advogado que usa OCR para processar documentos de clientes sem entender as limitações de precisão da ferramenta, os procedimentos de tratamento de dados ou as capacidades de preservação estrutural pode estar operando abaixo do padrão de competência. A regra não exige OCR perfeito, mas exige seleção informada e supervisão adequada da tecnologia usada em casos de clientes.
ABA Model Rule 1.6 (Confidencialidade de Informações) exige que os advogados "façam esforços razoáveis para prevenir a divulgação ou o acesso inadvertido ou não autorizado a informações relacionadas à representação de um cliente". Quando o OCR processa documentos contendo material privilegiado, segredos comerciais ou informações de identificação pessoal — e quando esses documentos passam pelos servidores do fornecedor de OCR — a Rule 1.6 impõe a obrigação de avaliar a segurança de dados do fornecedor, os padrões de criptografia e as políticas de retenção de dados. As ABA Model Rules não exigem processamento local, mas exigem que a terceirização do processamento de documentos para uma ferramenta de OCR em nuvem atenda a um padrão de "esforços razoáveis" para proteção da confidencialidade.
FRCP — Requisitos de Produção de Electronically Stored Information
FRCP Rule 34(b) permite que a parte solicitante especifique a forma de produção do ESI e exige que a parte produtora o produza "em uma forma ou formas nas quais seja normalmente mantido ou em uma forma ou formas razoavelmente utilizáveis". Documentos processados por OCR devem ser pesquisáveis, com números Bates preservados e texto extraível. Um conjunto de produção em que o OCR leu incorretamente os documentos-chave — ou em que a camada de OCR está ausente para arquivos digitalizados — pode ser contestado como não "razoavelmente utilizável". Tribunais já sancionaram partes por produzir ESI em formatos tecnicamente acessíveis, mas praticamente inutilizáveis, e uma camada de OCR fraca é um fator contribuinte comum.
FRCP Rule 26(f) exige que as partes discutam "quaisquer questões sobre a preservação de informações descobríveis" e "quaisquer questões sobre divulgação ou descoberta de informações armazenadas eletronicamente, incluindo a forma ou formas em que devem ser produzidas", durante a conferência pré-descoberta. A reunião e conferência da Rule 26(f) é onde os padrões de qualidade de OCR são estabelecidos — as partes podem concordar com limites mínimos de precisão de OCR, convenções de numeração Bates e campos de metadados a serem incluídos. Um escritório que entra nessa discussão sem conhecer as capacidades e limitações de sua ferramenta de OCR negocia em posição de ignorância, o que cria risco tanto estratégico quanto ético.
Integração com Plataformas de eDiscovery
A maioria dos fluxos de trabalho jurídicos modernos de OCR opera dentro de um ecossistema de eDiscovery que inclui ferramentas como Relativity (a plataforma dominante de processamento e revisão de eDiscovery), NetDocuments e iManage (sistemas de gerenciamento de documentos em nuvem usados por escritórios da Am Law 200) e plataformas de gestão de prática jurídica como Clio e MyCase (dominantes nos mercados de advogados autônomos e pequenos escritórios). Uma ferramenta de OCR que não consegue exportar nos formatos que essas plataformas ingerem — ou que remove a camada de metadados que essas plataformas exigem — introduz uma etapa manual de integração que anula o propósito da digitalização.
O Relativity, por exemplo, ingere texto de OCR como parte de seu pipeline de processamento por meio de um arquivo de carga `.txt` ou `.ocr`. Se a ferramenta de OCR não mantém o mapeamento um para um de página para texto que o Relativity exige para seu banco de dados de revisão, o documento perde sua associação com o texto extraído, tornando o investimento em OCR inútil na fase de revisão. Para escritórios que gerenciam seus documentos no iManage ou NetDocuments, a saída de OCR deve preservar a estrutura de pastas do documento, o histórico de versões e o modelo de permissões — ou o arquivo digital replica o caos do arquivo em papel.
Para uma comparação abrangente de ferramentas criadas para fluxos de trabalho jurídicos — incluindo como cada uma lida com numeração Bates, detecção de marcação de privilégio e integração com plataformas de eDiscovery — consulte nossa seleção dos melhores softwares de OCR para documentos jurídicos 2026.
Como Escolher OCR para Trabalho Jurídico
Os critérios de avaliação para OCR jurídico diferem do OCR genérico de documentos em cinco dimensões. Todo escritório de advocacia avaliando ferramentas de OCR deve testar esses requisitos específicos usando seus próprios documentos antes de se comprometer com uma plataforma.
1. Preservação de Layout e Estrutura
O critério mais importante. Teste com um parecer de várias colunas, um contrato com uma tabela de anexos que atravessa uma quebra de página e um documento com números Bates no rodapé. A saída preserva a ordem de leitura das colunas? As tabelas são reconstruídas corretamente entre limites de página? Os números Bates são capturados como identificadores pesquisáveis em vez de descartados?
2. Extração em Nível de Cláusula ou Campo
O OCR genérico gera todo o texto. Os fluxos de trabalho jurídicos precisam de dados específicos: "me dê o limite de indenização de cada contrato neste negócio." Avalie se a ferramenta consegue extrair campos que você define como colunas (contraparte, data de vigência, lei aplicável, termos de renovação) em um lote de documentos de diferentes contrapartes — sem exigir configuração de modelo por documento. É aqui que Extração de Colunas Personalizadas e Processamento Prioritário em Lote se tornam requisitos operacionais em vez de itens de destaque.
3. Segurança, Conformidade e Tratamento de Dados
Certificação SOC 2 Type II, criptografia em trânsito e em repouso, políticas de retenção e exclusão de dados, e a capacidade de excluir documentos processados sob demanda. Para escritórios que lidam com questões governamentais ou de setores regulados, a autorização FedRAMP ou equivalente pode ser exigida. Confirme o local de processamento de dados do fornecedor se requisitos jurisdicionais se aplicarem. A diligência da Regra 1.6 exige confirmação por escrito dessas proteções antes de enviar dados do cliente.
4. Processamento em Lote na Escala Jurídica
Um advogado autônomo pode precisar processar 50 contratos por mês. Um escritório de litígio de médio porte precisa de 50.000 documentos por caso. Um fornecedor de eDiscovery processa milhões. A ferramenta deve escalar do fluxo de trabalho de um único caso até a produção com múltiplos custodiantes sem alterar a arquitetura. Avalie limites de upload, capacidade de processamento simultâneo e confiabilidade de exportação no seu volume real — não no volume de demonstração de cinco arquivos de amostra.
5. Integração com o Stack de Tecnologia Jurídica
A ferramenta exporta em formatos que Relativity, NetDocuments, iManage, Clio ou MyCase podem ingerir diretamente? Ela suporta o mapeamento de metadados (intervalo Bates, custodiante, data de produção) que as plataformas de eDiscovery exigem? Ou força uma ponte manual de download e reupload? Quanto menos transferências, menos pontos de falha — e menor o custo total da digitalização.
Para equipes jurídicas que precisam de um ponto de partida simples — enviar documentos, definir colunas de saída, obter dados estruturados sem configurar modelos ou treinar modelos de IA — ferramentas baseadas em IA de visão-linguagem eliminam a sobrecarga de configuração que historicamente tornou a adoção de OCR cara na prática jurídica. Veja como o paradigma do software de OCR com IA se aplica aos fluxos de trabalho de documentos jurídicos, ou explore a categoria mais ampla de software de OCR para uma comparação de recursos entre abordagens de extração.
Perguntas Frequentes
O que torna o OCR para documentos jurídicos diferente do OCR padrão?
O OCR padrão lê caracteres e gera texto. O OCR jurídico deve preservar a estrutura do documento — numeração Bates, formatação em várias colunas, continuidade de cláusulas entre páginas, marcações de sigilo — porque o significado jurídico depende do layout e da sequência, não apenas do conteúdo textual. Uma ferramenta de OCR padrão que atinge 99% de precisão de caracteres, mas colapsa um memorial em várias colunas em um único fluxo de texto, produz uma saída estruturalmente corrompida para uso jurídico.
O OCR consegue lidar com anotações manuscritas em documentos jurídicos?
O OCR tradicional normalmente atinge menos de 40% de precisão em caligrafia cursiva. O OCR moderno baseado em IA, usando modelos de visão-linguagem, alcança 85–95% em caligrafia legível, o que é suficiente para capturar anotações à margem, blocos de assinatura e anotações do juiz em minutas de memoriais. A precisão diminui com qualidade de imagem ruim, caligrafia sobreposta e floreios cursivos extremos — portanto, conteúdo manuscrito crítico ainda deve ser verificado por um revisor humano.
O OCR atende aos requisitos da ABA Model Rule para competência tecnológica?
A ABA Model Rule 1.1, conforme interpretada pela Formal Opinion 477R, exige que os advogados entendam os benefícios e riscos da tecnologia que utilizam. Isso não exige precisão perfeita do OCR, mas exige seleção informada: conhecer as taxas de precisão da sua ferramenta, as capacidades de preservação estrutural, as medidas de segurança de dados e as limitações — e aplicar revisão humana apropriada onde a tecnologia falha. Usar uma ferramenta de OCR sem entender esses parâmetros pode ser questionado como operar abaixo do padrão de competência.
Como o OCR afeta a criação de registros de privilégio no eDiscovery?
O OCR é essencial para os fluxos de trabalho de registros de privilégio. Todo documento que entra em um conjunto de revisão de eDiscovery deve ter texto pesquisável extraído de suas páginas digitalizadas — caso contrário, identificar conteúdo privilegiado exige abrir e ler cada página de cada documento. O OCR com IA capaz de detectar cabeçalhos "PRIVILEGED AND CONFIDENTIAL", reconhecer nomes de escritórios de advocacia e sinalizar documentos com padrões de revisão por advogados acelera a identificação de privilégios. No entanto, nenhuma ferramenta de OCR deve ser usada como único mecanismo para determinar privilégio; o OCR identifica candidatos para revisão de privilégio, não a substitui.
O que um escritório de advocacia deve observar ao avaliar um fornecedor de OCR?
Cinco prioridades: (1) Teste com seus documentos reais — especialmente petições em várias colunas, contratos com anexos em tabelas e documentos digitalizados de qualidade variável. (2) Confirme a preservação do layout: os números Bates sobrevivem à extração, as tabelas são reconstruídas corretamente, a ordem de leitura é mantida em layouts de várias colunas? (3) Verifique a capacidade de extração em nível de cláusula ou de campo — a ferramenta permite definir os campos desejados e encontrá-los em todos os documentos sem configuração por documento? (4) Confira as certificações de segurança (SOC 2, criptografia, políticas de exclusão de dados) em relação às suas obrigações da Rule 1.6. (5) Valide a integração com sua stack de tecnologia jurídica existente — Relativity, NetDocuments, iManage, Clio ou quaisquer plataformas que seu escritório use.
A Conclusão para Equipes Jurídicas
O OCR para documentos jurídicos não é um problema de reconhecimento de caracteres. É um problema de preservação estrutural. Uma ferramenta que lê cada letra da página, mas perde a relação entre um anexo e seu contrato principal, entre um número Bates e sua página, ou entre uma marcação de privilégio e o documento que ela protege, não digitalizou o documento — criou uma responsabilidade de dados.
A mudança tecnológica do OCR baseado em posição para a IA de visão e linguagem muda fundamentalmente o que é possível. Quando uma ferramenta lê documentos por significado semântico em vez de coordenadas de modelo, a extração de contratos se torna uma operação de passagem única em centenas de acordos, o processamento de eDiscovery preserva o contexto estrutural em escala, e os requisitos de conformidade impostos pelas ABA Model Rules e pela FRCP se tornam alcançáveis em vez de aspiracionais. A questão para as equipes jurídicas não é mais se o OCR consegue lidar com documentos jurídicos. É se a ferramenta de OCR que escolhem entende o que torna os documentos jurídicos diferentes — e consegue preservar essa diferença em cada página que processa.
Teste essa questão com seus próprios documentos — envie um contrato que você conhece bem, defina os campos que realmente precisa e veja se o resultado oferece o que uma simples busca por palavra-chave não conseguiria.