OCR für Rechtsdokumente 2026:
Leitfaden zur Digitalisierung von Verträgen und eDiscovery
Die Technology Survey 2025 der International Legal Technology Association – die 580 Anwaltskanzleien mit über 152.000 Anwälten umfasst – ergab, dass 76 % cloudbasierte Dokumentenmanagementsysteme eingeführt haben, aber nur 31 % berichten, dass ihre Dokumentenabläufe vollständig digitalisiert sind. Die Lücke ist kein Problem der Technologieverfügbarkeit. Es ist eine strukturelle Diskrepanz zwischen generischen OCR-Tools, die Zeichen lesen, und den spezifischen Anforderungen juristischer Dokumente: Bates-nummerierte Seitenfolgen, mehrspaltige Schriftsätze, seitenübergreifende Klauseln in 80-seitigen Fusionsverträgen und die ethischen Verpflichtungen aus den ABA Model Rules 1.1 und 1.6. Dieser Leitfaden behandelt, was OCR für Rechtsdokumente tatsächlich erfordert, welche Dokumenttypen besondere Herausforderungen darstellen, wie Sie die Compliance-Bereitschaft bewerten und wo KI-gestützte Extraktion neue Möglichkeiten eröffnet.
Wichtigste Erkenntnisse
- 188 von 250 Arbeitstagen pro Jahr werden laut CLOC-Daten von über 1.300 Vertragsprofis damit verbracht, Klauseln in Verträgen zu finden – nicht sie zu analysieren.
- Eine Zeichengenauigkeit von 99,5 % ist nutzlos, wenn die OCR einen mehrspaltigen Schriftsatz in einen einzigen korrupten Textstrom plattdrückt, den ein Bundesrichter gemäß FRCP Rule 34 als nicht „angemessen nutzbar“ einstufen kann.
- KI-OCR, das die Haftungsobergrenze dadurch lokalisiert, dass es die Bedeutung der Klausel versteht – statt durch Abgleich einer Koordinatenvorlage – macht die Analyse des Vertragsportfolios zu einer Abfrage über fünfhundert Dateien statt einer manuellen Suche in jeder einzelnen.
Warum die Rechtsbranche OCR braucht — in Zahlen
Die OCR-Technologie hielt vor Jahrzehnten als Dokument-Scan-Lösung Einzug in den Rechtsmarkt — Papierakten in PDFs verwandeln, durchsuchbar machen, Aktenschrankplatz sparen. Dieser Anwendungsfall ist inzwischen selbstverständlich. Umfang und Komplexität juristischer Dokumenten-Workflows sind über das einfache Zeichenerkennungsmodell hinausgewachsen, und die Zahlen zeigen, warum.
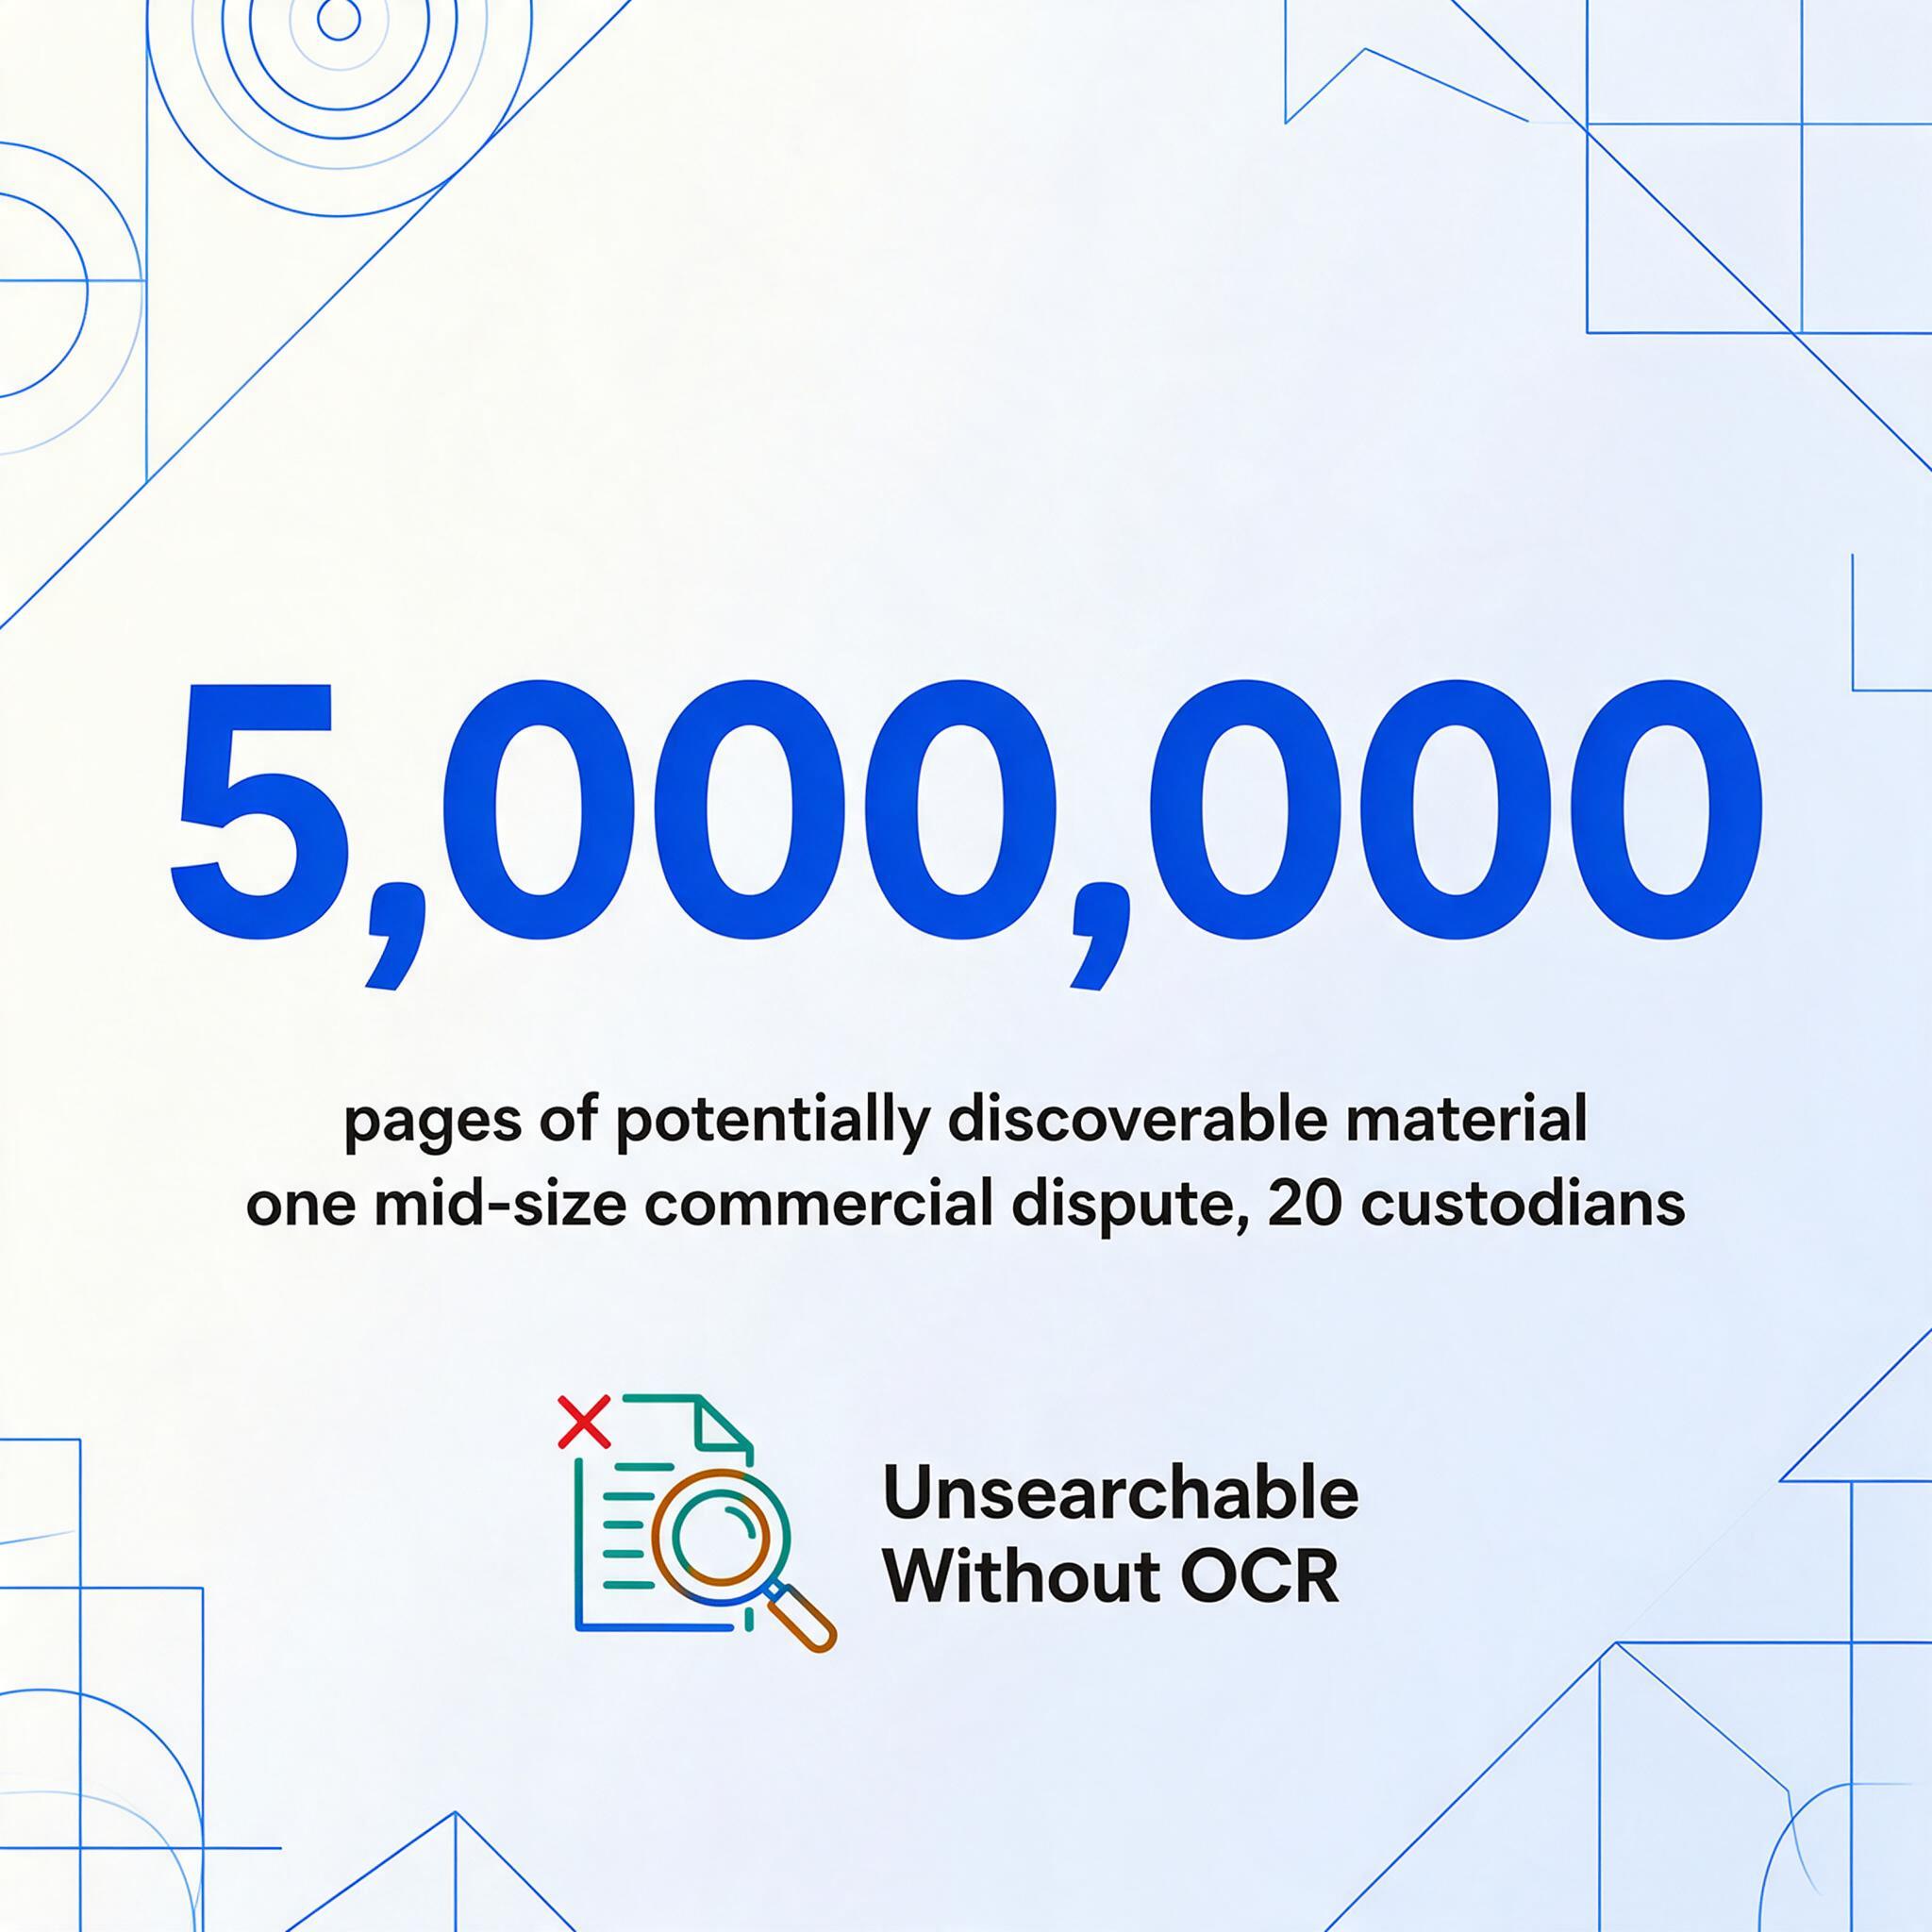
Allein eDiscovery erzeugt atemberaubende Datenmengen. Laut Branchen-Benchmarks erzeugt ein einzelner Datenträger in einem Rechtsstreit durchschnittlich 5 GB elektronisch gespeicherter Informationen (ESI), was etwa 250.000 Seiten pro Datenträger entspricht. Ein mittelgroßer kommerzieller Rechtsstreit mit 20 Datenträgern erzeugt 5 Millionen Seiten potenziell offenlegungspflichtigen Materials. FRCP Rule 26(b)(1) begrenzt die Offenlegung auf Informationen, die „in einem angemessenen Verhältnis zu den Anforderungen des Falles“ stehen, aber Verhältnismäßigkeit beseitigt nicht die Notwendigkeit, alles im Rahmen Liegende zu verarbeiten — und zu durchsuchen. Ohne OCR, die nutzbaren Text aus gescannten Dokumenten erhält, sind diese Millionen Seiten nicht nur nicht durchsuchbar; sie sind für das Prüfungsteam praktisch unsichtbar. Der Digital War Room 2025 Benchmark, basierend auf 150 Millionen Dokumenten aus 2.000 Verfahren, bestätigt, dass ein durchschnittliches GB 50.000 Dokumente enthält — und 99,9 % der Rechtsstreitigkeiten betreffen laut Branchenumfragen inzwischen ESI.
Die Vertragsprüfungszeit wird von der Suche dominiert, nicht von der Analyse. Die CLOC-Umfrage unter 1.300 Vertragsprofis ergab, dass das Auffinden einer bestimmten Klausel in einem einzelnen Vertrag im Durchschnitt über zwei Stunden dauert — 45 Minuten, um das richtige Dokument zu finden, und weitere 84 Minuten, um den Abschnitt zu lokalisieren. Für eine Rechtsabteilung, die 500 Verträge pro Jahr bearbeitet, sind das 188 von 250 Arbeitstagen, die allein für die Suche aufgewendet werden, bevor irgendeine rechtliche Analyse beginnt. World Commerce & Contracting beziffert die Umsatzauswirkung auf 9,2 % des Jahresumsatzes, die durch Vertragsdaten verloren gehen, die in unterzeichneten Vereinbarungen existieren, aber nie in eine filterbare Tabelle gelangen.
Die Gemeinkosten von Anwaltskanzleien hängen an der Dokumentenbearbeitungszeit. Eine Umfrage der IAALS aus dem Jahr 2025 ergab, dass 59 % der Anwälte angeben, mehr als ein Drittel ihrer Arbeitswoche mit Dokumentenverwaltungsaufgaben zu verbringen. Abrechnungssätze von 400–1.200 $ pro Stunde machen jede Minute manueller Dokumentenverarbeitung zu einem direkten Kostenfaktor für den Mandanten oder das Endergebnis der Kanzlei. Für Einzelanwälte und kleine Kanzleien — die 66 % des Rechtsmarktes nach Anwaltszahl ausmachen — ist der Margendruck durch die Dokumentenbearbeitung existenziell: Die für manuelle Dateneingabe bei Gerichtsdokumenten, Verträgen und Offenlegungsdokumenten verlorene Zeit begrenzt direkt die Anzahl der Fälle, die sie übernehmen können.
Diese Kennzahlen haben eine gemeinsame Wurzel: Rechtsdaten existieren in Dokumenten, die auf dem Niveau, das Anwälte benötigen, nicht maschinenlesbar sind. OCR ist die Konvertierungsebene, aber nur, wenn sie versteht, was Rechtsdokumente strukturell erfordern — nicht nur, welche Zeichen auf der Seite erscheinen. Zu den grundlegenden Konzepten hinter dieser Technologie siehe was OCR tatsächlich tut und wie es sich von der Dokumentextraktion unterscheidet, die Rechts-Workflows letztendlich benötigen.
Arten juristischer Dokumente und ihre OCR-Herausforderungen
Juristische Dokumente unterscheiden sich stark in ihrer Struktur, haben aber eine Gemeinsamkeit, die sie für generische OCR schwieriger macht als Rechnungen oder Quittungen: Die Bedeutung hängt von Layout, Reihenfolge und Querverweisen ab, nicht nur vom Textinhalt. Die Aufteilung eines Fusionsvertrags in einzelne Seiten ist keine Digitalisierung – es ist Informationsvernichtung.
Verträge – Mehrseitige Vereinbarungen mit verteilter Semantik
Ein typischer Handelsvertrag umfasst 20 bis 80 Seiten. Ein Arbeitsvertrag kann 5 bis 15 Seiten haben. Ein Rahmenliefervertrag mit Anhängen und Änderungen kann über 100 Seiten umfassen. Die Daten, die eine Rechtsabteilung aus diesen Dokumenten benötigt – Vertragspartner, Wirksamkeitsdatum, anwendbares Recht, Haftungsobergrenzen, Verlängerungsbedingungen, ordentliche Kündigung – sind über das gesamte Dokument von Seite 1 bis Seite 78 verteilt. Das Wirksamkeitsdatum steht in der Präambel. Die Rechtswahlklausel befindet sich meist im Abschnitt „Allgemeine Bestimmungen", oft dem letzten inhaltlichen Abschnitt vor den Unterschriftsblöcken. Die Haftungsobergrenze könnte in einem Anhang stehen, auf den in Abschnitt 12 verwiesen wird, der sich aber physisch 20 Seiten später befindet.
Generische OCR, die jede Seite unabhängig behandelt, zerstört jede seitenübergreifende Beziehung. Eine Klausel, die auf Seite 14 beginnt und auf Seite 15 endet, wird in zwei Fragmente aufgeteilt. Eine Tabelle mit Zahlungsmeilensteinen über die Seiten 22–24 verliert den Zeilenzusammenhang über den Seitenumbruch hinweg. Ein Unterschriftsblock auf Seite 79 hat keine Verbindung zur unterzeichnenden Partei, die auf Seite 1 genannt wird. Juristische OCR muss den dokumentübergreifenden Kontext verfolgen – alle Seiten lesen, Querverweise erhalten und erkennen, dass ein in Abschnitt 1.2 auf Seite 3 eingeführter definierter Begriff seine Verwendung auf Seite 47 bestimmt.
Bates-Nummerierung fügt eine weitere Ebene hinzu. Jede Seite produzierter Dokumente trägt eine eindeutige Bates-Nummer, die während des gesamten Rechtsstreits als Beweismittelkennung dient. Standard-OCR, die „IMG_000123" als zufälligen Fußzeilentext liest oder ganz weglässt, unterbricht die Beweiskette. FRCP Regel 34(b) erlaubt anfordernden Parteien, das Produktionsformat zu bestimmen, und die Bates-Nummerierung ist der De-facto-Standard – OCR, die diese nicht erhält, produziert Dokumente, die die Anforderung der „angemessen verwendbaren Form" nicht erfüllen.
Gerichtliche Schriftsätze und Schriftsatzeinreichungen — Mehrspaltige Formatierung und Zitierstruktur
Berufungsschriftsätze, Rechtsmemoranden und Anträge unterliegen strengen Formatierungsvorschriften, die durch lokale Gerichtsordnungen und die FRCP festgelegt sind. Zweispaltige Layouts sind in vielen Gerichtsbarkeiten Standard, wobei der Haupttext in der breiteren Spalte und Fallzitate oder Anmerkungen in der schmaleren Spalte stehen. Generische OCR, die von links nach rechts über die gesamte Seite liest, vermischt die Zitatspalte mitten in einem Satz und erzeugt Text, der nicht nur unordentlich, sondern rechtlich irreführend ist – ein Fallzitat, das zu einem anderen Argument zu gehören scheint als dem, das der Schriftsatz tatsächlich vorbringt.
Die Zitaterkennung ist eine weitere spezialisierte Anforderung. Juristische Dokumente stützen sich auf präzise Zitate – „Smith v. Jones, 123 F.3d 456, 460 (9th Cir. 2025)" – wobei die Seitenzahl nach dem Komma präjudizielle Bedeutung hat. Wenn die OCR die präzise Seitenzahl verliert oder in den umgebenden Text einfügt, wird der Zitierprüfungs-Workflow unterbrochen, auf den jeder Prozessanwalt angewiesen ist. Die Zitierformate des California Style Manual und des Bluebook fügen strukturelle Komplexität hinzu, die zeichenbasierte OCR nicht erfassen kann.
Handschriftliche Anmerkungen verschärfen die Herausforderung. Richter und Partner schreiben Randnotizen in Schriftsatzentwürfe. Rechtsanwaltsfachangestellte markieren Abschnitte mit handschriftlichen Haftnotizen. Schriftsätze der gegnerischen Anwaltschaft können durchgestrichene Bearbeitungen, eingekreiste Absatznummern oder Initialen am Rand enthalten. Herkömmliche OCR überspringt Handschrift entweder vollständig oder liefert unzuverlässige Zeichenratungen. KI-basierte OCR verarbeitet Handschrift bei sauberen Bildern mit einer Genauigkeit von 85–95 % – ausreichend, um Randanmerkungen zu erfassen, die oft das inhaltliche Feedback zu einem rechtlichen Argument enthalten.
eDiscovery-Dokumente — Variable Qualität in massivem Umfang
eDiscovery-Dokumentenpopulationen sind definitionsgemäß heterogen: E-Mails, PDFs, gescannte Korrespondenz, Smartphone-Fotos von physischen Dokumenten, Textnachrichten, Tabellenkalkulationen und Präsentationsdateien – alles gemischt in einem einzigen Produktionssatz. Ein Relativity-Verarbeitungsbericht für einen Standard-Zivilrechtsfall könnte 40 % native elektronische Dateien, 35 % gescannte Papierdokumente, 15 % E-Mail-Anhänge in verschiedenen Formaten und 10 % Legacy-Medien (alte WordPerfect-Dateien, gescannte Faxe, Mikrofiche-Konvertierungen) zeigen.
Jede Format-Untergruppe weist unterschiedliche OCR-Fehlermodi auf. Gescannte Papierdokumente aus jahrzehntealten Fallakten können eine niedrige Auflösung, Schräglage oder Verblassung aufweisen. Smartphone-Fotos von physischen Dokumenten führen zu perspektivischer Verzerrung, Spiegelungen und ungleichmäßiger Beleuchtung. Gefaxte Dokumente fallen auf 200 DPI mit Komprimierungsartefakten, die Zeichenerkennungsalgorithmen verwirren. Eine OCR-Pipeline für eDiscovery muss diese variablen Eingaben verarbeiten, ohne dass eine dokumentenspezifische Qualitätsprüfung erforderlich ist – denn bei fünf Millionen Seiten ist eine Einzelprüfung jeder Seite nicht durchführbar.
Die Erstellung von Privilegienprotokollen ist der Bereich, in dem OCR-Fehler beruflich folgenreich werden. Ein Privilegienprotokoll erfordert die Identifizierung jedes Dokuments, das anwaltlich geschützte oder dem Arbeitsergebnis-Schutz unterliegende Informationen enthält, die Extraktion von Datum, Autor, Empfängern und Betreff sowie die Aufzeichnung der Privilegienbasis – alles vor der Produktion. Eine OCR, die einen „PRIVILEGED AND CONFIDENTIAL"-Header in einer gescannten E-Mail übersieht oder einen Anwaltskanzleinamen in einem Metadatenfeld falsch liest, schafft ein Verzichtswagnis. Die FRCP verlangt keine perfekte Privilegienidentifizierung, aber Regel 26(b)(5)(A) verlangt von der produzierenden Partei, „die Art der zurückgehaltenen Dokumente zu beschreiben" – ein Standard, der eine genaue OCR der wichtigsten Identifikationsinformationen der Dokumente voraussetzt.
Der gemeinsame Nenner dieser Dokumenttypen: Juristische OCR scheitert nicht daran, dass Zeichen falsch erkannt werden – auch wenn das vorkommt –, sondern weil Struktur verloren geht. Bates-Nummern, die von Seiten getrennt werden, Klauseln, die über Seitenumbrüche aufgeteilt werden, Vertraulichkeitsvermerke, die als Fließtext behandelt werden, mehrspaltige Schriftsätze, die zu einspaltigen Textströmen eingeebnet werden. Ein juristisches OCR-Tool, das eine Zeichengenauigkeit von 99,5 % erreicht, aber die Dokumentstruktur zerstört, erzeugt Ergebnisse, die schlimmer als nutzlos sind – sie sind beruflich gefährlich.
Traditionelle OCR vs. KI-OCR für juristische Dokumente
Der Unterschied zwischen traditioneller OCR und KI-gestützter Extraktion ist für juristische Arbeitsabläufe nicht akademisch – er entscheidet darüber, ob ein Tool die im vorherigen Abschnitt beschriebene strukturelle Komplexität bewältigen kann oder bei jeder Datei manuelle Nacharbeit erfordert.
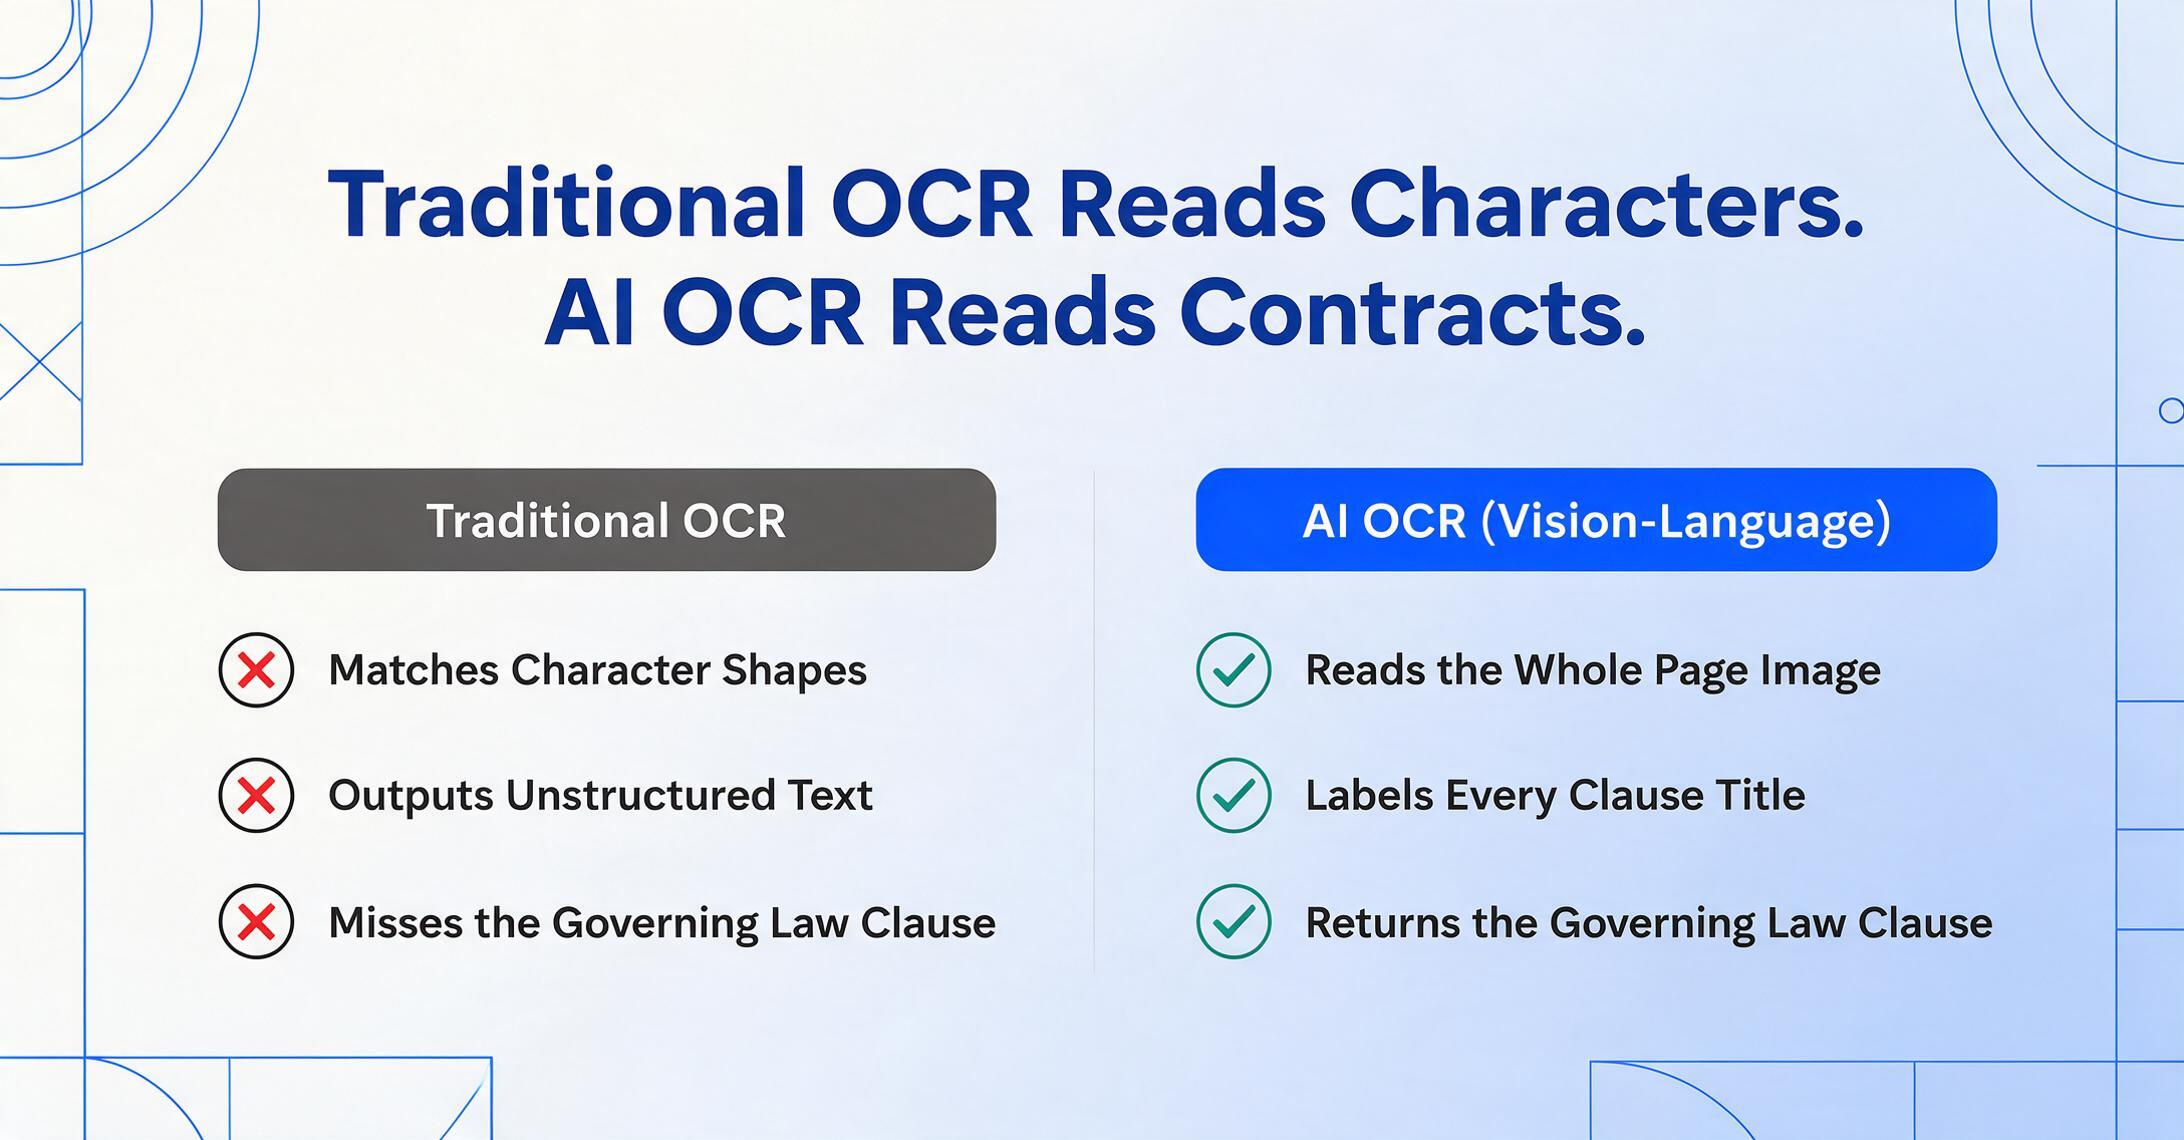
Traditionelle OCR – das Paradigma der Zeichenerkennung. Tools wie Tesseract, ABBYY FineReader und die in Dokumentenscannern integrierten OCR-Engines arbeiten mit einer Pixel-zu-Zeichen-Pipeline: Formen auf der Seite identifizieren, sie mit einer Bibliothek bekannter Zeichenmuster abgleichen und Text ausgeben. Die Ausgabe ist ein durchsuchbares PDF oder eine Klartextdatei – Zeichen in Lesereihenfolge, ohne semantische Struktur. Das ist völlig ausreichend, um einen gescannten Vertrag volltextdurchsuchbar zu machen. Es ist nicht ausreichend, um die Rechtswahlklausel, die Haftungsobergrenze oder die Verlängerungsfrist als einzelne Datenpunkte zu extrahieren – denn das Tool weiß nicht, was eine Rechtswahlklausel ist.
KI-OCR – das Paradigma der visuellen Sprachverarbeitung. Moderne KI-basierte Extraktion verwendet visuelle Sprachmodelle (VLMs), die eine Seite so lesen, wie es ein menschlicher Leser tun würde: visuell, ganzheitlich und semantisch. Es erkennt nicht Zeichen einzeln. Es verarbeitet das gesamte Dokumentbild, identifiziert Textbereiche, bestimmt deren funktionale Rolle (Kopfzeile, Fließtext, Klauseltitel, Unterschriftsblock, Randbemerkung) und extrahiert Bedeutung – nicht nur Zeichen. Eine ausführliche Erklärung dieser Architektur finden Sie unter Was KI-OCR ist und wie es sich von der traditionellen Zeichenerkennung unterscheidet.
In der juristischen Praxis führt dieser architektonische Unterschied zu konkreten operativen Unterschieden:
| Anforderung | Traditionelle OCR | KI-OCR (Vision-Language) |
|---|---|---|
| Bates-Nummern-Erhaltung | Behandelt als Streutext; oft weggelassen oder verschmolzen | Erkennt seitenweise Kennungen anhand des Musters; bewahrt sie |
| Klausel-Extraktion | Gibt gesamten Text sequenziell aus; keine Klausel-Identifikation | Identifiziert Klauselgrenzen anhand semantischer Rolle |
| Mehrspaltige Schriftsätze | Von links nach rechts über Spalten; Lesereihenfolge gestört | Spaltenbewusste Lesereihenfolge durch visuelle Layoutanalyse |
| Tabellenkontinuität über Seiten | Jede Seite einzeln verarbeitet; Zeilen brechen an Seitenrändern ab | Dokumentweiter Kontext erhalten; Tabellen seitenübergreifend rekonstruiert |
| Handschriftliche Anmerkungen | Typischerweise < 40 % Genauigkeit bei Schreibschrift | 85–95 % bei deutlicher Handschrift |
| Erkennung von Privilegvermerken | Wird als Fließtext gelesen; keine Markierung | Erkennt Privileg-Header anhand von Mustern und kennzeichnet sie zur Prüfung |
| Vorlagenfreier Betrieb | Erfordert formatabhängige Zonendefinitionen | Funktioniert ohne Einrichtung über Formate hinweg |
Das für die Rechtsbranche wichtigste Paradigma ist die benutzerdefinierte Spaltenextraktion: Sie definieren die gewünschten Ausgabespalten – „Haftungsobergrenze“, „Gerichtsstand“, „Kündigungsfrist bei Verlängerung“, „Haftungsbeschränkung“ – und die KI liest jede Seite jedes Dokuments, lokalisiert die Textblöcke, die den einzelnen angeforderten Feldern entsprechen, indem sie deren semantische Rolle versteht, und ordnet jede Übereinstimmung der richtigen Ausgabespalte zu. Keine Zonenzeichnung. Keine Vorlage pro Vertragspartner. Kein manueller Abgleich von Klauseldefinitionen, die in verschiedenen Vereinbarungen unterschiedliche Formulierungen verwenden. Dies ist der Wechsel von positionsbasierter zu semantischer Extraktion – und er adressiert direkt die Formatvarianz, die Vertrags- und eDiscovery-Verarbeitung mit herkömmlichen Werkzeugen unverhältnismäßig teuer macht.
Wichtige Felder für die Extraktion aus Rechtsdokumenten
Was ein Rechtsteam extrahieren muss, hängt vom Anwendungsfall ab – Due Diligence, Vertragsportfoliomanagement, eDiscovery-Review oder Prozessunterstützung. Die meisten Extraktions-Workflows im Rechtsbereich konvergieren jedoch auf einen Kern von Feldern, die nach dem Dokumentzweck organisiert sind.
Für Verträge und Vereinbarungen
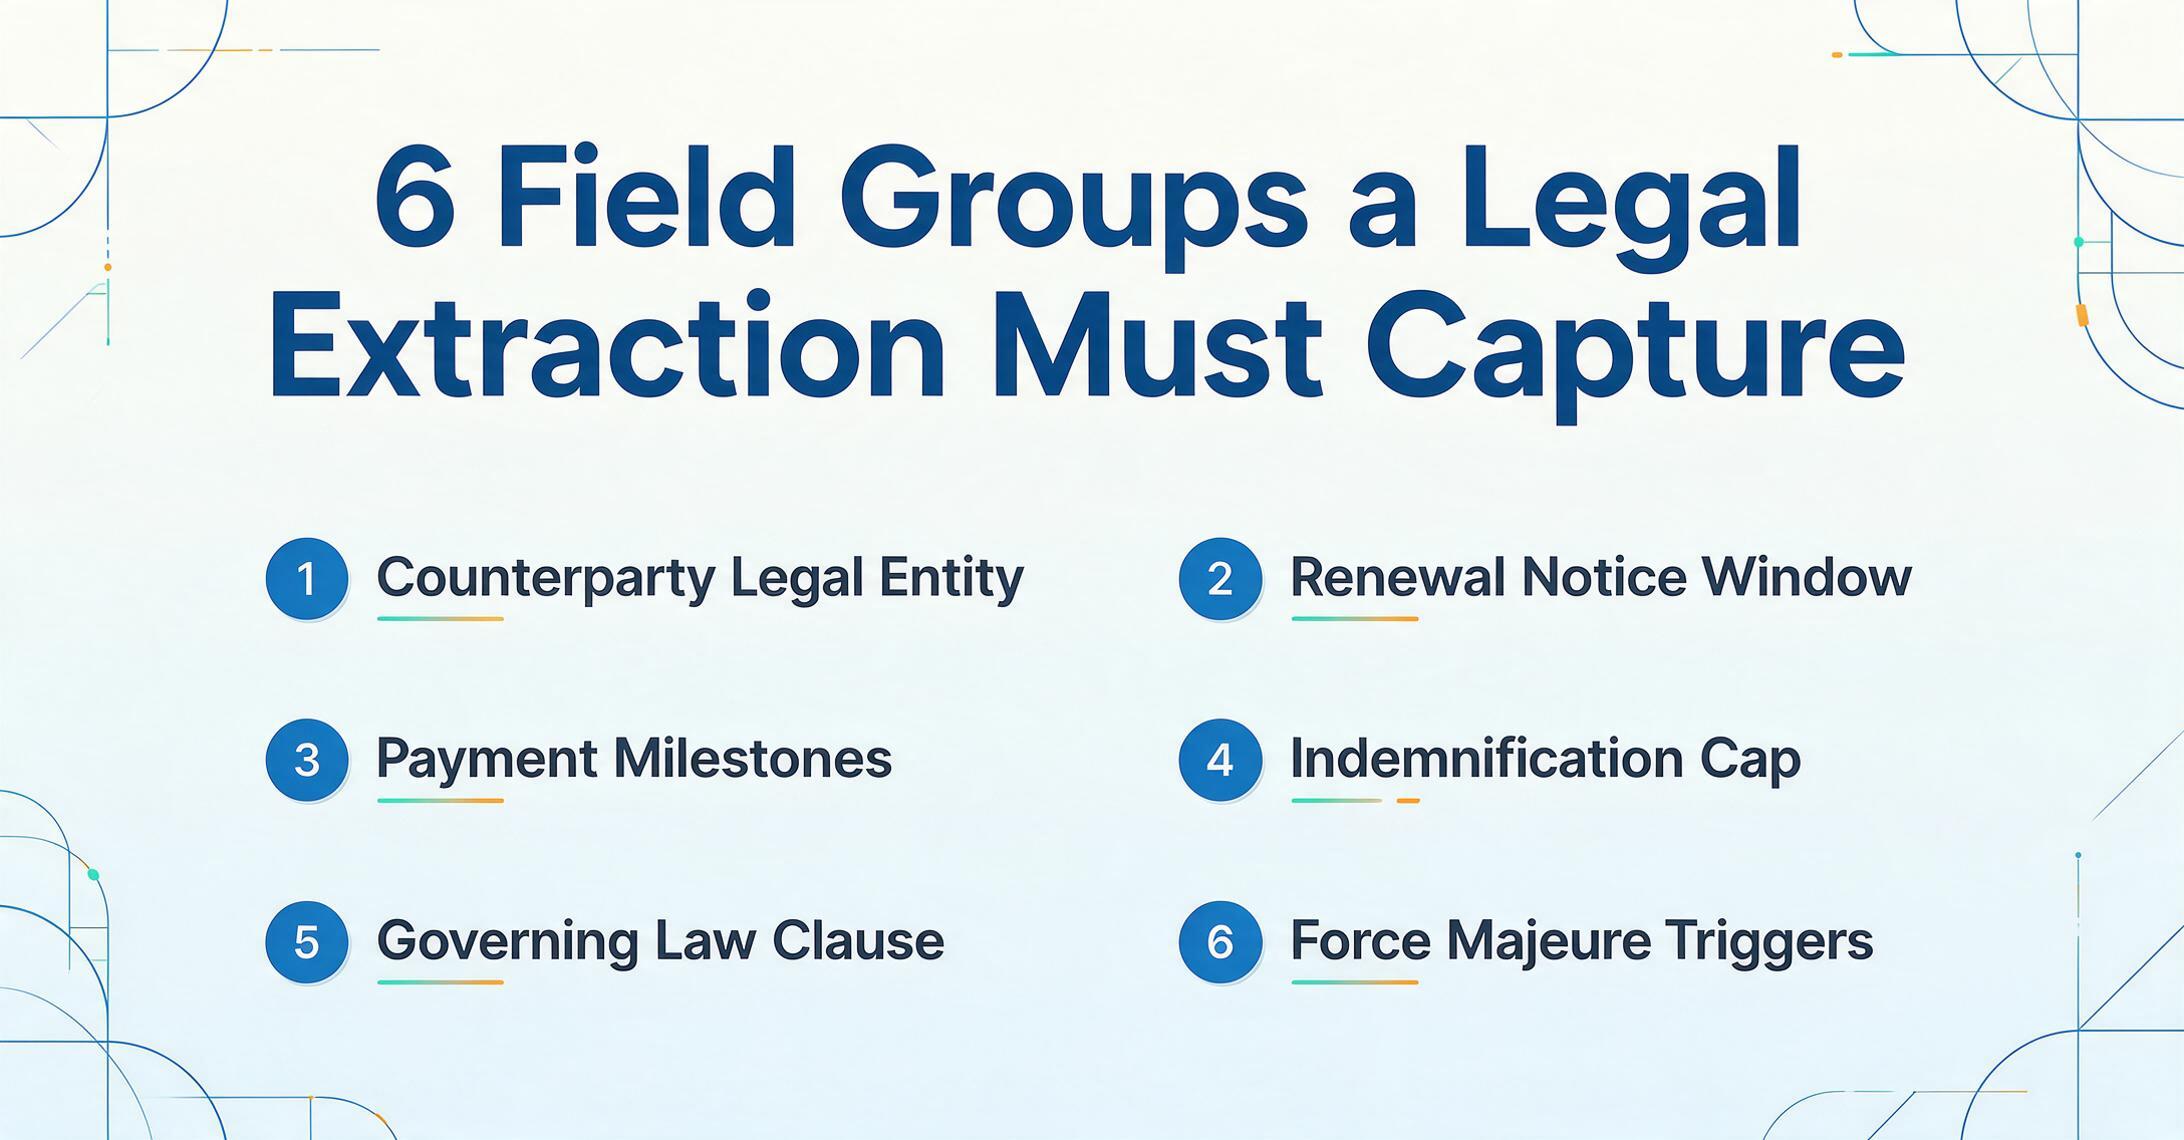
| Feldkategorie | Spezifische Felder | Warum es wichtig ist |
|---|---|---|
| Parteiidentifikation | Name der Gegenpartei, handelnde Rechtseinheit, Gründungsgerichtsbarkeit | Eine Gegenpartei kann über mehrere Tochtergesellschaften vertraglich handeln; die Identifizierung der korrekten Rechtseinheit ist für die Durchsetzung entscheidend |
| Daten und Fristen | Wirksamkeitsdatum, Ablaufdatum, Kündigungsfrist für Verlängerung, Kündigungsfenster aus Bequemlichkeit | Automatische Verlängerungsfallen und versäumte Kündigungsfenster sind die häufigste Ursache für Vertragshaftung |
| Finanzielle Bedingungen | Vertragswert, Zahlungsplan, Preisanpassungsmechanismus, Bedingungen für Verspätungsgebühren | Gebührenpläne erstrecken sich oft über Anlagetabellen; die Extraktion muss Querverweise verfolgen |
| Risikoverteilung | Umfang und Obergrenze der Freistellung, Haftungsbeschränkung, Ausschluss von Folgeschäden | Diese Klauseln bestimmen das finanzielle Risiko; „unbegrenzte Freistellung“ ist ein Warnsignal-Feld für jede Prüfung |
| Maßgebliche Bestimmungen | Anwendbares Recht, Streitbeilegung (Schiedsverfahren vs. Gerichtsverfahren), Gerichtsstand, Verzicht auf Jury-Verhandlung | Wirkt sich direkt darauf aus, wo und wie Streitigkeiten beigelegt werden; typischerweise eine einzelne Klausel im Abschnitt mit allgemeinen Bestimmungen |
| Operative Klauseln | Auslöseereignisse für höhere Gewalt, Umfang und Dauer des Wettbewerbsverbots, Vertraulichkeitsdauer, Datenschutzverpflichtungen | Leistungspflichten nach der Unterzeichnung, die sich direkt auf den Betrieb auswirken |
| Kündigung | Kündigung aus wichtigem Grund, Kündigung aus Bequemlichkeit, Pflichten nach der Kündigung, Fortbestandsklauseln | Beendigungsbedingungen definieren sowohl die Kosten der Beendigung einer Beziehung als auch fortbestehende Pflichten nach der Kündigung |
Für eDiscovery- und Prozessdokumente
- Dokumentkennungen: Bates-Nummernbereich, Name des Verwahrers, Quellvorgangsnummer, Erstellungsdatum — diese Metadaten sind das Minimum, das erforderlich ist, um produzierte Dokumente gemäß FRCP Rule 34(b) nutzbar zu machen.
- Privilegien-Kennzeichnungen: „PRIVILEGED AND CONFIDENTIAL", „ATTORNEY WORK PRODUCT", „ATTORNEY-CLIENT PRIVILEGE" — Kopf- und Fußzeilen sowie Stempel, die vor der Produktion erkannt und gekennzeichnet werden müssen.
- Wichtige Beteiligte und Daten: Autor (aus E-Mail-Kopfzeilen oder Signaturblöcken), Empfänger (einschließlich CC und BCC, sofern zugänglich), Erstellungsdatum, Sendedatum, Produktionsdatum — verwendet für Beweiszeitlinien und Zeugenvorbereitung.
- Klassifizierung des Dokumenttyps: Vertrag, E-Mail, Memo, Schriftsatz, Tabellenkalkulation, Voicemail-Transkript, SMS-Export — Klassifizierung von Dokumenten in großem Umfang, damit Prüfungsteams den richtigen Workflow auf jede Kategorie anwenden.
- Schwärzungsbereiche: Bereiche eines Dokuments, die geschwärzt wurden (geschwärzt oder weiß übermalt), ihre Position und ihr Umfang — Schwärzungen müssen während der Verarbeitung erhalten und kartiert werden, um die Vollständigkeit der Produktion sicherzustellen.
Für einen tieferen Einblick speziell in die Extraktion auf Klauselebene, siehe unseren Leitfaden zur Extraktion juristischer Verträge und wie sich die Klauselidentifizierung von der Extraktion auf Feldebene für Due Diligence und Portfoliomanagement unterscheidet.
Compliance-Überlegungen für juristische OCR
OCR in der Anwaltspraxis ist nicht nur eine Technologieentscheidung — es ist eine Compliance-Entscheidung. Drei regulatorische Rahmenwerke regeln direkt, wie Anwaltskanzleien mit digitalisierten Dokumenten umgehen müssen.
ABA Model Rules: Technologiekompetenz und Vertraulichkeit
ABA Model Rule 1.1 (Kompetenz) — präzisiert durch ABA Formal Opinion 477R (2017) — verlangt von Anwälten, „mit den Änderungen im Recht und seiner Praxis Schritt zu halten, einschließlich der Vorteile und Risiken, die mit relevanter Technologie verbunden sind." Dies bedeutet, dass ein Anwalt, der OCR zur Verarbeitung von Mandantendokumenten einsetzt, ohne die Genauigkeitsgrenzen, Datenverarbeitungsverfahren oder Fähigkeiten zur Strukturerhaltung des Tools zu verstehen, möglicherweise unter dem Kompetenzstandard arbeitet. Die Regel verlangt keine perfekte OCR, aber sie verlangt eine informierte Auswahl und angemessene Überwachung der in Mandatssachen verwendeten Technologie.
ABA Model Rule 1.6 (Vertraulichkeit von Informationen) verlangt von Anwälten, „angemessene Anstrengungen zu unternehmen, um die versehentliche oder unbefugte Offenlegung von oder den Zugriff auf Informationen im Zusammenhang mit der Vertretung eines Mandanten zu verhindern." Wenn OCR Dokumente verarbeitet, die privilegiertes Material, Geschäftsgeheimnisse oder personenbezogene Daten enthalten — und wenn diese Dokumente durch die Server des OCR-Anbieters laufen — auferlegt Rule 1.6 die Verpflichtung, die Datensicherheit, Verschlüsselungsstandards und Datenaufbewahrungsrichtlinien des Anbieters zu bewerten. Die ABA Model Rules schreiben keine lokale Verarbeitung vor, aber sie verlangen, dass die Auslagerung der Dokumentenverarbeitung an ein Cloud-OCR-Tool einem „angemessenen Anstrengungen"-Standard für den Vertraulichkeitsschutz entspricht.
FRCP — Anforderungen an die Produktion elektronisch gespeicherter Informationen
FRCP Rule 34(b) erlaubt der anfordernden Partei, die Form der Produktion für ESI festzulegen, und verlangt von der produzierenden Partei, diese entweder „in einer Form oder in Formen, in der sie gewöhnlich aufbewahrt wird, oder in einer angemessen nutzbaren Form oder Formen" zu produzieren. OCR-verarbeitete Dokumente müssen durchsuchbar sein, wobei Bates-Nummern erhalten bleiben und Text extrahierbar sein muss. Ein Produktionssatz, bei dem die OCR die Schlüsseldokumente falsch gelesen hat – oder bei dem die OCR-Ebene für gescannte Dateien fehlt – kann als nicht „angemessen nutzbar" angefochten werden. Gerichte haben Parteien sanktioniert, die ESI in Formaten produziert haben, die technisch zugänglich, aber praktisch unbrauchbar waren, und eine schwache OCR-Ebene ist ein häufiger beitragender Faktor.
FRCP Rule 26(f) verlangt von den Parteien, „alle Fragen zur Erhaltung auffindbarer Informationen" und „alle Fragen zur Offenlegung oder Entdeckung elektronisch gespeicherter Informationen, einschließlich der Form oder Formen, in der sie produziert werden sollen", während der Vorermittlungskonferenz zu erörtern. Die Rule 26(f)-Besprechung ist der Ort, an dem OCR-Qualitätsstandards festgelegt werden – die Parteien können Mindestgenauigkeitsschwellen für OCR, Konventionen zur Bates-Nummerierung und einzuschließende Metadatenfelder vereinbaren. Eine Kanzlei, die diese Diskussion ohne Kenntnis der Fähigkeiten und Grenzen ihres OCR-Tools führt, verhandelt aus einer Position der Unwissenheit, was sowohl strategisches als auch ethisches Risiko schafft.
Integration in eDiscovery-Plattformen
Die meisten modernen juristischen OCR-Workflows operieren innerhalb eines eDiscovery-Ökosystems, das Tools wie Relativity (die dominante eDiscovery-Verarbeitungs- und Prüfungsplattform), NetDocuments und iManage (Cloud-Dokumentenmanagementsysteme, die von Am-Law-200-Kanzleien genutzt werden) sowie Praxisverwaltungsplattformen wie Clio und MyCase (dominant im Markt für Einzelanwälte und kleine Kanzleien) umfasst. Ein OCR-Tool, das nicht in Formate exportieren kann, die diese Plattformen aufnehmen – oder das die Metadatenebene entfernt, die diese Plattformen benötigen – führt einen manuellen Brückenschritt ein, der den Zweck der Digitalisierung zunichtemacht.
Relativity beispielsweise nimmt OCR-Text als Teil seiner Verarbeitungspipeline über eine `.txt`- oder `.ocr`-Ladedatei auf. Wenn das OCR-Tool die Eins-zu-eins-Seiten-zu-Text-Zuordnung, die Relativity für seine Prüfungsdatenbank benötigt, nicht aufrechterhält, verliert das Dokument seine Verbindung zum extrahierten Text, wodurch die OCR-Investition in der Prüfungsphase nutzlos wird. Für Kanzleien, die ihr Dokumentenmanagement auf iManage oder NetDocuments betreiben, muss die OCR-Ausgabe die Ordnerstruktur, den Versionsverlauf und das Berechtigungsmodell des Dokuments bewahren – sonst repliziert der digitale Aktenschrank das Chaos des papierbasierten.
Für einen umfassenden Vergleich von Tools, die für juristische Workflows entwickelt wurden – einschließlich der Frage, wie jedes mit Bates-Nummerierung, Erkennung von Privilegienmarkierungen und eDiscovery-Plattformintegration umgeht – siehe unsere Übersicht der besten OCR-Software für Rechtsdokumente 2026.
OCR für die juristische Arbeit: So wählen Sie richtig
Die Bewertungskriterien für juristische OCR unterscheiden sich in fünf Dimensionen von denen für generische Dokumenten-OCR. Jede Kanzlei, die OCR-Tools evaluiert, sollte diese spezifischen Anforderungen anhand eigener Dokumente testen, bevor sie sich für eine Plattform entscheidet.
1. Layout- und Strukturerhaltung
Das mit Abstand wichtigste Kriterium. Testen Sie mit einem mehrspaltigen Schriftsatz, einem Vertrag mit einer Anlagentabelle über einen Seitenumbruch hinweg und einem Dokument mit Bates-Nummern in der Fußzeile. Bleibt die Lesereihenfolge der Spalten erhalten? Werden Tabellen korrekt über Seitengrenzen hinweg rekonstruiert? Werden Bates-Nummern als durchsuchbare Kennungen erfasst und nicht verworfen?
2. Extraktion auf Klausel- oder Feldebene
Generische OCR gibt den gesamten Text aus. Juristische Arbeitsabläufe benötigen spezifische Datenpunkte: „Gib mir die Haftungsobergrenze aus jedem Vertrag dieser Transaktion.“ Prüfen Sie, ob das Tool von Ihnen als Spalten definierte Felder (Vertragspartner, Wirksamkeitsdatum, anwendbares Recht, Verlängerungsbedingungen) über einen Stapel von Dokumenten verschiedener Vertragspartner hinweg extrahieren kann – ohne dass eine dokumentenspezifische Vorlageneinrichtung erforderlich ist. Hier werden benutzerdefinierte Spaltenextraktion und Batch-First-Verarbeitung zu operativen Anforderungen und nicht nur zu Feature-Listenpunkten.
3. Sicherheit, Compliance und Datenhandhabung
SOC-2-Typ-II-Zertifizierung, Verschlüsselung während der Übertragung und im Ruhezustand, Richtlinien zur Datenaufbewahrung und -löschung sowie die Möglichkeit, verarbeitete Dokumente auf Anfrage zu löschen. Für Kanzleien, die für Behörden oder regulierte Branchen tätig sind, kann eine FedRAMP-Autorisierung oder ein gleichwertiges Verfahren erforderlich sein. Bestätigen Sie den Standort der Datenverarbeitung des Anbieters, falls gerichtliche Anforderungen bestehen. Die Sorgfaltspflicht gemäß Regel 1.6 erfordert eine schriftliche Bestätigung dieser Schutzmaßnahmen vor dem Hochladen von Mandantendaten.
4. Stapelverarbeitung im juristischen Maßstab
Ein Einzelanwalt benötigt vielleicht 50 Verträge pro Monat. Eine mittelgroße Prozessführungskanzlei benötigt 50.000 Dokumente pro Fall. Ein eDiscovery-Anbieter verarbeitet Millionen. Das Tool muss vom Einzelfall-Workflow bis zur Multi-Custodian-Produktion skalieren, ohne die Architektur zu ändern. Bewerten Sie Upload-Limits, gleichzeitige Verarbeitungskapazität und Exportzuverlässigkeit bei Ihrem tatsächlichen Volumen – nicht beim Demo-Volumen von fünf Beispieldateien.
5. Integration in den juristischen Technologie-Stack
Exportiert das Tool in Formate, die Relativity, NetDocuments, iManage, Clio oder MyCase direkt importieren können? Unterstützt es das Metadaten-Mapping (Bates-Bereich, Custodian, Erstellungsdatum), das eDiscovery-Plattformen benötigen? Oder erzwingt es eine manuelle Download-und-Wiederupload-Brücke? Je weniger Schnittstellen, desto weniger Fehlerquellen – und desto geringer die Gesamtkosten der Digitalisierung.
Für juristische Teams, die einen einfachen Einstieg benötigen – Dokumente hochladen, Ausgabespalten definieren, strukturierte Daten erhalten, ohne Vorlagen zu konfigurieren oder Modelle zu trainieren – eliminieren Tools auf Basis von Vision-Language-KI den Einrichtungsaufwand, der die Einführung von OCR in der Anwaltspraxis historisch teuer gemacht hat. Erfahren Sie, wie das KI-OCR-Software-Paradigma auf juristische Dokumenten-Workflows anwendbar ist, oder erkunden Sie die breitere OCR-Software-Kategorie für einen Funktionsvergleich verschiedener Extraktionsansätze.
Häufig gestellte Fragen
Was unterscheidet OCR für juristische Dokumente von Standard-OCR?
Standard-OCR liest Zeichen und gibt Text aus. Juristische OCR muss die Dokumentstruktur erhalten – Bates-Nummern, mehrspaltige Formatierung, klauselübergreifende Kontinuität über Seiten hinweg, Privilegienvermerke – da die juristische Bedeutung von Layout und Reihenfolge abhängt, nicht nur vom Textinhalt. Ein Standard-OCR-Tool, das eine Zeichengenauigkeit von 99 % erreicht, aber ein mehrspaltiges Schriftsatzstück in einen einzigen Textstrom zusammenführt, erzeugt eine Ausgabe, die für den juristischen Gebrauch strukturell unbrauchbar ist.
Kann OCR handschriftliche Anmerkungen auf juristischen Dokumenten verarbeiten?
Traditionelle OCR erreicht bei kursiver Handschrift typischerweise eine Genauigkeit von unter 40 %. Moderne KI-basierte OCR mit Vision-Language-Modellen erreicht bei gut lesbarer Handschrift 85–95 %, was ausreicht, um Randanmerkungen, Unterschriftenblöcke und richterliche Vermerke auf Entwurfsschriftsätzen zu erfassen. Bei schlechter Bildqualität, überlappender Handschrift und extremen kursiven Ausschmückungen nimmt die Genauigkeit ab – kritische handschriftliche Inhalte sollten daher weiterhin von einem menschlichen Prüfer verifiziert werden.
Erfüllt OCR die Anforderungen der ABA Model Rules an technologische Kompetenz?
ABA Model Rule 1.1, ausgelegt durch Formal Opinion 477R, verlangt von Anwälten, die Vorteile und Risiken der von ihnen verwendeten Technologie zu verstehen. Dies schreibt keine perfekte OCR-Genauigkeit vor, erfordert jedoch eine informierte Auswahl: Kenntnis der Genauigkeitsraten des eigenen Tools, der Fähigkeiten zur Strukturerhaltung, der Datensicherheitsmaßnahmen und der Grenzen – sowie die Anwendung angemessener menschlicher Prüfung, wo die Technologie hinter den Anforderungen zurückbleibt. Die Verwendung eines OCR-Tools ohne Verständnis dieser Parameter könnte als Unterschreiten des Kompetenzstandards beanstandet werden.
Wie wirkt sich OCR auf die Erstellung von eDiscovery-Privilegienprotokollen aus?
OCR ist für Workflows mit Privilegienprotokollen von entscheidender Bedeutung. Jedes Dokument, das in einen eDiscovery-Review-Satz aufgenommen wird, muss durchsuchbaren Text aus seinen gescannten Seiten enthalten – andernfalls erfordert die Identifizierung privilegierter Inhalte das Öffnen und Lesen jeder Seite jedes Dokuments. KI-OCR, das Kopfzeilen wie „PRIVILEGED AND CONFIDENTIAL“ erkennen, Kanzleinamen identifizieren und Dokumente mit Anwaltsprüfungsmustern kennzeichnen kann, beschleunigt die Identifizierung von Privilegien. Allerdings sollte kein OCR-Tool als alleiniger Mechanismus für die Privilegienbestimmung verwendet werden; OCR identifiziert Kandidaten für die Privilegienprüfung, ersetzt sie jedoch nicht.
Worauf sollte eine Anwaltskanzlei bei der Bewertung eines OCR-Anbieters achten?
Fünf Prioritäten: (1) Testen Sie an Ihren tatsächlichen Dokumenten – insbesondere mehrspaltigen Schriftsätzen, Verträgen mit tabellarischen Anlagen und gescannten Dokumenten unterschiedlicher Qualität. (2) Bestätigen Sie die Layout-Erhaltung: Überleben Bates-Nummern die Extraktion, werden Tabellen korrekt rekonstruiert, wird die Lesereihenfolge in mehrspaltigen Layouts beibehalten? (3) Überprüfen Sie die Extraktionsfähigkeit auf Klausel- oder Feldebene – ermöglicht Ihnen das Tool, die gewünschten Felder zu definieren und sie ohne dokumentenspezifische Einrichtung über Dokumente hinweg zu finden? (4) Prüfen Sie Sicherheitszertifizierungen (SOC 2, Verschlüsselung, Datenlöschungsrichtlinien) im Hinblick auf Ihre Verpflichtungen gemäß Rule 1.6. (5) Validieren Sie die Integration in Ihren bestehenden Legal-Technology-Stack – Relativity, NetDocuments, iManage, Clio oder andere Plattformen, die Ihre Kanzlei verwendet.
Das Fazit für Legal-Teams
OCR für Rechtsdokumente ist kein Problem der Zeichenerkennung. Es ist ein Problem der Strukturerhaltung. Ein Tool, das jeden Buchstaben auf der Seite liest, aber die Beziehung zwischen einer Anlage und ihrem übergeordneten Vertrag, zwischen einer Bates-Nummer und ihrer Seite oder zwischen einer Privilegienkennzeichnung und dem von ihr geschützten Dokument verliert, hat das Dokument nicht digitalisiert – es hat eine Datenverbindlichkeit geschaffen.
Der technologische Wandel von positionsbasierter OCR hin zu Vision-Language-KI verändert grundlegend, was möglich ist. Wenn ein Tool Dokumente nach semantischer Bedeutung statt nach Vorlagenkoordinaten liest, wird die Vertragsextraktion zu einem einstufigen Vorgang über Hunderte von Vereinbarungen, die eDiscovery-Verarbeitung bewahrt strukturellen Kontext in großem Maßstab, und die Compliance-Anforderungen der ABA Model Rules und FRCP werden erreichbar statt bloß erstrebenswert. Die Frage für Legal-Teams lautet nicht mehr, ob OCR Rechtsdokumente verarbeiten kann. Sie lautet, ob das von ihnen gewählte OCR-Tool versteht, was Rechtsdokumente besonders macht – und ob es diesen Unterschied auf jeder verarbeiteten Seite bewahren kann.
Testen Sie diese Frage an Ihren eigenen Dokumenten – laden Sie einen Vertrag hoch, den Sie gut kennen, definieren Sie die Felder, die Sie tatsächlich benötigen, und prüfen Sie, ob die Ausgabe Ihnen liefert, was Sie mit einer einfachen Stichwortsuche nicht erhalten hätten.