A IA pode extrair dados de PDFs escaneados?
Sim — veja como funciona
Sim. A IA pode extrair dados estruturados — como datas, montos, nomes de fornecedores e itens — de PDFs escaneados, incluindo PDFs baseados em imagem onde a extração de texto tradicional falha. Em escaneos limpos de documentos impressos, as ferramentas modernas de extração com IA alcanzan até 99% de precisão. A escrita manual reduz isso a 85–95% dependendo da legibilidade. A distinção clave que determina se a extração funciona não é "quão boa é a IA" — é entender com que tipo de PDF você está lidando em primeiro lugar.
Puntos Clave
- Abre tu PDF e intenta seleccionar texto — si nada se resalta, cada biblioteca de Python, importador de Excel y analizador de PDF devuelve exactamente nada, porque los PDFs escaneados contienen cero caracteres.
- La IA omite la capa de texto por completo y lee las páginas escaneadas como escenas visuales — localizando "Total: $4,287.50" al entender lo que significa el número, no buscando sus coordenadas de píxeles.
- Los mismos tres nombres de columna — Número de Factura, Fecha, Total — extraen datos de PDFs nativos, PDFs escaneados y fotos de teléfono a través de un solo pipeline, porque la extracción nunca se trató del formato de archivo.
Como Funciona Bem: Os Três Tipos de PDFs
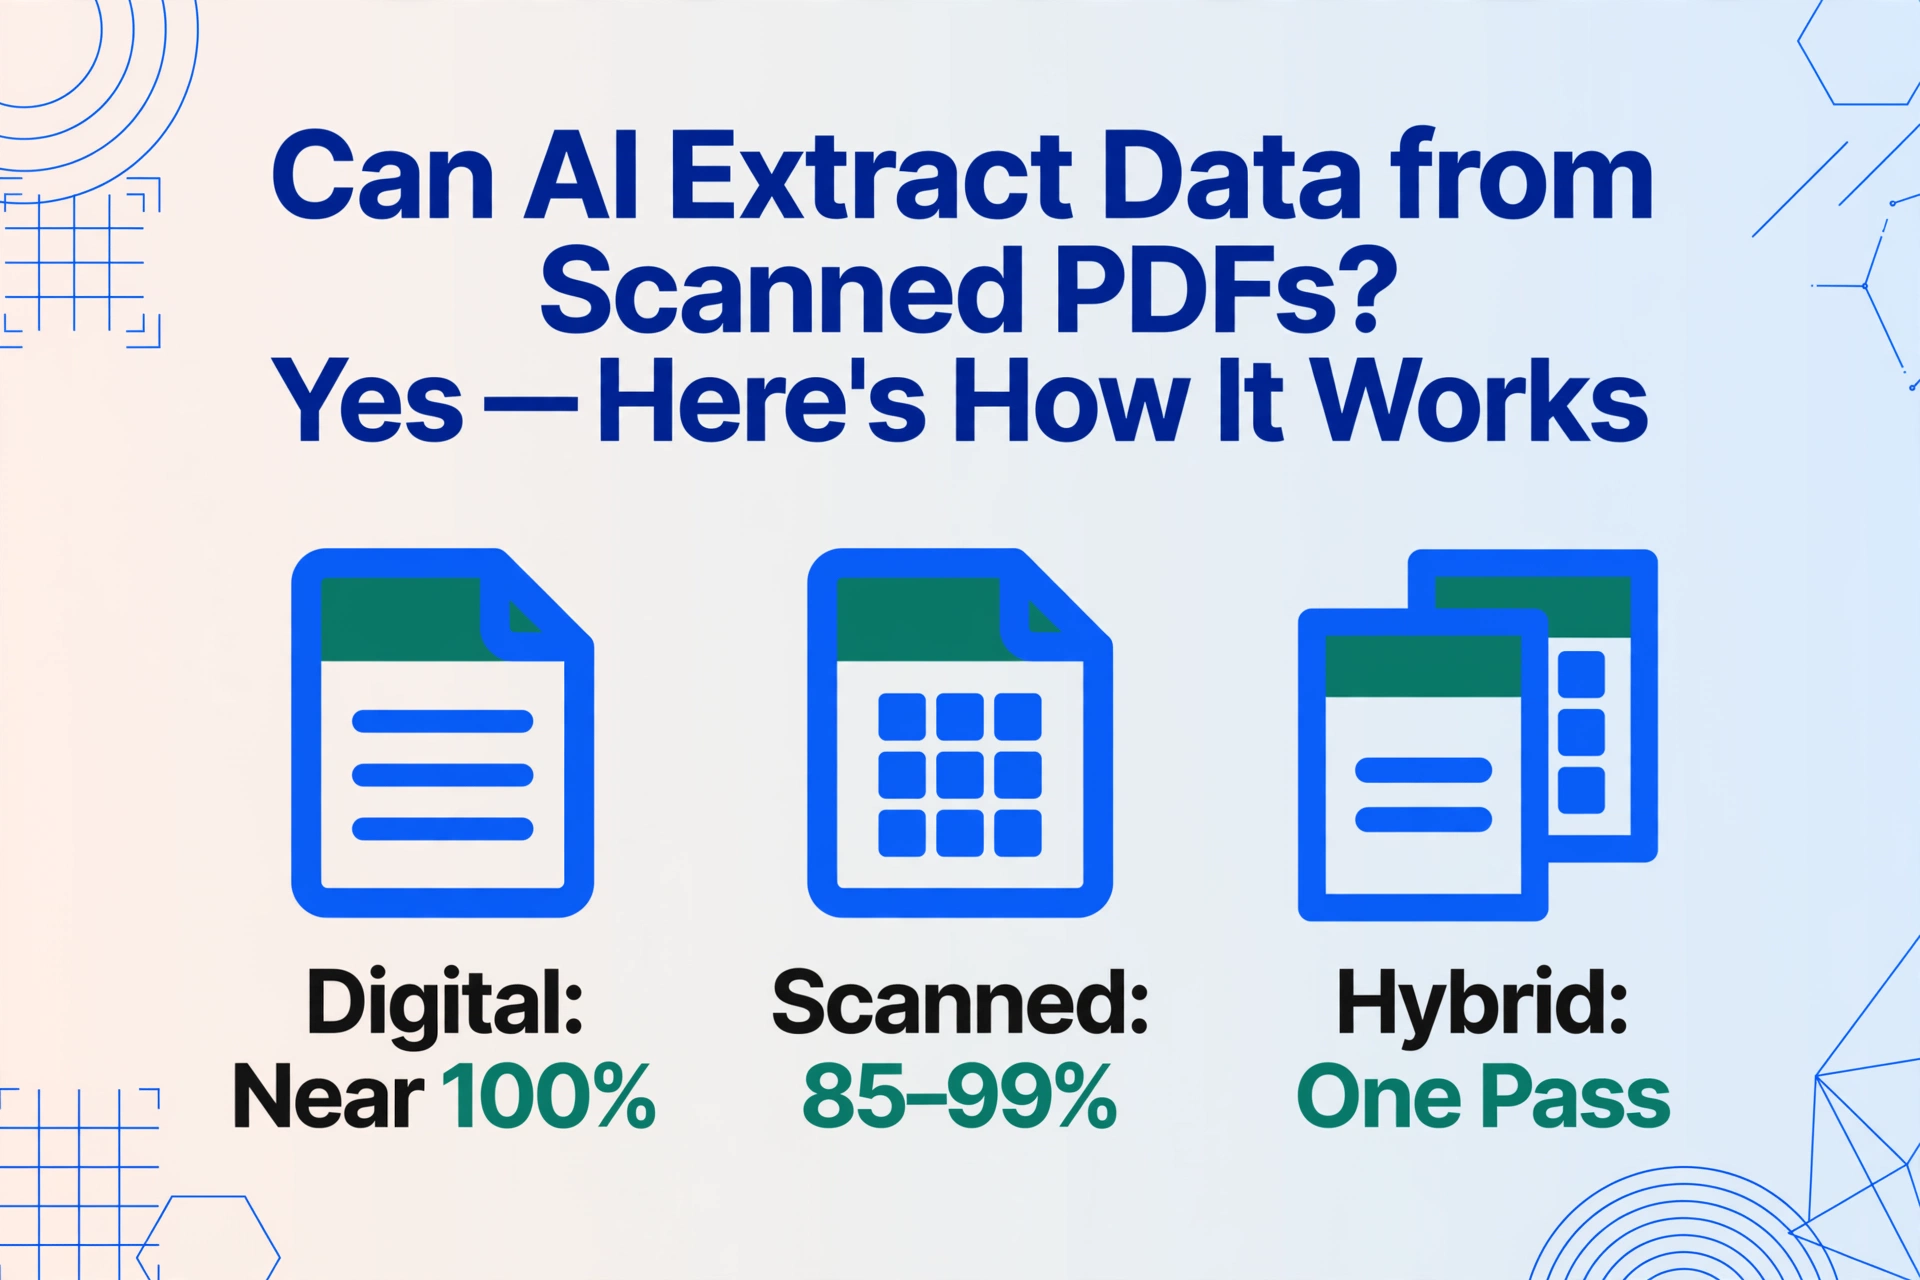
"A IA consegue extrair dados do meu PDF?" A resposta muda dependendo do tipo de PDF que você tem — e a maioria das pessoas não percebe que existe mais de um tipo. Aqui está a estrutura que determina se a extração funciona ou falha antes mesmo de qualquer ferramenta ser usada:
Criado por software — Word salvo como PDF, exportação do QuickBooks, relatório gerado pelo sistema. Contém uma camada de texto incorporada. Você pode selecionar, destacar e copiar texto com o mouse. Qualquer ferramenta básica de extração consegue ler. Precisão: quase 100% — os caracteres já são legíveis por máquina.
Uma fotografia de papel salva como PDF. Sem camada de texto — cada caractere é apenas pixels. Você não consegue selecionar ou copiar texto; clicar e arrastar desenha uma caixa de seleção sobre a imagem. Precisa de IA com compreensão visual ou OCR antes que qualquer dado possa ser extraído. Precisão: 85–99% dependendo da qualidade do escaneamento.
Uma mistura: a página 1 é texto nativo de uma exportação do sistema, as páginas 2–5 são escaneamentos de formulários em papel grampeados no mesmo arquivo. Comum em negócios do mundo real — contratos com páginas de assinatura escaneadas, pacotes de contas a pagar com fontes mistas. A maioria das ferramentas falha nas páginas escaneadas. A IA lida com ambas uniformemente.
O teste rápido: abra seu PDF e tente selecionar texto com o mouse. Se o texto for destacado e você conseguir copiá-lo, você tem um PDF digital — quase qualquer método funcionará. Se o cursor desenhar um retângulo de seleção vazio e nada for destacado, é escaneado — e você precisa de uma ferramenta que leia imagens, não apenas strings de texto. Se sua ferramenta der resultados quase perfeitos em um arquivo e resultados ruins em outro, mesmo que pareçam idênticos na tela, a diferença é quase sempre o tipo de PDF — veja por que os resultados de extração variam entre os 3 tipos de PDF.
Estima-se que uma parte significativa das faturas de fornecedores chega como PDFs escaneados, não digitais — impressos, assinados, carimbados e depois escaneados de volta para o computador. Esses são os documentos que quebram copiar-colar, o importador embutido do Excel e toda biblioteca tradicional de extração.
Por que PDFs escaneados quebram as ferramentas tradicionais
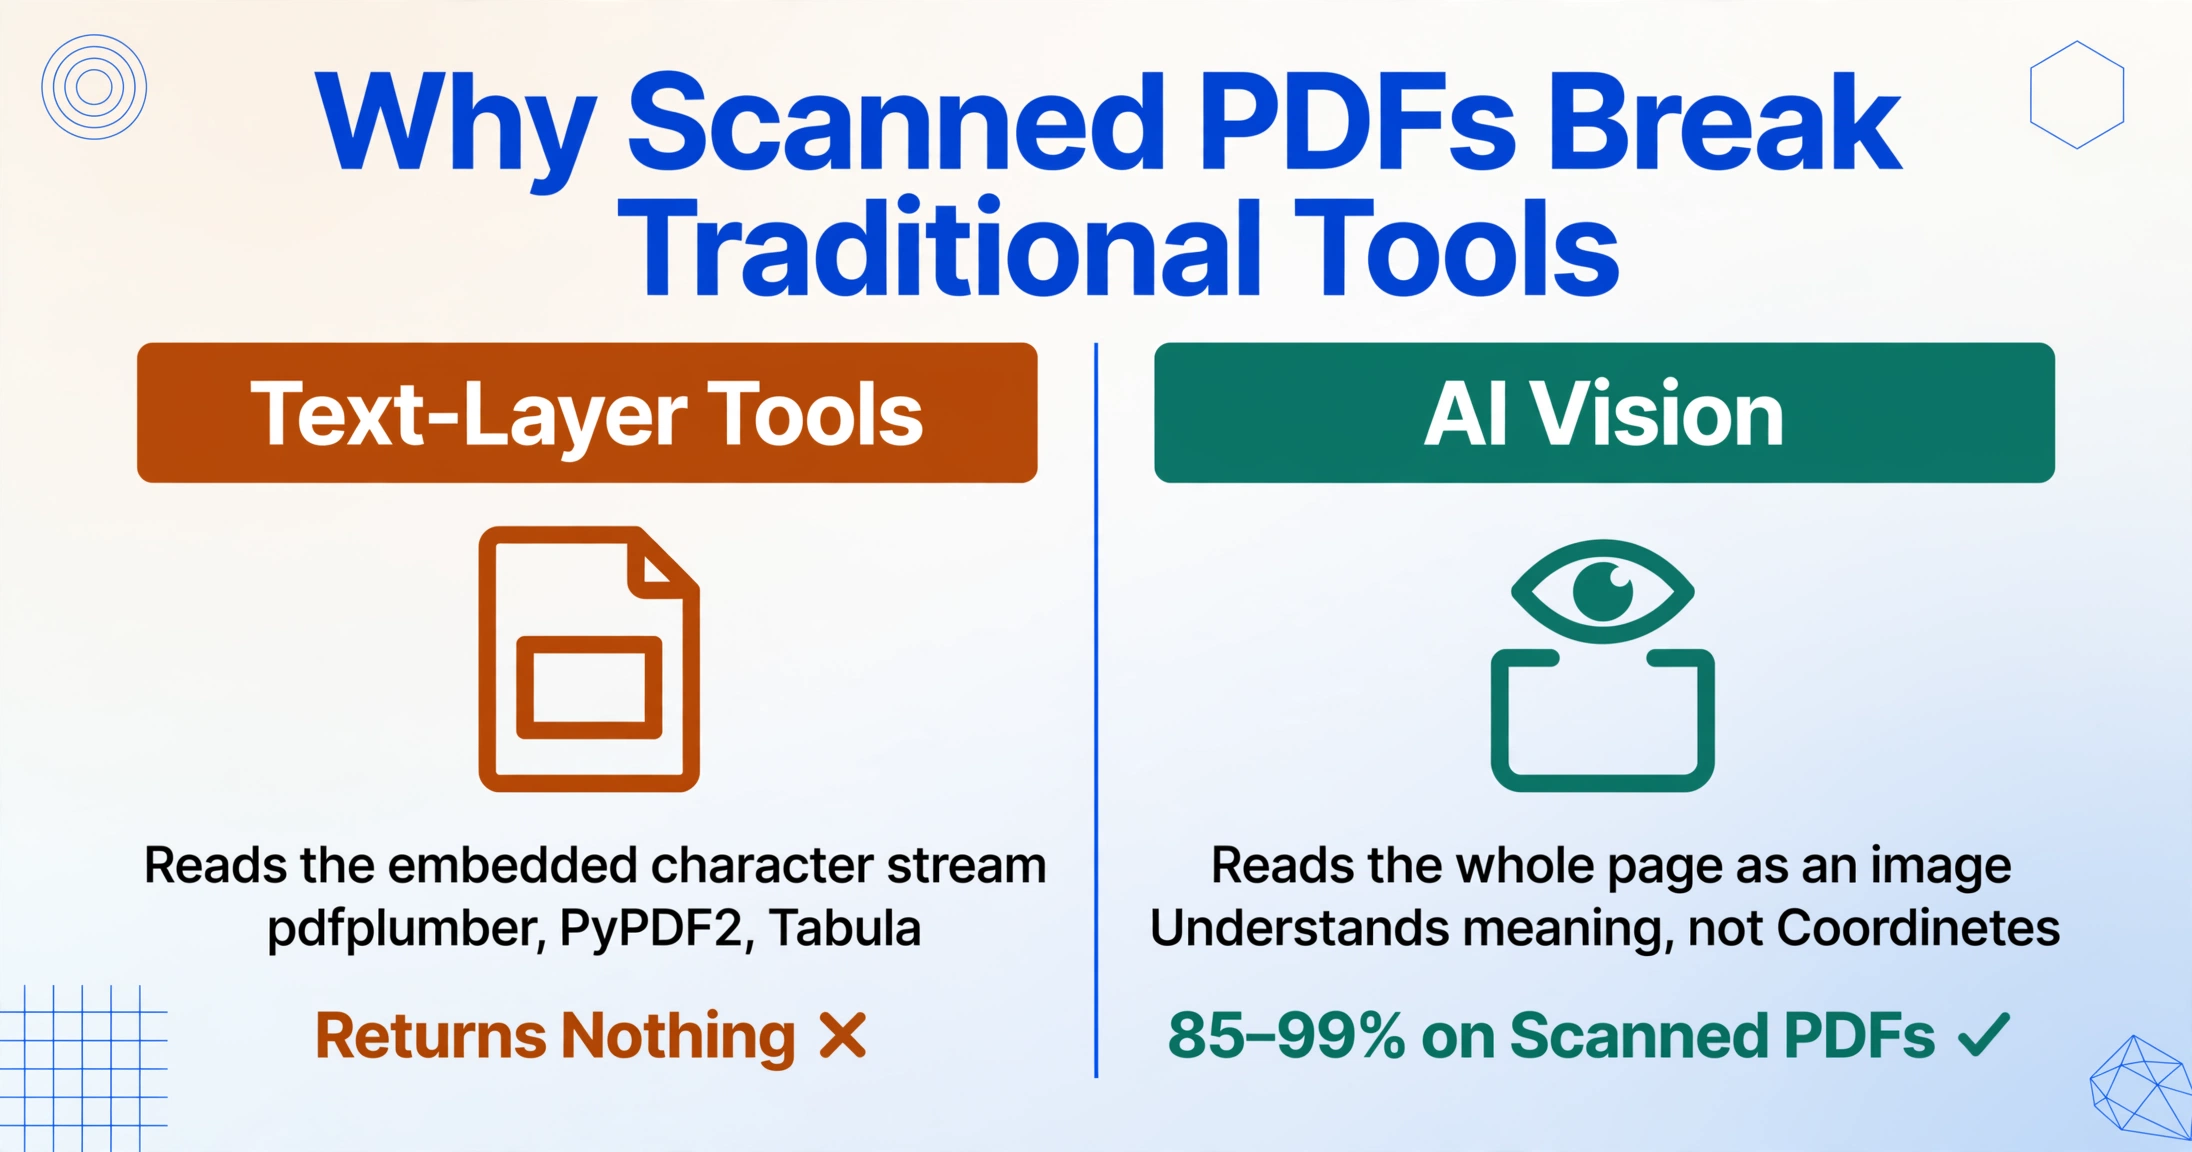
Toda ferramenta tradicional de extração de PDF — de bibliotecas Python ao importador integrado do Excel — funciona da mesma forma: ela lê a camada de texto embutida no arquivo. PDFs escaneados não têm camada de texto. A ferramenta abre o arquivo, não encontra nada para ler e retorna vazio. Isso não é um bug. É o documento não contendo o que a ferramenta precisa.
Considere o pdfplumber, uma das bibliotecas Python mais populares para extração de dados de PDF, com mais de 7.700 estrelas no GitHub. Ele funciona acessando o fluxo de texto interno do PDF — os dados invisíveis de caracteres, informações de fonte e posições de coordenadas que PDFs digitais carregam. Dê a ele um PDF nativo e limpo com uma tabela simples, e ele extrai linhas e colunas com precisão. Dê a ele um PDF escaneado — uma fotografia de um documento — e ele retorna nada. Não há caracteres no fluxo. A página inteira é uma única imagem plana.
A mesma limitação se aplica ao PyPDF2, Tabula, Camelot e ao importador Dados → Obter Dados → De PDF do Excel. Cada um deles procura texto em coordenadas específicas. Quando essas coordenadas contêm pixels em vez de caracteres, a ferramenta não tem com o que trabalhar. É por isso que um usuário do Reddit no r/automation que testou seis ferramentas de extração de PDF observou: "O teste real é sempre: ela consegue lidar com os casos extremos estranhos sem intervenção manual? É aí que a maioria das soluções quebra."
A solução alternativa historicamente tem sido executar uma etapa separada de OCR (reconhecimento óptico de caracteres) primeiro — converter a imagem escaneada em texto legível por máquina e então alimentar esse texto na ferramenta de extração. Mas esse pipeline de duas etapas introduz seus próprios problemas: erros de OCR se acumulam em erros de extração, pistas de formatação nas quais a ferramenta de extração dependia se perdem na conversão de OCR, e todo o fluxo de trabalho se torna frágil.
O problema central: Ferramentas tradicionais respondem "onde está o texto?" PDFs escaneados respondem a essa pergunta com silêncio. Você precisa de uma ferramenta que faça uma pergunta completamente diferente.
Como a IA lê PDFs escaneados de forma diferente
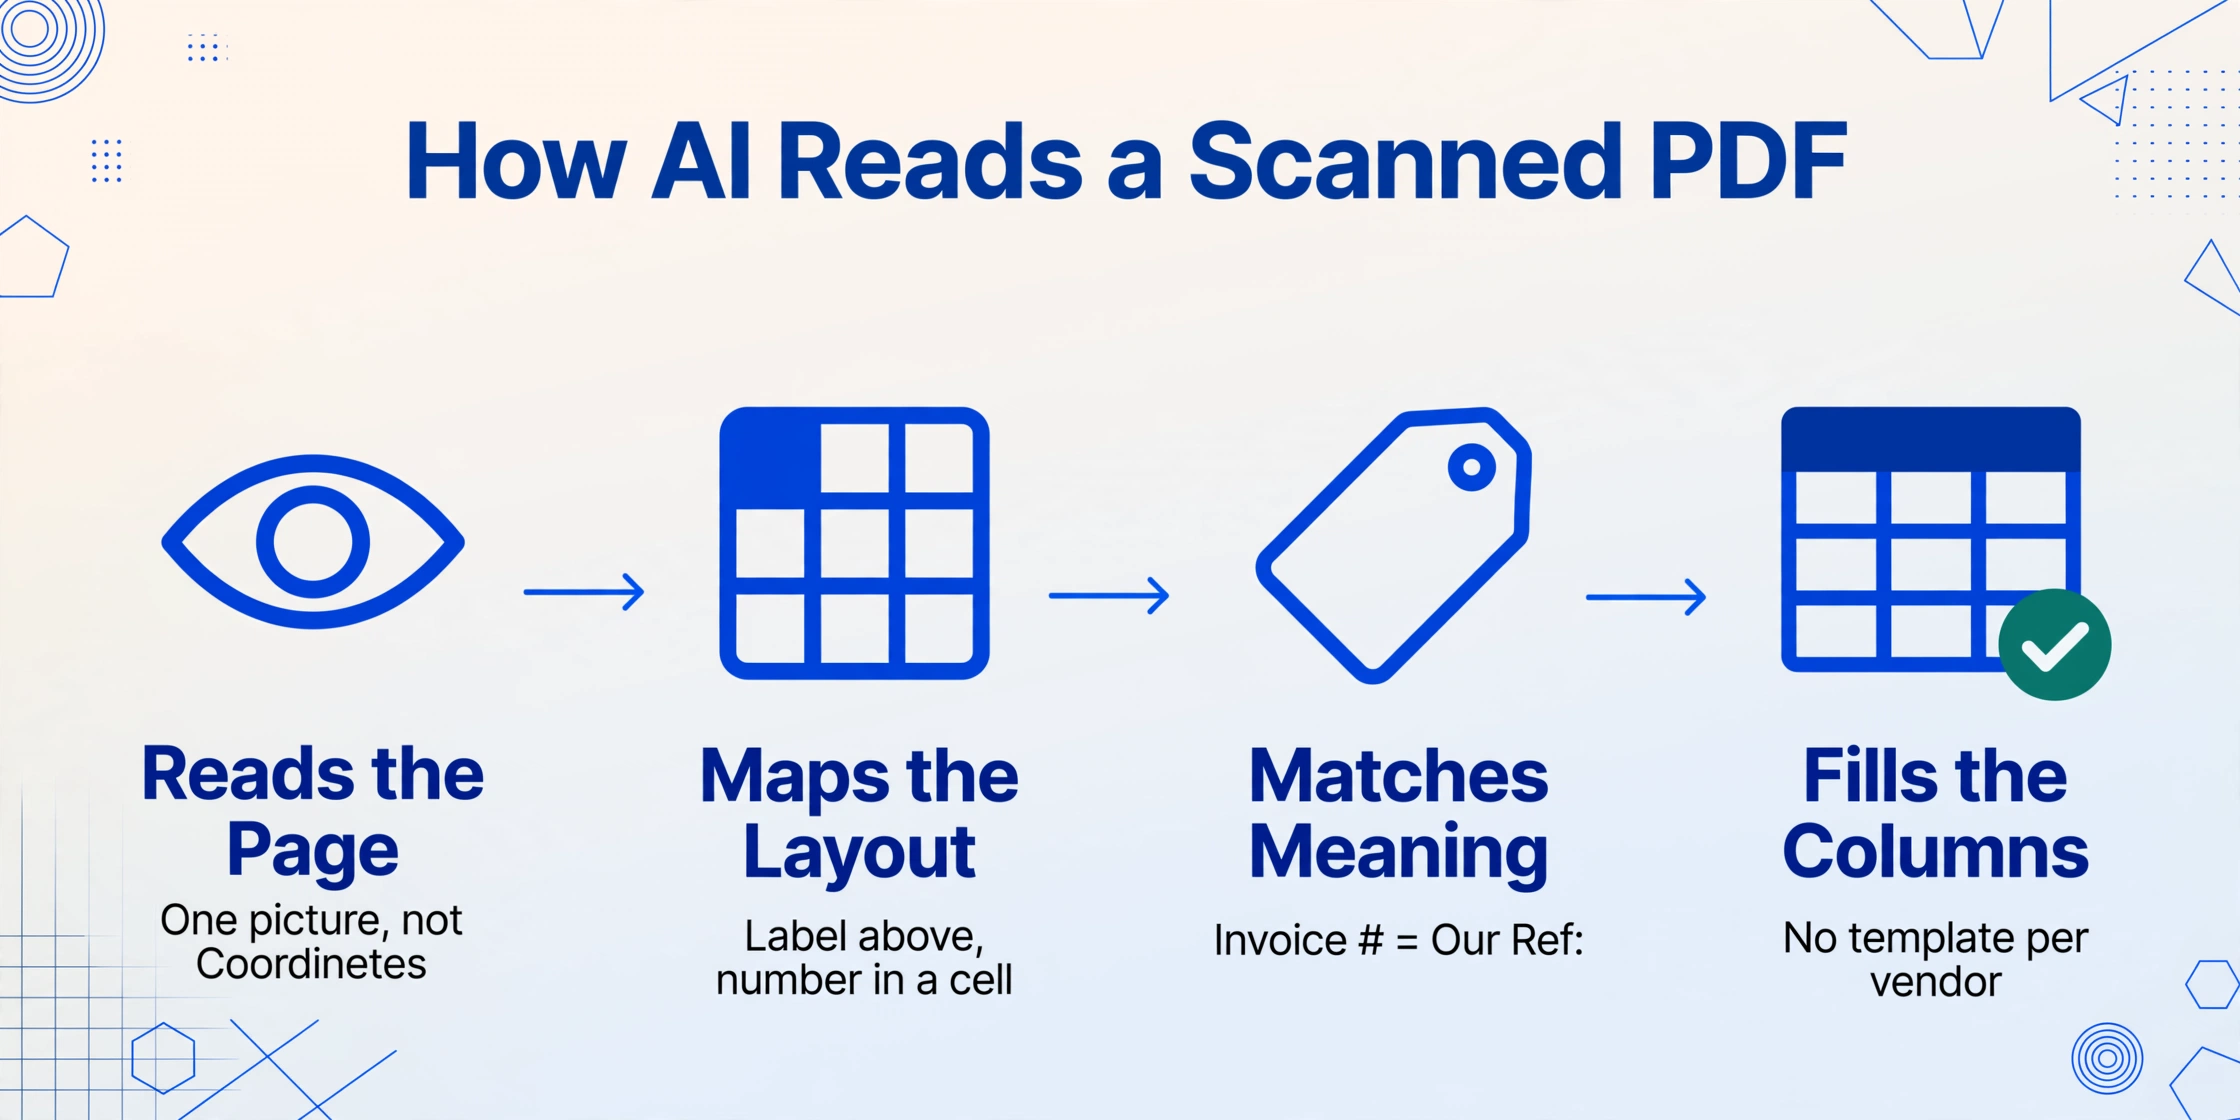
A extração por IA não procura por uma camada de texto. Ela lê o documento da mesma forma que seus olhos leem uma fotografia — compreendendo a cena visual como um todo, reconhecendo o que cada informação significa, não apenas em quais coordenadas ela está.
Pense em como você lê uma fatura escaneada na tela. Você não reconstrói mentalmente as coordenadas dos caracteres. Você dá uma olhada e seu cérebro mapeia a página inteira: logotipo no topo, itens no meio, total no canto inferior direito. Você encontra o número da fatura não porque sabe que ele está na posição (428, 156), mas porque reconhece o padrão — um rótulo como "Fatura nº" seguido por uma sequência alfanumérica curta.
A extração moderna de documentos por IA — baseada em grandes modelos de visão — funciona da mesma forma. Ela vê a página inteira como uma única imagem completa. Reconhece relações espaciais: um rótulo acima de um valor, um número dentro de uma célula de tabela, um logotipo na área do cabeçalho. E, principalmente, entende papéis semânticos: sabe que "Número da Fatura", "Fatura nº", "Fatura #" e "Nossa Ref:" são rótulos diferentes para a mesma coisa, então uma mudança de formato de um fornecedor para outro não a quebra.
Isso é fundamentalmente diferente do OCR tradicional. O OCR converte imagens de caracteres em strings de texto — ele informa que a página contém "F-A-T-U-R-A espaço cifrão dois pontos espaço quatro cinco dois um" sem qualquer compreensão de que isso é um identificador de fatura. Os modelos de visão de IA pulam a etapa de "converter para texto primeiro" por completo. Eles processam a cena visual diretamente, respondem "quais informações estão aqui" e geram dados estruturados — datas, valores, nomes — nas colunas que você definiu.
Na prática, isso significa que você usa uma ferramenta que oferece suporte a Custom Column Extraction: você digita os nomes dos campos desejados — "Número da Fatura", "Data", "Total", "Nome do Fornecedor" — e a IA localiza cada valor em qualquer lugar da página escaneada, compreendendo o que ele significa. Você define as colunas de saída. A IA navega pela entrada visual para encontrar os dados correspondentes. Quando o próximo documento é um PDF nativo em vez de um escaneado, ou uma foto de celular em vez de um PDF, a IA o processa pelo mesmo fluxo — porque nunca dependeu de uma camada de texto para começar.
Essa abordagem visual-first lida com o que o processo de extração de documentos por IA foi criado para fazer: documentos em que formato, layout e tipo de entrada variam de forma imprevisível. Para uma análise mais detalhada do processo em três etapas — VER a página, COMPREENDER seu conteúdo, BUSCAR os valores corretos — veja como a IA lê documentos.
Os arquivos são processados com segurança e não são armazenados.
O Que a IA Acerta em PDFs Escaneados
A extração com IA lida com vários cenários que derrotam as ferramentas tradicionais — não apenas PDFs escaneados em geral, mas casos específicos que aparecem em documentos do mundo real:
- Layouts inconsistentes no mesmo tipo de documento. Cinco fornecedores enviam faturas como PDFs escaneados — cada uma em um formato diferente. Ferramentas tradicionais precisam de modelos por fornecedor. A IA reconhece campos pelo significado, então um único conjunto de nomes de colunas ("Número da Fatura", "Data", "Total") funciona em todos os cinco layouts sem configuração.
- Tipos mistos de documentos em um único lote. Uma pasta de projeto pode conter PDFs nativos do QuickBooks, PDFs escaneados de contratos assinados e fotos de celular de notas de entrega manuscritas. A IA processa todos os três pelo mesmo pipeline — ela lê pixels, não formatos de arquivo. O que exigia três ferramentas separadas vira um único upload.
- Campos comerciais comuns entre tipos de documentos. Campos como datas, valores, nomes de fornecedores e números de referência aparecem em faturas, ordens de compra, recibos e extratos bancários. A IA treinada em documentos diversos transfere esse reconhecimento de padrões entre tipos de documento — ela encontra "Total a Pagar" esteja em uma fatura ou em um extrato.
- Extração de tabelas de escaneamentos. Os itens em uma fatura escaneada — quantidade, descrição, preço unitário, total do item — são particularmente difíceis para OCR tradicional porque o alinhamento das colunas é visual, não textual. Os modelos de visão da IA enxergam a estrutura tabular diretamente e preservam as relações linha-coluna que o OCR caractere por caractere perde.
- Processamento em lote em escala. Coloque 30 PDFs escaneados em um lote, defina suas colunas uma vez e receba uma única planilha unificada. Para uma única página de um escaneamento limpo, a IA processa em aproximadamente 5–10 segundos — comparado a uma média de 3 minutos de entrada manual de dados, isso é um ganho de eficiência de 18× por documento.
O padrão de precisão: Para escaneamentos limpos e bem iluminados de documentos impressos a 200+ DPI, a precisão da extração com IA é comparável à de um digitador humano cuidadoso — até 99% em campos-chave como datas, valores e números de referência. A queda começa quando a qualidade do escaneamento degrada, que é o que a próxima seção aborda.
Onde a IA Enfrenta Dificuldades com PDFs Escaneados
Ser honesto sobre as limitações importa mais do que um número de precisão perfeito. Aqui estão os cenários em que a extração por IA em PDFs escaneados precisa de revisão humana — e por quê.
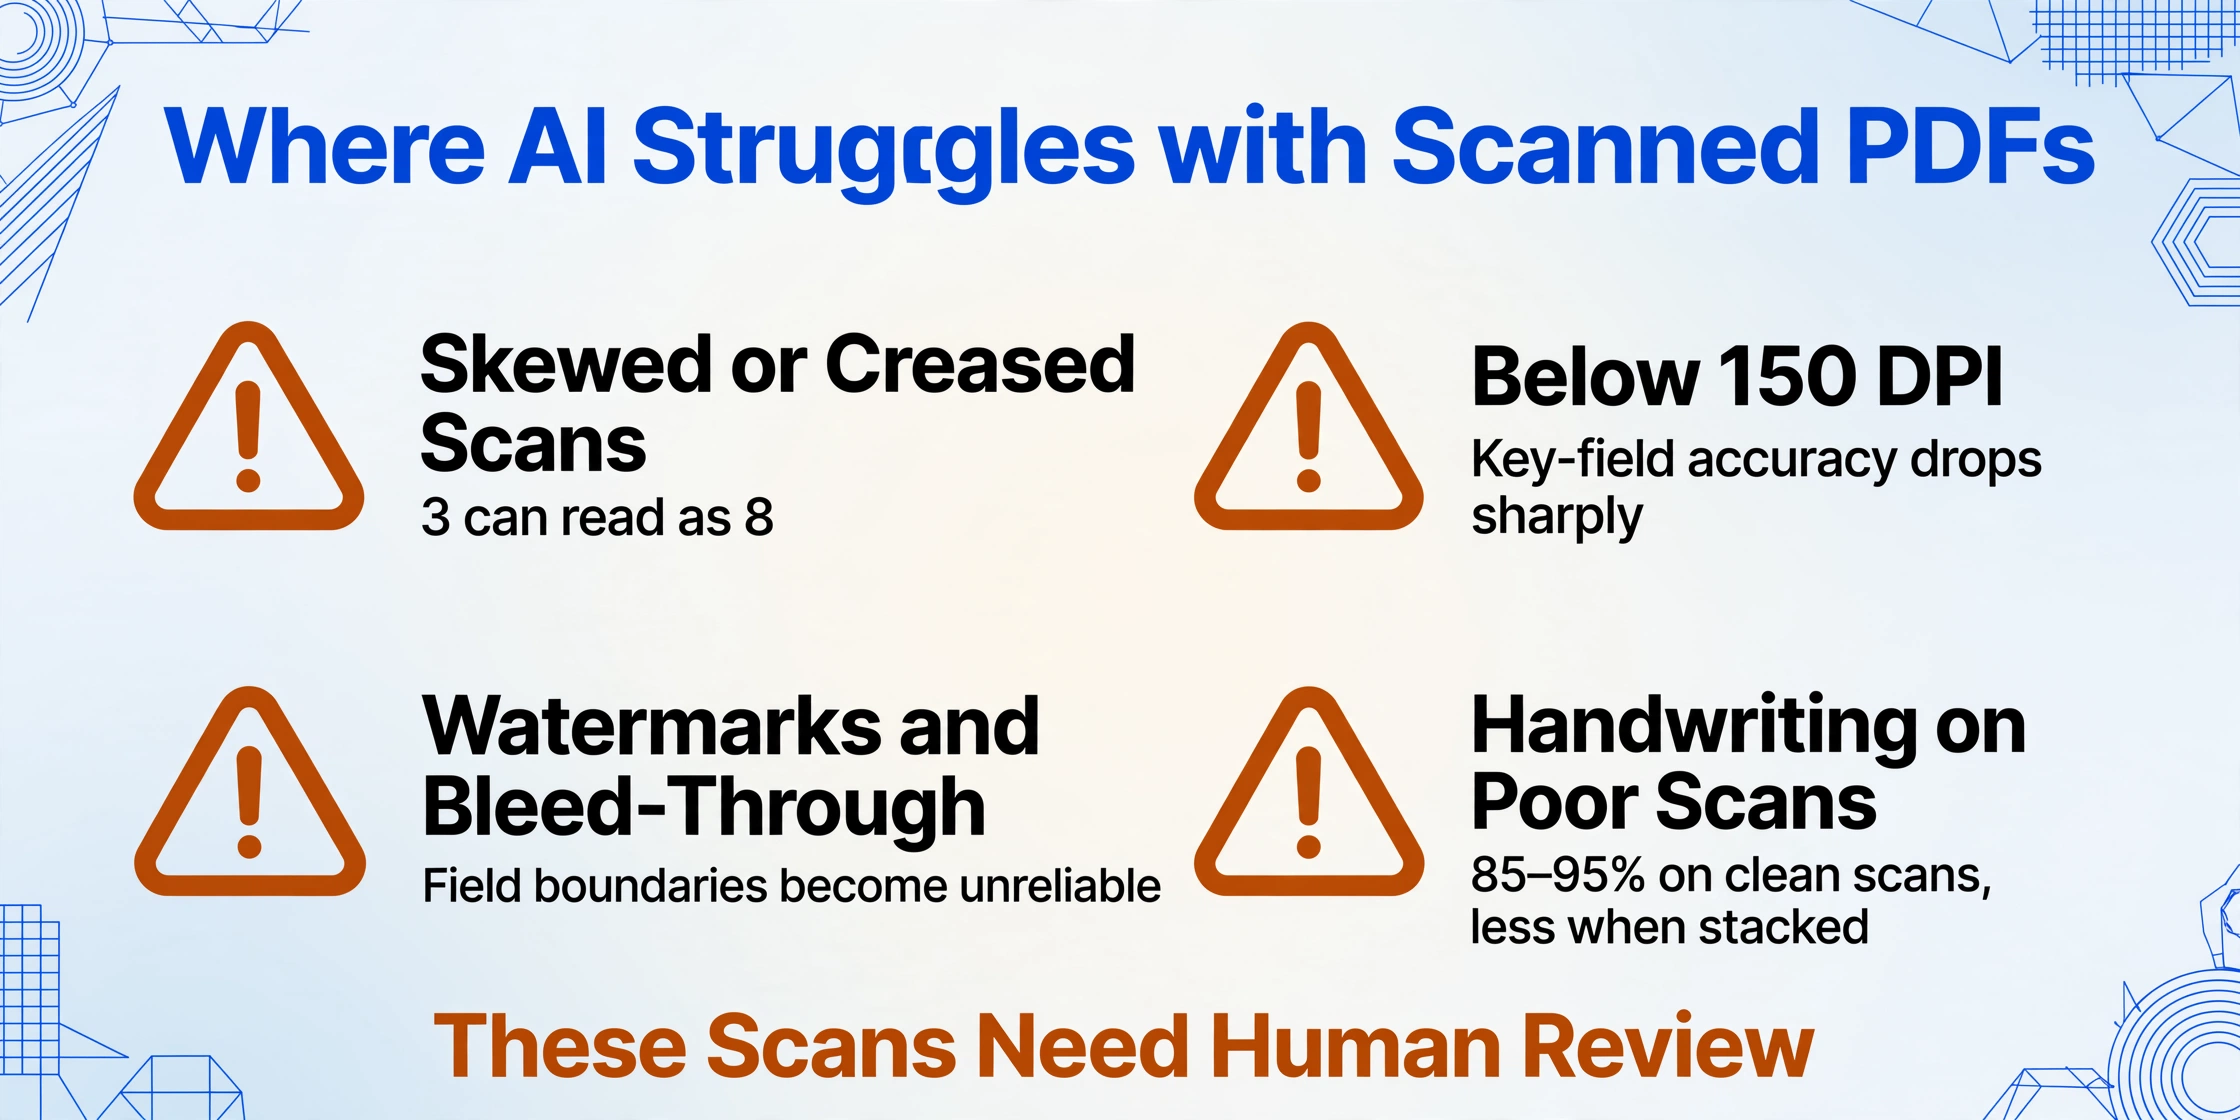
- Digitalizações muito inclinadas ou distorcidas. Se o papel foi alimentado no scanner em um ângulo acentuado, ou o documento tem vincos e dobras que distorcem o texto, a compreensão visual da IA degrada. Ela ainda consegue ler a maior parte do conteúdo, mas os erros de reconhecimento de caracteres individuais aumentam — um "3" pode ser lido como "8", um "$" como uma mancha.
- Resolução extremamente baixa (abaixo de 150 DPI). Digitalizações a 72–100 DPI — comuns em arquivos antigos ou documentos encaminhados por múltiplas compressões de e-mail — produzem texto pixelizado que até olhos humanos têm dificuldade de ler. A precisão da IA em campos-chave cai significativamente abaixo de 150 DPI. Uma digitalização a 200+ DPI é o mínimo prático para extração confiável.
- Fundos com marca d'água e muitos artefatos. Documentos escaneados com marcas d'água "CONFIDENCIAL" no fundo, ou documentos em que o scanner captou vazamento de tinta do verso da página, confundem a capacidade da IA de separar o texto em primeiro plano do ruído de fundo. O texto ainda pode ser reconhecido, mas os limites dos campos — onde um dado termina e o próximo começa — tornam-se não confiáveis.
- Escrita à mão em digitalizações de baixa qualidade. Uma anotação manuscrita em uma digitalização limpa é um desafio. Uma anotação manuscrita em uma digitalização escura, inclinada e de baixa resolução aumenta a dificuldade. O reconhecimento de escrita à mão por IA atinge 85–95% de precisão em imagens de qualidade razoável; adicione más condições de digitalização, e isso cai para 70% ou menos.
- Células de tabela mescladas em documentos escaneados. Se uma tabela escaneada tem células que se sobrepõem visualmente — comum em formulários mal projetados com bordas ambíguas — a IA pode combinar valores de colunas adjacentes, produzindo um único campo confuso em vez de dois dados separados.
A conclusão prática: a extração por IA em PDFs escaneados não é um processo de configurar e esquecer. É uma ferramenta que leva você 95% do caminho em boas digitalizações, e os 5% restantes são uma revisão rápida — verificar a planilha de saída para campos destacados de baixa confiança — em vez de digitar manualmente cada linha do zero. Em um lote de 50 documentos, revisar 3–5 campos sinalizados ainda é uma melhoria dramática em comparação a digitar 500.
Como obter os melhores resultados de PDFs escaneados
A maioria dos problemas de precisão na extração de PDFs escaneados está na digitalização em si, não na IA. Algumas práticas simples antes de escanear — ou ao receber documentos digitalizados — fazem a diferença entre uma extração de alta confiança e uma planilha cheia de pontos de interrogação:
Digitalize com 200–300 DPI. Esta é a faixa ideal. Abaixo de 150 DPI, as bordas dos caracteres ficam borradas e a precisão do reconhecimento visual da IA cai drasticamente. Acima de 300 DPI, aumenta o tamanho do arquivo sem ganhos significativos de precisão para extração de dados — a IA não se beneficia de ver pontos de tinta individuais. Se você receber PDFs escaneados de terceiros em baixa resolução, peça uma redigitalização em vez de aceitar uma entrada degradada.
Mantenha o documento plano e alinhado. Um documento digitalizado torto ou com uma dobra sobre campos críticos, como o total ou número da fatura, é um ponto de falha conhecido. Use um scanner de mesa em vez de um scanner de alimentação para documentos que foram dobrados, grampeados ou manuseados intensamente. Para digitalizações de documentos em papel com câmera de celular, segure o telefone diretamente acima do documento com iluminação uniforme — sem flash, sem ângulo.
Remova ruídos de fundo. Se o verso de um documento frente e verso transparecer, coloque uma folha de papel preta atrás dele ao digitalizar. Para documentos com marca d'água intensa, a digitalização colorida (em vez de escala de cinza ou preto e branco) dá à IA mais informações visuais para distinguir a marca d'água do texto. Uma verificação visual rápida — você consegue ler claramente cada campo na tela com zoom de 100%? — é um bom indicador se a IA consegue.
Defina suas colunas antes de enviar. Quanto mais específicos os nomes das colunas, mais precisa será a extração. "Valor" é ambíguo — a IA pode retornar o subtotal, imposto ou total. "Total da Fatura (após impostos)" diz exatamente à IA qual valor encontrar. O mesmo princípio se aplica a datas: "Data da Fatura" vs "Data de Vencimento" — se esses são campos diferentes no seu documento, nomeie-os de forma diferente.
Revise antes de exportar, não depois. As melhores ferramentas de extração sinalizam campos de baixa confiança — valores onde a IA não tem certeza se obteve os dados corretos. Gaste 30 segundos revisando esses campos sinalizados em vez de verificar aleatoriamente toda a saída. Em um lote de 30 faturas escaneadas, isso geralmente significa revisar de 5 a 8 campos no total, não 30 linhas de 10 colunas cada.
Exemplos Reais: PDFs Escaneados que a IA Processa Diariamente
Faturas em PDF Escaneadas
O PDF escaneado mais comum nos negócios: uma fatura impressa em papel de um fornecedor, assinada e carimbada, passada por um scanner. O documento contém número da fatura, data, vencimento, dados do fornecedor, itens com quantidades e preços unitários, subtotal, impostos e total — distribuídos entre cabeçalho, tabela e rodapé. Abordagens tradicionais exigem um modelo por fornecedor, pois cada um organiza esses campos de forma diferente. A extração por IA lê o documento semanticamente: entende que o valor ao lado de "Fatura nº" (ou "Nº da Nota" ou "Ref.:") é o identificador da fatura, independentemente de onde está na página, e que o número no canto inferior direito com um símbolo de moeda é provavelmente o total. Os itens dentro de uma tabela escaneada — tradicionalmente a parte mais difícil — são extraídos com as relações entre colunas preservadas: quantidade, descrição, preço unitário e total do item permanecem nas colunas corretas.
Contratos em PDF Escaneados
Contratos assinados quase sempre são escaneados — o original existe em papel com assinaturas a tinta. Um contrato escaneado típico contém nomes das partes, datas de início e término, valor do contrato, lei aplicável e referências a cláusulas principais — distribuídos por 5 a 40 páginas de texto denso. O que diferencia contratos de faturas é a falta de rótulos de campo consistentes. Um contrato diz "Data de Início", outro diz "Data de Vigência", um terceiro diz "Este Contrato entra em vigor em". A extração por IA lida com essa variação reconhecendo padrões temporais próximos à linguagem de abertura do contrato, em vez de procurar um rótulo específico. Ela também resolve o problema do PDF híbrido comum em contratos: as páginas 1 a 3 são texto nativo do documento Word, as páginas 4 a 5 são páginas de assinatura escaneadas — e ambos os tipos convivem no mesmo arquivo sem que o usuário precise separá-los primeiro.
Extratos Bancários em PDF Escaneado
Embora a maioria dos bancos modernos gere extratos em PDF digital, extratos arquivados — especialmente de contas encerradas, períodos antigos ou bancos menores — chegam como digitalizações. Um extrato bancário escaneado reúne datas de transações, descrições, valores de débito, valores de crédito e saldos em tabelas densas que podem abranger dezenas de páginas. O desafio da extração de tabelas é crítico aqui: a conversão tradicional de PDF para texto frequentemente colapsa a descrição da transação e as colunas de valores em um único bloco de texto mesclado, tornando a conciliação impossível. Os modelos de visão de IA preservam a estrutura das colunas lendo a tabela visualmente — reconhecendo que cada linha é uma transação separada e cada coluna é um campo separado — produzindo uma planilha onde Data, Descrição, Débito, Crédito e Saldo ficam cada um em sua própria coluna, prontos para importação em software de contabilidade.
FAQ
Como sei se meu PDF é escaneado ou digital?
O teste mais rápido: abra o PDF e tente selecionar texto com o mouse. Se o texto for destacado e você puder copiá-lo, é um PDF digital. Se o cursor desenhar um retângulo vazio e nada for destacado, é escaneado. Esse único teste indica se ferramentas básicas como o importador de PDF do Excel funcionarão ou se você precisará de extração com IA. Depois de confirmar que está lidando com uma digitalização, veja nosso guia passo a passo para fazer OCR de PDF escaneado para Excel para o processo completo.
Qual precisão posso esperar da IA em PDFs escaneados?
Para digitalizações limpas e bem iluminadas de documentos impressos com 200+ DPI, a extração por IA equivale à entrada manual cuidadosa de dados — até 99% em campos estruturados como datas, valores e números de referência. Para escrita à mão em digitalizações, espere 85–95% dependendo da legibilidade. A precisão cai em digitalizações muito inclinadas, de baixa resolução (abaixo de 150 DPI) ou com marcas d'água — nesses casos, é necessária revisão humana dos campos sinalizados com baixa confiança, em vez de aceitar cegamente o resultado.
Posso extrair dados de PDFs escaneados com ferramentas gratuitas como pdfplumber ou PyPDF2?
Não. pdfplumber, PyPDF2, Tabula e bibliotecas Python similares leem a camada de texto incorporada em PDFs digitais — dados de caracteres estruturados com coordenadas. PDFs escaneados não têm camada de texto; são imagens. Essas ferramentas não retornam nada porque não há caracteres para extrair. Você precisaria adicionar uma etapa separada de OCR (como Tesseract) antes de usar essas bibliotecas, o que introduz sua própria taxa de erro e complexidade.
A extração por IA funciona em documentos escaneados com anotações manuscritas?
Sim, dentro de limites. Modelos de visão por IA conseguem ler manuscritos em documentos escaneados — incluindo cursiva — com 85–95% de precisão em imagens de qualidade razoável. A precisão depende da legibilidade da caligrafia, da qualidade do escaneamento e se o texto manuscrito se sobrepõe ao texto impresso. Para mais sobre capacidades de reconhecimento de escrita manual, veja o que o reconhecimento de escrita manual por IA pode e não pode fazer.
A IA pode lidar com uma mistura de PDFs escaneados e digitais em um único lote?
Sim — este é um dos casos de uso mais fortes da extração por IA. Como a IA lê pixels em vez de depender de uma camada de texto, ela processa PDFs escaneados e digitais pelo mesmo pipeline visual. Envie uma pasta contendo ambos os tipos, defina os nomes das colunas uma vez, e a planilha de saída terá uma linha por documento, independentemente de a origem ser digital ou escaneada. Para um passo a passo, veja como converter PDFs em dados estruturados.
Meus documentos escaneados estão seguros ao usar extração por IA?
Isso depende da ferramenta específica. Ferramentas de extração confiáveis criptografam dados em trânsito, processam arquivos sem armazená-los permanentemente e cumprem regulamentações de proteção de dados relevantes. Sempre revise a política de privacidade e as práticas de tratamento de dados de uma ferramenta antes de enviar documentos escaneados sensíveis, como extratos financeiros, contratos ou formulários fiscais. Procure declarações explícitas sobre retenção de arquivos — se os arquivos são excluídos após o processamento e por quanto tempo os resultados permanecem acessíveis.
E quanto a PDFs escaneados com várias páginas?
A extração por IA lida com PDFs escaneados de várias páginas sem problemas. O modelo de visão lê cada página como uma cena visual separada, extrai os dados e os consolida em uma linha por documento. Para documentos em que o mesmo campo aparece em várias páginas — como um contrato com a data de vigência na página 1 e a data de assinatura na página 5 — a IA os distingue com base no contexto ao redor. O processamento em lote de vários documentos com várias páginas produz uma planilha mesclada em que cada linha representa um arquivo completo, não uma página.
Se o seu PDF permite selecionar texto, quase qualquer ferramenta funciona — copiar e colar, importação no Excel ou uma biblioteca de PDF. Se não permite — se o cursor desenha uma caixa vazia sobre uma imagem de documento — você precisa de uma ferramenta que leia pixels, não strings de texto. Envie um PDF escaneado e veja a diferença: os mesmos nomes de coluna que você digitaria em uma planilha extraem dados de uma imagem que ferramentas tradicionais nem conseguem abrir.
Experimente ImageToTable.ai Grátis