Cómo procesar documentos por lotes
sin escribir código
No necesita escribir scripts de Python para procesar documentos por lotes. La suposición de que automatizar la extracción de documentos requiere programación — escribir bucles for a través de un directorio de PDFs, lidiar con PyPDF2 o pdfplumber, configurar Tesseract OCR y luego unir la salida en un DataFrame de pandas — es una idea aprendida, arraigada en la era en que las herramientas de procesamiento de documentos solo exponían APIs y SDKs. Esa era está terminando. Las plataformas de arrastrar y soltar con extracción por IA ahora manejan el flujo de trabajo principal por lotes: suba varios archivos, nombre sus columnas de salida y obtenga una hoja de cálculo combinada — sin necesidad de una declaración import.
Conclusiones clave
- 78 horas al año — eso es lo que una persona dedica a copiar y pegar 30 facturas semanales en una hoja de cálculo, asumiendo que el procesamiento por lotes requiere Python que no conoce.
- Un solo proveedor que cambie silenciosamente el diseño de sus facturas rompe su script de extracción casero — y el mantenimiento, no la habilidad de programación, es donde muere la mayor parte de la automatización hecha por uno mismo.
- Cambie la pregunta, no el lenguaje: deje de decirle al código cómo encontrar campos en una página y comience a nombrar las columnas que desea — la combinación por lotes y el procesamiento concurrente se encargan de sí mismos.
Por qué el procesamiento por lotes no requiere código
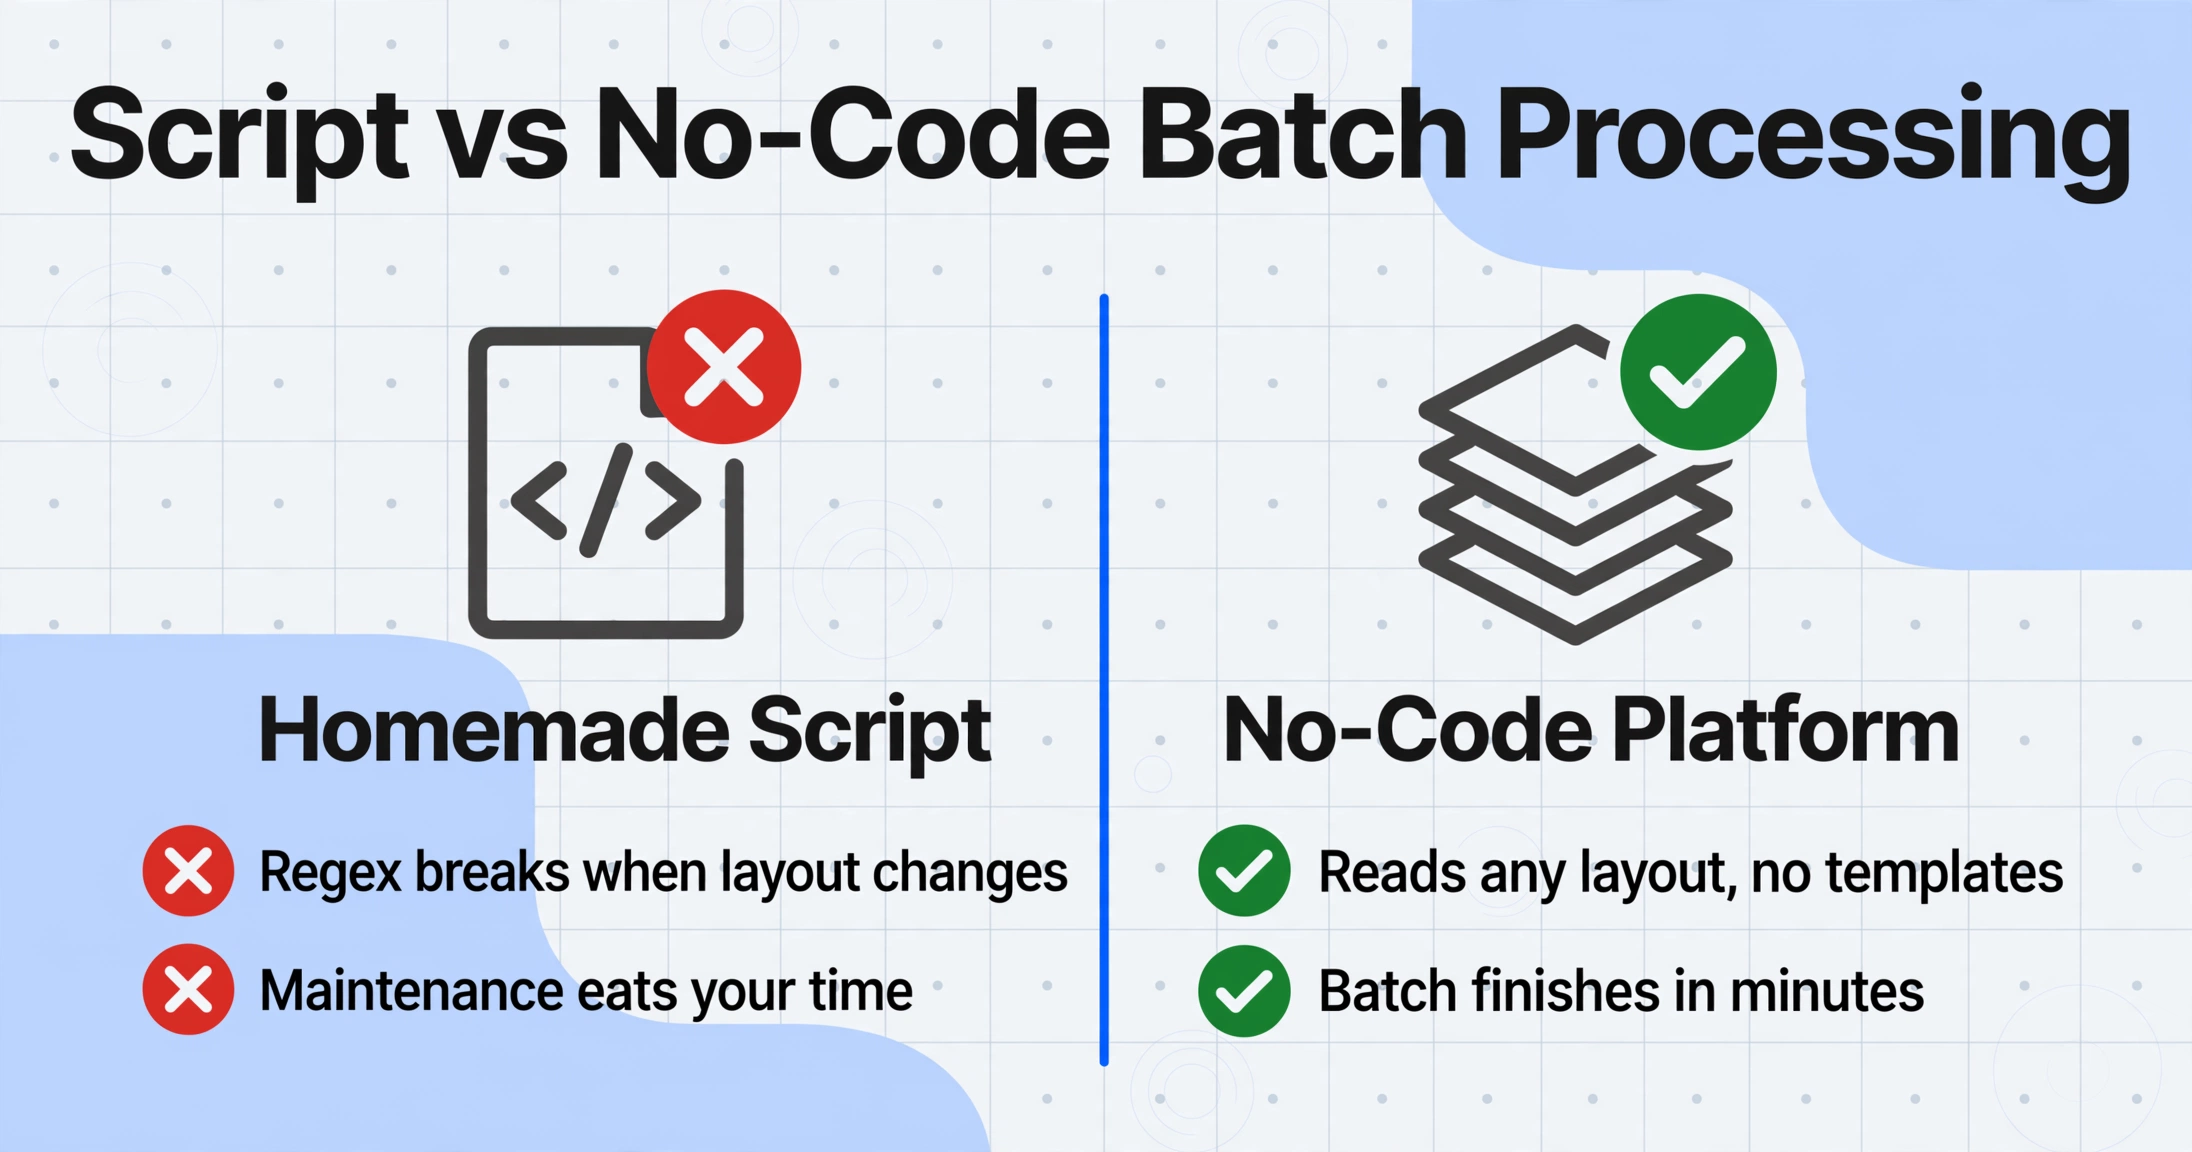
La asociación entre el procesamiento por lotes y la programación no es accidental. Durante años, la única forma de procesar múltiples documentos en una sola pasada era escribir un script. Ese script abría cada archivo, extraía texto usando una biblioteca de OCR como Tesseract o un analizador de PDF como PyPDF2 o pdfplumber, analizaba el texto sin formato en campos usando regex o lógica posicional, y escribía los resultados en un archivo CSV o Excel usando pandas o openpyxl.
Ese flujo de trabajo funciona, pero exige un conjunto de habilidades que la mayoría de los equipos pequeños no tienen. Según el Perfil de Pequeñas Empresas 2025 de la Oficina de Defensa de la SBA, el 99.9% de las empresas estadounidenses son pequeñas empresas, y el 82% de ellas operan sin empleados, y mucho menos con un desarrollador dedicado. Incluso entre las empresas con empleados, el 61.6% tiene menos de 5 empleados (Census Bureau, 2019). El BLS cuenta aproximadamente 1.7 millones de desarrolladores de software en los EE. UU., concentrados abrumadoramente en empresas de tecnología y grandes corporaciones, no en los 36 millones de pequeñas empresas que constituyen el 99.9% de las empresas del país.
"Escribí un script que convirtió todos los PDF en imágenes, usé pytesseract para leerlos, usé regex para buscar la cadena de datos que necesitaba y escribí los datos en un CSV", describió un usuario en r/learnpython, explicando su enfoque para extraer datos de dos PDF. La configuración funciona. Luego, un proveedor cambia el diseño de su factura y el regex se rompe. La salida de Tesseract en un nuevo escaneo es ilegible. El script necesita mantenimiento, y el mantenimiento es donde muere la mayoría de la automatización casera.
El procesamiento por lotes sin código rompe este ciclo no reemplazando el script con un script más simple, sino cambiando el paradigma por completo: en lugar de decirle a una computadora cómo encontrar datos en una página (coordenadas, patrones regex, nombres de etiquetas), usted le dice qué datos desea, y la IA los localiza comprendiendo el contenido del documento. La lógica de lotes — "procesar todos los archivos en este grupo y fusionar la salida" — está integrada en la plataforma, no escrita por el usuario. El resultado es funcionalmente equivalente a un pipeline de Python semiautomatizado para el 80% de los escenarios comunes de procesamiento de documentos, sin escribir ni una línea de código.
Lo que realmente necesitas
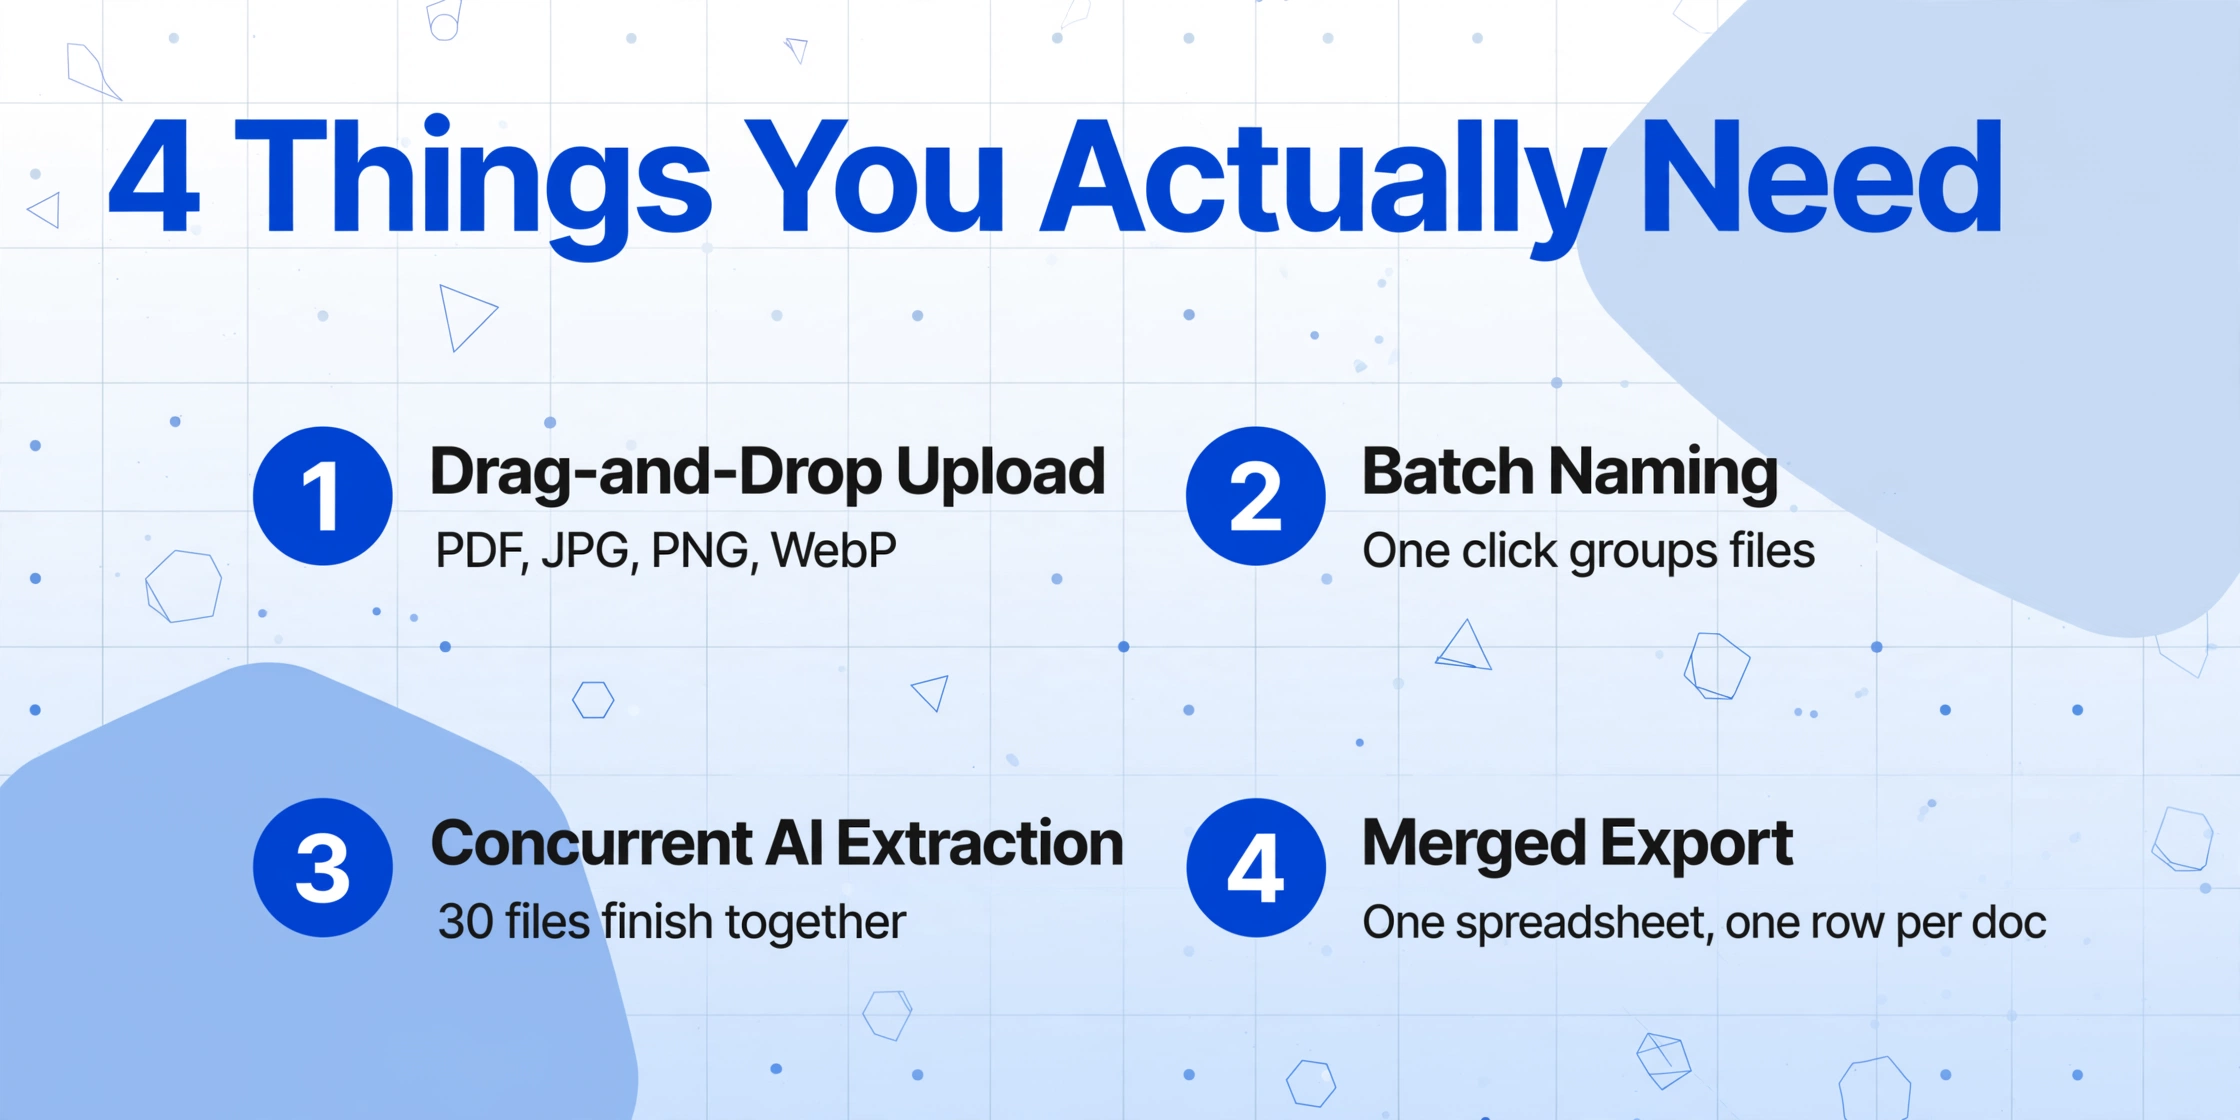
La configuración mínima viable para el procesamiento por lotes de documentos sin código es más corta de lo que la mayoría espera. Necesitas cuatro cosas:
- Una interfaz de carga por arrastrar y soltar que acepte los formatos de archivo con los que trabajas: PDF, JPG, PNG, WebP. La mayoría de las herramientas de extracción sin código ofrecen una superficie de carga basada en navegador o integrada en Google Sheets. No se requiere instalación de software local.
- Un mecanismo de nombre de lote que agrupe archivos relacionados. En una plataforma sin código, esto normalmente significa un solo clic para asignar un nombre de lote, el equivalente a nombrar una carpeta, en lugar de escribir un script que recorra directorios.
- Extracción concurrente con IA que procese todos los archivos del lote simultáneamente. Este es el motor oculto: mientras que un humano solo puede abrir y leer un documento a la vez, una plataforma consciente de lotes distribuye el procesamiento entre todos los archivos del grupo, de modo que 30 facturas terminan aproximadamente al mismo tiempo que una.
- Una exportación combinada que consolide los datos extraídos de cada documento en un solo archivo: una hoja de cálculo de Excel, un CSV, una pestaña de Google Sheets, donde cada fila representa un documento y cada columna representa un campo que definiste.
Eso es todo. Sin bucles for en Python. Sin endpoints de API que configurar. Sin muestras de entrenamiento que etiquetar. Los nombres de columna que escribes se convierten en los encabezados de tu hoja de cálculo de salida. La IA se encarga del resto.
Este es el cambio de paradigma central que subyace a la extracción moderna de documentos sin código, distinto de las herramientas basadas en plantillas o las plataformas de aprendizaje automático que aún requieren configuración inicial. Las plataformas construidas sobre Extracción de Columnas Personalizadas — donde escribes nombres de campos como "Número de factura, Proveedor, Total, Fecha de vencimiento" y la IA localiza cada valor mediante comprensión semántica — eliminan el impuesto de configuración que silenciosamente consume el tiempo que el no-code se supone que debe ahorrar.
El flujo de trabajo de procesamiento por lotes sin código
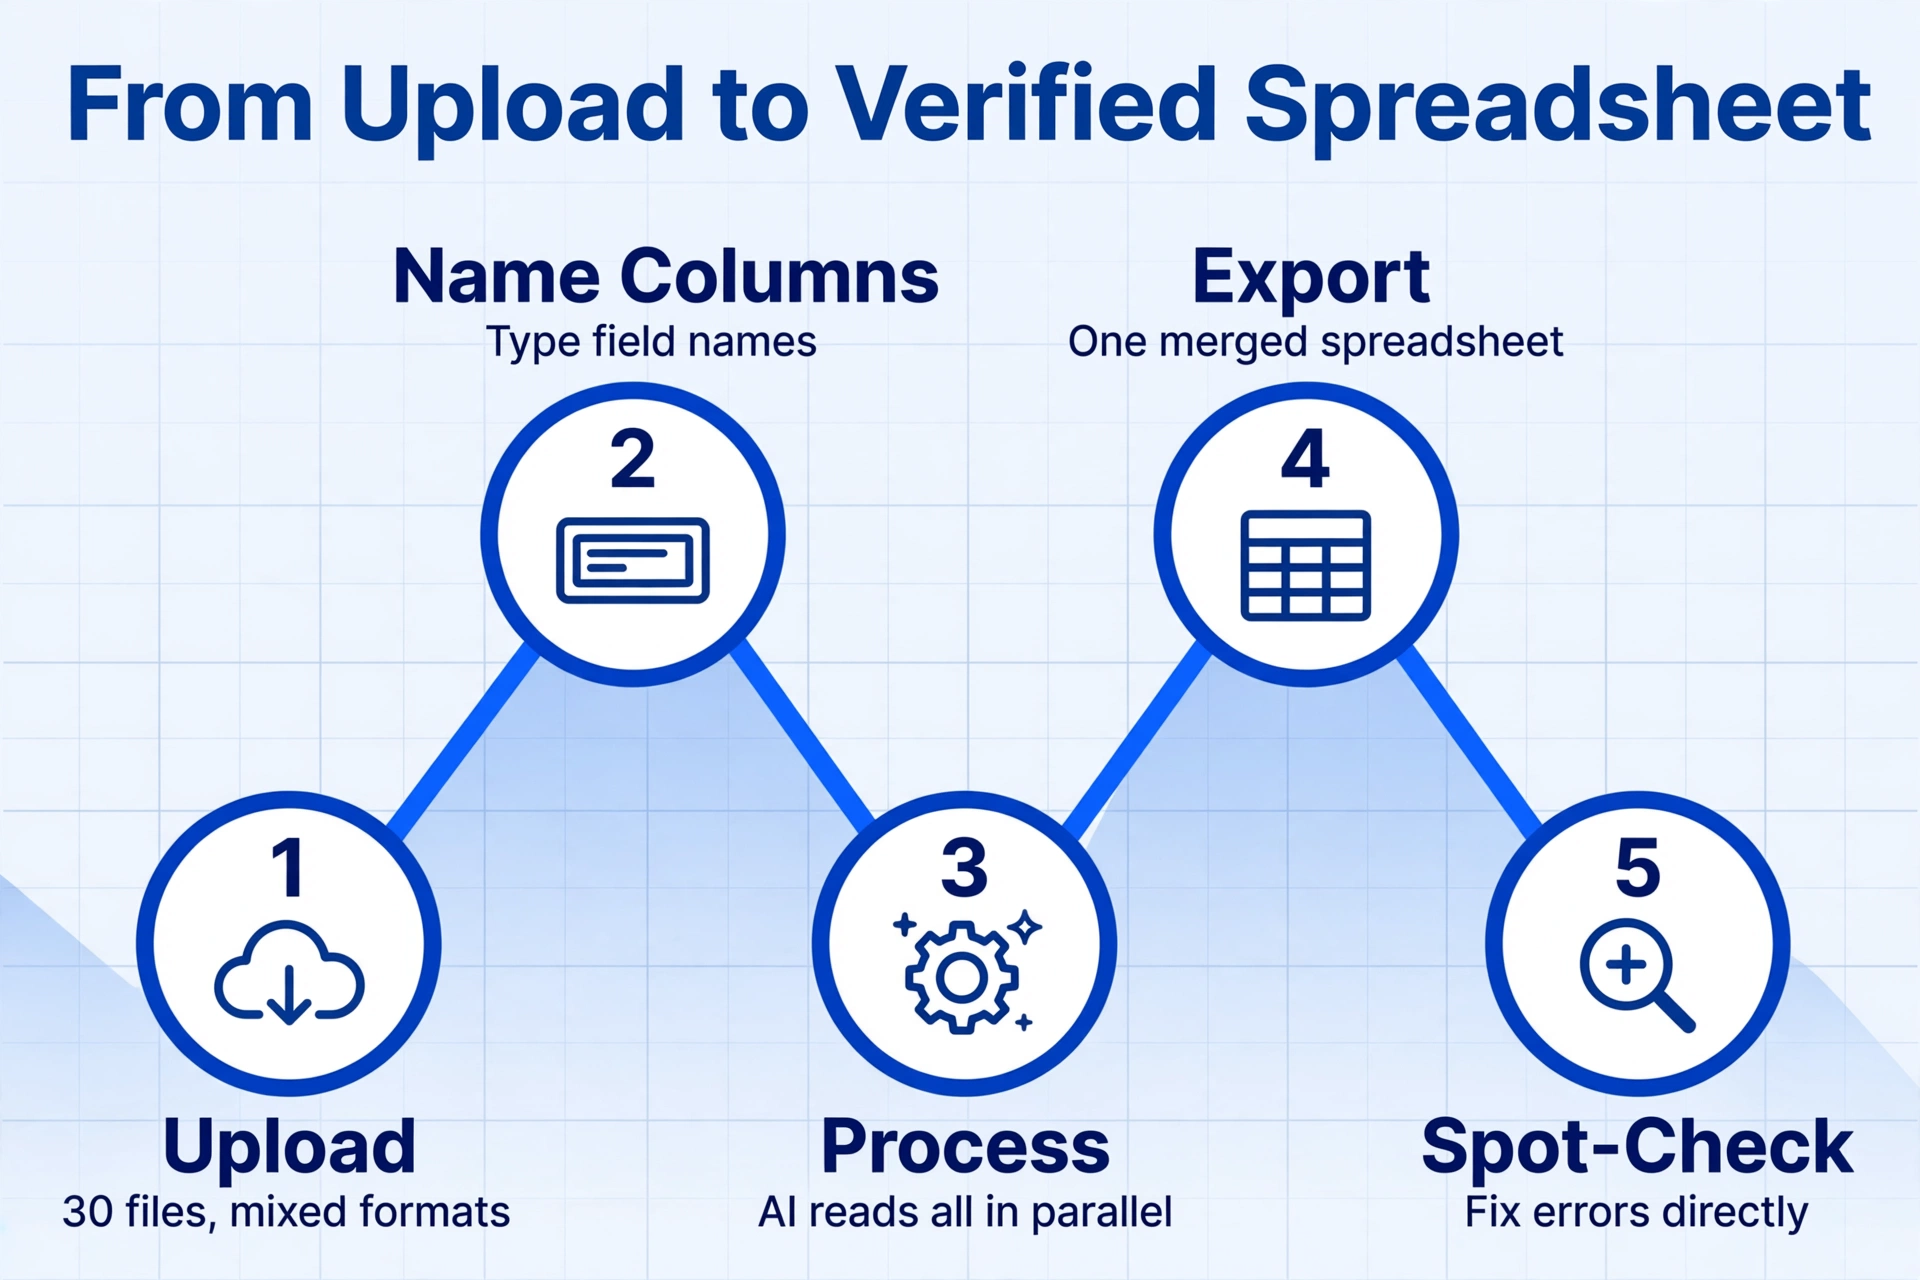
Este es el flujo de trabajo de principio a fin para un escenario real: un auxiliar de cuentas por pagar que procesa 30 facturas de proveedores cada miércoles. Las facturas llegan como PDF y escaneos JPEG de 12 proveedores diferentes, cada uno con un diseño distinto: algunas detalladas, otras de monto global, algunas con tablas de partidas y otras sin ellas.
Número de factura, Nombre del proveedor, Fecha de factura, Fecha de vencimiento, Monto total, Subtotal, Impuesto. Estos nombres se convierten en los encabezados de columna de su salida. Si no está seguro de qué campos contiene un documento, deje que la IA detecte y sugiera columnas automáticamente según lo que lea en los 30 archivos.2026-06-Miércoles-Proveedores. Haga clic en iniciar. La IA comienza a extraer datos de los 30 archivos simultáneamente. Cada archivo tarda aproximadamente 5 a 10 segundos, independientemente de la complejidad de la factura.Tiempo total para el empleado: aproximadamente 5 minutos de carga y configuración, y luego el procesamiento se ejecuta en segundo plano. La alternativa manual (abrir cada PDF, copiar los campos en una plantilla de Excel, verificar la precisión) tomaría de 30 a 90 minutos dependiendo de la complejidad de la factura. Eso es una ganancia de eficiencia de 6 a 18 veces, consistente con la mejora de velocidad de 18 veces documentada en comparaciones de referencia de extracción con IA versus entrada manual.
El mismo flujo de trabajo se aplica a todos los tipos de documentos. Reemplace "facturas de proveedores" por "notas de entrega de cinco almacenes", "recibos de gastos de 40 empleados" o "estados de cuenta bancarios de múltiples cuentas". Lo único que cambia son los nombres de las columnas que escribe. Para tutoriales paso a paso sobre tipos de documentos específicos, consulte cómo extraer datos de facturas por lotes a Excel o cómo procesar recibos de negocios por lotes en una hoja de cálculo de impuestos.
Lo que se pierde sin código
La honestidad sobre las concesiones es lo que separa una comparación útil de un discurso de ventas. El procesamiento por lotes sin código maneja de manera confiable el ciclo principal de extracción y combinación, pero las siguientes capacidades requieren un enfoque de programación:
Pipelines de procesamiento personalizados. Un script puede encadenar la extracción con acciones posteriores: "extraer datos de factura → validar contra la lista de códigos GL → publicar en QuickBooks vía API → enviar un correo electrónico al CFO si el total supera los $10,000". En una plataforma sin código, la extracción y la exportación son el final del camino automatizado. Cualquier cosa después de eso requiere intervención manual o una herramienta separada como Zapier o Make (anteriormente Integromat), que agregan su propia complejidad y costo.
Manejo de errores personalizado. Cuando un script encuentra un documento que no puede analizar, el desarrollador decide qué sucede: reintentar con diferentes parámetros, registrar el fallo en una base de datos, omitir el archivo y continuar, o marcarlo para revisión humana. Las plataformas sin código típicamente muestran indicadores de estado por documento (éxito, procesamiento, error), pero usted no controla la lógica de manejo de errores. Si la confianza es límite, no lo sabrá hasta la verificación puntual.
Automatización de API y programación. Un script de Python puede ejecutarse en un trabajo cron, activarse cuando un nuevo archivo llega a un bucket de S3, o llamarse desde un webhook. Se integra directamente con su infraestructura. Las plataformas sin código proporcionan acceso a API en planes de nivel superior, pero la automatización de activación y respuesta que los desarrolladores dan por sentada ("cuando un PDF llega a esta carpeta, extraerlo y agregarlo a esta tabla de base de datos") requiere una capa de automatización separada (Zapier, Power Automate, n8n) que agrega costo y mantenimiento.
Estas son limitaciones reales. Si el flujo de trabajo de su equipo involucra validación de múltiples pasos, enrutamiento condicional o activadores basados en eventos, el procesamiento por lotes sin código por sí solo no cubrirá el ciclo completo. Pero para la gran mayoría del procesamiento de documentos de volumen pequeño a mediano (el tipo que ocurre en firmas de contabilidad, pequeños equipos de logística, oficinas de administración de propiedades y prácticas de contabilidad independientes), estos son casos límite, no obstáculos.
Cuando tiene sentido escribir código
El procesamiento por lotes sin código no reemplaza universalmente a los scripts. Hay tres situaciones donde escribir código es la mejor opción:
Más de 500 documentos al día. A esta escala, la economía cambia. Un script en un servidor cuesta centavos por cada mil documentos, mientras que las plataformas sin código cobran por documento o página. Más importante aún, a alto volumen los modos de fallo cambian: un 1% de error en 500 documentos significa que 5 archivos necesitan reprocesarse. Los scripts pueden ajustarse para manejar casos límite mediante programación; las plataformas sin código exponen el mismo motor de extracción a cada documento, limitando tu capacidad de optimización.
Reglas de validación personalizadas vinculadas a tus datos. Si tu proceso requiere verificar valores extraídos contra tu propia base de datos — "¿está este RFC de proveedor en nuestra lista aprobada?" o "¿coincide el total de esta OC con la suma de las líneas?" — el código te da control total sobre la lógica de validación. Las plataformas sin código ofrecen columnas calculadas y posprocesamiento, pero la profundidad de validación es menor que la que un script con acceso completo a la base de datos puede lograr.
Integración profunda con APIs de sistemas existentes. Un script puede extraer datos de un documento, transformarlos y enviarlos directamente a tu ERP, CRM o software contable en una sola operación atómica. Las plataformas sin código suelen exportar a formatos intermedios (Excel, CSV, JSON) que requieren un segundo paso para importarlos a tu sistema. Para equipos que necesitan extracción → integración → activación en un flujo automatizado, un enfoque basado en API — ya sea una API de extracción especializada o un script que envuelva un servicio de extracción con IA — es la opción adecuada.
Para una comparación detallada de cuándo usar enfoques basados en API vs sin código, consulta API vs extracción de documentos sin código: qué arquitectura se adapta a tu equipo.
El punto medio honesto es un enfoque híbrido: usa extracción sin código para el paso de lectura de documentos (la parte que se beneficia de la IA visual y no necesita lógica personalizada) y un script ligero o plataforma de automatización para los pasos de enrutamiento y validación posteriores. Esta es la arquitectura que adoptan muchos equipos en crecimiento — sin código para la pesada carga de IA, y una capa delgada de código o conectores para la lógica de negocio.
Preguntas Frecuentes
¿Puedo procesar lotes de documentos en diferentes formatos — algunos PDF, otros imágenes escaneadas, otros fotos?
Sí. Las herramientas modernas de extracción por IA sin código aceptan tipos de archivo mixtos en un solo lote. PDF, JPG, PNG, WebP e incluso capturas de pantalla se pueden subir juntos y procesarse con el mismo conjunto de reglas de extracción. La IA lee el documento visualmente, no desde los metadatos del archivo, por lo que la variación de formato no afecta la lógica de extracción.
¿Cómo maneja el procesamiento por lotes sin código documentos con diferentes diseños de distintos proveedores?
Esta es la ventaja principal de la extracción por IA sin plantillas frente al OCR tradicional o al análisis zonal. En lugar de memorizar dónde están los campos en la página — lo que falla cuando los diseños cambian — la IA lee la semántica del campo: entiende cómo se ve un "número de factura" por contexto, no por posición. Así, 30 facturas de 30 proveedores diferentes se extraen correctamente en un solo lote, sin plantillas por proveedor ni muestras de entrenamiento.
¿Qué sucede si la IA se equivoca en algunos campos de algunos documentos?
Ningún sistema de extracción — codificado o no — alcanza el 100% de precisión en todos los documentos. La diferencia está en la velocidad de recuperación. Cuando revisas manualmente un lote sin código (paso 5 del flujo anterior), puedes corregir errores directamente en la hoja de cálculo descargada, reprocesar archivos individuales que fallaron o ajustar las definiciones de columnas para campos difíciles. El tiempo ahorrado sigue siendo órdenes de magnitud mayor que la extracción manual, incluso considerando las correcciones. Para una guía detallada sobre qué puede salir mal y cómo detectarlo, consulta por qué la extracción por lotes omite archivos — y qué hacer al respecto.
¿Necesito instalar algo en mi computadora?
No. El procesamiento por lotes sin código se ejecuta completamente en el navegador o a través de un panel lateral de complemento de Google Sheets. No hay software que instalar, ningún servidor local que ejecutar, ningún entorno de Python que configurar. El único requisito es una conexión a internet y un navegador web moderno.
¿Es el procesamiento por lotes sin código más barato que escribir un script?
Depende del volumen. Para equipos que procesan hasta unos cientos de documentos al mes, las plataformas sin código son más baratas que el tiempo de desarrollo necesario para construir y mantener un script personalizado — especialmente cuando se considera el costo de mantenimiento de scripts que se rompen cuando cambian los formatos de los documentos. Con un volumen muy alto (miles de documentos al día), un script ejecutándose en tu propia infraestructura tendrá costos por documento más bajos, aunque el salario del desarrollador y el tiempo de mantenimiento deben tenerse en cuenta en esa comparación.
Inicia tu primer lote sin código
La idea de que el procesamiento por lotes requiere programación ha hecho que muchos equipos pequeños sigan haciendo entrada manual de datos más tiempo del necesario. Las herramientas para extraer datos de 30, 50 o 200 documentos de una sola vez — sin escribir una sola línea de código — ya existen y son accesibles desde cualquier navegador. El flujo de trabajo es: subir, nombrar, procesar, exportar y verificar. Lo más difícil es saber qué datos quieres extraer. La IA se encarga del resto.
Si procesas documentos con regularidad y te ha frenado la idea de que necesitas aprender Python o contratar a un desarrollador, la prueba práctica es sencilla: toma tu próximo lote de documentos — aunque sean solo 5 o 10 archivos — súbelos a una plataforma de extracción sin código y mira cómo se ve el resultado. El primer lote no cuesta nada más que el tiempo que ya estás dedicando a la entrada manual.