コードを書かずに文書を
バッチ処理する方法
文書をバッチ処理するのにPythonスクリプトを書く必要はありません。文書抽出の自動化にはコーディングが必要だという思い込み — PDFディレクトリをforループで回し、PyPDF2やpdfplumberに苦労し、Tesseract OCRを設定し、出力をpandas DataFrameに結合する — は、文書処理ツールがAPIとSDKしか公開していなかった時代に根ざした学習されたものです。その時代は終わりつつあります。AI抽出機能を備えたドラッグ&ドロッププラットフォームが、コアとなるバッチワークフローを処理します。複数ファイルをアップロードし、出力列に名前を付け、結合された1つのスプレッドシートを取得するだけです。import文は不要です。
重要なポイント
- 年間78時間 — それは、バッチ処理には自分が知らないPythonが必要だと思い込み、毎週30件の請求書をスプレッドシートにコピーペーストするのに1人が費やす時間です。
- あるベンダーが請求書のレイアウトを静かに変更するだけで、自作の抽出スクリプトは静かに壊れます。そして、DIY自動化が失敗する主な原因は、コーディングスキルではなくメンテナンスです。
- 言語ではなく質問を変えましょう。コードにページ上のフィールドの見つけ方を指示するのをやめ、必要な列に名前を付け始めましょう。バッチ結合と並行処理は自動で行われます。
バッチ処理にコードが不要な理由
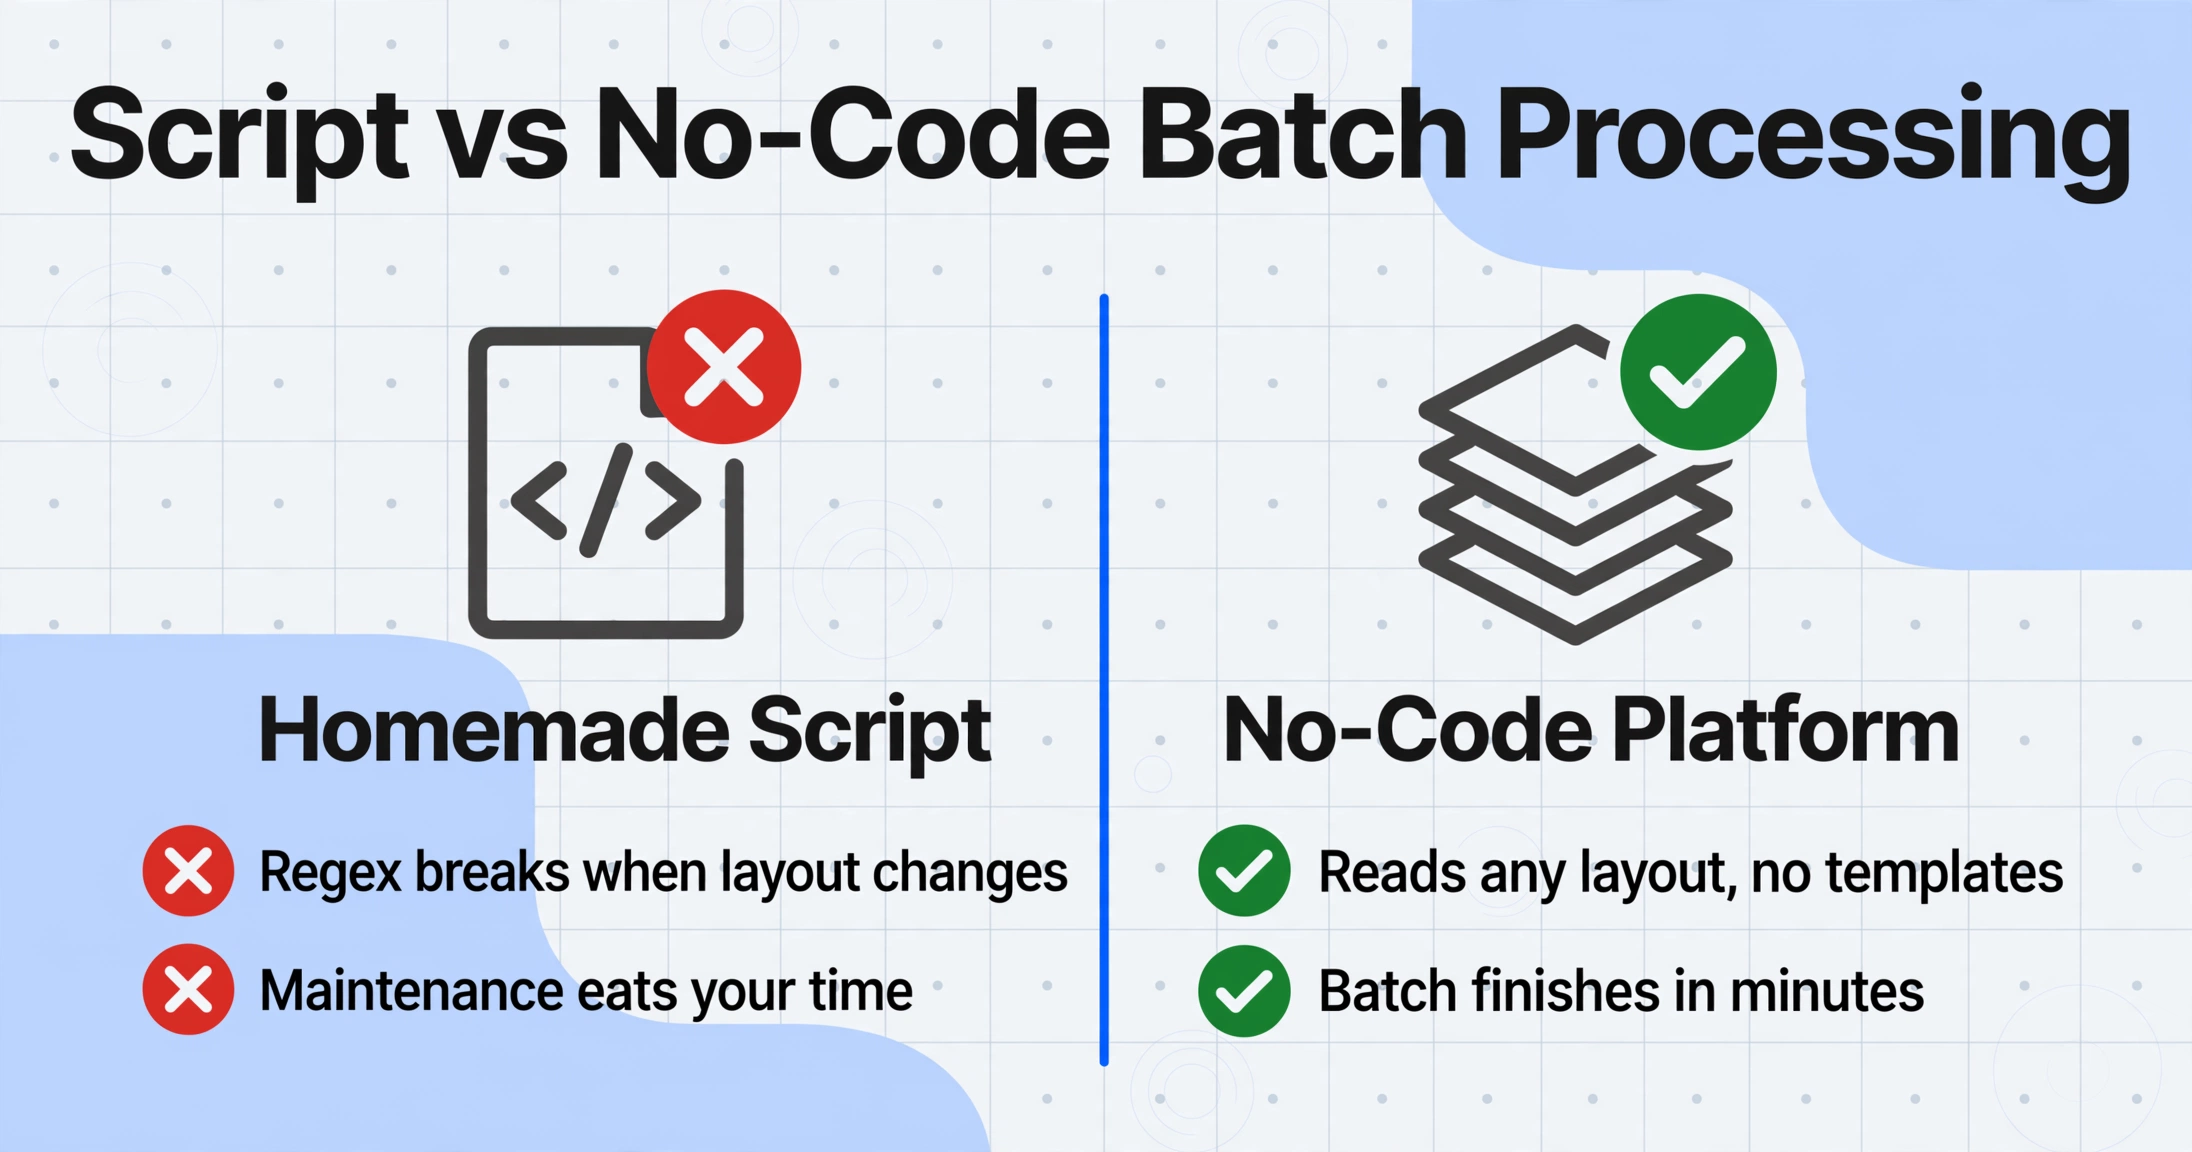
バッチ処理とプログラミングの結びつきは偶然ではありません。長年にわたり、複数の文書を一度に処理する唯一の方法はスクリプトを書くことでした。そのスクリプトは各ファイルを開き、Tesseract のようなOCRライブラリや PyPDF2 や pdfplumber のようなPDFパーサーを使ってテキストを抽出し、正規表現や位置情報のロジックで生テキストをフィールドに解析し、pandas や openpyxl を使って結果をCSVまたはExcelファイルに書き込むものでした。
そのパイプラインは機能しますが、ほとんどの小規模チームが持っていないスキルセットを要求します。SBA Advocacy Officeの2025年中小企業プロファイルによると、米国企業の99.9%が中小企業であり、その82%は従業員を一切雇用していません。専任の開発者はなおさらです。雇用企業の間でも、61.6%は従業員が5人未満です(国勢調査局、2019年)。BLSは米国に約170万人のソフトウェア開発者を数えていますが、その大半はテクノロジー企業や大企業に集中しており、国内企業の99.9%を占める3600万の中小企業にはいません。
「すべてのPDFを画像に変換するスクリプトを書き、pytesseractで読み取り、正規表現で必要なデータを文字列から検索し、CSVにデータを書き込みました」と、あるユーザーが r/learnpython で、2つのPDFからデータを抽出するアプローチを説明しています。この仕組みは機能します。しかし、ベンダーが請求書のレイアウトを変更すると、正規表現が壊れます。新しいスキャンでのTesseractの出力が文字化けします。スクリプトにはメンテナンスが必要です——そして、メンテナンスこそが、ほとんどの自作自動化が頓挫するポイントです。
ノーコードのバッチ処理は、スクリプトをより単純なスクリプトに置き換えるのではなく、パラダイムを完全に変えることでこのサイクルを断ち切ります。コンピューターにページ上のデータの見つけ方(座標、正規表現パターン、タグ名)を指示する代わりに、必要なデータが何かを伝えるだけで、AIが文書の内容を理解してそれを特定します。バッチロジック——「このグループのすべてのファイルを処理し、出力を結合する」——はプラットフォームに組み込まれており、ユーザーが書く必要はありません。その結果は、一般的な文書処理シナリオの80%において、コードを一切書かずに半自動化されたPythonパイプラインと機能的に同等です。
実際に必要なもの
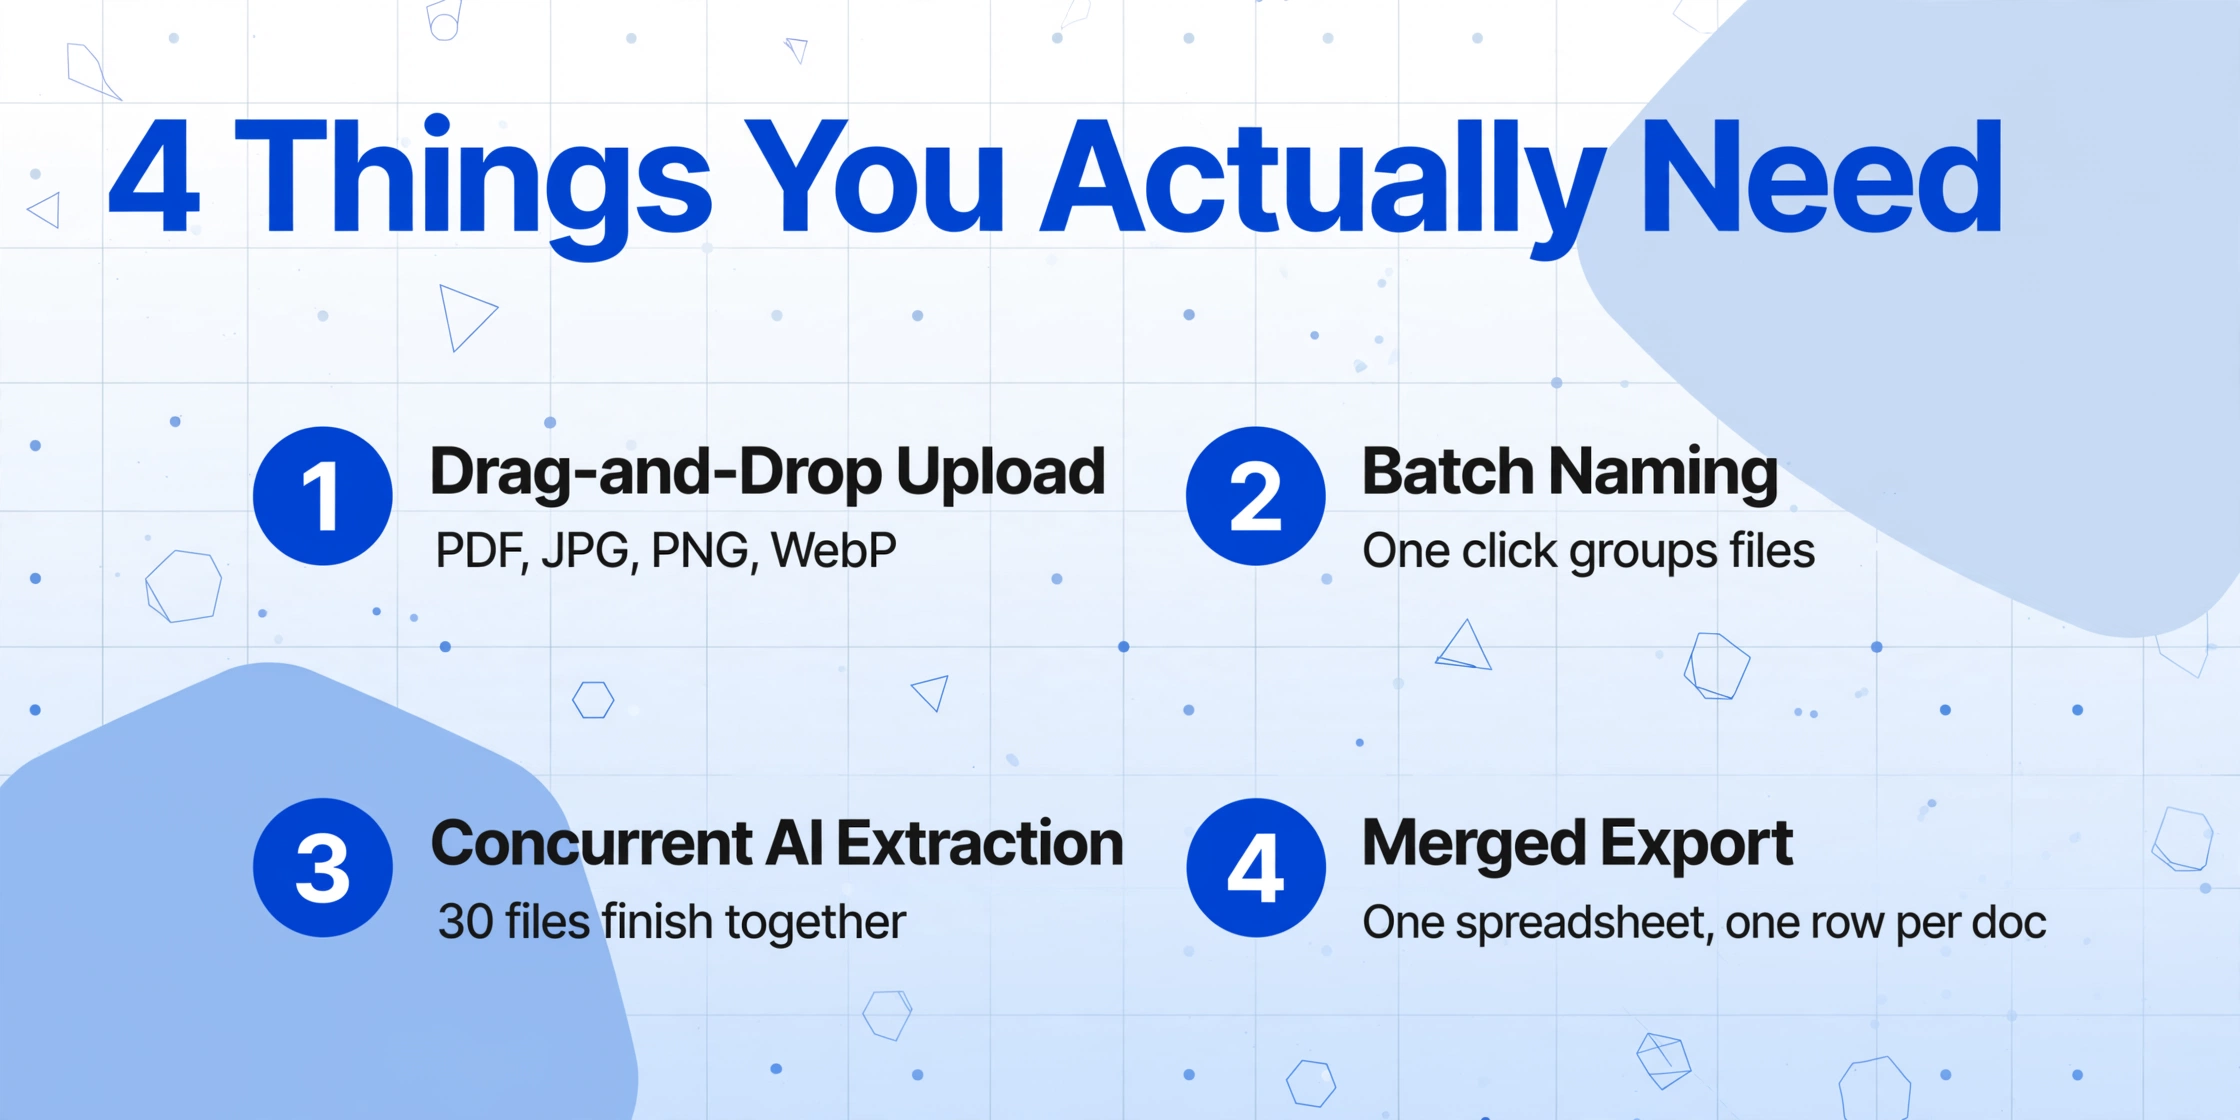
ノーコードのバッチ文書処理に必要な最小構成は、ほとんどの人が思うより短いものです。必要なのは次の4つだけです:
- ドラッグ&ドロップのアップロードインターフェース — 使用するファイル形式(PDF、JPG、PNG、WebP)を受け付けます。ほとんどのノーコード抽出ツールは、ブラウザベースまたはGoogle スプレッドシートに組み込まれたアップロード画面を提供します。ローカルソフトウェアのインストールは不要です。
- バッチ命名メカニズム — 関連するファイルをグループ化します。ノーコードプラットフォームでは、通常、ワンクリックでバッチ名を割り当てることを意味します — フォルダに名前を付けるのと同じです — ディレクトリを走査するスクリプトを書く必要はありません。
- 同時AI抽出 — バッチ内のすべてのファイルを同時に処理します。これが隠れたエンジンです:人間は一度に1つの文書しか開いて読めませんが、バッチ対応プラットフォームはグループ内のすべてのファイルに処理を分散させるため、30枚の請求書も1枚とほぼ同時に完了します。
- 統合エクスポート — すべての文書から抽出したデータを1つのファイル(1つのExcelスプレッドシート、1つのCSV、1つのGoogle スプレッドシートのタブ)に統合します。各行が1つの文書を表し、各列が定義した1つのフィールドを表します。
これだけです。Pythonのforループも、設定するAPIエンドポイントも、ラベル付けするトレーニングサンプルもありません。入力した列名が出力スプレッドシートのヘッダーになります。AIが残りを処理します。
これが、テンプレートベースのツールや事前設定が必要な機械学習プラットフォームとは異なる、現代のノーコード文書抽出の根底にあるパラダイムシフトです。カスタム列抽出に基づくプラットフォーム — 「請求書番号、仕入先、合計、支払期日」などのフィールド名を入力すると、AIが意味理解によって各値を特定する — は、ノーコードが節約するはずの時間を静かに消費する設定コストを排除します。
ノーコードのバッチ処理ワークフロー
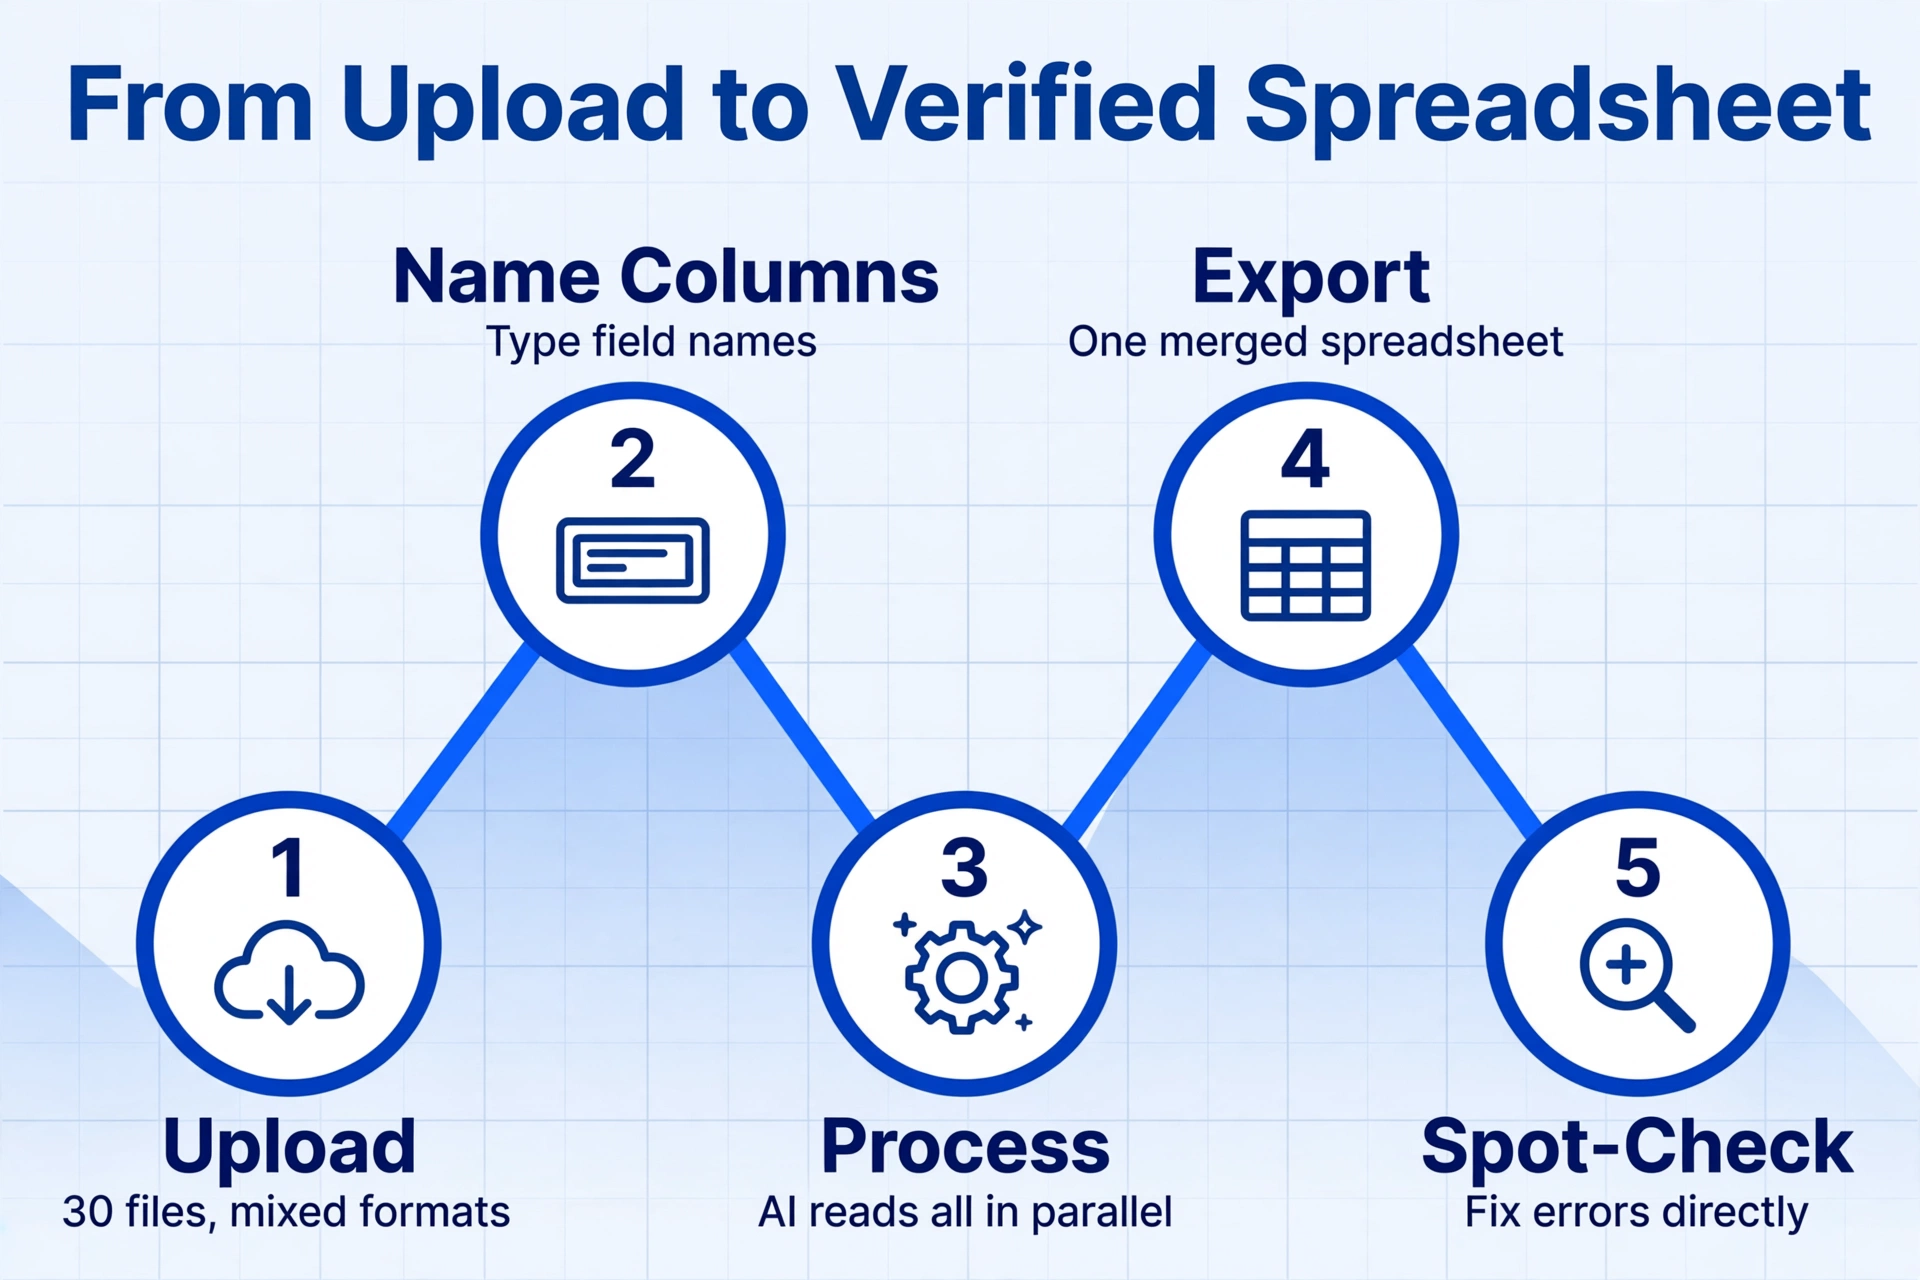
実際のシナリオにおけるエンドツーエンドのワークフローは次のとおりです。毎週水曜日に30件のベンダー請求書を処理する買掛金担当者を例にします。請求書は12社の異なるサプライヤーからPDFとJPEGスキャンで届き、それぞれレイアウトが異なります。明細項目があるもの、一括請求のもの、明細テーブルがあるもの、ないものなどさまざまです。
Invoice Number, Vendor Name, Invoice Date, Due Date, Total Amount, Subtotal, Tax。これらの名前が出力の列ヘッダーになります。文書にどのフィールドが含まれているか不明な場合は、AIが30件すべてのファイルを読み取って列を自動検出し、提案します。2026-06-Wednesday-Vendors のようなラベルをバッチに付けます。開始をクリックすると、AIが30件すべてのファイルから同時にデータ抽出を開始します。各ファイルは請求書の複雑さに関係なく、約5〜10秒かかります。事務担当者の合計時間: アップロードと設定に約5分、その後はバックグラウンドで処理が実行されます。手動での代替方法 — 各PDFを開き、フィールドをExcelテンプレートにコピーし、正確性を確認する — は、請求書の複雑さに応じて30〜90分かかります。これは6〜18倍の効率向上であり、AI抽出と手動入力を比較したベンチマークで記録された18倍の速度改善と一致します。
同じワークフローが文書タイプを問わず適用されます。「仕入先請求書」を「5つの倉庫からの納品書」、「40人の従業員からの経費領収書」、「複数の口座からの銀行明細書」に置き換えてください。変更されるのは入力する列名だけです。特定の文書タイプのステップバイステップのチュートリアルについては、請求書データをExcelに一括抽出する方法または業務用領収書を税務スプレッドシートに一括処理する方法をご覧ください。
ノーコードで失うもの
トレードオフについて正直に語ることが、役立つ比較とセールストークを分けるポイントです。ノーコードのバッチ処理は、コアとなる抽出・統合ループを確実に処理しますが、以下の機能にはコーディングによるアプローチが必要です:
カスタム処理パイプライン。スクリプトは抽出を後続のアクションと連鎖させることができます — 「請求書データを抽出 → GLコードリストと照合 → API経由でQuickBooksに転記 → 合計が$10,000を超える場合はCFOにメール送信」。ノーコードプラットフォームでは、抽出とエクスポートが自動化パスの終点です。それ以降は手動介入か、ZapierやMake(旧Integromat)のような別のツールが必要になり、複雑さとコストが追加されます。
カスタムエラー処理。スクリプトが解析できない文書に遭遇した場合、開発者が次に何が起こるかを決定します: 異なるパラメータで再試行、データベースへの失敗の記録、ファイルをスキップして続行、または人間によるレビューのためのフラグ付け。ノーコードプラットフォームは通常、文書ごとのステータスインジケータ(成功、処理中、エラー)を表示しますが、エラー処理ロジックを制御することはできません。信頼性が境界線上にある場合、スポットチェックまでわかりません。
API自動化とスケジューリング。Pythonスクリプトはcronジョブで実行したり、S3バケットに新しいファイルが到着したときにトリガーしたり、Webhookから呼び出したりできます。インフラストラクチャと直接統合されます。ノーコードプラットフォームは上位プランでAPIアクセスを提供しますが、開発者が当然と考えるトリガー・アンド・レスポンス自動化 — 「PDFがこのフォルダに到着したら、抽出してこのデータベーステーブルに追加する」 — には、コストとメンテナンスを追加する別の自動化レイヤー(Zapier、Power Automate、n8n)が必要です。
これらは実際の制限です。チームのワークフローに多段階の検証、条件付きルーティング、イベント駆動型トリガーが含まれる場合、ノーコードのバッチ処理だけでは完全なループをカバーできません。しかし、会計事務所、小規模な物流チーム、不動産管理オフィス、フリーランスの簿記業務で発生するような、中小規模の文書処理の大部分にとって、これらは致命的な問題ではなく、エッジケースです。
コードを書くべき3つのケース
ノーコードのバッチ処理は、スクリプトの万能な代替手段ではありません。以下の3つの状況では、コードを書く方が適切です。
1日500文書以上のボリューム。この規模になると、経済性が変わります。サーバー上で動作するスクリプトは1,000文書あたり数セントのコストですが、ノーコードプラットフォームは文書またはページごとに課金されます。さらに重要なのは、大量処理では障害のパターンが変わることです。500文書で1%のエラー率は5ファイルの再処理を意味します。スクリプトはエッジケースをプログラムで処理するよう調整できますが、ノーコードプラットフォームはすべての文書に同じ抽出エンジンを適用するため、最適化の余地が限られます。
データに紐づくカスタム検証ルール。抽出値を自社データベースと照合する必要がある場合(「このベンダーの税IDは承認リストに含まれているか?」「この発注書の合計は明細行の合計と一致するか?」など)、コードを使えば検証ロジックを完全に制御できます。ノーコードプラットフォームでも計算列や後処理は提供されますが、データベースに完全にアクセスできるスクリプトに比べると検証の深さは浅くなります。
既存システムとの深いAPI連携。スクリプトは文書からデータを抽出し、変換し、ERP、CRM、会計ソフトに1回のアトミックな操作で直接POSTできます。ノーコードプラットフォームは通常、中間形式(Excel、CSV、JSON)にエクスポートし、システムにインポートするための2番目のステップが必要です。抽出→統合→トリガーを1つの自動フローで実現したいチームには、APIベースのアプローチ(専用の抽出API、またはAI抽出サービスをラップしたスクリプト)が適しています。
APIベースとノーコードのアプローチの詳細な比較については、API vs ノーコード文書抽出:あなたのチームに適したアーキテクチャは?をご覧ください。
正直なところ、最適解はハイブリッドアプローチです。文書読み取りのステップ(視覚AIの恩恵を受け、カスタムロジックを必要としない部分)にはノーコード抽出を使用し、その後のルーティングと検証のステップには軽量なスクリプトまたは自動化プラットフォームを使用します。これは多くの成長中のチームが採用するアーキテクチャです。重いAI処理にはノーコード、ビジネスロジックには薄いコード層またはコネクタ、という構成です。
よくある質問
PDF、スキャン画像、写真など、異なる形式の書類を一括処理できますか?
はい。最新のノーコードAI抽出ツールは、1つのバッチで異なるファイル形式を受け付けます。PDF、JPG、PNG、WebP、スクリーンショットなどをまとめてアップロードし、同じ抽出ルールで処理できます。AIはファイルのメタデータではなく、書類を視覚的に読み取るため、形式の違いは抽出ロジックに影響しません。
ノーコードの一括処理は、取引先ごとにレイアウトが異なる書類をどのように扱いますか?
これこそが、従来のOCRやゾーン解析に対する、テンプレート不要のAI抽出の最大の利点です。AIはフィールドがページ上のどこにあるかを記憶するのではなく(レイアウトが変わると機能しなくなります)、フィールドの意味を読み取ります。つまり、「請求書番号」が何であるかを、位置ではなく文脈から理解します。そのため、30の異なる取引先からの30枚の請求書でも、取引先ごとのテンプレートや学習サンプルなしに、1つのバッチで正確に抽出できます。
一部の書類でAIが誤ったフィールドを抽出した場合はどうなりますか?
コード化されているかどうかに関わらず、あらゆる抽出システムで全ての書類を100%正確に処理することはできません。重要なのは復旧の速さです。ノーコードバッチを手動で確認する際(上記ワークフローのステップ5)、ダウンロードしたスプレッドシート上で直接エラーを修正したり、失敗したファイルを個別に再処理したり、扱いにくいフィールドに合わせて列定義を調整したりできます。修正にかかる時間を考慮しても、手動抽出と比較して格段に時間を節約できます。何が問題となり、どのように対処すべきかの詳細なガイドは、バッチ抽出でファイルが見逃される理由とその対処法をご覧ください。
コンピューターに何かをインストールする必要はありますか?
いいえ。ノーコードの一括処理は、ブラウザ上またはGoogleスプレッドシートのアドオンサイドバー上で完全に動作します。インストールするソフトウェア、実行するローカルサーバー、設定するPython環境は一切必要ありません。必要なのはインターネット接続と最新のウェブブラウザのみです。
ノーコードの一括処理は、スクリプトを作成するよりも安上がりですか?
ボリュームによります。月に数百件の書類を処理するチームにとっては、カスタムスクリプトの構築と保守にかかる開発者時間よりも、ノーコードプラットフォームの方が安価です。特に、書類形式の変更でスクリプトが使えなくなる場合の保守コストを考慮すると顕著です。非常に大量(毎日数千件)の場合は、自社インフラでスクリプトを実行する方が書類あたりのコストは低くなりますが、その比較には開発者の人件費と保守時間も考慮する必要があります。
初めてのノーコードバッチ処理を始める
バッチ処理にはプログラミングが必要だという思い込みから、多くの小規模チームが必要以上に手作業でのデータ入力を続けてきました。30、50、200もの文書から一度にデータを抽出するツールは、コードを一行も書かずに、どのブラウザからでもアクセスして使えます。ワークフローは、アップロード、命名、処理、エクスポート、スポットチェックの順です。最も難しいのは、どのデータを抽出したいかを決めることです。AIが残りを処理します。
定期的に文書を処理していて、Pythonを学んだり開発者を雇ったりする必要があるという考えに二の足を踏んでいるなら、実践的なテストは簡単です。次のバッチの文書(5~10ファイルでも構いません)を用意し、ノーコード抽出プラットフォームにアップロードして、出力結果を確認してみてください。最初のバッチにかかるコストは、これまで手作業の入力に費やしてきた時間だけです。