Comment choisir un outil OCR :
Un cadre de décision en 5 étapes pour 2026
La plupart des guides d'achat OCR partent du mauvais endroit : ils listent des outils, comparent des fonctionnalités et vous demandent de choisir dans un menu avant même que vous sachiez quel type de sortie vous avez réellement besoin. Cet article adopte l'approche inverse. À la fin de ces cinq étapes, vous disposerez d'un ensemble documenté d'exigences, d'une liste restreinte de catégories d'outils correspondant à ces exigences, et d'un plan de test qui confirme quel outil fonctionne réellement sur vos documents — pas sur les échantillons de démonstration du fournisseur.
Points clés à retenir
- Chaque outil OCR revendique une précision de 95 % ou plus — mais ce chiffre est mesuré sur du texte anglais imprimé propre préparé pour une démo, pas sur la photo au téléphone d'un reçu froissé que vous devez réellement traiter.
- La métrique que chaque fournisseur met en avant — le taux de reconnaissance des caractères — est la mauvaise pour la plupart des flux de travail professionnels. Un outil peut lire 99 % des caractères correctement et pourtant se tromper sur le total de votre facture parce qu'il a mal lu un chiffre. La métrique qui compte est la précision au niveau des champs.
- Avant de comparer un seul outil, répondez à une question : avez-vous besoin de texte consultable ou de données structurées dans une feuille de calcul ? Répondre à cette question élimine immédiatement 75 % des outils — la mauvaise catégorie ne peut pas être corrigée par plus de fonctionnalités ou un prix plus bas.
Avant de commencer : trois chiffres à connaître
Le cadre de décision ne fonctionne que si vous partez de réponses honnêtes à trois questions. Sautez cette étape et le reste du processus devient de la conjecture déguisée en analyse.
Quels types de documents traitez-vous ? Notez chaque type de document que vous gérez — factures, reçus, bons de commande, contrats, formulaires manuscrits, tout ce qui atterrit sur votre bureau. Regroupez-les par format (PDF envoyé par e-mail, photo prise au téléphone, scan de mauvaise qualité). La variété des types de documents que vous traitez détermine si vous avez besoin d'un outil spécialisé pour un format ou d'un outil généraliste qui en gère plusieurs.
Combien de documents par semaine ? Comptez, ne devinez pas. 10 documents par semaine nécessite une catégorie d'outil différente de 500. Le volume détermine si le traitement par lots est important, si la tarification par page a du sens, et si la vitesse d'automatisation est une vraie préoccupation ou un simple bonus.
Quel est votre budget réel ? Comptez le coût complet : frais de licence ou abonnement, temps de configuration (votre taux horaire × heures passées), et maintenance continue. Un outil « gratuit » qui vous coûte 10 heures de configuration est plus cher qu'un outil à 30 $/mois qui fonctionne en 10 minutes.
Règle de décision : Notez ces trois réponses avant d'évaluer le moindre outil. Chaque étape suivante s'y réfère. Si les réponses changent (vous passez à l'échelle, votre mix de documents évolue), le cadre fonctionne toujours — il suffit de le relancer avec les nouveaux chiffres.
Étape 1 : Auditez vos documents
Avant de pouvoir assortir un outil à vos documents, vous devez savoir à quoi ressemblent vos documents. L'audit documentaire semble être une charge supplémentaire, mais c'est l'étape qui sépare un achat que vous utilisez pendant des années de celui que vous abandonnez après trois mois. Pour un aperçu plus approfondi de la comparaison des types de documents côte à côte, notre comparatif des meilleurs logiciels OCR détaille quels outils gèrent quels formats de documents.
Auditez selon cinq dimensions :
1. Format
PDF numérique natif provenant d'un e-mail ? Image scannée à 300 DPI ? Photo de téléphone prise sous un éclairage fluorescent ? Chaque format affecte différemment les performances de l'outil. L'OCR traditionnel (Tesseract, ABBYY) a été conçu pour les images scannées de haute qualité. Les outils basés sur l'IA gèrent les photos de téléphone et les captures d'écran presque aussi bien que les scans propres. Si la plupart de vos documents sont des photos de téléphone, vous avez besoin d'un outil conçu pour cela.
2. Qualité
Évaluez vos documents sur une échelle simple : Bonne (scan 300 DPI propre, contraste élevé), Moyenne (légèrement flou, faible contraste, légère inclinaison), Mauvaise (faible résolution, ombres, reflets, texte délavé). Si plus de 20 % de vos documents sont de qualité Moyenne ou Mauvaise, recherchez des outils avec prétraitement d'image intégré — redressement, débruitage, amélioration du contraste. Ces fonctionnalités peuvent à elles seules améliorer la précision de 5 à 15 points de pourcentage.
3. Complexité de la mise en page
Simple = une colonne de texte, sans tableaux (une lettre, une page de contrat). Moyenne = tableaux avec limites de cellules claires, lignes d'articles (une facture standard, un bordereau d'expédition). Complexe = cellules fusionnées, mises en page multi-colonnes, texte pivoté, cases à cocher, annotations manuscrites (un bon de commande avec conditions, un certificat COI). La complexité de votre mise en page détermine si un outil doit disposer d'une extraction de tableaux, d'une détection de l'ordre de lecture ou d'une reconnaissance des cases à cocher. La plupart des outils OCR gratuits échouent sur les mises en page complexes.
4. Langue
Langue unique (anglais uniquement), plusieurs langues dans le même document (une facture bilingue), ou écritures non latines (chinois, arabe, coréen) ? Les moteurs OCR gratuits comme Tesseract prennent en charge de nombreuses langues mais nécessitent des packs de langues séparés et perdent en précision sur les documents multilingues. Les API cloud comme Google Cloud Vision et Azure Document Intelligence gèrent nativement plus de 200 langues. Si vos documents sont multilingues, cela seul peut éliminer certains outils.
5. Résultat souhaité
C'est la question la plus importante, et celle que la plupart des guides omettent : avez-vous besoin de texte consultable ou de données structurées ? Si votre objectif est de rendre les PDF consultables ou de copier des paragraphes dans un document, vous avez besoin d'OCR traditionnel — la reconnaissance de caractères. Si votre objectif est d'obtenir les totaux de factures, les lignes d'articles, les dates et les noms de fournisseurs dans une feuille de calcul ou une base de données, vous avez besoin d'extraction de données — ce qui est une catégorie technologique différente. Comprendre cette différence est la décision la plus importante que vous prendrez. Notre comparaison entre l'IA OCR et l'OCR traditionnel explique cet écart en détail.
Résultat de cette étape : Une fiche de profil de document — format, niveau de qualité, complexité de mise en page, langues et les champs spécifiques que vous devez extraire (si l'extraction de données est votre objectif). Ce profil devient votre base d'évaluation pour chaque outil que vous testez.
Étape 2 : Choisissez votre catégorie de déploiement
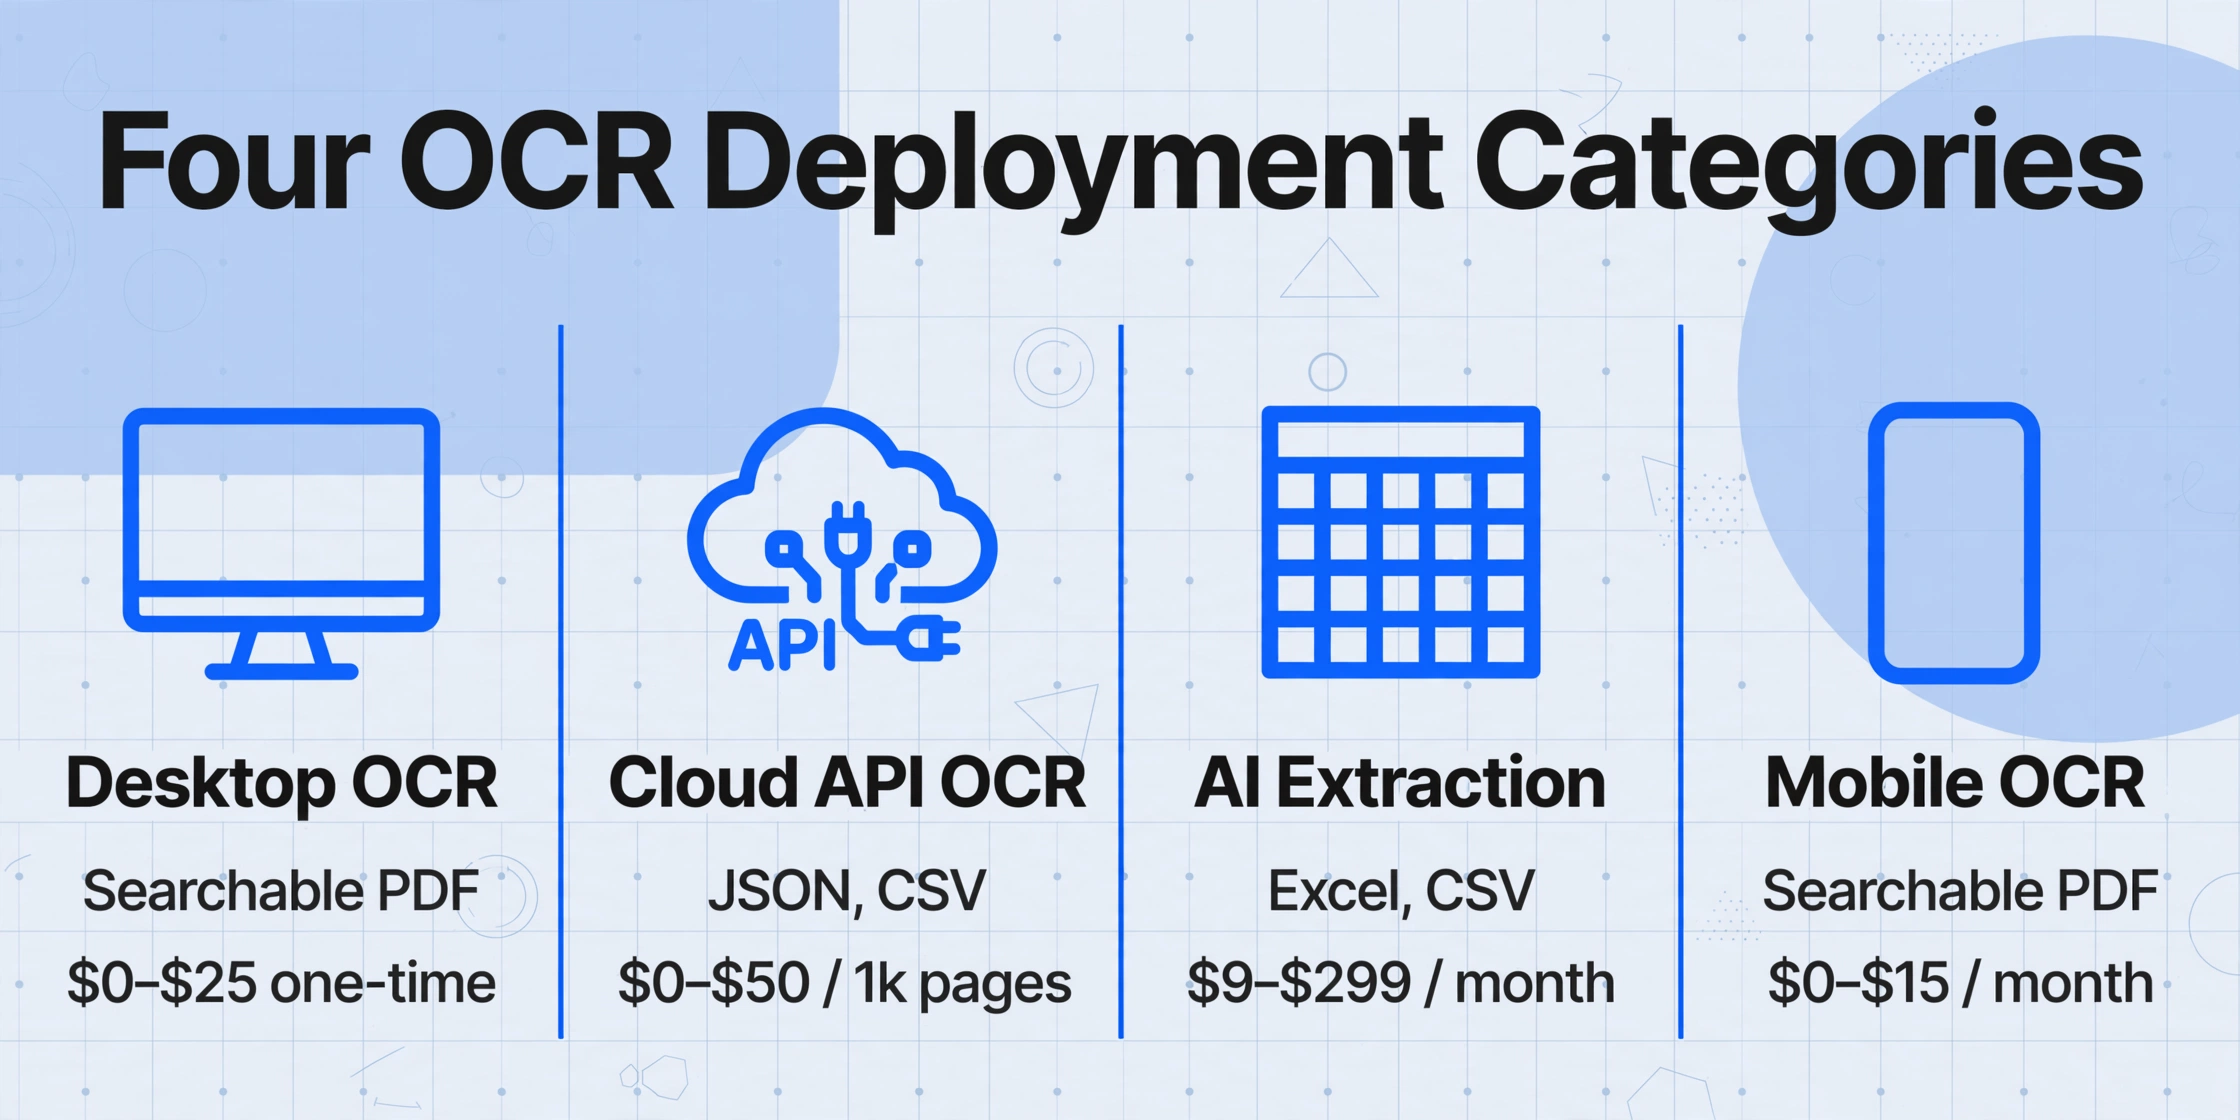
Les outils OCR se répartissent en quatre catégories de déploiement. Chacune répond à un besoin fondamentalement différent. Bien choisir sa catégorie élimine 75 % des options avant même de comparer les outils spécifiques.
| Catégorie | Idéal pour | Type de sortie | Coût mensuel (typique) | Compétence technique |
|---|---|---|---|---|
| OCR de bureau ABBYY, Adobe, Readiris | Hors ligne, projets ponctuels, archivage de documents | PDF consultable, Word modifiable | 0 à 25 $ une fois (licence perpétuelle) | Faible |
| OCR par API cloud Google, AWS, Azure, Tesseract API | Intégration développeur, volume élevé, pipeline personnalisé | JSON, CSV, texte structuré | 0 à 50 $ pour 1 000 pages | Élevée |
| Extraction par IA ImageToTable.ai, Nanonets, Rossum | Données structurées vers tableur, sans code, sans modèle | Excel, CSV, Google Sheets, JSON structuré | 9 à 299 $ par mois | Aucune à faible |
| OCR mobile Adobe Scan, Microsoft Lens, CamScanner | Capture en déplacement, reçus, tableaux blancs | PDF consultable, export de texte | 0 à 15 $ par mois | Aucune |
Le choix entre ces quatre catégories repose sur l'entrée « Sortie souhaitée » de votre profil de document. Si vous avez besoin de documents consultables, tournez-vous vers l'OCR de bureau ou mobile. Si vous avez besoin de données structurées dans un tableur, tournez-vous vers l'extraction par IA ou les API cloud. Si vous avez un développeur dans votre équipe et devez traiter plus de 5 000 documents par mois, les API cloud deviennent rentables. Si vous n'avez pas de développeur et avez besoin de données dans Excel, les outils d'extraction par IA suppriment entièrement la couche d'intégration. Nos guides spécialisés approfondissent chaque catégorie : meilleur logiciel OCR de bureau, meilleure API OCR et meilleures applications OCR mobiles.
Règle de décision : Si votre colonne de sortie indique « données », ignorez complètement l'OCR de bureau. Si votre colonne de sortie indique « PDF consultable », ignorez l'extraction par IA. Essayer d'utiliser un outil d'OCR de bureau pour extraire des données structurées dans un tableur, c'est comme utiliser un marteau pour visser une ampoule — possible en théorie, mais pénible en pratique.
Étape 3 : Évaluez selon vos exigences (cadre de liste de contrôle)
Votre catégorie de déploiement étant sélectionnée, vous disposez désormais d'une shortlist de 3 à 6 outils. Évaluez-les selon huit dimensions. Notez chacun de 1 (ne répond pas à l'exigence) à 5 (dépasse l'exigence). Utilisez votre profil de document de l'étape 1 pour pondérer chaque dimension.
1. Précision sur vos documents
Les affirmations de précision des fournisseurs reposent sur du texte anglais propre et imprimé dans des conditions idéales. Vos documents ne sont pas comme ça. La seule mesure de précision qui compte est la performance de l'outil sur votre mix de documents réel. Effectuez un test avec vos fichiers réels (voir l'étape 4).
2. Qualité et format de sortie
L'outil peut-il produire exactement ce dont vous avez besoin ? Pour l'extraction de données, cela signifie une précision au niveau des champs — obtient-il le bon total de facture, et pas seulement la lecture correcte de la plupart des caractères ? Pour les PDF consultables, préserve-t-il la mise en page d'origine ? Vérifiez que le format de sortie (Excel, CSV, JSON, PDF consultable) s'intègre directement à votre système en aval sans reformatage manuel.
3. Configuration et courbe d'apprentissage
OCR de bureau : installation et utilisation en une session. API cloud : de quelques jours à quelques semaines pour l'intégration SDK et la configuration IAM. Extraction par IA : téléchargez un fichier et extrayez en moins d'une minute. Le temps de configuration réaliste compte. Un outil qui nécessite deux semaines de configuration peut ne pas valoir la peine pour 50 documents par mois.
4. Capacités d'intégration
L'outil se connecte-t-il aux systèmes que vous utilisez déjà ? Intégration ERP (SAP, Oracle), logiciel de comptabilité (QuickBooks, Xero), Google Sheets ou Microsoft Excel, stockage cloud (Google Drive, Dropbox). Si l'outil produit un CSV mais que votre système comptable nécessite une API, vous avez besoin d'une couche d'intégration — intégrez-la au budget.
5. Évolutivité et performance
L'OCR de bureau ralentit considérablement au-delà de 50 à 100 pages par lot. Les API cloud peuvent traiter des milliers de pages par heure mais peuvent vous limiter en débit. Les outils d'extraction par IA gèrent généralement 100 à 500 fichiers par lot. Faites correspondre le débit à votre volume de l'étape 1, plus une marge de 2× pour les périodes de pointe.
6. Sécurité et conformité
Où vos documents sont-ils traités et stockés ? Les outils sur site traitent tout localement — aucune donnée ne quitte votre machine. Les API cloud et les outils d'extraction par IA traitent les données sur des serveurs distants. Si vous manipulez des données sensibles (PII, HIPAA, GDPR), vérifiez les politiques de traitement des données de l'outil : certification SOC 2, chiffrement des données en transit et au repos, options de résidence des données, et si les documents téléchargés sont utilisés pour l'entraînement des modèles. Pour les documents couverts par HIPAA, un outil sur site ou un fournisseur cloud avec BAA signé est requis.
7. Structure des coûts
Bureau : licence unique + frais de mise à jour annuels. API cloud : tarification par page avec paliers de volume. Extraction par IA : abonnement mensuel selon le nombre de documents ou les points de traitement. Mobile : offre gratuite avec publicités ou abonnement mensuel. Calculez le coût par document à votre volume réel. Un outil à 300 $/mois qui traite un nombre illimité de documents devient moins cher par page qu'une API « bon marché » par page une fois que vous dépassez 500 pages.
8. Support et communauté
OCR de bureau : support officiel + forums d'utilisateurs. Open source (Tesseract) : forums communautaires, Stack Overflow, issues GitHub. Commercial : support par e-mail/chat, SLA pour les niveaux entreprise. Si vous n'êtes pas technique, les outils open source sans support commercial ont un coût caché à chaque incident.
Pondérez ces dimensions en fonction de vos priorités. Si le coût est votre principale préoccupation, les outils de bureau ou open source peuvent l'emporter sur le prix, même s'ils obtiennent des scores inférieurs en matière de temps de configuration. Si la précision sur les documents manuscrits est essentielle, les outils d'extraction par IA qui utilisent des modèles de langage visuels (qui comprennent le contexte plutôt que de faire correspondre les formes des caractères) obtiendront de meilleurs scores que les moteurs OCR traditionnels, même à un prix plus élevé. Pour les lecteurs ayant un budget serré, notre guide des meilleurs logiciels OCR gratuits couvre les options gratuites avec des compromis de précision honnêtes.
Étape 4 : Testez avec des documents réels
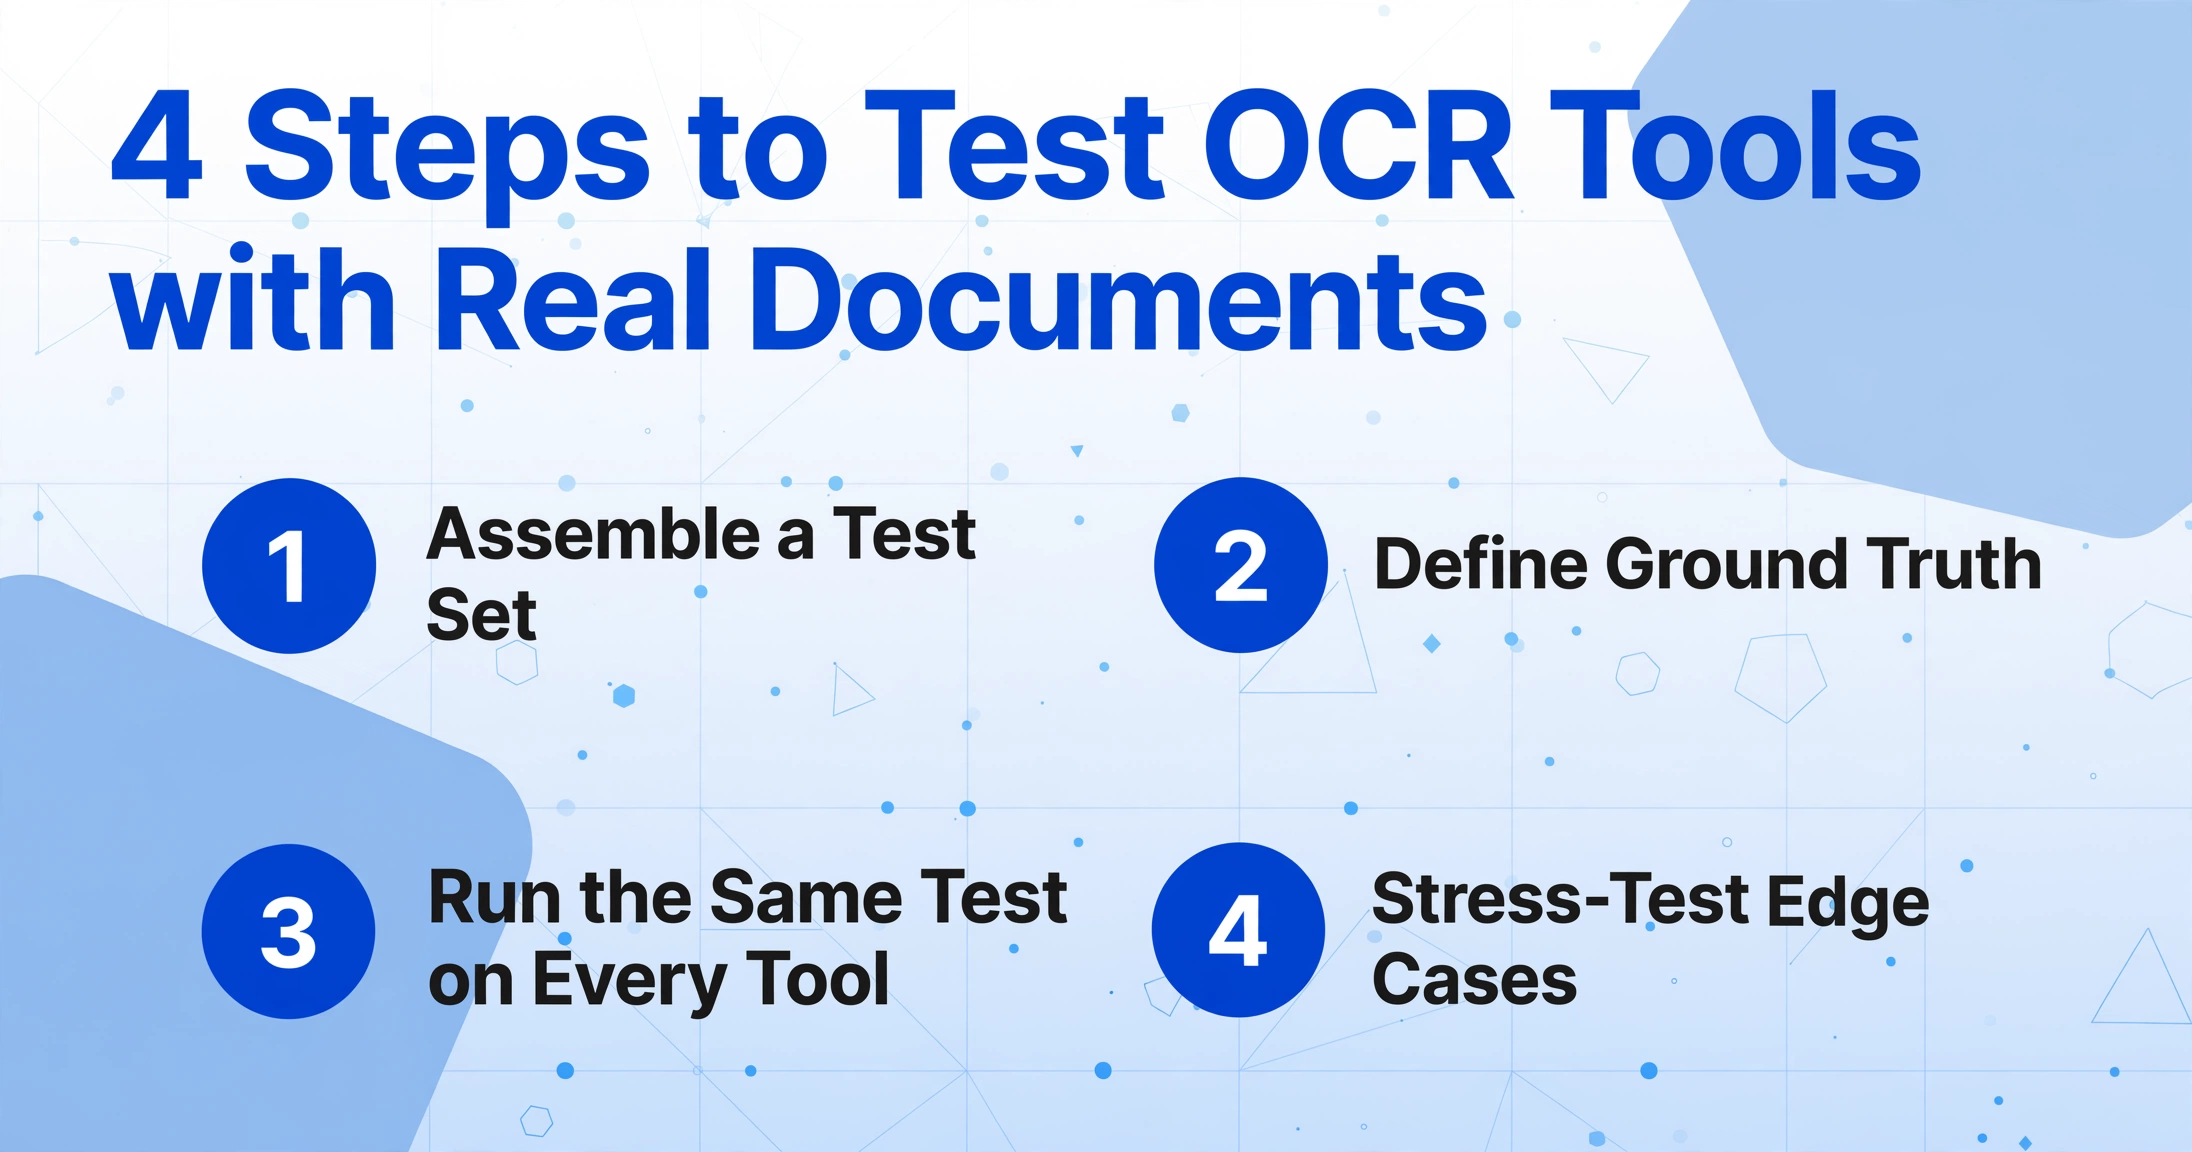
Chaque fournisseur fournit des échantillons de démonstration. L'outil de chaque fournisseur obtient un score de 100 % sur ces échantillons. Tester avec vos propres documents est la seule évaluation qui compte. Voici une méthodologie de test reproductible :
1. Constituez un ensemble de test. Collectez 20 à 50 documents représentatifs de votre mix documentaire réel : les formats courants, les cas limites et quelques-uns de vos fichiers de la plus mauvaise qualité. Incluez au moins 5 documents pour chaque type majeur de votre profil de document de l'étape 1. C'est le même conseil que donnent les services de bibliothèque de Penn State pour les projets OCR : un ensemble de test représentatif est le fondement d'une évaluation fiable.
2. Définissez la vérité terrain. Pour chaque document de test, enregistrez manuellement les champs importants. Pour l'extraction de données — enregistrez le numéro de facture, la date, le total, le nom du fournisseur et les lignes d'article. Pour la reconnaissance de texte — enregistrez un paragraphe représentatif du texte. C'est la référence par rapport à laquelle la sortie de votre outil sera mesurée.
3. Exécutez le même test sur chaque outil. Traitez exactement les mêmes documents avec chaque outil. N'ajustez pas les paramètres par document — testez comme le ferait un nouvel utilisateur. Enregistrez trois chiffres par outil : précision au niveau des caractères (combien de caractères ont été lus correctement), précision au niveau des champs (si vous extrayez des données, combien de champs cibles ont été renvoyés correctement) et temps par document (temps de configuration + temps de traitement, moyennés sur l'ensemble de test).
4. Testez les cas limites sous stress. Passez votre pire document — la photo basse résolution prise sous un mauvais angle — dans chaque outil. Ce seul test révèle souvent quels outils disposent d'un prétraitement d'image robuste et lesquels dépendent d'entrées idéales.
Remarque sur la précision au niveau des champs : Un outil peut lire 99 % des caractères correctement (CER = 1 %) et pourtant renvoyer un total de facture erroné parce qu'il a mal lu un chiffre. Pour les flux de travail axés sur les données, la précision au niveau des champs est la mesure qui détermine si la sortie est utilisable ou nécessite une vérification manuelle de chaque ligne. Chez ImageToTable.ai, la précision au niveau des champs est l'objectif de conception — le système est conçu pour comprendre ce que signifie chaque champ, et pas seulement pour lire des caractères individuels.
5. Évaluez le score de confiance. Les bons outils fournissent un score de confiance par champ ou par document. Cela vous permet de définir des seuils : les documents dont le score est supérieur à 95 % passent directement ; ceux qui sont en dessous nécessitent une vérification manuelle. Le score de confiance transforme efficacement un résultat binaire (réussite/échec) en un système de triage — vous ne vérifiez que la fraction de documents pour laquelle l'outil est incertain, plutôt que chacun d'entre eux.
Étape 5 : Prenez la décision
Vous disposez maintenant des scores de l'étape 3 et des résultats des tests de l'étape 4. Prenez la décision finale en utilisant une approche de notation pondérée :
- Attribuez un poids à chaque dimension d'évaluation de l'étape 3 en fonction de vos priorités. Si la précision est essentielle, pondérez-la à 30 %. Si le coût est prioritaire, pondérez-le à 30 %. Répartissez 100 % sur les dimensions qui comptent le plus pour vous.
- Multipliez le score de l'étape 3 de chaque outil par le poids et additionnez pour obtenir un score pondéré.
- Intégrez les résultats des tests comme une ligne distincte. Un outil qui a bien réussi sur le papier mais qui a échoué sur vos documents réels reçoit une pénalité. Un outil qui vous a surpris par sa précision lors des tests reçoit un bonus.
- Tenez compte des coûts de changement. Si vous utilisez déjà un outil, le coût de la migration des données historiques, de la formation du personnel et de la refonte des intégrations peut compenser les avantages d'un nouvel outil — à moins que l'écart de précision ou de débit ne soit suffisamment important pour justifier la perturbation.
- Planifiez un projet pilote. Choisissez l'outil le mieux noté et menez un projet pilote en conditions réelles pendant deux semaines. Mesurez le temps réellement gagné, le taux d'erreur en production et la satisfaction de l'équipe. Si le projet pilote répond à vos critères de réussite, procédez au déploiement complet. Sinon, passez à votre deuxième choix et répétez le processus.
Ce processus en cinq étapes demande des efforts — et c'est le cas. Mais l'alternative consiste à choisir un outil sur la base d'une liste de fonctionnalités ou d'une seule réunion de démonstration, pour découvrir six mois plus tard qu'il ne gère pas les photos prises avec un téléphone, que sa précision au niveau des champs est trop faible pour votre équipe comptable, ou que la tarification à la page était pertinente à 50 documents par mois mais pas à 500. Consacrer une semaine à une évaluation structurée en amont permet d'éviter des mois de frustration en aval.
Dépannage des problèmes courants
"J'ai choisi un outil d'OCR de bureau, mais j'ai maintenant besoin de données structurées dans un tableur." C'est le scénario de migration le plus courant. Les outils d'OCR de bureau produisent des PDF consultables et du texte modifiable, pas des lignes structurées. Vous pouvez extraire le texte et le formater manuellement, mais cela va à l'encontre du but recherché. La vraie solution consiste à passer à un outil d'extraction par IA qui génère nativement des fichiers Excel ou CSV. Exportez le profil de document de votre ancien outil — les champs que vous copiiez manuellement deviennent vos noms de colonnes dans le nouvel outil.
"Mon volume a doublé. Le palier tarifaire que j'ai choisi n'a plus de sens." Si vous avez opté pour une tarification à la page à faible volume, l'augmentation de l'échelle implique une hausse proportionnelle des coûts. Si vous avez choisi un abonnement à tarif forfaitaire, votre coût par page diminue à mesure que le volume augmente. Révisez votre modèle tarifaire lorsque votre volume change de plus de 50 % — réexécuter l'étape 3 avec de nouveaux chiffres révèle souvent un choix optimal différent.
"L'outil fonctionne sur la plupart des documents mais échoue sur les cas particuliers." Aucun outil ne traite parfaitement tous les documents. Prévoyez un taux d'exceptions manuelles : planifiez 5 à 15 % de documents nécessitant une revue humaine selon l'outil et la qualité de vos documents. La question n'est pas de savoir si des exceptions se produisent, mais si l'outil vous offre un moyen efficace de les gérer — les scores de confiance, les files de revue et la modification au niveau des champs réduisent tous le temps consacré à corriger les erreurs.
"Je dois traiter différents types de documents — un seul outil peut-il tous les gérer ?" Les outils généralistes existent (API cloud, extraction par IA polyvalente) mais ils sacrifient généralement la profondeur à l'étendue. Un outil qui gère correctement les factures, les reçus et les contrats n'égalera pas un outil spécialisé en factures sur la précision des factures. Si vos types de documents sont fondamentalement différents (une lettre nécessite une extraction de texte ; une facture nécessite une extraction de tableau), demandez-vous si vous avez besoin de deux outils plutôt que d'un seul couteau suisse.
Questions fréquemment posées
Quel est le facteur le plus important lors du choix d'un logiciel OCR ?
La correspondance entre le résultat souhaité et la capacité de sortie de l'outil. Si vous avez besoin de données structurées, choisissez un outil conçu pour l'extraction de données. Si vous avez besoin de documents consultables, choisissez un outil conçu pour l'OCR. Acheter un outil de la mauvaise catégorie est l'erreur la plus coûteuse que vous puissiez commettre, quelle que soit sa précision ou son prix.
Combien dois-je dépenser pour un logiciel OCR ?
Pour les particuliers et les petites entreprises, les outils open source gratuits ou les outils payants à moins de 30 $/mois couvrent la plupart des besoins. Pour les équipes traitant plus de 100 documents par semaine, prévoyez 50 à 300 $/mois pour un outil commercial. Pour un déploiement à l'échelle de l'entreprise (plus de 10 000 documents par mois), 500 à 2 000 $/mois est courant. Calculez le coût par document : un outil à 300 $/mois traitant 1 000 documents coûte 0,30 $ par document — moins d'une minute de saisie manuelle de données.
Puis-je utiliser des outils OCR gratuits à des fins professionnelles ?
Oui, avec des réserves. Tesseract est gratuit et open source, sans restriction d'utilisation, mais nécessite des compétences techniques et offre une précision moindre sur les écritures manuscrites, les photos et les mises en page complexes. Les services en ligne gratuits comme l'OCR intégré de Google Drive conviennent à un usage occasionnel, mais n'offrent ni traitement par lots, ni API, ni garantie de confidentialité des données — les documents sont traités sur les serveurs du fournisseur. Pour un usage occasionnel avec des documents propres, les outils gratuits suffisent. Pour un usage professionnel régulier, un outil payant est généralement rentabilisé par le temps gagné.
Quel niveau de précision les outils OCR doivent-ils atteindre pour mon flux de travail ?
Cela dépend de ce que vous faites du résultat. Pour la recherche documentaire (trouver un mot-clé dans un contrat scanné), une précision de 95 % au niveau des caractères suffit — vous trouverez quand même la plupart des documents. Pour la saisie de données dans un système comptable, la précision au niveau des champs doit être de 99 % ou plus — un seul chiffre erroné dans un total de facture crée un problème de rapprochement qui prend plus de temps à corriger que la saisie manuelle n'aurait pris. Des seuils de précision différents selon les cas d'usage signifient que le même outil peut être acceptable pour un flux de travail et inacceptable pour un autre.
Ai-je besoin d'une API ou d'un outil sans code ?
Si vous avez un développeur capable d'intégrer une API à vos systèmes existants (ERP, logiciel comptable, base de données personnalisée), un service OCR basé sur une API offre la plus grande flexibilité et le coût par document le plus bas à grande échelle. Si vous n'êtes pas technique ou si vous avez besoin de résultats immédiats, un outil sans code (OCR de bureau ou extraction par IA avec interface web) apporte de la valeur plus rapidement. De nombreuses équipes commencent avec un outil sans code pour valider le flux de travail, puis migrent vers une API lorsque le volume justifie l'investissement d'intégration.
Comment savoir si l'extraction par IA est meilleure que l'OCR traditionnel pour mon cas d'usage ?
Le facteur déterminant est ce que vous avez besoin que l'outil comprenne. L'OCR traditionnel reconnaît les caractères — il lit chaque lettre mais ne peut pas dire si « 1 250,00 » est le total de la facture ou un sous-total d'article. L'extraction par IA, alimentée par des modèles de langage visuels, comprend la sémantique du document — elle sait faire la différence entre un total et un sous-total parce qu'elle comprend le document comme le ferait une personne. Si vous avez besoin de champs spécifiques extraits dans une feuille de calcul, l'extraction par IA est la bonne catégorie. Si vous avez besoin d'un document converti en texte consultable, l'OCR traditionnel suffit et est généralement moins cher. Notre article sur la précision de l'OCR par IA par rapport à l'OCR traditionnel approfondit les cas où chaque approche est gagnante.
Que faire si l'outil que j'ai choisi ne convient pas ?
Commencez par identifier si le problème vient de la catégorie d'outil (mauvais type de sortie), de l'outil spécifique (mauvaise précision sur vos documents), ou de la mise en œuvre (configuration, intégration, formation). S'il s'agit d'une inadéquation de catégorie d'outil, repartez de l'étape 2. S'il s'agit d'un outil spécifique, les scores pondérés de l'étape 3 vous donnent un deuxième choix clair à évaluer. S'il s'agit de la mise en œuvre, demandez-vous si une intégration ou un support payant résoudrait le problème avant de changer complètement d'outil.
Puis-je tester des outils OCR avant d'acheter ?
Chaque outil OCR réputé propose un essai gratuit ou une offre gratuite. Les outils de bureau offrent généralement des essais de 14 à 30 jours. Les API cloud offrent une offre gratuite (Google Cloud Vision : 1 000 unités par mois, AWS Textract : 1 000 pages par mois pendant 3 mois). Les outils d'extraction par IA comme ImageToTable.ai offrent le traitement gratuit de vos propres fichiers sans exiger de carte de crédit. Utilisez ces essais pour appliquer la méthodologie de test de l'étape 4 avant de vous engager dans un achat. Un fournisseur qui n'offre pas d'essai significatif sur vos propres documents est un fournisseur dont il faut se méfier.
Appliquez le cadre à vos documents
La différence entre un bon achat d'OCR et un mauvais est rarement l'outil lui-même. C'est plutôt le fait que l'acheteur ait pris le temps de répondre à la question qu'est-ce que j'essaie réellement de produire avant de comparer les fonctionnalités. Un outil qui correspond au type de sortie, au mélange de documents et au volume que vous avez réellement vous servira pendant des années. Un outil choisi pour sa liste de fonctionnalités ou son nom de marque vous frustrera en quelques mois.
Les cinq étapes de cet article vous offrent un processus reproductible. Utilisez-le une fois pour votre besoin actuel. Réutilisez-le lorsque vos besoins changent. Et lorsque vous testez de vrais documents avec différentes approches — surtout si des données structurées dans un tableur sont votre objectif — vous verrez rapidement quelle catégorie d'outil produit réellement une sortie utilisable sans des heures de correction.