OCRの速度と精度:
どのベンダーも説明しないトレードオフ
どのOCRベンダーも、自社のツールは「高速」で「正確」だと言います。あたかも、この2つの特性が同じ軸上にあり、自動的に両方を得られるかのように。 現実はその逆です。速度と精度は、ラップトップで動作する無料のオープンソースライブラリから、数千台のGPUを備えたクラウドAPIまで、あらゆるOCRパイプラインにおいて直接的なトレードオフの関係にあります。最大速度向けに設定されたTesseractは、1ページを0.16秒で処理しますが、8語に1語を誤読します。同じページをほぼ完璧な精度で読み取るビジョンAIモデルは、30〜60倍の時間がかかります。あなたのワークフローにはどちらが適しているでしょうか。その答えは、何を処理しているのか、何を構築しているのか、そして1つの誤った数字がもたらすコストによって異なります。ほとんどのベンダーはこの質問を避けます。正直な答えである「場合による」が比較表に収まらないからです。
重要なポイント
- Tesseractは1ページを0.16秒で読み取り、8語に1語を見落とします。その0.16秒という速さが、ドキュメント1件あたり5分の修正作業を生み出しますが、どのベンダーのベンチマークもそれを数えていません。
- OCRベンチマークは、間違ったチェックポイントでレイテンシを測定しています。本当のボトルネックは、エンジンが1ページを読み取る速さではなく、誤読した部分をどれだけ速く修正できるかです。
- ビジョン言語モデルはその曲線を平坦化します。高速だが間違えるエンジンと、低速だが正しいエンジンのどちらかを選ぶ必要はもうありません。1つのエンジンを選び、出力をどこまで信頼するかを調整するだけです。
速度と精度が反比例する理由
速度と精度のトレードオフは、特定のツールの限界ではなく、OCRがアーキテクチャレベルでどのように機能するかの結果です。すべてのOCRシステムは、レガシーなパターンマッチングエンジンであれ、最新のビジョン言語モデルであれ、画像前処理、テキスト検出、文字認識、後処理という一連のステップに従います。各ステップは計算リソースを消費し、各ステップをより徹底的に実行するほど、結果の精度は高くなりますが、時間もかかります。
前処理の深さ。 速度最適化されたOCRパイプラインは、前処理をスキップまたは最小限に抑えます。画像をダウンサンプリングしてピクセル数を減らし、単純な二値化しきい値を適用し、結果を直接認識器に渡します。独立したベンチマークによると、スキュー補正、ノイズ除去、コントラスト強調などの前処理ステップをスキップすると、処理時間を40〜60%削減できますが、不完全な入力では精度も10〜20ポイント低下します。OCR文献全体での標準的な推奨事項(最低300 DPI、適応的二値化、幾何補正)自体が、速度と精度の妥協点です。300 DPIでは、10ptの文字は約42ピクセルに及び、認識器が細かいストロークを区別するのに十分な解像度を提供します。150 DPI未満では、テストされたすべてのエンジンで精度が急激に低下します。300 DPIを超えると、精度の向上は頭打ちになる一方、ファイルサイズと処理時間は増加し続けます。
モデルの複雑さ。 ここでトレードオフが最も顕著になります。Tesseractのレガシーエンジンは手作りの特徴抽出を使用します。事前計算された分類器を使用して、文字形状をテンプレートライブラリと照合します。これは高速(最新のCPUで1ページあたり0.1〜0.3秒)ですが、もろく、スマートフォン写真などの難しい入力では精度が約70〜80%に低下します。Tesseract 4のLSTMエンジンは、シーケンスコンテキストで文字を読み取るニューラルネットワーク層を追加し、ノイズの多いドキュメントでは精度を5〜15ポイント向上させながら、処理時間はほぼ2倍になります。PaddleOCRやEasyOCRなどの最新のディープラーニングOCRエンジンは、パイプライン全体をニューラルネットワーク(CNNベースのテキスト検出とアテンションベースのシーケンス認識)に置き換えます。これらのモデルは、特に複雑なレイアウトや手書き文字で大幅に高い精度を達成しますが、1ページあたり3〜30倍の計算量を必要とします。Codesotaによる2026年3月のベンチマークでは、単一の請求書で次の結果が測定されました。Tesseract 5.5は0.162秒で87.5%の精度、EasyOCRは0.656秒で62.5%の精度、PaddleOCRは4.85秒で100%の精度でした。相関関係は完全ではありません(PaddleOCRはこの特定のテストで優位でした)が、ドキュメントタイプ全体でのパターンは明確です。モデルが深いほど、遅くて正確になる傾向があります。
後処理チェーン。 精度最適化パイプラインは、認識後に検証ステップを追加します。辞書ベースのスペル修正、フィールド間の整合性チェック(請求書の合計は明細項目の合計と一致しますか?)、形式検証(日付は正しく解析されますか?)、および人間が介在するルーティングによる信頼度スコアのしきい値設定です。各ステップはレイテンシを追加します。生のテキストを0.2秒で出力する最小限のOCRでも、本番グレードの精度に達するには、さらに2〜3秒の後処理が必要になる場合があります。実際のスループットを決定するのは、認識ステップだけでなく、システム全体のレイテンシです。
速度の全体像:実際の数値はどうなっているのか
生の処理速度は、OCRエンジン、ハードウェア、文書の複雑さによって2桁の範囲で変動します。以下の表は、複数の独立した情報源から公開されているベンチマークを、実際の本番環境の条件を反映した範囲にまとめたものです。都合の良い最良ケースの実行結果だけを抜粋したものではありません。
| エンジン / API | 速度(1ページあたり、CPU) | 速度(GPU) | 精度(鮮明な印刷物) | 精度(困難な条件) |
|---|---|---|---|---|
| Tesseract 5.5(レガシーモード) | 0.1〜0.3秒 | なし(CPUのみ) | 90〜96% | 50〜70% |
| Tesseract 5.5(LSTMモード) | 0.3〜0.8秒 | なし(CPUのみ) | 93〜97% | 60〜80% |
| EasyOCR | 0.6〜2.5秒 | 0.2〜0.8秒 | 90〜95% | 55〜75% |
| Google Cloud Vision OCR | 1〜3秒(API) | — | 96〜99% | 75〜85% |
| AWS Textract | 2〜4秒(API) | — | 95〜98% | 78〜85% |
| Azure Document Intelligence | 3〜5秒(API) | — | 96〜99% | 80〜88% |
| PaddleOCR | 3〜6秒 | 約0.5秒(毎分120ページ) | 95〜99% | 75〜88% |
| 視覚言語モデル(VLM) | 5〜15秒 | 2〜6秒 | 96〜99% | 85〜95% |
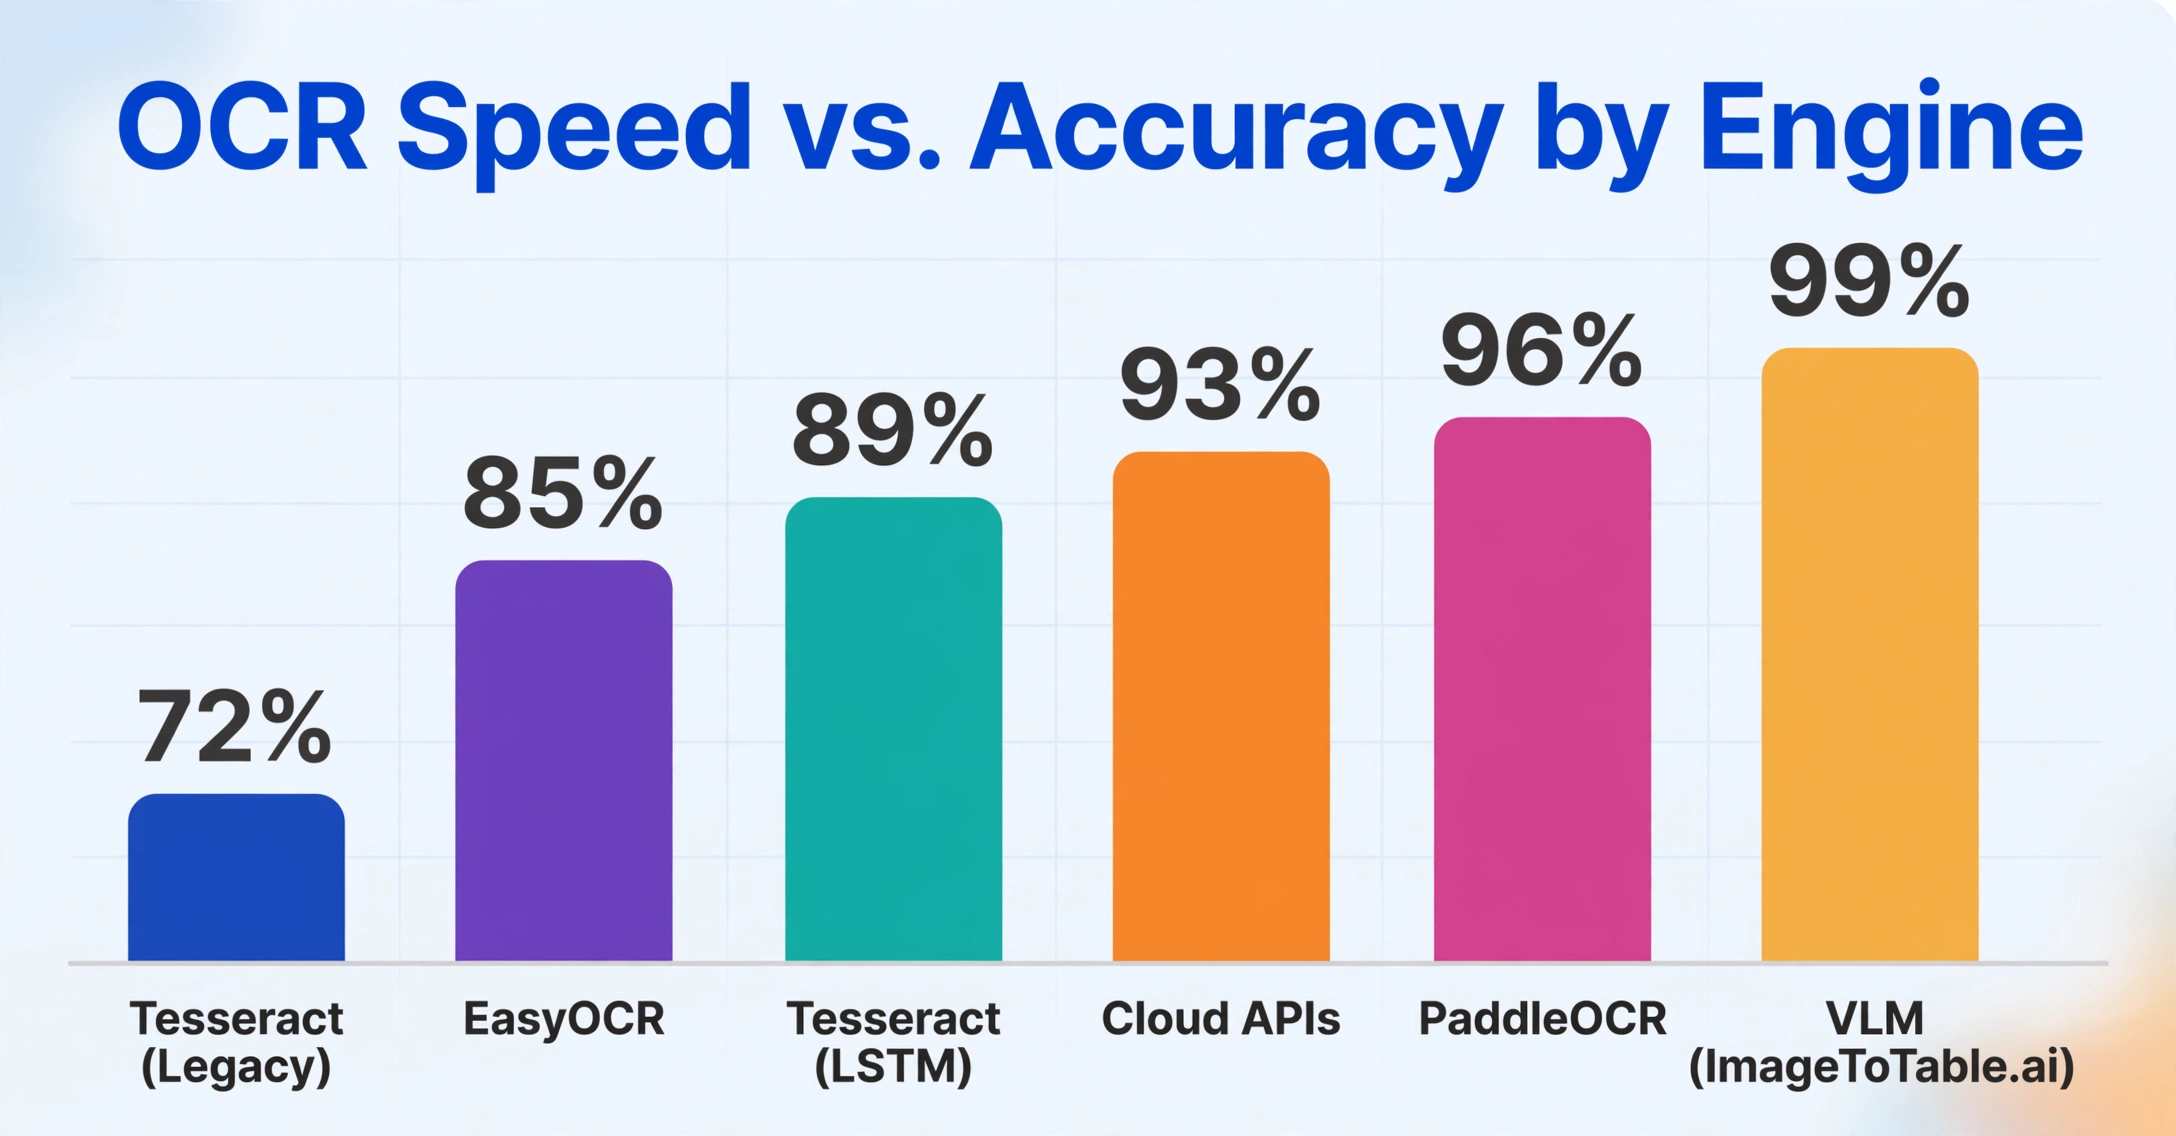
出典:Codesota(2026年3月)、AIMultiple DeltOCR Bench(2026年1月)、GigaGPU PaddleOCRベンチマーク、AWS/Azure/Google公式ドキュメント。「困難な条件」には、低解像度のスキャン、スマートフォンでの撮影、複雑なレイアウトの文書が含まれます。VLMカテゴリは、ImageToTable.aiやQwen-VLなどのツールを表します。
これらの数値から得られる重要な洞察:速度と精度の関係は滑らかな曲線ではありません。そこには変曲点があります。Tesseractは速度を提供しますが、不完全な文書では精度に硬い上限があります。クラウドAPIは、中程度のレイテンシでより高い上限を提供します。VLMは上限を最も高く押し上げますが、1ページあたりの時間が最もかかります。どれを選ぶかは、あなたの文書とエラーに対する許容度が、どの変曲点に位置するかを知ることを意味します。
実際の要点: Tesseractは、人間がまばたきするのと同じ時間で請求書を処理します。しかし、その請求書がしわくちゃの業者領収書のスマホ写真であれば、0.16秒の抽出には20〜30%のエラー率が発生する可能性があります。そして、会計システムでそれらのエラーを修正するには、文書ごとに数分かかります。高速な抽出が、後工程の遅い作業を生み出すのです。
速度がより重要になる場合
すべての文書ワークフローがフィールドレベルの完璧さを必要とするわけではありません。いくつかの実際のシナリオでは、文字レベルの精度よりもスループットを優先するのが正しい選択です。そして、「99%の精度」だけを宣伝するベンダーは、これらのケースを認識せずにユーザーに不利益をもたらしています。
リアルタイムのPOSスキャン。 小売店のチェックアウトシステムがレシートをスキャンして価格を調べたり返品を検証したりする場合、1秒以内に回答が必要です。OCRが商品名の1文字を誤読しても、在庫システムがファジーマッチングで正しいSKUを見つけられれば、取引は中断なく完了します。速度が制約条件であり、システムは1時間に数百件の取引を処理するため、スキャンごとに3秒余分にかかるとレジに行列ができてしまいます。このようなシナリオでは、Tesseractのレガシーモードや、タイムアウトを厳しく設定した軽量なクラウドAPIが正しい選択です。たとえ2〜5%の文字エラー率を受け入れることになってもです。
文書のトリアージとルーティング。 多くの文書処理パイプラインでは、受信した文書を分類して(これは請求書か、発注書か、納品書か?)から、正しい後続プロセッサにルーティングする必要があります。分類ステップでは、文書タイプを識別するのに十分なテキストだけを抽出する必要があります。通常はヘッダー、タイトル、またはいくつかの主要フィールドであり、ページ上のすべての文字ではありません。1ページあたり0.2秒で文書タイプの95%を正しく識別する高速なOCRパスは、1ページあたり5秒で98%を正しく識別する低速なOCRパスよりも価値があります。誤分類された3%は人間によるレビュー段階で捕捉できるからです。Google Cloud Vision OCRは、1〜3秒のレイテンシーと幅広い言語サポートを備えており、このルーティング層で一般的に選択されています。
検索可能なテキストを伴う大量アーカイブ。 目標が文書管理システムで何百万ページもの文書を検索可能にすることであり、特定のデータフィールドを抽出することではない場合、精度のしきい値は低くなります。文字精度90%のTesseract生成検索可能PDFでも、ユーザーはキーワード検索でほとんどの文書を見つけることができます。「Invoice #12345」を含む文書は、Tesseractが一部のページで「Invoice #1234S」と読んでも見つかるからです。高速なOCRパイプライン(1台のサーバーで1時間に数千ページ)と低速なパイプライン(1時間に数百ページ)のコスト差が、アーカイブプロジェクトが実現可能かどうかを決定します。
バッテリー制約のあるデバイスでのモバイルOCR。 スマートフォンやハンドヘルドスキャナーでディープラーニングOCRモデルを実行するには、精度とバッテリー消費・発熱のバランスを取る必要があります。最新のスマートフォンでのEasyOCRは、GPUアクセラレーション使用時に画像あたり約0.2〜0.8秒かかりますが、その代償としてかなりの電力消費があります。1シフトで数百枚のラベルをスキャンする現場作業者にとっては、精度を5%犠牲にしてバッテリー寿命を2倍にする軽量モデルの方が、運用上の正しい選択です。
精度が最優先されるべき場合
上記のすべてのシナリオに共通する特徴は、単一のエラーのコストが低いか、容易に吸収できることです。その前提を覆すと、トレードオフは完全に逆転します。
税務および財務書類。 VAT申告書、W-2の賃金欄、または請求書の合計額における1桁の誤読は、連鎖的な問題を引き起こします。OCRが$1,500の請求書合計額を$15,000と誤読すると、支払いエラーが発生し、照合、ベンダーへの問い合わせ、場合によっては修正された税務申告が必要になります。2025年のGennai分析によると、94%の精度で500件の請求書を処理するシステム(30件にエラー)では、バッチあたり5時間の修正作業が発生しましたが、99%の精度で400件の請求書を処理するシステム(4件にエラー)では、クリーンアップにわずか40分しかかかりませんでした。ページあたりの処理速度は遅くても、後者のシステムの方が1時間あたりの有効な出力という点で生産的でした。特に税務書類に関しては、IRSおよびほとんどの税務当局は、報告された数値に対して100%の正確さを期待しています。「ほぼ正確」では不十分です。年次税務申告書の単一のフィールドエラーは、監査、罰金、および利息を引き起こす可能性があり、そのコストは処理コストの削減額をはるかに上回ります。
法的契約書およびコンプライアンス文書。 コンプライアンス監視、リース契約の要約、または規制当局への提出のための契約データ抽出は、精度が絶対条件となる領域です。1か月ずれた契約更新日、誤って分類された免責条項、または$500,000を$5,000,000と誤読した責任限度額は、処理速度の速さでは正当化できない法的エクスポージャーを生み出します。これらの文書には、信頼度スコアリングと、低信頼度フィールドの必須の人的レビューを備えた精度最適化抽出が適切なアプローチです。文書全体を文脈で読み取り、条項の構造と意味的関係を解釈できるビジョン言語モデルは、ページあたり10〜15秒かかっても、ここでは標準になりつつあります。なぜなら、単一の抽出エラーが抽出ツールの年間予算全体を超える可能性があるからです。
医療請求および患者データ。 医療文書の抽出は、精度要件と規制上の制約が交差する領域にあります。CMS-1500請求書のCPTコードの誤読は、請求の拒否、支払いの遅延、または最悪の場合、患者の記録に誤った処置が請求されることにつながります。HIPAAコンプライアンスには、精度と監査可能性の両方が必要です。医療文書抽出の標準は、抽出されたすべての値をソース文書上の位置まで完全にトレース可能な、フィールドレベルで98%を超える精度です。速度は二の次です。誤って提出された請求は、遅れて提出された請求よりも高くつきます。
通貨間および国際取引。 通貨、小数点の表記法、数値形式が混在する文書は、速度最適化されたOCRに対して特に厳しいものです。米国の小数点表記法でトレーニングされたシステムが「€ 1.234,56」(1,234.56ユーロ)と表示されたヨーロッパの請求書を処理すると、金額を€1.23と誤読する可能性があります。これは1,000倍のエラーです。多言語および多形式の文書における精度低下はよく知られており、これらの形式固有のエラーを修正するには、国際的な形式でトレーニングされたモデルか、レイテンシーを追加する後処理検証ルールのいずれかが必要です。この領域では、形式エラーのコストは文字エラー率に比例しないため、精度が優先されなければなりません。小数点が1つずれるだけで、取引が破綻する可能性があります。
簡単な目安:出力結果の1つのフィールドを人間が再確認するのに30秒以上かかり、かつ週に200枚以上の文書を処理しているなら、精度を優先しましょう。エラーが減ることで節約できる確認時間は、抽出速度の低下を十分に補います。同じフィールドの確認に5秒未満しかかからず、エラーがすぐに明らかになる場合は、速度を優先しましょう。
実践的な判断フレームワーク
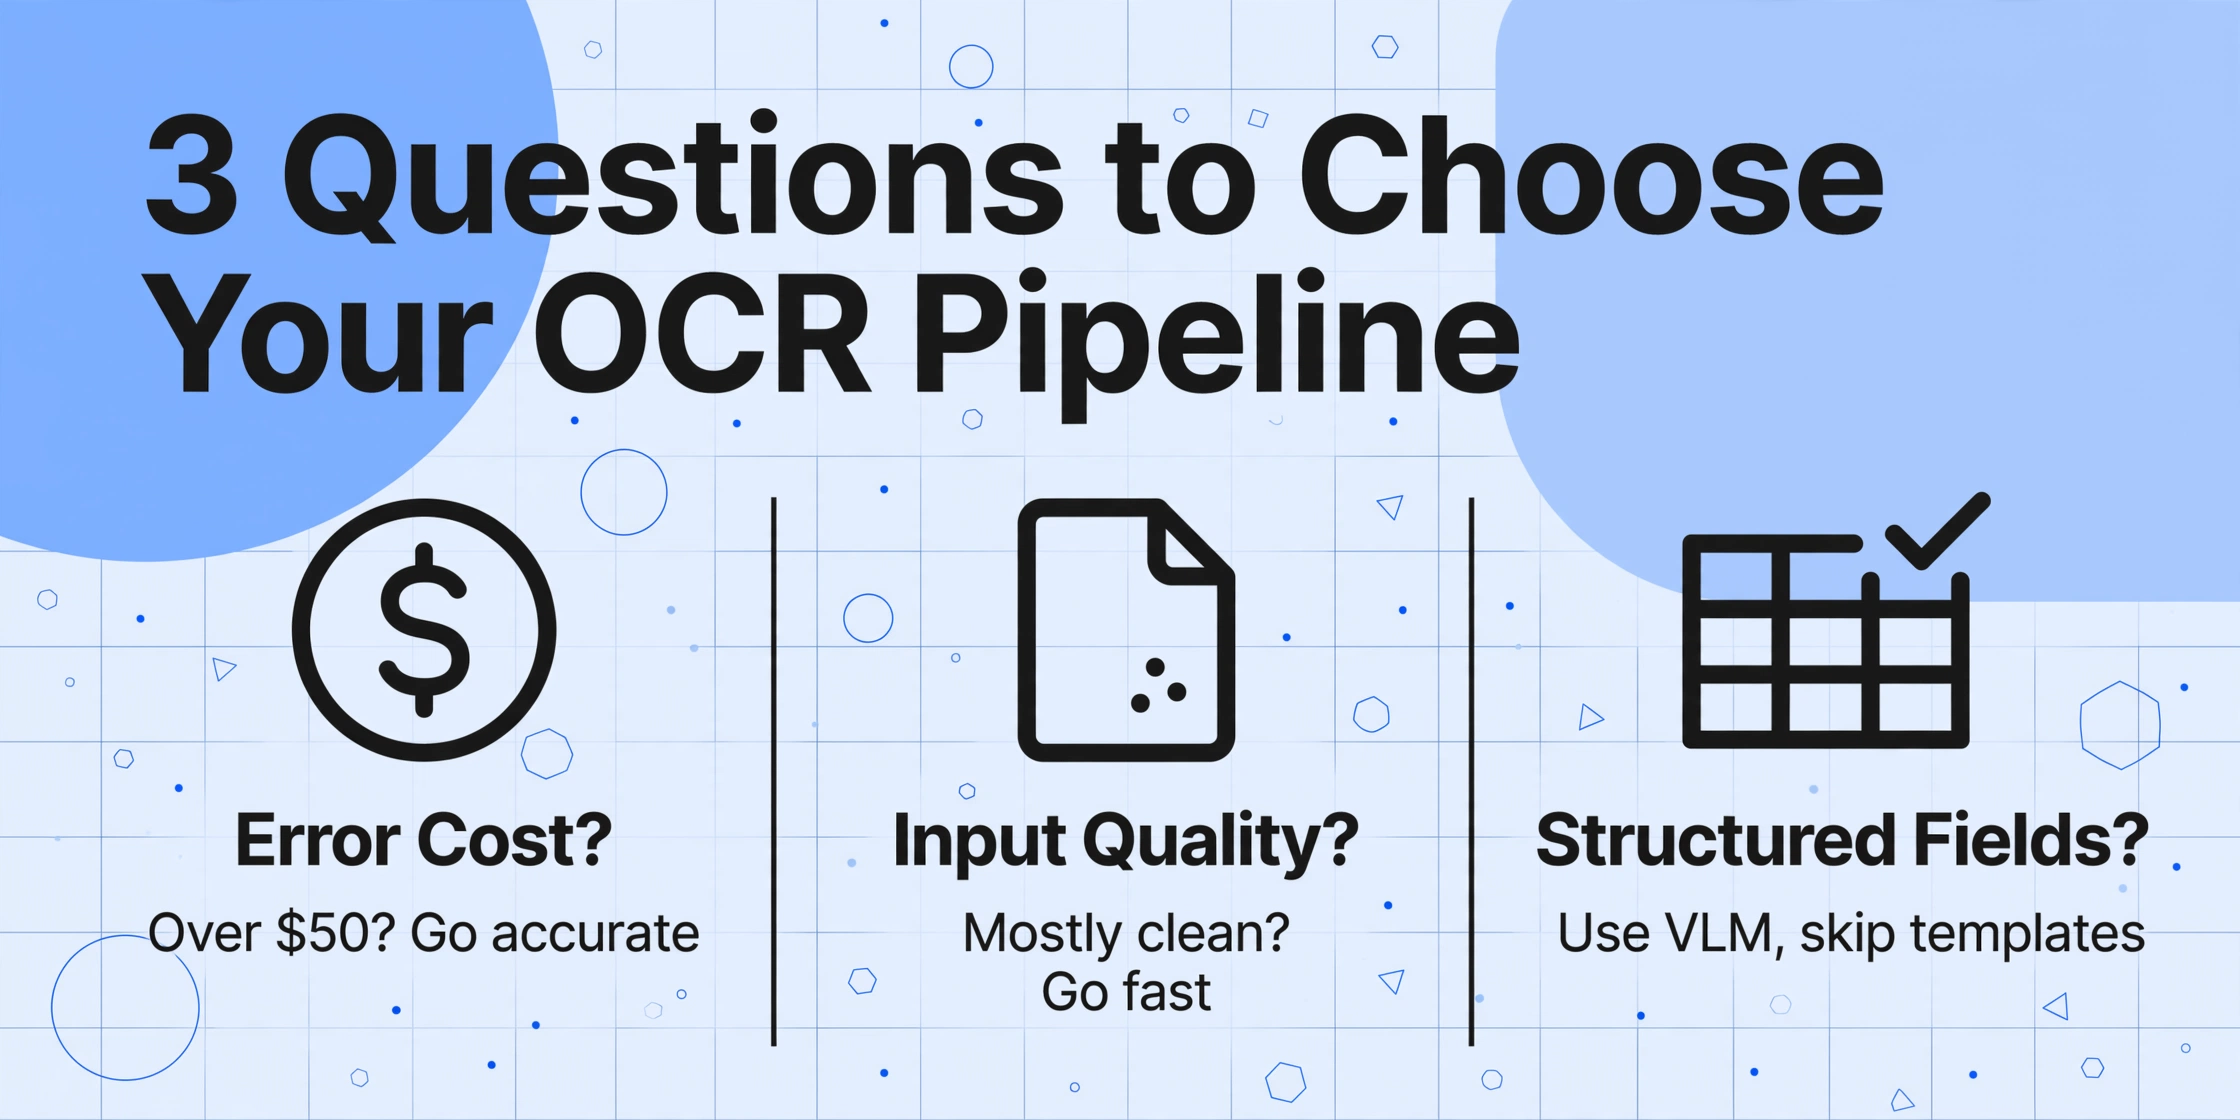
「どのOCRツールが最適か」と問うのではなく、あなたのワークフローについて次の3つの質問を順に考えてみてください。
ワークフローにおいて、1回の抽出エラーがもたらすコストはいくらですか?
1つのフィールドの誤読が、修正、後続プロセスの遅延、コンプライアンスリスクにおいて50ドル以上のコストになる場合は、精度を最適化したパイプラインから始め、スループットが遅くなることを受け入れましょう。エラーがすぐに発見され、修正コストが低い場合は、速度優先のパイプラインが適切です。
入力文書の品質分布はどのような状態ですか?
文書の90%が標準フォントのきれいな印刷PDFであれば、LSTMモードのTesseractで1ページあたり0.3秒の処理で十分でしょう。残りの10%のエッジケースのみ、より遅くても高精度なフォールバックシステムで処理すれば済みます。一方、大半がくしゃくしゃの感熱レシートをスマートフォンで撮影した写真のような場合は、画質劣化に強いモデルから始める必要があります。つまり、1ページあたりの処理速度が遅くなることを受け入れる必要があります。
構造化されたフィールド抽出が必要ですか、それとも生のテキストだけで十分ですか?
任意の形式から特定のフィールド(請求書の合計額、発注番号、税務ID)を抽出するには、意味理解が必要です。このタスクでは、従来のOCRの速度面での優位性は消えます。なぜなら、フィールドを特定・検証するための後処理が、認識速度に関係なくレイテンシを追加するからです。ここで、テンプレート不要のVLMベース抽出ツールであるImageToTable.aiが状況を変えます。従来のパイプラインを遅くするテンプレートの設定とメンテナンスを排除し、1ページあたり5〜10秒の処理でも、ワークフロー全体の時間では正味で高速になるのです。
このフレームワークをフィルターとして適用します。質問1が精度を示し、質問2で入力品質が不均一であると確認できた場合は、速度優先のツールを完全にスキップし、多様な文書に対応した精度重視のプラットフォームに直接進んでください。質問1が速度を示し、質問2でクリーンで均一な入力を確認できた場合は、Tesseractや高速なクラウドAPIを基盤とした軽量パイプラインが正しい選択です。多くのチームが犯す間違いは、これらの質問を順番に評価しないことです。彼らはまず速度でツールをベンチマークし、後になって精度要件がパイプラインの再構築を強いることに気づきます。
視覚言語モデルが状況をどう変えるか
これまで説明してきた速度と精度のトレードオフは、従来のOCRアーキテクチャに当てはまるものです。これらのエンジンは、文書の読み取りを順次的な独立したステップ(検出→認識→後処理)に分解します。視覚言語モデル(VLM)は、この問題に異なるアプローチを取ります。文書を単一の視覚シーンとして読み取り、レイアウト、テキスト、フィールドの関係性を統合された1回のパスで理解します。実際的な結果として、VLMは従来のOCRと同じ速度と精度のトレードオフ曲線に直面しません。
Tesseractの精度が難しい入力(例えば手書き文字で50〜70%)で急落するのに対し、VLMの精度は緩やかに低下します。クリーンな印刷テキストで96%、中程度の手書き文字で85〜90%、最悪のケースで約75〜80%です。崖のような急落はありません。EasyOCRが複雑な文書で許容可能な速度に達するためにGPUアクセラレーションを必要とするのに対し、CPU上で動作するVLMでも実用的な結果を生成できます。速度は遅くなりますが、前処理をスキップしたときに従来のOCRが見せる急激な精度低下はありません。
これにより、意思決定のフレームワークが変わります。ImageToTable.aiのようなVLMベースのツールでは、速度と精度のトレードオフはもはや「速いが間違っている」か「遅いが正しい」かの二者択一ではありません。代わりに、同じモデルが両方のシナリオに対応します。1枚の請求書を5〜10秒で処理し、フィールドレベルの精度95%超を達成することも、50枚の請求書をバッチ処理して低信頼度の出力のみをレビューすることもできます。文書品質を問わないモデルの一貫性、つまり精度の崖がないことが、これを可能にしています。高速トリアージ用と高精度抽出用に2つの異なるエンジンを選ぶのではなく、1つのエンジンを選んでレビューのしきい値を調整するのです。
2026年にOCRソリューションを評価するチームにとって、重要な変化はこれです。速度と精度のトレードオフは依然として現実のものですが、その曲線は平坦化しています。視覚言語モデルに基づくツールは、あらゆる速度ポイントで従来のOCRアーキテクチャが達成できるよりも高い精度の下限を提供します。問題はもはや「速度と引き換えにどれだけの精度を犠牲にするか」ではなく、「必要な精度を達成するために、パイプラインはどれだけのレイテンシーを許容できるか」です。そして、ほとんどの文書ワークフローにとって、その答えはあなたが考えている以上に大きいのです。
よくある質問
Q: 本番の文書抽出にTesseractを使用できますか、それとも精度が低すぎますか?
文書の種類と許容できるエラー率によります。標準フォントのきれいな機械印字PDFを300 DPIで処理する場合、Tesseract 5.5のLSTMモードは93〜97%の文字精度を達成します。これは、偶発的なタイプミスが致命的でない多くの内部ワークフローに十分です。レシートのスマホ写真、スキャンしたカーボンコピー、手書き文書では精度が50〜80%に低下し、手動レビューの負担が大きいため、本番使用には低すぎる可能性があります。オープンソースツールの詳細な比較については、オープンソースOCRツールのガイドをご覧ください。
Q: AWS TextractとGoogle Cloud Vision OCRではどちらが高速ですか?
どちらも同期モードでは通常1ページあたり2〜4秒で処理し、Googleは単純な文書ではわずかに高速(1〜3秒)、Textractも同等の2〜4秒です。バッチ/非同期モードでは、両サービスとも1時間あたり数百ページを処理できます。大きな違いは速度ではなく精度プロファイルです。Google Visionは多言語文書やノイズの多い画像に優れ、Textractはフォームとテーブルの抽出に強みがあります。クラウドOCR APIの直接比較については、Best OCR API 2026ガイドをご覧ください。
Q: 同じOCRツールで「高精度」モードは「高速」モードよりどのくらい遅いですか?
TesseractのLSTMモードは、同じ文書でレガシーモードより約2〜5倍遅く、1ページあたり0.3〜0.8秒(レガシーは0.1〜0.3秒)です。ABBYY FineReaderの「高精度」モードは「高速」モードより約2〜2.5倍遅くなります。精度の向上は、難しい文書で通常5〜10ポイントです。一部のツールの「超高精度」モードは複数のエンジンを並列実行して最良の結果を採用するため、処理時間がエンジン数倍になります。収穫逓減に関するCVISIONの分析がここでも当てはまります。エラー率を半分にするには、約2倍の処理時間が必要です。
Q: GPUアクセラレーションで速度と精度のトレードオフは解消されますか?
ギャップは大幅に縮まりますが、完全には解消されません。RTX 3090 GPU上のPaddleOCRは毎分約120ページを処理します。これはCPU速度の約5倍、TesseractのCPUのみのスループットの約5倍で、同じ精度を維持します。GPUアクセラレーションにより、チームは軽量エンジンに匹敵する速度でディープラーニングOCRモデルを実行でき、事実上、速度と精度の両方を得られます。ただし、GPUコスト、クラウド環境での可用性、エッジデバイスでの消費電力は依然として制約です。すべてのワークフローでGPUが利用できるわけではありません。
Q: 複数のベンダーから異なる形式の請求書を処理する場合、速度と精度のどちらを優先すべきですか?
精度です。複数ベンダーの請求書処理における主な課題は読み取り速度ではなく、形式の多様性です。テンプレートベースのOCRツールが各請求書を0.5秒で処理できても、ベンダーごとのレイアウトに個別のテンプレートが必要であれば、テンプレートのメンテナンスに実際の処理よりもはるかに多くの時間を費やすことになります。テンプレート不要のVLMベースのツールは各請求書の処理に5〜10秒かかりますが、セットアップ不要でどんな形式にも対応できるため、ワークフロー全体の時間では高速です。特にベンダー数が増えるほどその差は顕著になります。マルチフォーマットのワークフローにおいて、文字レベルの速度よりもフィールドレベルの精度が重要である理由については、OCR精度の実際の意味に関するガイドをご覧ください。
Q: トリアージ用の高速OCRと抽出用の高精度OCRを組み合わせたハイブリッドアプローチは、いつ使用すべきですか?
ハイブリッドパイプラインは、文書の品質分布が二峰性の場合に有効です。大量のクリーンで標準化された文書(高速パスで十分)と、少量の複雑または劣化した文書(精度重視の処理が必要)が混在しているケースです。Tesseractや軽量クラウドOCRによる文書トリアージは、各入来文書を「クリーン」または「困難」に分類し、クリーンな文書は高速抽出パイプラインへ、困難な文書はVLMまたは人間によるレビューへ振り分けます。これは、大規模サプライヤーからの電子請求書と小規模ベンダーからの紙の請求書の両方を処理する企業のAP部門で一般的なパターンです。注意点は、ルーティングロジック自体が非常に正確でなければならないことです。そうでなければ、困難な文書が高速パイプラインにすり抜けてエラーが発生する可能性があります。
トレードオフを意図的に設定する
OCRにおける速度と精度のトレードオフは、解決すべき問題ではなく、意図的に設定すべき設計パラメータです。文書処理ワークフローにはそれぞれ、正しいバランスポイントが存在します。ベンダーのデフォルト設定や単一のベンチマーク数値に判断を委ねてしまうのが誤りです。
多くのチームは評価時に速度を過大評価します。速度は測定が簡単(1つの数値、1回の実行、1つのタイマー)ですが、精度は文書の種類、品質、フィールド、エラー定義によって変わるため測定が難しいからです。誠実な評価プロセスでは、実際に処理する文書(不完全なものも含む)で精度をベンチマークし、OCRのレイテンシーだけでなくワークフロー全体の時間を測定します。その全体時間にはエラー修正にかかる時間も含まれており、そこで「高速な」OCRの利点は失われます。
ビジョン言語モデルは精度の曲線を平坦化し、ほとんどの業務文書ワークフローにおいて、許容可能な速度で高い精度を実現できるようにしました。精度が制約条件である場合(そしてほとんどの文書抽出ユースケースではそうあるべきです)、1ページを5〜10秒で処理し、フィールドレベルの精度が95%を超えるVLMベースのツールは、同じページを0.2秒で処理するものの、5番目ごとの値を検証する必要があるツールよりも優れた選択肢です。
実際の文書でトレードオフをテストしてください。かつて数分かけて見つけていたエラーがもはや存在しないとき、1ページあたり5秒がどのように見えるかを確認してください。