Velocidad del OCR frente a precisión:
La disyuntiva que ningún proveedor explica
Todos los proveedores de OCR le dicen que su herramienta es "rápida" y "precisa", como si ambas cualidades existieran en el mismo eje y usted obtuviera ambas automáticamente. La realidad es lo contrario: la velocidad y la precisión están en tensión directa en cada canalización de OCR, desde una biblioteca gratuita de código abierto que se ejecuta en una computadora portátil hasta una API en la nube respaldada por miles de GPU. Una instancia de Tesseract configurada para máxima velocidad procesa una página en 0,16 segundos, pero lee mal 1 de cada 8 palabras. Un modelo de IA de visión que lee la misma página con una precisión casi perfecta tarda entre 30 y 60 veces más. ¿Cuál es el adecuado para su flujo de trabajo? La respuesta depende de lo que esté procesando, de lo que esté creando y de cuánto le cueste un solo dígito erróneo. La mayoría de los proveedores omiten esa pregunta porque la respuesta honesta — «depende» — no cabe en una tabla comparativa.
Conclusiones clave
- Tesseract lee una página en 0,16 segundos y omite 1 de cada 8 palabras: esa velocidad de 0,16 segundos genera cinco minutos de trabajo de corrección por documento, y ningún proveedor cuenta esa métrica en sus referencias.
- Las referencias de OCR miden la latencia en el punto de control equivocado: el verdadero cuello de botella no es la rapidez con que el motor lee una página, sino la rapidez con que usted corrige lo que leyó mal.
- Los modelos de visión y lenguaje aplanan la curva: ya no elige entre un motor rápido pero incorrecto y uno lento pero correcto; elige un solo motor y ajusta cuánto confía en el resultado.
Por qué la velocidad y la precisión están inversamente relacionadas
La relación inversa entre velocidad y precisión no es una limitación de ninguna herramienta en particular — es una consecuencia de cómo funciona el OCR a nivel arquitectónico. Todo sistema de OCR, ya sea un motor heredado de coincidencia de patrones o un modelo moderno de visión-lenguaje, sigue una secuencia de pasos: preprocesamiento de imagen, detección de texto, reconocimiento de caracteres y posprocesamiento. Cada paso consume recursos computacionales, y cuanto más a fondo se ejecuta cada paso, más preciso es el resultado — y más tiempo lleva.
Profundidad del preprocesamiento. Un pipeline de OCR optimizado para velocidad omite o minimiza el preprocesamiento: reduce la resolución de la imagen para disminuir el número de píxeles, aplica un umbral de binarización simple y pasa el resultado directamente al reconocedor. Pruebas comparativas independientes muestran que omitir pasos de preprocesamiento como la corrección de inclinación, la eliminación de ruido y el realce de contraste puede reducir el tiempo de procesamiento en un 40–60% — pero también reduce la precisión en 10–20 puntos porcentuales en entradas imperfectas. La recomendación estándar en la literatura de OCR — mínimo 300 DPI, binarización adaptativa, corrección geométrica — es en sí misma un compromiso entre velocidad y precisión. A 300 DPI, un carácter de 10pt abarca aproximadamente 42 píxeles, lo que le da al reconocedor suficiente resolución para distinguir trazos finos. Por debajo de 150 DPI, la precisión cae drásticamente en todos los motores probados. Por encima de 300 DPI, las ganancias de precisión se estabilizan mientras que el tamaño del archivo y el tiempo de procesamiento siguen aumentando.
Complejidad del modelo. Aquí es donde la relación inversa se hace más visible. El motor heredado de Tesseract utiliza extracción de características artesanal — compara formas de caracteres contra una biblioteca de plantillas usando clasificadores precomputados. Esto es rápido (0.1–0.3 segundos por página en una CPU moderna) pero frágil: la precisión en entradas difíciles como fotos de teléfonos móviles cae a aproximadamente 70–80%. El motor LSTM de Tesseract 4 añade una capa de red neuronal que lee caracteres en contexto secuencial, mejorando la precisión en 5–15 puntos porcentuales en documentos ruidosos mientras que aproximadamente duplica el tiempo de procesamiento. Los motores modernos de OCR de aprendizaje profundo como PaddleOCR y EasyOCR reemplazan todo el pipeline con redes neuronales — detección de texto basada en CNN seguida de reconocimiento de secuencias basado en atención. Estos modelos logran una precisión sustancialmente mayor (especialmente en diseños complejos y escritura a mano) pero requieren de 3 a 30 veces más cómputo por página. Un benchmark de marzo de 2026 realizado por Codesota midió lo siguiente en una sola factura: Tesseract 5.5 a 0.162 segundos con 87.5% de precisión, EasyOCR a 0.656 segundos con 62.5% de precisión, y PaddleOCR a 4.85 segundos con 100% de precisión. La correlación no es perfecta — PaddleOCR dominó en esta prueba específica — pero el patrón en todos los tipos de documentos es claro: cuanto más profundo es el modelo, más lento y más preciso tiende a ser.
Cadena de posprocesamiento. Los pipelines optimizados para precisión añaden pasos de validación después del reconocimiento: corrección ortográfica basada en diccionarios, comprobaciones de consistencia entre campos (¿el total de la factura coincide con la suma de las partidas?), validación de formato (¿la fecha se parsea correctamente?) y umbralización de puntuaciones de confianza con enrutamiento humano en el circuito. Cada paso añade latencia. Un OCR básico que produce texto sin procesar en 0.2 segundos puede requerir 2–3 segundos adicionales de posprocesamiento para alcanzar una precisión de grado de producción. La latencia total del sistema — no solo el paso de reconocimiento — es lo que determina el rendimiento en el mundo real.
El panorama de velocidad: cómo se ven realmente las cifras
La velocidad de procesamiento bruta varía en dos órdenes de magnitud según el motor de OCR, el hardware y la complejidad del documento. La tabla siguiente resume los puntos de referencia publicados de múltiples fuentes independientes en rangos que reflejan las condiciones reales de producción, no ejecuciones seleccionadas de mejor caso.
| Motor / API | Velocidad (por página, CPU) | Velocidad (GPU) | Precisión (impresión limpia) | Precisión (con desafíos) |
|---|---|---|---|---|
| Tesseract 5.5 (modo heredado) | 0.1–0.3s | N/D (solo CPU) | 90–96% | 50–70% |
| Tesseract 5.5 (modo LSTM) | 0.3–0.8s | N/D (solo CPU) | 93–97% | 60–80% |
| EasyOCR | 0.6–2.5s | 0.2–0.8s | 90–95% | 55–75% |
| Google Cloud Vision OCR | 1–3s (API) | — | 96–99% | 75–85% |
| AWS Textract | 2–4s (API) | — | 95–98% | 78–85% |
| Azure Document Intelligence | 3–5s (API) | — | 96–99% | 80–88% |
| PaddleOCR | 3–6s | ~0.5s (120 páginas/min) | 95–99% | 75–88% |
| Modelo de visión-lenguaje (VLM) | 5–15s | 2–6s | 96–99% | 85–95% |
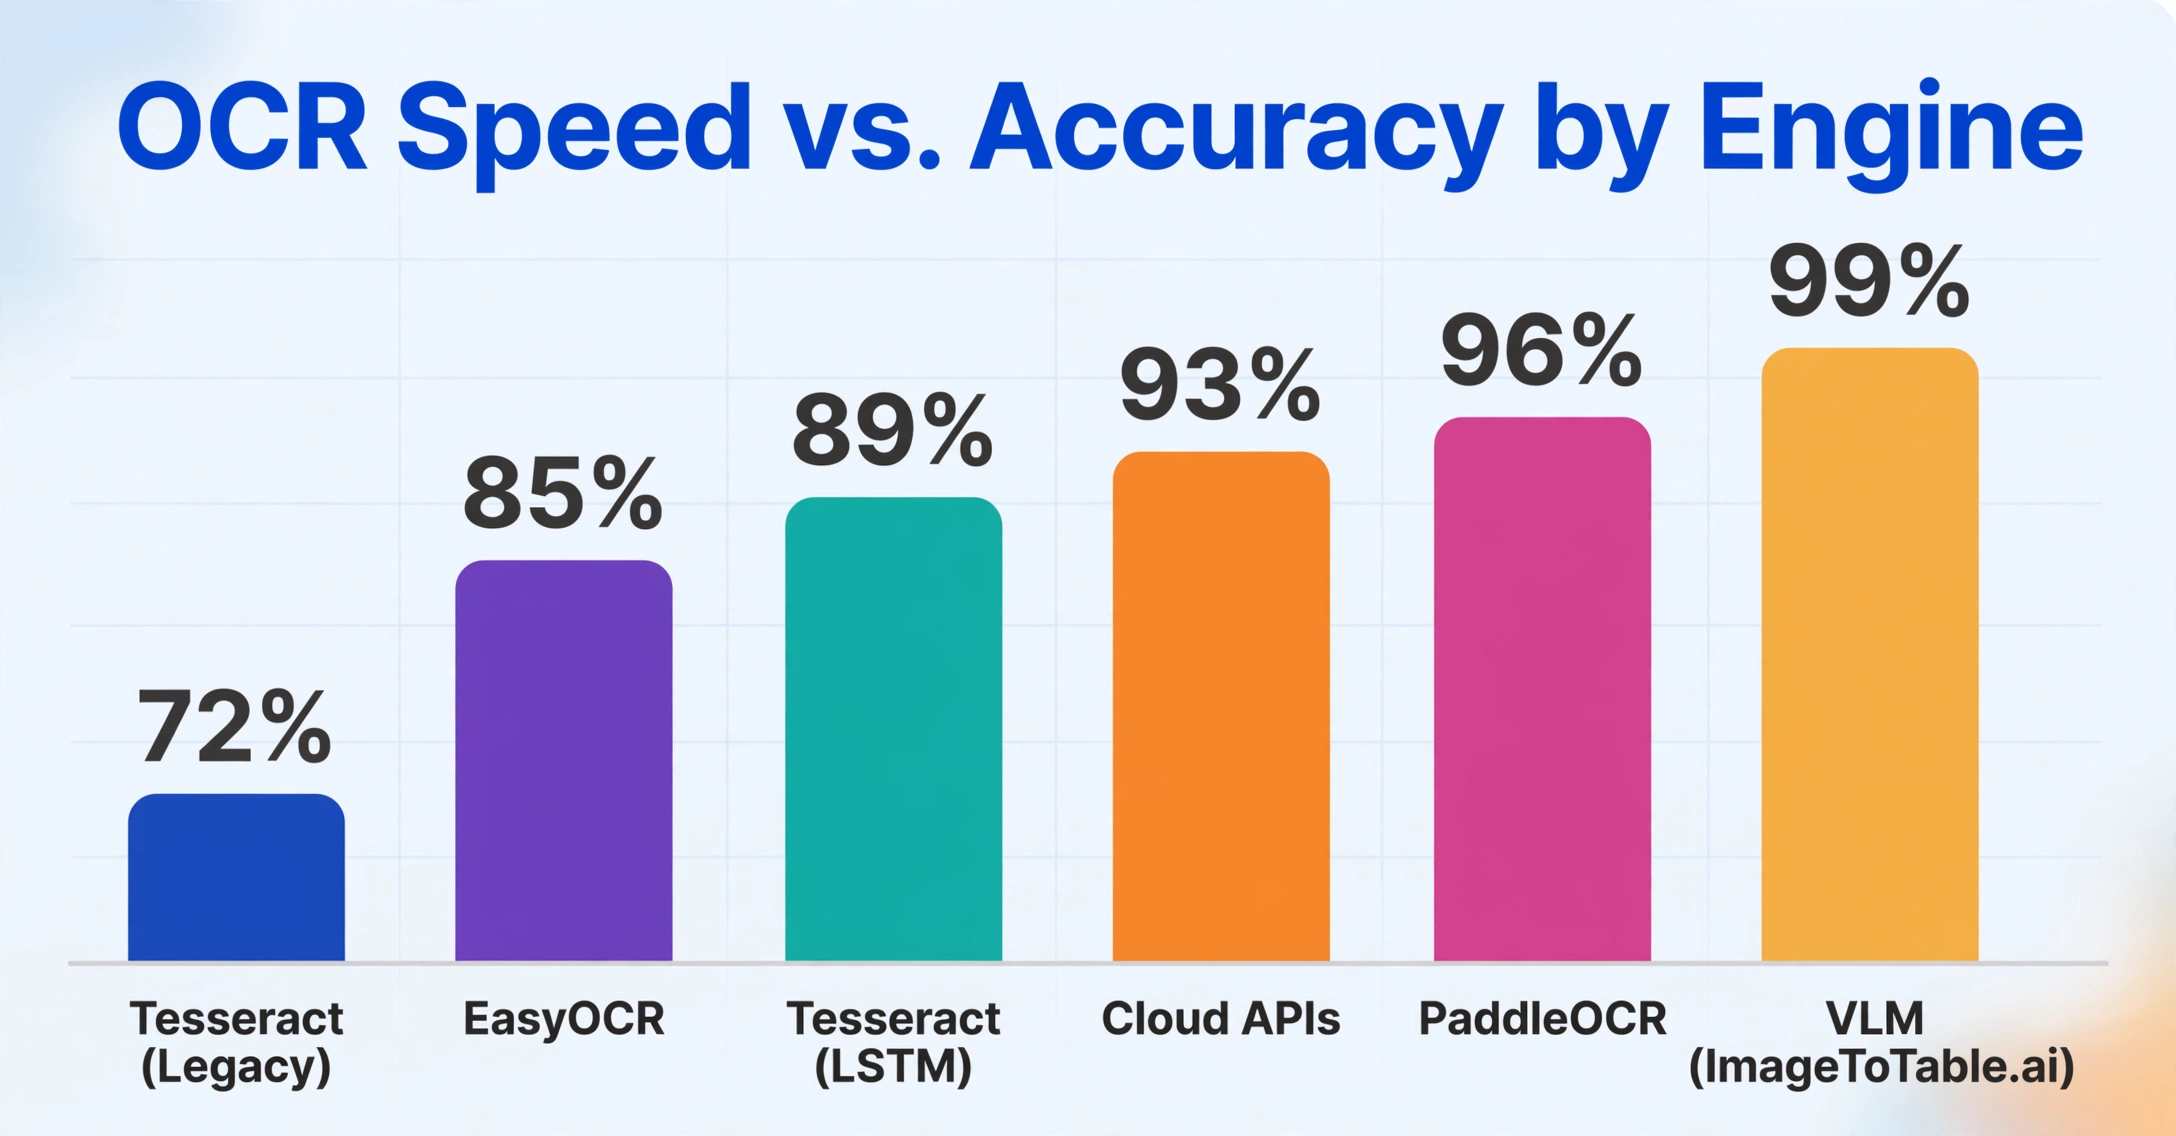
Fuentes: Codesota (marzo de 2026), AIMultiple DeltOCR Bench (enero de 2026), punto de referencia GigaGPU PaddleOCR, documentación oficial de AWS/Azure/Google. "Con desafíos" incluye escaneos de baja resolución, fotos tomadas con teléfonos móviles y documentos con diseños mixtos. La categoría VLM representa herramientas como ImageToTable.ai y Qwen-VL.
La conclusión clave de estas cifras: la relación entre velocidad y precisión no es una curva suave. Tiene puntos de inflexión. Tesseract le ofrece velocidad, pero alcanza un techo de precisión difícil en documentos imperfectos. Las API en la nube ofrecen un techo más alto con una latencia moderada. Los VLM elevan el techo al máximo, pero requieren más tiempo por página. Elegir entre ellos significa saber en qué punto de inflexión se encuentran sus documentos y su tolerancia a los errores.
La conclusión práctica: Tesseract procesa una factura en el tiempo que tarda un humano en parpadear. Pero si esa factura es una foto de teléfono de un recibo arrugado de un contratista, la extracción de 0,16 segundos puede tener una tasa de error del 20–30% — y corregir esos errores en su sistema de contabilidad toma minutos por documento. La extracción rápida crea trabajo lento aguas abajo.
Cuando la Velocidad Importa Más
No todos los flujos de trabajo de documentos requieren perfección a nivel de campo. Varios escenarios del mundo real priorizan correctamente el rendimiento sobre la precisión a nivel de carácter — y los proveedores que solo comercializan "99% de precisión" están perjudicando a sus usuarios al no reconocer estos casos.
Escaneo en punto de venta en tiempo real. Un sistema de caja minorista que escanea un recibo para consultar un precio o validar una devolución necesita una respuesta en menos de un segundo. Si el OCR lee mal un carácter en el nombre de un producto pero el sistema de inventario aún encuentra el SKU correcto mediante coincidencia difusa, la transacción se completa sin interrupción. La velocidad es la restricción vinculante; el sistema procesa cientos de transacciones por hora y 3 segundos adicionales por escaneo crearían una cola en la caja. Para estos escenarios, el modo heredado de Tesseract o una API ligera en la nube con tiempos de espera agresivos es la opción correcta — incluso si eso significa aceptar una tasa de error de caracteres del 2–5%.
Clasificación y enrutamiento de documentos. Muchos pipelines de procesamiento de documentos necesitan clasificar un documento entrante (¿es una factura, una orden de compra o un albarán?) antes de enrutarlo al procesador downstream correcto. El paso de clasificación requiere extraer solo el texto suficiente para identificar el tipo de documento — típicamente el encabezado, el título o algunos campos clave — no cada carácter de la página. Una pasada OCR rápida que identifica correctamente el 95% de los tipos de documento en 0,2 segundos por página es más valiosa que una pasada OCR lenta que identifica correctamente el 98% en 5 segundos por página, porque el 3% mal clasificado puede detectarse en la etapa de revisión humana. Google Cloud Vision OCR, con su latencia de 1–3 segundos y amplio soporte de idiomas, es una opción común para esta capa de enrutamiento.
Archivo de alto volumen con texto buscable. Cuando el objetivo es hacer buscables millones de páginas en un sistema de gestión documental — en lugar de extraer campos de datos específicos — el umbral de precisión es más bajo. Un PDF buscable generado por Tesseract con 90% de precisión de caracteres aún permite a los usuarios encontrar la mayoría de los documentos mediante búsqueda por palabras clave, porque un documento que contiene "Factura #12345" aún se encontrará incluso si Tesseract lee "Factura #1234S" en algunas páginas. La diferencia de costo entre un pipeline OCR rápido (miles de páginas por hora en un solo servidor) y uno lento (cientos de páginas por hora) determina si el proyecto de archivo es viable en absoluto.
OCR móvil en dispositivos con batería limitada. Ejecutar un modelo OCR de aprendizaje profundo en un teléfono inteligente o escáner portátil requiere equilibrar la precisión contra el consumo de batería y el calor. EasyOCR en un teléfono inteligente moderno toma aproximadamente 0,2–0,8 segundos por imagen cuando está acelerado por GPU, pero a costa de un consumo de energía significativo. Para trabajadores de campo que escanean cientos de etiquetas por turno, un modelo más ligero que sacrifica un 5% de precisión para duplicar la duración de la batería es la decisión operativa correcta.
Cuando la precisión debe imponerse
Cada uno de los escenarios anteriores comparte una característica: el costo de un solo error es bajo o fácilmente absorbible. Invierta esa suposición y la ecuación se revierte por completo.
Documentos fiscales y financieros. Un solo dígito mal leído en una declaración de IVA, en un campo salarial de un W-2 o en el total de una factura genera un problema en cascada. El total de factura de $1,500 que el OCR lee como $15,000 provoca un error de pago que requiere conciliación, seguimiento con el proveedor y posiblemente una declaración fiscal corregida. Un análisis de Gennai de 2025 calculó que un sistema que procesa 500 facturas con un 94% de precisión (30 facturas con errores) generaba 5 horas de trabajo de corrección por lote, mientras que un sistema que procesa 400 facturas con un 99% de precisión (4 con errores) generaba solo 40 minutos de limpieza — a pesar de la tasa más lenta por página. El sistema más lento era más productivo en términos de salida útil por hora. Para documentos fiscales específicamente, el IRS y la mayoría de las autoridades tributarias esperan un 100% de precisión en las cifras reportadas — no "casi exacto". Un solo error de campo en una declaración fiscal anual puede desencadenar una auditoría, sanciones y cargos por intereses que eclipsan cualquier ahorro en costos de procesamiento.
Contratos legales y documentos de cumplimiento. La extracción de datos de contratos para monitoreo de cumplimiento, abstracción de arrendamientos o presentaciones regulatorias es el ámbito donde la precisión no es negociable. Una fecha de renovación de contrato desfasada por un mes, una cláusula de indemnización mal clasificada o un límite de responsabilidad leído como $500,000 en lugar de $5,000,000 crea una exposición legal que ninguna velocidad de procesamiento justifica. Para estos documentos, el enfoque correcto es la extracción optimizada para precisión con puntuación de confianza y revisión humana obligatoria de cualquier campo de baja confianza. Los modelos de visión-lenguaje — que leen el documento completo en contexto y pueden interpretar la estructura de cláusulas y las relaciones semánticas — son cada vez más el estándar aquí, incluso a 10–15 segundos por página, porque el costo de un solo error de extracción puede superar el presupuesto anual completo de la herramienta de extracción.
Facturación médica y datos de pacientes. La extracción de documentos de salud se sitúa en la intersección de los requisitos de precisión y las restricciones regulatorias. Un código CPT mal leído en un formulario de reclamación CMS-1500 puede resultar en denegación de la reclamación, retraso en el pago o — en el peor caso — un procedimiento incorrecto facturado al registro del paciente. El cumplimiento de HIPAA exige tanto precisión como auditabilidad. El estándar en la extracción de documentos médicos es una precisión a nivel de campo superior al 98% con trazabilidad completa de cada valor extraído hasta su posición en el documento fuente. La velocidad es secundaria; una reclamación enviada incorrectamente es más costosa que una reclamación enviada tarde.
Transacciones multidivisa e internacionales. Los documentos que combinan divisas, convenciones decimales y formatos numéricos son particularmente implacables con el OCR optimizado para velocidad. Una factura europea que muestra "€ 1.234,56" (1.234,56 EUR) procesada por un sistema entrenado con convenciones decimales estadounidenses puede malinterpretar el importe como €1,23 — un error de 1.000x. La caída de precisión en documentos multilingües y multiformato está bien documentada, y corregir estos errores específicos de formato requiere ya sea un modelo entrenado con formatos internacionales o reglas de validación de posprocesamiento que añaden latencia. En este ámbito, la precisión debe imponerse porque el costo de un error de formato no es proporcional a la tasa de error por carácter — un punto decimal mal colocado puede arruinar una transacción.
Regla práctica rápida: Si una persona tarda más de 30 segundos en revisar un solo campo de su resultado y procesa más de 200 documentos por semana, optimice para precisión: el tiempo de revisión ahorrado gracias a menos errores compensará con creces la velocidad de extracción más lenta. Si revisar el mismo campo toma menos de 5 segundos y los errores son evidentes de inmediato, optimice para velocidad.
Un Marco de Decisión Práctico
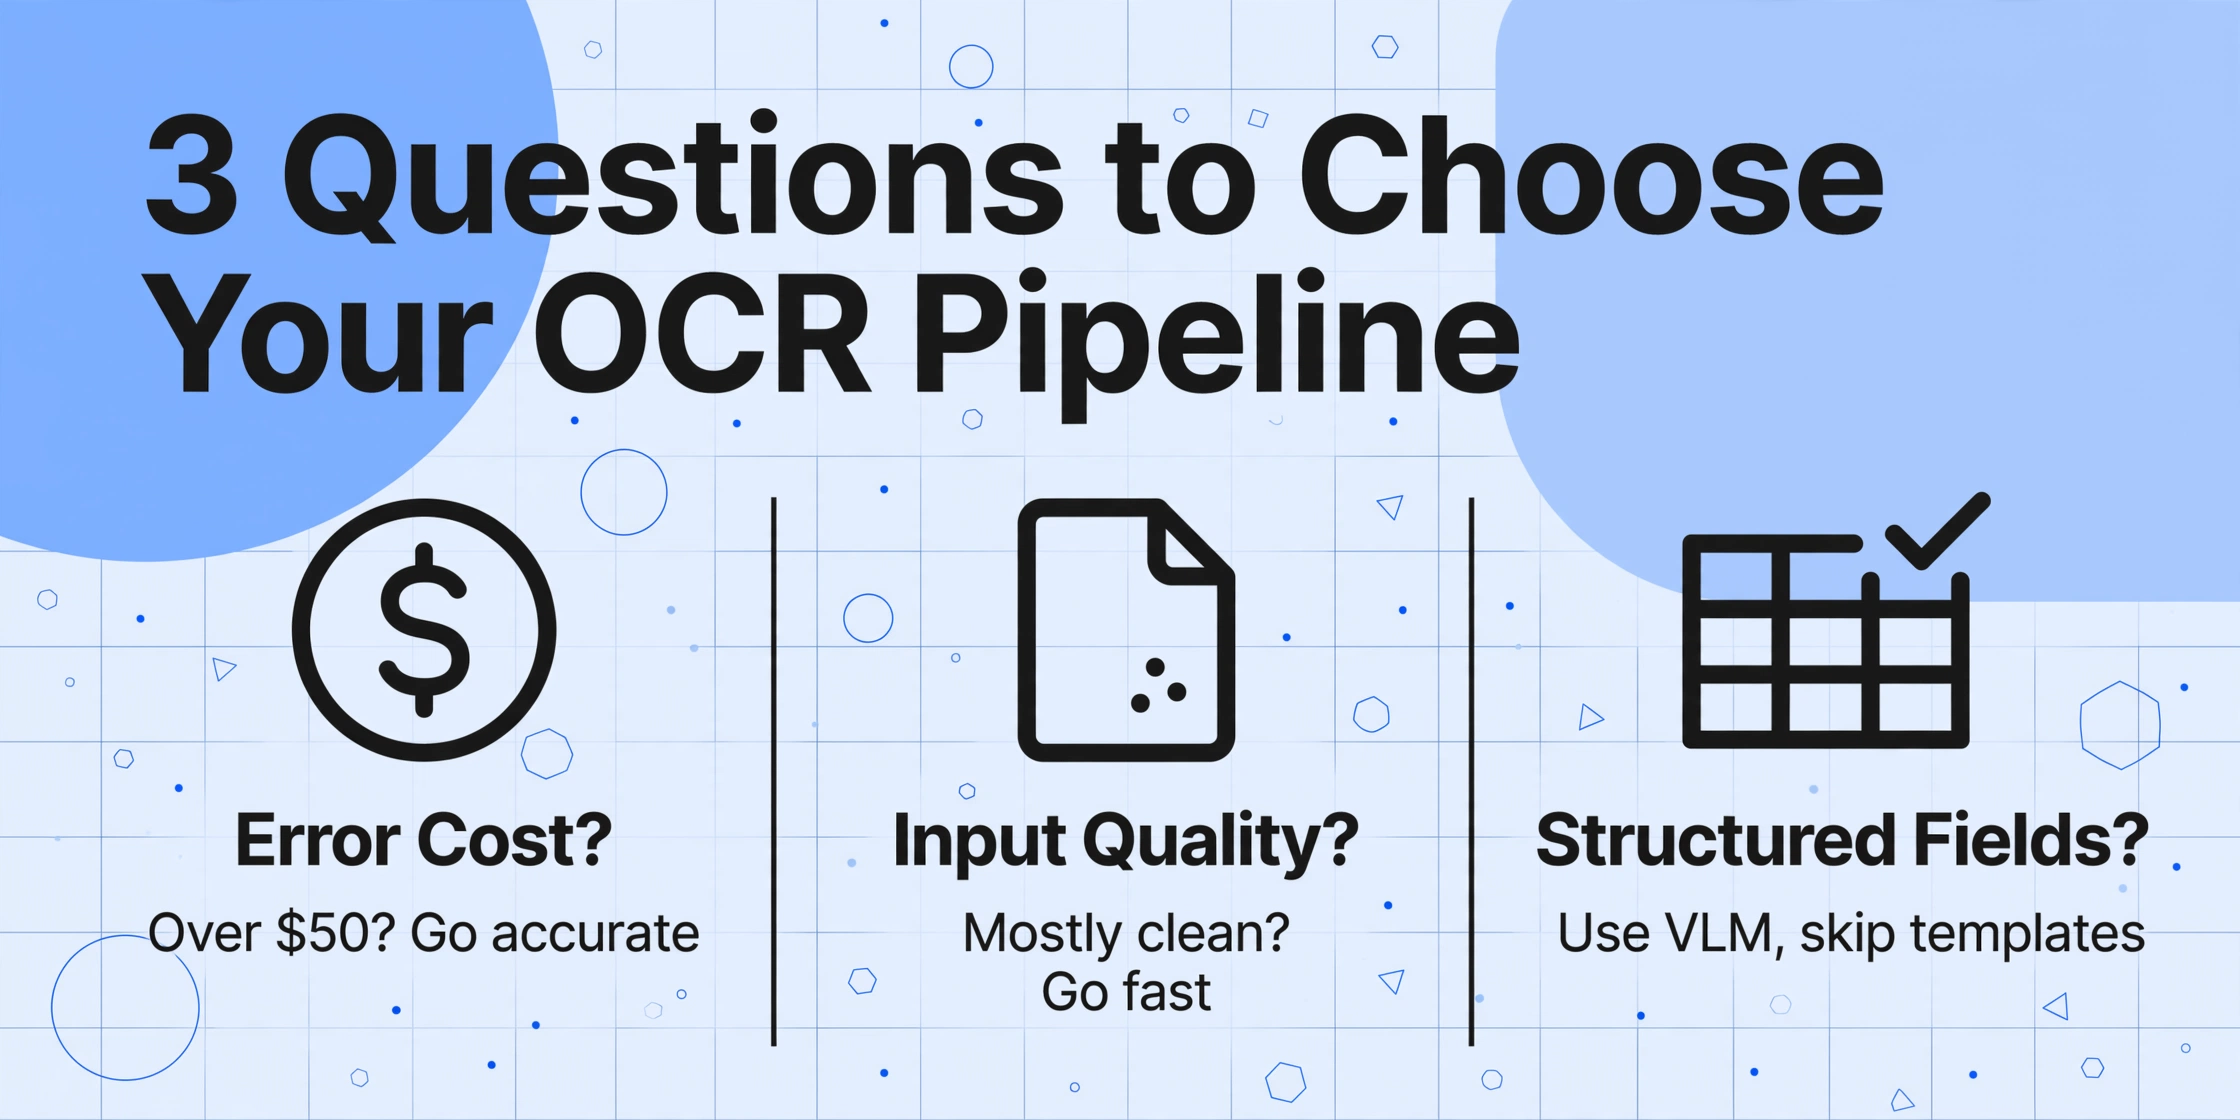
En lugar de preguntarse "cuál es la mejor herramienta de OCR", hágase estas tres preguntas sobre su flujo de trabajo, en orden:
¿Cuál es el costo de un solo error de extracción en su flujo de trabajo?
Si un campo mal leído cuesta más de $50 en correcciones, retrasos posteriores o riesgo de cumplimiento, comience con un pipeline optimizado para precisión y acepte un rendimiento más lento. Si los errores se detectan rápidamente y cuestan poco corregirlos, un pipeline que priorice la velocidad es lo adecuado.
¿Cuál es la distribución de calidad de sus documentos de entrada?
Si el 90% de sus documentos son PDF impresos limpios con fuentes estándar — Tesseract en modo LSTM a 0,3 segundos por página probablemente sea suficiente, y solo necesita manejar el 10% restante de casos límite con un sistema de respaldo más lento y preciso. Si la mayoría son fotos de teléfono móvil de recibos térmicos arrugados, comience con un modelo que maneje bien la degradación — lo que implica aceptar una velocidad por página más lenta.
¿Necesita extracción de campos estructurados o solo texto sin formato?
Extraer campos específicos (total de factura, número de orden de compra, ID fiscal) de formatos arbitrarios requiere comprensión semántica — una tarea donde las ventajas de velocidad del OCR tradicional desaparecen porque el posprocesamiento necesario para identificar y validar campos añade latencia independientemente de la velocidad de reconocimiento. Aquí es donde las herramientas de extracción sin plantilla basadas en VLM como ImageToTable.ai cambian la ecuación: eliminan la configuración y el mantenimiento de plantillas que ralentizan los pipelines tradicionales, haciendo que su procesamiento de 5 a 10 segundos por página sea netamente más rápido en el tiempo total del flujo de trabajo.
Aplique este marco como filtro: si la Pregunta 1 apunta a la precisión y la Pregunta 2 confirma que tiene calidad de entrada heterogénea, omita por completo las herramientas orientadas a la velocidad y vaya directamente a una plataforma diseñada para la precisión en documentos diversos. Si la Pregunta 1 apunta a la velocidad y la Pregunta 2 confirma una entrada limpia y uniforme, un pipeline ligero basado en Tesseract o una API en la nube rápida es la decisión correcta. El error que cometen la mayoría de los equipos es no evaluar estas preguntas en orden: primero comparan herramientas por velocidad y luego descubren que sus requisitos de precisión los obligan a reconstruir el pipeline.
Cómo los Modelos de Visión y Lenguaje Cambian la Ecuación
La compensación entre velocidad y precisión descrita hasta ahora se aplica a las arquitecturas OCR tradicionales: motores que dividen la lectura de documentos en pasos secuenciales e independientes (detección → reconocimiento → postprocesamiento). Los modelos de visión y lenguaje (VLM) abordan el problema de manera diferente: leen el documento como una única escena visual, comprendiendo el diseño, el texto y las relaciones entre campos en una sola pasada integrada. La consecuencia práctica es que los VLM no enfrentan la misma curva de compensación entre velocidad y precisión que el OCR tradicional.
Donde la precisión de Tesseract se desploma con entradas difíciles (50–70% en escritura a mano, por ejemplo), la precisión de un VLM se degrada gradualmente: de 96% en texto impreso limpio a 85–90% en escritura a mano moderada y aproximadamente 75–80% en el peor caso. No hay un precipicio. Donde EasyOCR requiere aceleración por GPU para alcanzar velocidades aceptables en documentos complejos, un VLM que se ejecuta en CPU aún puede producir resultados utilizables: más lento, pero sin la fuerte caída de precisión que exhibe el OCR tradicional cuando se omite el preprocesamiento.
Esto cambia el marco de decisión. Con una herramienta basada en VLM como ImageToTable.ai, la compensación entre velocidad y precisión ya no es una elección binaria entre "rápido e incorrecto" o "lento y correcto". En cambio, el mismo modelo sirve para ambos escenarios: puede procesar una sola factura en 5–10 segundos con precisión a nivel de campo superior al 95%, o procesar 50 facturas en lote y revisar solo las salidas de baja confianza. La consistencia del modelo entre calidades de documentos —la ausencia de precipicios de precisión— es lo que hace esto posible. No está eligiendo entre dos motores diferentes para triaje de alta velocidad y extracción de alta precisión; está eligiendo un motor y ajustando el umbral de revisión.
Para los equipos que evalúan soluciones OCR en 2026, el cambio importante es este: la compensación entre velocidad y precisión sigue siendo real, pero la curva se ha aplanado. Las herramientas basadas en modelos de visión y lenguaje ofrecen un piso de precisión más alto en cada punto de velocidad que las arquitecturas OCR tradicionales pueden igualar. La pregunta ya no es "¿cuánta precisión estoy dispuesto a sacrificar por velocidad?" sino "¿cuánta latencia puede tolerar mi pipeline para lograr la precisión que necesito?" — y la respuesta, para la mayoría de los flujos de trabajo documentales, es más de lo que cree.
Preguntas Frecuentes
P: ¿Puedo usar Tesseract para la extracción de documentos en producción, o es demasiado impreciso?
Depende de sus documentos y de su tolerancia al error. En PDFs impresos limpios, con fuentes estándar a 300 DPI, Tesseract 5.5 en modo LSTM ofrece una precisión de caracteres del 93–97 %, suficiente para muchos flujos de trabajo internos donde un error tipográfico ocasional no es catastrófico. En fotos de recibos tomadas con el móvil, copias carbón escaneadas o documentos con escritura a mano, la precisión cae al 50–80 %, lo que probablemente sea demasiado bajo para uso en producción sin una revisión manual significativa. Para una comparación detallada de herramientas de código abierto, consulte nuestra guía de herramientas de OCR de código abierto.
P: ¿Cuál es más rápido: AWS Textract o Google Cloud Vision OCR?
Ambos suelen procesar una página en 2–4 segundos en modo síncrono; Google es ligeramente más rápido en documentos simples (1–3 segundos) y Textract es comparable (2–4 segundos). En modo lote/asíncrono, ambos servicios pueden procesar cientos de páginas por hora. La mayor diferencia no es la velocidad, sino el perfil de precisión: Google Vision destaca en documentos multilingües e imágenes ruidosas, mientras que Textract tiene una extracción de formularios y tablas más sólida. Para una comparación directa de las API de OCR en la nube, consulte nuestra guía Best OCR API 2026.
P: ¿Cuánto más lento es el modo «preciso» frente al modo «rápido» en la misma herramienta de OCR?
El modo LSTM de Tesseract es aproximadamente 2–5 veces más lento que el modo heredado en el mismo documento: 0,3–0,8 segundos por página frente a 0,1–0,3 segundos. El modo «preciso» de ABBYY FineReader es unas 2–2,5 veces más lento que el modo «rápido». La ganancia de precisión suele ser de 5 a 10 puntos porcentuales en documentos difíciles. Algunos modos «superprecisos» ejecutan varios motores en paralelo y toman el mejor resultado, multiplicando el tiempo de procesamiento por el número de motores. El análisis de CVISION sobre rendimientos decrecientes aplica aquí: cada reducción a la mitad de la tasa de error requiere aproximadamente el doble de tiempo de procesamiento.
P: ¿La aceleración por GPU elimina la compensación entre velocidad y precisión?
Reduce la brecha significativamente, pero no la elimina. PaddleOCR en una GPU RTX 3090 procesa ~120 páginas por minuto, aproximadamente 5 veces más rápido que su velocidad en CPU y casi 5 veces el rendimiento de Tesseract solo en CPU, manteniendo la misma precisión. La aceleración por GPU permite a los equipos ejecutar modelos de OCR de aprendizaje profundo a velocidades comparables a las de los motores ligeros, lo que en la práctica les permite tener tanto velocidad como precisión. Sin embargo, el costo de la GPU, su disponibilidad en entornos de nube y el consumo de energía en dispositivos periféricos siguen siendo limitaciones. No todos los flujos de trabajo tienen una GPU disponible.
P: ¿Debo optimizar la velocidad o la precisión al procesar facturas de múltiples proveedores con formatos diferentes?
La precisión. El desafío principal del procesamiento de facturas de múltiples proveedores no es la velocidad de lectura, sino la variación de formatos. Una herramienta de OCR basada en plantillas que procesa cada factura en 0,5 segundos pero requiere una plantilla separada por diseño de proveedor dedicará mucho más tiempo total al mantenimiento de plantillas que al procesamiento real. Una herramienta sin plantilla basada en VLM que procesa cada factura en 5 a 10 segundos pero maneja cualquier formato sin configuración será más rápida en tiempo total de flujo de trabajo, especialmente a medida que crece el número de proveedores. Nuestra guía sobre lo que realmente significa la precisión del OCR explica por qué la precisión a nivel de campo importa más que la velocidad a nivel de carácter en flujos de trabajo de múltiples formatos.
P: ¿Cuándo debo usar un enfoque híbrido: OCR rápido para clasificación y OCR preciso para extracción?
Un pipeline híbrido tiene sentido cuando tiene una distribución bimodal de calidad de documentos: un gran volumen de documentos limpios y estandarizados (donde una pasada rápida es suficiente) mezclado con un volumen menor de documentos complejos o degradados (donde el procesamiento optimizado para precisión es necesario). La clasificación de documentos mediante Tesseract u OCR en la nube ligero clasifica cada documento entrante como "limpio" o "difícil", enrutando los documentos limpios a un pipeline de extracción rápida y los difíciles a una revisión por VLM o humana. Este es un patrón común en departamentos de cuentas por pagar empresariales que procesan tanto facturas electrónicas de grandes proveedores como facturas en papel de pequeños vendedores. El inconveniente: la lógica de enrutamiento en sí debe ser altamente precisa, o los documentos difíciles se filtrarán al pipeline rápido y producirán errores.
Tome la Decisión de Equilibrio de Forma Deliberada
El equilibrio entre velocidad y precisión en OCR no es un problema que deba resolverse: es un parámetro de diseño que debe establecerse deliberadamente. Para cada flujo de trabajo de procesamiento de documentos, existe un punto de equilibrio correcto. El error está en dejar que la configuración predeterminada del proveedor o un único valor de referencia tome la decisión por usted.
La mayoría de los equipos dan demasiada importancia a la velocidad durante la evaluación porque la velocidad es fácil de medir (un número, una ejecución, un cronómetro) y la precisión no lo es (varía según el tipo de documento, la calidad, el campo y la definición de error). El proceso de evaluación honesto compara la precisión en los documentos reales que procesa — incluidos los desordenados — y mide el tiempo total del flujo de trabajo, no solo la latencia del OCR. Ese total incluye el tiempo dedicado a corregir errores, que es donde el OCR "rápido" pierde su ventaja.
Los modelos de visión y lenguaje han aplanado la curva de precisión, haciendo que la alta precisión sea accesible a velocidades tolerables para la mayoría de los flujos de trabajo de documentos empresariales. Si la precisión es su restricción — y para la mayoría de los casos de uso de extracción de documentos, debería serlo — una herramienta basada en VLM que procesa una página en 5–10 segundos y ofrece una precisión a nivel de campo superior al 95% es una mejor opción que una herramienta que procesa la misma página en 0.2 segundos y le deja verificando cada 5.º valor.
Pruebe el equilibrio en sus documentos reales. Vea cómo son 5 segundos por página cuando los errores que solían tomar minutos en encontrar simplemente ya no están.