Velocidade do OCR vs. Precisão:
O Trade-off que Nenhum Fornecedor Explica
Todo fornecedor de OCR diz que sua ferramenta é "rápida" e "precisa" — como se as duas qualidades existissem no mesmo eixo e você obtivesse ambas automaticamente. A realidade é o oposto: velocidade e precisão estão em tensão direta em todo pipeline de OCR, desde uma biblioteca open-source gratuita rodando em um laptop até uma API em nuvem apoiada por milhares de GPUs. Uma instância do Tesseract configurada para velocidade máxima processa uma página em 0,16 segundos, mas lê errado 1 em cada 8 palavras. Um modelo de visão de IA que lê a mesma página com precisão quase perfeita leva de 30 a 60 vezes mais tempo. Qual é o certo para seu fluxo de trabalho? A resposta depende do que você está processando, do que está construindo e do quanto um único dígito errado custa para você. A maioria dos fornecedores ignora essa pergunta porque a resposta honesta — "depende" — não cabe em uma tabela de comparação.
Principais Conclusões
- O Tesseract lê uma página em 0,16 segundos e erra 1 em cada 8 palavras — essa velocidade de 0,16 segundos gera cinco minutos de trabalho de correção por documento, e nenhum benchmark de fornecedor conta isso.
- Os benchmarks de OCR medem a latência no ponto de verificação errado — o gargalo real não é a velocidade com que o mecanismo lê uma página, mas a rapidez com que você corrige o que ele leu errado.
- Modelos de visão-linguagem achatam a curva — você não escolhe mais entre um mecanismo rápido-mas-errado e um lento-mas-certo; você escolhe um mecanismo e ajusta o quanto confia na saída.
Por que Velocidade e Precisão São Inversamente Relacionadas
A relação de compromisso entre velocidade e precisão não é uma limitação de nenhuma ferramenta específica — é uma consequência de como o OCR funciona no nível arquitetural. Todo sistema de OCR, seja um mecanismo legado de correspondência de padrões ou um modelo moderno de visão-linguagem, segue uma sequência de etapas: pré-processamento de imagem, detecção de texto, reconhecimento de caracteres e pós-processamento. Cada etapa consome recursos computacionais, e quanto mais minuciosamente cada etapa é executada, mais preciso é o resultado — e mais tempo leva.
Profundidade do pré-processamento. Um pipeline de OCR otimizado para velocidade pula ou minimiza o pré-processamento: ele reduz a amostragem da imagem para diminuir a contagem de pixels, aplica um limiar simples de binarização e passa o resultado diretamente ao reconhecedor. Benchmarks independentes mostram que pular etapas de pré-processamento como correção de inclinação, remoção de ruído e aprimoramento de contraste pode reduzir o tempo de processamento em 40–60% — mas também reduz a precisão em 10–20 pontos percentuais em entradas imperfeitas. A recomendação padrão na literatura de OCR — mínimo de 300 DPI, binarização adaptativa, correção geométrica — é em si um compromisso entre velocidade e precisão. A 300 DPI, um caractere de 10pt abrange aproximadamente 42 pixels, dando ao reconhecedor resolução suficiente para distinguir traços finos. Abaixo de 150 DPI, a precisão cai drasticamente para todos os mecanismos testados. Acima de 300 DPI, os ganhos de precisão se estabilizam enquanto o tamanho do arquivo e o tempo de processamento continuam aumentando.
Complexidade do modelo. É aqui que a relação de compromisso se torna mais visível. O mecanismo legado do Tesseract usa extração de características artesanal — ele compara formas de caracteres contra uma biblioteca de modelos usando classificadores pré-computados. Isso é rápido (0,1–0,3 segundos por página em uma CPU moderna), mas frágil: a precisão em entradas desafiadoras como fotos de celular cai para aproximadamente 70–80%. O mecanismo LSTM do Tesseract 4 adiciona uma camada de rede neural que lê caracteres no contexto da sequência, melhorando a precisão em 5–15 pontos percentuais em documentos ruidosos enquanto aproximadamente dobra o tempo de processamento. Mecanismos modernos de OCR de aprendizado profundo como PaddleOCR e EasyOCR substituem todo o pipeline por redes neurais — detecção de texto baseada em CNN seguida de reconhecimento de sequência baseado em atenção. Esses modelos alcançam precisão substancialmente maior (especialmente em layouts complexos e escrita manual), mas exigem 3–30 vezes mais computação por página. Um benchmark de março de 2026 da Codesota mediu o seguinte em uma única fatura: Tesseract 5.5 em 0,162 segundos com 87,5% de precisão, EasyOCR em 0,656 segundos com 62,5% de precisão e PaddleOCR em 4,85 segundos com 100% de precisão. A correlação não é perfeita — PaddleOCR dominou neste teste específico — mas o padrão entre tipos de documentos é claro: quanto mais profundo o modelo, mais lento e mais preciso ele tende a ser.
Cadeia de pós-processamento. Pipelines otimizados para precisão adicionam etapas de validação após o reconhecimento: correção ortográfica baseada em dicionário, verificações de consistência entre campos (o total da fatura corresponde à soma dos itens de linha?), validação de formato (a data é analisada corretamente?) e limiarização de pontuação de confiança com roteamento humano no circuito. Cada etapa adiciona latência. Um OCR básico que gera texto bruto em 0,2 segundos pode exigir 2–3 segundos adicionais de pós-processamento para atingir precisão de nível de produção. A latência total do sistema — não apenas a etapa de reconhecimento — é o que determina a taxa de transferência no mundo real.
O Panorama de Velocidade: Como São os Números na Prática
A velocidade bruta de processamento varia por duas ordens de magnitude, dependendo do motor de OCR, do hardware e da complexidade do documento. A tabela abaixo condensa benchmarks publicados de múltiples fontes independentes em intervalos que refletem condições reais de produção — não execuções seleccionadas para mostrar o melhor caso.
| Motor / API | Velocidade (por página, CPU) | Velocidade (GPU) | Precisão (impresso limpo) | Precisão (desafiante) |
|---|---|---|---|---|
| Tesseract 5.5 (modo legado) | 0,1–0,3s | N/A (só CPU) | 90–96% | 50–70% |
| Tesseract 5.5 (modo LSTM) | 0,3–0,8s | N/A (só CPU) | 93–97% | 60–80% |
| EasyOCR | 0,6–2,5s | 0,2–0,8s | 90–95% | 55–75% |
| Google Cloud Vision OCR | 1–3s (API) | — | 96–99% | 75–85% |
| AWS Textract | 2–4s (API) | — | 95–98% | 78–85% |
| Azure Document Intelligence | 3–5s (API) | — | 96–99% | 80–88% |
| PaddleOCR | 3–6s | ~0,5s (120 páginas/min) | 95–99% | 75–88% |
| Modelo de Visão-Linguagem (VLM) | 5–15s | 2–6s | 96–99% | 85–95% |
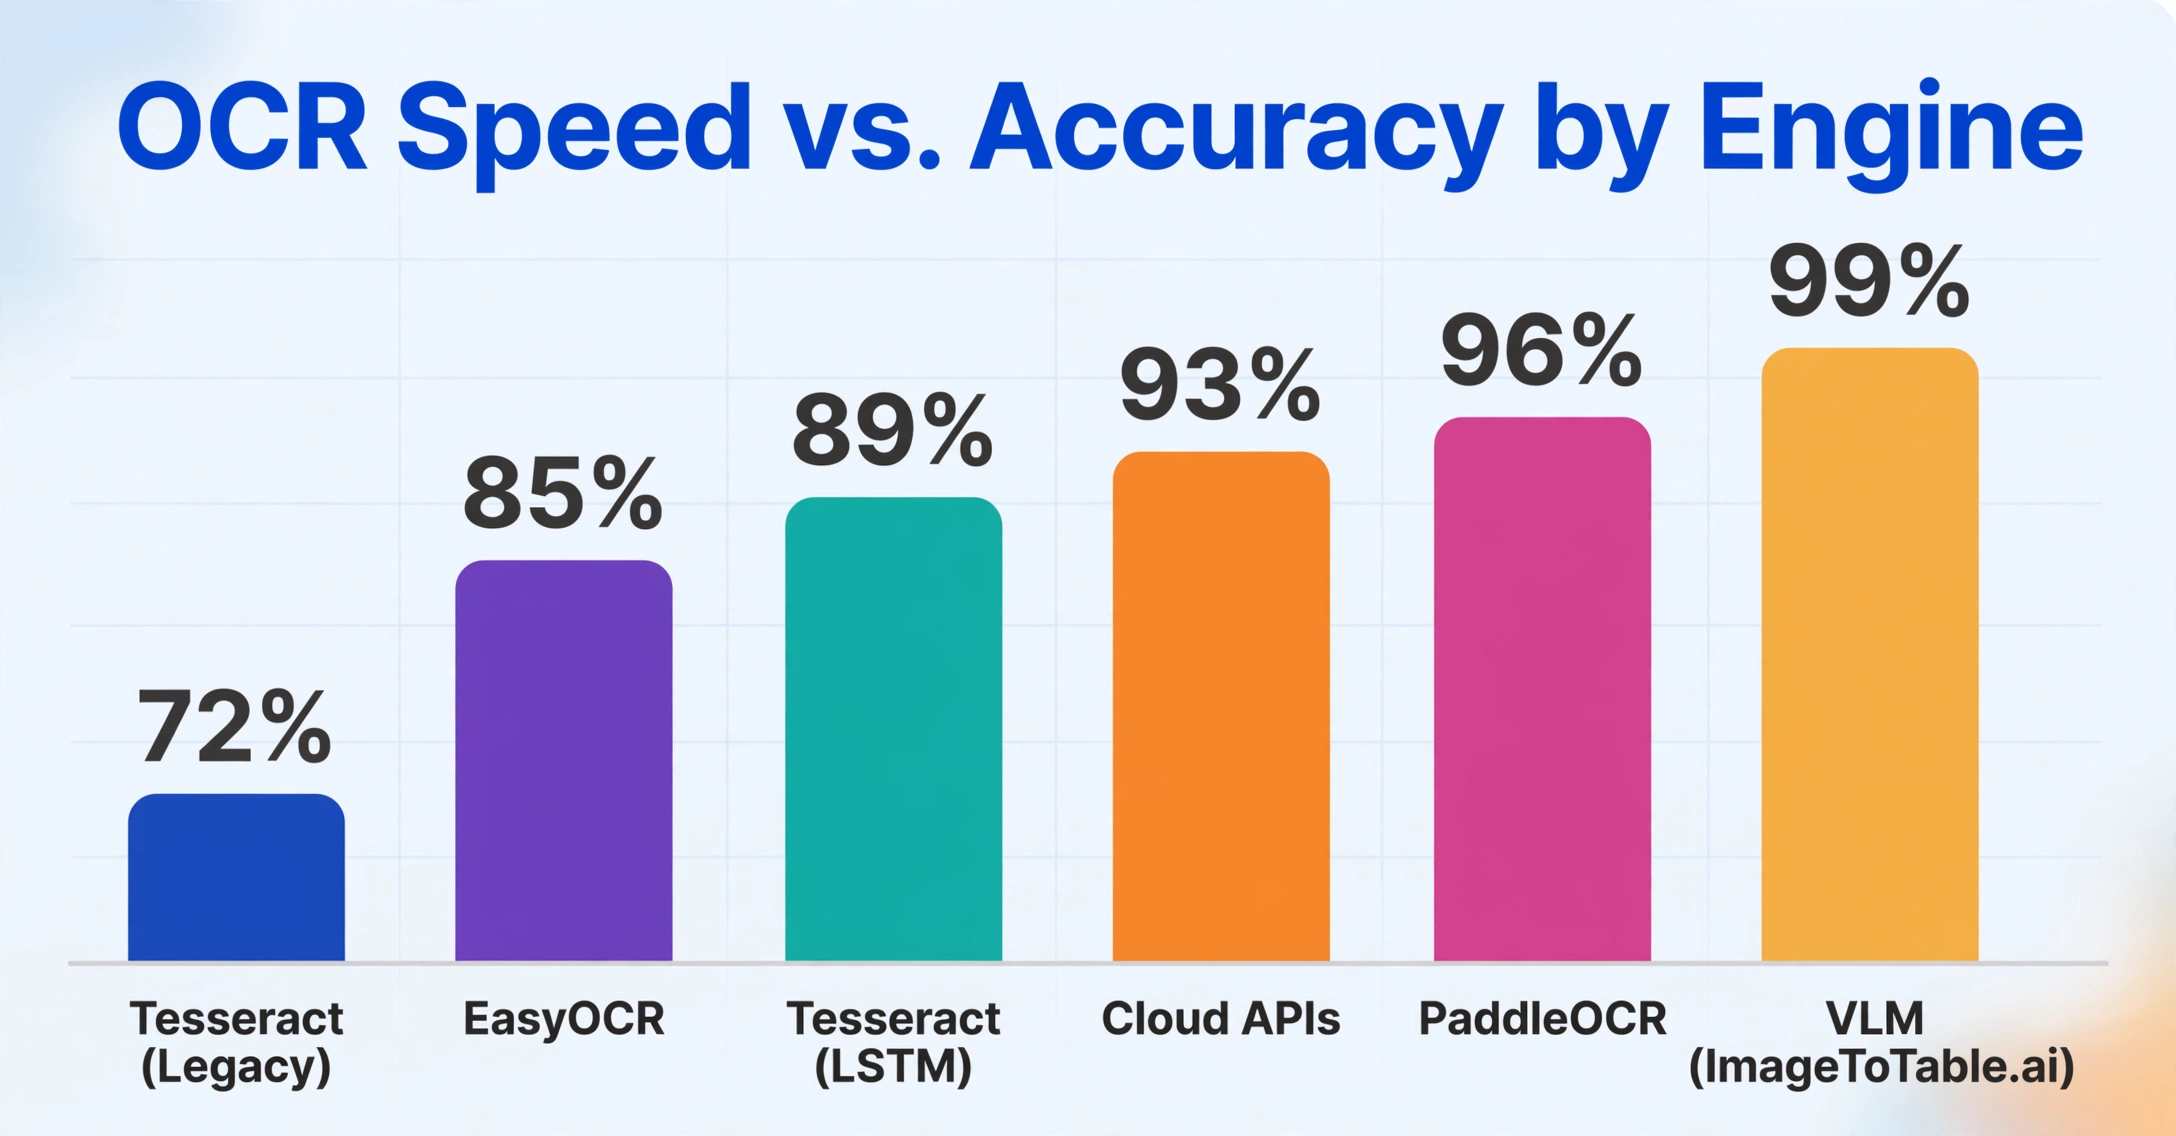
Fontes: Codesota (março de 2026), AIMultiple DeltOCR Bench (jan. 2026), benchmark PaddleOCR de GigaGPU, documentação oficial de AWS/Azure/Google. "Desafiante" incluye digitalizaciones de baixa resolução, fotos de celular e documentos com layouts mistos. A categoria VLM representa ferramentas como ImageToTable.ai e Qwen-VL.
A principal conclusão destes números: a relação entre velocidade e precisão não é uma curva suave. Tem pontos de inflexión. Tesseract oferece velocidade, mas atinge um teto duro de precisão em documentos imperfeitos. As APIs de nube oferecen um teto mais alto com latência moderada. Os VLM empurram o teto ao máximo, mas requerem mais tempo por página. Escolher entre eles significa saber em qual ponto de inflexión seus documentos e sua tolerância a erros o colocan.
A conclusão prática: O Tesseract processa uma fatura no tempo que um ser humano leva para piscar. Mas se essa fatura for uma foto de celular de um recibo amassado de prestador de serviços, a extração de 0,16 segundo pode ter uma taxa de erro de 20–30% — e corrigir esses erros no seu sistema contábil leva minutos por documento. A extração rápida gera trabalho lento a jusante.
Quando a Velocidade Importa Mais
Nem todo fluxo de trabalho com documentos exige perfeição em nível de campo. Vários cenários do mundo real priorizam corretamente a taxa de transferência em vez da precisão em nível de caractere — e os fornecedores que vendem apenas "99% de precisão" estão prejudicando seus usuários ao não reconhecer esses casos.
Escaneamento em ponto de venda em tempo real. Um sistema de checkout no varejo que escaneia um recibo para consultar um preço ou validar uma devolução precisa de uma resposta em menos de um segundo. Se o OCR ler incorretamente um caractere no nome de um produto, mas o sistema de inventário ainda encontrar o SKU correto por meio de correspondência difusa, a transação é concluída sem interrupção. A velocidade é a restrição limitante; o sistema processa centenas de transações por hora e 3 segundos extras por escaneamento criariam uma fila no caixa. Para esses cenários, o modo legado do Tesseract ou uma API de nuvem leve com tempos limite agressivos é a escolha correta — mesmo que isso signifique aceitar uma taxa de erro de caractere de 2–5%.
Triagem e roteamento de documentos. Muitos pipelines de processamento de documentos precisam classificar um documento recebido (é uma fatura, um pedido de compra ou uma nota de entrega?) antes de roteá-lo para o processador downstream correto. A etapa de classificação exige extrair texto suficiente apenas para identificar o tipo de documento — normalmente o cabeçalho, o título ou alguns campos-chave — não todos os caracteres da página. Uma passada rápida de OCR que identifica corretamente 95% dos tipos de documento em 0,2 segundo por página é mais valiosa do que uma passada lenta que identifica corretamente 98% em 5 segundos por página, porque os 3% classificados incorretamente podem ser detectados na etapa de revisão humana. O Google Cloud Vision OCR, com sua latência de 1–3 segundos e amplo suporte a idiomas, é uma escolha comum para essa camada de roteamento.
Arquivamento em alto volume com texto pesquisável. Quando o objetivo é tornar milhões de páginas pesquisáveis em um sistema de gerenciamento de documentos — em vez de extrair campos de dados específicos — o limite de precisão é menor. Um PDF pesquisável gerado pelo Tesseract com 90% de precisão de caractere ainda permite que os usuários encontrem a maioria dos documentos por meio de pesquisa por palavra-chave, porque um documento que contém "Fatura #12345" ainda será encontrado mesmo que o Tesseract leia "Fatura #1234S" em algumas páginas. A diferença de custo entre um pipeline de OCR rápido (milhares de páginas por hora em um único servidor) e um lento (centenas de páginas por hora) determina se o projeto de arquivamento é viável.
OCR móvel em dispositivos com bateria limitada. Executar um modelo de OCR de aprendizado profundo em um smartphone ou scanner portátil exige equilibrar precisão com consumo de bateria e aquecimento. O EasyOCR em um smartphone moderno leva aproximadamente 0,2–0,8 segundo por imagem quando acelerado por GPU, mas ao custo de consumo significativo de energia. Para trabalhadores de campo que escaneiam centenas de etiquetas por turno, um modelo mais leve que sacrifica 5% de precisão para dobrar a vida útil da bateria é a escolha operacional correta.
Quando a Precisão Deve Vencer
Cada cenário acima compartilha uma característica: o custo de um único erro é baixo ou facilmente absorvido. Inverta essa suposição, e a troca se reverte completamente.
Documentos fiscais e financeiros. Um único dígito lido incorretamente em uma declaração de IVA, um campo de salário W-2 ou um total de fatura cria um problema em cascata. O total de fatura de $1.500 que o OCR lê como $15.000 desencadeia um erro de pagamento que exige reconciliação, acompanhamento com o fornecedor e, potencialmente, uma declaração fiscal corrigida. Uma análise da Gennai de 2025 calculou que um sistema processando 500 faturas com 94% de precisão (30 faturas com erros) gerou 5 horas de trabalho de correção por lote, enquanto um sistema processando 400 faturas com 99% de precisão (4 com erros) gerou apenas 40 minutos de limpeza — apesar da taxa mais lenta por página. O sistema mais lento foi mais produtivo em termos de saída utilizável por hora. Para documentos fiscais especificamente, o IRS e a maioria das autoridades fiscais esperam 100% de precisão nos valores reportados — não "quase certo". Um único erro de campo em uma declaração de imposto anual pode desencadear uma auditoria, penalidades e encargos de juros que superam qualquer economia de custo de processamento.
Contratos legais e documentos de conformidade. A extração de dados de contratos para monitoramento de conformidade, abstração de arrendamentos ou arquivamentos regulatórios é o domínio onde a precisão é inegociável. Uma data de renovação de contrato com um mês de diferença, uma cláusula de indenização classificada incorretamente ou um limite de responsabilidade lido como $500.000 em vez de $5.000.000 cria exposição legal que nenhuma velocidade de processamento justifica. Para esses documentos, a abordagem correta é a extração otimizada para precisão com pontuação de confiança e revisão humana obrigatória de qualquer campo de baixa confiança. Modelos de visão-linguagem — que leem o documento inteiro em contexto e podem interpretar a estrutura de cláusulas e relações semânticas — são cada vez mais o padrão aqui, mesmo a 10–15 segundos por página, porque o custo de um único erro de extração pode exceder o orçamento anual inteiro da ferramenta de extração.
Cobrança médica e dados de pacientes. A extração de documentos de saúde fica na interseção de requisitos de precisão e restrições regulatórias. Um código CPT lido incorretamente em um formulário de reivindicação CMS-1500 pode resultar em negação da reivindicação, atraso no pagamento ou — no pior caso — um procedimento incorreto cobrado no registro do paciente. A conformidade com HIPAA exige precisão e auditabilidade. O padrão na extração de documentos médicos é precisão em nível de campo acima de 98% com rastreabilidade completa de cada valor extraído de volta à sua posição no documento de origem. A velocidade é secundária; uma reivindicação enviada incorretamente é mais cara do que uma reivindicação enviada tarde.
Transações internacionais e com múltiplas moedas. Documentos que misturam moedas, convenções decimais e formatos numéricos são particularmente implacáveis com OCR otimizado para velocidade. Uma fatura europeia mostrando "€ 1.234,56" (1.234,56 EUR) processada por um sistema treinado em convenções decimais dos EUA pode ler incorretamente o valor como €1,23 — um erro de 1.000x. A queda de precisão em documentos multilíngues e multi-formato é bem documentada, e corrigir esses erros específicos de formato exige um modelo treinado em formatos internacionais ou regras de validação de pós-processamento que adicionam latência. Neste domínio, a precisão deve vencer porque o custo de um erro de formato não é proporcional à taxa de erro de caracteres — um único ponto decimal mal colocado pode falir uma transação.
Regra rápida: Se uma pessoa levar mais de 30 segundos para verificar um único campo na sua saída, e você processar mais de 200 documentos por semana, otimize para precisão — o tempo de revisão economizado com menos erros compensará a velocidade de extração mais lenta. Se a verificação do mesmo campo levar menos de 5 segundos e os erros forem imediatamente óbvios, otimize para velocidade.
Um Framework Prático de Decisão
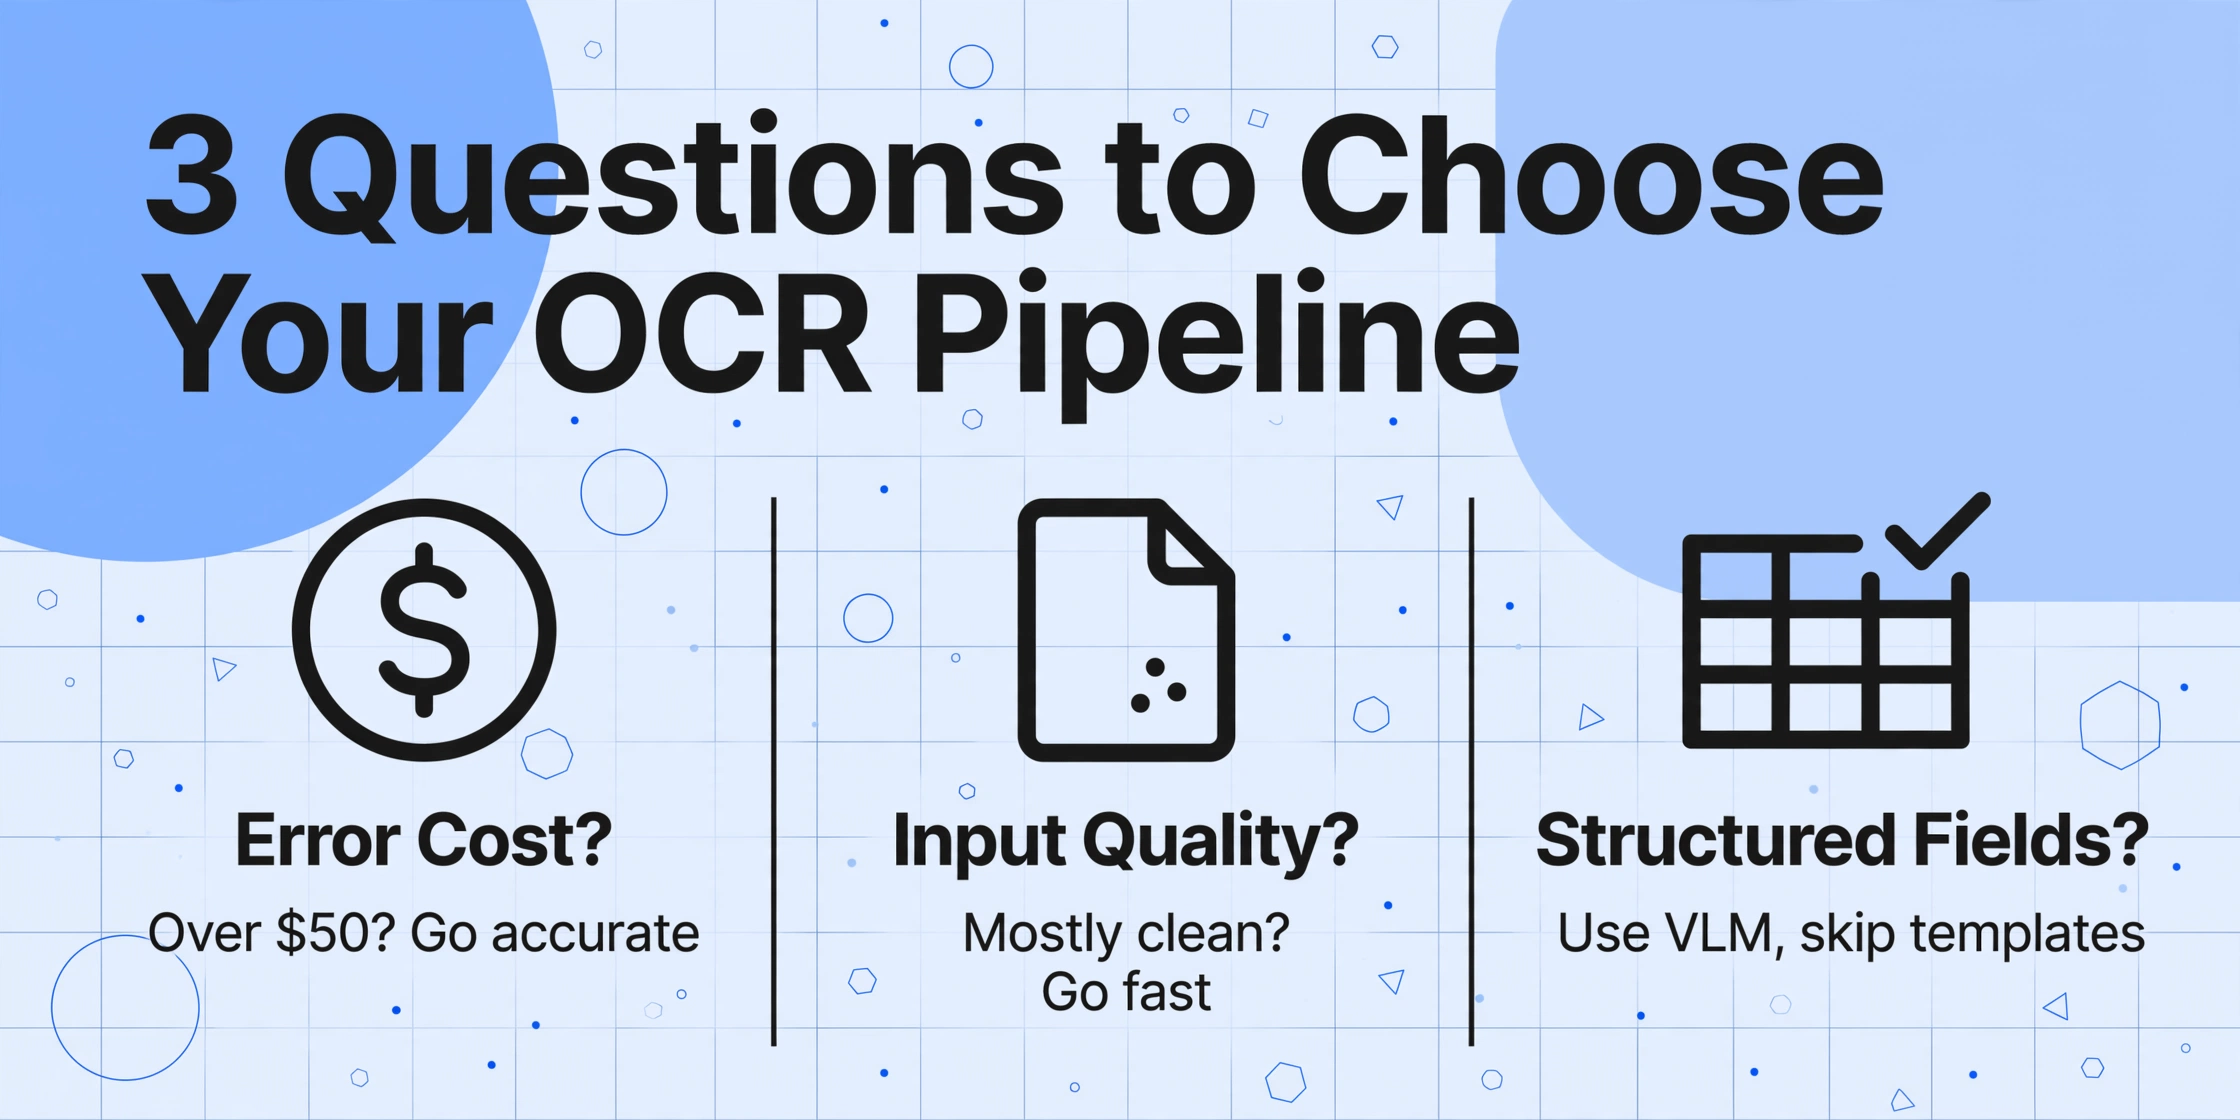
Em vez de perguntar "qual ferramenta de OCR é a melhor", faça estas três perguntas sobre seu fluxo de trabalho, em ordem:
Qual é o custo de um único erro de extração no seu fluxo de trabalho?
Se um único campo lido incorretamente custar mais de $50 em correções, atrasos downstream ou risco de conformidade, comece com um pipeline otimizado para precisão e aceite uma taxa de transferência mais lenta. Se os erros forem detectados rapidamente e custarem pouco para corrigir, um pipeline com prioridade de velocidade é adequado.
Qual é a distribuição de qualidade dos seus documentos de entrada?
Se 90% dos seus documentos são PDFs limpos e impressos com fontes padrão — o Tesseract no modo LSTM a 0,3 segundos por página provavelmente é suficiente, e você só precisa lidar com os 10% restantes de casos extremos com um sistema de fallback mais lento e preciso. Se a maioria são fotos de celular de recibos térmicos amassados, comece com um modelo que lida bem com degradação — o que significa aceitar uma velocidade por página mais lenta.
Você precisa de extração de campos estruturados ou apenas de texto bruto?
Extrair campos específicos (total da fatura, número do pedido, ID fiscal) de formatos arbitrários requer compreensão semântica — uma tarefa onde as vantagens de velocidade do OCR tradicional desaparecem porque o pós-processamento necessário para identificar e validar campos adiciona latência, independentemente da velocidade de reconhecimento. É aqui que ferramentas de extração sem modelo e baseadas em VLM, como o ImageToTable.ai, mudam a equação: elas eliminam a configuração e a manutenção de modelos que retardam os pipelines tradicionais, tornando o processamento de 5 a 10 segundos por página mais rápido no tempo total do fluxo de trabalho.
Aplique este framework como um filtro: se a Pergunta 1 aponta para precisão e a Pergunta 2 confirma que você tem qualidade de entrada heterogênea, pule totalmente as ferramentas focadas em velocidade e vá direto para uma plataforma projetada para precisão em documentos diversos. Se a Pergunta 1 aponta para velocidade e a Pergunta 2 confirma entrada limpa e uniforme, um pipeline leve baseado em Tesseract ou uma API de nuvem rápida é a escolha correta. O erro que a maioria das equipes comete é não avaliar essas perguntas em ordem — elas comparam ferramentas primeiro pela velocidade e depois descobrem que seus requisitos de precisão as forçam a reconstruir o pipeline.
Como os Modelos de Visão e Linguagem Mudam a Equação
A relação velocidade-precisão descrita até aqui se aplica a arquiteturas de OCR tradicionais — mecanismos que dividem a leitura de documentos em etapas sequenciais e independentes (detecção → reconhecimento → pós-processamento). Os modelos de visão e linguagem (VLMs) abordam o problema de forma diferente: eles leem o documento como uma única cena visual, compreendendo layout, texto e relações entre campos em uma única passada integrada. A consequência prática é que os VLMs não enfrentam a mesma curva de relação velocidade-precisão que o OCR tradicional.
Onde a precisão do Tesseract colapsa em entradas desafiadoras (50–70% em manuscritos, por exemplo), a precisão de um VLM degrada gradualmente — de 96% em texto impresso limpo para 85–90% em manuscritos moderados até aproximadamente 75–80% no pior caso. Não há um precipício. Onde o EasyOCR exige aceleração por GPU para atingir velocidades aceitáveis em documentos complexos, um VLM rodando em CPU ainda pode produzir resultados utilizáveis — mais lento, mas sem a queda acentuada de precisão que o OCR tradicional apresenta quando o pré-processamento é ignorado.
Isso muda o framework de decisão. Com uma ferramenta baseada em VLM como o ImageToTable.ai, a relação velocidade-precisão não é mais uma escolha binária entre "rápido e errado" ou "lento e certo". Em vez disso, o mesmo modelo atende aos dois cenários: você pode processar uma única fatura em 5–10 segundos com precisão em nível de campo superior a 95%, ou processar 50 faturas em lote e revisar apenas as saídas de baixa confiança. A consistência do modelo entre diferentes qualidades de documento — a ausência de precipícios de precisão — é o que torna isso possível. Você não está escolhendo entre dois mecanismos diferentes para triagem de alta velocidade e extração de alta precisão; você está escolhendo um mecanismo e ajustando o limite de revisão.
Para equipes que avaliam soluções de OCR em 2026, a mudança importante é esta: a relação velocidade-precisão ainda é real, mas a curva se achatou. Ferramentas construídas com modelos de visão e linguagem oferecem um piso de precisão mais alto em cada ponto de velocidade do que as arquiteturas de OCR tradicionais conseguem igualar. A pergunta não é mais "quanta precisão estou disposto a trocar por velocidade?" mas "quanta latência meu pipeline pode tolerar para alcançar a precisão que preciso?" — e a resposta, para a maioria dos fluxos de trabalho com documentos, é mais do que você imagina.
Perguntas Frequentes
P: Posso usar o Tesseract para extração de documentos em produção, ou ele é impreciso demais?
Depende dos seus documentos e da sua tolerância a erros. Em PDFs limpos, impressos por máquina, com fontes padrão a 300 DPI, o Tesseract 5.5 em modo LSTM entrega 93–97% de precisão de caracteres — suficiente para muitos fluxos de trabalho internos em que um erro de digitação ocasional não é catastrófico. Em fotos de recibos tiradas com celular, cópias carbono digitalizadas ou documentos com escrita manual, a precisão cai para 50–80%, o que provavelmente é baixo demais para uso em produção sem uma revisão manual significativa. Para uma comparação detalhada de ferramentas de código aberto, consulte nosso guia de ferramentas de OCR de código aberto.
P: Qual é mais rápido — AWS Textract ou Google Cloud Vision OCR?
Ambos normalmente processam uma única página em 2–4 segundos no modo síncrono, com o Google sendo em média um pouco mais rápido em documentos simples (1–3 segundos) e o Textract comparável, com 2–4 segundos. No modo lote/assíncrono, ambos os serviços podem processar centenas de páginas por hora. A maior diferença não é a velocidade, mas o perfil de precisão: o Google Vision se destaca em documentos multilíngues e imagens com ruído, enquanto o Textract tem extração mais forte de formulários e tabelas. Para uma comparação direta de APIs de OCR em nuvem, consulte nosso guia Melhor API de OCR 2026.
P: Quanto mais lento é o modo "preciso" em comparação ao modo "rápido" na mesma ferramenta de OCR?
O modo LSTM do Tesseract é aproximadamente 2–5x mais lento que o modo legado no mesmo documento — 0,3–0,8 segundos por página contra 0,1–0,3 segundos. O modo "preciso" do ABBYY FineReader roda aproximadamente 2–2,5x mais lento que o modo "rápido". O ganho de precisão é tipicamente de 5 a 10 pontos percentuais em documentos desafiadores. Os modos "superprecisos" de algumas ferramentas executam vários mecanismos em paralelo e usam o melhor resultado, multiplicando o tempo de processamento pelo número de mecanismos. A análise da CVISION sobre retornos decrescentes se aplica aqui: cada redução pela metade da taxa de erro exige aproximadamente 2x o tempo de processamento.
P: A aceleração por GPU elimina a relação entre velocidade e precisão?
Ela reduz significativamente a diferença, mas não a elimina. O PaddleOCR em uma GPU RTX 3090 processa ~120 páginas por minuto — cerca de 5x mais rápido que sua velocidade em CPU e quase 5x a taxa de transferência do Tesseract apenas em CPU — mantendo a mesma precisão. A aceleração por GPU permite que equipes executem modelos de OCR de aprendizado profundo em velocidades comparáveis às de mecanismos leves, na prática permitindo ter velocidade e precisão ao mesmo tempo. No entanto, o custo da GPU, a disponibilidade em ambientes de nuvem e o consumo de energia em dispositivos de borda continuam sendo limitações. Nem todo fluxo de trabalho tem uma GPU disponível.
P: Devo otimizar para velocidade ou precisão ao processar faturas de vários fornecedores com formatos diferentes?
Precisão. O principal desafio do processamento de faturas de vários fornecedores não é a velocidade de leitura — é a variação de formato. Uma ferramenta de OCR baseada em modelo que processa cada fatura em 0,5 segundos, mas exige um modelo separado para cada layout de fornecedor, gastará muito mais tempo total com manutenção de modelos do que com processamento real. Uma ferramenta sem modelo, baseada em VLM, que processa cada fatura em 5–10 segundos, mas lida com qualquer formato sem configuração, será mais rápida no tempo total do fluxo de trabalho — especialmente à medida que o número de fornecedores cresce. Nosso guia sobre o que a precisão do OCR realmente significa explica por que a precisão em nível de campo importa mais do que a velocidade em nível de caractere em fluxos de trabalho com múltiplos formatos.
P: Quando devo usar uma abordagem híbrida — OCR rápido para triagem e OCR preciso para extração?
Um pipeline híbrido faz sentido quando você tem uma distribuição bimodal de qualidade de documentos: um grande volume de documentos limpos e padronizados (onde uma passagem rápida é suficiente) misturado com um volume menor de documentos complexos ou degradados (onde o processamento otimizado para precisão é necessário). A triagem de documentos via Tesseract ou OCR em nuvem leve classifica cada documento recebido como "limpo" ou "desafiador", encaminhando documentos limpos para um pipeline de extração rápida e os desafiadores para revisão por VLM ou humana. Esse é um padrão comum em departamentos de contas a pagar empresariais que processam tanto faturas eletrônicas de grandes fornecedores quanto faturas em papel de pequenos fornecedores. O problema: a lógica de roteamento em si precisa ser altamente precisa, ou documentos desafiadores passarão pelo pipeline rápido e produzirão erros.
Faça a Compensação Deliberadamente
A compensação entre velocidade e precisão em OCR não é um problema a ser resolvido — é um parâmetro de design a ser definido deliberadamente. Para cada fluxo de trabalho de processamento de documentos, existe um ponto de equilíbrio correto. O erro é deixar que as configurações padrão do fornecedor ou um único número de benchmark tomem a decisão por você.
A maioria das equipes superestima a velocidade durante a avaliação porque a velocidade é fácil de medir (um número, uma execução, um cronômetro) e a precisão não é (ela varia por tipo de documento, qualidade, campo e definição de erro). O processo de avaliação honesto mede a precisão nos documentos reais que você processa — incluindo os bagunçados — e mede o tempo total do fluxo de trabalho, não apenas a latência do OCR. Esse total inclui o tempo gasto corrigindo erros, que é onde o OCR "rápido" perde sua vantagem.
Os modelos de visão-linguagem achataram a curva de precisão, tornando a alta precisão acessível em velocidades toleráveis para a maioria dos fluxos de trabalho de documentos empresariais. Se a precisão é sua restrição — e para a maioria dos casos de uso de extração de documentos, deveria ser — uma ferramenta baseada em VLM que processa uma página em 5–10 segundos e entrega precisão em nível de campo acima de 95% é uma escolha melhor do que uma ferramenta que processa a mesma página em 0,2 segundos e deixa você verificando cada 5º valor.
Teste a compensação em seus documentos reais. Veja como são 5 segundos por página quando os erros que costumavam levar minutos para encontrar simplesmente não estão mais lá.