Vitesse vs précision de l'OCR :
Le compromis que personne ne vous explique
Chaque fournisseur d'OCR vous dit que son outil est « rapide » et « précis » — comme si ces deux qualités existaient sur le même axe et que vous les obteniez automatiquement toutes les deux. La réalité est tout autre : la vitesse et la précision sont en tension directe dans chaque pipeline OCR, qu'il s'agisse d'une bibliothèque open source gratuite fonctionnant sur un ordinateur portable ou d'une API cloud adossée à des milliers de GPU. Une instance Tesseract configurée pour une vitesse maximale traite une page en 0,16 seconde mais se trompe sur 1 mot sur 8. Un modèle d'IA de vision qui lit la même page avec une précision quasi parfaite prend 30 à 60 fois plus de temps. Lequel convient à votre flux de travail ? La réponse dépend de ce que vous traitez, de ce que vous construisez et de ce que vous coûte un seul chiffre erroné. La plupart des fournisseurs évitent cette question parce que la réponse honnête — « cela dépend » — ne tient pas dans un tableau comparatif.
Points clés à retenir
- Tesseract lit une page en 0,16 seconde et manque 1 mot sur 8 — cette vitesse de 0,16 seconde génère cinq minutes de correction par document, et aucun benchmark de fournisseur ne le compte.
- Les benchmarks OCR mesurent la latence au mauvais point de contrôle — le vrai goulot d'étranglement n'est pas la vitesse à laquelle le moteur lit une page, mais la vitesse à laquelle vous corrigez ce qu'il a mal lu.
- Les modèles de vision-langage aplatissent la courbe — vous ne choisissez plus entre un moteur rapide mais faux et un moteur lent mais juste, vous choisissez un moteur et ajustez le niveau de confiance accordé à sa sortie.
Pourquoi la vitesse et la précision sont inversement liées
Le compromis entre vitesse et précision n'est pas une limitation d'un outil particulier — c'est une conséquence du fonctionnement de l'OCR au niveau architectural. Chaque système OCR, qu'il s'agisse d'un moteur de reconnaissance de formes hérité ou d'un modèle de vision-langage moderne, suit une séquence d'étapes : prétraitement de l'image, détection du texte, reconnaissance des caractères et post-traitement. Chaque étape consomme des ressources de calcul, et plus chaque étape est exécutée en profondeur, plus le résultat est précis — et plus cela prend du temps.
Profondeur du prétraitement. Un pipeline OCR optimisé pour la vitesse ignore ou minimise le prétraitement : il réduit l'image pour diminuer le nombre de pixels, applique un simple seuil de binarisation et transmet le résultat directement au reconnaisseur. Des benchmarks indépendants montrent que sauter les étapes de prétraitement comme la correction d'inclinaison, la suppression du bruit et l'amélioration du contraste peut réduire le temps de traitement de 40 à 60 % — mais cela fait aussi chuter la précision de 10 à 20 points de pourcentage sur des entrées imparfaites. La recommandation standard dans la littérature OCR — 300 DPI minimum, binarisation adaptative, correction géométrique — est elle-même un compromis vitesse-précision. À 300 DPI, un caractère de 10 pt couvre environ 42 pixels, donnant au reconnaisseur une résolution suffisante pour distinguer les traits fins. En dessous de 150 DPI, la précision chute fortement pour tous les moteurs testés. Au-dessus de 300 DPI, les gains de précision plafonnent tandis que la taille du fichier et le temps de traitement continuent d'augmenter.
Complexité du modèle. C'est ici que le compromis devient le plus visible. Le moteur hérité de Tesseract utilise une extraction de caractéristiques artisanale — il fait correspondre les formes de caractères à une bibliothèque de modèles à l'aide de classifieurs précalculés. C'est rapide (0,1 à 0,3 seconde par page sur un CPU moderne) mais fragile : la précision sur des entrées difficiles comme les photos de téléphone portable chute à environ 70 à 80 %. Le moteur LSTM de Tesseract 4 ajoute une couche de réseau neuronal qui lit les caractères dans leur contexte séquentiel, améliorant la précision de 5 à 15 points de pourcentage sur les documents bruités tout en doublant environ le temps de traitement. Les moteurs OCR modernes d'apprentissage profond comme PaddleOCR et EasyOCR remplacent tout le pipeline par des réseaux neuronaux — détection de texte basée sur CNN suivie d'une reconnaissance de séquence basée sur l'attention. Ces modèles atteignent une précision nettement supérieure (en particulier sur les mises en page complexes et l'écriture manuscrite) mais nécessitent 3 à 30 fois plus de calcul par page. Un benchmark de mars 2026 réalisé par Codesota a mesuré les résultats suivants sur une seule facture : Tesseract 5.5 à 0,162 seconde avec 87,5 % de précision, EasyOCR à 0,656 seconde avec 62,5 % de précision, et PaddleOCR à 4,85 secondes avec 100 % de précision. La corrélation n'est pas parfaite — PaddleOCR a dominé sur ce test spécifique — mais le schéma est clair sur tous les types de documents : plus le modèle est profond, plus il est lent et plus il tend à être précis.
Chaîne de post-traitement. Les pipelines optimisés pour la précision ajoutent des étapes de validation après la reconnaissance : correction orthographique basée sur un dictionnaire, contrôles de cohérence entre champs (le total de la facture correspond-il à la somme des lignes ?), validation du format (la date se parse-t-elle correctement ?) et seuillage du score de confiance avec routage humain dans la boucle. Chaque étape ajoute de la latence. Un OCR minimal qui produit du texte brut en 0,2 seconde peut nécessiter 2 à 3 secondes supplémentaires de post-traitement pour atteindre une précision de niveau production. La latence totale du système — pas seulement l'étape de reconnaissance — est ce qui détermine le débit réel.
Le paysage de la vitesse : ce que les chiffres montrent réellement
La vitesse de traitement brute varie de deux ordres de grandeur selon le moteur OCR, le matériel et la complexité des documents. Le tableau ci-dessous synthétise les benchmarks publiés par plusieurs sources indépendantes en fourchettes reflétant les conditions réelles de production — et non des exécutions optimales sélectionnées.
| Moteur / API | Vitesse (par page, CPU) | Vitesse (GPU) | Précision (texte imprimé propre) | Précision (documents difficiles) |
|---|---|---|---|---|
| Tesseract 5.5 (mode legacy) | 0,1–0,3 s | N/A (CPU uniquement) | 90–96 % | 50–70 % |
| Tesseract 5.5 (mode LSTM) | 0,3–0,8 s | N/A (CPU uniquement) | 93–97 % | 60–80 % |
| EasyOCR | 0,6–2,5 s | 0,2–0,8 s | 90–95 % | 55–75 % |
| Google Cloud Vision OCR | 1–3 s (API) | — | 96–99 % | 75–85 % |
| AWS Textract | 2–4 s (API) | — | 95–98 % | 78–85 % |
| Azure Document Intelligence | 3–5 s (API) | — | 96–99 % | 80–88 % |
| PaddleOCR | 3–6 s | ~0,5 s (120 pages/min) | 95–99 % | 75–88 % |
| Modèle vision-langage (VLM) | 5–15 s | 2–6 s | 96–99 % | 85–95 % |
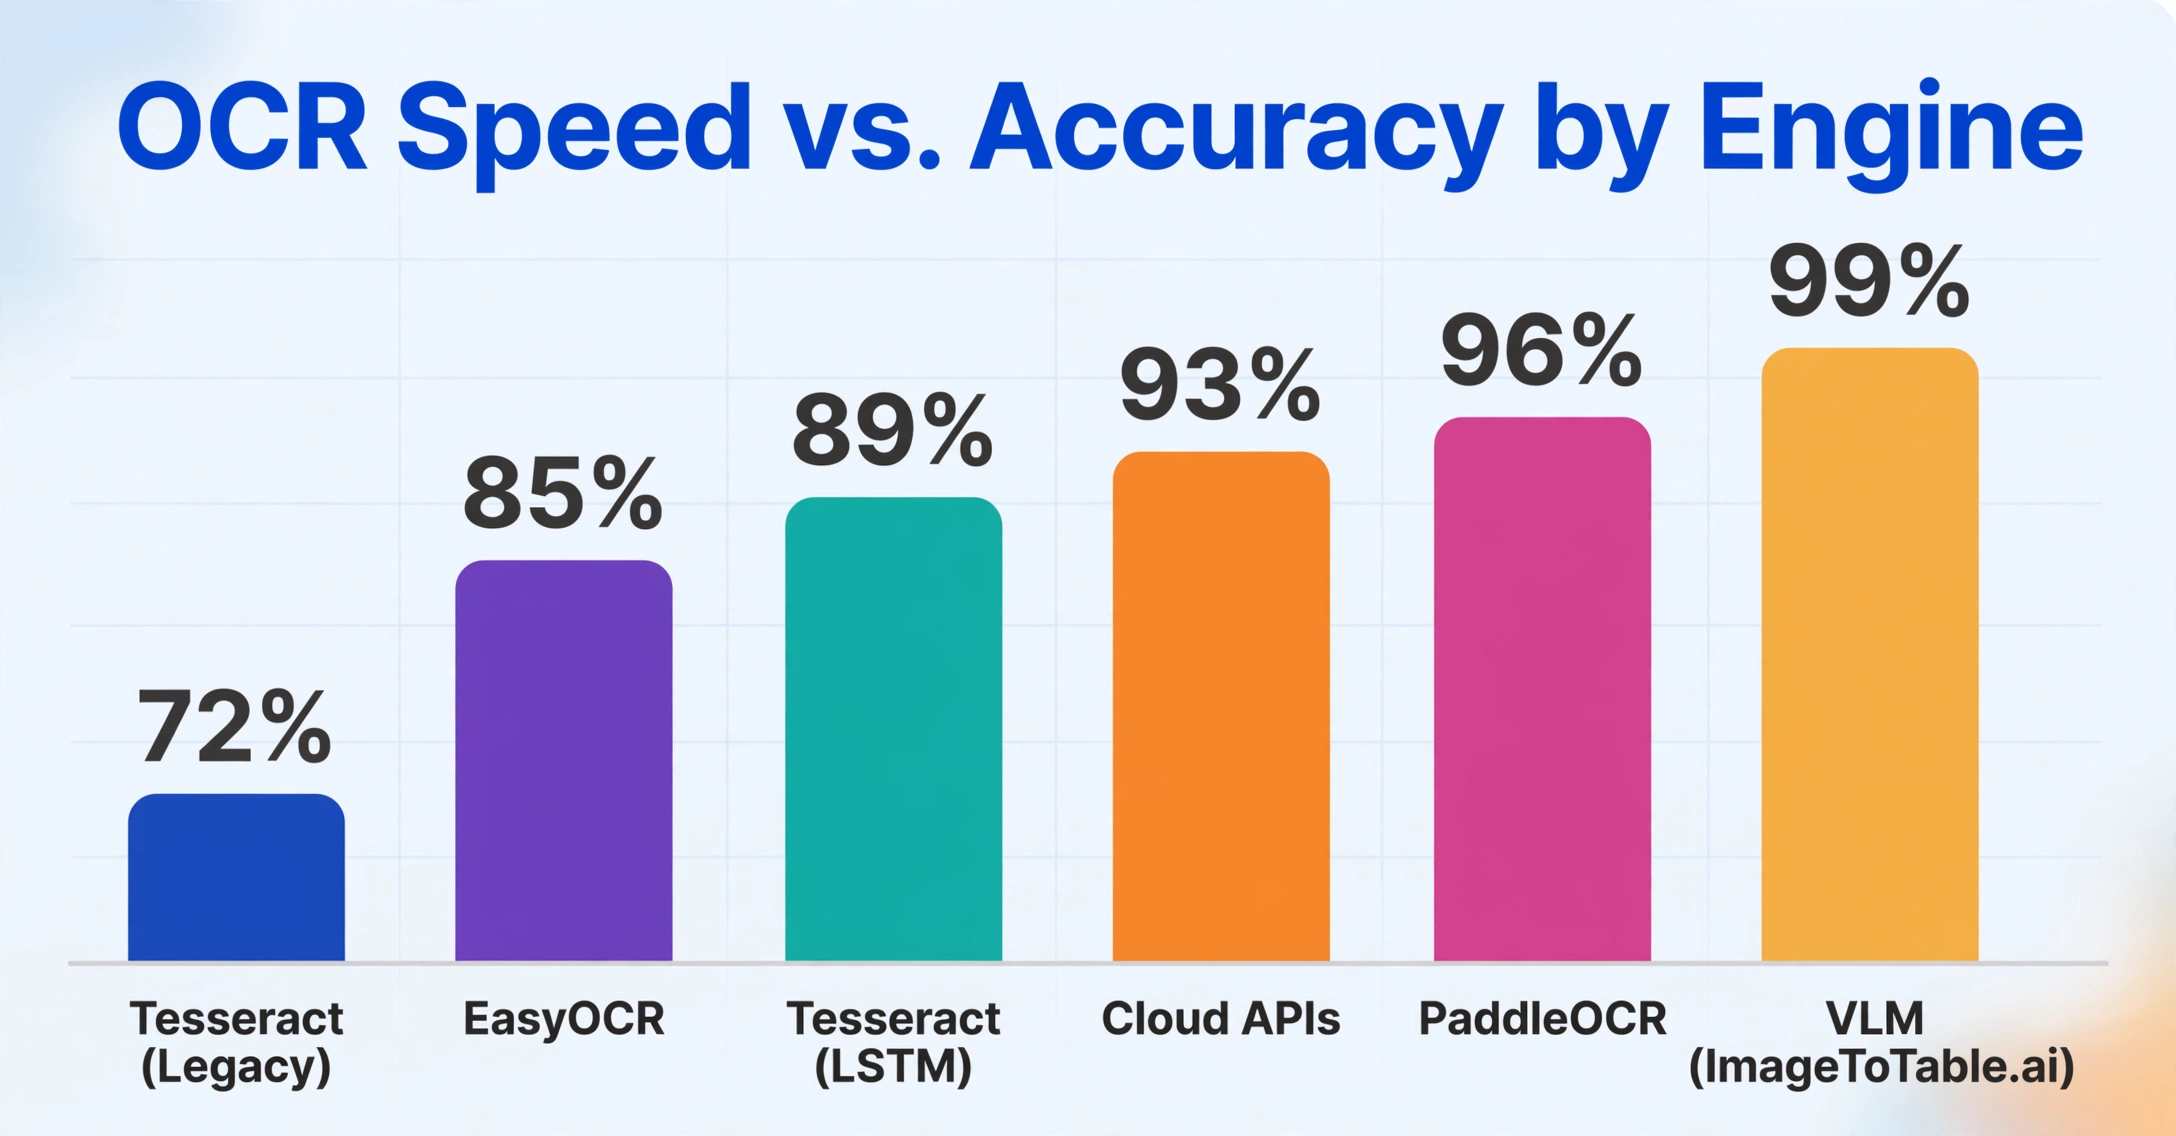
Sources : Codesota (mars 2026), AIMultiple DeltOCR Bench (janv. 2026), benchmark GigaGPU PaddleOCR, documentation officielle AWS/Azure/Google. « Documents difficiles » inclut les scans basse résolution, les photos prises au téléphone mobile et les documents à mise en page mixte. La catégorie VLM représente des outils comme ImageToTable.ai et Qwen-VL.
L'enseignement clé de ces chiffres : la relation entre vitesse et précision n'est pas une courbe lisse. Elle comporte des points d'inflexion. Tesseract offre de la vitesse mais atteint un plafond de précision strict sur les documents imparfaits. Les API cloud offrent un plafond plus élevé avec une latence modérée. Les VLM repoussent le plafond au plus haut mais exigent le plus de temps par page. Choisir entre eux signifie savoir à quel point d'inflexion vos documents et votre tolérance aux erreurs vous placent.
L'essentiel à retenir : Tesseract traite une facture en un clin d'œil. Mais si cette facture est une photo de téléphone d'un reçu froissé d'un entrepreneur, l'extraction en 0,16 seconde peut avoir un taux d'erreur de 20 à 30 % — et corriger ces erreurs dans votre système comptable prend des minutes par document. L'extraction rapide crée un travail en aval lent.
Quand la vitesse prime
Tous les flux de travail documentaires n'exigent pas une perfection au niveau des champs. Plusieurs scénarios concrets privilégient à juste titre le débit au détriment de la précision au niveau des caractères — et les fournisseurs qui ne commercialisent que la « précision à 99 % » rendent un mauvais service à leurs utilisateurs en ne reconnaissant pas ces cas.
Scan en temps réel au point de vente. Un système de caisse qui scanne un reçu pour rechercher un prix ou valider un retour a besoin d'une réponse en moins d'une seconde. Si l'OCR lit mal un caractère d'un nom de produit, mais que le système d'inventaire trouve quand même le bon SKU grâce à une correspondance floue, la transaction se termine sans interruption. La vitesse est la contrainte déterminante ; le système traite des centaines de transactions par heure et 3 secondes supplémentaires par scan créeraient une file d'attente à la caisse. Pour ces scénarios, le mode hérité de Tesseract ou une API cloud légère avec des délais d'attente agressifs est le bon choix — même si cela implique d'accepter un taux d'erreur de caractères de 2 à 5 %.
Tri et routage des documents. De nombreux pipelines de traitement de documents doivent classer un document entrant (est-ce une facture, un bon de commande ou un bon de livraison ?) avant de le router vers le processeur en aval approprié. L'étape de classification nécessite d'extraire juste assez de texte pour identifier le type de document — généralement l'en-tête, le titre ou quelques champs clés — et non chaque caractère de la page. Un passage OCR rapide qui identifie correctement 95 % des types de documents en 0,2 seconde par page est plus précieux qu'un passage OCR lent qui en identifie correctement 98 % en 5 secondes par page, car les 3 % mal classés peuvent être détectés lors de l'étape de révision humaine. Google Cloud Vision OCR, avec sa latence de 1 à 3 secondes et sa large prise en charge linguistique, est un choix courant pour cette couche de routage.
Archivage à grand volume avec texte consultable. Lorsque l'objectif est de rendre des millions de pages consultables dans un système de gestion documentaire — plutôt que d'extraire des champs de données spécifiques — le seuil de précision est plus bas. Un PDF consultable généré par Tesseract avec une précision de caractères de 90 % permet toujours aux utilisateurs de trouver la plupart des documents par recherche par mots-clés, car un document contenant « Facture n° 12345 » sera toujours trouvé même si Tesseract lit « Facture n° 1234S » sur certaines pages. La différence de coût entre un pipeline OCR rapide (des milliers de pages par heure sur un seul serveur) et un pipeline lent (des centaines de pages par heure) détermine si le projet d'archivage est même réalisable.
OCR mobile sur des appareils à autonomie limitée. Exécuter un modèle OCR d'apprentissage profond sur un smartphone ou un scanner portable nécessite de trouver un équilibre entre la précision et la consommation de batterie et la chaleur. EasyOCR sur un smartphone moderne prend environ 0,2 à 0,8 seconde par image avec accélération GPU, mais au prix d'une consommation d'énergie importante. Pour les travailleurs de terrain qui scannent des centaines d'étiquettes par quart de travail, un modèle plus léger qui sacrifie 5 % de précision pour doubler l'autonomie de la batterie est le bon choix opérationnel.
Quand la précision doit primer
Chaque scénario ci-dessus partage une caractéristique : le coût d'une erreur unique est faible ou facilement absorbé. Inversez cette hypothèse, et le compromis s'inverse complètement.
Documents fiscaux et financiers. Un seul chiffre mal lu dans une déclaration de TVA, un champ de salaire W-2 ou un total de facture crée un problème en cascade. Le total de facture de 1 500 $ que l'OCR lit comme 15 000 $ déclenche une erreur de paiement qui nécessite un rapprochement, un suivi auprès du fournisseur et potentiellement une déclaration fiscale corrigée. Une analyse Gennai de 2025 a calculé qu'un système traitant 500 factures avec une précision de 94 % (30 factures avec erreurs) créait 5 heures de travail de correction par lot, tandis qu'un système traitant 400 factures avec une précision de 99 % (4 avec erreurs) ne créait que 40 minutes de nettoyage — malgré un taux de traitement par page plus lent. Le système le plus lent était plus productif en termes de sortie utilisable par heure. Pour les documents fiscaux spécifiquement, l'IRS et la plupart des autorités fiscales exigent une précision de 100 % sur les chiffres déclarés — pas « assez proche ». Une seule erreur de champ dans une déclaration fiscale annuelle peut déclencher un audit, des pénalités et des frais d'intérêt qui éclipsent toute économie de coût de traitement.
Contrats juridiques et documents de conformité. L'extraction de données contractuelles pour la surveillance de la conformité, l'extraction de baux ou les dépôts réglementaires est le domaine où la précision est non négociable. Une date de renouvellement de contrat décalée d'un mois, une clause d'indemnisation mal classifiée ou un plafond de responsabilité mal lu comme 500 000 $ au lieu de 5 000 000 $ crée une exposition juridique qu'aucune vitesse de traitement ne justifie. Pour ces documents, la bonne approche est une extraction optimisée pour la précision avec un score de confiance et un examen humain obligatoire de tout champ à faible confiance. Les modèles de vision-langage — qui lisent le document entier dans son contexte et peuvent interpréter la structure des clauses et les relations sémantiques — sont de plus en plus la norme ici, même à 10 à 15 secondes par page, car le coût d'une seule erreur d'extraction peut dépasser le budget annuel entier de l'outil d'extraction.
Facturation médicale et données patients. L'extraction de documents de santé se situe à l'intersection des exigences de précision et des contraintes réglementaires. Un code CPT mal lu sur un formulaire de réclamation CMS-1500 peut entraîner un refus de réclamation, un retard de paiement ou — dans le pire des cas — une procédure incorrecte facturée au dossier d'un patient. La conformité HIPAA exige à la fois précision et auditabilité. La norme en matière d'extraction de documents médicaux est une précision au niveau du champ supérieure à 98 % avec une traçabilité complète de chaque valeur extraite jusqu'à sa position sur le document source. La vitesse est secondaire ; une réclamation soumise incorrectement coûte plus cher qu'une réclamation soumise en retard.
Transactions transfrontalières et internationales. Les documents qui mélangent les devises, les conventions décimales et les formats de nombres sont particulièrement impitoyables envers l'OCR optimisé pour la vitesse. Une facture européenne affichant « € 1.234,56 » (1 234,56 EUR) traitée par un système formé sur les conventions décimales américaines peut mal lire le montant comme 1,23 € — une erreur de 1 000x. La baisse de précision sur les documents multilingues et multi-formats est bien documentée, et la correction de ces erreurs spécifiques au format nécessite soit un modèle formé sur les formats internationaux, soit des règles de validation post-traitement qui ajoutent de la latence. Dans ce domaine, la précision doit primer car le coût d'une erreur de format n'est pas proportionnel au taux d'erreur de caractères — une virgule mal placée peut faire échouer une transaction.
Règle empirique : Si la vérification humaine d'un seul champ dans votre sortie prend plus de 30 secondes et que vous traitez plus de 200 documents par semaine, optimisez pour la précision — le temps de relecture économisé grâce à moins d'erreurs compensera largement la vitesse d'extraction plus lente. Si la vérification du même champ prend moins de 5 secondes et que les erreurs sont immédiatement évidentes, optimisez pour la vitesse.
Un cadre de décision pratique
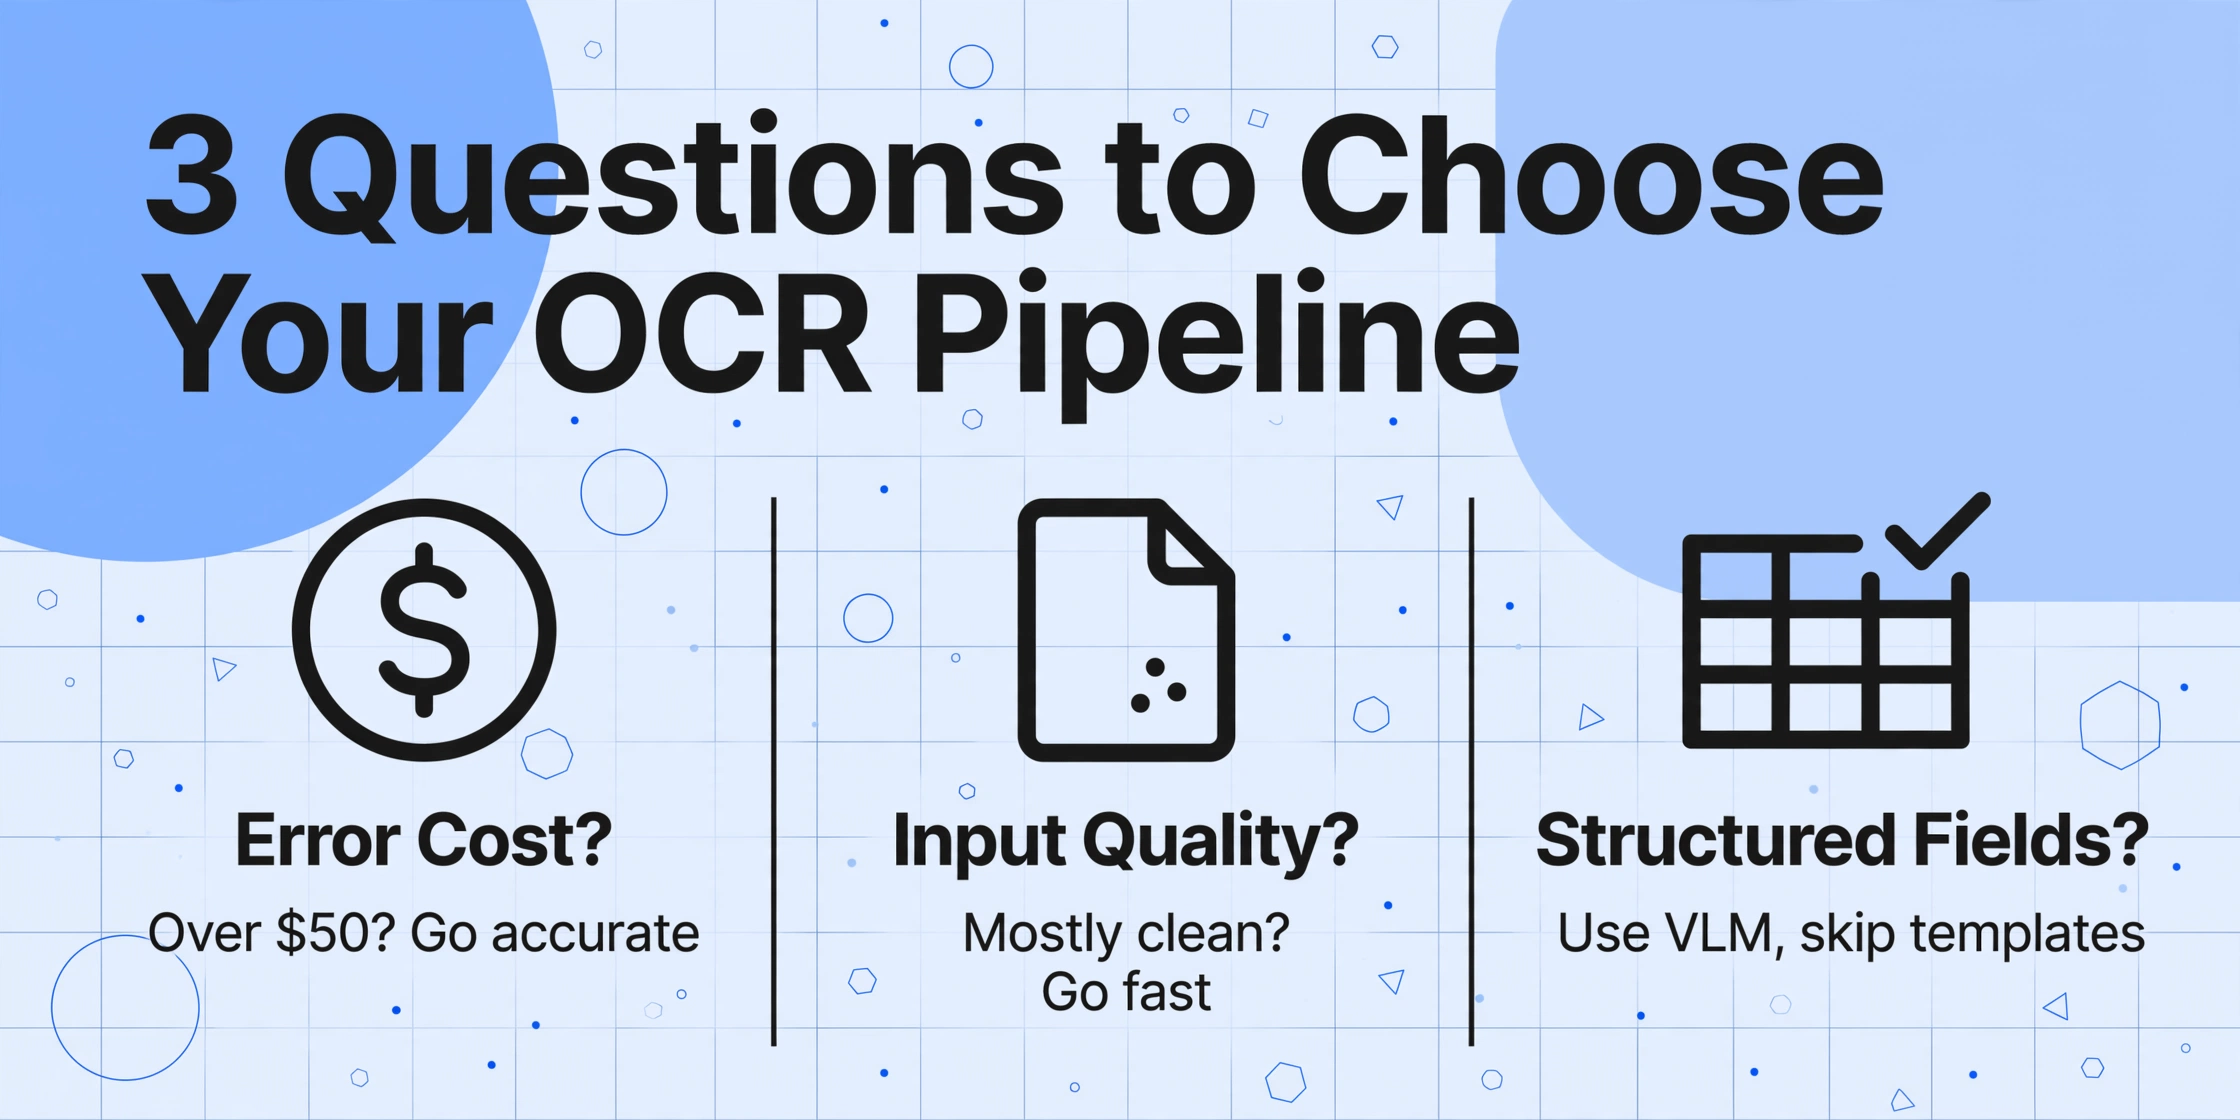
Plutôt que de demander « quel outil OCR est le meilleur », posez-vous ces trois questions sur votre flux de travail, dans l'ordre :
Quel est le coût d'une seule erreur d'extraction dans votre flux de travail ?
Si une seule erreur de lecture coûte plus de 50 $ en corrections, retards en aval ou risque de non-conformité, commencez par un pipeline optimisé pour la précision et acceptez un débit plus lent. Si les erreurs sont détectées rapidement et coûtent peu à corriger, un pipeline priorisant la vitesse est approprié.
Quelle est la distribution de qualité de vos documents d'entrée ?
Si 90 % de vos documents sont des PDF imprimés propres avec des polices standard — Tesseract en mode LSTM à 0,3 seconde par page est probablement suffisant, et vous n'avez qu'à gérer les 10 % restants de cas limites avec un système de secours plus lent et plus précis. Si la majorité sont des photos prises au téléphone de tickets thermiques froissés, commencez par un modèle qui gère bien la dégradation — ce qui signifie accepter une vitesse par page plus lente.
Avez-vous besoin d'une extraction de champs structurés ou simplement de texte brut ?
Extraire des champs spécifiques (total de facture, numéro de bon de commande, numéro d'identification fiscale) à partir de formats arbitraires nécessite une compréhension sémantique — une tâche où les avantages de vitesse de l'OCR traditionnel disparaissent, car le post-traitement nécessaire pour identifier et valider les champs ajoute de la latence, quelle que soit la vitesse de reconnaissance. C'est là que les outils d'extraction sans modèle basés sur VLM comme ImageToTable.ai changent la donne : ils éliminent la configuration et la maintenance de modèles qui ralentissent les pipelines traditionnels, rendant leur traitement de 5 à 10 secondes par page plus rapide en termes de temps de flux de travail total.
Appliquez ce cadre comme un filtre : si la question 1 indique que la précision est prioritaire et que la question 2 confirme une qualité d'entrée hétérogène, écartez entièrement les outils axés sur la vitesse et passez directement à une plateforme conçue pour la précision sur des documents variés. Si la question 1 indique que la vitesse est prioritaire et que la question 2 confirme des entrées propres et uniformes, un pipeline léger basé sur Tesseract ou une API cloud rapide est le bon choix. L'erreur que commettent la plupart des équipes est de ne pas évaluer ces questions dans l'ordre — elles comparent les outils d'abord sur la vitesse, puis découvrent plus tard que leurs exigences de précision les obligent à reconstruire le pipeline.
Comment les modèles vision-langage changent la donne
Le compromis vitesse-précision décrit jusqu'ici s'applique aux architectures OCR traditionnelles — des moteurs qui décomposent la lecture de documents en étapes séquentielles et indépendantes (détection → reconnaissance → post-traitement). Les modèles vision-langage (VLM) abordent le problème différemment : ils lisent le document comme une scène visuelle unique, comprenant la mise en page, le texte et les relations entre champs en un seul passage intégré. La conséquence pratique est que les VLM ne font pas face à la même courbe de compromis vitesse-précision que l'OCR traditionnel.
Là où la précision de Tesseract s'effondre sur des entrées difficiles (50–70 % sur l'écriture manuscrite, par exemple), la précision d'un VLM se dégrade progressivement — de 96 % sur du texte imprimé propre à 85–90 % sur une écriture manuscrite modérée, jusqu'à environ 75–80 % dans le pire des cas. Il n'y a pas de chute brutale. Là où EasyOCR nécessite une accélération GPU pour atteindre des vitesses acceptables sur des documents complexes, un VLM fonctionnant sur CPU peut encore produire des résultats utilisables — plus lentement, mais sans la chute brutale de précision que l'OCR traditionnel présente lorsque le prétraitement est ignoré.
Cela change le cadre décisionnel. Avec un outil basé sur VLM comme ImageToTable.ai, le compromis vitesse-précision n'est plus un choix binaire entre « rapide et faux » ou « lent et juste ». Au lieu de cela, le même modèle sert les deux scénarios : vous pouvez traiter une seule facture en 5–10 secondes avec une précision au niveau des champs dépassant 95 %, ou traiter 50 factures par lots et ne vérifier que les sorties à faible confiance. La cohérence du modèle à travers les qualités de documents — l'absence de chutes de précision — est ce qui rend cela possible. Vous ne choisissez pas entre deux moteurs différents pour le tri rapide et l'extraction de haute précision ; vous choisissez un seul moteur et ajustez le seuil de vérification.
Pour les équipes évaluant des solutions OCR en 2026, le changement important est le suivant : le compromis vitesse-précision est toujours réel, mais la courbe s'est aplatie. Les outils basés sur des modèles vision-langage offrent un plancher de précision plus élevé à chaque point de vitesse que les architectures OCR traditionnelles ne peuvent égaler. La question n'est plus « combien de précision suis-je prêt à sacrifier pour la vitesse ? » mais « combien de latence mon pipeline peut-il tolérer pour atteindre la précision dont j'ai besoin ? » — et la réponse, pour la plupart des flux de travail documentaires, est plus que vous ne le pensez.
Questions fréquemment posées
Q : Puis-je utiliser Tesseract pour l'extraction de documents en production, ou est-il trop imprécis ?
Cela dépend de vos documents et de votre tolérance aux erreurs. Sur des PDF propres, imprimés par machine, avec des polices standard à 300 DPI, Tesseract 5.5 en mode LSTM atteint une précision de caractères de 93 à 97 % — suffisante pour de nombreux flux de travail internes où une faute de frappe occasionnelle n'est pas catastrophique. Sur des photos de reçus prises avec un téléphone portable, des copies carbone numérisées ou des documents manuscrits, la précision chute à 50–80 %, ce qui est probablement trop faible pour une utilisation en production sans une relecture manuelle importante. Pour une comparaison détaillée des outils open source, consultez notre guide des outils OCR open source.
Q : Lequel est le plus rapide — AWS Textract ou Google Cloud Vision OCR ?
Les deux traitent généralement une page en 2 à 4 secondes en mode synchrone, Google étant en moyenne légèrement plus rapide sur les documents simples (1 à 3 secondes) et Textract comparable à 2–4 secondes. En mode batch/asynchrone, les deux services peuvent traiter des centaines de pages par heure. La différence la plus importante n'est pas la vitesse mais le profil de précision : Google Vision excelle sur les documents multilingues et les images bruitées, tandis que Textract offre une extraction de formulaires et de tableaux plus robuste. Pour une comparaison directe des API OCR cloud, consultez notre guide Meilleure API OCR 2026.
Q : De combien le mode « précis » est-il plus lent que le mode « rapide » dans le même outil OCR ?
Le mode LSTM de Tesseract est environ 2 à 5 fois plus lent que le mode hérité sur le même document — 0,3 à 0,8 seconde par page contre 0,1 à 0,3 seconde. Le mode « précis » d'ABBYY FineReader est environ 2 à 2,5 fois plus lent que le mode « rapide ». Le gain de précision est généralement de 5 à 10 points de pourcentage sur les documents difficiles. Certains modes « super précis » exécutent plusieurs moteurs en parallèle et retiennent le meilleur résultat, multipliant le temps de traitement par le nombre de moteurs. L'analyse CVISION des rendements décroissants s'applique ici : chaque réduction de moitié du taux d'erreur nécessite environ 2 fois plus de temps de traitement.
Q : L'accélération GPU élimine-t-elle le compromis vitesse-précision ?
Elle réduit considérablement l'écart mais ne l'élimine pas. PaddleOCR sur un GPU RTX 3090 traite environ 120 pages par minute — environ 5 fois plus vite que sa vitesse CPU et près de 5 fois le débit CPU seul de Tesseract — tout en maintenant la même précision. L'accélération GPU permet aux équipes d'exécuter des modèles OCR d'apprentissage profond à des vitesses comparables à celles des moteurs légers, offrant ainsi à la fois vitesse et précision. Cependant, le coût des GPU, leur disponibilité dans les environnements cloud et la consommation d'énergie sur les appareils de périphérie restent des contraintes. Tous les flux de travail ne disposent pas d'un GPU.
Q : Dois-je optimiser la vitesse ou la précision lors du traitement de factures provenant de plusieurs fournisseurs avec des formats différents ?
La précision. Le principal défi du traitement de factures multi-fournisseurs n'est pas la vitesse de lecture — c'est la variation de format. Un outil OCR basé sur des modèles qui traite chaque facture en 0,5 seconde mais nécessite un modèle distinct par mise en page de fournisseur consacrera bien plus de temps total à la maintenance des modèles qu'au traitement réel. Un outil sans modèle, basé sur un VLM, qui traite chaque facture en 5 à 10 secondes mais gère n'importe quel format sans configuration sera plus rapide en temps de flux de travail total — surtout à mesure que le nombre de fournisseurs augmente. Notre guide sur ce que signifie réellement la précision OCR explique pourquoi la précision au niveau des champs importe plus que la vitesse au niveau des caractères dans les flux de travail multi-formats.
Q : Quand dois-je utiliser une approche hybride — OCR rapide pour le tri et OCR précis pour l'extraction ?
Un pipeline hybride a du sens lorsque vous avez une distribution bimodale de la qualité des documents : un grand volume de documents propres et standardisés (où un passage rapide suffit) mélangé à un plus petit volume de documents complexes ou dégradés (où un traitement optimisé pour la précision est nécessaire). Le tri des documents via Tesseract ou un OCR cloud léger classe chaque document entrant comme « propre » ou « difficile », acheminant les documents propres vers un pipeline d'extraction rapide et les documents difficiles vers un VLM ou une revue humaine. C'est un modèle courant dans les services AP d'entreprise qui traitent à la fois des factures électroniques de grands fournisseurs et des factures papier de petits fournisseurs. Le hic : la logique de routage elle-même doit être très précise, sinon les documents difficiles passent à travers le pipeline rapide et produisent des erreurs.
Faites ce compromis délibérément
Le compromis entre vitesse et précision en OCR n'est pas un problème à résoudre — c'est un paramètre de conception à définir délibérément. Pour chaque flux de traitement de documents, il existe un point d'équilibre correct. L'erreur consiste à laisser les paramètres par défaut du fournisseur ou un seul chiffre de référence prendre la décision à votre place.
La plupart des équipes accordent trop d'importance à la vitesse lors de l'évaluation, car la vitesse est facile à mesurer (un chiffre, une exécution, un chronomètre) alors que la précision ne l'est pas (elle varie selon le type de document, la qualité, le champ et la définition de l'erreur). Un processus d'évaluation honnête évalue la précision sur les documents réels que vous traitez — y compris les plus complexes — et mesure le temps total du flux, pas seulement la latence de l'OCR. Ce total inclut le temps passé à corriger les erreurs, là où l'OCR « rapide » perd son avantage.
Les modèles de vision-langage ont aplati la courbe de précision, rendant une haute précision accessible à des vitesses acceptables pour la plupart des flux de documents professionnels. Si la précision est votre contrainte — et pour la plupart des cas d'extraction de documents, elle devrait l'être — un outil basé sur un VLM qui traite une page en 5 à 10 secondes et offre une précision au niveau des champs supérieure à 95 % est un meilleur choix qu'un outil qui traite la même page en 0,2 seconde et vous laisse vérifier une valeur sur cinq.
Testez ce compromis sur vos documents réels. Voyez ce que représentent 5 secondes par page lorsque les erreurs qui prenaient des minutes à trouver n'existent tout simplement plus.