OCR-Geschwindigkeit vs. Genauigkeit:
Der Kompromiss, den kein Anbieter erklärt
Jeder OCR-Anbieter sagt Ihnen, sein Tool sei „schnell" und „genau" – als ob beide Eigenschaften auf derselben Achse lägen und Sie beides automatisch bekämen. Die Realität ist das Gegenteil: Geschwindigkeit und Genauigkeit stehen in jeder OCR-Pipeline in direktem Spannungsverhältnis – von einer kostenlosen Open-Source-Bibliothek auf einem Laptop bis hin zu einer Cloud-API mit Tausenden GPUs. Eine Tesseract-Instanz, die auf maximale Geschwindigkeit konfiguriert ist, verarbeitet eine Seite in 0,16 Sekunden, liest aber 1 von 8 Wörtern falsch. Ein Vision-KI-Modell, das dieselbe Seite mit nahezu perfekter Genauigkeit liest, benötigt 30 bis 60 Mal länger. Was ist für Ihren Workflow das Richtige? Die Antwort hängt davon ab, was Sie verarbeiten, was Sie bauen und was ein einziges falsches Zeichen Sie kostet. Die meisten Anbieter überspringen diese Frage, weil die ehrliche Antwort – „es kommt darauf an" – nicht in eine Vergleichstabelle passt.
Die wichtigsten Erkenntnisse
- Tesseract liest eine Seite in 0,16 Sekunden und übersieht 1 von 8 Wörtern – diese 0,16-Sekunden-Geschwindigkeit erzeugt fünf Minuten Korrekturaufwand pro Dokument, und kein Anbieter-Benchmark zählt das.
- OCR-Benchmarks messen die Latenz am falschen Kontrollpunkt – der eigentliche Engpass ist nicht, wie schnell die Engine eine Seite liest, sondern wie schnell Sie beheben, was sie falsch gelesen hat.
- Vision-Sprachmodelle flachen die Kurve ab – Sie wählen nicht mehr zwischen einer schnellen-falschen und einer langsamen-richtigen Engine, sondern eine Engine und passen an, wie sehr Sie der Ausgabe vertrauen.
Warum Geschwindigkeit und Genauigkeit in umgekehrtem Verhältnis zueinander stehen
Der Kompromiss zwischen Geschwindigkeit und Genauigkeit ist keine Einschränkung eines bestimmten Tools – er ist eine Konsequenz der architektonischen Funktionsweise von OCR. Jedes OCR-System, ob eine veraltete Mustererkennungs-Engine oder ein modernes Vision-Language-Modell, folgt einer Abfolge von Schritten: Bildvorverarbeitung, Texterkennung, Zeichenerkennung und Nachbearbeitung. Jeder Schritt verbraucht Rechenressourcen, und je gründlicher jeder Schritt ausgeführt wird, desto genauer ist das Ergebnis – und desto länger dauert es.
Tiefe der Vorverarbeitung. Eine geschwindigkeitsoptimierte OCR-Pipeline überspringt oder minimiert die Vorverarbeitung: Sie verkleinert das Bild, um die Pixelanzahl zu reduzieren, wendet einen einfachen Binarisierungsschwellenwert an und übergibt das Ergebnis direkt an den Erkerner. Unabhängige Benchmarks zeigen, dass das Überspringen von Vorverarbeitungsschritten wie Schräglagenkorrektur, Rauschunterdrückung und Kontrastverbesserung die Verarbeitungszeit um 40–60 % verkürzen kann – aber auch die Genauigkeit bei unvollkommenen Eingaben um 10–20 Prozentpunkte senkt. Die Standardempfehlung in der OCR-Literatur – mindestens 300 DPI, adaptive Binarisierung, geometrische Korrektur – ist selbst ein Kompromiss zwischen Geschwindigkeit und Genauigkeit. Bei 300 DPI umfasst ein 10-Punkt-Zeichen etwa 42 Pixel, was dem Erkerner genügend Auflösung bietet, um feine Striche zu unterscheiden. Unter 150 DPI sinkt die Genauigkeit bei jeder getesteten Engine stark ab. Über 300 DPI flacht der Genauigkeitszuwachs ab, während Dateigröße und Verarbeitungszeit weiter steigen.
Modellkomplexität. Hier wird der Kompromiss am sichtbarsten. Die Legacy-Engine von Tesseract verwendet handgefertigte Merkmalsextraktion – sie gleicht Zeichenformen anhand vorkomputierter Klassifikatoren gegen eine Bibliothek von Vorlagen ab. Das ist schnell (0,1–0,3 Sekunden pro Seite auf einer modernen CPU), aber spröde: Die Genauigkeit bei anspruchsvollen Eingaben wie Handyfotos sinkt auf etwa 70–80 %. Die LSTM-Engine von Tesseract 4 fügt eine neuronale Netzwerkschicht hinzu, die Zeichen im Sequenzkontext liest, was die Genauigkeit bei verrauschten Dokumenten um 5–15 Prozentpunkte verbessert und die Verarbeitungszeit etwa verdoppelt. Moderne Deep-Learning-OCR-Engines wie PaddleOCR und EasyOCR ersetzen die gesamte Pipeline durch neuronale Netze – CNN-basierte Texterkennung gefolgt von aufmerksamkeitsbasierter Sequenzerkennung. Diese Modelle erreichen deutlich höhere Genauigkeit (insbesondere bei komplexen Layouts und Handschrift), benötigen aber 3–30-mal mehr Rechenleistung pro Seite. Ein Benchmark von Codesota vom März 2026 maß Folgendes an einer einzelnen Rechnung: Tesseract 5.5 bei 0,162 Sekunden mit 87,5 % Genauigkeit, EasyOCR bei 0,656 Sekunden mit 62,5 % Genauigkeit und PaddleOCR bei 4,85 Sekunden mit 100 % Genauigkeit. Die Korrelation ist nicht perfekt – PaddleOCR dominierte bei diesem spezifischen Test –, aber das Muster über Dokumenttypen hinweg ist klar: Je tiefer das Modell, desto langsamer und genauer tendenziell.
Nachbearbeitungskette. Genauigkeitsoptimierte Pipelines fügen Validierungsschritte nach der Erkennung hinzu: wörterbuchbasierte Rechtschreibkorrektur, feldübergreifende Konsistenzprüfungen (stimmt die Rechnungssumme mit der Summe der Positionen überein?), Formatvalidierung (lässt sich das Datum korrekt parsen?) und Konfidenzschwellenwert-Routing mit menschlicher Kontrolle. Jeder Schritt fügt Latenz hinzu. Eine minimale OCR, die Rohtext in 0,2 Sekunden ausgibt, kann 2–3 zusätzliche Sekunden Nachbearbeitung benötigen, um Produktionsqualität zu erreichen. Die gesamte Systemlatenz – nicht nur der Erkennungsschritt – bestimmt den realen Durchsatz.
Die Geschwindigkeitslandschaft: Wie die Zahlen tatsächlich aussehen
Die reine Verarbeitungsgeschwindigkeit variiert um zwei Größenordnungen, abhängig von der OCR-Engine, der Hardware und der Dokumentkomplexität. Die folgende Tabelle fasst veröffentlichte Benchmarks aus mehreren unabhängigen Quellen zu Bereichen zusammen, die reale Produktionsbedingungen widerspiegeln – nicht ausgesuchte Best-Case-Läufe.
| Engine / API | Geschwindigkeit (pro Seite, CPU) | Geschwindigkeit (GPU) | Genauigkeit (sauber gedruckt) | Genauigkeit (anspruchsvoll) |
|---|---|---|---|---|
| Tesseract 5.5 (Legacy-Modus) | 0,1–0,3s | N/A (nur CPU) | 90–96% | 50–70% |
| Tesseract 5.5 (LSTM-Modus) | 0,3–0,8s | N/A (nur CPU) | 93–97% | 60–80% |
| EasyOCR | 0,6–2,5s | 0,2–0,8s | 90–95% | 55–75% |
| Google Cloud Vision OCR | 1–3s (API) | — | 96–99% | 75–85% |
| AWS Textract | 2–4s (API) | — | 95–98% | 78–85% |
| Azure Document Intelligence | 3–5s (API) | — | 96–99% | 80–88% |
| PaddleOCR | 3–6s | ~0,5s (120 Seiten/min) | 95–99% | 75–88% |
| Vision-Language-Modell (VLM) | 5–15s | 2–6s | 96–99% | 85–95% |
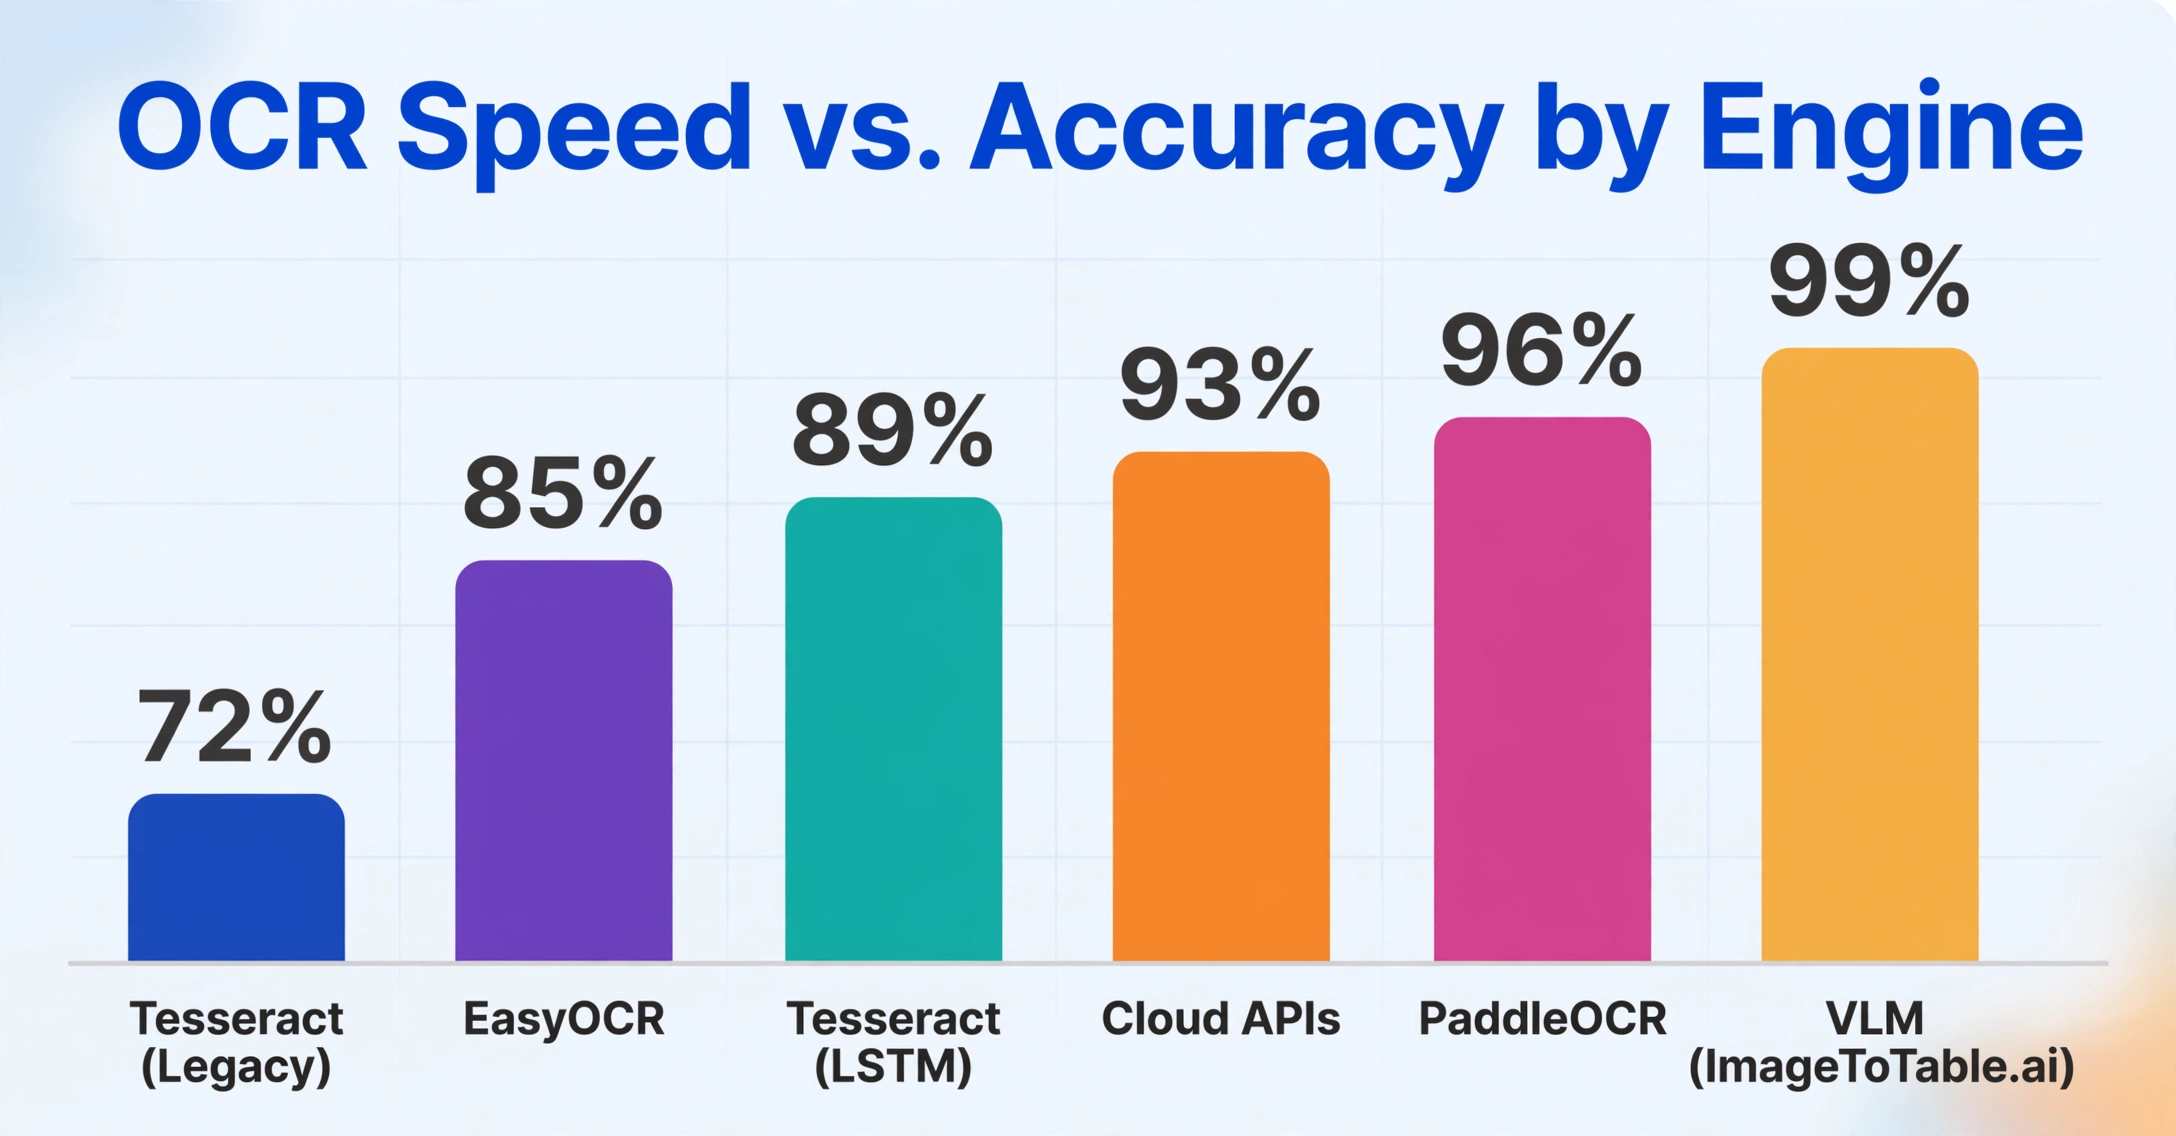
Quellen: Codesota (März 2026), AIMultiple DeltOCR Bench (Jan. 2026), GigaGPU PaddleOCR-Benchmark, offizielle AWS/Azure/Google-Dokumentation. „Anspruchsvoll“ umfasst Scans mit niedriger Auflösung, Handyfotos und Dokumente mit gemischten Layouts. Die VLM-Kategorie repräsentiert Tools wie ImageToTable.ai und Qwen-VL.
Die wichtigste Erkenntnis aus diesen Zahlen: Die Beziehung zwischen Geschwindigkeit und Genauigkeit ist keine glatte Kurve. Sie hat Wendepunkte. Tesseract bietet Ihnen Geschwindigkeit, stößt aber bei unvollkommenen Dokumenten an eine harte Genauigkeitsgrenze. Cloud-APIs bieten eine höhere Grenze bei moderater Latenz. VLMs verschieben die Grenze am weitesten nach oben, benötigen aber die meiste Zeit pro Seite. Die Wahl zwischen ihnen bedeutet zu wissen, an welchem Wendepunkt Ihre Dokumente und Ihre Fehlertoleranz Sie positionieren.
Die praktische Erkenntnis: Tesseract verarbeitet eine Rechnung in der Zeit, die ein Mensch zum Blinzeln braucht. Aber wenn diese Rechnung ein Handyfoto eines zerknitterten Handwerkerbelegs ist, kann die 0,16-Sekunden-Extraktion eine Fehlerquote von 20–30 % aufweisen – und die Korrektur dieser Fehler in Ihrem Buchhaltungssystem dauert Minuten pro Dokument. Die schnelle Extraktion erzeugt langsame Folgearbeit.
Wenn Geschwindigkeit wichtiger ist
Nicht jeder Dokumenten-Workflow erfordert Perfektion auf Feldebene. Mehrere reale Szenarien priorisieren zu Recht den Durchsatz gegenüber der Zeichengenauigkeit – und die Anbieter, die nur mit „99 % Genauigkeit“ werben, tun ihren Nutzern einen Bärendienst, indem sie diese Fälle nicht anerkennen.
Echtzeit-Scannen am Point of Sale. Ein Einzelhandels-Kassensystem, das eine Quittung scannt, um einen Preis nachzuschlagen oder eine Rückgabe zu validieren, benötigt eine Antwort in unter einer Sekunde. Wenn die OCR ein Zeichen bei einem Produktnamen falsch liest, das Inventarsystem aber durch Fuzzy-Matching dennoch die richtige SKU findet, wird die Transaktion ohne Unterbrechung abgeschlossen. Geschwindigkeit ist die bindende Einschränkung; das System verarbeitet Hunderte von Transaktionen pro Stunde, und zusätzliche 3 Sekunden pro Scan würden eine Warteschlange an der Kasse erzeugen. Für diese Szenarien ist Tesseracts Legacy-Modus oder eine leichte Cloud-API mit aggressiven Timeouts die richtige Wahl – selbst wenn das bedeutet, eine Zeichenfehlerquote von 2–5 % zu akzeptieren.
Dokumenten-Triage und -Routing. Viele Dokumentenverarbeitungspipelines müssen ein eingehendes Dokument klassifizieren (ist das eine Rechnung, eine Bestellung oder ein Lieferschein?), bevor sie es an den richtigen nachgelagerten Prozessor weiterleiten. Der Klassifizierungsschritt erfordert das Extrahieren von gerade genug Text, um den Dokumenttyp zu identifizieren – typischerweise Kopfzeile, Titel oder ein paar Schlüsselfelder – nicht jedes Zeichen auf der Seite. Ein schneller OCR-Durchlauf, der 95 % der Dokumenttypen in 0,2 Sekunden pro Seite korrekt identifiziert, ist wertvoller als ein langsamer OCR-Durchlauf, der 98 % in 5 Sekunden pro Seite korrekt identifiziert, weil die 3 % falsch klassifizierten Dokumente in der menschlichen Prüfphase aufgefangen werden können. Google Cloud Vision OCR, mit seiner 1–3-Sekunden-Latenz und breiter Sprachunterstützung, ist eine häufige Wahl für diese Routing-Ebene.
Hochvolumige Archivierung mit durchsuchbarem Text. Wenn das Ziel darin besteht, Millionen von Seiten in einem Dokumentenmanagementsystem durchsuchbar zu machen – statt spezifische Datenfelder zu extrahieren – ist die Genauigkeitsschwelle niedriger. Ein von Tesseract erzeugtes durchsuchbares PDF mit 90 % Zeichengenauigkeit ermöglicht es Nutzern dennoch, die meisten Dokumente über die Stichwortsuche zu finden, weil ein Dokument mit „Invoice #12345“ auch dann gefunden wird, wenn Tesseract auf einigen Seiten „Invoice #1234S“ liest. Der Kostendifferenz zwischen einer schnellen OCR-Pipeline (Tausende von Seiten pro Stunde auf einem einzelnen Server) und einer langsamen (Hunderte von Seiten pro Stunde) entscheidet, ob das Archivierungsprojekt überhaupt machbar ist.
Mobile OCR auf batteriebetriebenen Geräten. Das Ausführen eines Deep-Learning-OCR-Modells auf einem Smartphone oder Handscanner erfordert ein Abwägen zwischen Genauigkeit und Akkuverbrauch sowie Wärmeentwicklung. EasyOCR auf einem modernen Smartphone benötigt bei GPU-Beschleunigung etwa 0,2–0,8 Sekunden pro Bild, allerdings auf Kosten eines erheblichen Stromverbrauchs. Für Außendienstmitarbeiter, die Hunderte von Etiketten pro Schicht scannen, ist ein leichteres Modell, das 5 % Genauigkeit opfert, um die Akkulaufzeit zu verdoppeln, die richtige betriebliche Wahl.
Wenn Genauigkeit entscheidend ist
Jedes oben genannte Szenario hat eines gemeinsam: Die Kosten eines einzelnen Fehlers sind gering oder leicht zu verkraften. Wenn man diese Annahme umdreht, kehrt sich der Kompromiss vollständig um.
Steuer- und Finanzdokumente. Eine einzelne falsch gelesene Ziffer in einer Umsatzsteuererklärung, einem W-2-Lohnfeld oder einem Rechnungsbetrag führt zu einem Problem mit Folgewirkungen. Der Rechnungsbetrag von 1.500 $, den die OCR als 15.000 $ liest, löst einen Zahlungsfehler aus, der einen Abgleich, die Nachverfolgung mit dem Lieferanten und möglicherweise eine korrigierte Steuererklärung erfordert. Eine Gennai-Analyse aus dem Jahr 2025 berechnete, dass ein System, das 500 Rechnungen mit 94 % Genauigkeit verarbeitet (30 Rechnungen mit Fehlern), 5 Stunden Korrekturaufwand pro Batch erzeugt, während ein System, das 400 Rechnungen mit 99 % Genauigkeit verarbeitet (4 mit Fehlern), nur 40 Minuten Bereinigung erfordert – trotz der langsameren Verarbeitung pro Seite. Das langsamere System war in Bezug auf den nutzbaren Output pro Stunde produktiver. Bei Steuerdokumenten im Besonderen erwarten der IRS und die meisten Steuerbehörden 100 % Genauigkeit bei den gemeldeten Zahlen – nicht „ungefähr richtig“. Ein einzelner Feld Fehler in einer jährlichen Steuererklärung kann eine Prüfung, Strafen und Zinsbelastungen auslösen, die alle Kosteneinsparungen durch die Verarbeitung bei weitem übersteigen.
Rechtsverträge und Compliance-Dokumente. Die Extraktion von Vertragsdaten für Compliance-Überwachung, Lease-Abstraktion oder regulatorische Einreichungen ist der Bereich, in dem Genauigkeit nicht verhandelbar ist. Ein Vertragsverlängerungsdatum, das um einen Monat abweicht, eine falsch klassifizierte Freistellungsklausel oder eine Haftungsobergrenze, die als 500.000 $ statt 5.000.000 $ gelesen wird, schafft ein rechtliches Risiko, das keine noch so hohe Verarbeitungsgeschwindigkeit rechtfertigt. Für diese Dokumente ist der richtige Ansatz eine auf Genauigkeit optimierte Extraktion mit Konfidenzbewertung und obligatorischer menschlicher Überprüfung jedes Feldes mit niedriger Konfidenz. Vision-Language-Modelle – die das gesamte Dokument im Kontext lesen und Klauselstrukturen sowie semantische Beziehungen interpretieren können – werden hier zunehmend zum Standard, selbst bei 10–15 Sekunden pro Seite, weil die Kosten eines einzigen Extraktionsfehlers das gesamte Jahresbudget des Extraktionstools übersteigen können.
Medizinische Abrechnung und Patientendaten. Die Extraktion aus Gesundheitsdokumenten liegt an der Schnittstelle von Genauigkeitsanforderungen und regulatorischen Beschränkungen. Ein falsch gelesener CPT-Code auf einem CMS-1500-Antragsformular kann zu einer abgelehnten Forderung, verzögerten Zahlung oder – im schlimmsten Fall – zu einem falschen Eingriff in der Patientenakte führen. Die HIPAA-Konformität erfordert sowohl Genauigkeit als auch Prüfbarkeit. Der Standard bei der medizinischen Dokumentextraktion ist eine Feldgenauigkeit von über 98 % mit vollständiger Rückverfolgbarkeit jedes extrahierten Werts zu seiner Position im Quelldokument. Geschwindigkeit ist zweitrangig; eine falsch eingereichte Forderung ist teurer als eine verspätet eingereichte.
Transaktionen mit mehreren Währungen und internationalen Bezügen. Dokumente, die Währungen, Dezimalkonventionen und Zahlenformate mischen, verzeihen eine geschwindigkeitsoptimierte OCR besonders wenig. Eine europäische Rechnung mit „€ 1.234,56“ (1.234,56 EUR), die von einem auf US-Dezimalkonventionen trainierten System verarbeitet wird, kann den Betrag als €1,23 fehlinterpretieren – ein Fehler um den Faktor 1.000. Der Genauigkeitsabfall bei mehrsprachigen und mehrformatigen Dokumenten ist gut dokumentiert, und die Korrektur dieser formatspezifischen Fehler erfordert entweder ein Modell, das auf internationale Formate trainiert wurde, oder Validierungsregeln für die Nachbearbeitung, die die Latenzzeit erhöhen. In diesem Bereich muss Genauigkeit gewinnen, weil die Kosten eines Formatfehlers nicht proportional zur Zeichenfehlerrate sind – ein einziger falsch gesetzter Dezimalpunkt kann eine Transaktion zunichtemachen.
Faustregel: Wenn eine Person mehr als 30 Sekunden benötigt, um ein einzelnes Feld in Ihrer Ausgabe manuell zu prüfen, und Sie mehr als 200 Dokumente pro Woche verarbeiten, optimieren Sie auf Genauigkeit – die durch weniger Fehler eingesparte Prüfzeit gleicht die langsamere Extraktionsgeschwindigkeit mehr als aus. Wenn die Prüfung desselben Felds weniger als 5 Sekunden dauert und Fehler sofort offensichtlich sind, optimieren Sie auf Geschwindigkeit.
Ein praktischer Entscheidungsrahmen
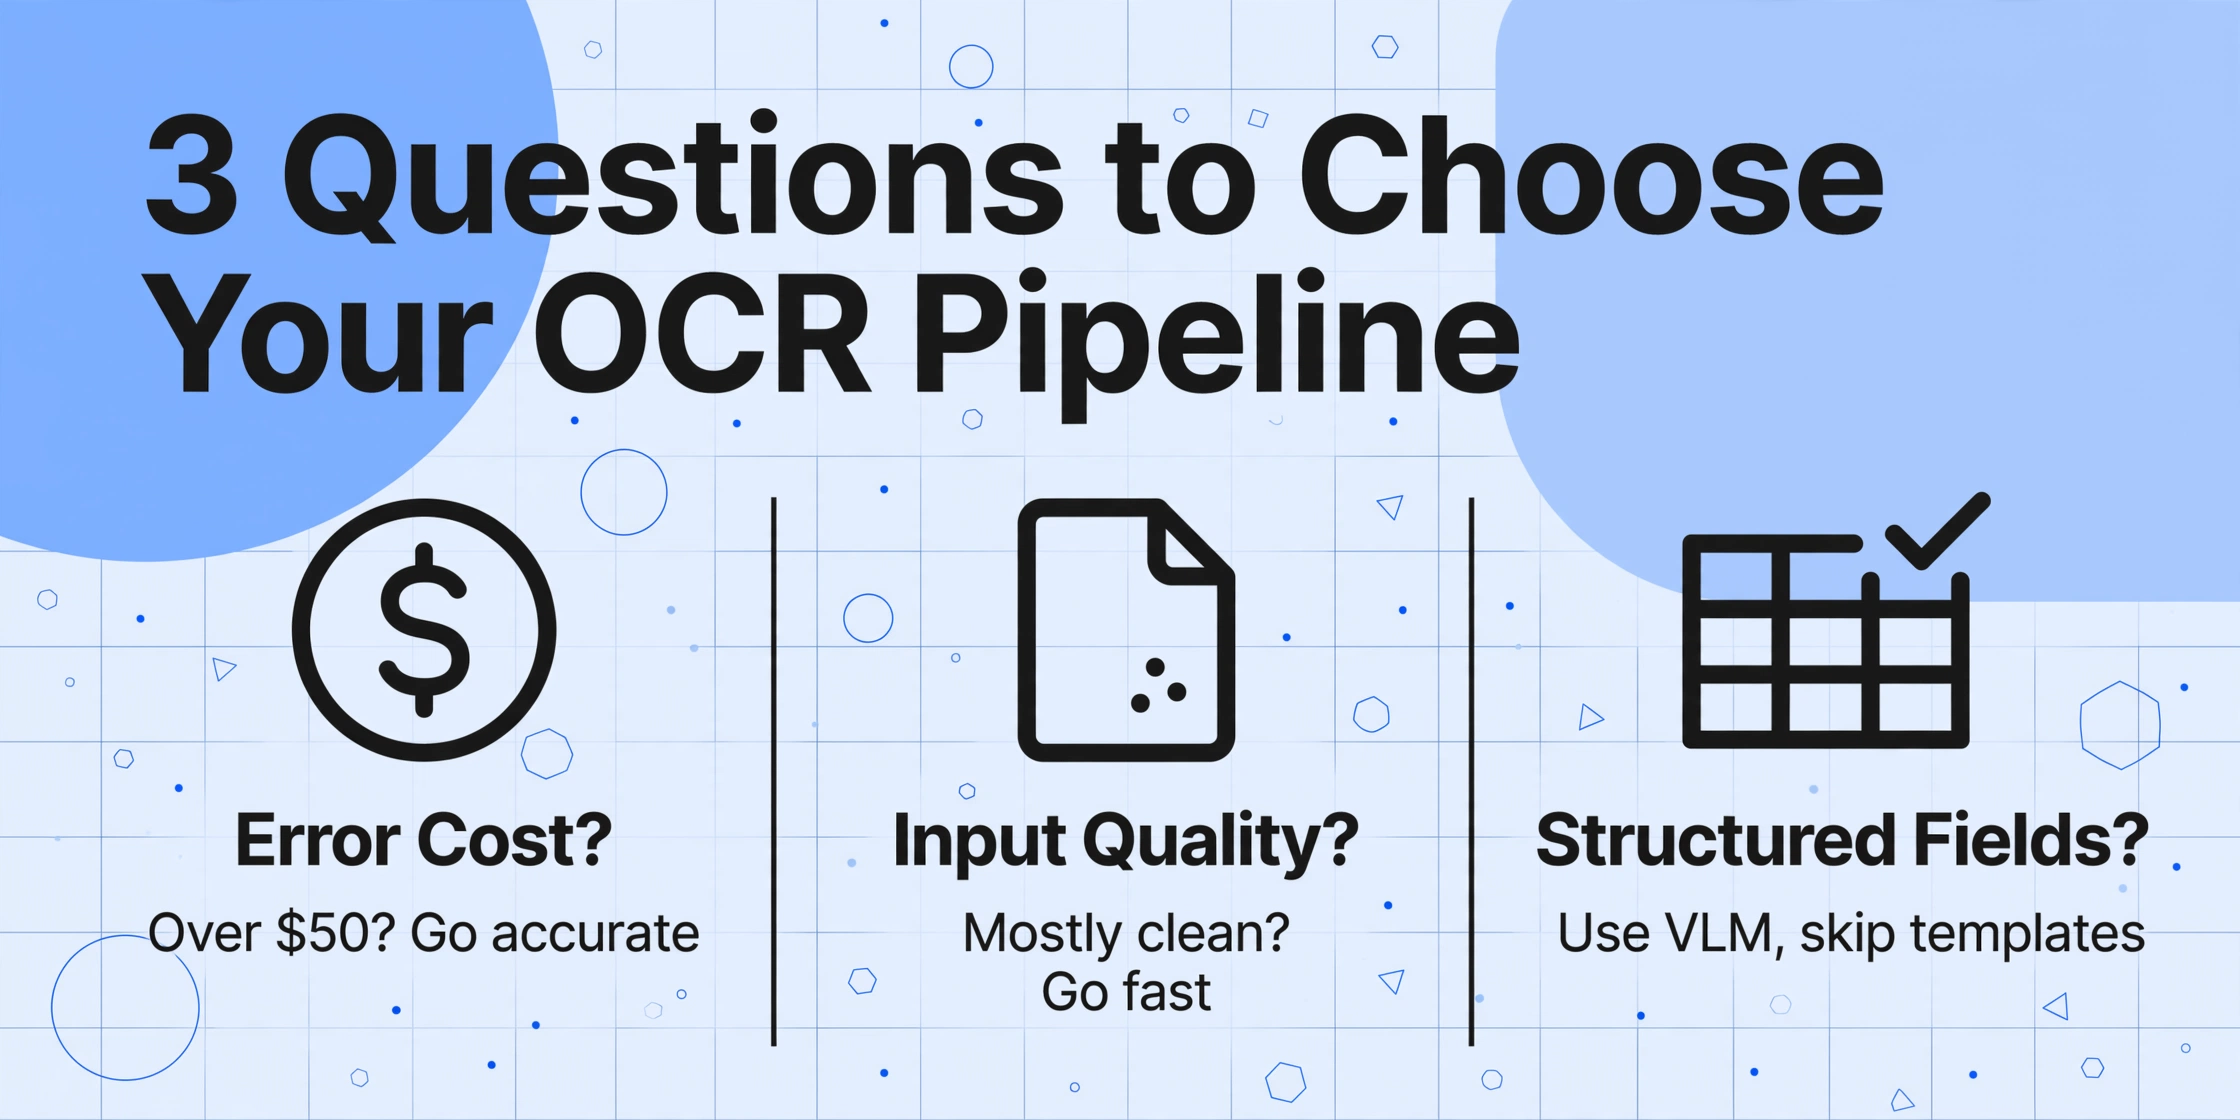
Stellen Sie sich statt der Frage „Welches OCR-Tool ist am besten?“ der Reihe nach diese drei Fragen zu Ihrem Workflow:
Wie hoch sind die Kosten eines einzelnen Extraktionsfehlers in Ihrem Workflow?
Wenn ein einziges falsch gelesenes Feld mehr als $50 an Korrekturen, nachgelagerten Verzögerungen oder Compliance-Risiko verursacht, beginnen Sie mit einer auf Genauigkeit optimierten Pipeline und akzeptieren Sie einen langsameren Durchsatz. Wenn Fehler schnell erkannt werden und wenig kosten, ist eine geschwindigkeitsorientierte Pipeline geeignet.
Wie ist die Qualitätsverteilung Ihrer Eingabedokumente?
Wenn 90% Ihrer Dokumente saubere, gedruckte PDFs mit Standard-Schriftarten sind, ist Tesseract im LSTM-Modus mit 0,3 Sekunden pro Seite wahrscheinlich ausreichend, und Sie müssen nur die restlichen 10% der Randfälle mit einem langsameren, genaueren Fallback-System abdecken. Wenn es sich bei der Mehrheit um Handyfotos von zerknitterten Thermo-Bons handelt, beginnen Sie mit einem Modell, das mit schlechter Qualität gut umgeht – das bedeutet, Sie akzeptieren eine langsamere Geschwindigkeit pro Seite.
Benötigen Sie eine strukturierte Feldextraktion oder nur Rohtext?
Das Extrahieren bestimmter Felder (Rechnungssumme, Bestellnummer, Steuer-ID) aus beliebigen Formaten erfordert semantisches Verständnis – eine Aufgabe, bei der die Geschwindigkeitsvorteile der traditionellen OCR verschwinden, da die für die Identifizierung und Validierung von Feldern erforderliche Nachbearbeitung unabhängig von der Erkennungsgeschwindigkeit Latenz hinzufügt. Hier verändern ohne Vorlage arbeitende, VLM-basierte Extraktionstools wie ImageToTable.ai die Gleichung: Sie eliminieren die Vorlageneinrichtung und -wartung, die traditionelle Pipelines verlangsamen, und machen ihre Verarbeitung von 5–10 Sekunden pro Seite in der Gesamtworkflow-Zeit netto schneller.
Wenden Sie dieses Framework als Filter an: Wenn Frage 1 auf Genauigkeit abzielt und Frage 2 bestätigt, dass Sie heterogene Eingabequalität haben, überspringen Sie die geschwindigkeitsorientierten Tools vollständig und gehen Sie direkt zu einer Plattform, die für Genauigkeit bei unterschiedlichen Dokumenten ausgelegt ist. Wenn Frage 1 auf Geschwindigkeit abzielt und Frage 2 saubere, einheitliche Eingaben bestätigt, ist eine schlanke Pipeline auf Basis von Tesseract oder einer schnellen Cloud-API die richtige Wahl. Der Fehler, den die meisten Teams machen, ist, diese Fragen nicht in der richtigen Reihenfolge zu bewerten – sie benchmarken Tools zuerst auf Geschwindigkeit und stellen später fest, dass ihre Genauigkeitsanforderungen sie zwingen, die Pipeline neu aufzubauen.
Wie Vision-Language-Modelle die Gleichung verändern
Der bisher beschriebene Geschwindigkeits-Genauigkeits-Kompromiss gilt für traditionelle OCR-Architekturen – Engines, die das Dokumentlesen in sequenzielle, unabhängige Schritte zerlegen (Erkennung → Erkennung → Nachbearbeitung). Vision-Language-Modelle (VLMs) gehen das Problem anders an: Sie lesen das Dokument als eine einzige visuelle Szene und verstehen Layout, Text und Feldbeziehungen in einem integrierten Durchgang. Die praktische Konsequenz ist, dass VLMs nicht derselben Geschwindigkeits-Genauigkeits-Kompromisskurve wie traditionelle OCR folgen.
Wo die Genauigkeit von Tesseract bei anspruchsvollen Eingaben einbricht (z. B. 50–70 % bei Handschrift), verschlechtert sich die Genauigkeit eines VLM allmählich – von 96 % bei sauberem gedrucktem Text auf 85–90 % bei mäßiger Handschrift bis zu etwa 75–80 % im schlechtesten Fall. Es gibt keinen abrupten Abfall. Wo EasyOCR GPU-Beschleunigung benötigt, um bei komplexen Dokumenten akzeptable Geschwindigkeiten zu erreichen, kann ein VLM auf der CPU immer noch brauchbare Ergebnisse liefern – langsamer, aber ohne den starken Genauigkeitsabfall, den traditionelle OCR zeigt, wenn die Vorverarbeitung übersprungen wird.
Dies verändert das Entscheidungsframework. Mit einem VLM-basierten Tool wie ImageToTable.ai ist der Geschwindigkeits-Genauigkeits-Kompromiss keine binäre Wahl mehr zwischen „schnell und falsch“ oder „langsam und richtig“. Stattdessen bedient dasselbe Modell beide Szenarien: Sie können eine einzelne Rechnung in 5–10 Sekunden mit Feldgenauigkeit von über 95 % verarbeiten oder 50 Rechnungen im Batch verarbeiten und nur die Ausgaben mit geringer Konfidenz prüfen. Die Konsistenz des Modells über Dokumentqualitäten hinweg – das Fehlen von Genauigkeitsabfällen – macht dies möglich. Sie wählen nicht zwischen zwei verschiedenen Engines für schnelle Triage und hochgenaue Extraktion; Sie wählen eine Engine und passen die Prüfschwelle an.
Für Teams, die 2026 OCR-Lösungen evaluieren, ist die wichtige Verschiebung diese: Der Geschwindigkeits-Genauigkeits-Kompromiss ist weiterhin real, aber die Kurve hat sich abgeflacht. Tools, die auf Vision-Language-Modellen basieren, liefern bei jedem Geschwindigkeitspunkt eine höhere Genauigkeitsuntergrenze, als traditionelle OCR-Architekturen erreichen können. Die Frage ist nicht mehr „Wie viel Genauigkeit bin ich bereit, für Geschwindigkeit zu opfern?“, sondern „Wie viel Latenz kann meine Pipeline tolerieren, um die Genauigkeit zu erreichen, die ich brauche?“ – und die Antwort ist für die meisten Dokument-Workflows mehr, als Sie denken.
Häufig gestellte Fragen
F: Kann ich Tesseract für die Dokumentextraktion in der Produktion verwenden, oder ist es zu ungenau?
Das hängt von Ihren Dokumenten und Ihrer Fehlertoleranz ab. Bei sauberen, maschinengedruckten PDFs mit Standard-Schriftarten bei 300 DPI erreicht Tesseract 5.5 im LSTM-Modus eine Zeichengenauigkeit von 93–97 % – ausreichend für viele interne Arbeitsabläufe, bei denen der gelegentliche Tippfehler nicht katastrophal ist. Bei Fotos von Quittungen, gescannten Durchschlägen oder Dokumenten mit Handschrift sinkt die Genauigkeit auf 50–80 %, was für den Produktionseinsatz ohne erheblichen manuellen Prüfaufwand wahrscheinlich zu niedrig ist. Für einen detaillierten Vergleich von Open-Source-Tools lesen Sie unseren Leitfaden zu Open-Source-OCR-Tools.
F: Was ist schneller – AWS Textract oder Google Cloud Vision OCR?
Beide verarbeiten eine einzelne Seite im synchronen Modus typischerweise in 2–4 Sekunden, wobei Google bei einfachen Dokumenten im Durchschnitt etwas schneller ist (1–3 Sekunden) und Textract mit 2–4 Sekunden vergleichbar ist. Im Batch-/asynchronen Modus können beide Dienste Hunderte von Seiten pro Stunde verarbeiten. Der größere Unterschied liegt nicht in der Geschwindigkeit, sondern im Genauigkeitsprofil: Google Vision zeichnet sich bei mehrsprachigen Dokumenten und verrauschten Bildern aus, während Textract eine stärkere Formular- und Tabellenextraktion bietet. Für einen direkten Vergleich von Cloud-OCR-APIs lesen Sie unseren Best-OCR-API-2026-Leitfaden.
F: Wie viel langsamer ist der „genaue“ Modus im Vergleich zum „schnellen“ Modus im selben OCR-Tool?
Der LSTM-Modus von Tesseract ist bei demselben Dokument etwa 2–5x langsamer als der Legacy-Modus – 0,3–0,8 Sekunden pro Seite gegenüber 0,1–0,3 Sekunden. Der „genaue“ Modus von ABBYY FineReader läuft etwa 2–2,5x langsamer als der „schnelle“ Modus. Der Genauigkeitsgewinn beträgt bei anspruchsvollen Dokumenten typischerweise 5–10 Prozentpunkte. Einige „supergenaue“ Modi von Tools führen mehrere Engines parallel aus und nehmen das beste Ergebnis, was die Verarbeitungszeit mit der Anzahl der Engines multipliziert. Die CVISION-Analyse des abnehmenden Ertrags gilt auch hier: Jede Halbierung der Fehlerrate erfordert etwa die 2-fache Verarbeitungszeit.
F: Beseitigt GPU-Beschleunigung den Geschwindigkeits-Genauigkeits-Kompromiss?
Sie verringert die Lücke erheblich, beseitigt sie aber nicht. PaddleOCR auf einer RTX 3090 GPU verarbeitet ~120 Seiten pro Minute – etwa 5x schneller als die CPU-Geschwindigkeit und fast 5x den reinen CPU-Durchsatz von Tesseract – bei gleicher Genauigkeit. GPU-Beschleunigung ermöglicht es Teams, Deep-Learning-OCR-Modelle mit Geschwindigkeiten auszuführen, die mit leichtgewichtigen Engines vergleichbar sind, und so effektiv sowohl Geschwindigkeit als auch Genauigkeit zu haben. GPU-Kosten, Verfügbarkeit in Cloud-Umgebungen und Stromverbrauch auf Edge-Geräten bleiben jedoch Einschränkungen. Nicht jeder Arbeitsablauf hat eine GPU zur Verfügung.
F: Sollte ich bei der Verarbeitung von Rechnungen mehrerer Lieferanten mit unterschiedlichen Formaten auf Geschwindigkeit oder Genauigkeit optimieren?
Genauigkeit. Die größte Herausforderung bei der Rechnungsverarbeitung mehrerer Lieferanten ist nicht die Lesegeschwindigkeit, sondern die Formatvielfalt. Ein vorlagenbasiertes OCR-Tool, das jede Rechnung in 0,5 Sekunden verarbeitet, aber eine separate Vorlage für jedes Lieferantenlayout benötigt, verbringt insgesamt mehr Zeit mit der Vorlagenpflege als mit der eigentlichen Verarbeitung. Ein Tool ohne Vorlage, das auf VLM basiert und jede Rechnung in 5–10 Sekunden verarbeitet, aber jedes Format ohne Einrichtung bewältigt, ist in der Gesamtarbeitszeit schneller – insbesondere wenn die Anzahl der Lieferanten wächst. Unser Leitfaden zu was OCR-Genauigkeit tatsächlich bedeutet erklärt, warum Feldgenauigkeit in Multi-Format-Workflows wichtiger ist als Geschwindigkeit auf Zeichenebene.
F: Wann sollte ich einen Hybrid-Ansatz verwenden – schnelles OCR für die Sichtung und genaues OCR für die Extraktion?
Eine Hybrid-Pipeline ist sinnvoll, wenn Sie eine bimodale Dokumentqualitätsverteilung haben: eine große Menge sauberer, standardisierter Dokumente (bei denen ein schneller Durchlauf ausreicht) gemischt mit einer kleineren Menge komplexer oder minderwertiger Dokumente (bei denen eine auf Genauigkeit optimierte Verarbeitung erforderlich ist). Die Dokumentensichtung über Tesseract oder leichtgewichtiges Cloud-OCR klassifiziert jedes eingehende Dokument als „sauber“ oder „anspruchsvoll“ und leitet saubere Dokumente an eine schnelle Extraktions-Pipeline weiter, anspruchsvolle an eine VLM- oder menschliche Prüfung. Dies ist ein häufiges Muster in Unternehmens-AP-Abteilungen, die sowohl elektronische Rechnungen großer Lieferanten als auch Papierrechnungen kleiner Anbieter verarbeiten. Der Haken: Die Routing-Logik selbst muss hochgenau sein, sonst gelangen anspruchsvolle Dokumente in die schnelle Pipeline und erzeugen Fehler.
Den Kompromiss bewusst eingehen
Der Geschwindigkeits-Genauigkeits-Kompromiss in der OCR ist kein Problem, das gelöst werden muss – er ist ein Designparameter, der bewusst festgelegt werden sollte. Für jeden Dokumentenverarbeitungs-Workflow gibt es den richtigen Balancepunkt. Der Fehler besteht darin, die Standardeinstellungen des Anbieters oder eine einzelne Benchmark-Zahl die Entscheidung für Sie treffen zu lassen.
Die meisten Teams legen bei der Bewertung zu viel Gewicht auf Geschwindigkeit, weil Geschwindigkeit leicht zu messen ist (eine Zahl, ein Durchlauf, ein Timer) und Genauigkeit nicht (sie variiert je nach Dokumenttyp, Qualität, Feld und Fehlerdefinition). Ein ehrlicher Bewertungsprozess misst die Genauigkeit an den tatsächlich verarbeiteten Dokumenten – einschließlich der unordentlichen – und misst die Gesamtworkflow-Zeit, nicht nur die OCR-Latenz. Diese Gesamtzeit umfasst auch die Zeit für die Fehlerkorrektur, und genau dort verliert die „schnelle“ OCR ihren Vorteil.
Vision-Language-Modelle haben die Genauigkeitskurve abgeflacht und machen hohe Genauigkeit bei tolerablen Geschwindigkeiten für die meisten Geschäfts-Workflows zugänglich. Wenn Genauigkeit Ihre Einschränkung ist – und für die meisten Dokumentextraktions-Anwendungsfälle sollte sie das sein – ist ein VLM-basiertes Tool, das eine Seite in 5–10 Sekunden verarbeitet und Feldgenauigkeit über 95 % liefert, die bessere Wahl als ein Tool, das dieselbe Seite in 0,2 Sekunden verarbeitet und Sie jeden 5. Wert überprüfen lässt.
Testen Sie den Kompromiss an Ihren tatsächlichen Dokumenten. Sehen Sie, wie 5 Sekunden pro Seite aussehen, wenn die Fehler, die früher Minuten zur Suche brauchten, einfach nicht mehr da sind.