OCRで小数点や通貨記号が
欠落するのはなぜ?
OCRツールが$154.99を$15499に変換してしまい、請求書の合計金額が100倍に膨れ上がった経験はありませんか?これは決して珍しいことではなく、買掛金管理や経費管理で最も頻繁に報告されるデータ抽出エラーのひとつです。この問題には4つの明確な根本原因があり、どの原因が自分のドキュメントに該当するかを特定することが、最速の修正方法です。
重要なポイント
- OCRツールは99%の文字精度を謳っていますが、残り1%のエラー率が、請求書の金額を100倍に膨らませるたった1文字に集中しています。
- 小数点のエラーには必ず認識可能な特徴があり、JPEG圧縮による2ピクセルのドット消失から、米国製エンジンを混乱させる欧州式のカンマ小数点まで、4つの根本原因のいずれかに遡ることができます。
- その特徴を原因に照合できれば、闇雲に解像度を調整し続ける必要はなくなり、実際の問題に対処する唯一の修正方法を最初の試行で適用できます。
コストは画面上の誤った数字だけにとどまりません。SOXコンプライアンス要件の下では、公開企業は完全かつ正確な財務記録を維持する必要があります。自動化パイプラインでの小数点の誤りは、コンプライアンス上のリスクとなります。どの企業にとっても、$154.99の請求書に対する$15,499.00の支払いは、月末締めで発覚するまで$15,344.01の過払いを意味します。ほとんどのOCRエンジンは99%の文字レベル精度を謳っていますが、数値フィールドの1文字の誤りがデータ行全体を壊す可能性がある場合、その数字は誤解を招きます。ここでは、ピクセルレベルでこれらのエラーが発生する原因と、その防止方法を説明します。
原因1: 低解像度圧縮が小さなドットを消し去る
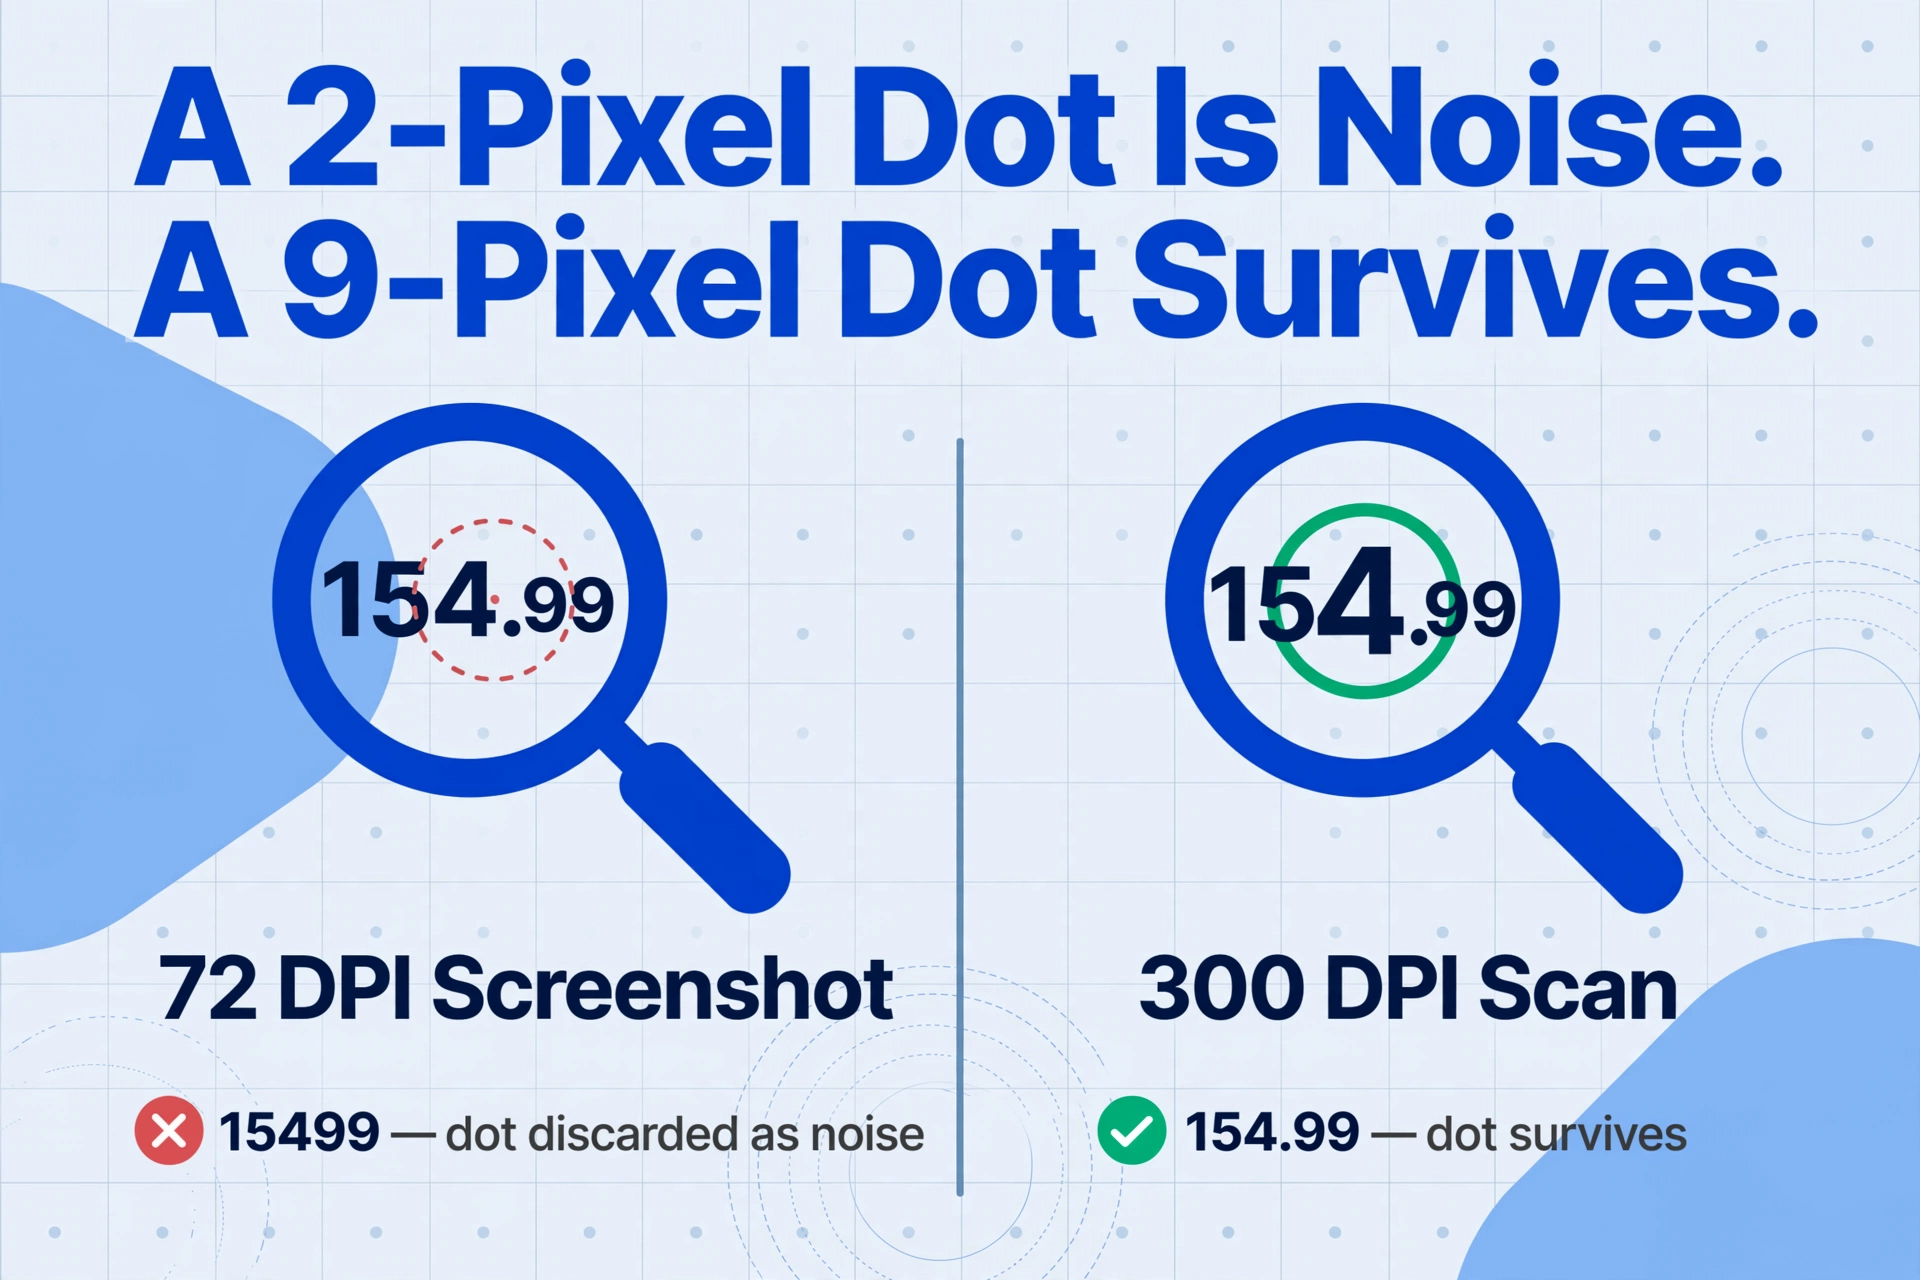
10ptフォントの小数点は、100 DPIでわずか3〜5ピクセルの幅しかありません。72 DPI(ほとんどのスクリーンショットの解像度)では、約2ピクセルに縮小します。JPEG圧縮は画像を8×8ピクセルのブロックで処理するため、ほぼ白のブロック内の2ピクセルのドットはノイズとして扱われ、破棄されます。
これが$154.99が$15499になる仕組みです。4と9の間の小数点が単純に消え、以前は明確に区別されていた154と99が、元の100倍の大きさの単一の数値に統合されます。同じメカニズムは、明細金額、単価、税合計、および2桁の小数部分に依存するその他のフィールドにも影響します。
この影響は照明が悪いとさらに悪化します。小数点周辺の影やグレアは、二値化フィルター(カラーを白黒ピクセルに変換する処理)がドットを背景から区別するのをさらに難しくします。二値化された画像でドットが消えてしまうと、どの言語モデルもそれを復元できません。エンジンがそもそもそれを見ていないからです。
原因2: 通貨記号の近接による混乱
通貨記号は、ほとんどのOCRエンジンにとって盲点となっています。ドル記号($)、ユーロ記号(€)、ポンド記号(£)、円記号(¥)は、数値の直前または直後に表示される装飾文字です。従来のOCRはこれらを識別すべき孤立したグリフとして扱いますが、しばしば誤認識します。
実際には、通貨記号に影響する3つの異なる障害モードがあります:
- 記号が完全に削除される — OCRエンジンが$1,234.56を単に1,234.56と判断し、通貨表示を黙って削除します。これにより曖昧な出力が生じます: 1,234.56はUSD、EUR、または他の単位でしょうか?複数のサプライヤーや通貨からのデータが単一のスプレッドシートに統合されると、通貨マーカーの喪失により、どの値が比較可能かを判断することが不可能になります。
- 記号が文字や数字として誤読される — $はSや5として頻繁に読み取られます。£は大文字のLや様式化されたEとして読み取られることがあります。これらの置換により
S1,234.56のような出力が生成され、下流システムが数値ではなく文字列として解釈する可能性があり、データベースインポートやExcel数式で型キャストエラーを引き起こします。 - 記号が隣接する数字と結合する — $記号が太字やセリフフォントで印刷され、最初の数字に近接している場合、OCRは結合領域を単一の文字として読み取る可能性があります。
$5はフォントの詳細に応じて55や95になります。
通貨記号の混乱は、出力が簡単な目視チェックを通過するため frustrating です — 数字は正しく見えます — しかし、それらの数字がどの通貨を表すかという情報は失われています。これが、金融文書処理において文字レベルの精度よりもフィールドレベルの精度が重要である理由です。
原因3: 小さい文字に対するアンチエイリアスのぼやけ
アンチエイリアス(フォントスムージング)は、文字の輪郭を部分的に塗りつぶされたピクセルのグラデーションとして描画し、滑らかな曲線を表現します。大きな本文テキストでは読みやすさが向上しますが、小数点や通貨記号のような小さい文字では逆効果になります。
8ptや9ptで描画された小数点は、請求書の明細行テーブルやレシートの細かい文字でよく見られますが、ピクセル数が少なすぎるため、スムージングによって背景にぼやけてしまいます。OCRエンジンが二値化(画像を白黒に変換する処理)を適用すると、ドットはグレーの汚れとなり信頼度しきい値を下回り、エンジンはその位置に何も出力しません。
同じことは、マイナス金額のマイナス記号、クレジットに使われる括弧、¥や€などの通貨記号の細いストロークにも当てはまります。これらはすべて、アンチエイリアスが最も破壊的な影響を与える密集したテーブルセル内で、非常に小さいサイズで描画されることがよくあります。
原因4: カンマと小数点の表記規則の曖昧さ
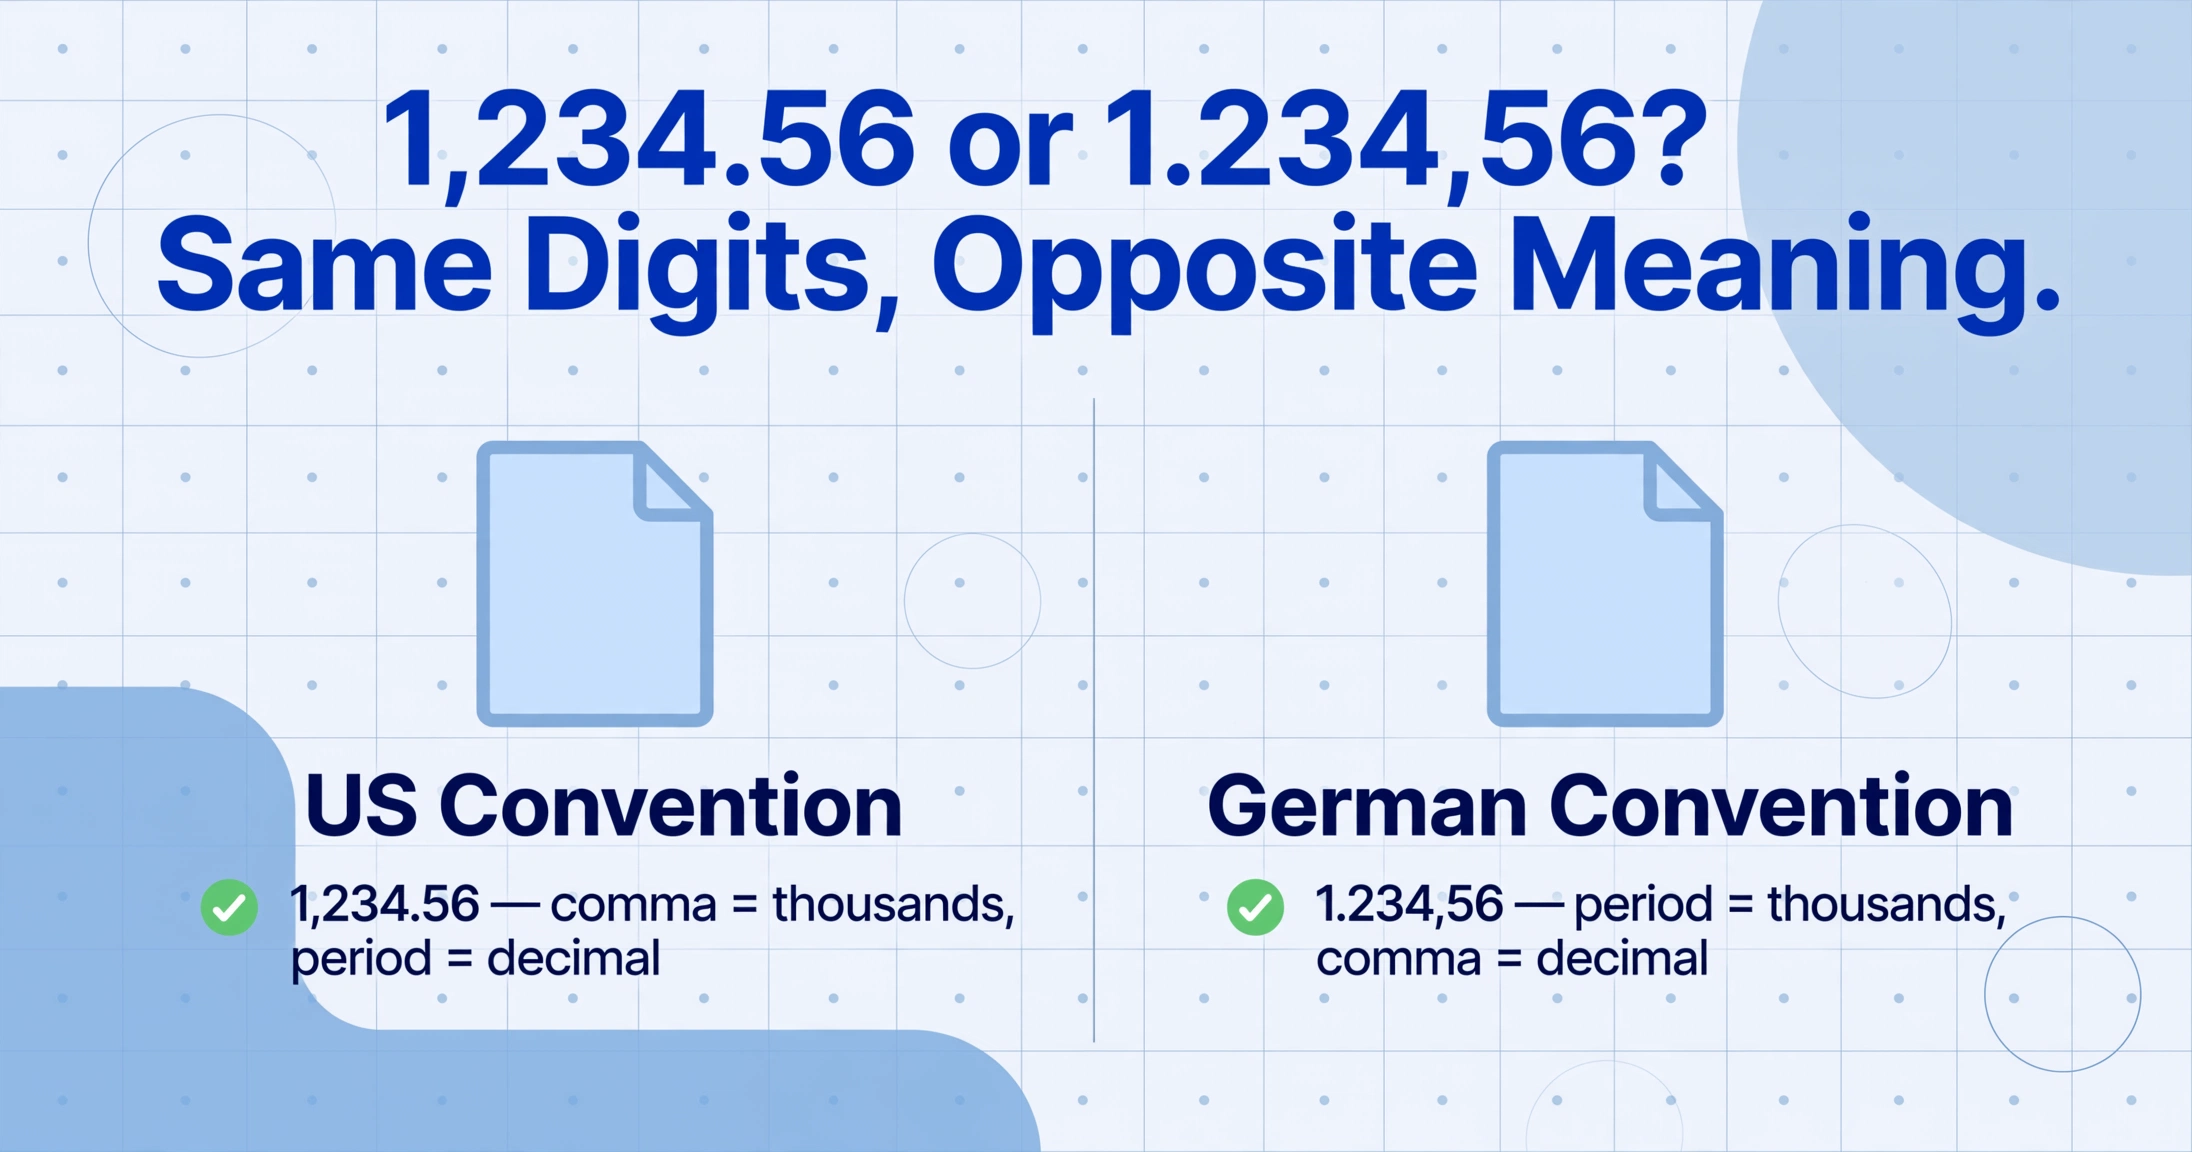
ピリオドやカンマという単一の文字が、文書の出所によって正反対の意味を持ちます。米国では、1,234.56はカンマが桁区切り、ピリオドが小数点です。大陸ヨーロッパの大半では、同じ数値は1.234,56と表記され、ピリオドが桁区切り、カンマが小数点になります。地域の文脈を持たないOCRエンジンには、これらを確実に見分ける方法がありません。
米国の請求書用に設計されたOCRシステムがドイツの1.234,56に遭遇すると、2つの数値(1と234,56)に分割したり、両方の区切り文字を完全に削除して123456にしたりして、値を100倍に膨らませる可能性があります。どちらの場合も、破損したデータが静かに会計システムに入り込みます。
複数地域が混在する文書では問題がさらに悪化します。フランスのサプライヤーがカンマ小数点を使用しながら英語のフィールドラベルを使用する場合、単一の地域規則を想定するロケールベースのOCRツールは混乱します。
小数点の曖昧さによる実際のコスト: 買掛金チームが毎月1,000件の国際請求書を処理し、2%の小数点誤読率の場合、20件の静かなエラーが発生します。そのうち5件でも誤った支払いにつながった場合、1件あたり平均$3,000の修正コストで、毎月$15,000の防げる損失になります。これは調査にかかる時間やベンダー関係の修復を考慮する前の数字です。
修正方法: 症状ベースの診断フレームワーク
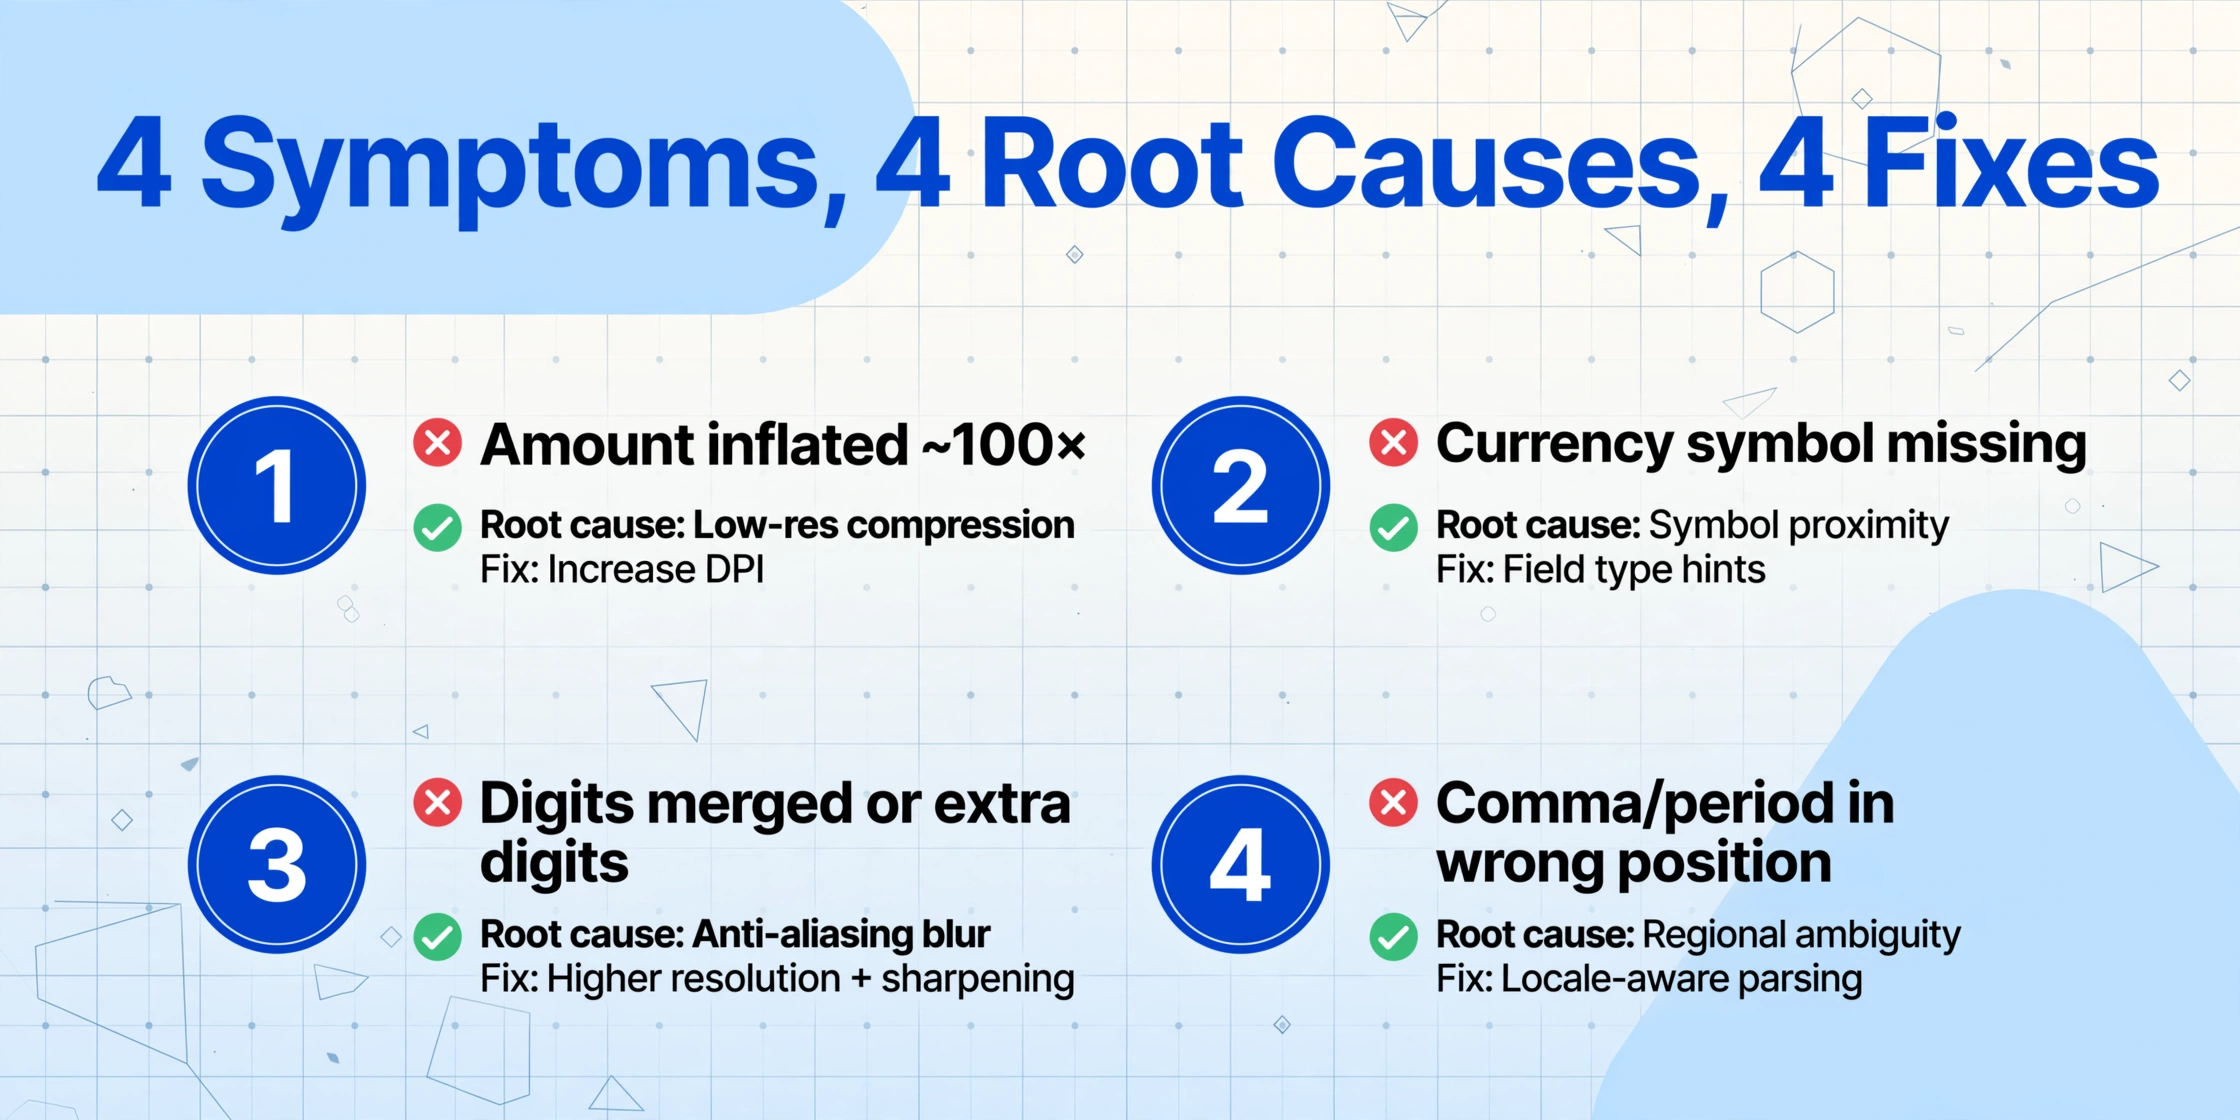
小数点や通貨に関するエラーは、すべて同じ根本原因を持つわけではありません。誤った修正を適用すると時間を浪費し、実際の問題を見逃します。以下の表は、抽出結果に現れる症状を、最も可能性の高い原因と対応する修正にマッピングしたものです。
| 出力の症状 | 最も可能性の高い原因 | 主な修正方法 |
|---|---|---|
| 金額が約100倍に膨張 | 低解像度圧縮 | 入力DPIを上げる / ロスレス形式を使用 |
| 通貨記号の欠落 | 記号の近接性またはフォント描画 | フィールド型ヒント + 意味的抽出 |
| 通貨記号が文字として誤読 | 文字形状の混同 | 後処理での正規表現パターンマッチ |
| 数字の結合または余分な数字の出現 | アンチエイリアスによるぼやけ | より高い入力解像度 + シャープニング前処理 |
| カンマ/ピリオドの位置が誤り (123.456 vs 123,456) | 地域慣習の曖昧さ | ロケール対応の後処理 + クロスフッティング |
| 金額が2つの別々の値に分割される | カンマ小数点の誤解釈 | 地域検出付きコンテキスト認識パーサー |
修正1: ソース画像の品質を向上させる
最も効果的な修正は最も単純なものです。OCRエンジンにより多くのピクセルを提供します。300 DPIでの小数点は約9ピクセルを占め、JPEG圧縮がノイズとして破棄できないほどです。600 DPIでは、同じドットが18ピクセルに広がり、圧縮設定が厳しくても生き残ります。
- 最低300 DPIでスキャン — 200 DPIが下限です。300 DPIが財務ドキュメントの信頼できる標準です。可能な限りスマートフォンのカメラではなくフラットベッドスキャナを使用してください。
- JPEGではなくTIFFまたはPNGで保存 — JPEGの非可逆圧縮が小数点ドロップアウトの主な原因です。TIFFとPNGはJPEGが破棄する2〜3ピクセルのドットを保持します。
- スマートフォンの写真の場合 — 真上から撮影し、明るい面を使用し、カメラの最大解像度でエクスポートします。テキスト領域のピクセル密度を最大化するために、ドキュメント領域に厳密にクロップします。
修正2: フィールド型ヒントを使用する
これは、一般的なOCRツールが提供できない修正であり、財務データに最も効果的なものです。システムにフィールドが通貨金額であることを伝えると、小数点と通貨記号を通常の文字ではなく、値に関する意味的なシグナルとして扱います。
ImageToTable.aiでは、これはカスタム列抽出を通じて機能します。「請求書合計」などの列を定義すると、AIがフィールド型を理解します。既知の通貨フィールドで値に遭遇すると、小数点区切り文字を積極的に探し、期待される2桁の小数構造を使用して数字を検証します。生の出力が「Total (USD)」フィールドに対して「15499」を生成した場合、AIは欠落した小数点にフラグを立て、確率的修正を適用します。
これは、位置ベースの抽出(ツールがゾーン内のすべての文字を読み取り、表示されたものを出力する)と意味ベースの抽出(ツールが何を探しているかを理解し、そのコンテキストを使用して曖昧さを解決する)の根本的な違いです。フィールド型ヒントは、小数点ドロップアウトを静かなデータ破損から修正可能な曖昧さに変えます。同じアプローチにより、仕入先ごとのテンプレート設定なしで、仕入先請求書のバッチを構造化されたExcelシートに直接処理できます。AIは各フィールドの意味を理解することで形式のバリエーションを処理し、ページ上の位置には依存しません。
修正3: 正規表現とクロスフッティングによる後処理
ソース品質や抽出ツールを制御できない場合、後処理が安全網となります。抽出後に発生する小数点および通貨エラーの大部分を、2つの手法で捕捉できます。前処理、エンジンチューニング、フィールドレベル検証戦略の概要については、金融文書のOCR精度を向上させる方法に関する完全ガイドをご覧ください。
パターンベースの検証。 ほとんどの通貨金額は予測可能なパターンに従います。^\d{1,3}(?:,\d{3})*\.\d{2}$のような正規表現は、米国形式の金額を検証します。小数点がない値、小数点以下4桁の値、または区切り記号が不一致の値は、レビュー用にフラグが立てられます。
クロスフッティング(数学的検証)。 明細項目がある文書では、明細金額の合計が総額と一致する必要があります。不一致は小数点の誤読を示します。明細の合計が$1,249.85なのに総額が$124,985.00として抽出された場合、小数点が3桁移動しています — ほぼ間違いなくドット消失エラーです。クロスフッティングは根本原因に関係なく、これを即座に検出します。
後処理は、優れたソース品質や意味的抽出の代替ではありません — すり抜けたエラーを検出するための検出層です。
エスカレーションのタイミング: 修正の限界を認識する
すべての小数点および通貨記号エラーが、入力品質の向上や後処理ルールの追加で修正できるわけではありません。3つのシナリオは、抽出アプローチ自体を変更する必要があることを示しています:
シナリオ1: 大量の複数ソース処理。 ワークフローが異なる形式や地域の慣習を使用する何百ものサプライヤーからの請求書を処理する場合、ベンダーごとの前処理チューニングはスケールしません — オーバーヘッドが自動化の効率向上を打ち消します。
シナリオ2: 主にモバイルで撮影された文書。 スマートフォンの写真は、遠近歪み、グレア、変動する照明を引き起こし、小さな文字の認識を一貫して低下させます。修正策はより良い前処理ではなく、文字レベルの認識が不確かな場合に意味的コンテキストを使用して値を解釈するシステムです。
シナリオ3: 非常に密度の高い表を含む文書。 銀行明細書、証券レポート、複数行の請求書は、小数点が6ptから8ptで表示される小さな表セルに数値を詰め込みます。そのサイズでは、スキャン解像度に関係なくアンチエイリアスのぼやけはほぼ避けられません — ピクセルベースのOCRは根本的な精度の限界に達します。
これらのシナリオでは、完璧な前処理でさえギャップを埋めることはできません — 解決策は、ピクセル値だけでなく文書構造とフィールドセマンティクスを理解するビジョンベースのアプローチです。関連するガイダンスについては、結合セルがテーブル抽出を壊す仕組みとOCRがテーブルを認識できない理由を参照してください — 小数点エラーがピクセルレベルの問題ではなく構造的な誤読から発生する一般的なシナリオです。
よくある質問
電話で撮影した写真ではOCRが小数点を落としやすいのに、スキャン文書では落とさないのはなぜですか?
腕を伸ばして撮影した電話の写真は、72〜150 DPIの範囲の画像になります。この解像度では、小数点はわずか2〜4ピクセルの幅しかありません。JPEG圧縮は8×8ピクセルのブロック単位で画像を処理するため、ほぼ白のブロック内にある2ピクセルの点はノイズとみなされて破棄されます。一方、300 DPIのフラットベッドスキャナでは、点は9ピクセル以上になり、圧縮を確実に生き残ります。これは物理的な限界です。小さな文字は、センサーノイズと区別できるだけの十分なピクセル数を必要とします。
AIベースのOCRは、従来のOCRが見逃す小数点エラーを修正できますか?
はい — ただし、JPEGが破棄した点を「見る」ことによる修正ではありません。AIベースの抽出は、コンテキストを使用して小数点の位置を推論します。システムが請求書の合計金額を読み取っていると認識し、生の出力が「15499」である場合、学習済みパターン(ほとんどの合計金額は小数点以下2桁)を適用して、$154.99を再構築します。これはフィールドタイプが既知の場合にのみ機能します。白紙のOCRシナリオでは、キャプチャされなかったものを修正できるAIはありません。
地域別フォーマットが混在する請求書(米国とEUのサプライヤー)はどう処理すればよいですか?
地域混在の処理は、表記規則に依存する解析にとって最も難しいケースです。最も実用的なアプローチは、抽出した金額を数学的な整合性に対して検証することです — 明細項目の合計が総額と一致しますか? 1.234,56のカンマ小数点の読み取りが明らかに非現実的な値を生成する場合、システムは代替の解析を試みます。セマンティック抽出ツールはこれを自動的に適用できます — AIがフィールドが妥当な金額であるべきだと理解していれば、非現実的な区切り文字の解釈を除外します。
OCRの前に低解像度画像をアップスケーリングすると、小数点の復元に役立ちますか?
従来のアップスケーリング(バイリニアまたはバイキュービック補間)では、失われた詳細は復元されません — 既存のピクセルをより大きなキャンバスに広げるだけです。2ピクセルの小数点を200%にアップスケーリングすると、補間されたグレーの4ピクセルになりますが、それでもほとんどのOCR検出しきい値を下回ります。劣化した画像を修正しようとするよりも、高品質のソース画像から始める方が常に効果的です。
財務書類で小数点を確実に読み取るための最小スキャン解像度は?
300 DPIが実用的な最小値です。200 DPIでは、標準的な10ptフォントの小数点は4〜5ピクセルに広がり、スマートフォンのカメラ解像度と大差ありません。300 DPIでは同じドットが8〜9ピクセルになり、OCRエンジンが背景ノイズと区別するのに十分な信号が得られます。非常に小さなフォント(明細表の8pt以下)の文書では、400〜600 DPIが推奨されますが、高DPIにするとファイルサイズが線形に増加することに注意してください。
カンマ区切りの千単位表記(1,234.56)は、ほとんどのOCRツールで安全に扱えますか?
必ずしもそうとは限りません。多くのOCRエンジンは米国式の表記を適切に処理しますが、カンマがピリオドと誤読されたり、破棄されたりして、1.234.56や1234.56になることがあります。さらに重要なのは、同じ文書内にカンマが小数点として使われる値(複数ベンダーのワークフローで一般的)が含まれる場合、OCRは形状だけでは2つの用途を区別できず、どのフィールドがどちらの形式かを示す文脈知識が必要になることです。そのため、複数地域にまたがる信頼性の高い処理には、フィールドレベルの型ヒントが不可欠です。
小数点の見逃しが何千ドルもの損失を生む前に
小数点や通貨記号は小さな文字ですが、その影響は計り知れません。たった一つの小数点の見逃しで、ベンダーに$15,000を過払いしたり、月末チェックでコンプライアンス違反を見逃したりする可能性があります。これらのエラーは偶然ではなく、OCRエンジンがピクセルレベルで画像を処理する仕組みに根ざした、それぞれ追跡可能な原因があります。どの原因がドキュメントに影響したかを把握することが、設定を盲目的に調整するのと、問題を恒久的に修正することの違いを生みます。
最も信頼できる修正方法は、読み取った内容を理解する抽出システムです。欠落した小数点の再構築、期待される形式に対する値の検証、手動設定なしでの地域別の区切り記号の処理を実現します。これがセマンティック抽出の可能性です。現在のツールで苦労している請求書をアップロードして、精度を並べて比較してみてください。